Hay una anécdota que circula desde hace años entre la gente que ha implantado sistemas de gestión en empresas grandes. Un consultor con muchas implantaciones a la espalda llegaba a la primera reunión de un proyecto nuevo y, antes de preguntar por el presupuesto, el alcance, los módulos o las fechas, hacía una sola pregunta: cuando dos áreas no se pongan de acuerdo y haya que elegir, ¿quién decide? Si la respuesta era «eso ya lo veremos entre todos», recogía sus cosas y se iba.
No he podido verificar esa anécdota en su forma literal, así que no la voy a vender como una cita. El candidato más serio que he encontrado es Thinking About ERP (Pienaar, du Toit, Viljoen y Wessels, 2008), un libro escrito por consultores a partir de sus propias implantaciones que dedica un apartado entero, titulado sin ambigüedad «Clear and unambiguous decision-making authority», a defender que antes de seleccionar nada hay que especificar qué autoridad tiene el jefe de proyecto, cuál el decisor ejecutivo, cuál el consejero delegado y qué temas se escalan. Y que cuando el proyecto implica rediseñar procesos no es un proyecto técnico, de modo que poner al responsable de sistemas al frente puede ser letal: hace falta alguien con autoridad para cambiar las reglas del negocio.
La anécdota funciona aunque no sea literal, porque señala con precisión el momento en el que se decide el destino de una transformación. Y ese momento no está en la implantación. Está antes del kickoff, en una sala donde todavía no hay Jira, ni proveedor, ni presentación con la palabra journey.
Antes de arrancar una transformación hay que diseñar el sistema mediante el cual esa transformación va a ser dirigida, decidida, corregida y —si hace falta— detenida. Todo lo demás es ejecución.
Este artículo es el manual de ese momento previo. Contiene los quince aspectos que hay que tener resueltos, el checklist de cuarenta preguntas que conviene pasar antes de convocar el kickoff, qué hace exactamente el líder —no qué dice que va a hacer—, los seis mensajes concretos que tiene que dar y cuándo, los doce modos de fallo por los que estos proyectos se caen de verdad con sus señales tempranas, y la curva psicológica que atraviesan los equipos: del monte de la ignorancia al valle de la desesperación, explicada con el detalle que merece porque es donde más líderes se equivocan.
Una aclaración de alcance antes de empezar. Aquí no se desarrollan los modelos de gestión del cambio. Kotter, ADKAR, Lewin y McKinsey 7-S aparecen solo cuando hacen falta para sostener un argumento, porque ya tienen su propio análisis en por qué falla la transformación empresarial: de Kotter a ADKAR. Repetirlos aquí sería convertir este texto en otro catálogo de marcos, que es exactamente lo que no necesita nadie.
El dato del 70% es falso. El problema no.
Cualquier presentación sobre transformación empieza con la misma diapositiva: el 70% de los proyectos de transformación fracasa. A veces el 70%, a veces el 75%, en los casos más entusiastas el 84% o el 96%. La cifra se atribuye indistintamente a McKinsey, a BCG, a Kotter o a Prosci, y casi nunca viene con una nota al pie.
En 2011, Mark Hughes, de la Universidad de Brighton, publicó en el Journal of Change Management un artículo con un título que lo dice todo: «Do 70 Per Cent of All Organizational Change Initiatives Really Fail?». Rastreó las cinco fuentes más citadas para ese número —Hammer y Champy, Beer y Nohria, un artículo de Bain, uno de McKinsey y Kotter— y encontró el mismo patrón en todas: o afirmaban la cifra sin aportar evidencia, o citaban a otro que la afirmaba sin evidencia. Su conclusión fue que existe un relato popular del 70% de fracaso, pero no existe evidencia empírica válida y fiable que lo sostenga.
Esto importa más de lo que parece, y no por pedantería estadística. Un número repetido sin evidencia sirve para justificar cualquier cosa: comprar una metodología, contratar una consultora, montar una oficina de cambio o —sobre todo— excusar un fracaso propio. «Ya se sabe que el 70% fracasa» es una frase que ha salvado muchas carreras y no ha arreglado ningún proyecto.
No sabemos con rigor cuántas transformaciones fracasan. Sabemos bastante bien por qué fracasan las que fracasan. Y esa segunda lista sí está sostenida por décadas de investigación coincidente.
La literatura de factores críticos de éxito en implantaciones de sistemas es, por una vez, aburridamente consistente. Somers y Nelson (2001), Umble, Haft y Umble (2003) y la revisión de Finney y Corbett (2007), que analizó cuarenta y cinco trabajos previos, repiten prácticamente el mismo listado: apoyo real de la dirección, competencia del equipo, cooperación entre departamentos, objetivos claros, gestión de proyecto, comunicación, gestión del cambio, formación, y calidad y gobierno de los datos.
Mire esa lista otra vez. Salvo la gestión de datos, no hay ni un solo elemento tecnológico. Y sin embargo la mayoría del presupuesto, del tiempo de dirección y de la atención del comité se va en elegir la tecnología. Esa asimetría entre dónde está el riesgo y dónde se pone el foco es, en una frase, el problema.
Hay un segundo hallazgo, menos citado y más útil. Knut Samset y Gro Holst Volden estudiaron la fase inicial de grandes proyectos y concluyeron que buena parte de los problemas que estallan en la ejecución tienen su origen en una definición deficiente del front-end: decisiones débiles, ambiguas o directamente no tomadas en las primeras semanas, cuando todavía costaba muy poco tomarlas bien. Dicho de otro modo: muchos proyectos que parecen fracasar durante la implantación ya estaban mal diseñados el día del kickoff.
El kickoff no es la salida. Es la meta de una fase anterior
La forma habitual de entender el kickoff es la de un pistoletazo: se anuncia el proyecto, se presenta el equipo, se enseña el cronograma y a partir de ahí empieza el trabajo de verdad. Es exactamente al revés. El kickoff debería ser el acto en el que se comunica algo que ya está resuelto: qué problema se resuelve, qué beneficio se persigue, quién responde de conseguirlo, quién decide cuando haya conflicto, qué puede cambiar y qué no, y bajo qué condiciones el proyecto se reorienta o se para.
Bent Flyvbjerg y Dan Gardner lo formularon en How Big Things Get Done (2023) con tres palabras que resumen décadas de datos sobre megaproyectos: think slow, act fast. Pensar despacio no significa eternizar el análisis ni montar catorce comités; significa invertir de verdad en definir, explorar alternativas, simular y prototipar mientras el coste de equivocarse todavía es una reunión, para después ejecutar rápido y sin titubeos. El patrón corporativo habitual es el contrario y tiene su propia secuencia: actuar rápido, descubrir la catástrofe, montar catorce comités y entonces sí, pensar muy despacio.
De ese mismo trabajo sale una herramienta barata y muy incómoda: la visión exterior o reference class forecasting. En lugar de preguntar «¿cuánto creemos que tardaremos?», preguntar «¿cuánto han tardado proyectos parecidos al nuestro, hechos por empresas parecidas a la nuestra?». La diferencia entre las dos respuestas es la medida exacta del optimismo del equipo. Si su proyecto de dieciocho meses se parece a otros que tardaron treinta, tiene dos opciones honestas: cambiar el plan o cambiar el alcance. La tercera —confiar en que esta vez será distinto— es la que produce las diapositivas rojas del mes catorce.
La segunda aportación práctica es la modularidad. Un proyecto dividido en módulos repetibles aprende entre módulo y módulo y limita el daño de cada error. Un proyecto concebido como un único gran salto acumula todo el riesgo en una sola fecha. Si su plan tiene un único go-live para toda la compañía y ese go-live está a dos años vista, no tiene un plan: tiene una apuesta.
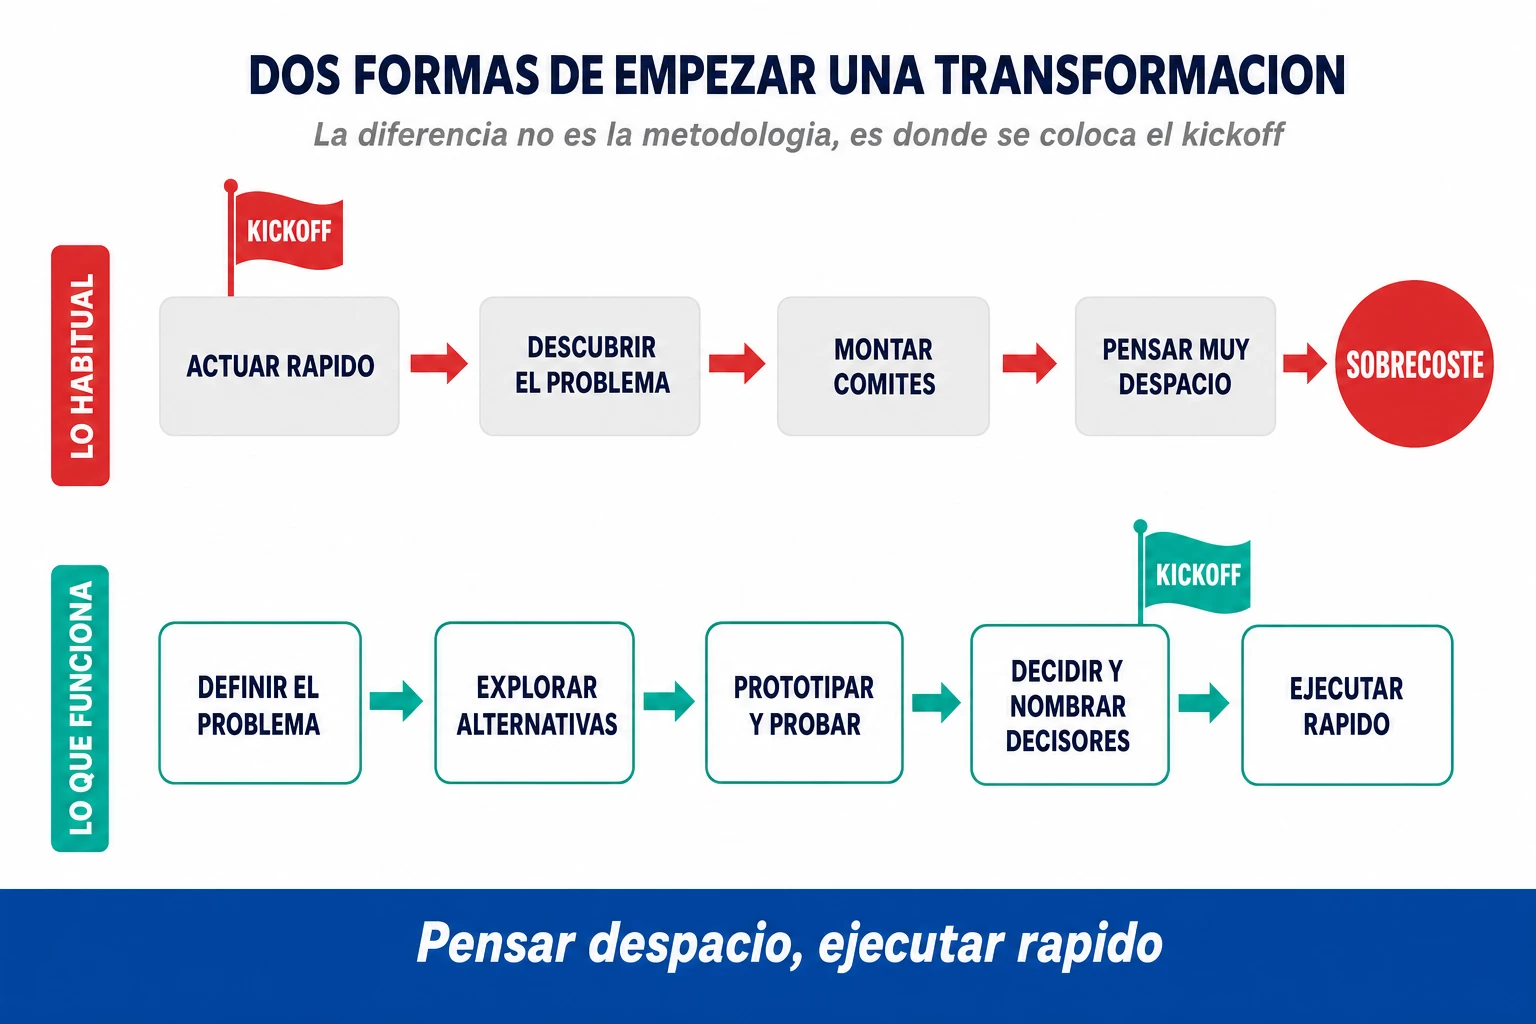
Una prueba sencilla para saber en cuál de las dos secuencias está usted: coja el acta del comité de la semana pasada y cuente cuántos puntos terminan en «pendiente de confirmar quién lo decide». Si hay más de dos, el kickoff llegó antes de tiempo.
Los quince aspectos clave, en cinco bloques
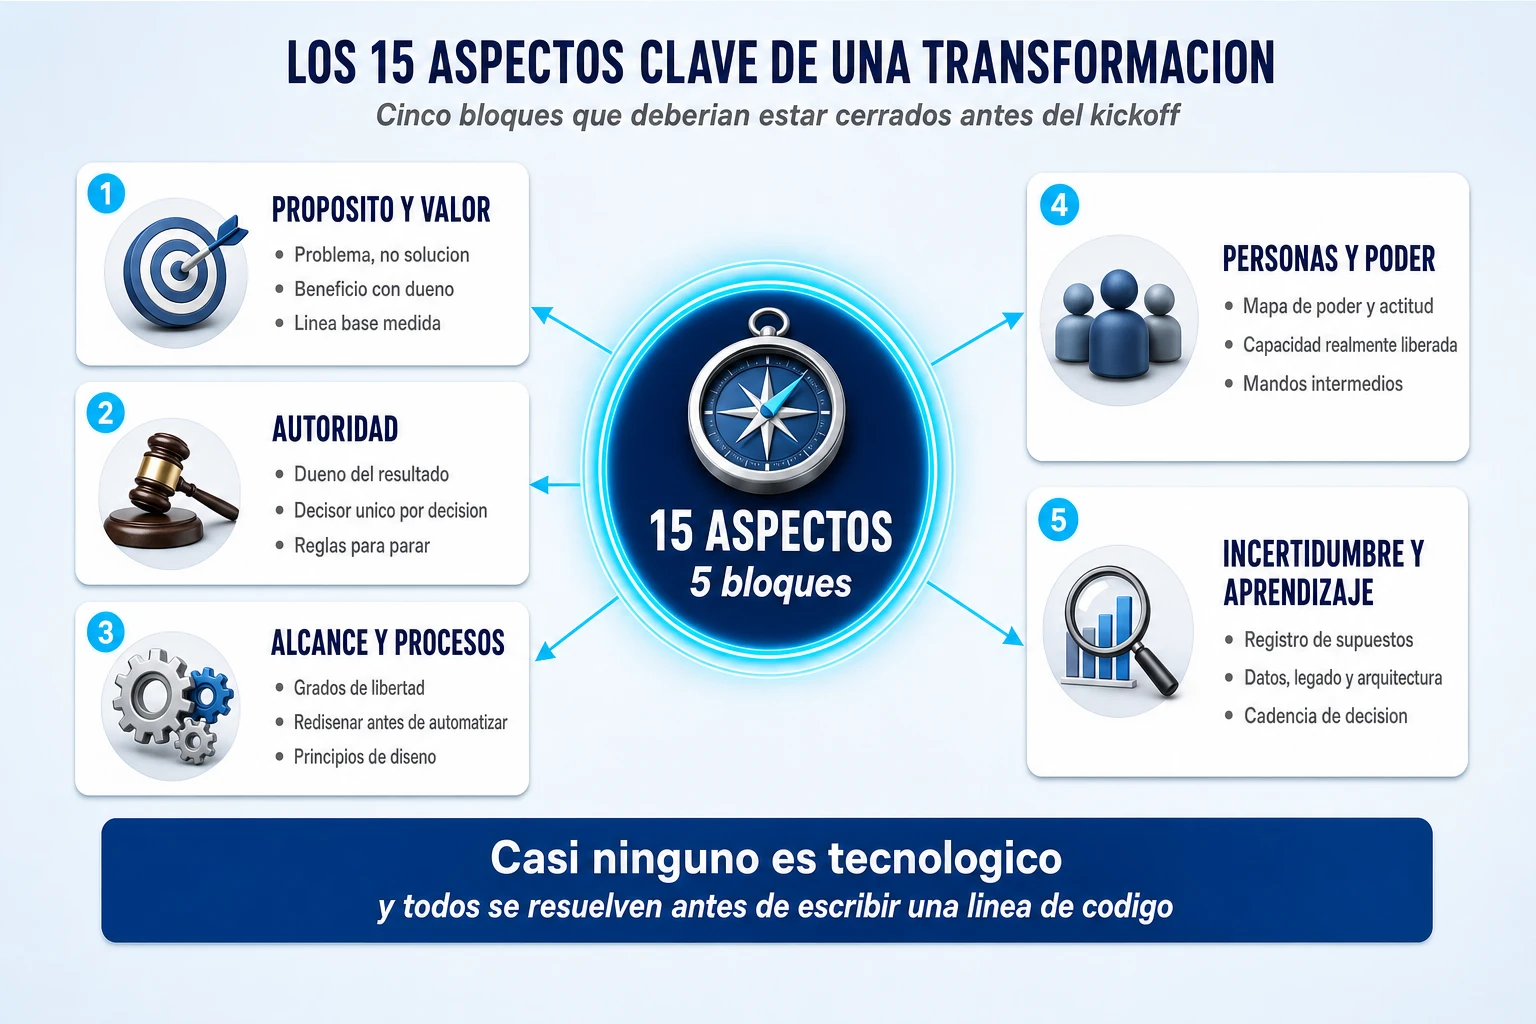
Si se juntan las grandes referencias sobre arranque de proyectos —la literatura de ERP, la de gobernanza de decisiones, la de front-end, la de stakeholders, la de incertidumbre y la de gestión del cambio— y se les quita a cada una su envoltorio metodológico, queda debajo una arquitectura común. Son quince asuntos. Ninguno es opcional y casi ninguno es tecnológico.
| # | Aspecto | Pregunta fundamental | Señal de que no está resuelto |
| Bloque 1 · Propósito y valor | |||
| 1 | Problema | ¿Qué problema queremos resolver y qué pasa si no hacemos nada? | El business case empieza con el nombre de un producto |
| 2 | Beneficio | ¿Qué beneficio económico u operativo esperamos y quién responde de él? | Los objetivos son entregables: «ERP implantado» |
| 3 | Métrica | ¿Cuál es la línea base y cómo sabremos que ha funcionado? | No existe medición previa del proceso actual |
| Bloque 2 · Autoridad | |||
| 4 | Ownership | ¿Quién se despertaría preocupado si en dos años no hay beneficios? | «El proyecto es de todos» |
| 5 | Derechos de decisión | ¿Quién decide cada decisión crítica? | Las decisiones vuelven al comité por tercera vez |
| 6 | Reglas de parada | ¿Qué tendría que pasar para reorientar o cancelar el proyecto? | Nadie tiene autoridad política para pararlo |
| Bloque 3 · Alcance y procesos | |||
| 7 | Grados de libertad | ¿Qué podemos cambiar: tecnología, procesos, organización o las tres? | Nadie ha escrito qué no se puede tocar |
| 8 | Rediseño | ¿Estamos rediseñando el proceso o automatizando el actual? | El TO-BE se parece al AS-IS con pantallas nuevas |
| 9 | Principios de diseño | ¿Qué reglas resuelven por adelantado las decisiones de detalle? | Cada excepción se debate desde cero |
| Bloque 4 · Personas y poder | |||
| 10 | Mapa de poder | ¿Quién puede acelerar, bloquear o deformar el proyecto? | Hay un Excel de stakeholders con alto/medio/bajo y nada más |
| 11 | Capacidad liberada | ¿Qué dejarán de hacer las personas clave para poder participar? | «Lo compaginarán con su trabajo» |
| 12 | Mandos intermedios | ¿Qué ganan y qué pierden los jefes de área con este cambio? | Apoyan en el comité y frenan en su equipo |
| Bloque 5 · Incertidumbre y aprendizaje | |||
| 13 | Supuestos | ¿Qué estamos dando por cierto sin haberlo comprobado? | Hay registro de riesgos pero no de supuestos |
| 14 | Datos y arquitectura | ¿Puede la arquitectura y el dato actual sostener el modelo futuro? | La migración se ha aplazado ya dos veces |
| 15 | Cadencia | ¿Cada cuánto se decide, se mide y se corrige? | El gobierno es un comité mensual de estado |
Bloque 1 · Propósito y valor
1. Empezar por el problema, no por la solución. La mayoría de los proyectos no nacen de un problema, nacen de una solución: «implantar SAP», «meter IA», «montar un nuevo modelo de atención». A partir de ahí, todo el análisis posterior se dedica a justificar una decisión ya tomada. La regla es simple y casi nadie la aplica: no se debería aprobar una solución hasta haber aprobado el problema que pretende resolver. Y hay una pregunta que ahorra mucho dinero: ¿qué pasa si no hacemos nada? A veces la respuesta revela que no hay un problema de veinte millones, sino una presentación especialmente entusiasta.
2. Definir beneficios, no entregables. «ERP implantado», «plataforma desplegada», «cien agentes migrados» son outputs. No demuestran que la empresa funcione mejor. La cadena correcta es outputs → outcomes → beneficios → valor, y cada beneficio necesita un dueño con nombre y apellidos que responda de él cuando el proyecto ya haya terminado. La diferencia entre «implantar una nueva plataforma de atención» y «bajar el tiempo medio de resolución de 42 a 18 horas, reducir un 20% las reiteraciones y un 15% el coste por incidencia en doce meses» no es de redacción. Es la diferencia entre un proyecto que se puede evaluar y uno que no.
3. Línea base antes que objetivo. Un objetivo sin línea base es una opinión. Si nadie ha medido el proceso actual, el primer entregable del proyecto no es un diseño: es una medición. Y conviene hacerla antes de anunciar nada, porque en cuanto se anuncia el proyecto los números empiezan a moverse por razones que no tienen que ver con el proyecto. El formato mínimo de cada compromiso es siempre el mismo: línea base → indicador → objetivo → fecha → responsable del beneficio.
Bloque 2 · Autoridad
4. Quién es dueño del resultado. Jefe de proyecto, sponsor, propietario de proceso, dirección de negocio, sistemas, proveedor y comité de dirección no son intercambiables, aunque en la mayoría de las actas lo parezcan. La Association for Project Management define al sponsor como la persona que responde de que el trabajo esté bien gobernado y entregue los beneficios previstos, con autoridad para atravesar fronteras funcionales. La prueba definitiva es esta pregunta: ¿quién se despertaría preocupado si dentro de dos años los beneficios prometidos no se hubieran conseguido? Si la respuesta es «el proyecto es de todos», significa «no es de nadie», que es una tradición organizativa muy extendida y muy cara.
5. Derechos de decisión explícitos. Peter Weill y Jeanne Ross, del MIT, definieron la gobernanza con una fórmula que se puede escribir en una servilleta: gobernanza = derechos de decisión + rendición de cuentas. Quién tiene autoridad para decidir cada cosa y quién responde del resultado. Esto merece su propia sección y la tiene más abajo, porque es el punto donde se cae más gente.
6. Reglas para continuar, cambiar o parar. La gobernanza no consiste solo en explicar quién aprueba el proyecto; tiene que explicar quién puede pararlo. Antes del kickoff deberían existir criterios explícitos de go / pivot / pause / stop: qué resultado de qué prueba, a qué fecha, obliga a reabrir el diseño o a cancelar un tramo. Hay una pregunta muy saludable para hacer en el comité de arranque: ¿qué tendría que ocurrir para que decidiéramos parar esto? Si la respuesta es «nada, ya está aprobado», lo que hay en esa sala no es gobernanza. Es fe.
Bloque 3 · Alcance y procesos
7. Grados de libertad. Este concepto, que viene de Thinking About ERP, es de lo más útil que se puede llevar a una reunión de arranque. Hay proyectos donde solo puede cambiar la tecnología; otros donde pueden cambiar tecnología y procesos; otros donde además cambia la organización; y transformaciones donde cambia todo. Cuantos más elementos puedan cambiar, más arriba tiene que estar la autoridad que gobierna el proyecto. Poner una transformación de tres dimensiones bajo la autoridad de un director funcional es garantizar el bloqueo. Por eso hay que escribir dos listas explícitas —qué puede cambiar y qué no— y hacerlas firmar. Eso evita descubrir en el mes nueve que la «transformación radical» tenía permiso para cambiar los iconos de la aplicación y poco más.
8. Rediseñar antes de automatizar. También tiene sección propia más abajo, porque con inteligencia artificial de por medio ha dejado de ser un consejo de buenas prácticas para convertirse en un riesgo de primer orden.
9. Principios de diseño. Antes de entrar en el detalle conviene acordar seis u ocho principios que resuelvan por adelantado cientos de discusiones posteriores. Por ejemplo: fit-to-standard antes de personalizar; un dato, una fuente; automatizar salvo excepción justificada; resolver en el punto más cercano al cliente; humano en el bucle solo donde aporte valor; el recorrido de cliente manda sobre el silo departamental. Weill y Ross demostraron que las decisiones sobre principios deben preceder y orientar a las de arquitectura, infraestructura, aplicaciones e inversión. Un principio sirve para algo solo si alguna vez obliga a decir que no a alguien con galones.
Bloque 4 · Personas y poder
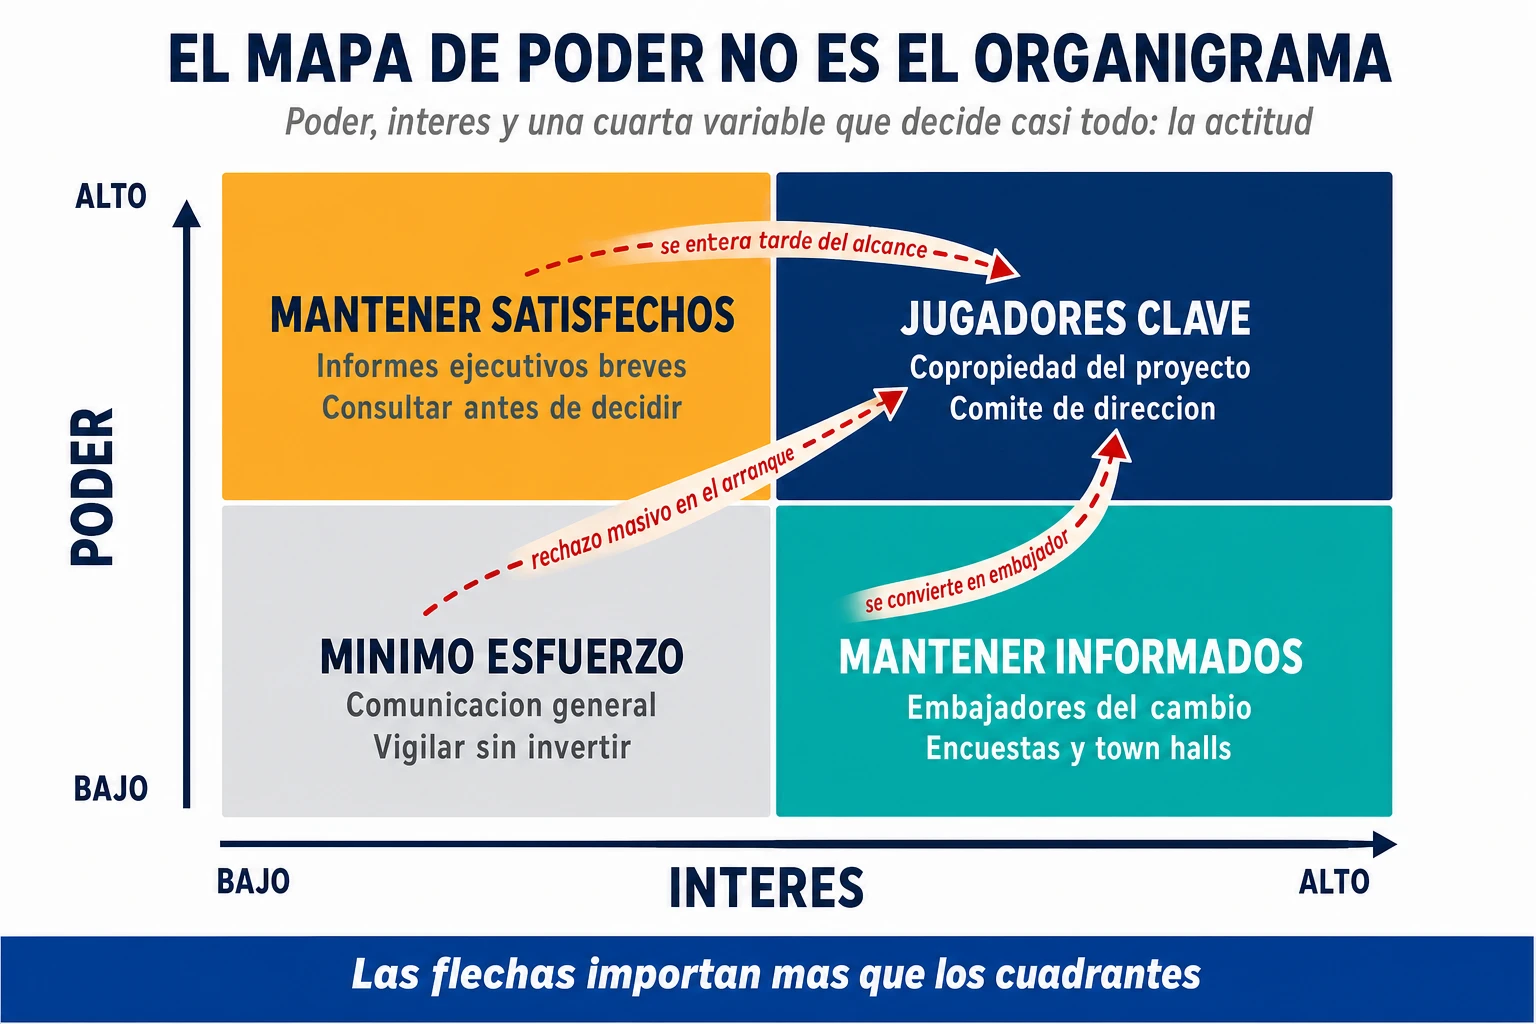
10. El mapa de poder, no el organigrama. Freeman estableció que hay que mirar a todos los que pueden afectar o verse afectados por la iniciativa, no solo a los responsables formales. Mitchell, Agle y Wood lo hicieron operativo con tres dimensiones —poder, legitimidad y urgencia— cuya combinación determina cuánta atención merece cada actor. La matriz de poder e interés de Mendelow añade la lectura táctica: a los de alto poder y alto interés se les gestiona de cerca y se les da copropiedad; a los de alto poder y bajo interés se les mantiene satisfechos antes de que se enteren tarde y bloqueen; a los de bajo poder y alto interés se les convierte en embajadores.
Conviene añadir una cuarta variable que no está en los modelos académicos y que decide casi todo: la actitud ante el cambio. Y tratar el mapa como algo vivo, no como una diapositiva. Un colectivo situado en «bajo poder / bajo interés» puede saltar a «alto poder / alto interés» en una sola mañana si rechaza masivamente el sistema el día del arranque y para la operación. Descubrir tarde a un actor crítico es una de las causas mejor documentadas de expansión de alcance.
11. Capacidad real liberada. Esta es la pregunta que casi nunca aparece en el organigrama del proyecto: ¿qué van a dejar de hacer las personas clave para poder participar? Porque «María será propietaria del proceso al 30%» casi siempre significa «María mantendrá el 100% de su trabajo y además participará en esto cuando pueda». Si la respuesta a qué dejan de hacer es «nada», no tiene un equipo: tiene voluntarios agotados que en el mes cuatro dejarán de ir a las sesiones. La cifra que se maneja en transformaciones serias es liberar formalmente entre un 20% y un 30% de la carga operativa de los usuarios clave, con sustituciones nombradas. Y hay un test de selección que funciona: si sacar a esa persona de la operación diaria no genera incomodidad inmediata en su departamento, no ha elegido a la persona correcta.
12. Los mandos intermedios. La capa de gerentes y jefes de área es el punto de mayor fricción de casi cualquier transformación, y casi nunca por terquedad. Es una evaluación de riesgos perfectamente racional dados sus incentivos: se les exige mantener los resultados del día a día mientras ceden a sus mejores profesionales al proyecto; asumen personalmente la caída de productividad de la transición pero no participan del beneficio estratégico; y la estandarización reduce sus parcelas de poder y de información. Si no se tocan esas tres cosas, la resistencia no es un problema de comunicación: es la respuesta correcta al sistema de incentivos que usted mismo ha diseñado.
Bloque 5 · Incertidumbre y aprendizaje
13. Supuestos, no solo riesgos. Chris Chapman y Stephen Ward critican el registro de riesgos convencional porque acaba siendo una «lista de cosas malas que podrían pasar» que nadie lee. Proponen hablar de gestión de la incertidumbre, que incluye lo que ignoramos sobre objetivos, alcance, comportamiento de los usuarios, tecnología, dependencias y estimaciones. De ahí sale la herramienta más rentable del arranque: un registro de supuestos con cuatro columnas —supuesto, solidez de la evidencia, impacto si es falso y cómo comprobarlo— y la obligación explícita de intentar destruir cuanto antes los supuestos más peligrosos. Descubrir en el mes uno que una hipótesis era falsa cuesta una semana. Descubrirlo con catorce millones gastados cuesta el proyecto.
| Supuesto | Evidencia | Impacto si es falso | Cómo comprobarlo, y cuándo |
| Los usuarios adoptarán el canal digital | Débil | Alto | Piloto con 50 usuarios reales · mes 2 |
| Las API del sistema antiguo soportarán el volumen | Media | Crítico | Prueba de carga · mes 1 |
| El proceso estándar cubre el 90% de los casos | Baja | Alto | Análisis fit-gap sobre casos reales · mes 2 |
| El ahorro esperado es del 20% | Baja | Alto | Contraste con proyectos comparables · mes 1 |
14. Datos, legado y arquitectura desde el día uno. La literatura de implantaciones señala una y otra vez los mismos culpables: sistemas heredados, integraciones, calidad del dato, pruebas y encaje entre el estándar del producto y el proceso real. Antes de prometer nada —y con más razón si lo prometido lleva la palabra «inteligencia artificial»— hay que saber qué datos existen, quién es su dueño, qué calidad tienen, qué sistema es la fuente de verdad, qué API hay disponibles, qué restricciones regulatorias aplican y qué integraciones harán falta. Una transformación digital se apoya sobre una arquitectura que ya existe, le guste o no al PowerPoint.
15. Cadencia de decisión, no comité de estado. El gobierno no se ejerce con informes mensuales, se ejerce con una cadencia de decisión. Lo que funciona son tres alturas con funciones distintas: un comité estratégico mensual o trimestral que asigna capital y decide puertas de control; una sala de control semanal o quincenal que desbloquea lo transversal y aprueba decisiones; y una sincronización operativa diaria o bisemanal para incidencias, pruebas y datos. La métrica de salida de cada una no es «estado del proyecto», es «decisiones tomadas y bloqueos eliminados». Un comité que no decide nada es una reunión de información con catering.
Quién decide qué: RAPID, la regla del decisor único y el SLA de 48 horas
En 2006, Paul Rogers y Marcia Blenko, de Bain, publicaron en Harvard Business Review un artículo con uno de los mejores títulos de la historia de la literatura de gestión: «Who Has the D?». Su tesis era que las organizaciones invierten muchísimo en decidir qué hacer y casi nada en decidir quién decide, y que la ambigüedad sobre ese punto produce decisiones que circulan eternamente entre funciones sin cerrarse nunca. El marco que propusieron, RAPID, separa cinco papeles distintos que en la práctica se confunden todo el tiempo.
| Letra | Papel | Qué hace | Regla de oro y error típico |
| R | Recommend · Recomienda | Diseña la propuesta, reúne los datos, analiza alternativas y presenta una opción concreta | Una sola persona o equipo focal. Integra los insumos antes de elevar, no durante |
| A | Agree · Acuerda | Verifica que se cumplen restricciones obligatorias: legales, regulatorias, financieras o de riesgo | Debe estar muy acotado. Repartir vetos destruye la agilidad. Si no acuerda, escala al decisor |
| P | Perform · Ejecuta | Implanta la decisión y se queda después con la operación | Identificado pronto, para validar que lo decidido es implantable de verdad |
| I | Input · Aporta | Proporciona datos y perspectiva operativa que enriquecen la propuesta | Se le consulta obligatoriamente, pero no tiene derecho de veto ni necesita estar de acuerdo |
| D | Decide · Decide | Elige la opción, compromete recursos y asume la responsabilidad | Una sola persona física. Nunca un comité paritario. Nunca dos nombres separados por una barra |
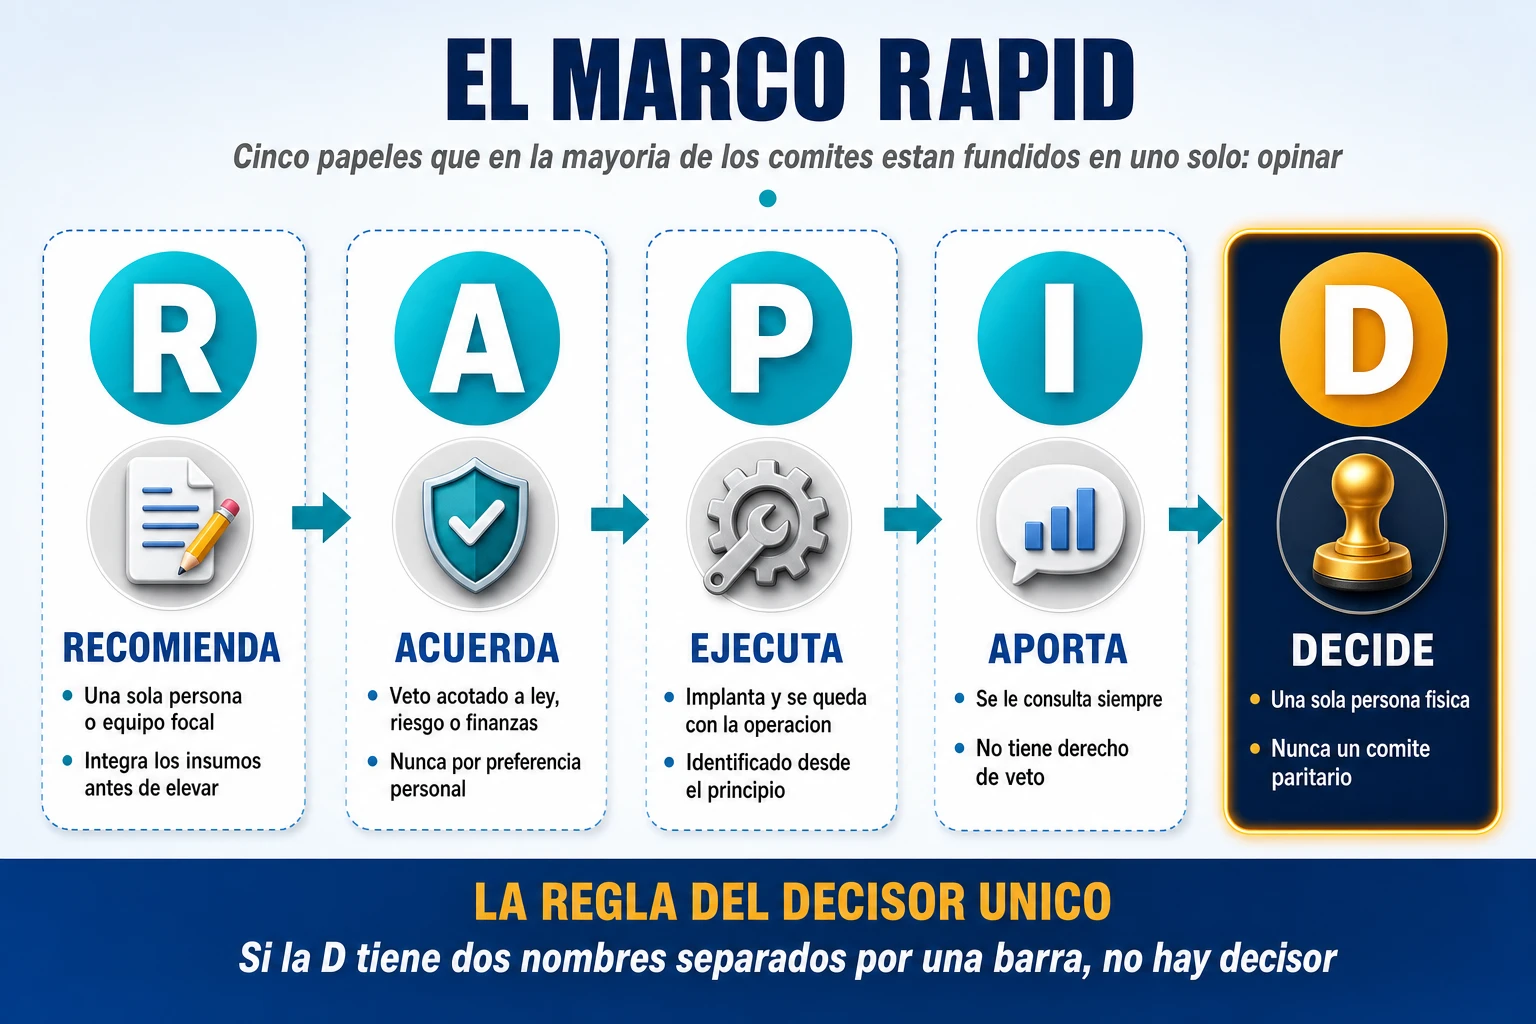
Hay tres detalles de aplicación que marcan la diferencia entre usar RAPID y dibujarlo en una diapositiva.
El primero: RAPID se asigna por decisión, no por persona. No es un organigrama alternativo. Es una lista de las decisiones grandes del proyecto, cada una con sus cinco papeles. Si antes del kickoff no existe esa lista, todavía no hay gobernanza, hay buenas intenciones.
| Decisión crítica | Quién decide (D) |
| Alcance y prioridades | Sponsor ejecutivo |
| Diseño del proceso TO-BE | Propietario del proceso |
| Arquitectura tecnológica y estándares | Dirección de sistemas |
| Excepciones al estándar y personalizaciones | Comité de dirección del programa |
| Cambio organizativo y de roles | Dirección de negocio |
| Ampliación de presupuesto | Comité de dirección del programa |
| Salida a producción | Negocio y sistemas conjuntamente, con criterios objetivos pactados |
| Reorientar o detener el proyecto | Sponsor y comité de dirección |
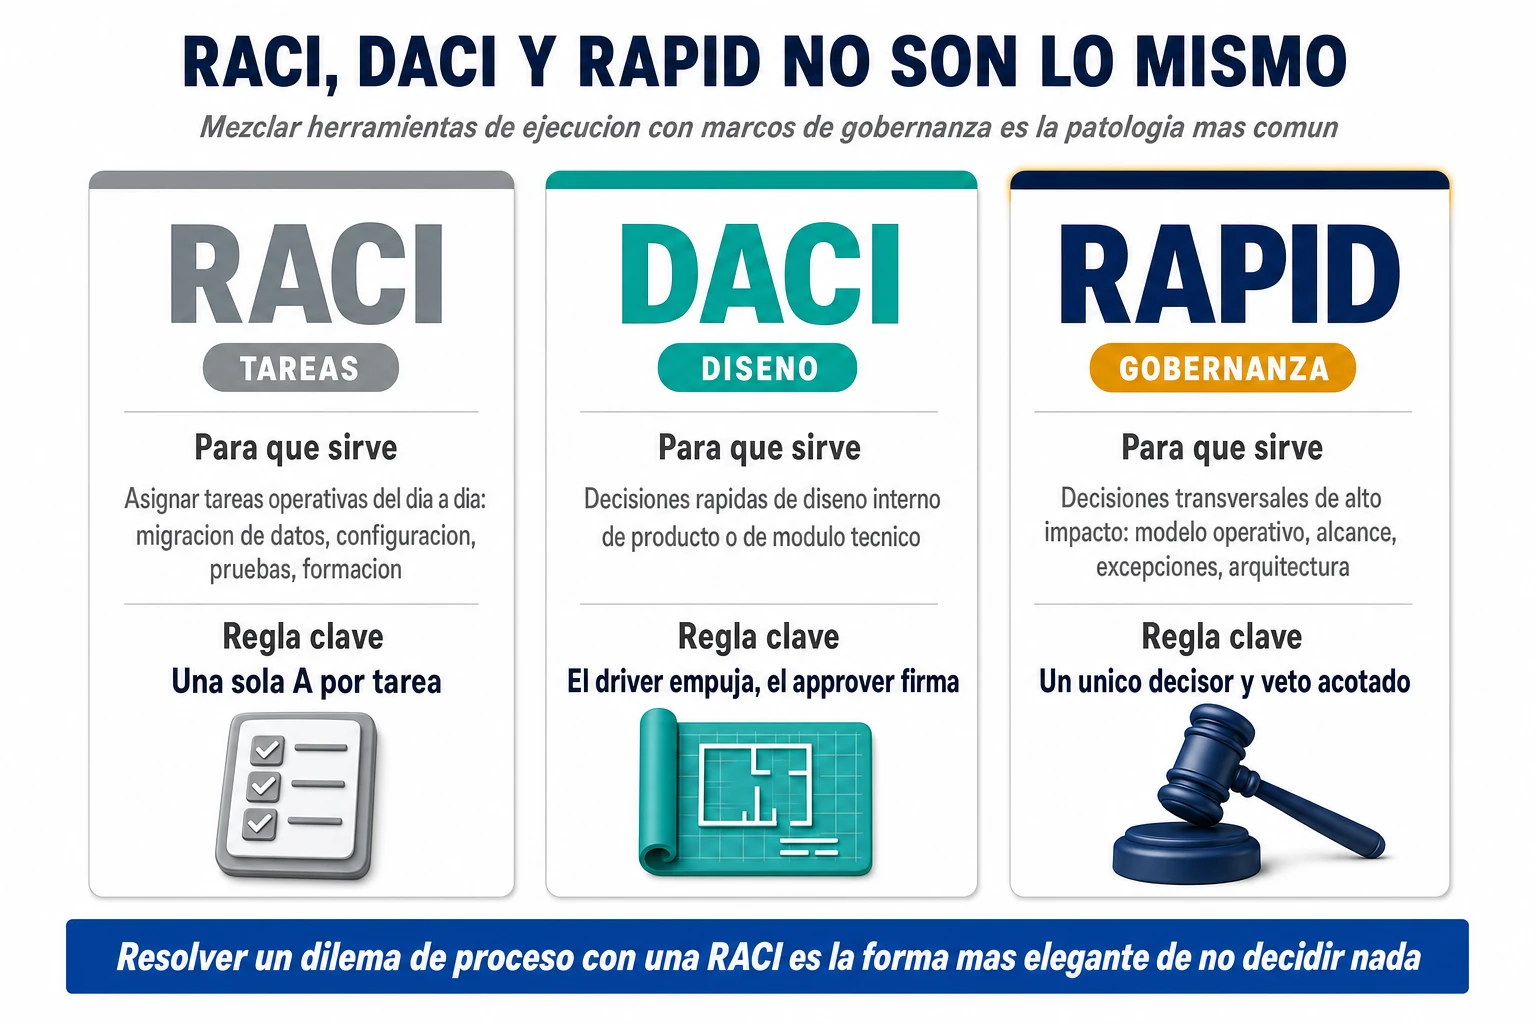
El segundo: no confundir RAPID con RACI ni con DACI. Mezclar herramientas de ejecución de trabajo con marcos de gobernanza es una patología habitual y produce comités donde nadie sabe si la «C» significa que le consultan o que puede vetar.
| Marco | Para qué sirve de verdad | Regla clave |
| RACI | Asignar tareas operativas y entregables del día a día: migración de datos, configuración, pruebas, formación | Una sola «A» por tarea. Si hay dos accountable, no hay ninguno |
| DACI | Decisiones rápidas de diseño interno de producto o de módulo técnico | El driver empuja la propuesta; el approver firma el entregable |
| RAPID | Decisiones transversales de alto impacto: modelo operativo, alcance, excepciones de proceso, arquitectura | Un único decisor y veto acotado por norma, no por preferencia |
El tercero: el SLA de decisión. Los derechos de decisión sin plazo se convierten en derechos de bloqueo. La regla que funciona es acotar a 48 o 72 horas el plazo en el que las áreas consultadas pueden emitir una objeción técnica, legal o de riesgo fundamentada; pasado ese plazo, se aplica el silencio positivo y el recomendador avanza sin represalias.
Ahora la letra pequeña, que casi nunca se cuenta. El silencio positivo solo es legítimo si se cumplen tres condiciones: que la propuesta haya llegado completa y con la información necesaria para evaluarla; que el plazo sea real y no caiga íntegro en agosto o en cierre de trimestre; y que el decisor asuma el coste si se equivoca. Sin esas tres condiciones, el SLA de 48 horas no es una regla de agilidad, es un mecanismo elegante para saltarse a la gente que sabe. Y funciona muy bien durante unos cuatro meses.
La deuda de decisión: el pasivo que no aparece en ningún informe
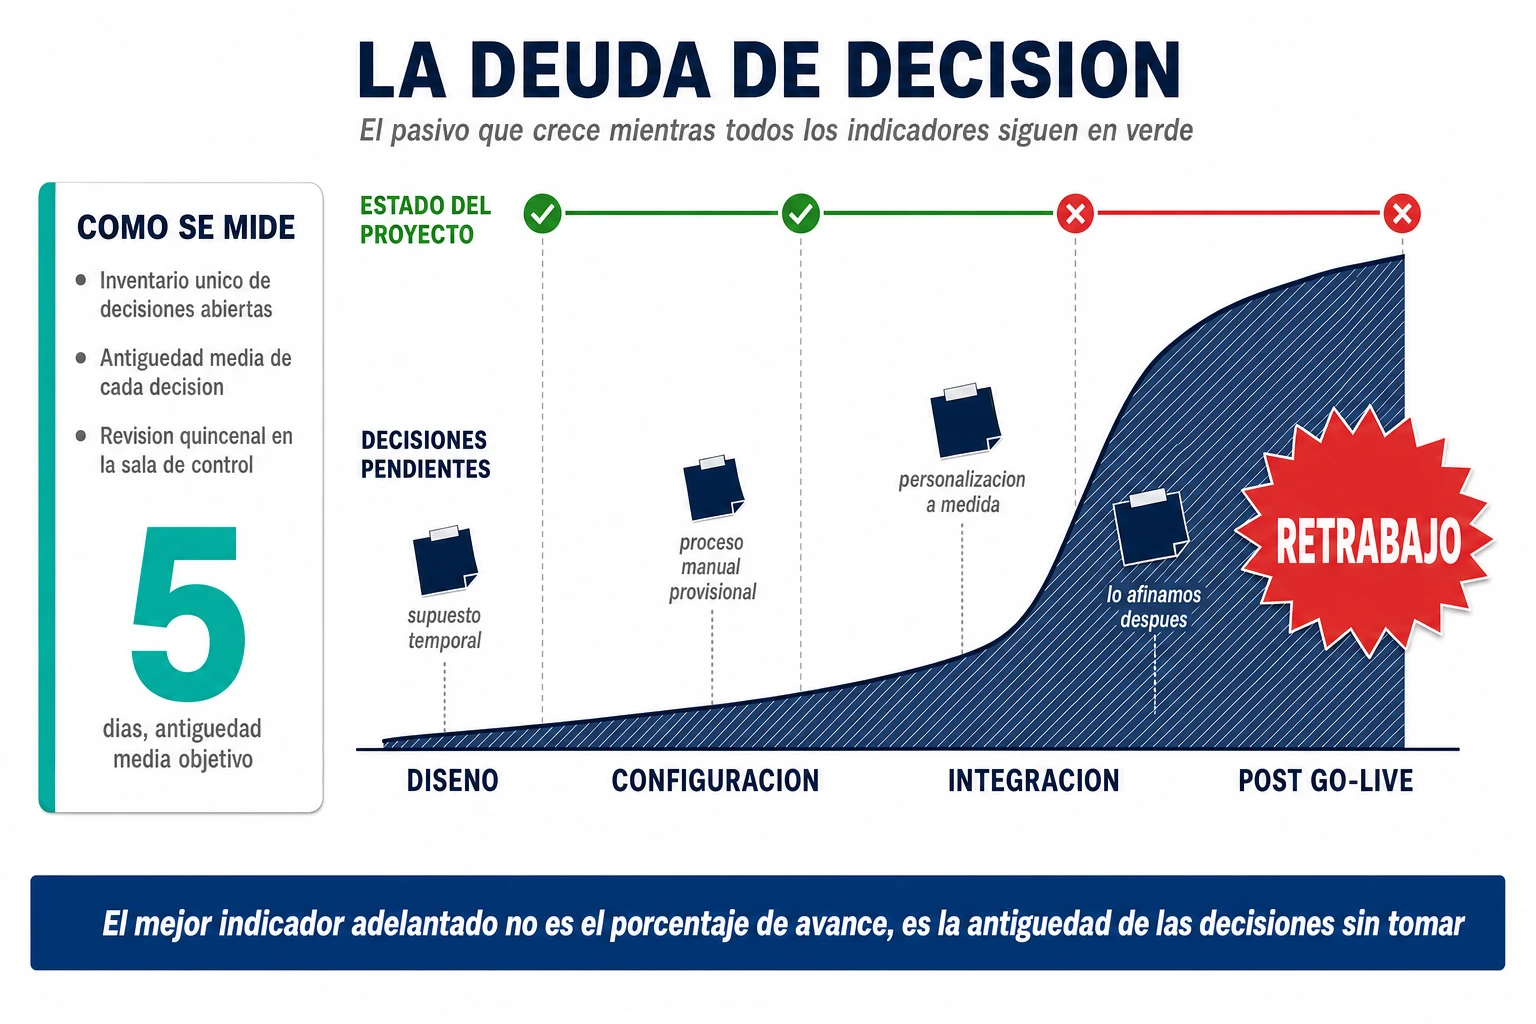
Mientras la oficina de proyecto vigila el presupuesto y el calendario, se acumula en paralelo un pasivo que nadie contabiliza: la deuda de decisión. Se genera cada vez que el proyecto pospone la resolución de un conflicto de negocio y lo sustituye por un parche: un supuesto temporal, un proceso manual provisional, una personalización a medida, un «esto lo afinamos después del arranque».
El parche tiene una propiedad perversa: mantiene los indicadores en verde. El hito se cumple, la fase se cierra, el semáforo del comité no se pone en ámbar. La factura llega toda junta y tarde, durante las pruebas de integración o después del go-live, en forma de retrabajo masivo y sobrecostes que ya no se pueden absorber.
El mejor indicador adelantado de un proyecto de transformación no es el porcentaje de avance. Es el inventario de decisiones pendientes y su antigüedad media.
Gestionarla es sorprendentemente barato. Se mantiene un inventario único de decisiones abiertas con cuatro campos —decisión, decisor asignado, fecha de compromiso, coste estimado del retraso— y se revisa quincenalmente en la sala de control. Un objetivo razonable para un programa sano es que la antigüedad media de las decisiones abiertas se mantenga por debajo de cinco días hábiles. Cuando ese número empieza a subir de forma sostenida, el proyecto ya ha empezado a fracasar, aunque el cronograma todavía no lo sepa.
Rediseñar antes de automatizar (y por qué con IA el error sale más caro)
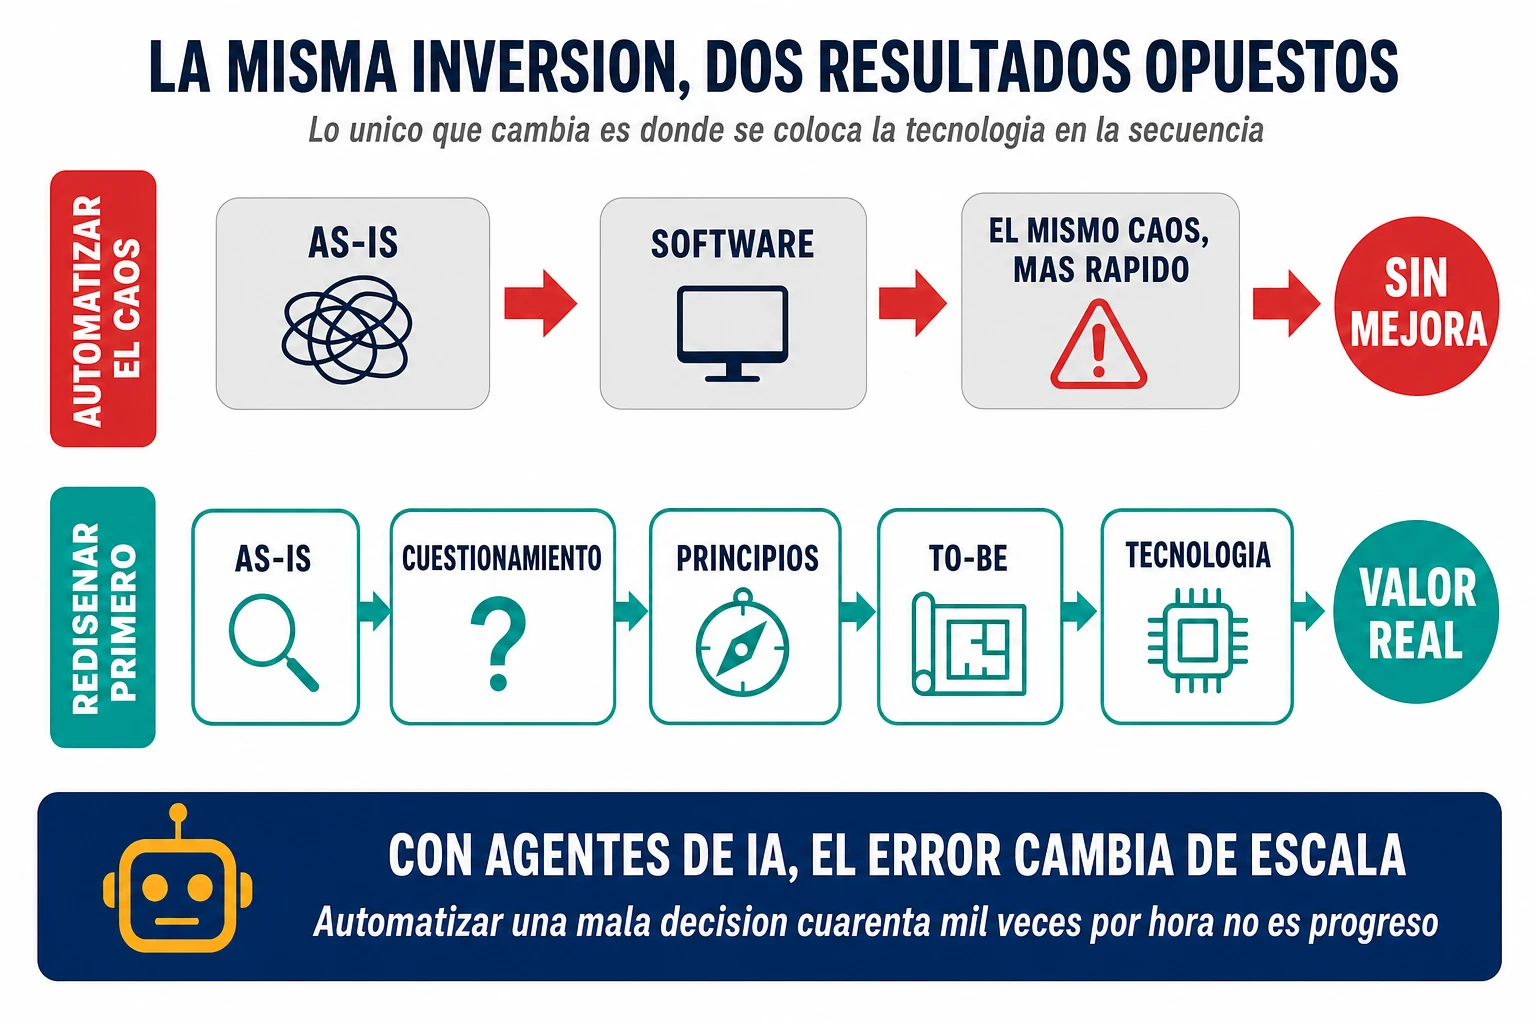
En 1990, Michael Hammer publicó en Harvard Business Review un artículo titulado «Reengineering Work: Don’t Automate, Obliterate». Su denuncia era que las empresas estaban usando la informática para hacer más deprisa procesos diseñados décadas antes, en lugar de preguntarse por qué existían esos procesos. Treinta y cinco años después el argumento sigue intacto, solo que ahora se ejecuta con otras siglas.
Thomas Davenport añadió en 1998 la otra mitad del problema en «Putting the Enterprise into the Enterprise System»: un sistema de gestión integrado no es simplemente software. Al integrar la información obliga a decidir hasta qué punto la empresa quiere estandarizarse y hasta qué punto quiere seguir siendo un conjunto de feudos con reglas propias. Es una decisión de negocio disfrazada de decisión técnica, y por eso se toma sistemáticamente en el foro equivocado.
El orden correcto es AS-IS → cuestionamiento → principios → TO-BE → tecnología. El orden habitual es AS-IS → software → automatización del AS-IS. La diferencia entre los dos no se ve en el mes tres; se ve en el mes veinte, cuando alguien pregunta por qué los indicadores no se han movido a pesar de que el sistema funciona perfectamente.
Las preguntas que hay que contestar antes de configurar nada son siempre las mismas seis:
- ¿Qué procesos queremos estandarizar de verdad, y en cuáles la variedad aporta valor?
- ¿Qué excepciones son necesarias y cuáles son vicios históricos de departamento?
- ¿Qué actividades pueden desaparecer directamente?
- ¿Qué decisiones pueden automatizarse y cuáles requieren criterio humano?
- ¿Qué pasos existen solo porque un sistema antiguo obligaba a ellos?
- ¿Qué controles protegen algo real y cuáles protegen la memoria de un incidente de hace doce años?
La regla de causalidad de Hammer: el proceso no puede ir por delante de la empresa
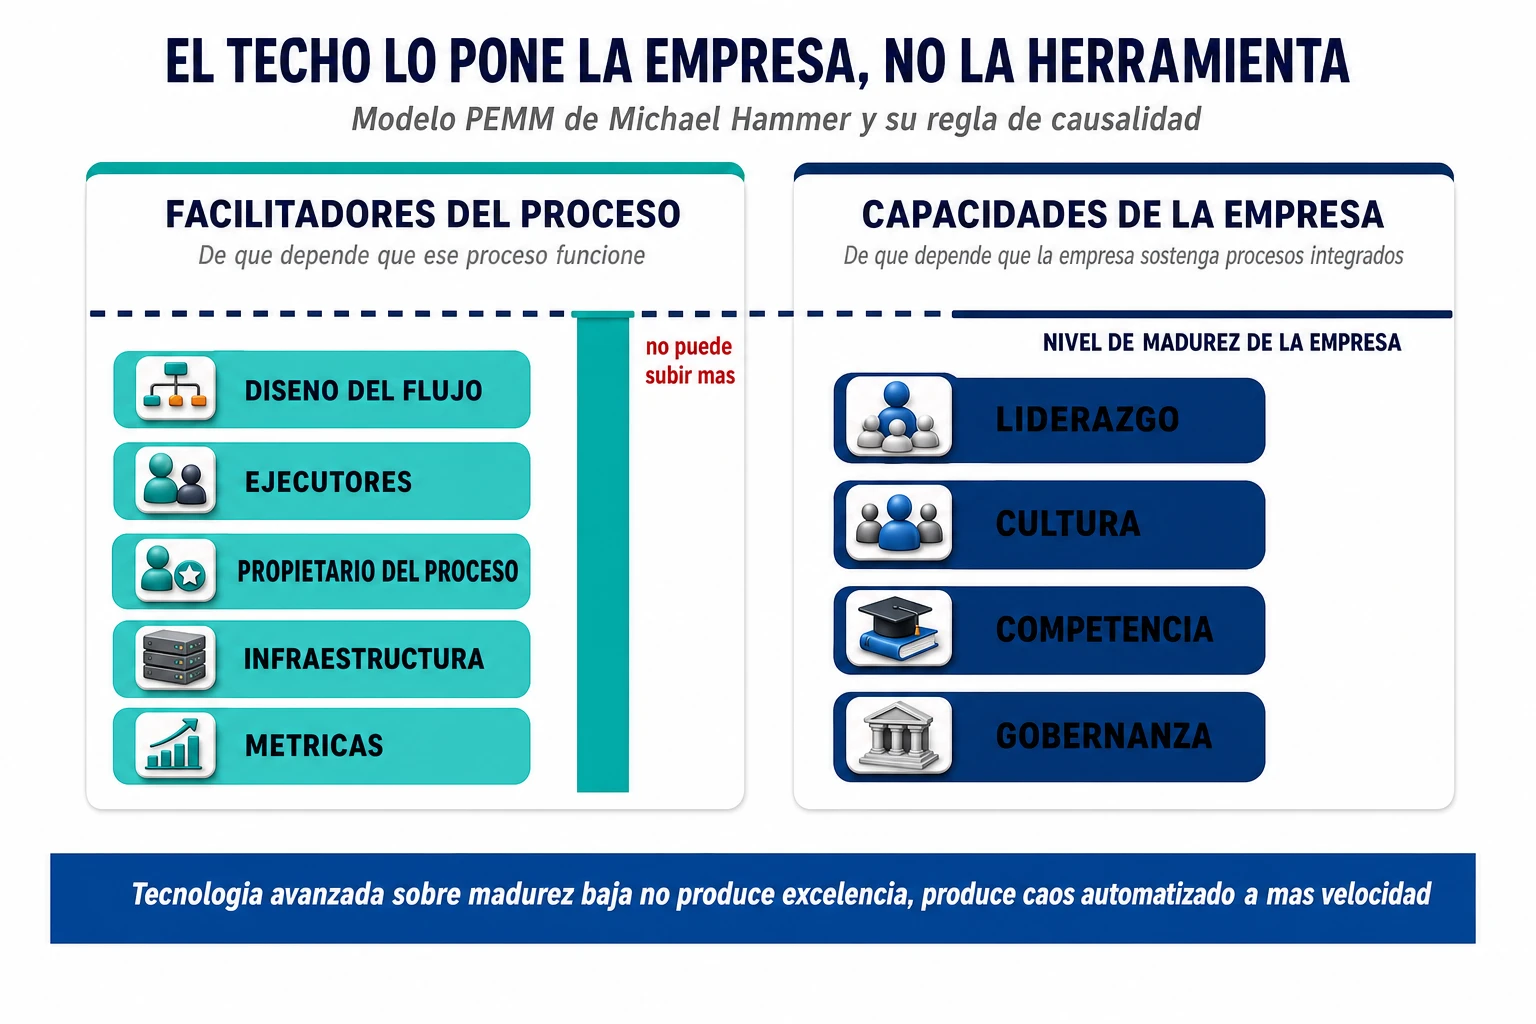
Hammer volvió sobre el tema en 2007 con el modelo PEMM (Process and Enterprise Maturity Model), que es la herramienta de diagnóstico previo más infrautilizada que conozco. Mide dos dimensiones distintas:
- Facilitadores del proceso: diseño del flujo, ejecutores, propietario del proceso, infraestructura de soporte y métricas. Determinan lo bien que puede funcionar ese proceso.
- Capacidades de la empresa: liderazgo, cultura, competencia interna y gobernanza. Determinan si la empresa es capaz de sostener procesos integrados en general.
Y de ahí sale la regla que debería estar colgada en la sala del comité: un proceso no puede sostener un nivel de madurez superior al que permiten las capacidades de la empresa. Si se instala tecnología avanzada sobre una organización con baja madurez de gobierno y cultura, no se obtiene un proceso excelente. Se obtiene el caos anterior, automatizado y circulando a mucha más velocidad.
Con IA agéntica, el error cambia de escala
Todo lo anterior se escribió pensando en ERP y en digitalización clásica. Con agentes de inteligencia artificial el argumento no cambia de naturaleza, cambia de magnitud, por tres razones concretas.
La primera es de volumen. Un proceso mal diseñado ejecutado por personas tiene un límite físico: el número de personas y las horas del día. Un agente no lo tiene. Automatizar una mala decisión cuarenta mil veces por hora no es progreso, es escalar el error. Y como cada ejecución individual es barata, nadie la audita.
La segunda es de opacidad. Un proceso manual malo deja rastro: la gente se queja, improvisa, monta una hoja de cálculo paralela. Un proceso automatizado malo es silencioso. Funciona, cumple su SLA, no genera tickets, y su daño solo aparece agregado tres trimestres después en un indicador de negocio que nadie había conectado con él.
La tercera es de irreversibilidad práctica. Una vez que un agente sostiene un proceso, ese proceso se congela: cualquier rediseño posterior implica rehacer la automatización, renegociar accesos, revalidar seguridad y volver a entrenar a la gente. El coste de cambiar de opinión sube de golpe. Por eso, con IA, el rediseño previo deja de ser una buena práctica y pasa a ser la única ventana razonable para hacerlo.
Hay una prueba de humildad que conviene pasar antes de automatizar cualquier proceso con agentes: si el proceso actual no se puede describir con precisión suficiente como para que un empleado nuevo lo ejecute sin preguntar, tampoco está listo para que lo ejecute un agente. Lo que suele faltar no es tecnología: es definición.
La curva: del monte de la ignorancia al valle de la desesperación
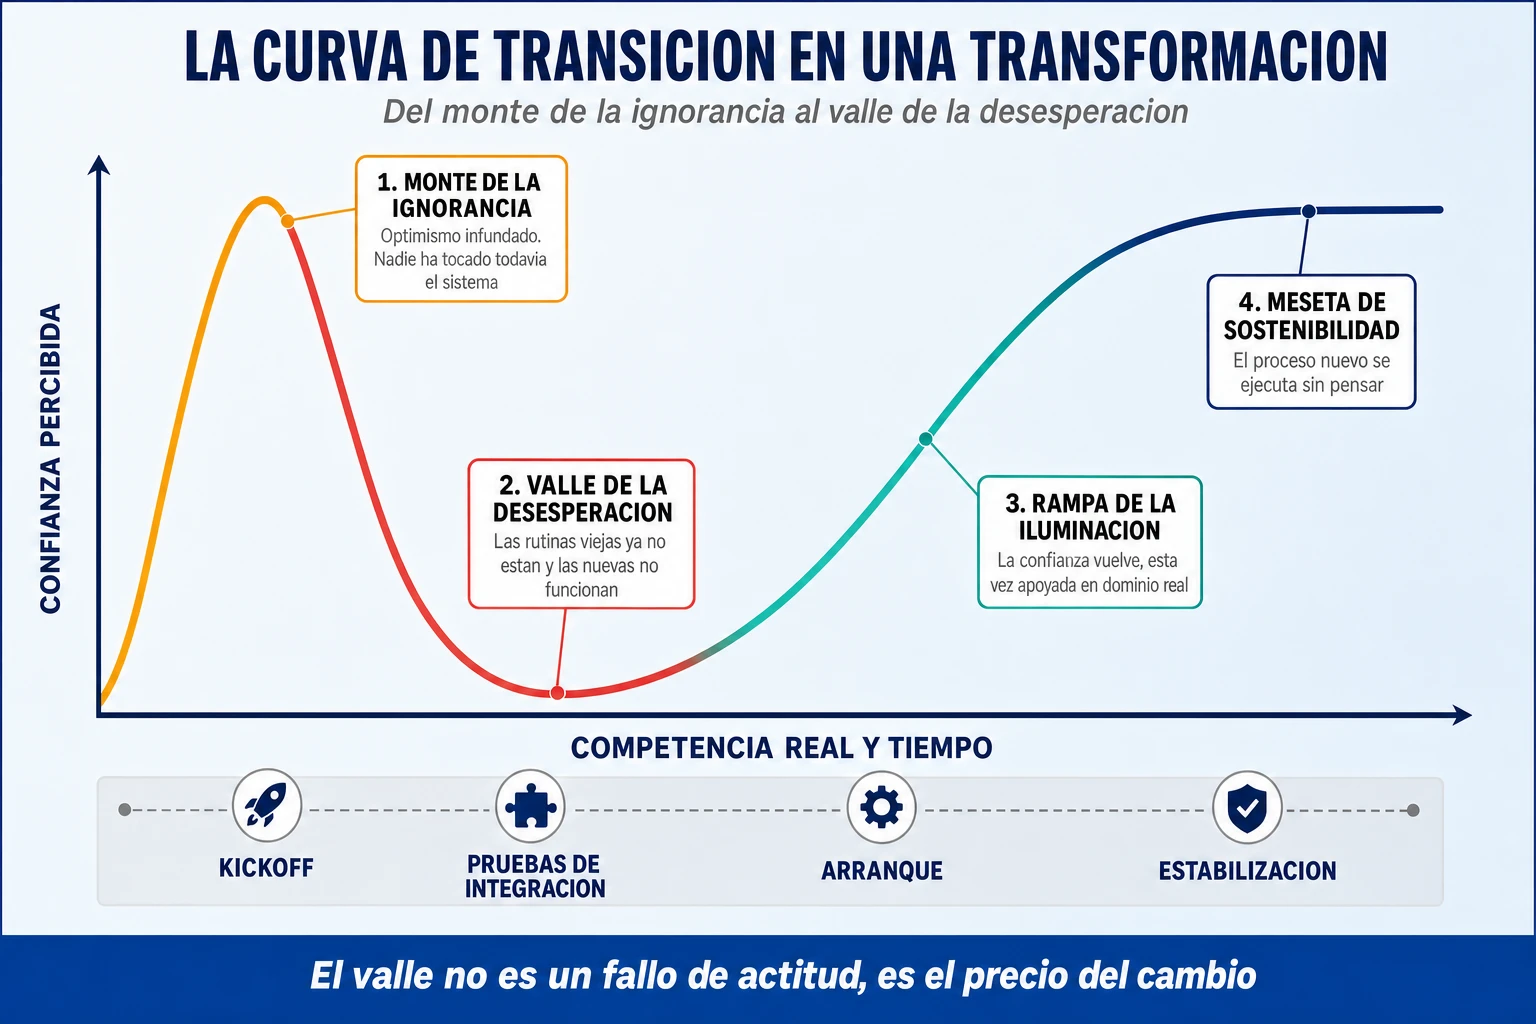
Hay un patrón que se repite con una regularidad casi cómica en todas las transformaciones. Las primeras semanas después del anuncio, el ambiente es excelente: la gente está ilusionada, los talleres funcionan, todo el mundo dice que ya era hora. Seis o siete meses después, cuando empiezan las pruebas de integración y la migración de datos, el mismo equipo está convencido de que el proyecto es un desastre, de que el sistema nuevo es peor que el viejo y de que nadie les preguntó. Y no ha cambiado nada en el proyecto. Lo que ha cambiado es lo que saben.
Ese recorrido tiene nombre y tiene origen académico. En 1999, Justin Kruger y David Dunning publicaron en el Journal of Personality and Social Psychology un artículo titulado «Unskilled and Unaware of It: How Difficulties in Recognizing One’s Own Incompetence Lead to Inflated Self-Assessments». Su hallazgo, resumido por Alberto Soler en su análisis del efecto, es que las personas menos competentes en un área tienden a sobreestimar sus capacidades. Y la explicación es elegante: las habilidades que hacen falta para ser competente en algo son las mismas que hacen falta para juzgar esa competencia. Quien no sabe, tampoco sabe lo que no sabe. Soler lo cierra con la frase de Bertrand Russell: el problema de la humanidad es que los estúpidos están seguros de todo y los inteligentes están llenos de dudas.
Antes de usarla: qué dice el estudio original y qué no
Conviene ser honesto con esto, porque se usa mal constantemente. La curva con el «monte de la ignorancia» y el «valle de la desesperación» que aparece en todas las presentaciones corporativas no está en el artículo de 1999. Es una popularización posterior, construida a partir de la idea original y difundida en internet hasta que la repetición la convirtió en cita. Kruger y Dunning midieron la brecha entre desempeño real y autoevaluación en cuartiles de participantes; no dibujaron ningún viaje emocional por fases.
Y hay más. El propio efecto ha recibido críticas estadísticas serias —Nuhfer y colaboradores (2016 y 2017), Gignac y Zajenkowski (2020)— que muestran que buena parte del patrón característico puede emerger de la regresión a la media y del sesgo general de creerse por encima del promedio. Incluso las críticas más duras, eso sí, conceden que la precisión con la que alguien se autoevalúa correlaciona con su competencia real: el efecto es más pequeño que el meme, pero la señal existe.
En una transformación, la curva no sirve como teoría psicológica. Sirve como modelo operativo del estado de ánimo de los equipos: predice cuándo va a bajar la moral, por qué, y qué intervención toca en cada momento. Con eso basta, y hay que usarla sabiendo exactamente eso.
Dicho de otra forma: la curva funciona porque se solapa con dos cosas que sí están bien documentadas en contexto organizativo. Una es la curva del cambio derivada de los trabajos de Kübler-Ross y Streich, que describe el duelo por lo que se pierde. La otra es la zona neutra de William Bridges: ese tramo en el que las rutinas viejas ya se han desmontado y las nuevas todavía no funcionan, y donde la productividad cae por razones estructurales, no por falta de ganas.
Fase 1 · El monte de la ignorancia (optimismo infundado)
Qué se observa. Justo después del kickoff y de la presentación de la visión, la confianza del equipo alcanza su máximo histórico. Nadie ha tocado todavía el sistema, nadie ha visto la calidad real de los datos, nadie ha intentado mapear una excepción de verdad. Las frases características son «esto nos va a simplificar mucho el trabajo» y «con esto se acaban los Excel». Se estiman plazos alegres, se aceptan alcances imposibles y se firma casi cualquier cosa.
Por qué ocurre. Porque la ignorancia sobre el esfuerzo necesario produce una sensación de control. No es entusiasmo tonto: es la consecuencia lógica de no tener aún la información que permitiría matizarlo.
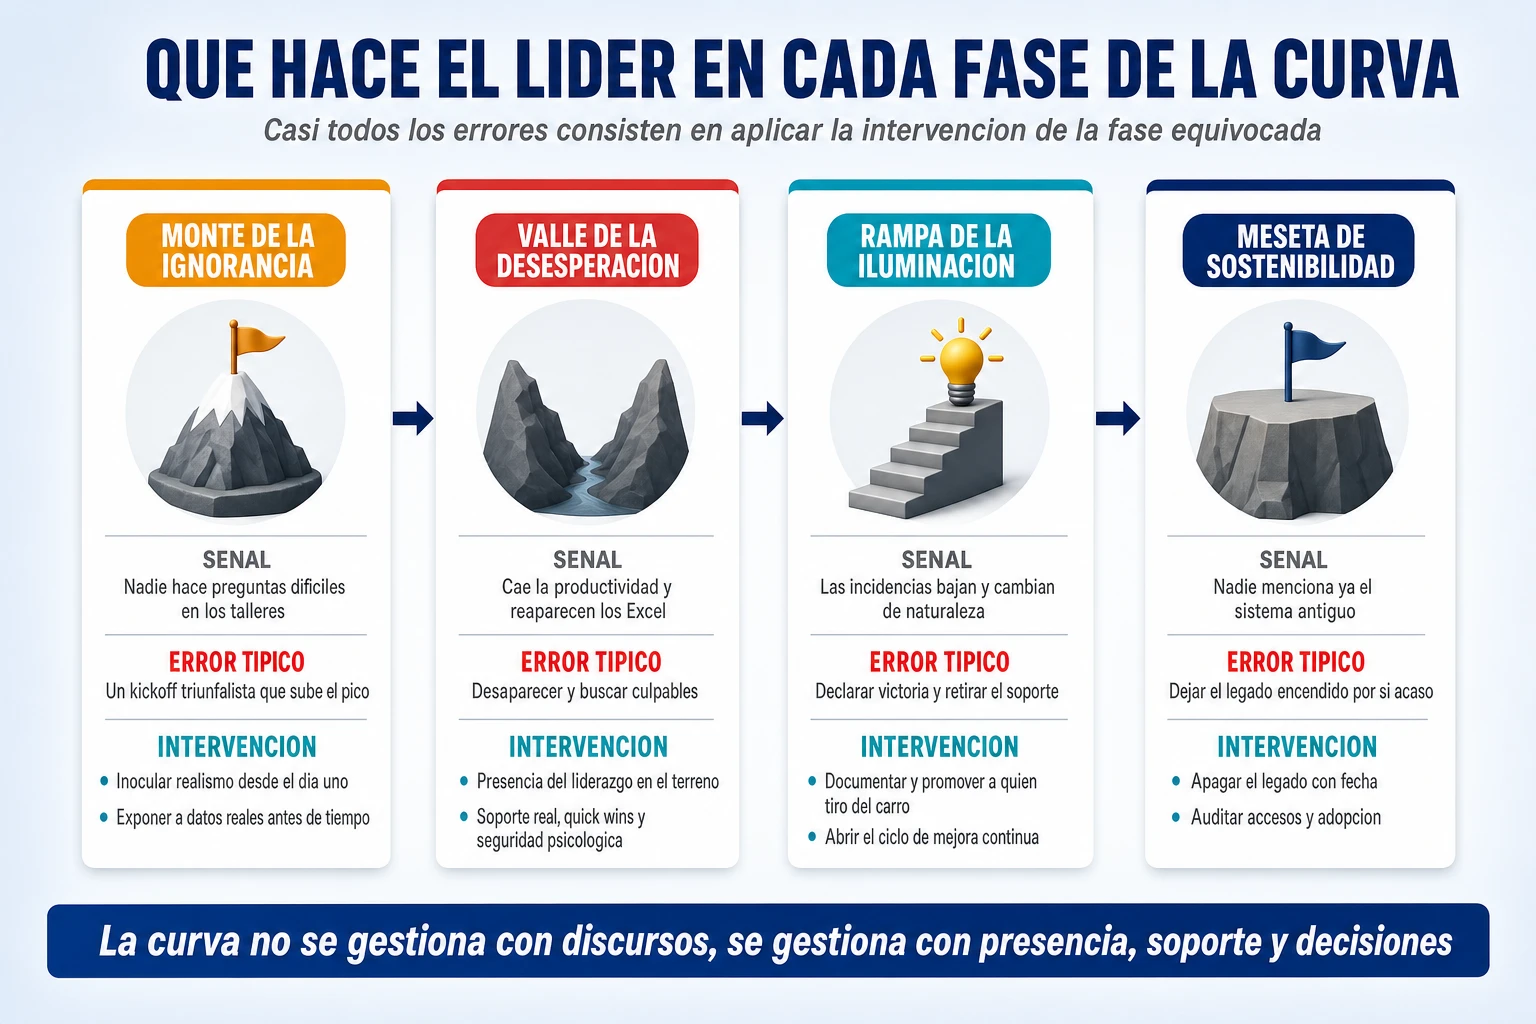
El error típico del líder. Amplificarlo. Un kickoff triunfalista, con promesas de simplificación inmediata y un vídeo corporativo con gente sonriendo, sube el pico y, exactamente en la misma proporción, profundiza el valle posterior. Cuanto más alto se promete, más duro cae. El segundo error es confundir ese pico con adhesión real: no lo es, es desconocimiento con buena cara.
Qué hacer. Inocular realismo desde el día uno, que es justo lo contrario de lo que pide el departamento de comunicación. Decir explícitamente que habrá meses difíciles, que al principio costará más trabajo hacer lo mismo y que eso es normal y está previsto. Y sobre todo, adelantar el choque con la realidad: exponer a los usuarios a entornos de prueba con datos reales —sucios, incompletos, con las excepciones de verdad— tres o cuatro semanas antes de lo que pide el plan. El objetivo no es desmoralizar a nadie: es que el descubrimiento de la complejidad ocurra cuando todavía se puede cambiar el diseño.
Fase 2 · El valle de la desesperación (la zona neutra)
Qué se observa. Empiezan las pruebas de integración, la migración de datos y el corte operativo. La realidad colisiona con las expectativas. Las rutinas históricas ya se han desmontado, pero las competencias nuevas todavía no están consolidadas: la gente sabe lo justo para darse cuenta de todo lo que no sabe. La productividad cae —de verdad, no en la percepción—, los errores aumentan, aparecen la frustración, el síndrome del impostor en profesionales que llevaban quince años siendo los mejores de su área, y el deseo casi físico de volver a la hoja de cálculo que funcionaba.
Por qué ocurre. Porque es estructural. Desmontar rutinas de quince años y sustituirlas por otras no puede hacerse sin un tramo en el que no se domina ninguna de las dos. No es un fallo de actitud ni de formación: es el precio del cambio, y está en el presupuesto aunque nadie lo haya escrito.
El error típico del líder. Desaparecer. Y ocurre casi siempre, porque en el valle el proyecto «va mal», las reuniones son incómodas y nadie quiere salir en esa foto. Justo cuando la organización más necesita ver a la dirección en el terreno, la dirección se refugia en el comité. El segundo error es responder al valle con motivación: discursos, camisetas, sesiones de engagement. La gente en el valle no tiene un problema de ánimo, tiene un problema de competencia y de incidencias sin resolver. El tercero, el más caro, es buscar culpables: en cuanto alguien es señalado por un error, el resto deja de reportar los suyos.
Qué hacer. Cuatro cosas concretas, en este orden. Primero, presencia física del liderazgo en la operación, no en la sala de proyecto: en el valle, la señal más potente que puede emitir un directivo es estar ahí. Segundo, capacidad real de soporte: superusuarios liberados, entornos de práctica y un compromiso explícito de resolución rápida de incidencias, porque cada incidencia sin resolver más de 48 horas se convierte en una anécdota que circula por toda la empresa. Tercero, victorias tempranas planificadas a noventa días: mejoras pequeñas, visibles y atribuibles al nuevo modelo, celebradas en público. Y cuarto, seguridad psicológica, que merece párrafo aparte.
Fase 3 · La rampa de la iluminación (aprendizaje real)
Qué se observa. La confianza empieza a subir otra vez, pero esta vez apoyada en dominio real. La gente encuentra atajos, empieza a enseñar a otros, propone mejoras del proceso nuevo en lugar de pedir el antiguo. Las incidencias bajan en número y suben en calidad: ya no son «esto no funciona», son «esto funciona pero debería hacerlo de otra manera».
El error típico del líder. Declarar victoria y retirar el soporte. La rampa es frágil: si en ese momento se disuelve el equipo de superusuarios, se cierra el canal de incidencias o se devuelve a los usuarios clave al 100% de su carga operativa, la organización se desliza otra vez hacia el valle y la segunda caída es mucho peor, porque ya no hay crédito.
Qué hacer. Convertir el aprendizaje en activo: documentar lo que la gente ha descubierto, institucionalizar los atajos buenos, promover visiblemente a quienes han tirado del carro. Y empezar aquí —no después— el ciclo de mejora continua, porque el mejor momento para rediseñar un proceso es cuando quienes lo ejecutan por fin lo dominan.
Fase 4 · La meseta de sostenibilidad (institucionalización)
Qué se observa. El proceso nuevo se ejecuta sin pensar. El desempeño se estabiliza por encima del nivel anterior y los beneficios financieros empiezan a aparecer en la cuenta de resultados, que es el único sitio donde cuentan.
El error típico del líder. Dejar el sistema antiguo encendido «por si acaso» y tolerar las hojas de cálculo paralelas. Mientras exista una vía alternativa, una parte de la organización seguirá usándola, los datos se dividirán en dos verdades y la transformación no habrá terminado: habrá creado un segundo proceso. El apagado del legado no es una tarea técnica de cierre, es la última decisión de gobierno del proyecto, y necesita fecha, responsable y auditoría de accesos.
| Fase | Momento del proyecto | Señal de que estás ahí | Intervención del líder |
| Monte de la ignorancia | Kickoff y diseño inicial | Nadie hace preguntas difíciles en los talleres | Inocular realismo · exponer a datos reales antes de tiempo |
| Valle de la desesperación | Integración, migración, UAT y arranque | Cae la productividad y reaparecen los Excel | Presencia en el terreno · soporte real · quick wins · seguridad psicológica |
| Rampa de la iluminación | Estabilización | Las incidencias bajan y cambian de naturaleza | No retirar el soporte · documentar y promover · abrir mejora continua |
| Meseta de sostenibilidad | Operación normalizada | Nadie menciona ya el sistema antiguo | Apagar el legado con fecha · auditar adopción · cerrar la oficina de transformación |
Cómo distinguir un valle normal de un proyecto roto
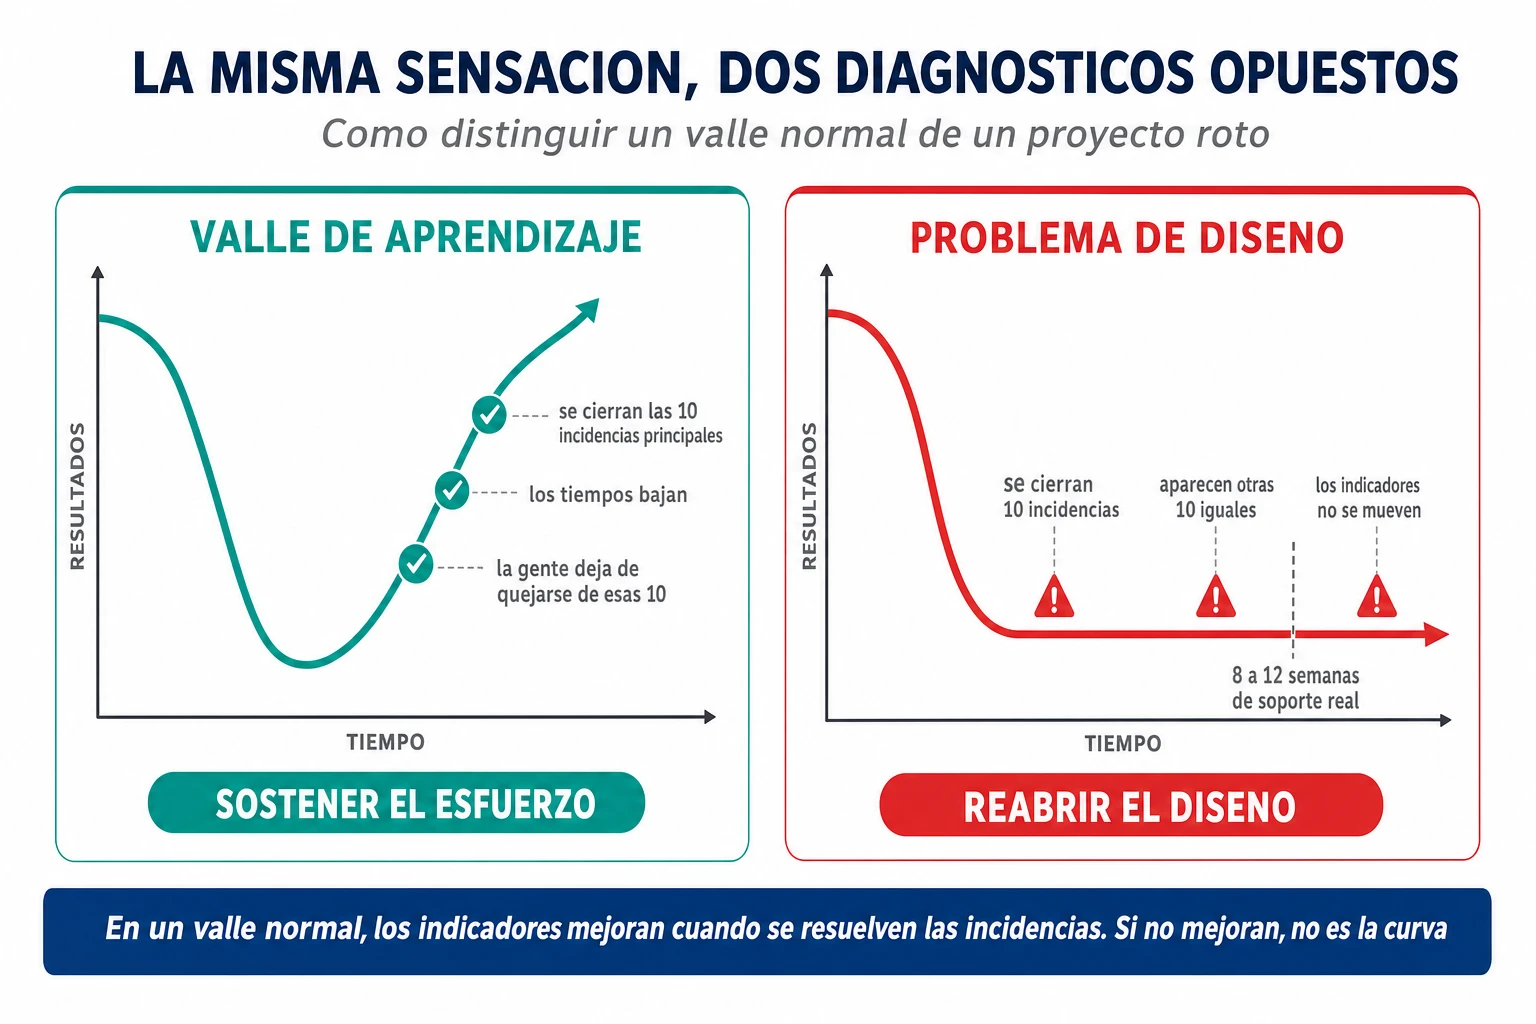
Aquí está el matiz que casi nunca se cuenta y que separa a un buen líder de transformación de uno que solo repite la diapositiva de la curva. La curva se usa muchas veces como coartada. Cuando todo va mal, es enormemente cómodo decir «esto es el valle de la desesperación, es normal, hay que aguantar». Y a veces es verdad. Y a veces el proyecto está efectivamente roto y la curva sirve para posponer seis meses la conversación que tocaba tener hoy.
La prueba para distinguirlos es de comportamiento, no de ánimo: en un valle normal, los indicadores mejoran cuando se resuelven las incidencias. Si el equipo de soporte cierra los diez problemas principales y a las dos semanas los tiempos bajan, los errores caen y la gente deja de quejarse de esos diez, usted tiene una curva de aprendizaje y lo que necesita es sostener el esfuerzo. Si se resuelven los diez problemas principales y aparecen otros diez de la misma naturaleza, y luego otros diez, y los indicadores no se mueven después de ocho a doce semanas de soporte real, entonces no tiene un problema de curva: tiene un problema de diseño, y ninguna cantidad de acompañamiento emocional lo va a arreglar.
Hay un segundo fenómeno que conviene anticipar: la curva no se recorre a la misma velocidad en todos los niveles. La dirección sale del valle mucho antes, porque no ejecuta el proceso nuevo todos los días; cuando en el comité ya se habla de «la fase de consolidación», en la operación todavía se está en el punto más bajo. Ese desfase explica una buena parte de los conflictos de los meses ocho a doce, y se corrige de una sola manera: obligando a que el comité vea los indicadores de la operación —incidencias, tiempos, reintentos— y no solo los del proyecto.
La palanca que acorta el valle: seguridad psicológica
Amy Edmondson, de Harvard, lleva desde finales de los noventa documentando un fenómeno contraintuitivo: los equipos que reportan más errores no son los que más errores cometen, sino los que tienen suficiente seguridad para admitirlos. En una transformación esto tiene una consecuencia directa y muy práctica.
Durante el rediseño y las pruebas, quienes detectan primero las incoherencias de datos y los fallos de proceso son los operativos, no los consultores. Si la cultura penaliza el error o incomoda al que levanta la mano, esa información no sube: se guarda, se parchea localmente y aparece toda junta el día del arranque, cuando ya cuesta veinte veces más. Un proyecto donde las incidencias reportadas bajan justo antes del go-live no es un proyecto que va bien. Es un proyecto donde la gente ha dejado de avisar.
Prefiero mil veces descubrir hoy un error grave de datos durante las pruebas que tener una sombra de duda el día del lanzamiento. Aquí no se sanciona a nadie por levantar la mano. Se premia.
Que eso sea verdad y no un cartel depende de una sola cosa: de lo que ocurre la primera vez que alguien señala un fallo que deja mal a un directivo. Esa escena la mira toda la organización y fija el comportamiento de los doce meses siguientes. Si la persona sale reconocida en público, el canal se abre. Si sale escarmentada, ya puede montar usted todas las encuestas anónimas que quiera.
La versión operativa de esto es sencilla: agradecer públicamente y por nombre a quien reporta un fallo relevante antes de producción; incluir «errores detectados en pruebas» como indicador positivo del cuadro de mando y no como incidencia negativa; y hacer un análisis pre-mortem un mes antes del arranque —reunir al equipo y preguntar «si esto fracasara estrepitosamente el primer día, ¿cuáles habrían sido las causas?»—, porque formular el fracaso como hipótesis permite decir en voz alta cosas que nadie se atreve a plantear como crítica.
El rol del líder: se mide en decisiones, no en discursos
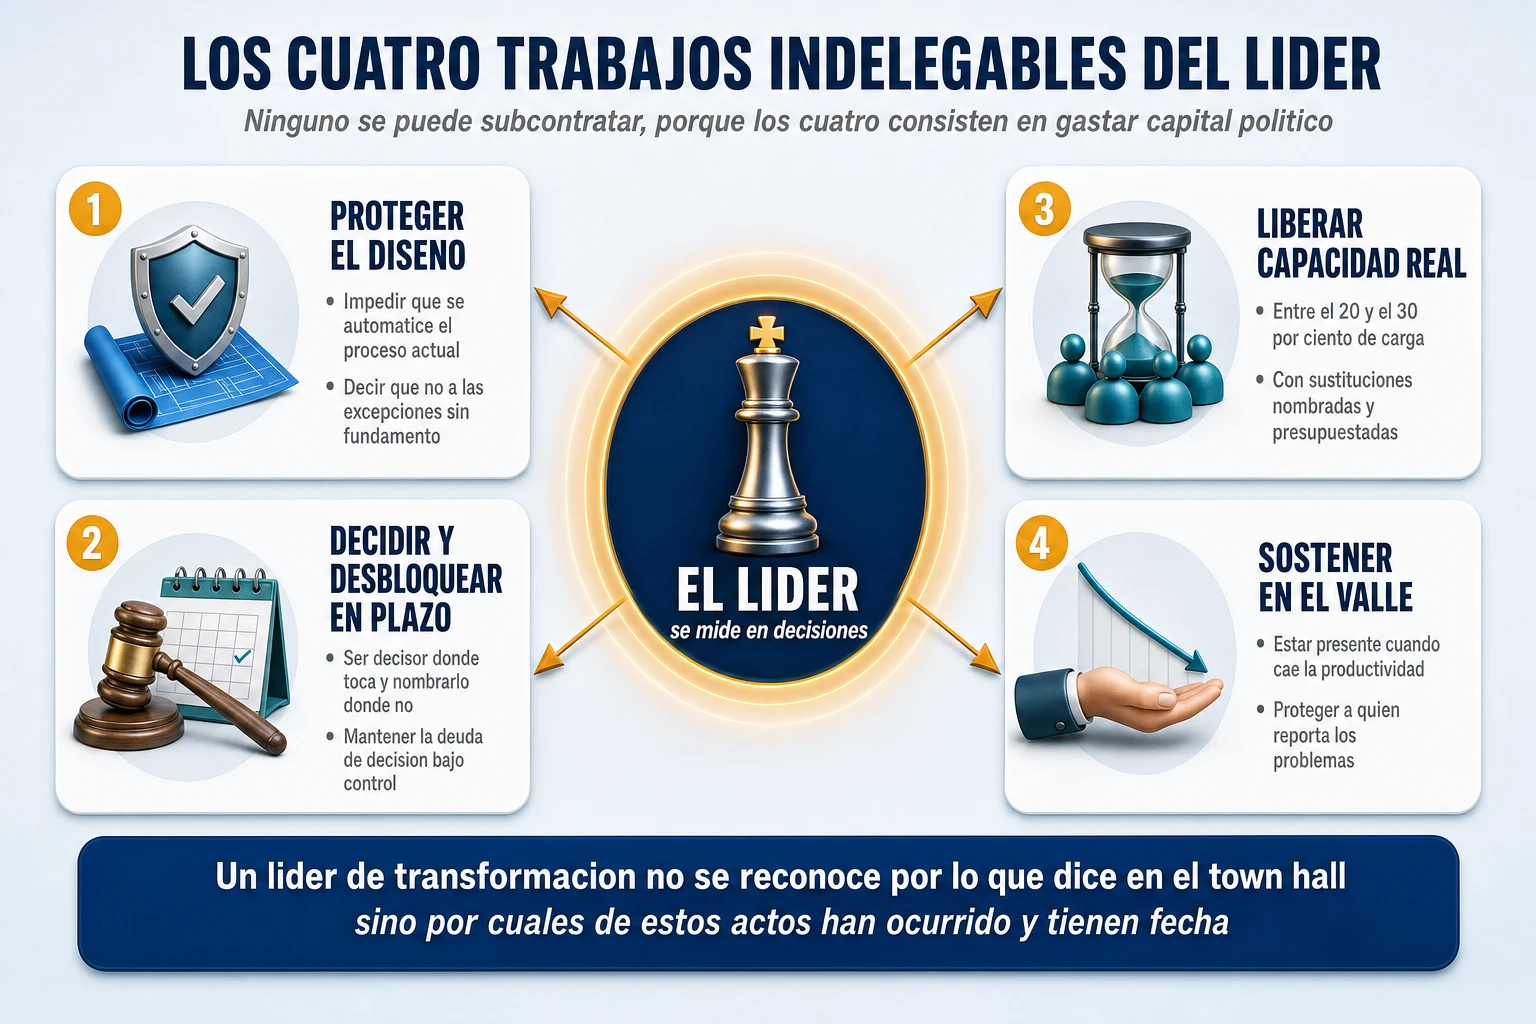
El papel del líder de una transformación se describe habitualmente con verbos que no comprometen a nada: inspirar, alinear, acompañar, impulsar. Conviene sustituirlos por una lista de trabajos concretos. Son cuatro y no se pueden delegar, porque los cuatro consisten en gastar capital político que solo tiene él.
- Proteger el diseño. Impedir que se automatice el proceso actual, que cada área imponga sus excepciones y que la personalización devore el estándar. Es decirle que no, a la cara, a gente con mucho poder y buenos argumentos.
- Decidir y desbloquear en plazo. Ser el decisor donde le toca serlo, nombrar decisores donde no, y mantener la deuda de decisión bajo control. Ningún otro rol de la empresa puede hacer esto.
- Liberar capacidad real. Conseguir que los mejores profesionales dediquen tiempo de verdad al proyecto, con la carga operativa formalmente reducida y sustituciones nombradas. Esto cuesta dinero y por eso casi nunca se hace.
- Sostener a la organización en el valle. Estar presente cuando la productividad cae, proteger a quien reporta problemas y evitar que la empresa vuelva al sistema antiguo por la puerta de atrás.
Un patrocinador activo, no ceremonial
La investigación de Prosci lleva años situando el patrocinio activo y visible entre los factores más correlacionados con el éxito de un cambio. Y «activo» significa algo muy distinto de lo que suele ocurrir: no es presentar el kickoff y volver para la foto del arranque. Es decidir, desbloquear, proteger recursos, comunicar, alinear a otros directivos y gestionar resistencias durante todo el proyecto.
Por eso la pregunta al elegirlo no es si está motivado. Es si reúne las cuatro condiciones a la vez: poder, tiempo, interés y credibilidad. Un patrocinador con poder pero sin agenda es casi tan inútil como uno muy entusiasta sin autoridad. Y hay un tipo especialmente peligroso: el que tiene poder, tiempo e interés pero no credibilidad operativa, porque cada vez que habla en una planta o en un centro de servicio, refuerza la sensación de que esto lo ha decidido gente que no sabe cómo se trabaja aquí.
Los diez actos que demuestran que hay un líder de verdad
Un líder de transformación no se reconoce por lo que dice en el town hall, sino por si estas diez cosas han ocurrido o no. Son verificables, tienen fecha y dejan rastro documental.
- Ha nombrado propietarios de proceso con autoridad de extremo a extremo, por encima de las fronteras departamentales, y no meros coordinadores.
- Ha publicado la lista de decisiones críticas con su decisor único, y la ha hecho firmar por el comité.
- Ha modificado temporalmente los objetivos y los bonus de los jefes de área para que el éxito del proyecto compute en su evaluación.
- Ha liberado formalmente entre el 20% y el 30% de la carga de los usuarios clave, con las sustituciones cubiertas y presupuestadas.
- Ha montado una oficina de transformación orientada a capturar valor económico y adopción real, no a reportar hitos y desviaciones presupuestarias.
- Ha instaurado el SLA de decisión y revisa quincenalmente el inventario de decisiones pendientes.
- Ha desplegado una red de embajadores reconocidos por sus compañeros, no elegidos por disponibilidad.
- Ha agradecido públicamente y por nombre a alguien que reportó un fallo incómodo.
- Ha ejecutado un pre-mortem un mes antes del arranque y ha neutralizado las tres causas más probables.
- Ha fijado la fecha de apagado del sistema antiguo y ha aceptado que se auditen los accesos residuales.
Si de esos diez actos han ocurrido menos de seis, la transformación tiene un patrocinador nominal. Lo demás es cuestión de tiempo.
Qué hacer con los mandos intermedios
Los supervisores y jefes de área son quienes tienen que traducir una estrategia abstracta en comportamientos concretos de lunes por la mañana, y casi nunca se les prepara para ello. Prosci resume ese trabajo en cinco funciones —el modelo CLARC—: comunicador del mensaje personalizado para su equipo, enlace que devuelve al proyecto la fricción real del terreno, defensor visible del cambio, gestor de resistencias uno a uno y entrenador de su gente. Enumerarlas no sirve de nada si antes no se ha resuelto su conflicto de incentivos; con el conflicto resuelto, son la palanca más potente que tiene el proyecto.
Y hay un diagnóstico de resistencia que evita muchos errores caros. Ante un mando que frena, hay que identificar la causa antes de intervenir:
| Causa real | Cómo suena | Qué funciona | Qué lo empeora |
| No sabe (falta de comprensión) | «No entiendo qué gano yo con esto» | Explicación concreta del impacto en su área y en sus números | Repetir el mensaje corporativo más alto |
| No puede (falta de capacidad) | «Con la carga que tengo, es imposible» | Liberar carga, dar herramientas, ajustar plazos | Tratarlo como falta de compromiso |
| No quiere (falta de incentivo) | «Muy interesante» y después nada | Cambiar objetivos, evaluación y bonus. Y si no cambia, cambiar a la persona | Más comunicación y más talleres |
Confundir un «no puede» con un «no quiere» es la forma más habitual de perder a un buen gestor. Confundir un «no quiere» con un «no sabe» es la forma más habitual de perder seis meses.
Lo que un líder de transformación no debe hacer nunca
- Prometer que será fácil. Es la única promesa que la realidad va a desmentir con absoluta seguridad, y en una fecha conocida.
- Delegar la transformación en el área de sistemas. Si el proyecto cambia procesos y organización, el área de sistemas no tiene autoridad para decidir lo que hay que decidir, y se le estará pidiendo que arbitre conflictos de negocio sin mandato.
- Desaparecer en el valle y reaparecer para la foto de la estabilización.
- Premiar al que oculta problemas porque «su área va bien». Suele ser el área que más va a romper en producción.
- Aceptar excepciones sin decisor. Cada excepción aprobada informalmente en un pasillo es deuda de decisión con intereses.
- Dejar el legado encendido sin fecha de apagado. Si existe una alternativa, se usará.
Los seis mensajes que el líder tiene que dar, y cuándo
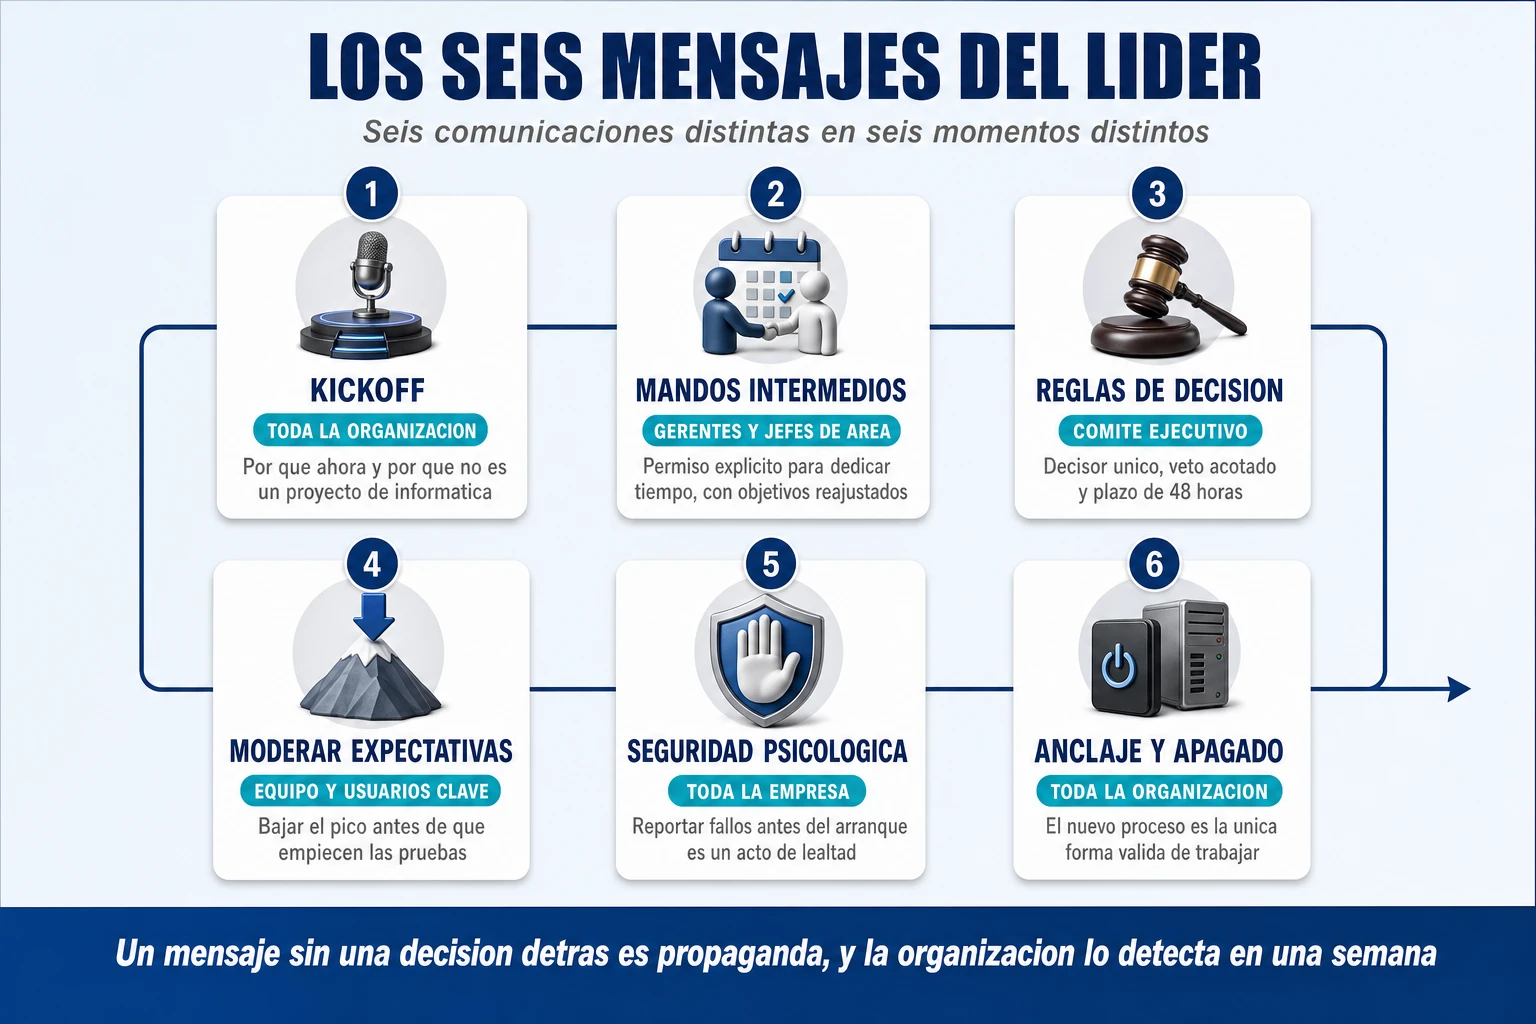
Una transformación necesita seis comunicaciones distintas en seis momentos distintos. No son seis versiones del mismo discurso: cada una resuelve un problema concreto y, si no se da a tiempo, ese problema aparece igual pero sin gestionar.
| # | Momento | Audiencia | Qué tiene que conseguir | Qué pasa si no se da |
| 1 | Kickoff | Toda la organización | Urgencia y relato: por qué ahora y por qué no es un proyecto de informática | El proyecto se percibe como «cosa de sistemas» durante dos años |
| 2 | Diseño y asignación de equipos | Gerentes y jefes de área | Permiso explícito para dedicar tiempo, con objetivos reajustados | Los mejores profesionales no aparecen en las sesiones |
| 3 | Constitución del gobierno | Comité ejecutivo y responsables funcionales | Reglas de decisión: decisor único, veto acotado, plazo de 48 horas | Cada decisión transversal tarda seis semanas |
| 4 | Antes de las pruebas | Equipo de proyecto y usuarios clave | Moderar expectativas antes del pico de optimismo | El valle se vive como un fracaso del proyecto |
| 5 | Pruebas críticas y prearranque | Toda la empresa | Seguridad psicológica: reportar fallos es un acto de lealtad | Los errores se ocultan y aparecen todos juntos en producción |
| 6 | Arranque y estabilización | Toda la organización | Anclaje e irreversibilidad: el nuevo proceso es la única forma válida | Convivencia indefinida de dos sistemas y dos verdades |
Abajo va una versión de cada uno. No son plantillas para leer literalmente —eso se nota a tres metros—, sino la sustancia que cada mensaje tiene que contener. Lo importante no es la redacción: es que cada afirmación sea verdad en el momento en que se pronuncia.
Mensaje 1 · Kickoff: por qué ahora y por qué no es un proyecto técnico
No estamos anunciando la compra de un sistema. Estamos cambiando cómo trabajamos, y la tecnología es solo la herramienta con la que lo vamos a hacer. Seguir operando como hasta ahora no es la opción segura: es el mayor riesgo que tenemos encima de la mesa. Lo que va a decidir si esto funciona no es el software, sino si somos capaces de rediseñar nuestros procesos, eliminar duplicidades y trabajar con un dato único. Habrá meses complicados y vamos a ser transparentes con eso desde hoy. A cambio, la dirección se compromete a darles tiempo, formación y decisiones rápidas.
Mensaje 2 · Mandos intermedios: el permiso explícito
Entiendo la presión que tienen para sostener los resultados del día a día, y no espero que hagan además el cambio al cien por cien sin apoyo. Vamos a reajustar formalmente los objetivos de sus áreas durante esta fase y a liberar el 25% del tiempo de sus mejores profesionales, con las sustituciones cubiertas. Su evaluación de este año no dependerá solo de la operación corriente, sino también de que protejan a esas personas y lideren la adopción en su área. No van a perder autoridad por estandarizar: van a decidir cómo queda el estándar.
Mensaje 3 · Comité ejecutivo: las reglas de decisión
A partir de hoy, cada decisión crítica de este programa tiene una sola persona con autoridad final, y está escrita con nombre y apellidos en la carta de gobierno. Las áreas afectadas serán consultadas siempre, pero aportar información no da derecho de veto. El veto queda reservado a objeciones legales, regulatorias o de riesgo, y tiene que estar fundamentado. Si una propuesta se envía a revisión y en 48 horas no recibe una objeción de ese tipo, se da por aprobada y el responsable avanza. La indecisión nos cuesta más que una decisión imperfecta corregida a tiempo.
Mensaje 4 · Antes de las pruebas: bajar el pico
Estamos a punto de entrar en la fase más exigente, y quiero ser muy claro sobre lo que viene. Habrá procesos que no salgan bien a la primera, pantallas que parezcan más complicadas que las de antes y datos históricos que tendremos que limpiar a mano. Durante unas semanas costará más trabajo hacer lo mismo que hacíamos ayer. Eso no significa que el proyecto vaya mal: es la consecuencia inevitable de desmontar rutinas de quince años. Lo que tenemos que hacer ahora no es acelerar, es aprender y ajustar el diseño.
Mensaje 5 · En el valle: permiso para levantar la mano
Sé que ahora mismo esto se siente difícil, que la productividad ha bajado y que hay frustración. Primero: es normal y está previsto; estamos en el punto más duro de la transición. Segundo, y más importante: en esta empresa nadie va a ser sancionado por decir «este proceso no funciona» o «estos datos están mal». Señalar un fallo hoy, antes del arranque, es un acto de lealtad profesional y lo vamos a tratar como tal. Traigan los problemas a la superficie ahora; tenemos soporte preparado para resolverlos.
Mensaje 6 · Arranque: no hay marcha atrás
Desde hoy, el nuevo proceso y el nuevo sistema son la única forma válida de trabajar. El viernes quedan desactivados los accesos a los sistemas anteriores y dejan de utilizarse las hojas de cálculo paralelas: la fuente de verdad operativa y financiera es una sola. El equipo directivo va a estar en el terreno acompañando departamento por departamento durante la transición, y seguiremos corrigiendo todo lo que haga falta. Pero el estándar no se negocia.
La regla que hace que estos mensajes sirvan para algo
Un mensaje sin una decisión detrás es propaganda, y la organización lo detecta en menos de una semana. Cada uno de los seis tiene que ir acompañado de un acto verificable que lo respalde, y ese acto es lo que de verdad comunica.
| Mensaje | Acto que lo hace creíble |
| 1 · Kickoff | El programa no depende del área de sistemas y hay propietarios de proceso nombrados |
| 2 · Mandos intermedios | Los objetivos del área están modificados por escrito y las sustituciones, contratadas |
| 3 · Reglas de decisión | La carta de gobierno con los decisores está publicada y firmada |
| 4 · Expectativas | El plan reconoce oficialmente una caída de productividad y la tiene presupuestada |
| 5 · Seguridad psicológica | Alguien ha sido reconocido en público por reportar un fallo incómodo |
| 6 · Anclaje | Existe fecha de apagado del legado y auditoría de accesos residuales |
Y, por simetría, las cinco frases que destruyen más credibilidad que cualquier error de ejecución: «esto no va a cambiar la forma de trabajar de nadie»; «el proyecto es de sistemas»; «no hay presupuesto para liberar a tu gente, hay que compaginarlo»; «esto lo decidimos entre todos»; y, la peor de todas porque cierra el canal de información para siempre, «si esto sale mal, buscaremos responsables».
El checklist de arranque: cuarenta preguntas antes del kickoff
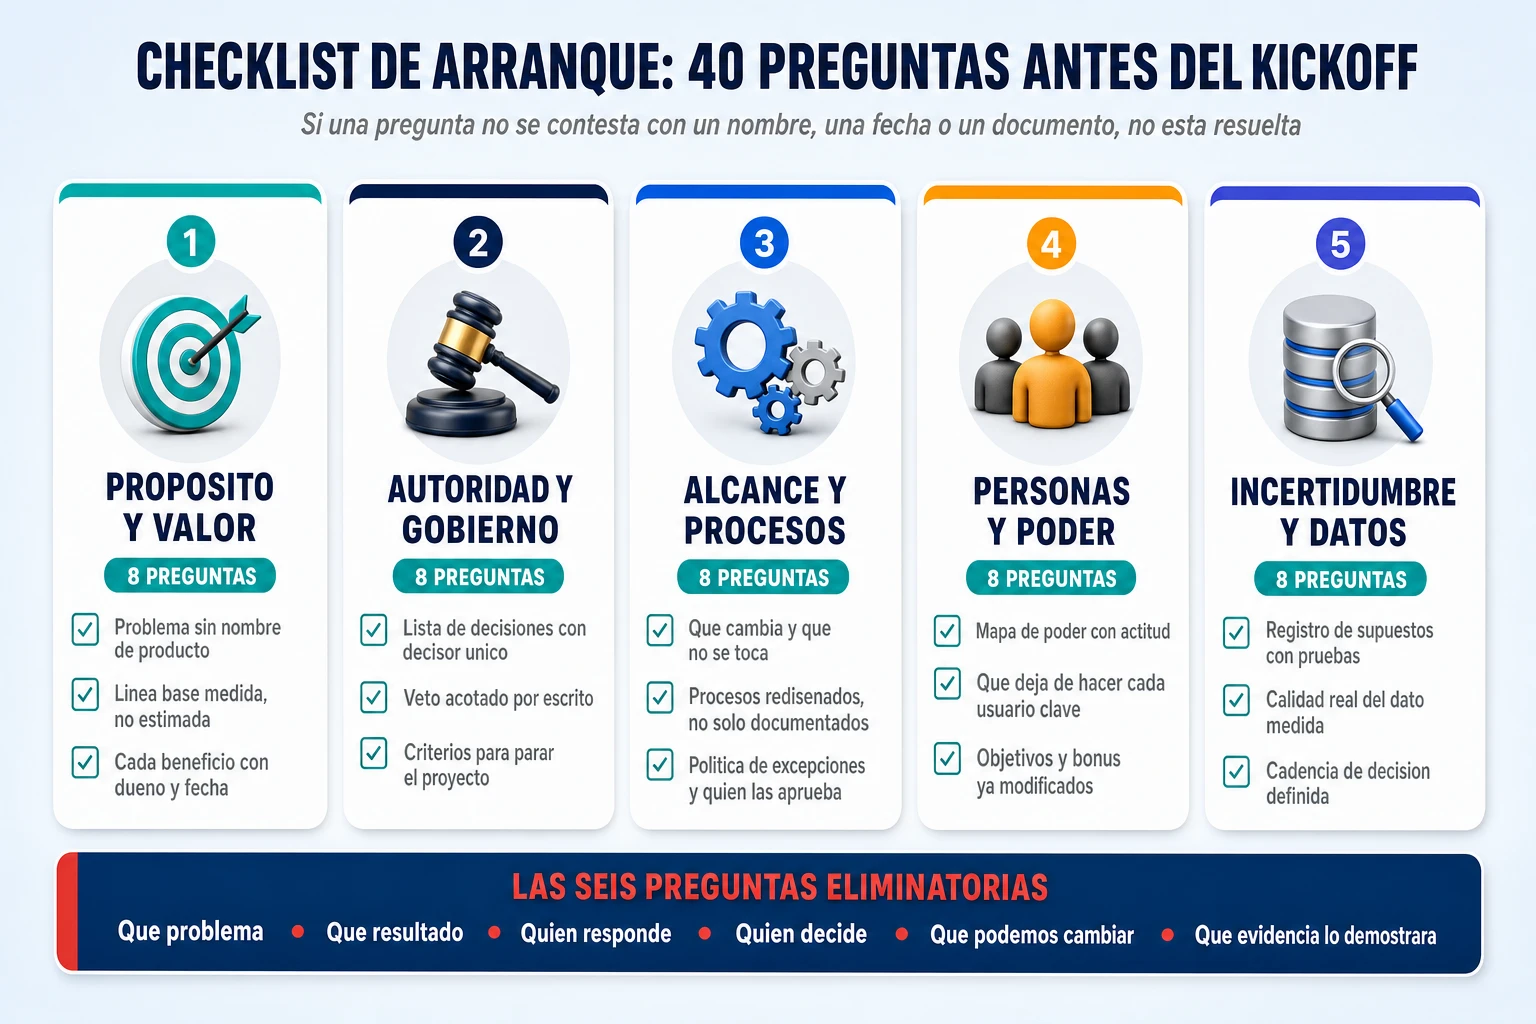
Esto es lo que hay que pasar antes de convocar la reunión de lanzamiento. No es un cuestionario de madurez para rellenar en una jornada de trabajo en equipo: es una lista de preguntas que se contestan con un nombre, una fecha o un documento. Si una pregunta no se puede contestar así, la respuesta es que no está resuelta.
Bloque 1 · Propósito y valor
- ¿Está escrito el problema en una frase que no contenga el nombre de ningún producto, tecnología ni proveedor?
- ¿Está cuantificado qué pasa si no hacemos nada durante veinticuatro meses?
- ¿Existe una línea base medida —no estimada en una reunión— de los procesos que vamos a tocar?
- ¿Cada beneficio comprometido tiene indicador, objetivo, fecha y un responsable con nombre y apellidos?
- ¿Ese responsable del beneficio seguirá razonablemente en su puesto cuando toque rendir cuentas?
- ¿Hemos evaluado y descartado explícitamente al menos una alternativa más barata que el proyecto?
- ¿Los ahorros comprometidos están incorporados al presupuesto del área que los tiene que entregar?
- ¿Sabemos qué parte del beneficio es ahorro real y qué parte es «capacidad liberada»? Porque la capacidad liberada que nadie reasigna no es un beneficio: es una hoja de Excel.
Bloque 2 · Autoridad y gobierno
- ¿Quién se despertaría preocupado dentro de dos años si no hay beneficios? ¿Y esa persona lo sabe?
- ¿Cuántas horas al mes va a dedicar el patrocinador al proyecto, y están en su agenda?
- ¿Existe la lista de decisiones críticas del programa con un único decisor asignado a cada una?
- ¿Hay alguna decisión cuyo decisor sea un comité, o dos nombres separados por una barra?
- ¿Está acotado por escrito quién puede vetar y por qué motivos concretos?
- ¿Hay un plazo máximo de decisión y alguien responsable de medir si se cumple?
- ¿Existen criterios escritos de continuar, reorientar, pausar o parar, con umbrales concretos?
- ¿Quién tiene autoridad política real para parar esto, y lo ha reconocido delante de otros?
Bloque 3 · Alcance y procesos
- ¿Están escritas las dos listas: qué puede cambiar y qué no se toca?
- ¿La autoridad que gobierna el proyecto está a la altura de los grados de libertad que le hemos dado?
- ¿Hemos evaluado con honestidad la madurez de procesos y de empresa antes de diseñar el modelo futuro?
- ¿Los procesos críticos están rediseñados, o solamente documentados tal como son hoy?
- ¿Existen los principios de diseño y alguien ha tenido ya que decir que no a alguien invocando uno?
- ¿Hay un propietario por proceso de extremo a extremo, con autoridad por encima de los departamentos?
- ¿Cuál es la política de excepciones y personalizaciones, y quién las aprueba una por una?
- ¿El proyecto está modularizado en olas, o hemos concentrado todo el riesgo en un único arranque?
Bloque 4 · Personas y poder
- ¿Existe un mapa de actores con poder, impacto y actitud, actualizado en los últimos treinta días?
- ¿Hay algún área con mucho poder y poco interés que todavía no se ha enterado del alcance real?
- ¿Está escrito qué dejará de hacer cada usuario clave y quién lo sustituye?
- ¿La salida de esas personas de la operación diaria genera incomodidad real en su departamento?
- ¿Están modificados por escrito los objetivos y la retribución variable de los jefes de área implicados?
- ¿Los embajadores del cambio han sido elegidos por su influencia real o por su disponibilidad?
- ¿Qué puestos van a cambiar de contenido, y se ha hablado ya con esas personas antes que con el resto?
- ¿Hay alguien cuyo trabajo principal —no una tarea añadida— sea la adopción y la gestión del cambio?
Bloque 5 · Incertidumbre, datos y aprendizaje
- ¿Existe un registro de supuestos, y hay plan para intentar destruir los tres más peligrosos antes del mes tres?
- ¿Hemos contrastado nuestro plazo con el de proyectos comparables, en lugar de con nuestro optimismo?
- ¿Conocemos la calidad real del dato que vamos a migrar, medida sobre una muestra y no supuesta?
- ¿Está identificado el sistema que es fuente de verdad para cada dato maestro?
- ¿Sabemos qué integraciones y API existen, cuáles hay que construir y quién las construye?
- ¿Está definida la cadencia: comité estratégico, sala de control semanal y sincronización operativa?
- ¿Existe un inventario único de decisiones pendientes y alguien mide su antigüedad media?
- ¿Está agendado el pre-mortem, con fecha y con quién lo facilita?
Cómo se usa: las seis preguntas eliminatorias
Las cuarenta se puntúan en verde, ámbar o rojo, con dueño y fecha para cada ámbar. Pero no todas pesan igual. Hay seis que son eliminatorias: si alguna está en rojo, el proyecto no está listo para arrancar y convocar el kickoff solo sirve para trasladar el problema a un momento en el que costará diez veces más resolverlo.
- ¿Qué problema queremos resolver, dicho sin nombrar ninguna tecnología?
- ¿Qué resultado económico u operativo esperamos, con línea base y fecha?
- ¿Quién es personalmente responsable de conseguirlo?
- Cuando haya un conflicto serio, ¿quién tiene autoridad para decidir?
- ¿Qué estamos dispuestos a cambiar: tecnología, procesos, organización o las tres cosas?
- ¿Qué evidencia demostrará dentro de seis, doce y veinticuatro meses que esto ha funcionado?
Si alguna de esas seis respuestas es ambigua, todavía no está en fase de ejecución. Está en fase de definición, aunque el cronograma diga otra cosa y aunque ya haya contratado al integrador.
Por qué fracasan de verdad: doce modos de fallo y su señal temprana
Los proyectos de transformación no se caen de golpe. Se caen despacio, y casi siempre por uno de estos doce caminos. Lo relevante de la tabla no es la columna de la izquierda —esa lista la firma cualquiera—, sino la del centro: la señal temprana, que es lo que permite intervenir cuando todavía es barato.
| Modo de fallo | Señal temprana | Antídoto |
| 1. Se aprueba la solución antes que el problema | El business case empieza con el nombre de un producto | Aprobar primero el problema y el escenario de no hacer nada |
| 2. Nadie es dueño del resultado | «El proyecto es de todos». Nadie responde del beneficio a dos años | Responsable de beneficio nominal, con el ahorro en su presupuesto |
| 3. No hay decisor | La misma decisión vuelve al comité por tercera vez | RAPID por decisión y decisor único publicado |
| 4. Deuda de decisión sin control | Las actas se llenan de «pendiente de confirmar» | Inventario quincenal y antigüedad media por debajo de cinco días |
| 5. Se automatiza el caos | El diseño TO-BE se parece al AS-IS con pantallas nuevas | Rediseño previo, evaluación de madurez y propietario de proceso |
| 6. La personalización devora el estándar | La lista de gaps crece cada semana y nadie la cierra | Principio de encaje al estándar y excepciones aprobadas una a una |
| 7. Equipo sin capacidad liberada | Los usuarios clave empiezan a faltar a las sesiones en el mes tres | Liberación formal del 20-30% con sustituciones contratadas |
| 8. Mandos intermedios con incentivos contrarios | Apoyan en el comité y frenan en su equipo | Modificar objetivos y bonus antes de pedir colaboración |
| 9. Stakeholder crítico descubierto tarde | Cambio de alcance en el mes siete por un área que nadie mapeó | Mapa de poder dinámico, revisado cada mes |
| 10. Datos y legado subestimados | La migración se aplaza por segunda vez | Perfilado real del dato en el front-end, sobre muestras |
| 11. Silencio en el valle | Las incidencias reportadas bajan justo antes del arranque | Seguridad psicológica, reconocimiento público y pre-mortem |
| 12. Nadie puede parar ni reorientar | «¿Qué haría falta para pararlo?» · «Nada, ya está aprobado» | Criterios de go / pivot / pause / stop con umbrales y decisor |
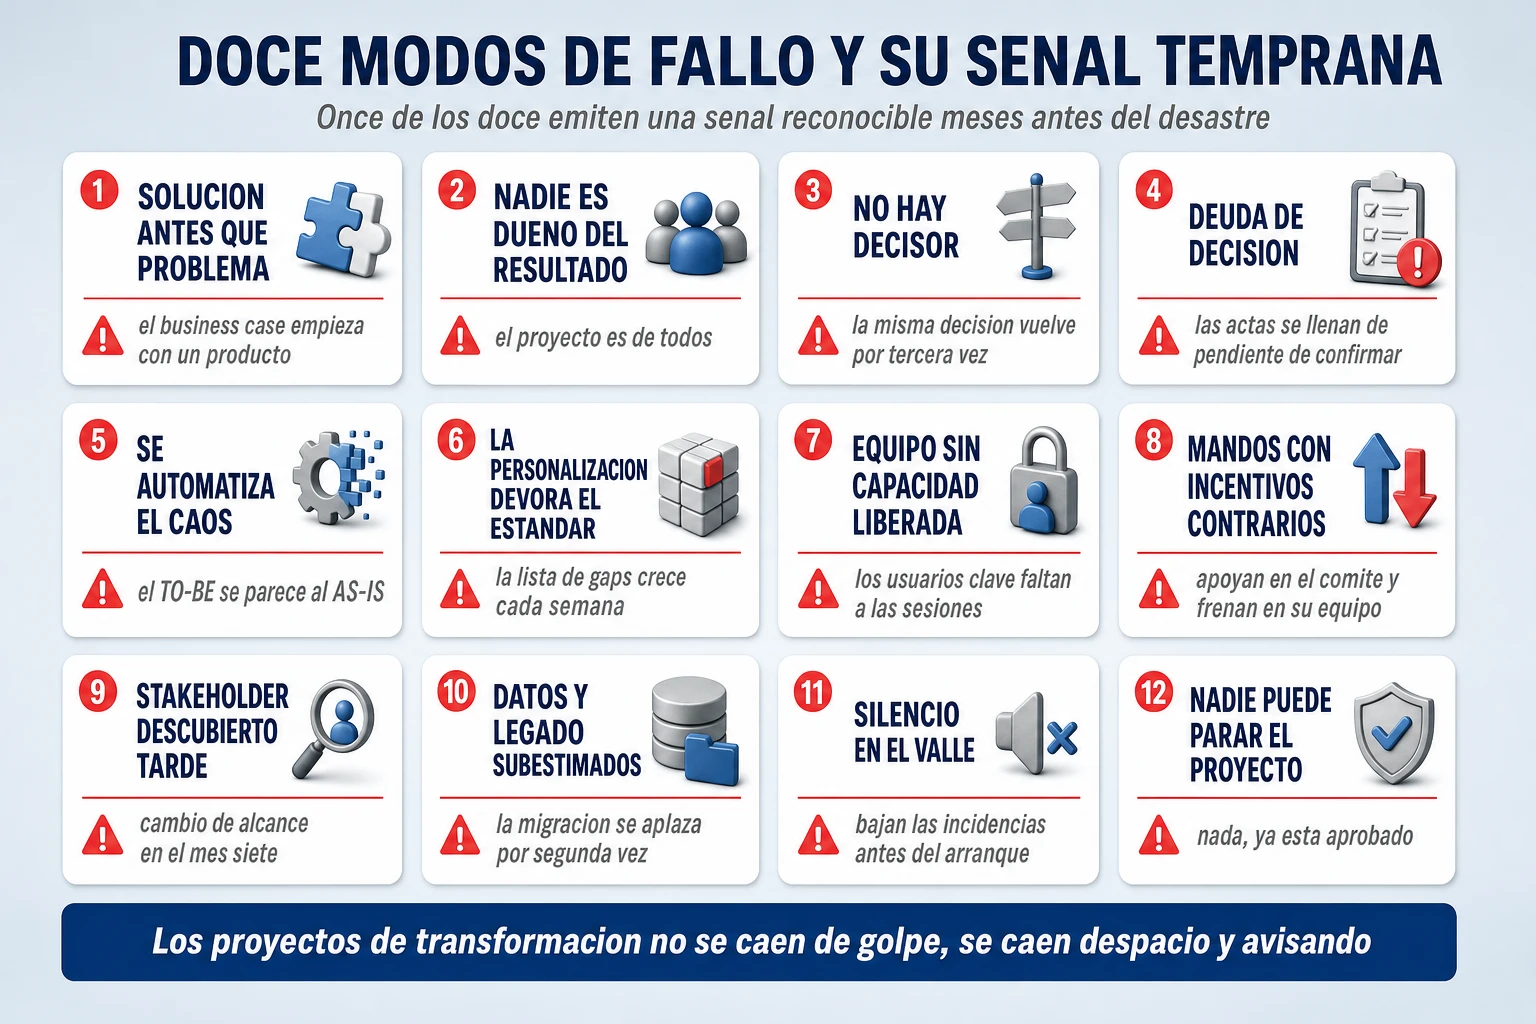
Merece la pena detenerse en dos de ellos, porque son los que más se confunden con buenas noticias.
El número 4 es traicionero porque la deuda de decisión mantiene el proyecto en verde mientras se acumula. Un programa con todos los hitos cumplidos y cuarenta decisiones abiertas está en peor situación que uno con dos semanas de retraso y ninguna: el primero ha convertido su problema en invisible, el segundo lo tiene delante.
El número 11 es directamente contraintuitivo. En la mayoría de los cuadros de mando, que bajen las incidencias reportadas se celebra. Semanas antes de un arranque, ese descenso casi nunca significa que haya menos problemas: significa que la gente ha calculado que reportarlos no compensa. Es el indicador adelantado más fiable de un go-live malo, y el más ignorado.
Los primeros cien días: qué tiene que estar cerrado y cuándo
Una vez arrancado, el primer trimestre decide el resto. No por lo que se construye —normalmente todavía no se construye casi nada—, sino porque es la ventana en la que todavía se puede cambiar el diseño sin coste político. Este es un calendario razonable para una transformación de tamaño medio.
| Periodo | Gobierno y decisión | Valor y procesos | Personas |
| Semanas 1-2 Movilizar | Carta de gobierno: decisiones críticas, decisores, SLA y criterios de parada | Alcance con sus dos listas: qué cambia y qué no | Patrocinador con agenda comprometida y equipo mínimo liberado |
| Semanas 3-6 Diagnosticar | Cadencia en marcha: sala de control semanal e inventario de decisiones | Línea base medida · AS-IS de los procesos críticos · madurez evaluada | Mapa de poder con actitud · usuarios clave nombrados y sustituidos |
| Semanas 7-10 Diseñar y probar | Primeras decisiones grandes tomadas y publicadas, con su fundamento | Principios de diseño acordados · TO-BE de uno o dos procesos · registro de supuestos con pruebas lanzadas | Objetivos y bonus de los jefes de área modificados · embajadores formados |
| Semanas 11-13 Escalar | Revisión de deuda de decisión y primer contraste de plazo con proyectos comparables | Dos o tres victorias tempranas en producción · cuadro de mando con indicadores de negocio, no solo de avance | Primer mensaje de moderación de expectativas · soporte y entornos de práctica listos |
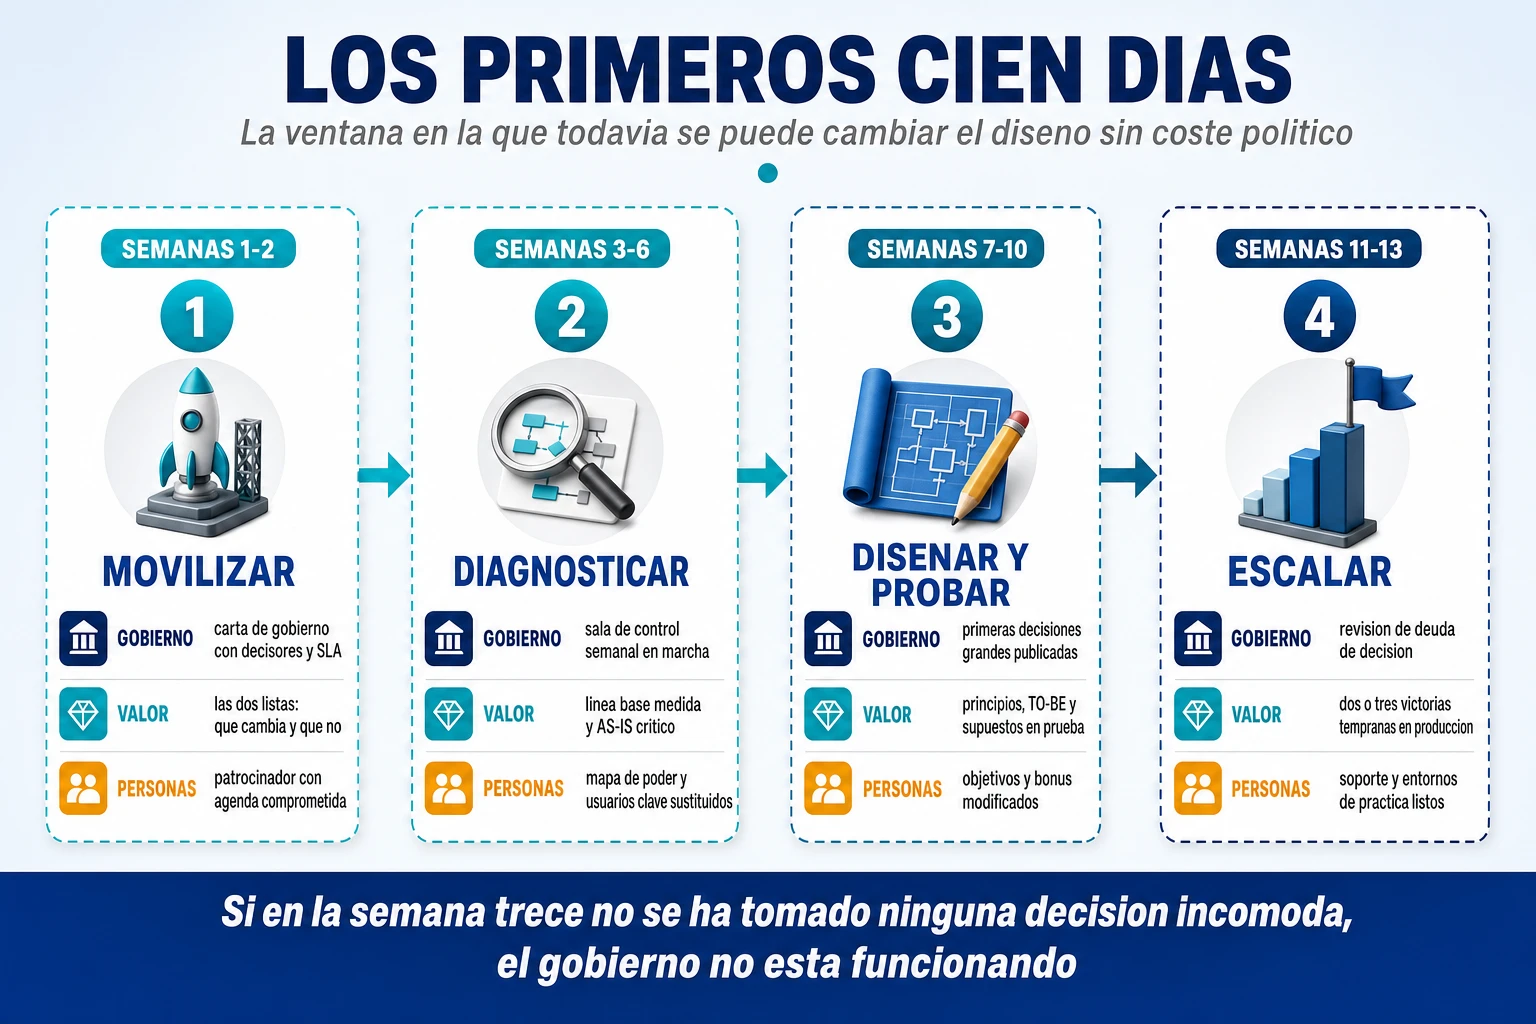
Dos advertencias sobre este calendario. La primera: las victorias tempranas tienen que ser reales y atribuibles. Una mejora que ya estaba en marcha antes del proyecto y que se apunta el programa destruye más credibilidad de la que construye, porque todo el mundo en la operación sabe de dónde venía. La segunda: si al final de la semana trece no se ha tomado ninguna decisión incómoda —ninguna que haya dejado a alguien descontento—, el gobierno no está funcionando. Un sistema de decisión que nunca molesta a nadie es un sistema que no está decidiendo.
Dónde encajan Kotter, ADKAR, Lewin y 7-S
Este artículo ha evitado deliberadamente desarrollar los modelos de gestión del cambio, y conviene explicar por qué. El riesgo metodológico más común en estos proyectos es lo que se ha llamado fetichismo del marco de trabajo: suponer que adoptar un modelo teórico con disciplina garantiza el resultado. Ninguno cubre por sí solo todas las dimensiones de una transformación, y discutir cuál es mejor es una forma cómoda de no discutir quién decide.
Puestos a usarlos, funcionan mejor en capas, cada uno en la altitud que le corresponde: Kotter para movilizar al comité ejecutivo y generar sentido de urgencia; McKinsey 7-S para diagnosticar incoherencias entre estrategia, estructura, sistemas y valores antes de diseñar; Lewin y sobre todo Bridges para la contención emocional durante la transición, que es la fase de este artículo dedicada al valle; y ADKAR a pie de supervisor, para medir en qué punto exacto se bloquea la adopción de cada persona: si no sabe por qué, si no quiere, si no sabe cómo, si no puede o si nadie está reforzando el hábito nuevo.
El análisis en detalle de los cuatro, con sus fases, sus mecanismos y sus límites, está en por qué falla la transformación empresarial: de Kotter a ADKAR. Aquí bastaba con situarlos, porque el argumento de este texto es otro: ninguno de esos modelos le va a decir quién firma la decisión que su comité lleva seis semanas devolviendo.
Conclusión: el kickoff como línea de llegada
Si hubiera que reducir todo lo anterior a una sola idea, sería esta: el kickoff no debería ser el principio de una transformación, sino el final de una fase previa en la que se ha construido el sistema de gobierno, decisión, valor, cambio y aprendizaje que permitirá ejecutarla. Todo lo que no se resuelva en esa fase no desaparece; se convierte en deuda de decisión, y se paga con intereses durante la integración, durante el arranque y durante los dos años siguientes.
Lo incómodo del asunto es que casi nada de esto es difícil desde el punto de vista técnico. Escribir la lista de decisiones críticas con su decisor único cuesta una tarde. Medir la línea base cuesta dos semanas. Liberar el 25% del tiempo de ocho personas cuesta dinero, pero es un número que cabe en un presupuesto. Lo que cuesta de verdad es lo otro: decirle que no a un director que quiere su excepción, aceptar en público que la productividad va a caer, aguantar el valle sin buscar culpables y admitir que existe un escenario en el que este proyecto se para.
Por eso la anécdota del consultor sigue funcionando treinta años después. Preguntar quién decide no es una formalidad de gobernanza. Es la forma más rápida de averiguar si la organización está dispuesta a pagar el precio de transformarse o solo quiere comprar el software y esperar a ver qué pasa.
Cuando aparezca el primer conflicto serio y haya que elegir, ¿quién va a decidir? Si la respuesta es «ya lo veremos entre todos», acaba de encontrar el primer riesgo del proyecto. Y todavía no ha abierto el Jira.
En Transformalix ayudamos a construir exactamente eso antes de que el proyecto arranque: el mapa de decisiones con su decisor único, la línea base que hace medibles los beneficios, el rediseño de los procesos que van a soportar la automatización y el modelo de gobierno que sostiene todo cuando llega el valle. Si está a punto de arrancar una transformación —o ya la arrancó y sospecha que alguna de las seis preguntas eliminatorias sigue en rojo—, hablemos.