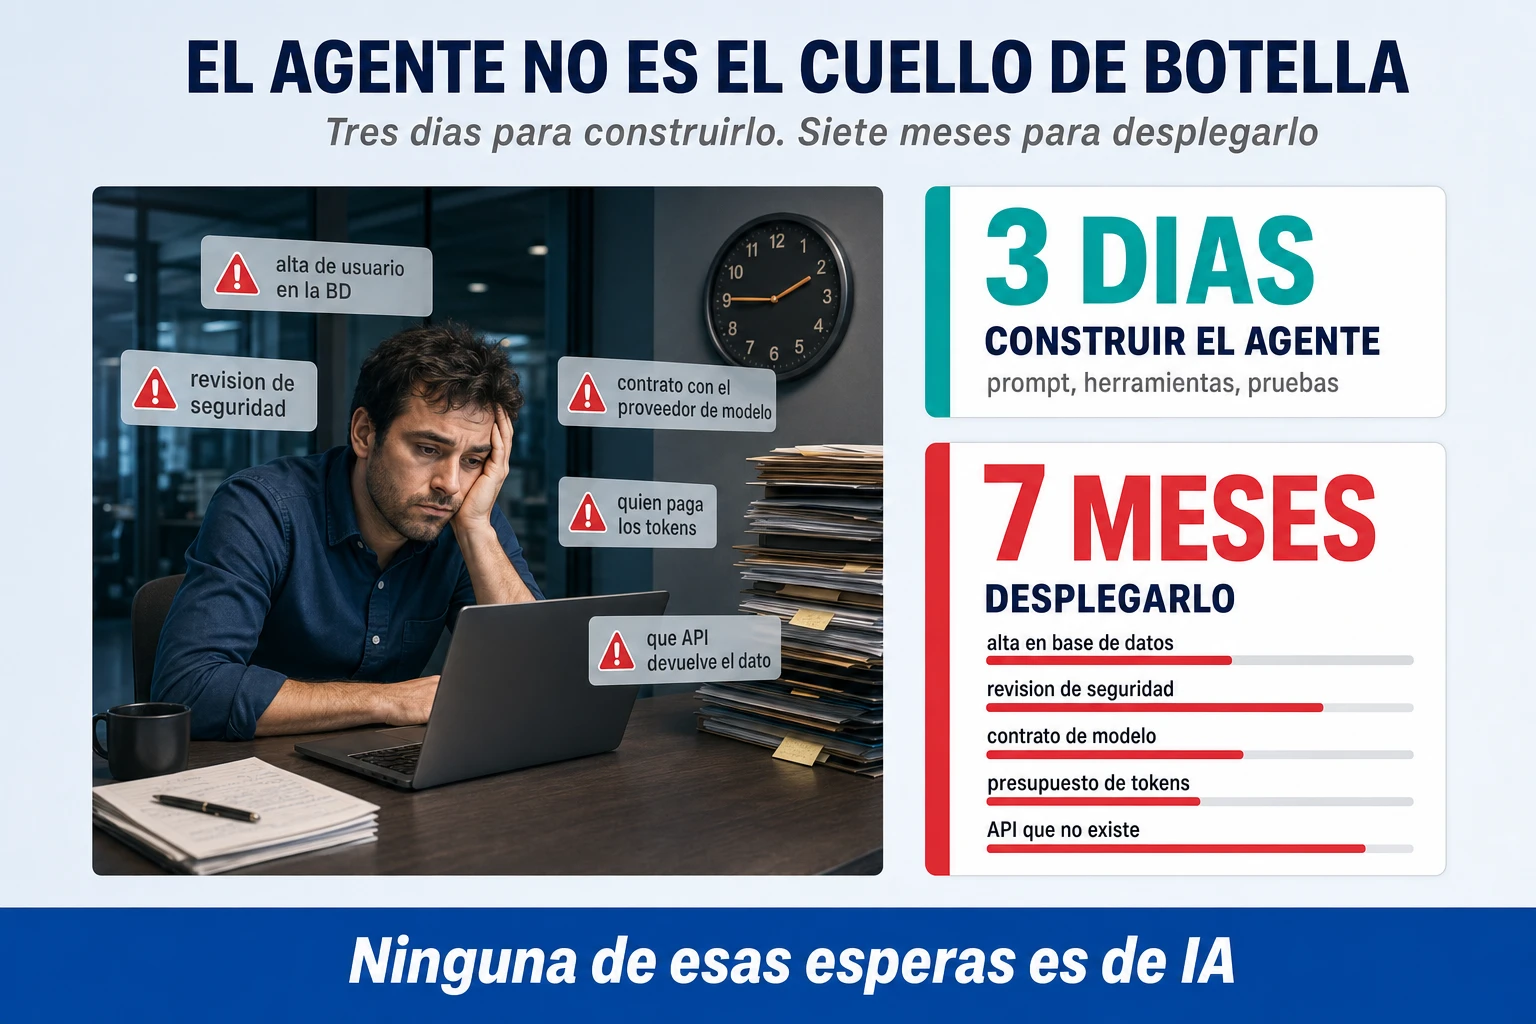
Tres personas construyen un agente en tres días. Consulta el estado de un pedido, lo cruza con la incidencia abierta del cliente, decide si procede una compensación y redacta la respuesta. La demo funciona, el comité aplaude y alguien dice la frase que condena el proyecto: «esto en dos semanas lo tenemos en producción». Siete meses después sigue sin estarlo.
Merece la pena desglosar esos siete meses, porque el desglose es el artículo entero. Seis semanas en dar de alta un usuario técnico contra la base de datos, con tres comités por medio. Un mes en una revisión de seguridad que empieza desde cero porque no existe ningún patrón aprobado al que acogerse. Tres semanas en averiguar quién firma el contrato con el proveedor del modelo. Dos semanas en decidir contra qué centro de coste se imputan los tokens. Un mes en responder qué pasa si el agente cierra una incidencia que no debía cerrar. Y dos meses largos en la pregunta más humilde de todas: de qué API salen exactamente los datos del pedido, y si esa API existe.
Ninguno de esos siete meses es de inteligencia artificial. Ninguno. El modelo estaba listo el tercer día y no volvió a ser el problema. Lo que faltaba era todo lo demás: identidad, contrato, presupuesto, control, catálogo y una respuesta a quién responde cuando la cosa se equivoca. Es decir, plataforma.
La velocidad a la que una gran empresa despliega agentes no la decide el agente. La decide cuánto de la plataforma estaba ya montado antes de que llegara el caso de uso.
De ahí sale el eje de todo lo que viene. Hay dos relojes y casi todo el mundo los mezcla. El primero es el de la plataforma: se monta una vez y se amortiza en todos los agentes —gateways, identidad, runtime, observabilidad, catálogo, contratos con proveedores de modelo, entorno de evaluación—. El segundo es el del caso de uso: se repite N veces —qué sistemas, qué fuentes, qué herramientas, qué datos, qué umbrales—.
La industria ha convergido en una arquitectura razonablemente estable, y conviene enunciarla en una línea antes de discutirla: el agente no toca los sistemas, toca capacidades gobernadas, y son esas capacidades las que tocan los sistemas y los datos. Todo lo demás existe para que esa frase sea verdad en producción y no solo en una diapositiva.
Las preguntas que bloquean su construcción son siempre las mismas, y se repiten en toda empresa que llega lo bastante lejos como para tropezar con ellas. Si la vectorización de documentos puede ser automática o hay que controlarla. Si todo el tráfico tiene que pasar por el gateway de APIs, incluida la recuperación documental. Si ese mismo gateway puede exponerse además como servidor MCP. Si de verdad no puede haber conexiones directas a base de datos y, en ese caso, cuántas APIs existen y si hay un directorio. Y qué hacer con la observabilidad cuando conviven dos herramientas de trazas y nadie ha decidido cuál es el estándar.
Las cinco están respondidas más adelante, en la sección donde toca cada una. Pero hay una sexta que hace dos años no estaba en ninguna lista y hoy decide más que las otras cinco juntas: qué se le expone exactamente a un agente, y quién decide que eso es una capacidad de la compañía y no un endpoint.
El plano: qué hay dentro de una plataforma de agentes
Una plataforma de agentes no es un producto que se compra. Es un conjunto de decisiones que se toman una vez y se materializan en siete capas y cuatro capacidades transversales. Ninguna de las once es opcional, aunque tres o cuatro se pueden empezar de forma rudimentaria y madurar después.
El orden importa porque cada capa solo puede delegar hacia abajo, nunca hacia arriba. El AI Gateway no puede proteger una base de datos: no sabe qué es una fila. El gateway de APIs no puede limitar el gasto en tokens: no sabe qué es un token. Cuando una capa intenta resolver el problema de otra, el resultado es un control que parece existir y no existe.
| Capa | Qué decide | Qué NO decide | Quién la mantiene |
| 1. Desarrollo y ciclo de vida | Cómo se construye, versiona, certifica y promociona un agente | Qué hace el agente en producción ni a qué accede | Ingeniería de plataforma con la oficina de IA |
| 2. Runtime de ejecución | Dónde se ejecuta, cómo escala, cómo persiste el estado, cómo se aísla | Qué modelo se usa ni qué permisos tiene el agente | Plataforma / SRE |
| 3. AI Gateway — el plano del modelo | Acceso a modelos, cuotas por tokens, coste, guardrails, trazas de inferencia | Permisos sobre datos ni lógica de negocio | Plataforma de IA |
| 4. Capacidades — MCP, Agent Gateway y catálogo de herramientas | Qué capacidades ve el agente, con qué contrato, con qué identidad y con qué límite | Si el sistema de abajo aguanta la llamada ni si la operación tiene sentido de negocio | Dueño de cada dominio, con la plataforma |
| 5. Federación — A2A y API de agente | Cómo se delega trabajo entre agentes de dominios distintos | Qué hace cada agente por dentro | Arquitectura de integración |
| 6. Integración — API Gateway y apificación del legacy | Autenticación de servicio, traducción de protocolo, límite de tasa, cortocircuito | La semántica de negocio de la operación ni el coste en tokens | Equipo de integración |
| 7. Datos — plataforma de datos, capa semántica, catálogo de metadatos y conocimiento no estructurado | Qué se indexa, qué se consulta, con qué permisos y contra qué copia | Qué va a preguntar el agente | Gobierno del dato y administración de bases de datos |
| Capacidades transversales | |||
| Seguridad e identidad | Quién es el agente, en nombre de quién actúa, con qué alcance y hasta cuándo | Si la acción tiene sentido de negocio | Seguridad e identidad corporativa |
| Observabilidad | Qué se traza, con qué esquema y bajo qué identificador de correlación | Si lo trazado está bien hecho | Plataforma con observabilidad corporativa |
| Gobierno | Quién aprueba, certifica, publica y apaga un agente o una herramienta | Cómo se implementa | Oficina de IA o equivalente |
| FinOps | Etiquetado, presupuesto por agente, corte duro y métrica de coste | Si el caso de uso vale la pena | Finanzas con plataforma |
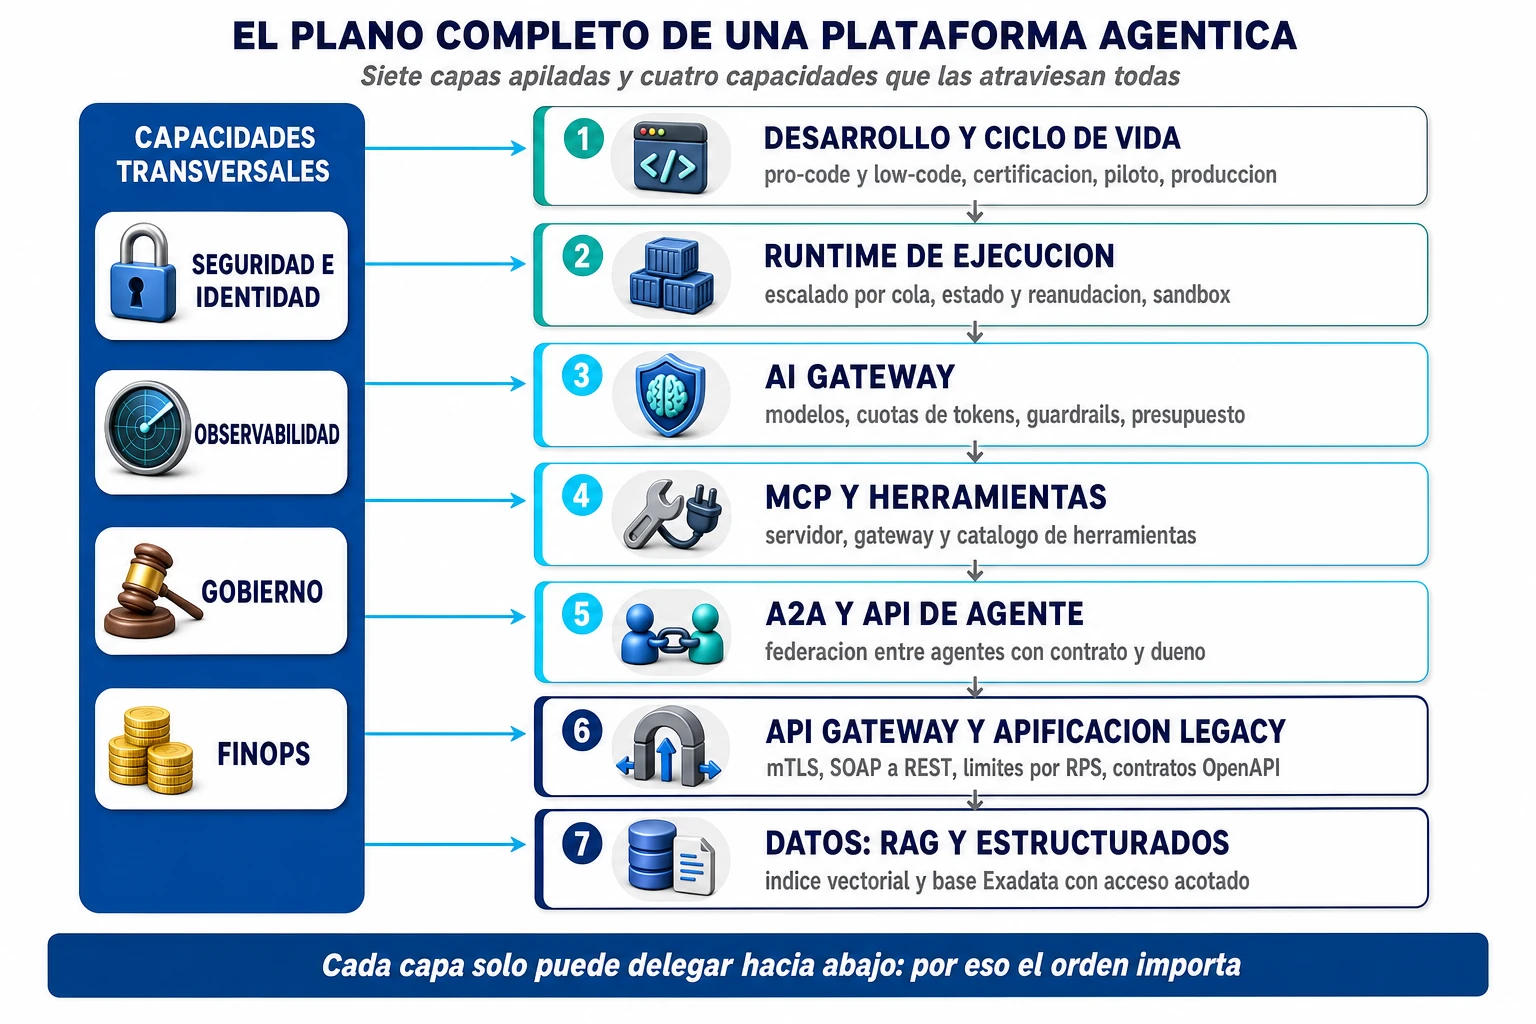
El principio que ordena el plano cabe en tres palabras enlazadas: agente → capacidades gobernadas → sistemas y datos. Un agente que llama directamente a un sistema es un agente sin gobierno. Y una capacidad que no está en ningún catálogo es una capacidad que nadie puede retirar.
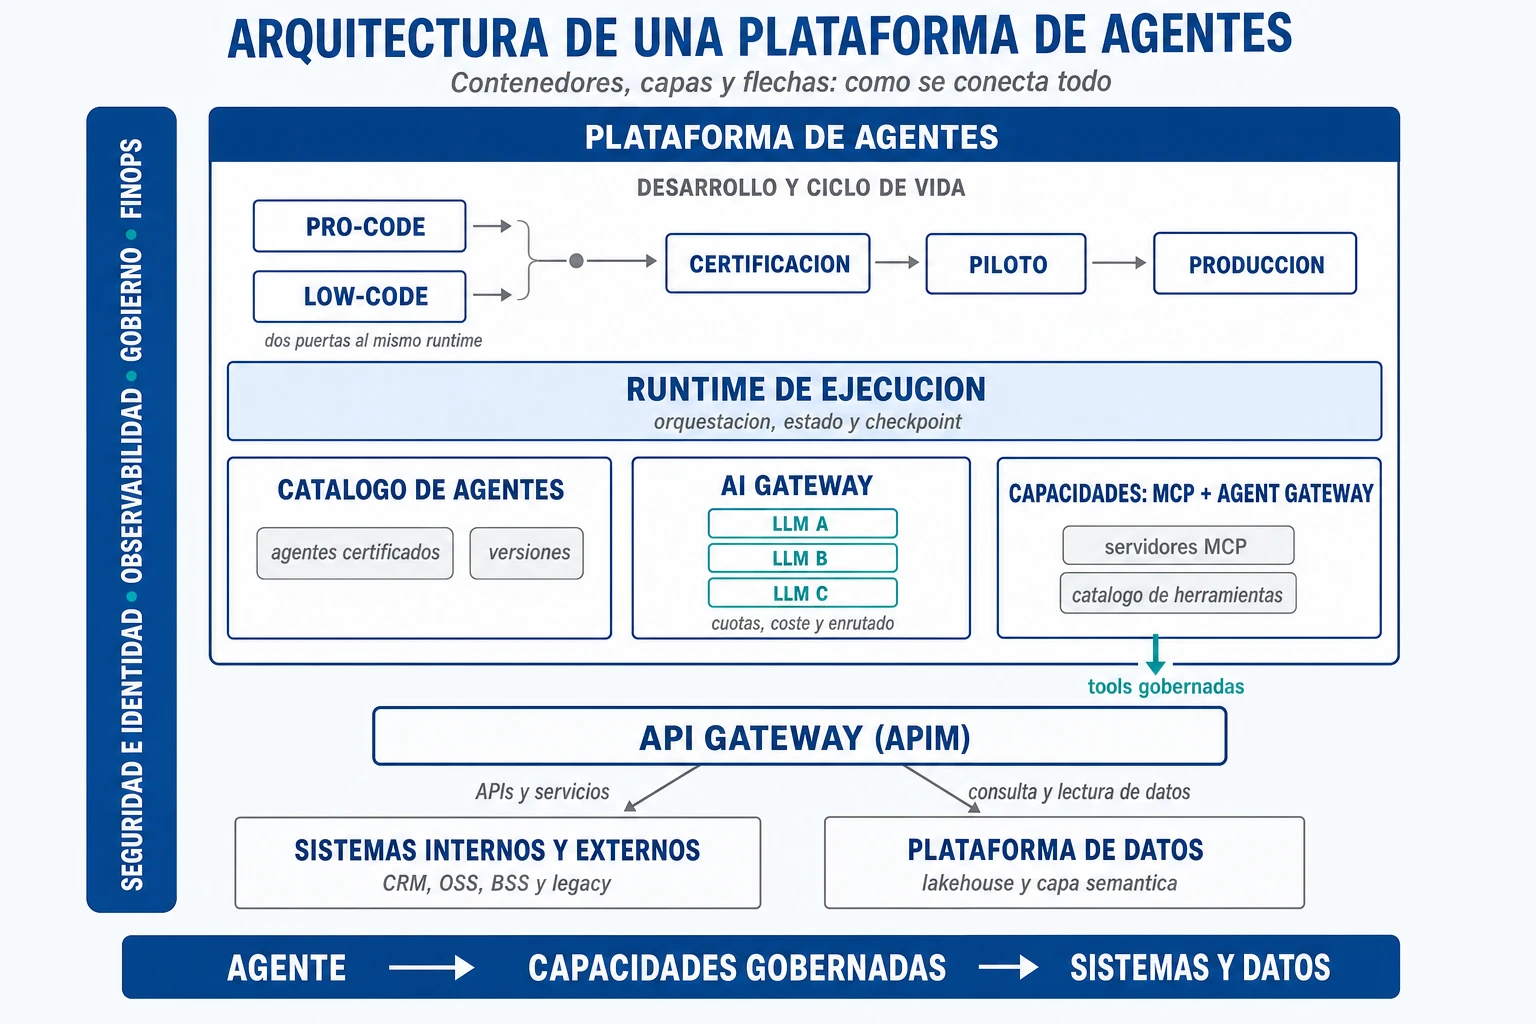
La recomendación cabe en una frase y se aplica antes de comprar nada: dibuje las once, marque quién es el dueño de cada una con nombre y apellidos, y acepte que las que se queden sin dueño no existen. Un componente sin dueño va a montarlo cada equipo por su cuenta, tres veces y de tres formas distintas.
Capa 1: desarrollo y ciclo de vida del agente
Las cuatro puertas de calidad: desarrollo, certificación, piloto, producción
El ciclo habitual —certificación, piloto, producción— es correcto, pero la segunda puerta esconde el cambio más importante respecto al software de siempre. Certificar un agente no es pasar pruebas unitarias. Es medir una distribución.
| Entorno | Qué se comprueba | Controles activos | Mecanismo de despliegue y criterio de salida |
| Desarrollo | Que el agente hace lo que dice hacer en el caso feliz | Datos sintéticos o anonimizados, sin acceso a producción, presupuesto de tokens simbólico, herramientas simuladas | Rama con despliegue automático a un espacio aislado. Sale cuando completa el caso de extremo a extremo sin intervención |
| Certificación | Que acierta lo suficiente y que falla de forma segura | Conjunto de evaluación versionado con umbral publicado, equipo rojo de inyección de prompt, revisión de herramientas y permisos, límite de coste por ejecución | Promoción automática si supera el umbral; revisión manual si no. Sale con un informe de evaluación firmado por el dueño del caso de uso |
| Piloto | Que aguanta usuarios reales, datos reales y carga real | Solo lectura o acciones reversibles, lista blanca de usuarios, umbral monetario por operación, humano en el bucle para lo irreversible, presupuesto acotado | Despliegue canario con porcentaje de tráfico. Sale con dos semanas sin incidente de seguridad, sin desviación de coste y con la métrica de negocio medida |
| Producción | Que sigue acertando cuando cambian el modelo, los datos y los usuarios | Todos los anteriores, más presupuesto duro con corte, alertas de deriva, reevaluación automática en cada cambio de versión de modelo | Despliegue progresivo con vuelta atrás probada. Sale —hacia la retirada— cuando incumple el umbral escrito el día que entró |
El agente es un activo con dueño, versión y fecha de caducidad
Cada agente necesita una ficha con ocho campos y no más: dueño de negocio, dueño técnico, versión del agente, modelo y versión contra los que está certificado, herramientas que consume, datos que toca con su clasificación, entorno y fecha de próxima revisión. Caben en una tabla y se rellenan en diez minutos.
El octavo campo cambia el comportamiento del sistema entero. Si nadie renueva un agente en su fecha de revisión, se apaga. No se escala, no se abre un ticket, no se pregunta en el comité: se apaga. Es el único mecanismo que funciona contra la acumulación silenciosa de agentes que nadie usa, nadie mantiene y todos tienen credenciales vivas.
Capa 2: el runtime, o por qué un agente no escala como una web
Una petición web entra, trabaja doscientos milisegundos y se va. Un agente razona unos segundos, llama a una herramienta que tarda cuarenta, vuelve a razonar, pide una aprobación humana que llega cuatro horas después y entonces continúa. Su perfil de recursos no se parece en nada.
| Dimensión | Aplicación web tradicional | Agente |
| Duración de la unidad de trabajo | Milisegundos a segundos | Segundos a horas, con esperas humanas por medio |
| Perfil de recurso | CPU proporcional al tráfico | Ráfagas de CPU separadas por esperas que solo retienen memoria |
| Señal de escalado útil | CPU, peticiones por segundo | Profundidad de cola, ejecuciones pendientes, antigüedad del trabajo más viejo |
| Coste marginal de una petición | Estable y conocido | Variable: depende de cuántas vueltas dé el bucle de razonamiento |
| Estado | Sin estado o en sesión | Conversación, plan parcial y resultados de herramientas: hay que persistirlo |
| Fallo típico | Timeout o error 500 | Bucle, herramienta mal elegida, presupuesto agotado, respuesta inventada con consecuencia |
| A quién protege el límite de concurrencia | Al propio servicio | Al sistema legacy que hay tres saltos más abajo |
La respuesta es escalado dirigido por eventos sobre una señal que represente el trabajo pendiente —profundidad de cola— con reducción a cero cuando no hay nada que hacer, y persistencia de estado: guardar el punto en el que va una ejecución para pausarla, reanudarla en otro nodo sin repetir inferencias ya pagadas y meter a un humano en el bucle de verdad. Conviene no confundirla con otra cosa: el punto de control no es la memoria del agente. El punto de control es infraestructura y su dueño es la plataforma; la memoria es producto —qué recuerda el agente, cuánto tiempo y con qué base legal—.
La otra pieza obligatoria es el aislamiento. En el momento en que un agente ejecuta código —y va a ejecutarlo—, el entorno aislado pasa a ser un requisito de entrada: contenedor endurecido, sin red saliente salvo lista blanca, ficheros efímeros y límite de tiempo y memoria. Un agente con capacidad de ejecutar código y salida libre a internet es una puerta trasera con documentación.
La concurrencia del agente es la carga del legacy. El límite de instancias no es un parámetro de coste: es un parámetro de protección del mainframe.
Recomendación: escriba el presupuesto de concurrencia como un contrato explícito —«N ejecuciones simultáneas y M llamadas por segundo contra el sistema X»—, haga que viva en el manifiesto de despliegue y que lo firme el dueño del sistema de destino.
Capa 3: el AI Gateway no es un API Gateway con otro nombre
Es el bloque peor entendido de esta arquitectura. Se dibuja como una caja que contiene los modelos, MCP, A2A y la API de agente, y de ahí se deduce que es «un gateway de APIs para cosas de IA» y que quien ya tenga uno corporativo se lo puede ahorrar. Es un error caro y se paga en la renovación del contrato con el proveedor de modelo.
Lo que gobierna es concreto: el acceso a los modelos —un único punto de salida hacia cualquier proveedor—, el enrutado y la conmutación entre ellos, las cuotas medidas en tokens, la caché semántica, los guardrails de entrada y salida, el presupuesto por agente con capacidad de corte, y la traza de cada inferencia con su modelo, sus tokens y su coste.
Dos desajustes lo explican. Una petición de API es atómica y cuesta siempre lo mismo; una sesión agéntica es un flujo largo cuyo coste no se conoce hasta que termina. Y los gateways tradicionales cortan a los sesenta segundos, mientras el razonamiento agéntico dura minutos: meter ese tráfico por el gateway de APIs obliga a romper el agente o a subir los tiempos de espera globales y degradar el resto de la producción.
Denial-of-Wallet: el ataque que no tira nada y se lo lleva todo
El bucle infinito de un agente no tumba el sistema: vacía el presupuesto, de noche y sin generar una sola alerta de disponibilidad, porque para la infraestructura todo funciona. El descubrimiento llega con la factura. Y no hace falta un atacante: basta un agente que interpreta mal el resultado de una herramienta, vuelve a llamarla igual y no tiene condición de parada distinta de «lo he conseguido». La defensa es aburrida y eficaz: cubo de tokens por agente, límite de pasos y de coste por ejecución, y presupuesto duro mensual con corte automático. Corte, no alerta: una alerta a las tres de la mañana no detiene un bucle, solo documenta que existió.
| Dimensión | API Gateway | AI Gateway | Agent Gateway (MCP) |
| Unidad de control | Petición HTTP contra un endpoint | Inferencia contra un modelo | Invocación de herramienta dentro de una tarea de agente |
| Métrica de límite | Peticiones por segundo, cuota por consumidor | Tokens por minuto y por día, coste por agente | Llamadas por herramienta y por tarea, alcance del token |
| Patrón de tráfico | Corto, síncrono, atómico | Largo, en streaming, de coste variable | Muchas llamadas pequeñas correlacionadas dentro de una misma tarea |
| Qué inspecciona | Esquema, cabeceras, credencial de servicio | Prompt y respuesta: inyección, datos personales, contenido | Qué herramienta, con qué argumentos y en nombre de quién |
| Qué cachea | Respuesta por clave exacta | Caché semántica por similitud del prompt | Metadatos de descubrimiento, y solo si el ámbito de caché lo permite; nunca el resultado |
| Amenaza que mitiga | Abuso de API, credencial filtrada, saturación del backend | Inyección de prompt, fuga de datos, Denial-of-Wallet | Herramienta con descripción manipulada, servidor no aprobado, agente usado como intermediario confundido |
| Quién lo opera | Equipo de integración | Plataforma de IA | Plataforma de IA con los dueños de dominio |
| Qué NO puede hacer | Entender qué está haciendo el modelo ni cuánto cuesta | Proteger el backend de la carga que genera el agente | Sustituir a la autorización del sistema final ni entender la intención de una secuencia |
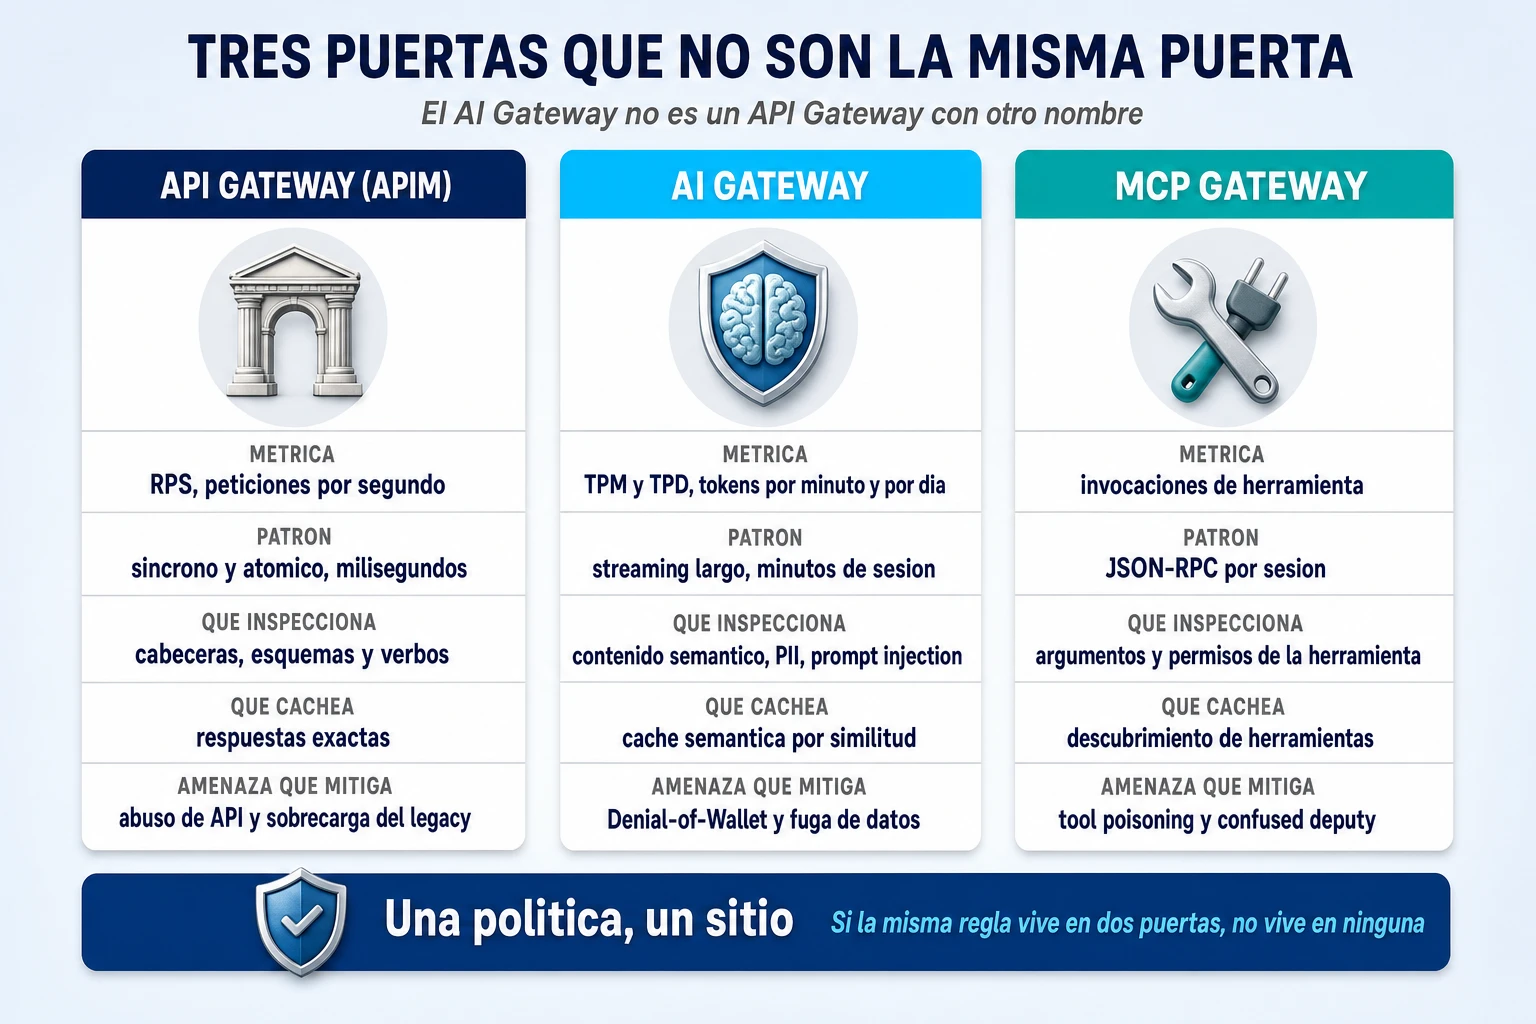
Recomendación: tres puertas, tres dueños y una regla que ahorra años de discusión —una política, un sitio—. Si se puede escribir en términos de tokens, modelos o prompts, vive en el AI Gateway. Si se escribe en términos de herramientas y tareas de agente, en el Agent Gateway. Si se escribe en términos de endpoints y backends, en el gateway de APIs. Cuando una política vive en dos sitios acaba sin vivir en ninguno, porque cada equipo supone que la aplica el otro.
API, Tool y capability: tres cosas que se confunden
La mitad de los errores de diseño de esta arquitectura nacen de confundir tres conceptos que se parecen y no son lo mismo. Conviene resolverlo antes de entrar en MCP, porque todo lo que viene después se apoya en esta distinción.
Una API es un contrato técnico para que otro software consuma un sistema. Su audiencia es un programador que ya sabe lo que quiere. Su granularidad es la del sistema: si este separa cliente, contrato y consumo en tres tablas, la API tendrá tres recursos.
Una tool —herramienta— es una capacidad expuesta a un agente. Su audiencia es un modelo que tiene que decidir si la necesita, y lo decide leyendo su nombre y su descripción, no su documentación. Eso cambia el diseño entero: nombre de negocio, descripción interpretable, esquema de entrada acotado, errores que el modelo sepa leer y respuesta pensada para un modelo.
Una capability empresarial —capacidad de negocio— es lo que la compañía sabe hacer, con independencia del sistema que lo implemente: «comprobar la cobertura en una dirección», «emitir una nota de crédito». Vive en el mapa de capacidades, no en un repositorio, y sobrevive a los sistemas que la implementan.
| Dimensión | API | Tool (herramienta) | Capability empresarial |
| Audiencia | Un programador que ya sabe qué quiere | Un modelo que tiene que decidir si la necesita | La dirección de la compañía y la arquitectura empresarial |
| Contrato | Especificación técnica: rutas, métodos, esquemas, códigos de error | Nombre, descripción, esquema de entrada acotado, errores legibles, ejemplos y contraejemplos | Descripción de negocio: qué resultado produce y para quién |
| Granularidad | La del sistema que expone | La de la intención del usuario | La del proceso de negocio |
| Cómo se nombra | Con el vocabulario del sistema | Con el vocabulario del negocio, en verbo y objeto | Con el vocabulario de la compañía, estable en el tiempo |
| Dueño | El equipo que mantiene el sistema | El dueño del dominio, con la plataforma | El responsable del proceso de negocio |
| Versionado | Por versión de contrato, con deprecación anunciada | Por versión de herramienta, con el nombre en el espacio de nombres del dominio | Casi nunca cambia; cambian sus implementaciones |
| Descubrimiento | Portal de APIs e inventario | Catálogo de herramientas y registro, filtrado por identidad y rol | Mapa de capacidades |
| Cómo se prueba | Pruebas de contrato deterministas | Conjunto de evaluación: ¿la elige cuando toca y no la elige cuando no toca? | Por resultado de negocio |
La idea que hay que retener: una capability se implementa con una o varias APIs y se expone a los agentes como una o varias tools. Los tres niveles no se corresponden uno a uno. «Emitir una nota de crédito» puede necesitar tres llamadas a dos sistemas y exponerse como una sola herramienta; y una API de consulta genérica puede dar pie a cuatro herramientas porque responde a cuatro intenciones.
Pretender que la correspondencia es uno a uno es lo que produce catálogos inservibles. Una herramienta por endpoint da un catálogo enorme donde el modelo no sabe elegir; una herramienta por capacidad sin mirar qué APIs hay debajo da herramientas que no se pueden implementar. El trabajo está en el medio, y tiene dueño: el dueño del dominio.
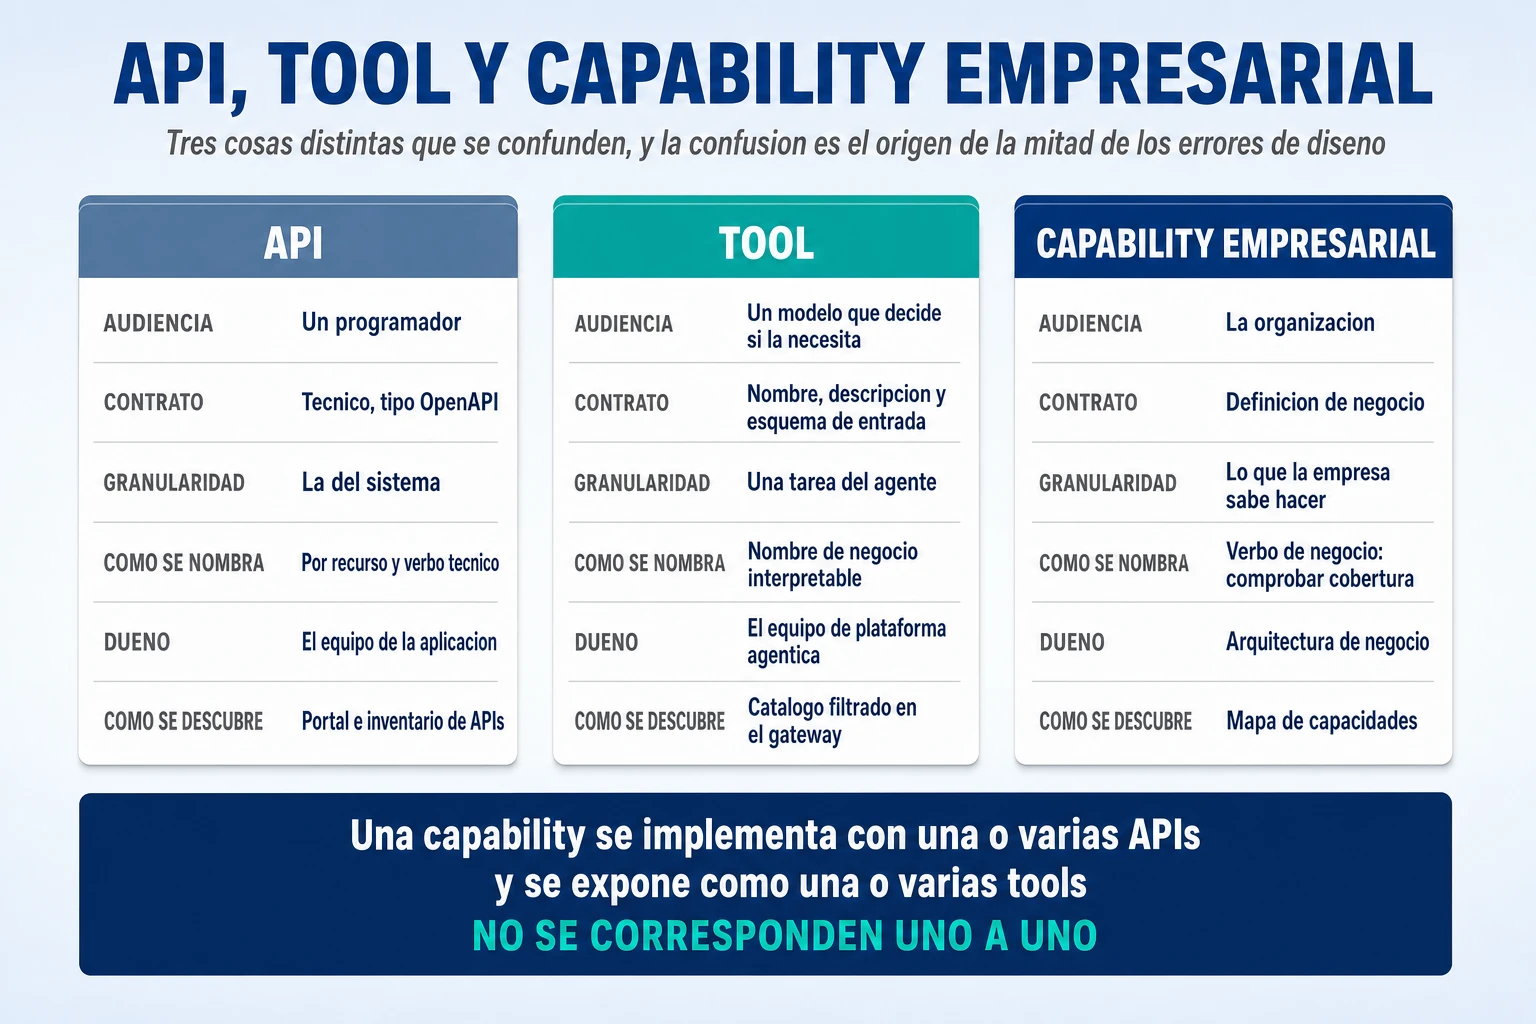
Recomendación: antes de publicar la primera herramienta de un dominio, escriba sus diez capacidades de negocio en una lista, sin mirar los sistemas. Después mire qué APIs hay para cada una. La distancia entre las dos columnas es el trabajo real del programa.
Capa 4: MCP y el Agent Gateway
MCP —Model Context Protocol— es un protocolo abierto para que un modelo descubra e invoque herramientas con un contrato estándar, en lugar de un conector a medida por sistema y por framework. El valor está en la aritmética que evita: sin protocolo común, integrar N sistemas con M frameworks cuesta N×M conectores; con protocolo común, cuesta N.
Para un comité hay dos datos que cambian la conversación. El primero es de gobierno: MCP dejó de ser el formato de un fabricante y su especificación se mantiene bajo una fundación, con una política de ciclo de vida que garantiza doce meses mínimos entre la deprecación de una funcionalidad y su retirada. Un protocolo con política de deprecación publicada es un protocolo sobre el que se puede planificar, y eso vale más que cualquier cifra de adopción. De paso, dos deprecaciones que afectan a decisiones de compra: el transporte antiguo basado en eventos de servidor y el registro dinámico de clientes de OAuth.
Qué es MCP hoy, y no en su versión de 2024
El segundo dato es técnico. La línea de revisiones es 2024-11-05 → 2025-03-26 → 2025-06-18 → 2025-11-25 → 2026-07-28, y la vigente es la última, que se compara contra la de noviembre de 2025. Buena parte del material que circula describe la versión de 2024 o la de mediados de 2025 y ya no es exacto.
El cambio importante es que MCP dejó de ser un protocolo con sesión. Desaparecen el saludo inicial de negociación y la cabecera de sesión; la versión de protocolo y las capacidades viajan en cada petición, y cada petición es autocontenida. Aparece además una operación de descubrimiento obligatoria para los servidores.
La consecuencia práctica: un servidor MCP ya se despliega detrás de un balanceador normal, sin sesiones pegajosas ni almacén de sesión compartido, y en un clúster Kubernetes los despliegues progresivos y el autoescalado dejan de ser visibles para el cliente. Esa es la señal de madurez, y es más informativa que cualquier número de descargas. La contrapartida: el estado no desaparece, se hace explícito en identificadores que el servidor acuña y que hay que atar al usuario autenticado, porque un identificador de estado es un nombre, no un permiso.
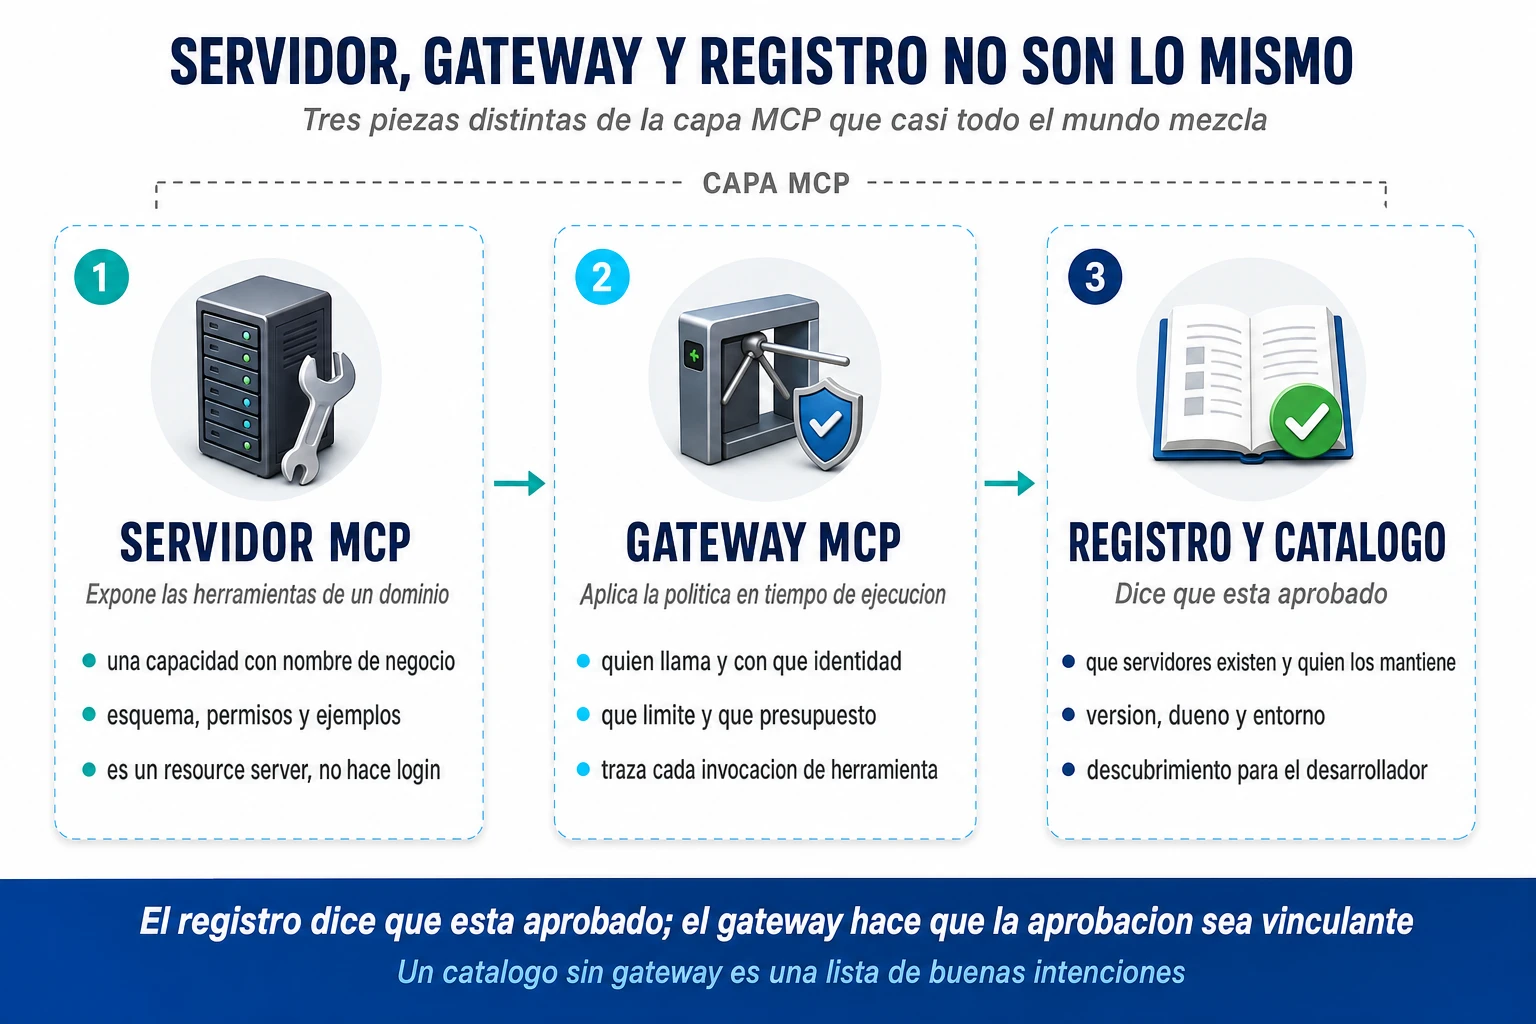
Servidor, gateway y registro son tres piezas distintas, y una de ellas se suele nombrar mal
- Servidor MCP. Expone las herramientas de un dominio —facturación, inventario, CRM, provisión—. Lo mantiene el dueño de ese dominio, que es quien sabe qué significa cada operación y qué pasa si se invoca mal.
- Agent Gateway (o gateway MCP). Aplica la política en tiempo de ejecución: quién puede llamar a qué, con qué identidad, con qué argumentos, con qué límite y dejando qué traza.
- Registro o catálogo. Declara qué servidores y herramientas están aprobados, qué datos tocan, qué nivel de riesgo tienen y quién responde de ellos.
Y aquí va la corrección más importante, porque el mercado la tiene del revés: el Agent Gateway no es el plano de control. Es un punto de aplicación de política. El plano de control lo forman otras tres cosas: el motor y repositorio de políticas, el sistema de identidad y el catálogo o registro.
Punto de decisión y punto de aplicación: quién decide y quién obliga
No es una sutileza ni una opinión: es el reparto estándar de la industria, el mismo de la gestión de APIs y las mallas de servicio, y está escrito en la arquitectura de confianza cero del NIST. Son cuatro papeles:
- El punto de aplicación de política intercepta la petición, pregunta si se permite y ejecuta la respuesta. No decide.
- El punto de decisión evalúa la petición contra las políticas y responde permitir o denegar. Decide, pero no ve el tráfico ni puede bloquear nada.
- El punto de administración gestiona el ciclo de vida de las políticas y del inventario: qué existe, qué está aprobado y desde cuándo.
- El punto de información aporta el contexto con el que se decide: grupos de esta persona, clasificación de este dato, riesgo de esta herramienta.
| Plano | Pieza | Qué hace | Qué NO hace |
| Control | Motor y repositorio de políticas | Define y evalúa qué está permitido; versiona y distribuye la política | No ve el tráfico ni puede bloquear nada por sí mismo |
| Control | Sistema de identidad (IdP corporativo) | Autentica, emite tokens con destinatario y alcance acotados, aporta atributos, revoca | No conoce la semántica de las herramientas |
| Control | Catálogo y registro empresarial | Declara qué servidores y herramientas están aprobados, con qué metadatos y para quién | No tiene poder de ejecución: es declarativo |
| Datos | Agent Gateway | Intercepta cada invocación, autentica, consulta al motor de políticas, aplica la decisión, filtra el catálogo, limita, registra y traza | No decide la política, no es la fuente de verdad del catálogo y no es la autoridad de identidad |
Esto no es una lectura de parte. Un trabajo en curso del grupo de autorización de la OpenID Foundation define cómo se traducen los mensajes MCP a peticiones de una API de autorización estándar, y reparte los papeles igual: el punto de aplicación es el gateway MCP —o el propio servidor, si no hay gateway— y la decisión la toma un motor de políticas externo, con autorización al nivel del parámetro: si este agente, actuando por esta persona, puede llamar a esta herramienta con estos argumentos. Cautela: son borradores en maduración, no norma cerrada.
Merece la pena nombrar el conflicto, porque explica por qué la categoría está confusa: parte del mercado vende su gateway MCP como «el plano de control para agentes empresariales» y otra parte separa correctamente aplicación de política y plano de control. La terminología estándar respalda a los segundos. Quien compre con la primera lectura acabará con aplicación sin inventario.
El catálogo declara qué está aprobado. La política decide. El gateway hace que la aprobación sea vinculante. Un registro sin gateway es política sin aplicación; un gateway sin registro es aplicación sin criterio.
Qué hace un Agent Gateway en cada invocación
Lo más interesante de la revisión vigente es que el protocolo le hizo sitio al intermediario: no es que el gateway se cuele, es que la especificación lo prevé. Tres cambios lo demuestran.
El primero: las peticiones llevan cabeceras obligatorias con el método y el nombre de la herramienta, para que balanceadores, gateways y herramientas de observabilidad enruten e inspeccionen sin abrir el cuerpo del mensaje.
El segundo: hay un error específico para el desajuste entre cabecera y cuerpo, precisamente para evitar que un balanceador enrute según la cabecera mientras el servidor ejecuta lo que dice el cuerpo. El tercero: los listados llevan campos de caché obligatorios, con un ámbito que controla si un intermediario compartido puede guardar la respuesta.
| Función en tiempo de ejecución | Qué hace exactamente | Qué pasa si no está |
| Autenticar | Valida el token y comprueba que fue emitido para él, no para otro destinatario | Un token obtenido para otro servicio vale aquí; la reutilización de credenciales entre servicios deja de detectarse |
| Autorizar la invocación | Consulta al motor de políticas: este sujeto, este agente, esta herramienta, estos argumentos | El permiso efectivo es el del token, que casi siempre es más amplio que la operación |
| Filtrar el catálogo | Devuelve solo las herramientas que corresponden al rol, el dominio y el usuario en cuyo nombre se actúa | El modelo ve herramientas que no puede usar, gasta contexto en ellas y elige peor |
| Validar argumentos | Comprueba el esquema de entrada y aplica restricciones de valor —importe máximo, ámbito de cliente, rango de fechas— | La autorización es por nombre de herramienta, que es demasiado grueso para operaciones con consecuencia |
| Limitar | Llamadas por herramienta y por tarea, cuotas, tiempos de espera | El bucle del agente se convierte en carga del sistema de destino |
| Registrar y auditar | Toda invocación con argumentos saneados, identidad, resultado e identificador de traza | No se puede responder a «qué hizo el agente X el martes», que es la primera pregunta del auditor |
| Desambiguar | Prefija los nombres de herramienta con el dominio al agregar varios servidores | Dos servidores con una herramienta llamada igual comparten la política que autoriza a uno de ellos |
Autorización: el servidor MCP no debe hacer login
El modelo de autorización coloca al servidor MCP como recurso protegido: valida tokens, no los emite. La traducción cabe en una línea: el servidor MCP no debe autenticar a nadie, debe delegar en el proveedor de identidad corporativo. Uno que gestione sus propias credenciales es un silo de identidad nuevo, con sus propias bajas que nadie ejecuta. Y hay una consecuencia organizativa: montar servidores MCP no es un proyecto del equipo de IA, es un proyecto del equipo de identidad con ayuda del equipo de IA.
La segunda regla es la que más se incumple: el token que llega no se reenvía tal cual hacia abajo. La especificación prohíbe aceptar tokens que no fueron emitidos para uno y transitarlos, porque eso salta los controles que dependen del destinatario, hace que la auditoría de abajo registre una identidad equivocada y convierte al servidor en un proxy de exfiltración si el token es robado. Cada salto valida que el token era para él y obtiene una credencial de alcance menor para el siguiente.
Existe un estándar de intercambio de tokens para hacer eso, y conviene situarlo bien: no forma parte de los requisitos de conformidad de la autorización MCP. Es un patrón de arquitectura de gateway, no una exigencia del protocolo.
Queda un dato de realidad que es, además, el mejor argumento a favor del gateway. La extensión oficial pensada para empresa —en la que el proveedor de identidad evalúa la política antes de emitir el token, de modo que un empleado sin autorización nunca recibe credencial— aparece soportada, en la matriz oficial de clientes, por un número muy reducido de ellos; los más usados no la soportan. De ahí la conclusión: si el cliente no implementa el control, el control tiene que estar en la ruta de datos.
Los riesgos, y por qué el gateway es necesario y no suficiente
Cuatro riesgos hay que mirar de frente, y ninguno necesita siglas:
- Descripción de herramienta manipulada. La descripción entra en el contexto del modelo, así que manipularla es inyección de prompt con privilegios. Está demostrado sobre servidores reales, y el hallazgo incómodo es que los modelos más capaces resultaron más susceptibles. Las descripciones son código, no documentación, y se revisan como código.
- Cambio de definición después de la aprobación. Un servidor se aprueba con unas herramientas y cambia sus descripciones más tarde. El control: guardar en el registro la huella de la definición aprobada y compararla en cada refresco, fallando cerrado si no coincide.
- Servidores no aprobados. Servidores MCP en el portátil de un desarrollador, conectados a sistemas reales con credenciales reales. La detección por red funciona para lo remoto y no funciona para lo local, que es donde vive buena parte del riesgo. El control eficaz no es prohibirlo: es que el catálogo aprobado sea más cómodo que montárselo por su cuenta.
- El agente como intermediario confundido. El agente tiene permisos amplios porque sirve a muchos usuarios; uno le pide algo que él no podría hacer y el agente lo hace con sus propios permisos. No hay vulnerabilidad técnica: hay un fallo de diseño de autorización, y se resuelve reduciendo el alcance del token antes de la tarea.
Y ahora el contrapeso. Hay ataques documentados que no implican ninguna herramienta maliciosa ni ninguna llamada no autorizada, y que acaban en exfiltración. El mejor documentado es de mayo de 2025, sobre el servidor MCP de un repositorio de código muy usado: un atacante publica una incidencia en un repositorio público, el desarrollador pide a su agente que revise las incidencias abiertas, el agente lee ese texto como instrucción y usa el acceso que ya tenía —que alcanzaba los repositorios privados— para sacar datos y publicarlos donde el atacante los ve.
Ninguna herramienta era maliciosa, ninguna definición estaba manipulada, ninguna llamada estaba sin autorizar. Un punto de aplicación que autorice llamada a llamada las habría permitido todas, porque el ataque está en la composición de herramientas legítimas dentro de un mismo agente. Los propios investigadores lo dijeron sin rodeos: no es un fallo del código del servidor, es un problema arquitectónico del sistema de agente.
El Agent Gateway es necesario y no es suficiente. Reduce el radio de explosión —menos alcance, menos herramientas, filtrado de salida— y no puede distinguir una llamada legítima de una llamada legítima inducida por un atacante.
Lo que sí reduce ese riesgo vive por encima del gateway: acotar el alcance del token antes de empezar —un cliente, un expediente, un repositorio por tarea—, separar lectura de escritura y exigir confirmación humana en lo que publica o modifica.
| Riesgo | Control en el plano de control | Control en el Agent Gateway | Control en el agente |
| Descripción manipulada | Curación y revisión humana antes de aprobar; no admitir servidores sin auditar | Sanear descripciones y aislar servidores entre sí; interceptar antes de la llamada | Mostrar al usuario la descripción completa que ve el modelo |
| Cambio de definición tras la aprobación | Fijar versión y huella del artefacto aprobado | Comparar la huella en cada refresco y fallar cerrado | Volver a pedir consentimiento cuando cambia una definición |
| Servidores no aprobados | Inventario autoritativo y proceso de alta obligatorio | Bloquear el tráfico MCP que no venga por el camino aprobado | Política de dispositivo para los servidores locales, donde el gateway no llega |
| Intermediario confundido | Alcance mínimo por tarea; preferir metadatos de cliente al registro dinámico | Consentimiento por cliente; coincidencia exacta de la URL de retorno | Validar el emisor del token antes de canjear nada |
| Exfiltración por composición | Reducir el alcance antes de la tarea; clasificar los datos en el registro | Correlación de secuencias y filtrado de datos en la salida | Aquí está el control decisivo: aislar contextos y exigir humano en el bucle para publicar o escribir |
| Reenvío del token del usuario | Un emisor que soporte destinatario acotado e intercambio de tokens | Validar el destinatario del token entrante y obtener credencial propia hacia abajo | No enviar tokens a servidores distintos del que los emitió |
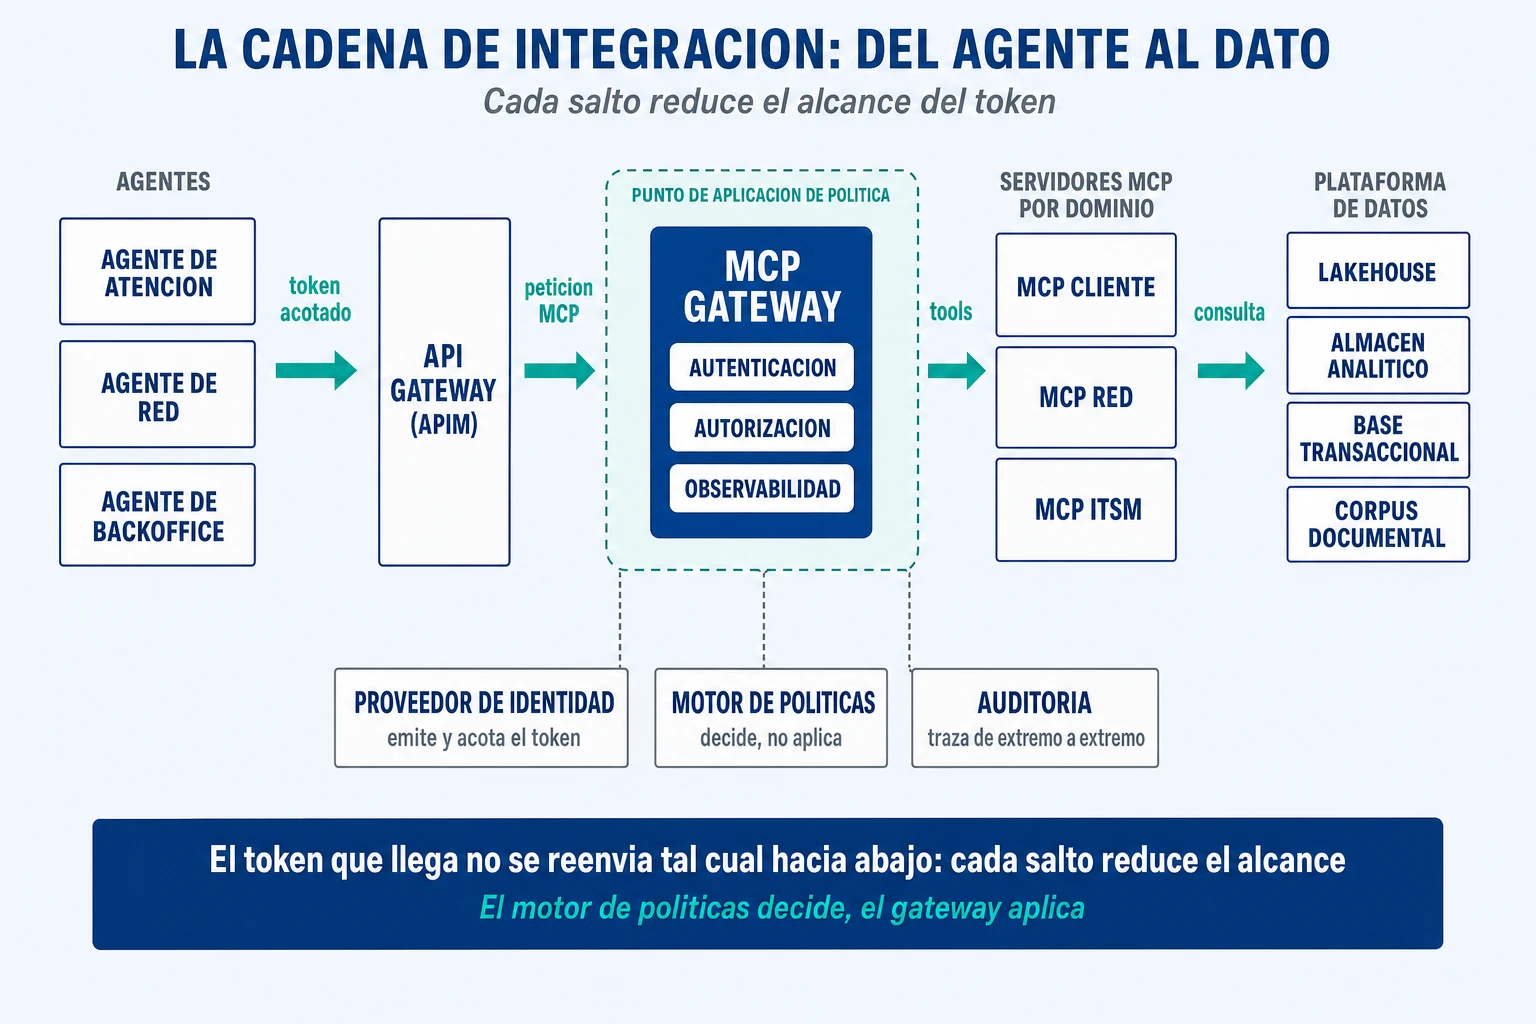
Recomendación: monte el gateway y el registro a la vez, nunca uno sin el otro, y escriba en una página quién es el punto de decisión. Si la respuesta es «el gateway decide», no tiene plano de control: tiene un portero improvisando. Y presupueste lo que ningún producto le dará: el inventario de herramientas con su dueño, su clasificación de datos y su nivel de riesgo.
Tool discovery y filtrado dinámico de herramientas
El problema es aritmético y aparece antes de lo que nadie espera: el catálogo crece y la ventana de contexto no. Cada herramienta publicada ocupa espacio describiéndose antes de que empiece el trabajo, y a partir de cierto número el modelo no solo gasta más: elige peor.
Los umbrales medidos son más bajos de lo que se suele suponer: la precisión al elegir herramienta cae por debajo del 90 % a partir de diez o quince herramientas en los modelos pequeños y de veinte o treinta en los medianos. Use esos órdenes de magnitud y desconfíe de la cifra de «cuarenta o cincuenta» que circula sin medición detrás: contradice a las que sí existen.
El dato que mejor explica el problema viene de un catálogo real desplegado, con 110 agentes y 584 herramientas. Al escalar de diez a ciento diez agentes, la calidad del enrutado cae entre 16 y 23 puntos en tres modelos de dos proveedores. Lo valioso es que separa las dos causas, que suelen confundirse.
- Una parte de la caída es de recuperación: el modelo no consigue traer al contexto la herramienta correcta. Es infraestructura, y la búsqueda de herramientas recupera diez u once puntos.
- La otra parte es de confusión: incluso con recuperación perfecta el techo baja unos diez puntos. Es diseño: hay herramientas que no se distinguen entre sí.
La búsqueda de herramientas le devuelve la mitad de lo que perdió. La otra mitad solo la recupera el diseño.
Es el mejor argumento cuantitativo del capítulo, y conviene tenerlo a mano cuando alguien proponga resolver el catálogo comprando un gateway con buscador: ayuda, y no basta. Un matiz honesto del mismo estudio: en tráfico real la mejora se confirma, pero el rendimiento absoluto es entre diez y quince puntos inferior al de laboratorio.
Filtrado dinámico: el catálogo que ve el agente no es el catálogo que existe
Filtrado dinámico significa que cada agente ve solo las herramientas que le corresponden según cuatro cosas: su rol, su dominio, el usuario en cuyo nombre actúa y la tarea en curso. Un agente de atención que no puede tocar nada de red no debe ver las herramientas de red; no solo porque las tenga prohibidas, sino porque cada una que ve le resta precisión en las que sí necesita.
Hay un matiz normativo contraintuitivo que conviene contar bien. Con la revisión vigente los listados de herramientas ya no varían por conexión —eso desapareció con las sesiones—, pero sí pueden variar según la autorización que presenta la petición. El catálogo se filtra por el token, que viaja en cada llamada, no por el estado de una sesión. Eso es lo que legitima que el filtro viva en el gateway y no en el agente.
Primera consecuencia, y es el error más común de los despliegues que parecen bien montados: filtrar el listado no es un control de seguridad, es una reducción de superficie. El modelo puede conocer el nombre de una herramienta por una conversación anterior, por una caché o inventándolo, así que la política tiene que volver a aplicarse en la invocación, con lista blanca y denegación por defecto.
La segunda consecuencia es más sutil. La especificación obliga a declarar el ámbito de caché de los listados. Un catálogo filtrado por identidad marcado como cacheable por intermediarios compartidos es una fuga: otro agente puede recibir el catálogo de alguien con más permisos. Tiene que ir como privado. Es un ejemplo de que el filtrado dinámico tiene consecuencias en la capa de transporte, y de que un detalle de configuración puede anular un control de autorización.
Descubrimiento progresivo, espacios de nombres y retirada
Descubrimiento progresivo es lo contrario de inyectar el catálogo entero: el agente ve unas pocas herramientas esenciales y una de búsqueda, y localiza el resto cuando le hacen falta. Los mantenedores del protocolo lo han reconocido como problema abierto y le han dedicado un grupo de trabajo. Detalle de coste: la búsqueda añade definiciones en lugar de intercambiarlas, y por eso preserva la caché de prompt.
Para catálogos muy grandes queda una vía de escape —exponer una interfaz tipada y dejar que el modelo escriba código contra ella en un entorno aislado—, que funciona y no debe ser la puerta principal. Y tres disciplinas aburridas y necesarias. Espacios de nombres por dominio: la unicidad del nombre solo está garantizada dentro de un servidor, así que al agregar varios hay que prefijar; si no, dos herramientas llamadas igual comparten la política que autoriza a una. Versionado: cambiar el esquema sin versión rompe agentes en silencio. Retirada: fecha de revisión y procedimiento de baja, porque un catálogo que solo crece acaba siendo el problema que intentaba resolver.
Y la pregunta de gobierno, que nunca tiene dueño: ¿quién aprueba que una herramienta entre en el catálogo y quién la retira? El reparto que funciona: el dueño del dominio propone y responde de la semántica; la plataforma revisa contrato, esquema y errores; seguridad revisa alcance y clasificación de datos; y el catálogo registra quién aprobó y cuándo toca revisar. Sin ese circuito, el catálogo lo escribe quien tiene más prisa.
| Síntoma | Causa | Intervención | Qué recupera |
| El agente no encuentra la herramienta correcta en un catálogo grande | Recuperación: la herramienta no llega al contexto | Búsqueda de herramientas y descubrimiento progresivo | Unos diez u once puntos de la caída medida, y una reducción grande del contexto ocupado |
| El agente elige una herramienta parecida a la correcta | Confusión: dos herramientas no se distinguen semánticamente | Rediseño: nombres de negocio, descripciones que dicen cuándo usarla y cuándo no | La mitad restante. Ninguna infraestructura lo arregla |
| El agente acierta la herramienta y falla los parámetros | Descripción insuficiente del esquema | Añadir ejemplos de uso a la definición | Es la intervención más barata medida: del 72 % al 90 % en manejo de parámetros complejos |
| El agente ve herramientas que no puede usar | Falta de filtrado por identidad y rol | Filtrado en el gateway según el token, más reautorización en la invocación | Contexto, precisión y una superficie de ataque menor |
| Dos equipos construyen la misma herramienta | Catálogo no usable o no buscable | Catálogo con búsqueda, ejemplos y permisos visibles | Tiempo de desarrollo y coherencia del vocabulario |
| Un cambio de esquema rompe un agente sin aviso | Herramienta sin versión ni contrato estable | Versionado explícito y espacio de nombres por dominio | La capacidad de cambiar el backend sin romper al agente |
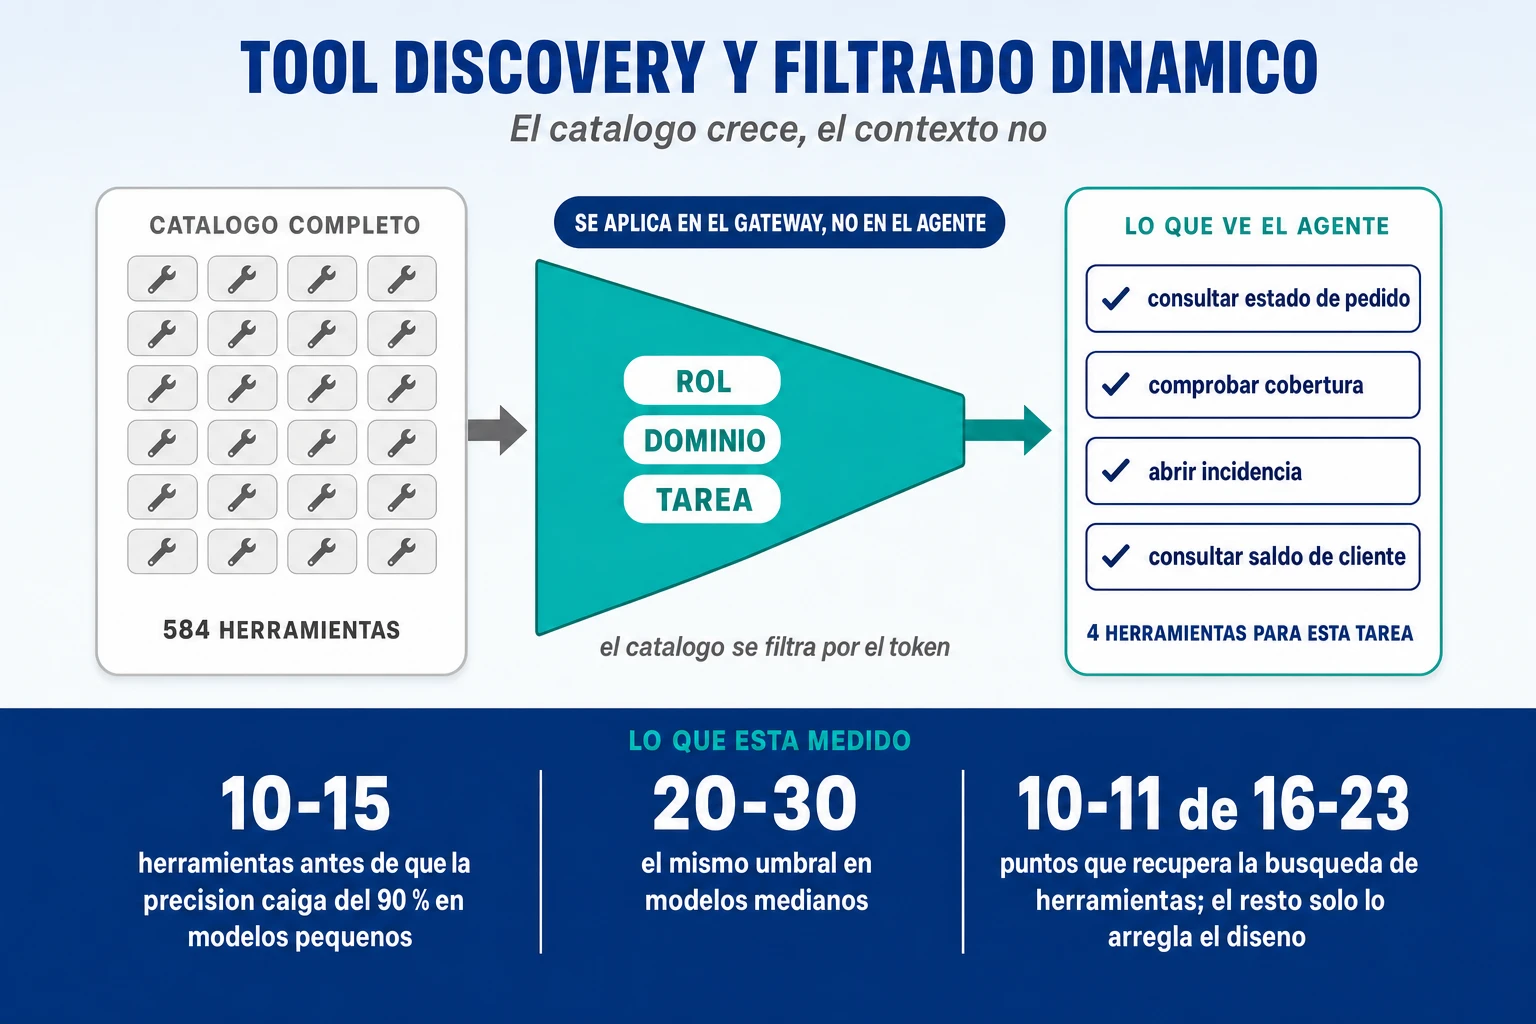
Recomendación: ponga un tope explícito de herramientas visibles por agente —veinte es un buen número de partida— y trate rebasarlo como una decisión que alguien firma. Y mida dos cosas desde el primer día: cuántas veces el agente elige la herramienta equivocada y cuántas acierta la herramienta y falla los parámetros. Son dos problemas distintos con dos arreglos distintos.
APIficar y MCPificar no son la misma operación
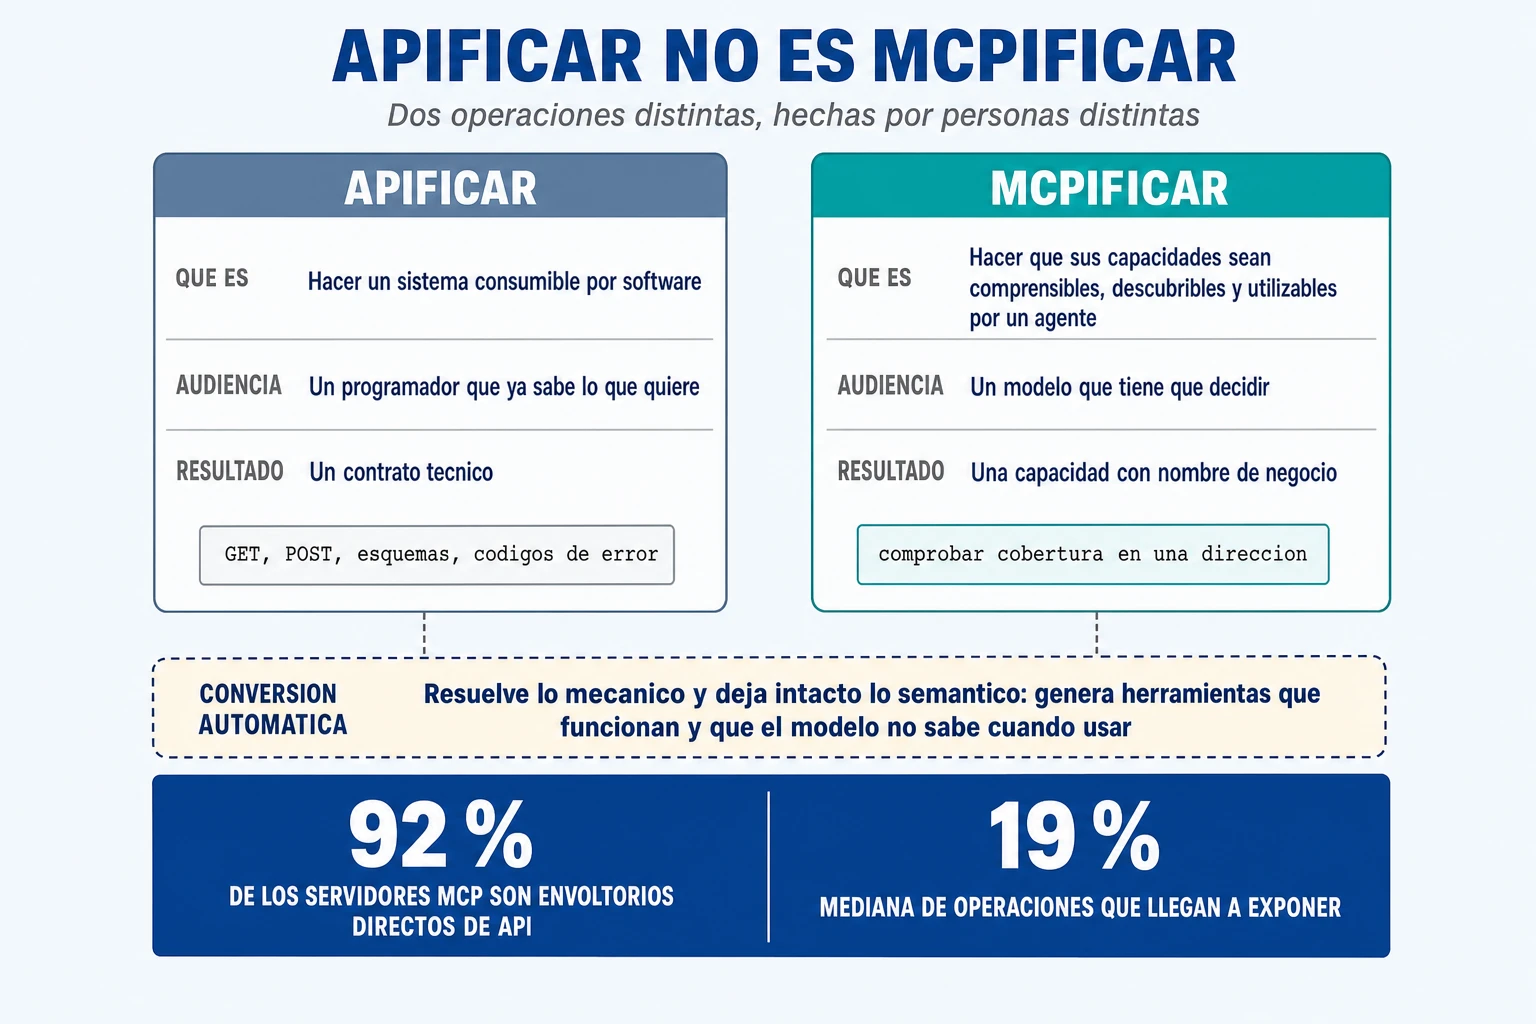
APIficar es hacer que un sistema sea consumible por software: poner delante un contrato, un esquema y una autenticación. MCPificar es hacer que sus capacidades sean comprensibles, descubribles y utilizables por un agente. No es lo mismo, no se mide igual y no lo hace la misma persona: lo primero lo hace ingeniería de integración; lo segundo exige a alguien que sepa qué significa una nota de crédito en esta compañía.
La conversión automática resuelve el problema mecánico y deja intacto el semántico
Se repite mucho que convertir automáticamente un contrato de API en servidor MCP «no funciona». Es impreciso, y la imprecisión importa. Hay un estudio empírico sobre 116 servidores MCP oficiales y 80 contratos de API reales que mide justo esto, y mide lo contrario: la generación automática funciona técnicamente en el 76 % de los casos, y sube al 94,2 % si además se repara automáticamente la especificación de partida.
Lo que produce, entonces, no es código roto: es un servidor que funciona y cuyas herramientas el modelo no sabe cuándo usar —granularidad equivocada, nombres técnicos sin significado, parámetros sin contexto, explosión de herramientas y errores que el modelo no puede interpretar para corregirse—. La formulación correcta: la conversión automática resuelve el problema mecánico y deja intacto el semántico.
El mismo estudio trae tres cifras que retratan el sector. El 88,6 % de los servidores MCP están respaldados por APIs REST: MCP se apoya en la apificación, no la sustituye. El 92 % implementa sus herramientas como envoltorios directos de la API. Y exponen una mediana del 19 % de las operaciones disponibles.
Ese 19 % es la prueba de que alguien decide qué exponer y qué descartar. Esa decisión es la MCPificación. El filtrado y el reagrupamiento automáticos reducen el número de herramientas en un tercio; el resto exige criterio de dominio, que es lo que ninguna herramienta genera.
Cuidado: hacer herramientas a mano sin semántica de negocio es peor que no hacer nada
Aquí está el dato más importante de la sección, y va antes de cualquier recomendación porque impide la lectura perezosa de todo lo anterior. Una medición controlada —diecisiete tareas empresariales, cuatro modelos pequeños, temperatura cero, más de seiscientas ejecuciones— compara tres diseños de servidor MCP sobre la misma base de datos.
| Diseño del servidor MCP | Puntuación de acierto | Qué significa |
| Pack de herramientas genéricas hecho a mano, una por tabla, envoltorio fino | 0,605 | Escritas por personas, sin semántica de negocio dentro |
| SQL crudo: ninguna herramienta, el esquema en el contexto | 0,666 | No hacer nada rinde mejor que el diseño anterior |
| Pack de herramientas alineadas al dominio, con consultas parametrizadas que encapsulan los cruces y las reglas de negocio | 0,939 | La diferencia no está en quién las escribe: está en qué llevan dentro |
Léase la segunda fila dos veces. Escribir herramientas a mano sin semántica de negocio rinde peor que no escribir ninguna. En palabras de los autores, el valor lo crea el diseño de la herramienta, no su existencia. Un equipo que escriba a mano una herramienta por endpoint creyendo que sigue el consejo habrá empeorado su sistema.
El eje correcto no es manual frente a automático. Es alineado al dominio frente a no alineado. Una herramienta generada automáticamente pero enriquecida con criterio de negocio vale más que diez escritas a mano que solo renombran endpoints.
El segundo hallazgo del mismo estudio es el mejor argumento de negocio de la sección: el modelo más pequeño de los cuatro pasa de 0,583 a 0,929 con el pack de dominio, igualando a configuraciones mayores, y el coste por respuesta correcta mejora en un orden de magnitud. Dicho de otro modo: un buen diseño de herramientas permite usar modelos más baratos. Esa palanca económica no caduca con la siguiente generación de modelos.
Las limitaciones conviene declararlas: un solo esquema pequeño, cuatro modelos locales modestos, sin modelos de frontera. Es una medición controlada, no una ley; pero es la mejor que hay y nadie ha publicado una que la contradiga.
| Dimensión | APIficar | MCPificar |
| Qué produce | Un contrato técnico estable y validado sobre un sistema | Un conjunto acotado de capacidades que un modelo puede elegir bien |
| Quién lo hace | Ingeniería de integración | El dueño del dominio, con la plataforma |
| Entregable | Especificación de la API, autenticación, límites, versión | Nombre de negocio, descripción con casos de uso y contraejemplos, esquema acotado, errores legibles, reglas de dominio encapsuladas |
| Qué se automatiza bien | Casi todo lo mecánico: fachadas, traducción de protocolo, validación de esquema | El descarte y el reagrupamiento, hasta un tercio. Lo demás exige criterio |
| Cómo se mide el éxito | Pruebas de contrato: la API responde lo que dice | El agente elige la herramienta correcta cuando toca y no la elige cuando no toca |
| Modo de fallo típico | Contrato desactualizado respecto al sistema | Catálogo enorme de herramientas indistinguibles con nombres técnicos |
| Qué cuesta si se salta | El agente no puede llegar al sistema | El agente llega al sistema y hace lo que no debía, con confianza |
La capa semántica de capacidades: qué es, quién la define y qué contiene
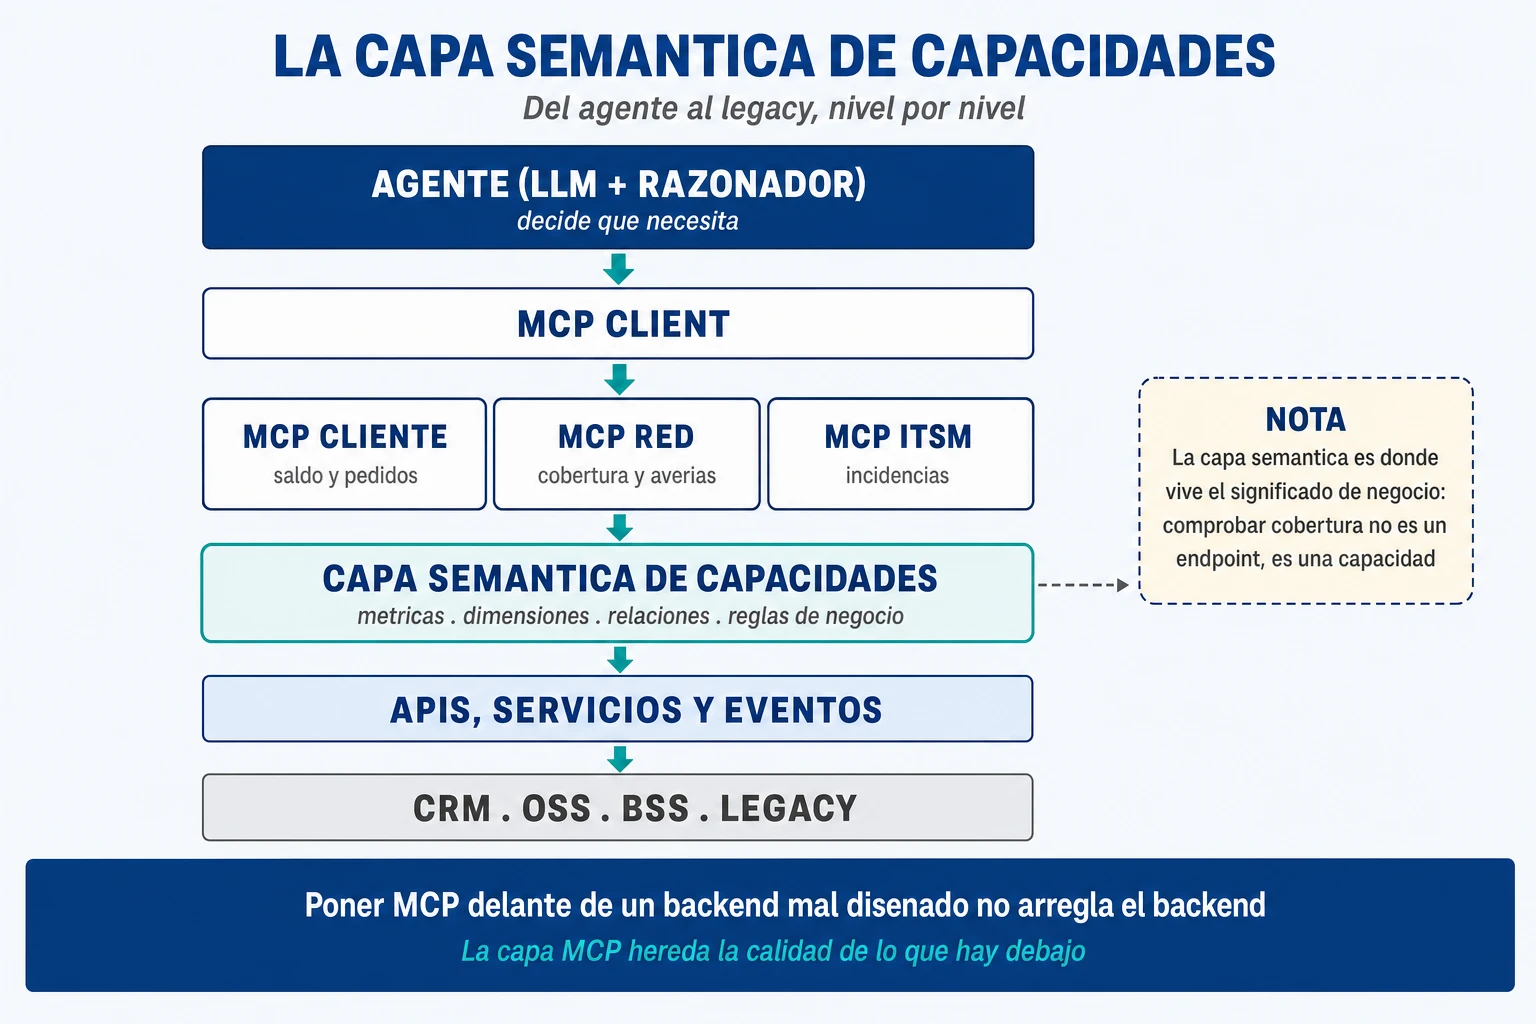
La pieza que resuelve esto tiene nombre: una capa semántica de capacidades es la abstracción entre las APIs de sistema y los servidores MCP cuya única misión es que el conocimiento de negocio esté escrito una vez y en un sitio. No es un producto; es un artefacto con dueño.
Contiene cuatro cosas: los nombres de las capacidades en lenguaje de negocio —«comprobar cobertura en una dirección», no «consultar tabla de nodos de acceso»—; los cruces entre sistemas necesarios para responder, encapsulados en el servidor y no en el prompt; las reglas de negocio —qué cuenta como cliente activo, cómo se calcula el consumo facturable—; y la traducción de identificadores técnicos a algo interpretable.
El encuadre que mejor funciona es el del diseño guiado por el dominio, porque ya está en el vocabulario de sus arquitectos: un servidor MCP es un contexto acotado y una herramienta es una capa de traducción entre el razonamiento del modelo y los tipos del sistema. De ahí la regla de nombrado más útil del artículo: nombre los servidores por su dominio, no por la API que envuelven. Un servidor llamado «facturación» sobrevive a tres migraciones; uno llamado por el sistema que envuelve muere con él.
Honestidad sobre la evidencia, porque el lector técnico lo va a comprobar: la capa semántica está bien argumentada y mal medida. Los textos que la defienden son de posición, sin métricas, y usar el mapa de capacidades de arquitectura empresarial como fuente del catálogo no tiene ningún caso documentado. La sostiene lo que sí existe: el 0,939 frente al 0,605, los diez puntos de confusión y el fracaso del texto a SQL sobre esquemas complejos.
El orden de construcción, sin dogma
Lo habitual, y lo que la evidencia respalda, es que las capacidades y las APIs sólidas vengan antes y la capa MCP después. El 88,6 % de servidores respaldados por REST no es una opinión sobre el orden correcto: es el orden observado. Y la consultora independiente que ha puesto en «esperar» la conversión ingenua recomienda construir un servidor MCP dedicado encima de las APIs que ya se tienen.
Pero hay dos matices que cambian decisiones. El primero: el servidor MCP es la fachada, así que puede preceder al arreglo del backend. En el estudio de los tres diseños, el pack de dominio no tocó el esquema ni construyó una API nueva: puso una capa semántica sobre un backend sin modificar y pasó de 0,666 a 0,939. Si la herramienta es una capa de traducción, exigir «primero un backend bueno» contradice el propósito del patrón.
El segundo: a veces la API existente es un peor punto de partida que un modelo semántico bien hecho. Una API diseñada hace doce años para una aplicación de escritorio, con parámetros que codifican decisiones de interfaz y respuestas que mezclan tres entidades, obliga al modelo a reconstruir la semántica desde cero. Envolverla es propagar el problema.
El criterio no es un orden fijo sino una pregunta: ¿existe una API que cubra la capacidad completa con vocabulario que un humano de negocio reconozca? Si sí, envuélvala y dedique el esfuerzo a la descripción y los ejemplos. Si cubre la mitad, construya la capacidad sobre ella y acepte dos llamadas. Si no existe o su vocabulario es ininteligible, empiece por la capacidad y trate la API como un detalle sustituible.
Poner MCP delante de un backend mal diseñado no arregla el backend. La capa MCP hereda la calidad de lo que hay debajo, y lo único que puede hacer es encapsularla — a cambio de que alguien escriba, una vez, el conocimiento que faltaba.
Cuatro objeciones que este argumento tiene que aceptar
- No todo necesita MCP. La misma consultora que desaconseja la conversión ingenua sitúa también en «esperar» el «MCP por defecto»: a menudo una buena interfaz de línea de comandos con ayuda de calidad, salida estructurada y errores fiables cubre las necesidades de un agente sin el impuesto de abstracción de otro protocolo.
- Hay empresas grandes haciendo lo contrario y les funciona. Equipos muy competentes han colapsado quince mil operaciones en una decena de herramientas genéricas, o treinta en una o dos. El matiz: allí el consumidor es un desarrollador, el modelo ya conoce el dominio por entrenamiento y el límite de seguridad se delega en la identidad del llamante. La granularidad correcta depende del consumidor y de cuánto sabe el modelo del dominio de antemano.
- Parte del dolor es transitorio. Sobre el mismo catálogo, los modelos de última generación aciertan mucho más que los de la anterior —treinta puntos sin tocar una herramienta, según el fabricante—. Lo que no se arregla solo es la autorización, el gobierno y la auditoría.
- Exponer la API completa como código tipado es un competidor serio. Si el camino ganador acaba siendo que el modelo escriba código contra una interfaz tipada en un entorno aislado, la inversión se desplaza hacia APIficar bien más que hacia curar herramientas, y hay mediciones que apuntan ahí. El matiz: ese enfoque también necesita semántica, solo cambia de sitio.
Recomendación: genere automáticamente para llegar rápido y cure a mano donde importa. Las veinte o cuarenta capacidades críticas de cada dominio, con nombre de negocio, descripción revisada, ejemplos, contraejemplos y errores explicados; la cola larga, detrás de una interfaz tipada y un entorno aislado. Y el criterio de aceptación de una herramienta no es que funcione: es que un conjunto de evaluación demuestre que el modelo la elige cuando toca y no la elige cuando no toca.
Capa 5: federación — A2A y la API de agente
A2A es el protocolo de federación entre agentes: permite que un agente descubra a otro, sepa qué sabe hacer y le delegue una tarea. Está también bajo gobernanza de fundación. El concepto que hay que retener es la tarjeta de agente, que describe qué sabe hacer, qué acepta y cómo se le habla: el equivalente del contrato de una API, con una diferencia —describe capacidades, no endpoints—.
El otro lado es la API de agente, que suele pasar desapercibida. Un agente también es proveedor, y al publicarse para que lo consuman otros sistemas pasa a ser una API más del catálogo, con contrato, versión, nivel de servicio, dueño y política de deprecación. Si acaso hay una exigencia adicional: una API determinista devuelve lo mismo siempre y un agente no, de modo que su contrato tiene que decir qué garantiza y qué no.
A2A no es una excusa para no tener contratos. Que dos agentes «se entiendan en lenguaje natural» no elimina la necesidad de un contrato: la esconde en el peor sitio posible, la interpretación de un modelo.
Recomendación y criterio de frontera: A2A para delegación entre dominios con dueños distintos —el agente de atención pide al de logística que reprograme una entrega—, y llamada directa a herramienta dentro del mismo dominio. La prueba para decidir: intente escribir la petición como una función con parámetros tipados. Si sale, no necesita A2A. A2A empieza a aportar cuando la petición es ambigua, requiere negociación —fechas alternativas, compensaciones— o depende de conocimiento que solo tiene el otro dominio.
Capa 6: la integración con el legacy
Es la capa que decide si el proyecto agéntico de una gran empresa avanza o se queda en demos: el punto donde la arquitectura nueva se encuentra con treinta años de sistemas que funcionan y que nadie va a reescribir.
El agente no habla con el sistema. Habla con el contrato.
Conviene empezar por lo que hace el gateway de APIs y el AI Gateway no puede hacer: autenticación mutua con certificados, OAuth de servicio a servicio, traducción de SOAP a REST, versionado de contratos, límite por peticiones por segundo, cortocircuitos ante backends degradados y cuotas por consumidor. Ninguna se puede saltar porque quien llame sea un agente.
El contrato tipado es el entregable, y reutilizar una API es un criterio, no un mandamiento
Lo que cambia con los agentes es el entregable: el contrato deja de ser documentación y pasa a ser un artefacto tipado y validado en el gateway. Un desarrollador que ve un campo mal documentado pregunta; un modelo se inventa qué significa, con una seguridad admirable. De ahí una regla que ahorra semanas: si la API existe pero su contrato está desactualizado, para un agente es como si no existiera.
Sobre el principio de «API primero» conviene ser preciso, porque como dogma produce malas arquitecturas. Reutilizar una API existente es lo más rápido cuando existe y cubre el caso: hereda la lógica, la autorización y la auditoría que llevan años funcionando, y en la mitad de los casos existe y nadie lo sabía. Pero no siempre existe, no siempre cubre el caso completo y a veces es peor punto de partida que el modelo semántico. La pregunta correcta es si la API cubre la capacidad, no si la API existe.
El límite de tasa como cortafuegos transaccional
El bucle de un agente puede lanzar cientos de peticiones por segundo contra un sistema cuya capacidad se mide —y se factura— en MIPS: un error de prompt se convierte en una incidencia de nivel 1 y en una línea inesperada de la factura del host. Conviene cambiar el discurso interno: el límite de tasa no es una molestia que integración le pone al proyecto de IA, es el cortafuegos transaccional que protege a la compañía del comportamiento no determinista de un componente nuevo. Y los tiempos de espera no se suben: se desacoplan, dejando la llamada al legacy corta y síncrona y el razonamiento del lado del agente, que tiene estado persistido para poder esperar.
¿Todo tiene que pasar por el gateway de APIs, incluida la recuperación documental?
La regla «todo pasa por el gateway de APIs, sin excepciones» es correcta como principio de gobierno, pero necesita matiz. Obligar a que el tráfico de recuperación documental pase por ahí tiene sentido cuando el índice vive detrás de un servicio propio, con su ciclo de vida, sus consumidores y su necesidad de cuotas. No lo tiene cuando el índice es parte del runtime del agente y lo que hay que controlar son los permisos documentales, no el perímetro: una recuperación ocurre veinte veces por conversación, y meterla por el gateway añade latencia y un salto que puede fallar sin añadir ningún control. Recomendación: por el gateway, sin excepciones, todo el acceso a sistemas de registro y datos de negocio; para la recuperación vectorial, el criterio es dónde vive el índice.
El gateway de APIs como servidor MCP: el atajo correcto, tomado con cuidado
La segunda pregunta recurrente es si el propio gateway de APIs puede exponerse además como servidor MCP y consumirse a través del Agent Gateway. Es correcto y es el camino más rápido para tener herramientas reales el primer mes en lugar del cuarto. El cuidado está en no confundir capacidad con criterio: no se debe publicar automáticamente todo el catálogo de APIs como herramientas.
Es la conclusión de la sección anterior en forma operativa: publicar mil doscientas operaciones como mil doscientas herramientas produce el catálogo indistinguible cuyo coste ya está medido, y publicar cuarenta a mano renombrando endpoints produce el diseño que rinde peor que no hacer nada.
¿Cuántas APIs existen? ¿Hay un directorio?
Es la pregunta más importante de toda la arquitectura y la que menos gente quiere responder en voz alta, porque condiciona el calendario del programa entero: si no hay inventario de APIs, no hay proyecto agéntico, hay arqueología. Lo que suele encontrarse al mirar de verdad es un portal con cuatrocientas APIs registradas, de las cuales ciento cincuenta están vivas, noventa tienen dueño localizable y cuarenta tienen el contrato actualizado; y fuera del portal, otras doscientas integraciones punto a punto que son, precisamente, las que usa el proceso crítico.
El inventario mínimo viable tiene nueve columnas —nombre de negocio, qué devuelve en lenguaje de negocio, dueño, estado, sistema de origen, lectura o escritura, clasificación del dato, límite de tasa y quién la consume— y una décima que casi nadie pone y lo cambia todo: «¿sirve para un agente?», con tres valores —sí; sí, con una fachada; no, hay que construirla—.
Recomendación: no intente inventariar las cuatrocientas; un inventario completo se abandona en el mes cinco con el treinta por ciento hecho. Inventaríe las treinta que toca el primer caso de uso, deje el formato montado y haga que cada caso posterior añada las suyas.
Capa 7: la arquitectura de datos para agentes
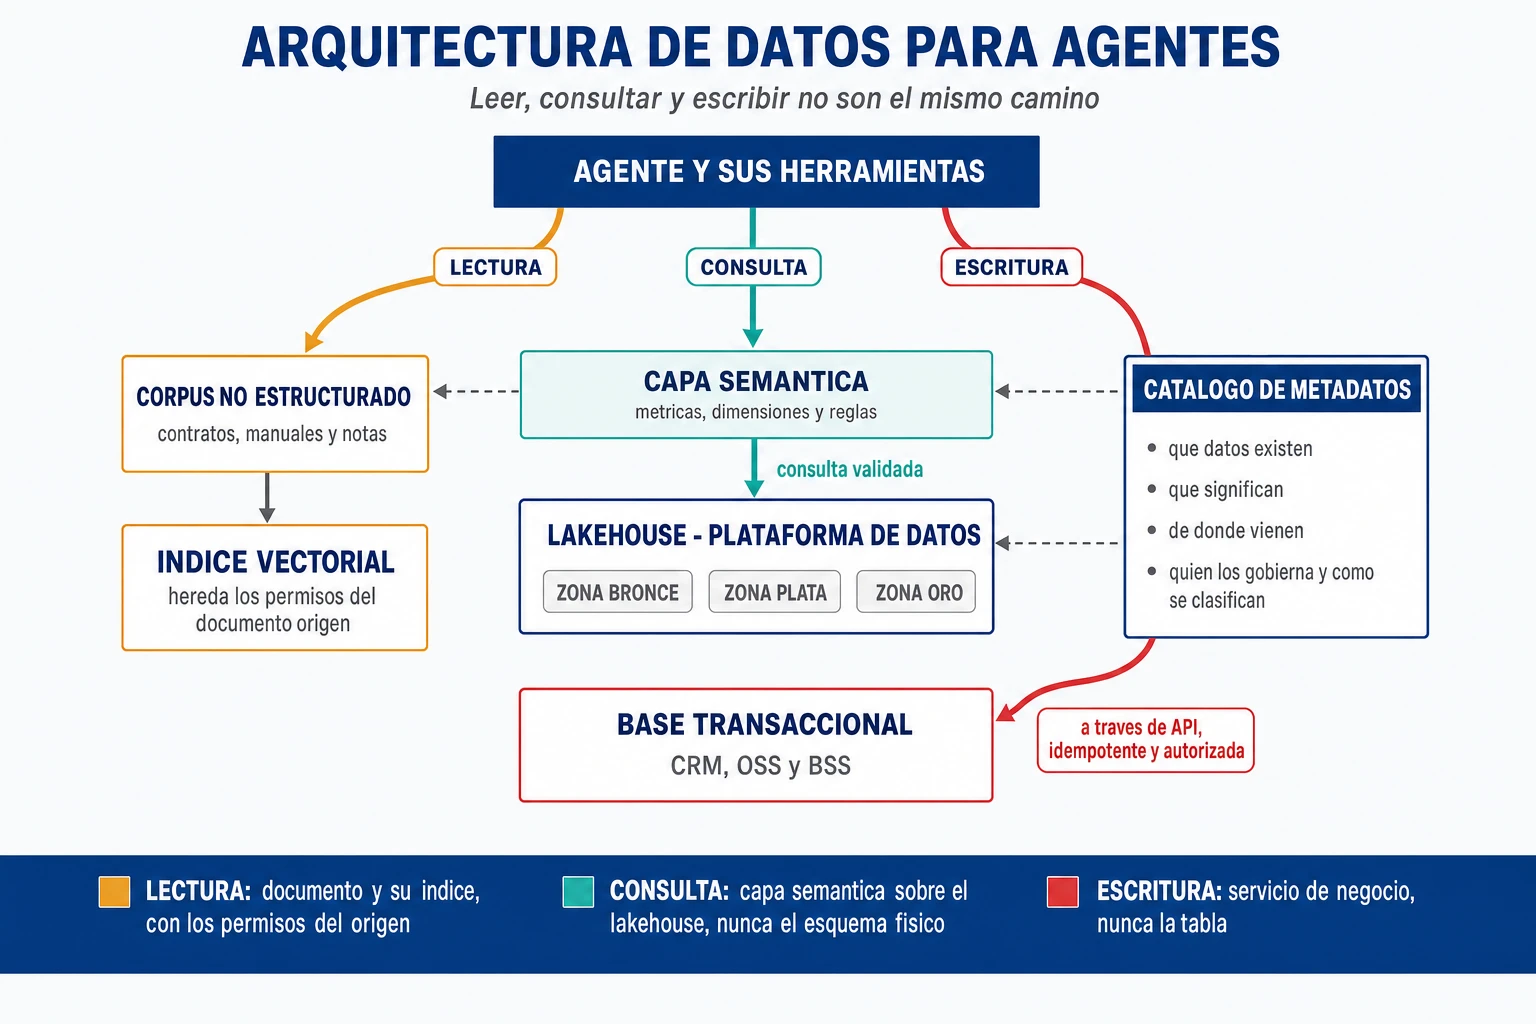
En una gran empresa —telco, banca, utility, retail, seguros— el dato que el agente necesita de verdad no está en un PDF: el cliente, el contrato, el consumo, la factura o el estado de una provisión están en bases transaccionales y en la plataforma de datos corporativa. Y hay una diferencia de consecuencias que conviene interiorizar: una recuperación documental mal montada devuelve una respuesta mala; una consulta mal montada contra la base de facturación tumba el cierre del mes.
Las cuatro piezas, y por qué la carga agéntica no va a la base transaccional
La primera pieza es la plataforma de datos corporativa —el lakehouse o almacén analítico: donde el dato de toda la compañía se consolida para analizarlo, separado de los sistemas que lo generan—. Ahí se dirige la carga agéntica, por una razón operativa: la consulta de un agente es ad hoc, no determinista y de coste impredecible, que es el perfil que no se quiere compitiendo con el cierre de facturación por la misma CPU.
La contrapartida es el desfase, y hay que decírsela al usuario: si la plataforma se refresca cada quince minutos, «cuánto debo» puede valer y «confirma que este pago se ha registrado» no. Y hay una tentación que conviene nombrar: dejar al agente suelto sobre el almacén analítico porque ahí no se rompe nada. Cierto; pero esas plataformas facturan por consulta, así que el incidente de rendimiento se convierte en una factura. El control cambia de nombre, no desaparece.
La segunda pieza es la capa semántica o modelo semántico: la capa que traduce lenguaje de negocio a consultas seguras y previamente validadas. Contiene métricas —cómo se calcula el ingreso recurrente—, dimensiones, relaciones y reglas de negocio. Es la pieza que decide si el acceso generativo a datos funciona.
La tercera es el catálogo de metadatos: qué datos existen, qué significan, de dónde vienen, quién los gobierna y qué clasificación tienen. Es lo que hace posible el descubrimiento, y no solo para los agentes: si una persona no puede averiguar qué tabla contiene el consumo facturable, un modelo tampoco. Es además donde vive la clasificación del dato, sin la cual la política de autorización no puede expresar nada.
La cuarta es el conocimiento no estructurado: contratos, normativa, procedimientos, actas. Deja de ser un mundo aparte y pasa a ser una fuente más de la misma arquitectura, con clasificación obligatoria, identidad propagada y trazabilidad de lo que devolvió.
| Pieza | Qué resuelve | Quién es el dueño | Qué pasa si falta |
| Plataforma de datos corporativa (lakehouse, almacén analítico) | Dónde vive el dato consolidado y dónde se dirige la carga agéntica, aislada de lo transaccional | Arquitectura de datos | El agente consulta la base que factura, y el primer incidente serio no es de seguridad: es de rendimiento |
| Capa semántica | Traduce lenguaje de negocio a consultas válidas y acotadas; métricas, dimensiones, relaciones y reglas definidas una vez | Negocio con ingeniería de datos | Cada herramienta reinventa la definición de «cliente activo», y ninguna coincide |
| Catálogo de metadatos | Qué datos existen, qué significan, de dónde vienen, quién los gobierna, qué clasificación tienen | Gobierno del dato | No hay descubrimiento ni clasificación, y sin clasificación la política de acceso no puede decir nada |
| Conocimiento no estructurado | Normativa, contratos y procedimientos disponibles con sus permisos y su versión | Gestión documental con seguridad | El índice se convierte en un agujero de confidencialidad legal y sin rastro |
Un aviso de alcance: comprar una plataforma de recuperación documental no resuelve el acceso a datos estructurados, y ningún vector convierte una tabla de facturación en un corpus. Si su caso es «responder preguntas sobre la factura del cliente», su proyecto es de integración y control de acceso, no de búsqueda semántica.
El conocimiento no estructurado: vectorización, permisos y frescura
El proceso es conocido —ingesta, troceado, vectorización, índice, recuperación y entrega al agente— y cada flecha es un sitio donde se pierde control. Las tres pérdidas que importan son siempre las mismas: el permiso del documento, su versión y su contexto.
La primera decisión es si la vectorización es automática o controlada. La automática llega en días, con el troceado y el modelo por defecto de la plataforma. La controlada —decidir troceado, metadatos, modelo y reindexado— cuesta semanas y necesita dueño, pero es la única que permite responder a «¿por qué el agente ha contestado esto?». El criterio se resuelve con dos preguntas: ¿el troceado afecta a la respuesta? —pasa con normativa, contratos, tarifas y todo lo que tenga tablas— y ¿los permisos varían por documento dentro del mismo corpus?
Recomendación: empiece por vectorización automática para llegar rápido, y tenga identificado desde el primer día qué corpus nunca deben ir por esa vía. Esa lista se escribe en una tarde con dos personas de negocio y una de cumplimiento.
El error que más veces se comete tiene nombre: copiar el documento sin copiar sus permisos. Un documento vive en un repositorio donde esa carpeta la ven doce personas; al indexarlo, sus fragmentos entran en un índice sin permisos o con permisos planos. En ese momento el índice es un agujero de confidencialidad perfectamente legal por el que sale el Excel de salarios o la oferta que se prepara para un competidor. Y lo peor no es la fuga: es que no deja rastro de acceso indebido, porque el acceso fue legítimo. La detección será una persona preguntando «¿y esto de dónde ha salido?».
Tres controles lo cierran. Filtrado por permisos dentro de la recuperación, con la identidad del usuario final, no después sobre los resultados. Clasificación obligatoria en cada fragmento: sin clasificación no se indexa, sin excepciones. Y reindexado cuando cambian los permisos, no solo cuando cambia el contenido: es el que nadie implementa, y por eso el índice refleja quién podía ver qué el día que se montó.
Queda la frescura. Sin proceso de retirada, el agente sigue citando la tarifa del año pasado con total convicción, y el cliente que recibe esa respuesta tiene una captura con el logotipo de la compañía encima. Tres controles baratos: tiempo de vida por corpus, borrado disparado desde el sistema documental de origen y no desde el equipo de IA, y cita con documento, versión y fecha. La cita con versión no es un adorno: es el mecanismo por el que un humano detecta que el índice está desactualizado antes de que lo detecte un cliente.
El único punto de decisión que el agente no puede eludir está dentro del motor de datos
Todos los controles anteriores viven en la ruta que el agente recorre. Hay uno que vive al final de ella y por eso es distinto: el que aplica el propio motor de datos. Un filtro de fila evaluado dentro del motor se aplica aunque la consulta venga por un camino que nadie previó.
Los fabricantes de bases de datos están sacando políticas declarativas de fila, columna y celda, con enmascarado por defecto de lo no autorizado, y las posicionan explícitamente como contención frente a un agente subvertido. Es material de fabricante y hay que etiquetarlo así —que la función exista no significa que esté activada en su instalación—, pero la dirección importa: por muchos gateways que ponga, el último control es el del motor, y es el único que un agente no puede saltarse. Conviene comprobar qué está activado antes de prometer nada, porque varias funciones de acceso agéntico gestionado existen solo en las versiones gestionadas en la nube.
Lo que se puede prometer de la trazabilidad, y lo que no
Aquí hay que corregir una promesa que se repite mucho: la de la cadena trazable «hasta la fila». Ninguna de las grandes plataformas de datos registra qué filas devolvió una consulta. Registran el texto de la sentencia, el principal, las políticas en vigor, los bytes escaneados y el número de filas. No el contenido ni las claves de esas filas.
Lo alcanzable no es trazabilidad hasta la fila: es reproducibilidad. Se consigue registrando cuatro cosas junto a cada consulta: el identificador de traza, la versión de la política aplicada, el identificador de la decisión de autorización y el estado de los datos en ese momento. Con esas cuatro, la consulta se puede volver a ejecutar tal como se ejecutó y se puede demostrar qué vio el agente.
Recomendación: escriba ese requisito en el contrato de datos del primer caso de uso, porque ahí cuesta media hora. Si se deja para cuando lo pida el auditor, hay que reconstruirlo sobre registros que no lo tienen, y eso no se reconstruye.
Los tres patrones de acceso al dato
Un agente accede al dato de tres maneras, y conviene decir de entrada que no forman un escalafón moral. No son «de mejor a peor»: son tres patrones que conviven, y la pregunta no es cuál es el bueno sino cuál toca en este caso.
Patrón 1: herramienta que invoca una API de negocio. La herramienta llama a un servicio existente —«estado del pedido», «saldo del cliente»—. Determinista, hereda la lógica y la autorización del servicio y deja la auditoría donde ya estaba. Para operaciones conocidas y acotadas.
Patrón 2: herramienta que ejecuta una consulta parametrizada. La herramienta lleva dentro una consulta predefinida y revisada; el agente rellena huecos —cliente, rango de fechas, tipo de producto— pero no redacta la consulta. Es el patrón para preguntas previsibles sobre datos donde no hay servicio, y el que más rendimiento da por unidad de esfuerzo: es el diseño que puntuó 0,939. La clave está en la frase: el riesgo nunca estuvo en que el agente acceda al dato; está en que redacte la sentencia.
Patrón 3: herramienta que formula una consulta generativa contra el modelo semántico. El agente pregunta en lenguaje de negocio —«ingresos por canal del último trimestre, excluyendo bajas»— y la capa semántica traduce eso a una consulta válida con métricas y dimensiones que ya existen. Es el patrón de la exploración y la analítica. Y depende por completo de la calidad del modelo semántico: sin él, esto es texto a SQL contra el esquema de producción, que es otra cosa y funciona mucho peor.
| 1 · Herramienta → API | 2 · Herramienta → consulta parametrizada | 3 · Herramienta → consulta generativa sobre modelo semántico | |
| Cuándo toca | Operaciones conocidas y acotadas, y toda escritura | Preguntas previsibles sobre datos donde no hay servicio de negocio | Exploración y analítica, donde no se pueden anticipar todas las preguntas |
| Qué lo controla | La autorización y la lógica del propio servicio, más el límite de tasa del gateway de APIs | La consulta está escrita y revisada; el agente solo aporta parámetros validados contra un esquema | El modelo semántico: solo se pueden pedir métricas y dimensiones que existen |
| Qué riesgo deja abierto | Que la API no cubra el caso y alguien fuerce una interpretación creativa de sus parámetros | Cobertura: si el catálogo de consultas es corto, alguien pedirá abrir la mano | Coste por consulta impredecible, y respuestas plausibles si el modelo semántico está incompleto |
| Qué hace falta tener antes | Inventario de APIs, contrato actualizado y fachada donde falte | Vistas o consultas aprobadas, usuario de solo lectura, réplica o plataforma de datos | Modelo semántico con métricas, dimensiones y reglas definidas; presupuesto por consulta; catálogo de metadatos |
| Cómo se evalúa que funciona | Pruebas de contrato más conjunto de evaluación de elección de herramienta | Tasa de acierto y tasa de error de parámetros sobre un conjunto de preguntas reales | Conjunto de preguntas de negocio con respuesta conocida, más porcentaje de preguntas que la capa declara que no puede responder |
| Coste marginal | El de la llamada al sistema | Bajo y previsible: la consulta es siempre la misma | Variable: depende de lo que pregunte el agente |
Sobre el patrón 3 hay que ser duro, porque es donde más humo hay. El texto a SQL sobre esquemas empresariales complejos no funciona. El estudio revisado más citado sobre bases de datos empresariales reales mide 0 % de precisión en los dos cuadrantes de esquema complejo. No «peor»: inutilizable. Y «esquema complejo» en un banco o una aseguradora es el caso normal. Sobre la representación semántica del mismo dominio, el mismo modelo pasaba del 16 % al 54 %.
Los benchmarks públicos que se usan para decir lo contrario tienen un problema medido y publicado: en los dos más conocidos, más de la mitad de los casos están mal etiquetados —52,8 % y 66,1 % de error de anotación—, y al corregirlos el rendimiento de los cinco métodos líderes se mueve entre un −3 % y un +31 % relativo. Cualquier diferencia de clasificación menor de unos cinco puntos es ruido. Desconfíe también de los benchmarks de fabricante con 100 % de acierto: hay uno muy citado con once preguntas, firmado por empleados del proveedor que gana y cargando el esquema completo en contexto para el brazo rival, algo que sus autores admiten que no es viable a escala.
El argumento que no depende de ningún benchmark es este: la capa semántica falla diciendo que no puede responder; el texto a SQL libre falla devolviendo un número plausible y equivocado. Una consulta contra métricas definidas solo puede pedir lo que existe; una sentencia generada libremente es sintácticamente válida con el cruce equivocado, y devuelve filas.
Hay además un corolario que resuelve una discusión frecuente con los equipos de base de datos: los cortafuegos de sentencias, que autorizan SQL por lista blanca y bloquean el resto dentro del motor, son incompatibles por construcción con el texto a SQL libre, porque este genera sentencias nuevas que por definición no están en la lista. No es cuestión de configuración: son dos arquitecturas que se excluyen. O capa semántica y consultas previsibles, o renuncia al control por lista blanca.
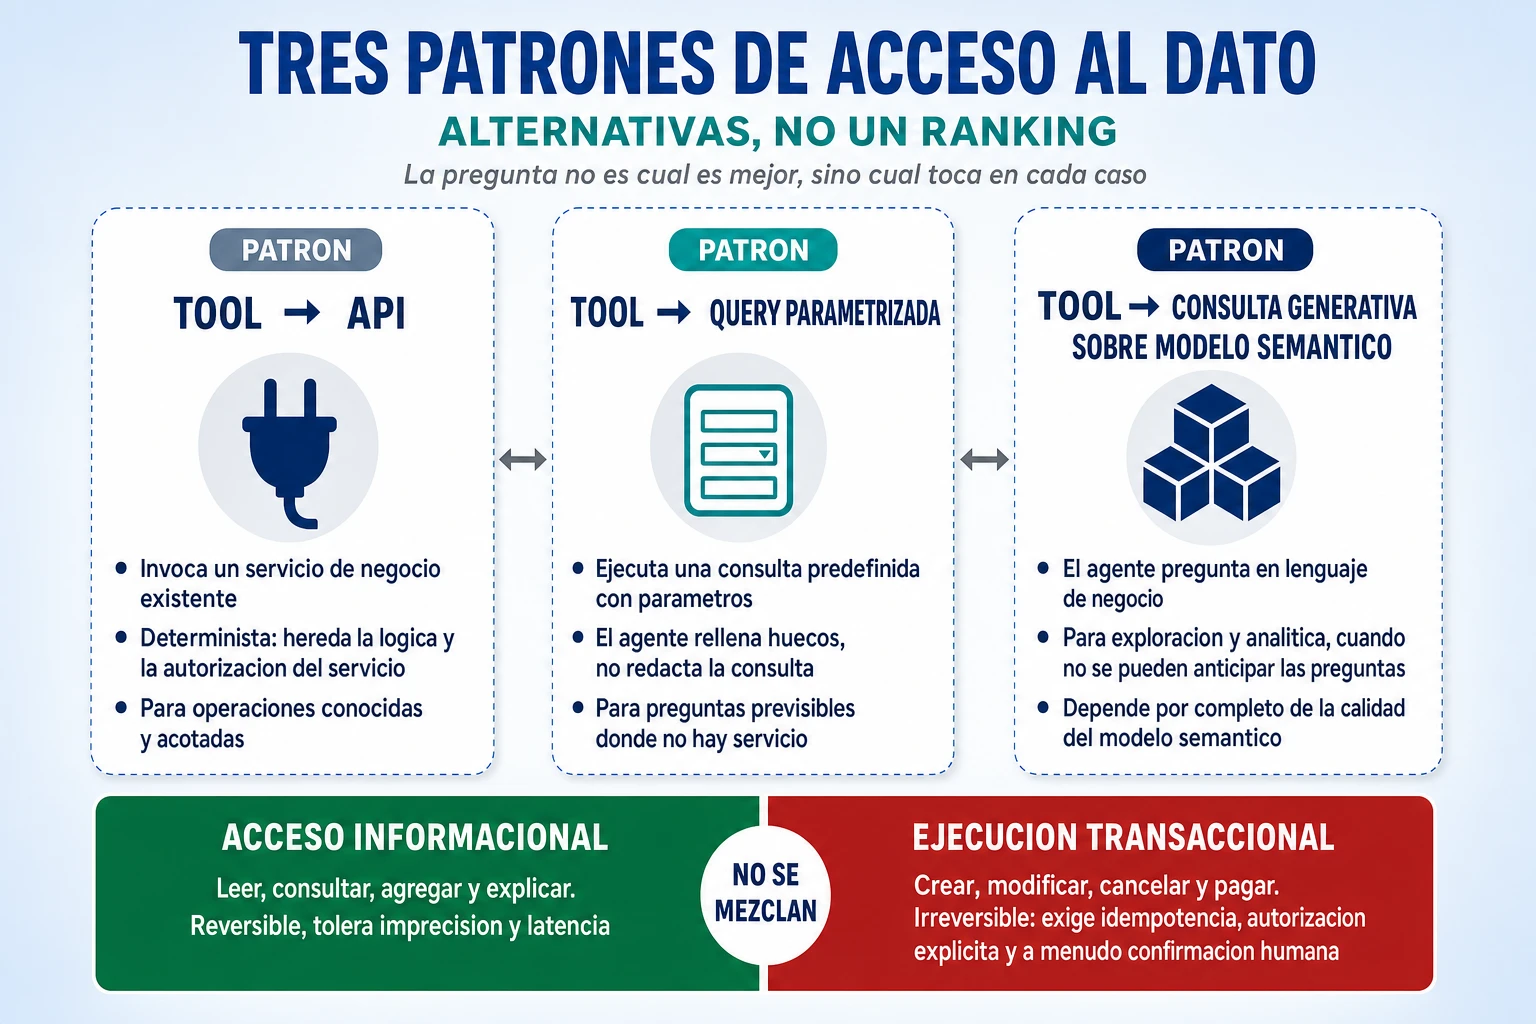
Acceso informacional frente a ejecución transaccional
Es la separación que más incidentes evita de todo el artículo, y es gratis. Leer no es lo mismo que hacer, y tratarlo como lo mismo convierte un error de razonamiento en un error de datos.
El acceso informacional es leer, consultar, agregar y explicar: reversible, tolera cierta imprecisión y tolera latencia. Conviene concederlo con amplitud, porque un agente que no puede consultar nada no sirve para nada.
La ejecución transaccional es crear, modificar, cancelar, pagar o provisionar: irreversible, no tolera imprecisión y exige idempotencia, autorización explícita por operación y a menudo confirmación humana. Aquí no vale «el agente tiene permiso»: hace falta saber qué operación, sobre qué objeto y con qué límite.
| Dimensión | Acceso informacional | Ejecución transaccional |
| Verbos | Leer, consultar, agregar, comparar, explicar | Crear, modificar, cancelar, pagar, provisionar |
| Reversibilidad | Reversible: el peor caso es una respuesta mala | Irreversible: el peor caso es un dato mal cambiado y un cliente afectado |
| Tolerancia a la imprecisión | Alta, si la respuesta va con su fuente y su fecha | Ninguna |
| Tolerancia a la latencia | Alta: una respuesta correcta en diez segundos sirve | Baja, y además exige confirmación |
| Qué exige de la herramienta | Filtro por identidad, cita de la fuente, límite de volumen | Idempotencia, umbral por operación, doble confirmación en lo material, registro con identidad de la persona |
| Camino típico | Plataforma de datos, capa semántica o corpus documental | API de negocio transaccional, nunca consulta directa al dato |
| Nivel de autonomía razonable | Amplio | Estrecho, con humano en el bucle por encima de un umbral escrito |
| Cómo se audita | Qué se consultó, con qué política y sobre qué versión del dato | Qué se ejecutó, en nombre de quién, con qué aprobación y con qué resultado |
La regla que se deriva es corta y se incumple constantemente: no se mezclan en la misma herramienta, ni en el mismo camino, ni con el mismo nivel de autonomía. Una herramienta que consulta y además modifica tiene un riesgo que no se puede clasificar, y por tanto no se puede autorizar bien. Un agente puede tener acceso informacional amplio y transaccional estrecho: eso es el diseño normal.
Recomendación: etiquete cada herramienta con un único nivel de riesgo —lectura, escritura, destructiva, financiera— y prohíba las mixtas. El coste es partir en dos alguna herramienta cómoda; el beneficio es que la autorización, la revisión de seguridad y la decisión de cuándo pedir confirmación humana se vuelven mecánicas.
Las cuatro capacidades transversales
Identidad: el agente no es un usuario ni una cuenta de servicio
Un agente no es un usuario —que tiene detrás una persona que responde— ni una cuenta de servicio —un permiso permanente sin nadie detrás—: actúa en nombre de alguien, con criterio propio y a veces sin que esa persona esté delante. Lo primero es una identidad propia por agente: ni credenciales compartidas, ni cuentas genéricas, ni el usuario técnico que ya existía «para no dar de alta otro». Si dos agentes comparten credencial, no se puede apagar uno sin apagar el otro.
Lo segundo es la distinción entre delegación y suplantación. En la suplantación el agente recibe todos los derechos de la persona y es indistinguible de ella en los registros. En la delegación mantiene identidad propia y queda explícito que actúa en representación de alguien: el registro dice quién es el sujeto y quién el actor. Para auditar solo sirve la segunda; para apagar selectivamente, también.
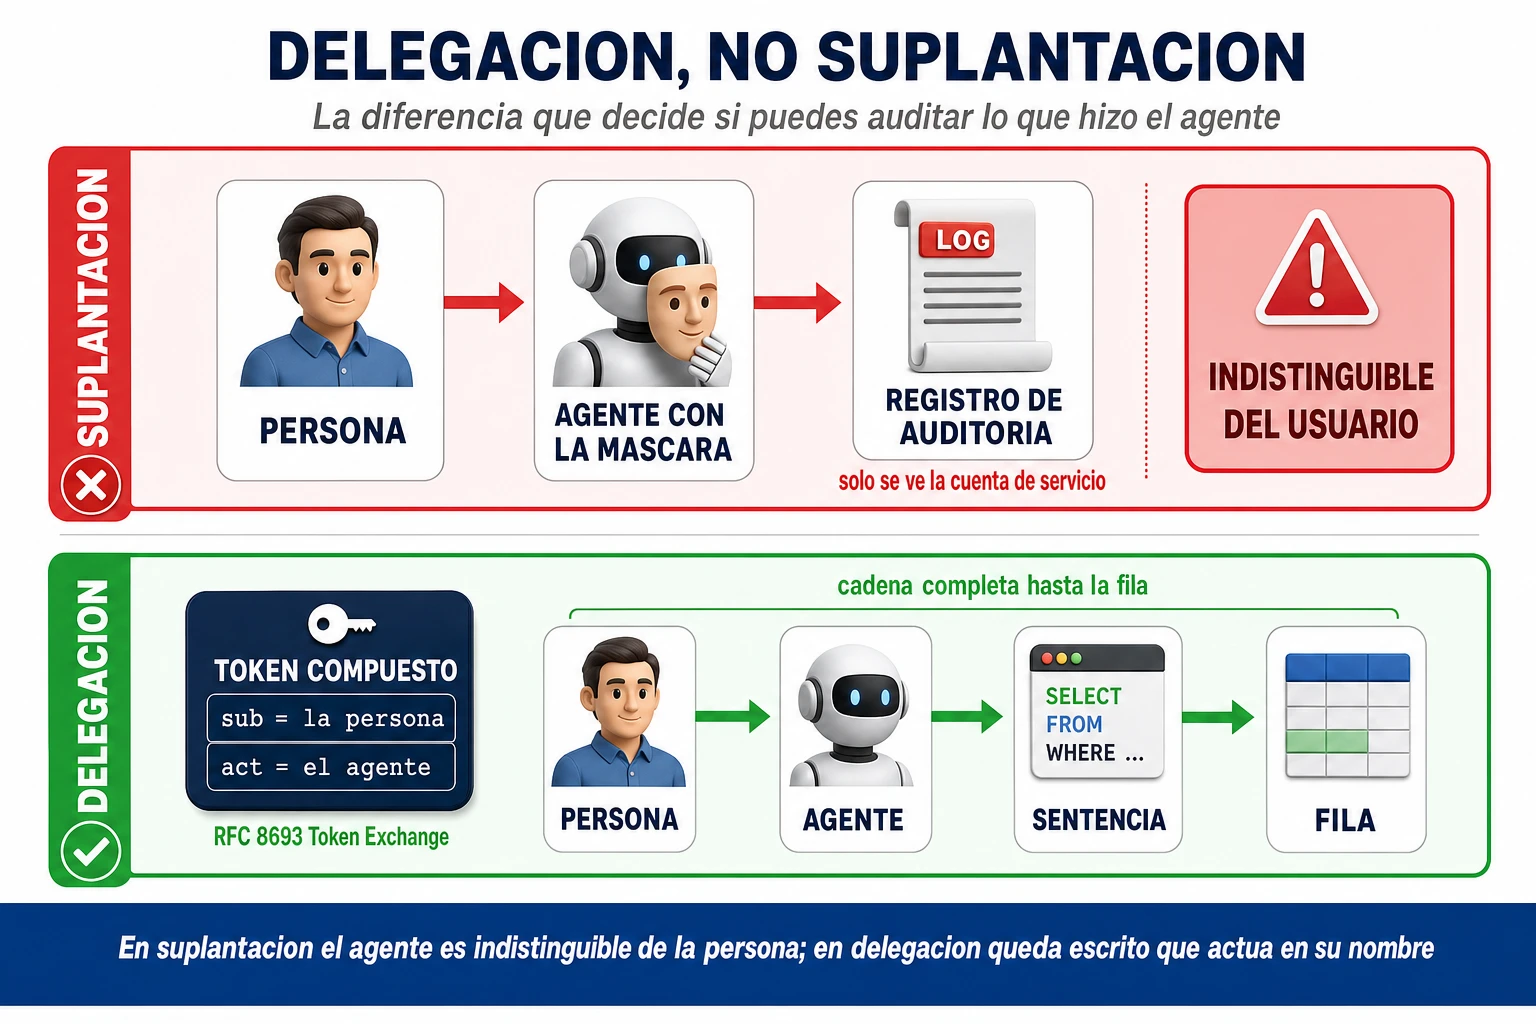
Existe un estándar de intercambio de tokens para materializarlo, y el patrón es el ya visto: el token que llega no se reenvía hacia abajo; cada salto valida que la credencial era para él y obtiene otra de alcance menor. La cadena se registra —persona, agente, gateway—, y esa cadena anidada sirve para auditar, no para decidir: cada salto decide con lo que tiene delante, no fiándose de lo que los anteriores dicen de sí mismos.
Dos cautelas. La alarma de «demasiados saltos» que circula viene de arquitecturas multiagente, no de esta cadena, que es lineal y tiene dos o tres intercambios. Y cifrar el token en lugar de solo firmarlo suena bien y choca con la arquitectura: si el gateway debe leer sus datos para autorizar, necesita la clave, y la confidencialidad frente a ese intermediario se diluye. La práctica habitual es otra: token opaco de cara afuera y token legible solo dentro del perímetro.
Recomendación: no empiece comprando un producto de identidad de agentes. Dibuje cómo viaja la identidad del usuario final desde la conversación hasta la consulta, salto por salto, con el mecanismo y el alcance de cada uno. Si esa cadena no cabe en una servilleta, ningún producto la va a arreglar.
Observabilidad: una sola traza, dos herramientas y un identificador
Lo que hay que poder reconstruir es una sola cadena: persona → agente → modelo → herramienta → servidor MCP → API → sistema → dato, bajo un mismo identificador de correlación, porque una petición de usuario genera decenas de llamadas internas. Cuatro tipos de traza bastan: inferencia, ejecución de agente, invocación de herramienta y recuperación de datos.
Hay una buena noticia que resuelve el problema técnico más molesto de esta capa: el protocolo ya documenta la propagación del contexto de traza de OpenTelemetry en los metadatos de cada mensaje, así que la traza cruza el gateway y llega al servidor MCP sin inventar nada. Las convenciones de nombres para IA generativa, en cambio, todavía se están asentando: adopte el vocabulario y fije un esquema propio de diez o doce campos, documentado y versionado, y construya los cuadros de mando contra él.
Queda la pregunta que aparece siempre: qué hacer cuando conviven dos herramientas de trazas y nadie ha decidido cuál es el estándar. Está mal planteada. No hay que elegir el estándar: hay que decidir qué señal vive dónde. Métricas y alertas operativas, en la plataforma corporativa, donde está el resto de la producción. Trazas de razonamiento, versiones de prompt y resultados de evaluación, en una herramienta que entienda esos conceptos.
Lo que no puede haber son dos identificadores de correlación distintos: entonces tiene dos sistemas de observabilidad y ninguna observabilidad. Recomendación: las dos herramientas, un identificador y una regla escrita. Si hay que quedarse con una, la corporativa: el agente falla a las tres de la mañana junto con todo lo demás, y quien está de guardia no va a abrir dos consolas.
Gobierno: quién puede crear, publicar y apagar
Gobierno son cuatro derechos de decisión con nombre y apellidos, y se aplican por igual a los agentes y a las herramientas: quién aprueba uno nuevo, quién lo certifica, quién lo publica y quién lo apaga o lo retira. El cuarto es el que falta, y sin él los otros tres son decorativos.
El botón de apagado necesita dueño y necesita estar probado: alguien lo ha pulsado en un simulacro, ha medido cuánto tarda y ha comprobado qué pasa con las ejecuciones en curso. Conviene medir el tiempo real de revocación, porque en varias plataformas revocar por pertenencia a grupo tarda una hora o más; para un incidente hace falta otra palanca, y esa palanca es el gateway.
Los dos catálogos —agentes y herramientas— son distintos y los dos obligatorios. El de agentes registra qué existe, qué hace en lenguaje de negocio, quién lo mantiene, qué herramientas consume, qué datos toca y cuándo se revisó. Sin él, en seis meses hay cuatro agentes que consultan facturas y el más usado es el que montó alguien en febrero para salir del paso.
FinOps: la unidad de coste no es el token
Tres reglas y una métrica. Etiquetado por agente, usuario y centro de coste desde la primera llamada: si se etiqueta después no se etiqueta nunca. Presupuesto duro por agente con corte automático, no alerta. Y un agente sin etiqueta no arranca, comprobado en el despliegue. Aviso: la atribución de coste por agente no está resuelta a nivel de producto en varias plataformas de datos, y el apaño es aislar agentes en proyectos separados.
La métrica: lo que importa no es el coste por token, es el coste por resolución —por incidencia cerrada, por pedido tramitado—, comparado con hacerlo como se hacía antes. Un agente que baja el coste por token y sube el número de intentos ha empeorado, y su cuadro de mando dirá que ha mejorado. Y aquí conecta la capa de capacidades: un buen diseño de herramientas baja el coste por resolución en un orden de magnitud, porque permite resolver el mismo caso con un modelo más barato.
Recomendación: mida la línea base del coste por resolución antes de desplegar. Cuesta dos semanas y después no se puede reconstruir, porque el proceso habrá cambiado. Sin línea base, la discusión sobre el retorno se resolverá por jerarquía.
Los dos relojes: lo que se monta una vez y lo que se monta en cada caso
Hasta aquí, los componentes. Ahora lo que decide el calendario: cuáles de esas decisiones se toman una sola vez para toda la compañía y cuáles en cada caso de uso. Confundirlas es el origen de las tres patologías y de los siete meses de la apertura.
Reloj 1: la plataforma, que se monta una vez
| Elemento | Qué se decide | Quién decide | Criterio de «hecho» |
| Identidad y delegación | Cómo viaja la identidad del usuario final hasta el último sistema; intercambio de tokens, alcance y caducidad | Seguridad e identidad, con arquitectura | Una consulta del agente aparece en la auditoría del sistema final con el nombre de la persona |
| Fronteras entre gateways | Qué política vive en el gateway de APIs, cuál en el AI Gateway y cuál en el Agent Gateway | Arquitectura | Una tabla de una página, publicada, sin ninguna política duplicada |
| Plano de control de capacidades | Motor de políticas, registro privado, catálogo con clasificación y nivel de riesgo, y quién aprueba una herramienta | Plataforma con seguridad y los dueños de dominio | Una herramienta no aprobada no se puede invocar, y se puede demostrar |
| Runtime y escalado | Orquestador, escalado por cola, reducción a cero, persistencia de estado, entorno aislado | Plataforma y SRE | Un agente se pausa, se reanuda en otro nodo y no repite inferencias |
| Capa semántica de capacidades | Cómo se nombra una capacidad, dónde viven las reglas de dominio, cómo se versiona una herramienta | Dueños de dominio con arquitectura | Existe una herramienta de referencia, con ejemplos y contraejemplos, que los demás dominios copian |
| CI/CD y evaluación | Cadena de despliegue, conjuntos de evaluación, umbrales, promoción automática | Ingeniería de plataforma | Un agente pasa de rama a producción sin reunión extraordinaria |
| Esquema de observabilidad | Los campos propios, el identificador de correlación único, qué señal vive dónde | Plataforma con observabilidad corporativa | Una petición se sigue entera en una sola traza, del chat al dato |
| Política FinOps | Etiquetado obligatorio, presupuesto por agente, corte duro, métrica de coste por resolución | Finanzas con plataforma | Un agente sin etiqueta no arranca |
| Guardrails por defecto | Qué se filtra siempre a la entrada y a la salida, y quién puede levantarlo | Seguridad | Un agente nuevo nace con los guardrails puestos; no se los pone su autor |
| Plantilla de agente | Esqueleto con identidad, trazas, límites, despliegue y pruebas ya cableados | Plataforma | Un agente nuevo arranca en un día, no en dos semanas |
| Entornos y datos de prueba | Datos realistas, anonimizados y suficientes para evaluar | Gobierno del dato | Se puede evaluar sin pedir un volcado de producción |
| Acceso a datos preaprovisionado | Aislamiento de recursos, réplica o plataforma de datos, vistas base, usuario de solo lectura, presupuesto por consulta | Administración de bases de datos con arquitectura de datos | Existe antes de que llegue el caso de uso |
| Contratos con proveedores de modelo | Las diez cláusulas del apartado siguiente | Jurídico y compras, con arquitectura | Hay contrato firmado con dos proveedores capaces de servir el mismo caso |
Los contratos con proveedores de modelo: la parte de arquitectura que firma jurídico
Es la pieza del reloj 1 que se decide sin arquitectos en la sala, y por eso se decide mal. Cada uno de los diez puntos parece una cláusula y es una decisión de diseño disfrazada.
| # | Cláusula | Qué hay que cerrar | Por qué es arquitectura y no papeleo |
| 1 | Uso de datos para entrenamiento | Prohibido por defecto, en el contrato y no en la documentación del producto | Si no está prohibido por escrito, la decisión de qué dato entra en un prompt deja de ser suya |
| 2 | Retención | Retención cero o mínima y documentada, incluida la retención «para abuso y seguridad» | Es la que casi nadie lee y la que determina si puede meter datos de cliente |
| 3 | Residencia y subencargados | Dónde se procesa, quién más toca el dato, acuerdo de tratamiento y transferencias internacionales | Decide a qué regiones puede enrutar su gateway, que es una regla de configuración |
| 4 | Límites de tasa y su ampliación | Cuál es el límite en tokens por minuto, en cuánto se amplía y con qué preaviso | Es el techo real de su capacidad de producción; se negocia antes, no el día del pico |
| 5 | Versionado y deprecación | Preaviso mínimo y ventana de convivencia entre versiones de modelo | Sin eso, su plan de migración lo marca el proveedor |
| 6 | Precio y compromiso de consumo | Descuento, compromiso, qué pasa si no lo consume y si es transferible | Un compromiso mal dimensionado convierte el gateway en una máquina de cumplir cuota |
| 7 | Nivel de servicio, disponibilidad y créditos | Qué se compromete, cómo se mide y qué le devuelven | Los créditos no le sirven de nada; lo que sirve es la conmutación a otro proveedor desde el gateway |
| 8 | Propiedad de la salida e indemnización | De quién es lo que genera el modelo y quién responde ante una reclamación de terceros | Determina qué casos de uso de cara al cliente puede autorizar |
| 9 | Certificaciones, auditoría e incidentes | Qué certificaciones, derecho de auditoría y plazo de notificación | Es exactamente lo que le van a pedir a usted sus reguladores y sus clientes |
| 10 | Salida | Portabilidad, borrado verificable y qué se lleva | Sin salida escrita, el contrato se renueva solo y el precio también |
El punto 5 es el riesgo más subestimado de toda la arquitectura. Su agente está certificado contra un modelo concreto; el proveedor publica una versión nueva, retira la anterior en noventa días y su conjunto de evaluación empieza a dar resultados distintos sin que nadie toque una línea de código. Sin preaviso y ventana de convivencia en contrato, la fecha de su migración la decide otro.
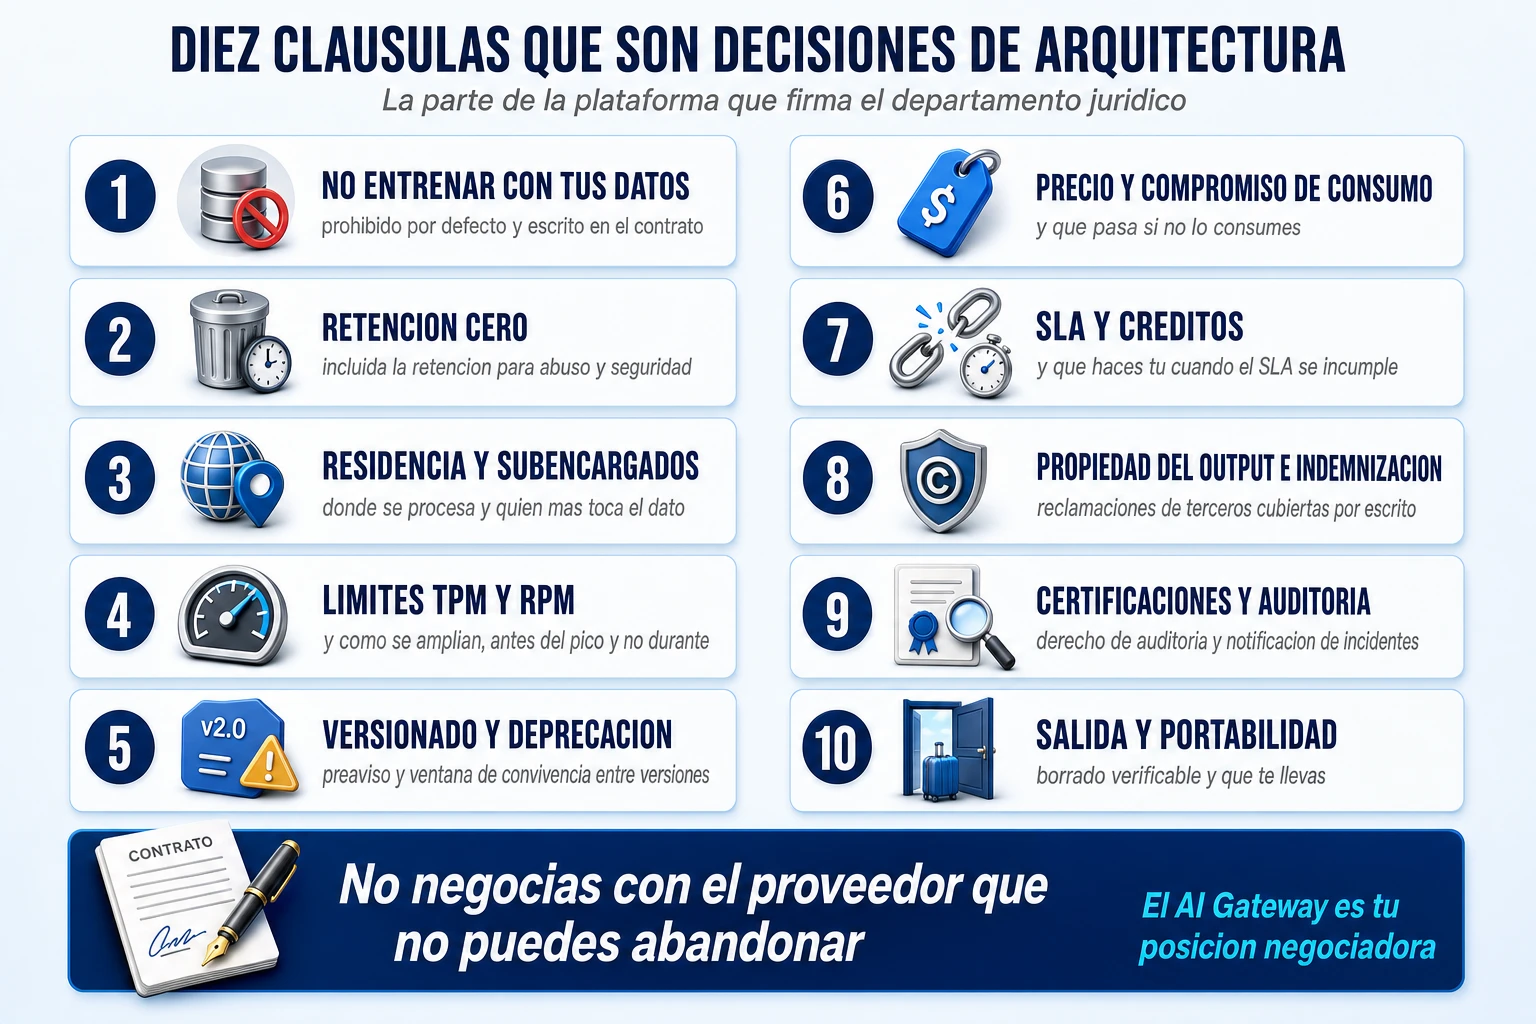
No se negocia con el proveedor al que no se puede abandonar. El AI Gateway y una suite de evaluación propia son, literalmente, su posición negociadora.
Reloj 2: el caso de uso, que se monta N veces
Lo que se decide de verdad en cada caso es una lista corta: qué sistemas y fuentes entran; qué capacidades se publican como herramientas y con qué descripción; qué datos, con qué filtro y contra qué copia; qué umbral de autonomía y cuándo escala a un humano; qué conjunto de evaluación; qué plan de despliegue y criterio de retirada; y qué métrica de negocio, con su línea base medida.
Nada de esa lista es plataforma, y nada de la tabla anterior es caso de uso. La prueba del algodón: si una decisión hay que volver a tomarla en el segundo agente, estaba mal clasificada.
| Componente | Reloj 1 · una vez | Reloj 2 · cada caso |
| AI Gateway | El gateway, los proveedores conectados, los guardrails por defecto, el esquema de trazas | El presupuesto de este agente, el modelo elegido y los guardrails adicionales |
| Capacidades y MCP | El Agent Gateway, el registro privado, el motor de políticas, el proceso de aprobación y el patrón de autorización | El servidor MCP del dominio de facturación y sus herramientas concretas, con sus ejemplos |
| Catálogo de herramientas | El formato, la búsqueda, el filtrado por rol y el tope de herramientas visibles | Qué herramientas ve este agente y con qué alcance |
| Gateway de APIs | La plataforma, las políticas base, el inventario y su formato | Las fachadas concretas que necesita este caso y sus límites de tasa |
| Datos estructurados | Aislamiento de recursos, plataforma de datos, capa semántica base, controles del motor activos, patrón de identidad delegada | Las métricas y vistas de este caso, las filas visibles y el umbral de coste por consulta |
| Conocimiento no estructurado | Proceso de ingesta, política de clasificación, filtrado por permisos, proceso de retirada | Qué corpus, con qué troceado y quién lo aprueba |
| Identidad | Servicio emisor de tokens, intercambio, ciclo de vida, patrón de delegación | El alcance concreto de este agente y su fecha de caducidad |
| Runtime | Orquestador, escalado, persistencia, entorno aislado | El límite de concurrencia de este agente frente a su sistema de destino |
| Observabilidad | Esquema, identificador de correlación, qué señal vive dónde | Los cuadros de mando de este caso y sus alertas de negocio |
| Evaluación | El marco, la cadena de ejecución y el umbral de promoción | El conjunto de evaluación de este caso y sus casos adversos |
| Gobierno | Derechos de decisión, catálogos, procedimiento de apagado probado | El dueño de este agente y su fecha de revisión |
| FinOps | Etiquetado, corte duro, modelo de imputación | El presupuesto y la métrica de coste por resolución de este caso |
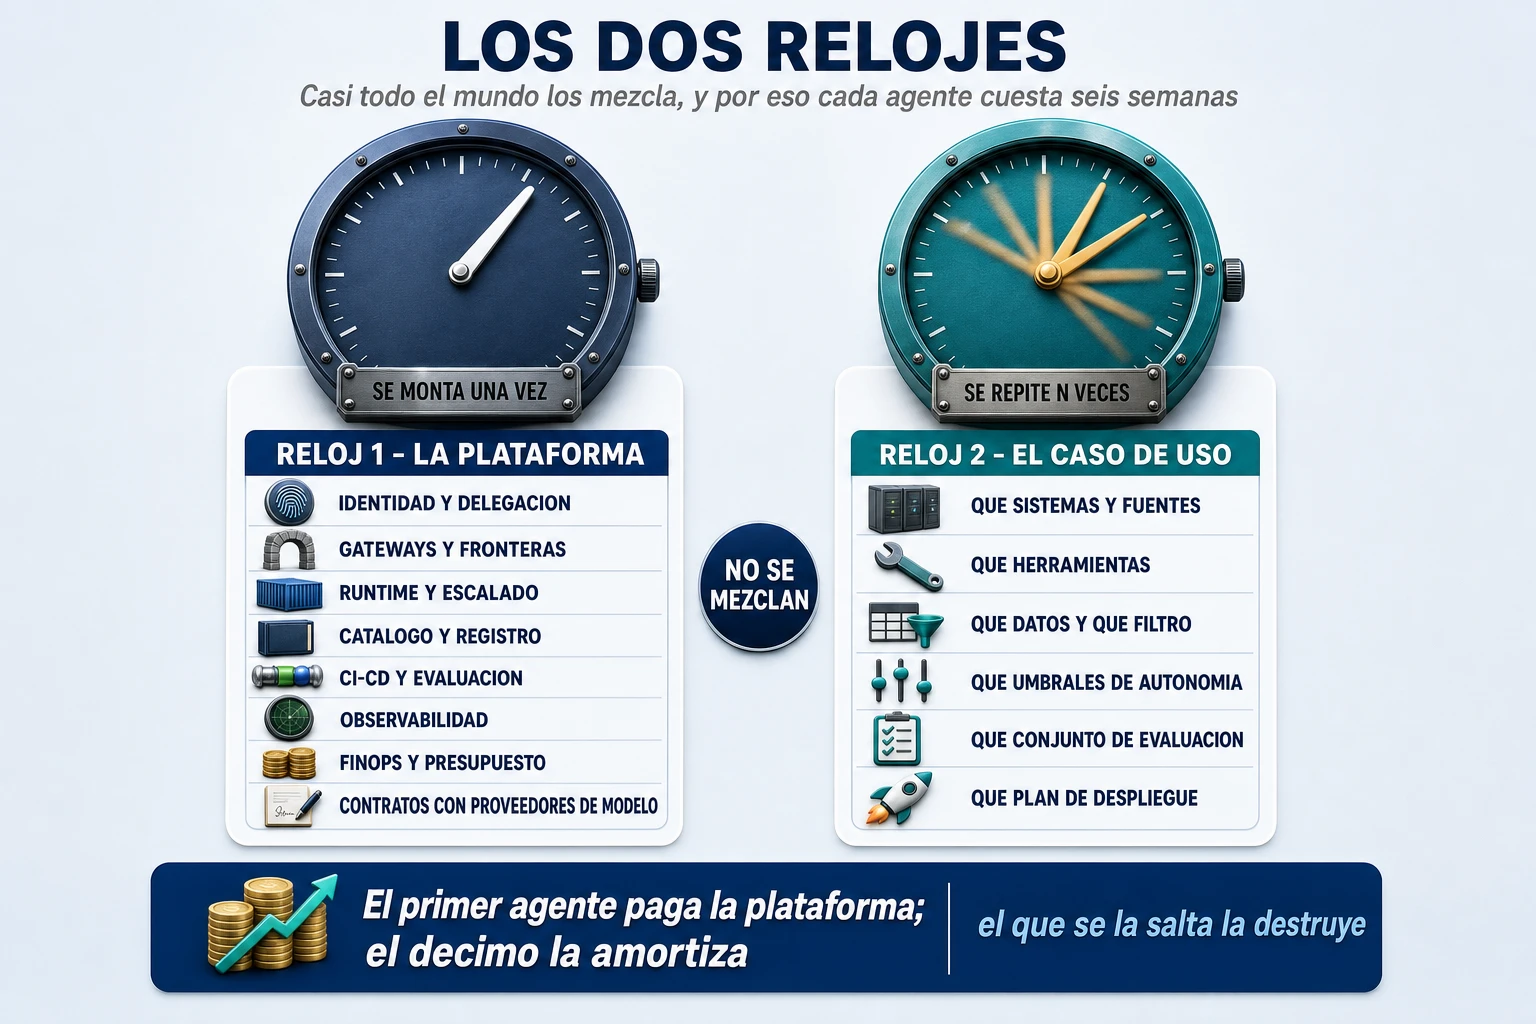
Las tres formas de romperlo
Uno: cada agente reabre la plataforma. La revisión de seguridad empieza de cero en cada proyecto, cada equipo negocia sus accesos a datos y cada agente elige su modelo y su SDK. Seis semanas por agente, para siempre, porque nunca se acumula aprendizaje. Es la patología que produce los siete meses de la apertura, repetidos indefinidamente.
Dos: la plataforma sin caso de uso. Hay gateway, hay catálogo, hay hoja de ruta y cero agentes en producción. Se reconoce porque todos los hitos son entregas de infraestructura y ninguno es un resultado de negocio. Es la más cara porque es la más respetable: nadie discute un hito de infraestructura, y se pueden encadenar dieciocho meses.
Tres: el caso de uso que se salta la plataforma. Agentes en cuentas personales de proveedor, servidores MCP no aprobados en portátiles, claves de API en repositorios. Es el más peligroso porque va rápido y parece que funciona. Cuando se descubre —por un incidente, no por una auditoría— ya hay tres áreas dependiendo de él y apagarlo tiene coste político.
La forma de evitar las tres a la vez es la regla del caso 0: elegir deliberadamente un primer caso que obligue a montar el setenta por ciento de la plataforma —uno que toque un sistema legacy real, datos con permisos que varían por usuario y una acción con consecuencia, aunque sea reversible— y montar la plataforma en vertical con él, no en cascada antes de él.
Lo que no sirve como caso 0 es un asistente de preguntas frecuentes sobre documentación interna: no toca legacy, no toca datos con permisos diferenciados, no ejecuta ninguna acción y no ejercita ni la identidad delegada ni el control de coste. Sale rápido, queda estupendo en el comité y no deja nada montado.
Y una advertencia que no es de arquitectura pero decide resultados: un agente montado sobre un proceso mal diseñado automatiza el mal diseño, más rápido y con más confianza. Antes de agentizar conviene saber si el proceso merece sobrevivir, y eso tiene su propio análisis en por qué falla la transformación empresarial. La plataforma acelera lo que haya. No arregla nada.
La metodología: cómo se acelera de verdad
La secuencia de montaje, que es un orden de dependencias y no un calendario
Antes de la secuencia, una advertencia que ahorra un trimestre: los planes por fases que circulan en la documentación de producto son un orden de dependencias, no un calendario. Ejecutarlos en cascada produce la segunda patología con precisión de reloj. Se ejecutan en vertical contra el caso 0, cogiendo de cada fase solo lo que ese caso necesita.
- Fase A · Fundamento. Inventario de las APIs y fuentes del caso 0, AI Gateway operativo, política de identidad escrita, esquema de trazas definido. Salida: una llamada de prueba atraviesa toda la cadena y aparece entera en una sola traza.
- Fase B · Capacidades. Las diez capacidades del dominio escritas en lenguaje de negocio, fachadas sobre el legacy donde falten, primeros servidores MCP con herramientas curadas, registro privado y Agent Gateway con motor de políticas detrás. Salida: un desarrollador elige una herramienta del catálogo sin hablar con nadie, y una herramienta no aprobada no se puede invocar.
- Fase C · Identidad y datos. Intercambio de tokens en producción, plataforma de datos y capa semántica con las métricas del caso, permisos documentales aplicados dentro de la recuperación. Salida: una consulta queda registrada con la identidad de la persona, la política aplicada y la versión del dato.
- Fase D · Industrialización. Despliegue continuo con conjuntos de evaluación, presupuestos con corte, cuadro de mando de coste por resolución y procedimiento de apagado probado. Salida: un agente pasa de rama a producción sin reunión extraordinaria. Los cuatro criterios son demostraciones, no documentos.
El bucle del caso de uso, en ocho pasos
| # | Paso | Entregable | Quién |
| 1 | Selección del caso con criterio explícito y línea base medida | Ficha del caso con métrica de éxito y dueño | Dueño de negocio con la oficina de IA |
| 2 | Inventario de sistemas y fuentes implicados | Lista de sistemas con estado y huecos identificados | Arquitectura de integración |
| 3 | Capacidades del caso escritas en lenguaje de negocio, antes de mirar los sistemas | Lista de capacidades con su correspondencia a APIs y sus huecos | Dueño del dominio |
| 4 | Contrato de datos y permisos: qué datos, de qué copia, con qué filtro y qué identidad | Contrato de datos firmado por el dueño del dato, con requisito de reproducibilidad | Gobierno del dato con seguridad |
| 5 | Publicación de herramientas con nombre de negocio, ejemplos, contraejemplos y un solo nivel de riesgo | Herramientas en el catálogo, revisadas y aprobadas | Dueño del dominio con plataforma |
| 6 | Construcción del agente sobre la plantilla | Agente en el entorno de desarrollo | Equipo del caso de uso |
| 7 | Evaluación y equipo rojo, incluida inyección de prompt y elección de herramienta | Informe de evaluación con el umbral superado | Equipo con seguridad |
| 8 | Piloto acotado y paso a producción con umbral de retirada escrito | Agente en el catálogo, con dueño y fecha de revisión | Plataforma con el dueño |
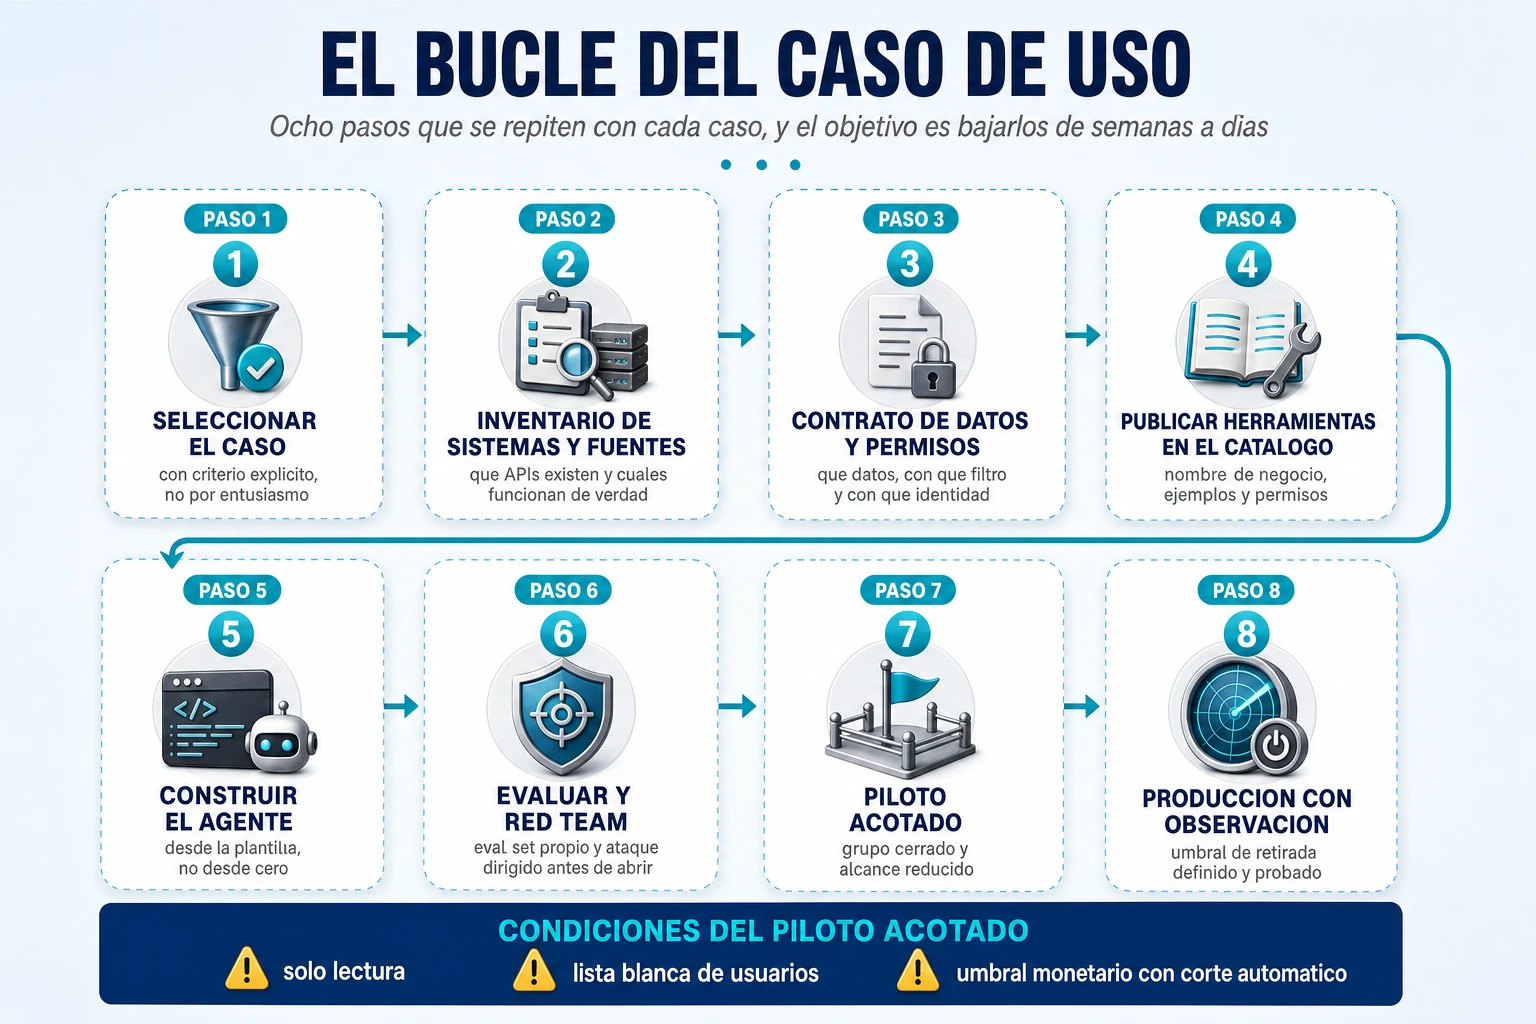
Los siete aceleradores reales
- El inventario de APIs y fuentes. Nada acelera más y es lo menos glamuroso. Sin directorio, cada caso empieza con dos semanas de arqueología que no aparecen en ningún plan porque no son una tarea: son una ausencia.
- Patrones de seguridad preaprobados. Un catálogo de patrones ya aprobados —«agente de solo lectura sobre la plataforma de datos con token delegado», «agente con acción reversible y umbral monetario»— con vía rápida para quien se acoge a uno. La revisión pasa de cuatro semanas a dos días.
- Acceso a datos preaprovisionado. Aislamiento de recursos, copia de lectura, vistas base, usuario de solo lectura y presupuesto por consulta, creados antes de que llegue el caso de uso. Es el mismo trabajo en otro momento, y esa diferencia vale seis semanas por agente.
- Una herramienta de referencia por dominio. Una sola bien hecha —nombre de negocio, descripción con casos y contracasos, esquema acotado, errores legibles, reglas de dominio dentro— que los demás equipos copian. Más eficaz que cualquier guía de estilo: la guía se lee, el ejemplo se clona.
- Catálogo de herramientas usable. Que un desarrollador pueda buscar «consultar contrato de cliente», encontrarla, ver un ejemplo y qué permisos requiere, y usarla. Usable significa que compite en comodidad con montárselo por su cuenta; si no compite, pierde.
- Suite de evaluación reutilizable. Sin conjunto de evaluación no hay certificación, y sin certificación no hay producción. La evaluación no es calidad, es velocidad: es lo que permite promocionar sin una reunión de aprobación.
- Vía rápida de aprobación con criterios objetivos y publicados. Si el criterio no está escrito, la aprobación es una negociación, y las negociaciones tardan lo que tarde la agenda del que aprueba.
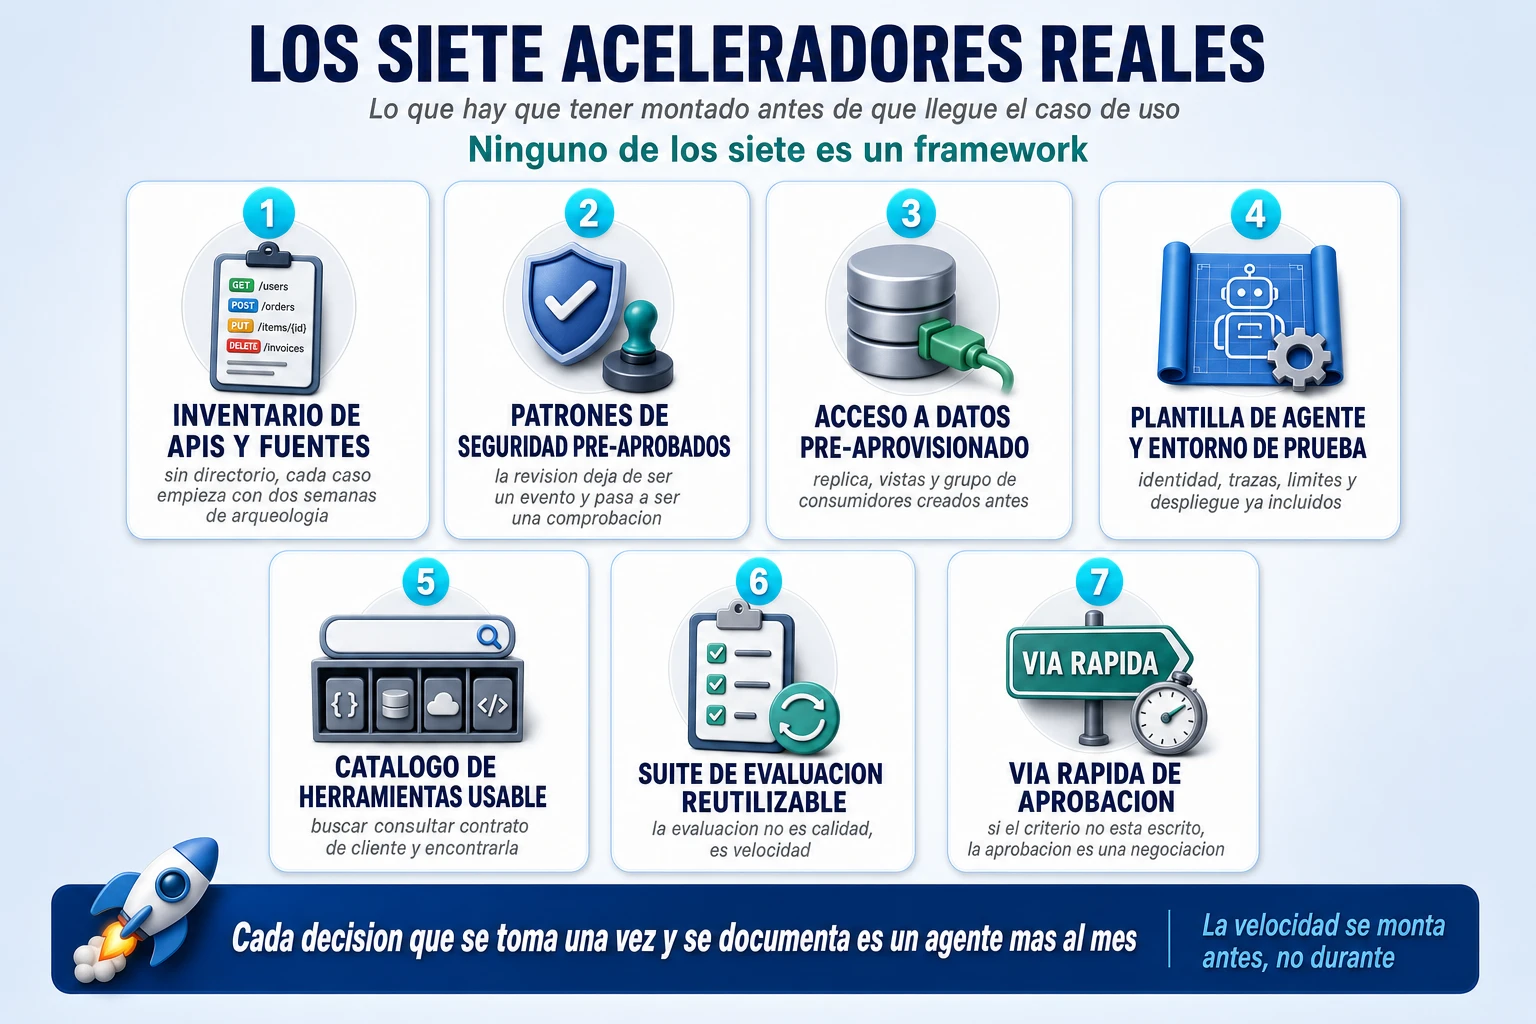
La métrica que casi nadie mide: el lead time de agente
De idea aprobada a producción, descompuesto en tiempo de trabajo y tiempo de espera. Es una métrica de flujo de siempre, y aquí es reveladora porque el tiempo de trabajo es justamente el que todo el mundo intenta optimizar con herramientas nuevas.
La conclusión incómoda que aparece siempre que se mide: la mayor parte del lead time es espera —un alta, una aprobación, un entorno, la respuesta del dueño de un sistema, una revisión jurídica—. La proporción hay que medirla en cada organización; la observación de campo es que el grueso está en la espera, pero eso es una observación, no un dato de estudio. Medirlo cuesta una semana.
Lo importante es la consecuencia: ninguna herramienta de IA reduce la espera. Un copiloto mejor no acorta el alta de un usuario técnico; un modelo más barato no adelanta la revisión de seguridad. Todo el esfuerzo de mejora se concentra en la parte del tiempo que ya era rápida.
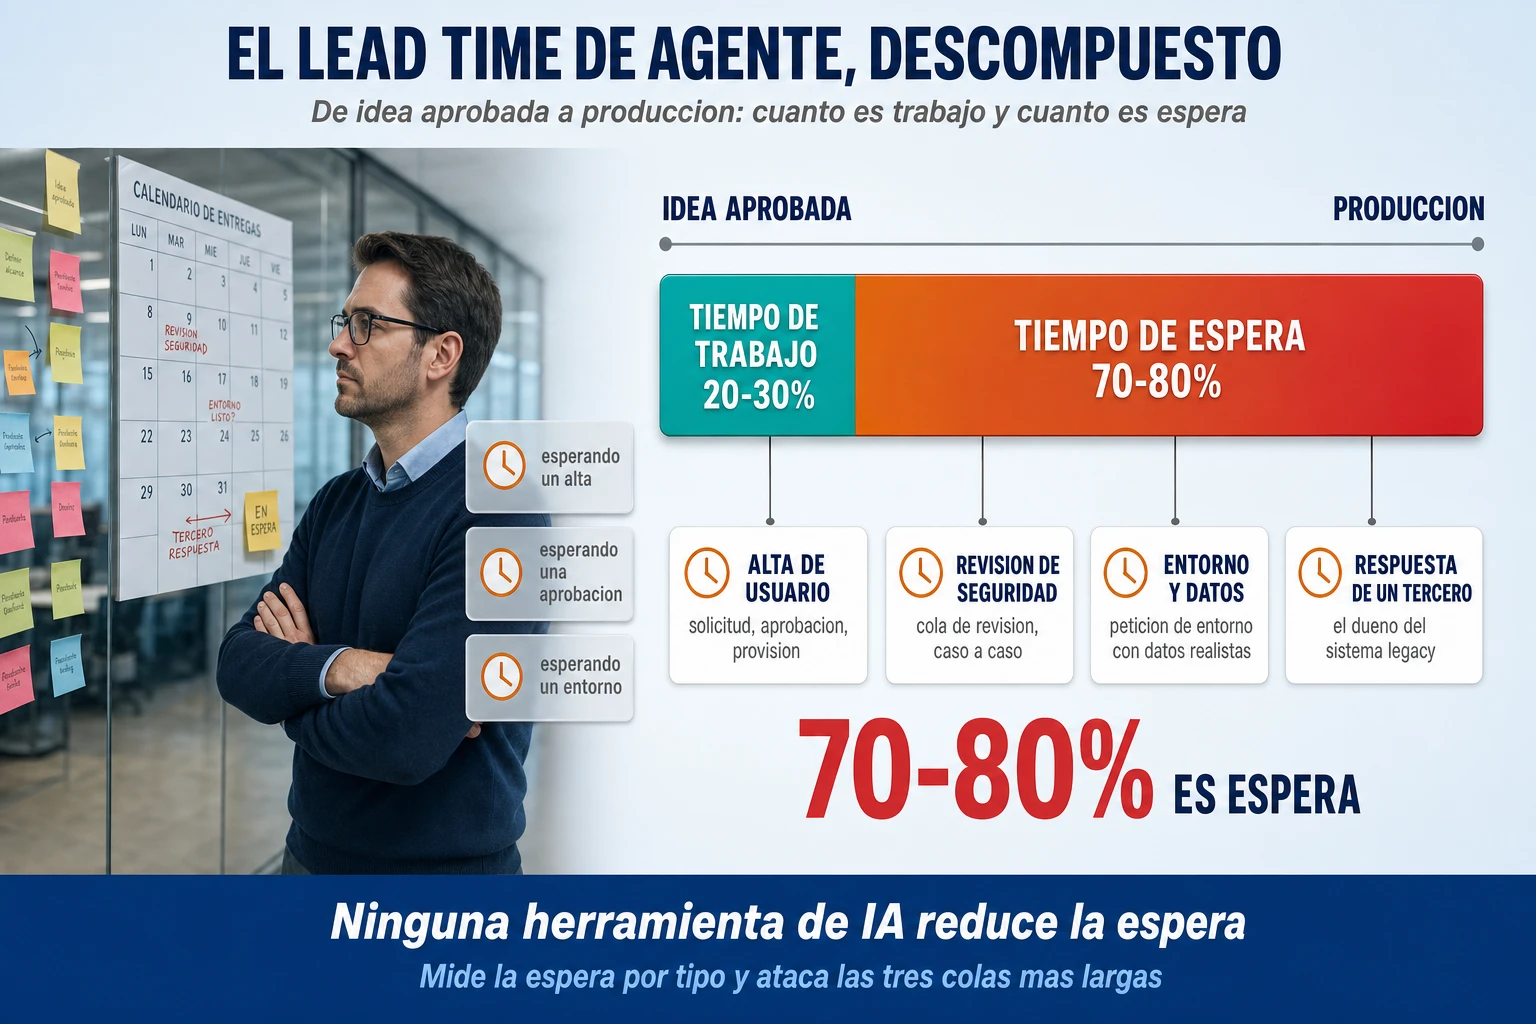
Recomendación: mida el lead time y publique cada trimestre la proporción de espera con el nombre de la cola más larga. Hacen falta dos fechas por transición y una etiqueta de «en trabajo» o «en espera». Nada acelera más una aprobación que aparecer en un gráfico como el cuello de botella del programa.
La pregunta correcta no es qué componentes necesito
La conversación sobre plataformas agénticas empieza casi siempre con la pregunta equivocada: ¿qué componentes necesito? Es cómoda porque tiene respuesta de catálogo, y aquí hay once componentes y unas cuantas tablas para contestarla. Pero no es la que decide el resultado.
Hay dos que sí lo deciden. La primera: ¿cuántas veces voy a tener que volver a decidir esto? Cada decisión que se toma una vez y se convierte en valor por defecto es un agente más al mes; cada decisión que se reabre en cada proyecto son seis semanas que se pagan íntegras otra vez.
La segunda es la que este artículo ha puesto en el centro: ¿quién escribe lo que la compañía sabe hacer, y dónde lo escribe? Un catálogo de herramientas es eso, escrito de forma que una máquina pueda elegir. Si nadie lo escribe, el modelo lo adivina. Si se escribe copiando endpoints, se escribe mal, y está medido que eso rinde peor que no escribir nada. Y si se escribe bien, el mismo caso se resuelve con un modelo más barato, con menos intentos y con una auditoría que se sostiene.
El trabajo consiste en cuatro cosas poco lucidas y sin demo asociada. Mirar las once piezas y señalar cuáles no tienen dueño. Separar el plano de control del punto de aplicación, y escribir en una página quién decide y quién obliga. Escribir las capacidades de un dominio en lenguaje de negocio antes de exponer la primera herramienta. Y elegir un caso 0 que obligue a montar lo que de verdad hace falta.
Un agente se construye en tres días. Lo que tarda siete meses es todo lo que no es el agente. Y casi todo lo que no es el agente se monta una sola vez.
En Transformalix ayudamos a separar los dos relojes antes de que el programa arranque: qué decisiones de plataforma hay que cerrar una sola vez, cómo se reparte el plano de control entre políticas, identidad y catálogo, qué capacidades de negocio merecen convertirse en herramientas y cuáles no, qué patrón de acceso al dato toca en cada caso y qué hay que negociar con el proveedor de modelo para no quedarse sin salida. Si está montando una plataforma de agentes —o ya la tiene y sospecha que cada caso de uso la está volviendo a abrir—, hablemos.