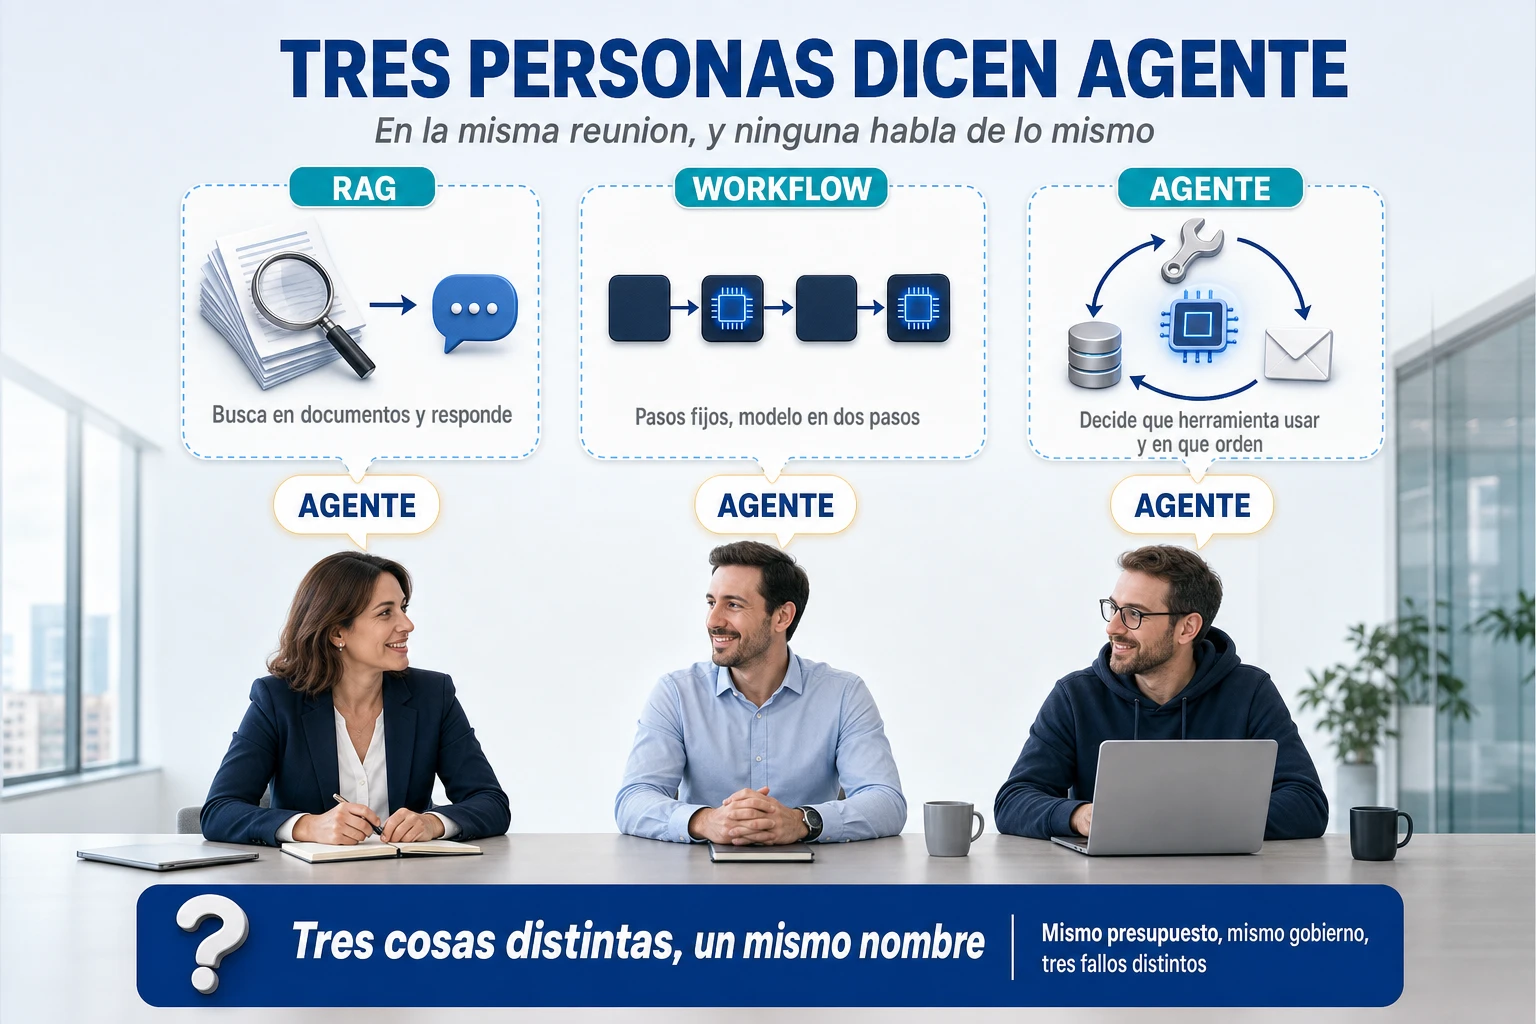
En la misma reunión, tres personas dicen «agente» y ninguna habla de lo mismo. La directora de atención al cliente habla de un asistente que responde con la base de conocimiento: eso es RAG, un buscador que recupera fragmentos de documentos y se los pasa al modelo para que redacte la respuesta. El director de operaciones habla de un flujo que lee facturas, las clasifica y las contabiliza: eso es un workflow, un proceso con pasos fijos en el que el modelo interviene dos veces, una para extraer los datos y otra para clasificar el gasto. El director de tecnología habla de un sistema que decide por sí mismo qué herramientas usar y en qué orden hasta cerrar una incidencia: eso sí es un agente.
Los tres se llaman «agente» en la presentación. Los tres se presupuestan igual, se gobiernan igual y pasan por el mismo comité de seguridad. Y los tres van a fallar por motivos distintos: el primero por responder con aplomo sobre un documento caducado, el segundo por contabilizar un importe mal extraído que nadie revisó, el tercero por hacer algo que nadie le pidió.
El precio de esa confusión se paga tres veces. Se compra una plataforma multiagente para lo que era una búsqueda sobre documentos. Se da autonomía a lo que debía ser un proceso con pasos fijos, y aparece el no determinismo justo donde no lo había. Y se somete a la revisión de seguridad propia de un agente a lo que es un formulario con un modelo detrás, con lo que el comité tarda cuatro meses en aprobar algo que no podía hacer daño a nadie. Tres errores de diseño, y ninguno es un error de inteligencia artificial.
La tesis que ordena todo lo que sigue cabe en dos frases. La autonomía no es una prestación: es un coste. La arquitectura correcta para un problema es la que le da la mínima autonomía que lo resuelve, y casi siempre es más simple que la que se está comprando.
Lo que define una arquitectura agéntica no es el modelo. Es quién decide el siguiente paso. Si lo decide el código, es un workflow. Si lo decide el modelo, es un agente. Todo lo demás son piezas.
Ese criterio, y no la cantidad de inteligencia artificial que lleva dentro, es el que separa lo que hay que gobernar de una forma y lo que hay que gobernar de otra. Un workflow con cuatro llamadas al modelo se prueba, se audita y se presupuesta como un proceso. Un agente con una sola herramienta se prueba, se audita y se presupuesta como un sistema que toma decisiones. Confundir los dos es la fuente de la mayoría de los sobrecostes y de casi todos los incidentes que hoy se atribuyen a «la IA».
Con ese criterio en la mano, la lista de casos de uso de cualquier gran empresa cambia de aspecto. De los seis que aparecen siempre —asistente documental, analista de datos, atención al cliente, backoffice, operaciones de red y seguridad, procesos autónomos— solo tres necesitan un agente de verdad. Los otros tres funcionan mejor, más barato y con menos incidentes sin él.
Qué es una arquitectura agéntica: quién decide el siguiente paso
La definición operativa es corta. Un agente es un sistema en el que un modelo de lenguaje, dentro de un bucle, elige acciones —llamar a una herramienta, consultar un dato, escribir en un sistema, preguntar a una persona— en función de lo que observa, hasta cumplir un objetivo o rendirse. Tres ingredientes, los tres obligatorios: un modelo que razona, unas herramientas descritas para que pueda usarlas y un bucle con criterio de parada. Si falta el bucle, es una llamada al modelo. Si falta el criterio de parada, es un incidente esperando fecha.
La distinción que ha adoptado la industria la publicó Anthropic el 19 de diciembre de 2024. Un workflow es un sistema donde el modelo y las herramientas «se orquestan mediante rutas de código predefinidas»; un agente es un sistema donde «el modelo dirige dinámicamente sus propios procesos y uso de herramientas». OpenAI, en su guía práctica de 2025, llega al mismo sitio: un agente es un sistema que «realiza tareas de forma independiente en su nombre», y los chatbots simples y los clasificadores «no son agentes» aunque lleven un modelo dentro. Google y Microsoft han llevado la distinción al producto: sus frameworks separan los agentes en los que decide el modelo de los flujos en los que decide el código, con nombres y controles distintos.
Es la distinción útil porque no mide «cuánta IA tiene» el sistema, sino quién controla el flujo. Un proceso de facturas puede llamar al modelo cinco veces y seguir siendo un workflow, porque el orden está escrito. Un sistema que llama al modelo una vez pero le deja decidir si después consulta el CRM, envía un correo o cierra el ticket ya es un agente. Lo primero se prueba como software; lo segundo, como una distribución de comportamientos, y esa diferencia cambia el coste, la latencia, la varianza y el gobierno.
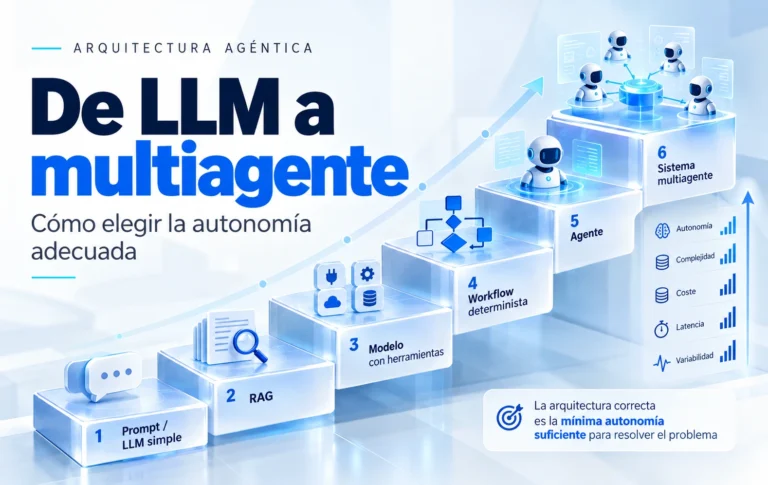
La escalera de seis peldaños
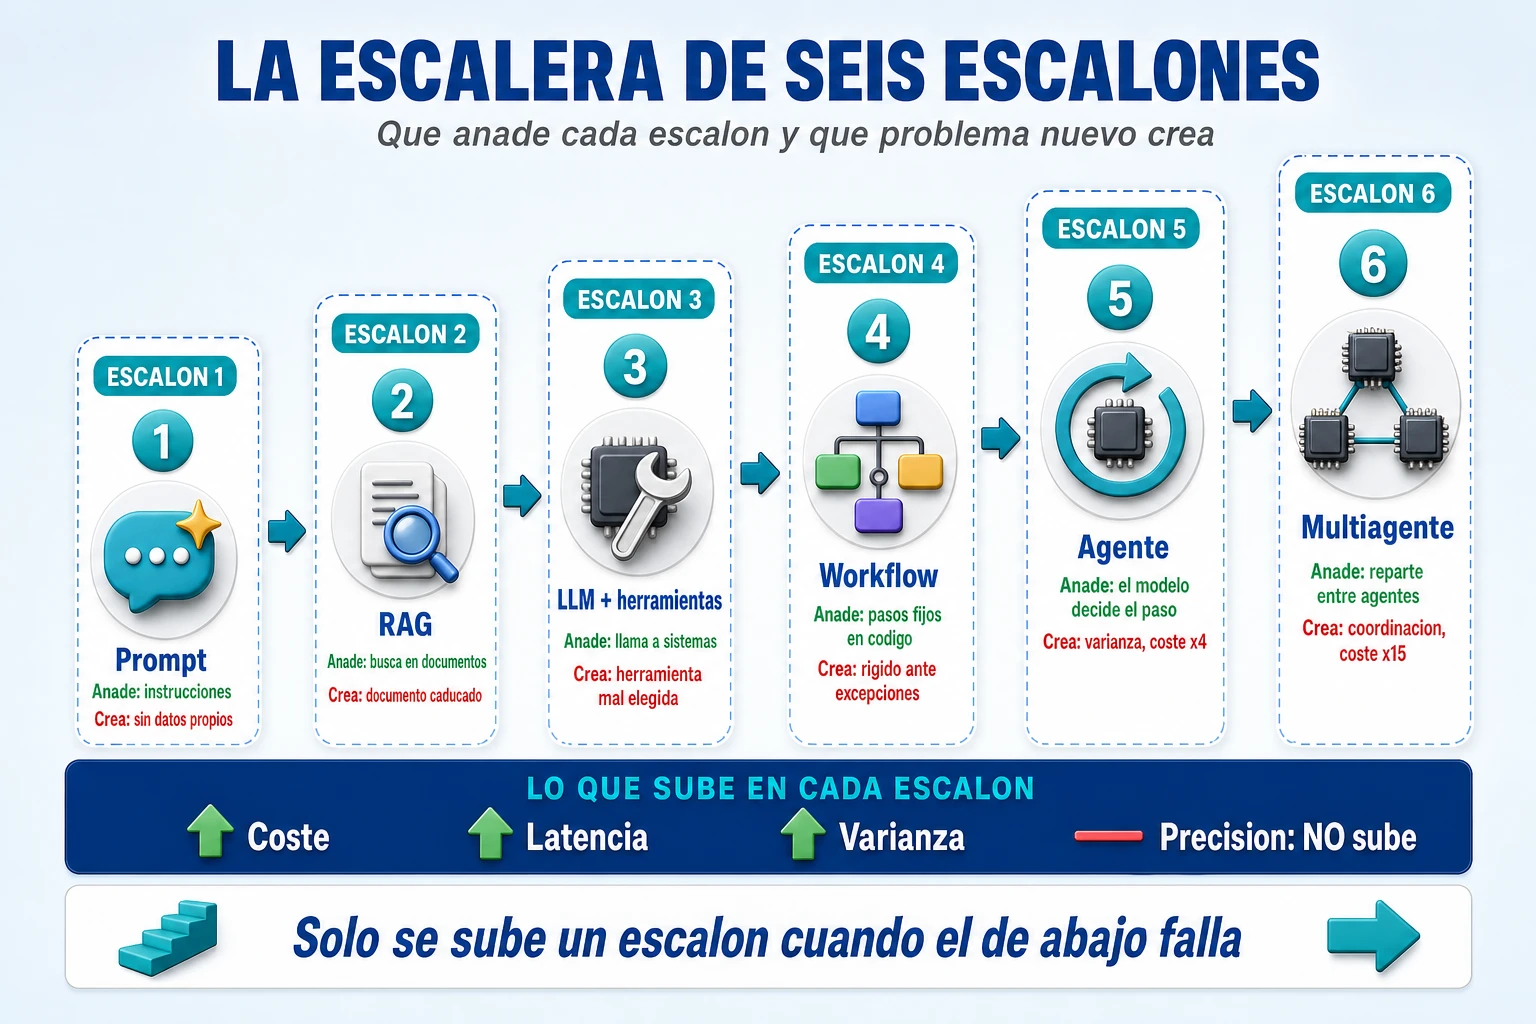
La forma más clara de situar cualquier sistema es una escalera de seis peldaños. Cada uno añade algo al anterior, resuelve un problema concreto y crea uno nuevo, y cada uno tiene fecha. El primero es el prompt: una llamada al modelo con toda la información dentro de la petición. El segundo es el RAG, la generación aumentada por recuperación, formulada en mayo de 2020: antes de generar, el sistema busca en un índice los fragmentos relevantes y se los pasa al modelo, que responde citándolos. El tercero es el modelo con herramientas: su antecedente académico es ReAct, en octubre de 2022, y su versión comercial llegó con el function calling de OpenAI el 13 de junio de 2023, con el uso de herramientas de Anthropic en disponibilidad general el 30 de mayo de 2024 y con el computer use, manejar una pantalla como si fuera una herramienta, en octubre de 2024.
El cuarto es el workflow determinista con el modelo en pasos concretos: un motor de procesos fija el orden, los reintentos, las esperas y las puertas de aprobación, y el modelo aparece como una función más. Es el peldaño que casa con la mayoría de los procesos de backoffice y el que menos se vende, porque no tiene demo. El quinto es el agente: el modelo decide el siguiente paso y cuándo parar, dentro de límites que fija el código. El sexto es el sistema multiagente, con varios agentes con contexto propio y un orquestador que reparte y recoge. Los estándares que hacen posibles los dos últimos son recientes: MCP, el protocolo para conectar agentes con herramientas, se publicó el 25 de noviembre de 2024; A2A, el protocolo para conectar agentes entre sí, el 9 de abril de 2025; los dos se gobiernan hoy desde una fundación de la Linux Foundation.
| Peldaño | Qué añade | Qué problema resuelve | Qué problema nuevo crea | Quién decide el flujo | Ejemplo |
| 1. Prompt | Una llamada al modelo con toda la información en la petición | Redactar, resumir, clasificar con etiquetas conocidas | Salida no determinista; sin acceso a datos actuales | El código, todo | Clasificar un correo de soporte en facturación, técnico o baja |
| 2. RAG (2020) | Recuperación de fragmentos de un corpus antes de generar | Conocimiento propio y actualizable sin reentrenar | Recuperación pobre; permisos por documento; respuesta segura sobre documento caducado | El código, con una recuperación fija | Responder «¿cuál es la política de devoluciones?» con cita al documento vigente |
| 3. Modelo con herramientas (2022-2024) | El modelo elige una función y sus argumentos; el código la ejecuta | Datos vivos y acciones simples | Herramientas mal descritas; argumentos inventados; primer riesgo de acción real | El código, salvo la elección de herramienta en cada vuelta | Consultar el estado del pedido 4711 en el sistema de pedidos y responder |
| 4. Workflow determinista con modelo en pasos | Un motor de procesos fija orden, reintentos, esperas y aprobaciones; el modelo es una función | Procesos repetibles y auditables que necesitan leer texto o decidir en ambigüedad acotada | Rigidez ante casos no previstos; tentación de «agentizarlo» después | El código, siempre | Extraer una factura, validarla contra el pedido, pedir aprobación, contabilizar |
| 5. Agente (2024-2025) | El modelo decide el siguiente paso y cuándo terminar | Problemas con número de pasos impredecible y decisiones en ejecución | Varianza; unas cuatro veces más tokens que un chat; bucles; acciones no pedidas | El modelo, dentro de límites que fija el código | Diagnosticar una incidencia abierta probando hipótesis con varias herramientas |
| 6. Sistema multiagente (2025) | Varios agentes con contexto propio y un orquestador que reparte y recoge | Amplitud paralelizable; dominios con contextos incompatibles | Unas quince veces más tokens que un chat; fallos de coordinación; contexto perdido entre agentes | El orquestador, que puede ser código o modelo | Investigar un mercado repartiendo fuentes entre subagentes que devuelven un resumen |
Lo que la escalera no dice
La escalera sugiere progreso, y ahí está la trampa. Subir un peldaño no mejora la precisión de las respuestas: la reduce, porque añade una decisión más que el modelo puede tomar mal. Lo que sube es el coste, la latencia y la varianza. Anthropic lo cuantificó el 13 de junio de 2025 al describir su sistema de investigación multiagente: los agentes «usan típicamente unas cuatro veces más tokens que una interacción de chat, y los sistemas multiagente unas quince veces más». Es la cifra de un proveedor sobre su propio sistema, pero es la única medida pública de este tipo y es coherente con lo que se observa en despliegues reales.
El mismo texto trae el dato incómodo. Su sistema multiagente superó al agente único en un 90,2 % en la evaluación interna de Anthropic, pero el propio análisis reconoce que el consumo de tokens «explica por sí solo el 80 % de la varianza» del rendimiento. El multiagente gana en gran parte porque gasta más, en paralelo. No es una tecnología mejor; es una forma de comprar más intentos a la vez, y solo compensa en «tareas cuyo valor es suficientemente alto para pagar el aumento de rendimiento». De ahí la regla que gobierna el resto del artículo: solo se sube un peldaño cuando el de abajo falla por una razón que el de arriba resuelve. Si el RAG responde bien el 92 % de las preguntas, la pregunta correcta es qué pasa con el 8 % restante, y casi nunca la respuesta es «un agente». Suele ser mejor troceado, mejor recuperación o mejor documentación.
Diez piezas que se confunden en cada reunión
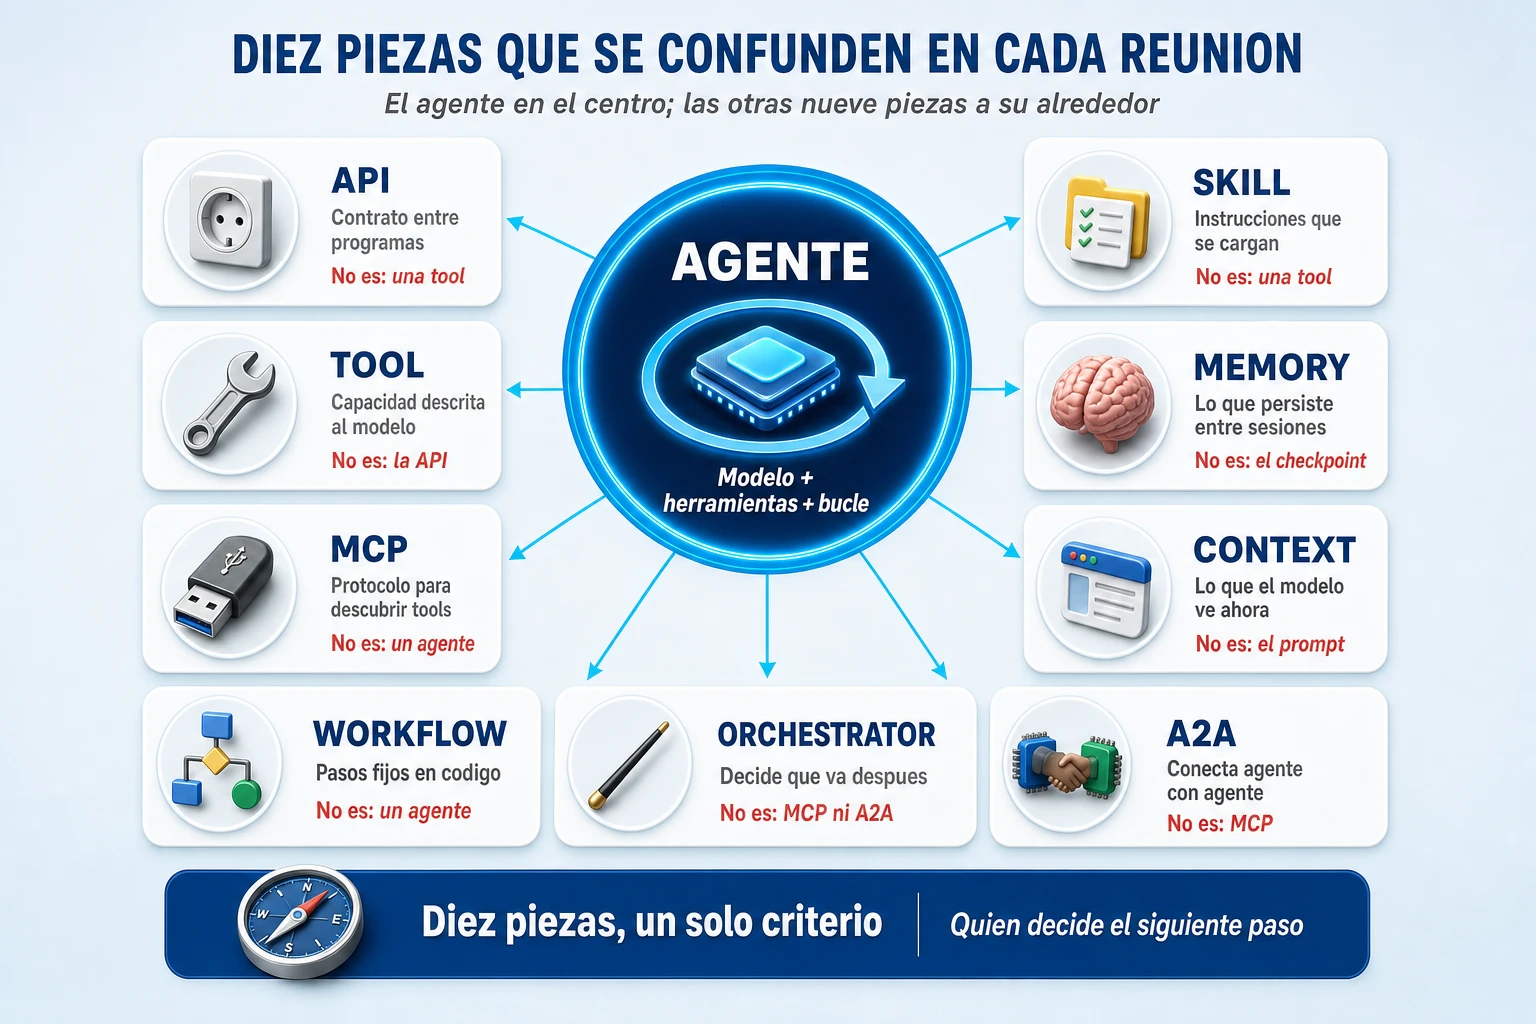
Diez palabras aparecen en cualquier conversación sobre agentes, y la mitad de las veces se usan mal: API, tool, MCP, agente, skill, memoria, contexto, workflow, orquestador y A2A. Ninguna es difícil. El problema es que se parecen por parejas, y la pareja se confunde. La tabla las pone en fila con el mismo ejemplo para todas —consultar el estado de un pedido— porque es la única forma de ver dónde termina una y empieza la siguiente.
| Pieza | Qué es | Para qué sirve | Con qué se confunde | Ejemplo con «estado de un pedido» |
| API | Contrato técnico entre dos programas: operaciones, parámetros, formatos, errores, autenticación | Exponer las capacidades de un sistema a otro software | Con la tool: la API existe sin ninguna IA y la consume código | La operación consultar pedido por identificador del sistema de pedidos, documentada en OpenAPI |
| Tool (herramienta) | Función descrita al modelo con nombre, descripción y esquema de entrada, que el modelo puede pedir que se ejecute | Que el modelo lea datos o actúe sobre sistemas | Con la API (la tool es la descripción legible por el modelo) y con MCP (la tool es la unidad; MCP, el protocolo) | obtener_estado_pedido(identificador), que envuelve la llamada a la API y devuelve una respuesta pensada para un modelo |
| MCP | Protocolo abierto que estandariza cómo una aplicación de IA descubre e invoca tools, recursos y prompts de un servidor | Construir la integración una vez y usarla desde cualquier cliente compatible | Con un agente u orquestador (MCP no decide nada) y con A2A (no conecta agentes entre sí) | Un servidor MCP de pedidos expone la tool anterior; la consumen tres asistentes distintos sin código específico |
| Agente | Sistema en el que el modelo decide dinámicamente los pasos y las herramientas, en un bucle, hasta cumplir un objetivo | Tareas abiertas cuyo número de pasos no se puede predecir | Con el chatbot (no controla el flujo) y con el workflow (el flujo está en el código) | Recibe «¿dónde está mi pedido?», consulta, ve el retraso, lee la política de compensación, propone un vale y pide aprobación antes de emitirlo |
| Skill | Carpeta con un fichero de instrucciones, ejemplos, scripts y recursos que el agente carga solo cuando la tarea lo requiere | Dar al agente conocimiento procedimental de la empresa, versionado y portable | Con la tool (la skill es cómo hacerlo; la tool, poder hacerlo) y con el prompt (la skill se carga bajo demanda) | «Gestión de incidencias de pedidos»: qué comprobar, umbrales de compensación, plantillas de respuesta |
| Memoria | Información persistida fuera de la ventana de contexto que el agente recupera en interacciones futuras | Continuidad entre sesiones y personalización | Con el checkpoint del runtime: reanudar una ejecución no es recordar al cliente | Recuerda que este cliente reclamó dos veces este mes y que prefiere el correo al teléfono |
| Contexto | El conjunto de tokens que entra en una llamada concreta al modelo | Que el modelo tenga exactamente lo que necesita para el siguiente paso | Con el prompt (es solo una parte) y con la memoria (la memoria está fuera; el contexto, dentro) | Instrucciones + skill activada + definiciones de tools + historial + resultado de la consulta + notas sobre el cliente |
| Workflow | Código determinista que orquesta llamadas al modelo y a herramientas por rutas predefinidas | Procesos repetibles, auditables y de coste acotado | Con el agente: aquí el modelo nunca decide la topología | Clasificar la petición → si es «estado de pedido», llamar a la API → redactar con el modelo → enviar |
| Orquestador | Componente que decide qué agente, herramienta o paso viene a continuación | Coordinar varios agentes o pasos | Con MCP y A2A (que solo transportan) y, si es un modelo, con «un agente más» | Un enrutador decide si la petición va al agente de pedidos, al de facturación o a una persona |
| A2A | Protocolo abierto para que agentes independientes se descubran y se deleguen tareas como pares | Interoperar entre agentes de distintos frameworks, proveedores u organizaciones | Con MCP (herramientas, no pares) y con un bus de mensajes genérico | El agente de atención delega en el agente del transportista, otra empresa, la tarea «localizar envío» y sigue su estado hasta que termina |
API, tool y MCP: el sistema, la capacidad y el enchufe
Una API es un contrato para software: qué operaciones existen, con qué parámetros, qué devuelven y cómo se autentica quien las llama. Existe sin ninguna IA y la consume código. Una tool es una capacidad descrita para que un modelo decida usarla: un nombre de negocio, una descripción que dice cuándo conviene usarla, un esquema de entrada y una respuesta pensada para que la lea un modelo. La diferencia parece menor y no lo es. Anthropic la resume en una regla que conviene enmarcar: «si un ingeniero humano no puede decir con certeza qué herramienta usar, no cabe esperar que un agente lo haga mejor». La mayoría de los catálogos de tools nacen exponiendo las API tal cual, con sus doscientos parámetros, y el agente falla porque nadie le ha explicado cuál de las cuatro operaciones parecidas es la que toca.
MCP, el Model Context Protocol, es el enchufe. Lo publicó Anthropic el 25 de noviembre de 2024 como estándar abierto para que un agente descubra e invoque tools —y también recursos, que son datos de contexto, y prompts, que son plantillas— sin integración a medida. Su documentación lo compara con «un puerto USB-C para aplicaciones de IA», con un matiz: un puerto es pasivo, y MCP también transporta acciones con efectos, como borrar o pagar. En diciembre de 2025 se donó a la Agentic AI Foundation, bajo la Linux Foundation, con AWS, Anthropic, Block, Bloomberg, Cloudflare, Google, Microsoft y OpenAI como miembros platino y más de 10.000 servidores publicados. La revisión de julio de 2026 es, según el propio proyecto, «la mayor desde el lanzamiento»: el protocolo pasa a ser sin estado y sin sesiones, con extensiones formales para tareas largas y aprobaciones.
Lo que MCP no es importa tanto como lo que es. No es un agente ni un orquestador: la especificación dice que «no dicta cómo las aplicaciones usan los modelos ni gestionan el contexto»; la decisión de llamar a una tool la toma el modelo. Y no resuelve por sí solo la seguridad: quién puede exponer un servidor, quién lo aprueba, con qué identidad se ejecuta cada llamada y cómo se filtran las herramientas por rol son decisiones de plataforma, con su gateway y su registro, que se desarrollan en el artículo sobre la plataforma de agentes.
Agente, workflow y orquestador: quién decide el siguiente paso
El orquestador es el componente que decide qué va después: qué agente, qué herramienta, qué paso. Puede ser código —un grafo, una máquina de estados, un motor de procesos— o un modelo que delega, lo que la industria llama supervisor. Esa es toda la diferencia vista desde dentro: un workflow tiene el orquestador en el código, y un agente lo lleva dentro del modelo. Dos consecuencias. Un workflow puede llamar al modelo muchas veces sin dejar de serlo, porque el modelo nunca decide la topología: un enrutado entre tres ramas predefinidas sigue siendo un workflow. Y un orquestador que es un modelo es un agente cuya herramienta principal son otros agentes, y hay que gobernarlo como tal.
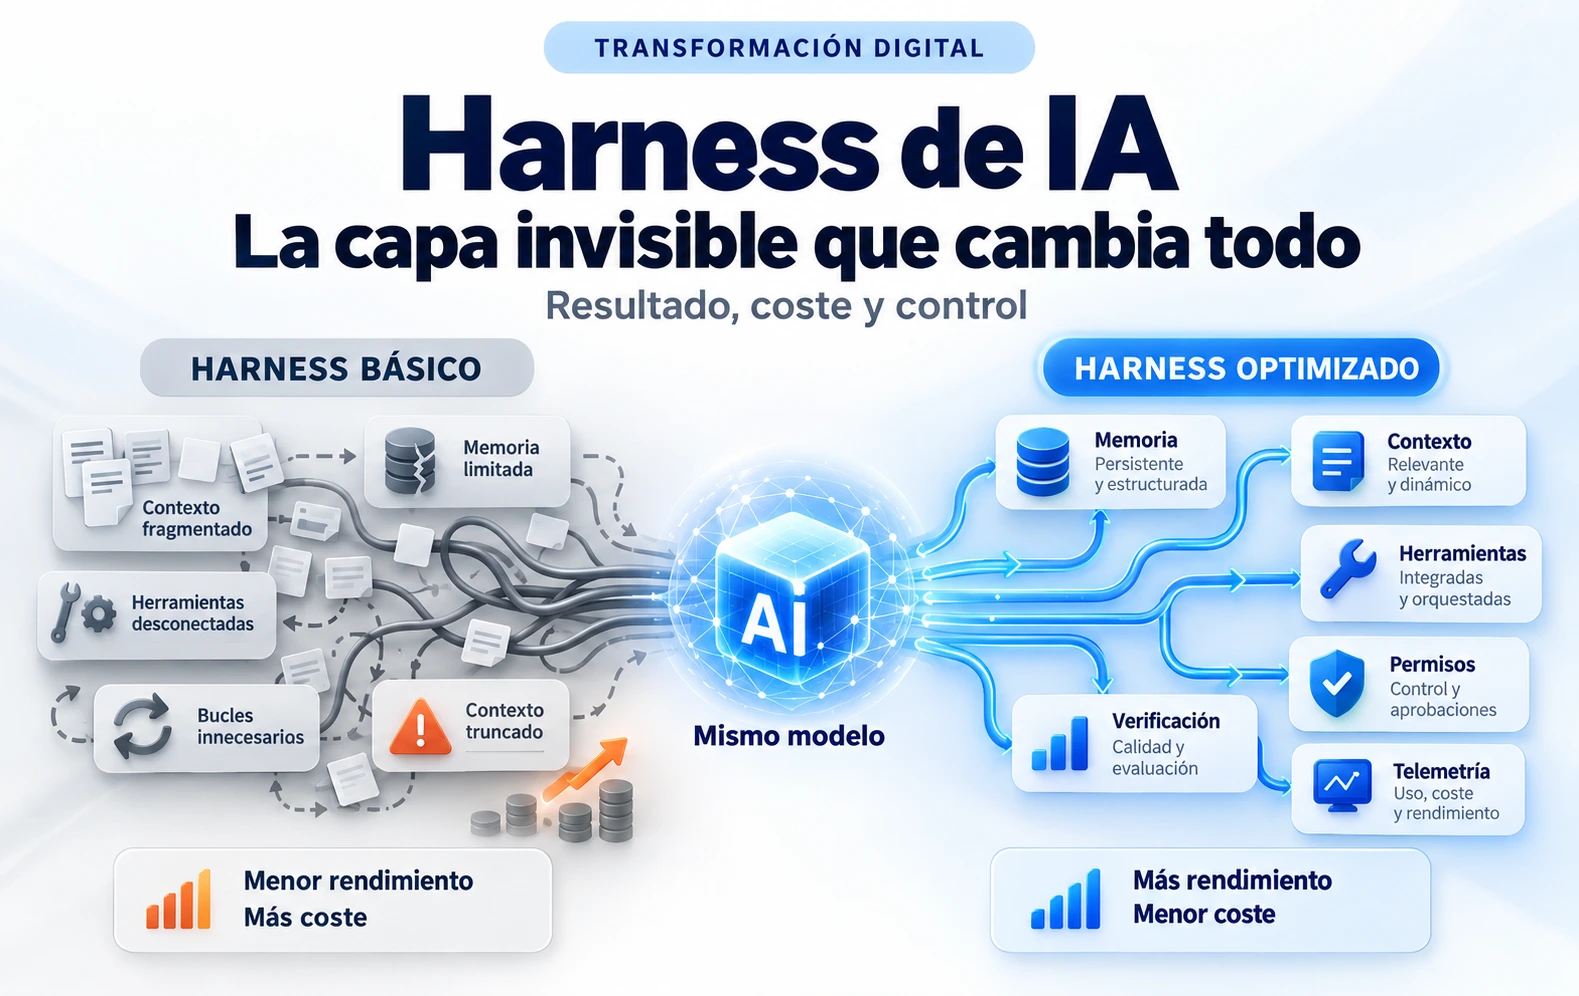
Una advertencia de vocabulario: OpenAI usa «workflow» para la tarea de negocio y «agente» para quien la ejecuta; Anthropic usa «workflow» para la arquitectura determinista, y esa es la acepción de este artículo. Y una palabra más que el lector va a oír: harness, el arnés, el nombre que Anthropic, OpenAI, Microsoft y AWS han dado en 2025 y 2026 a todo lo que rodea al modelo para que trabaje solo: el bucle de herramientas, la gestión del contexto, los permisos, la persistencia, la verificación, la telemetría. Cuando alguien dice que «la calidad está en el harness», dice que está en la parte del sistema que no es el modelo. Suele tener razón.
Skill, memoria y contexto: lo que el agente sabe, recuerda y ve
Una skill es un paquete de instrucciones, ejemplos y recursos que el agente carga cuando la tarea lo requiere y no antes. Anthropic las presentó el 16 de octubre de 2025 como «carpetas con instrucciones, scripts y recursos que se cargan cuando hacen falta», y en diciembre de 2025 las publicó como estándar abierto, adoptado por OpenAI, Google, Microsoft, Cursor, Block y JetBrains. El mecanismo importante es la carga progresiva en tres niveles: al arrancar, el agente ve solo el nombre y la descripción de cada skill; cuando la tarea encaja, lee las instrucciones completas; y solo si hace falta carga los ficheros o ejecuta los scripts. La diferencia con la tool está en una frase de Anthropic: las skills «complementan a los servidores MCP enseñando workflows más complejos». La skill es el cómo; la tool es el poder hacerlo.
La memoria es lo que persiste entre sesiones fuera de la ventana de contexto. La taxonomía de referencia, publicada en 2023 con el nombre de CoALA, distingue cuatro: de trabajo (lo que está activo en la ventana ahora), episódica (qué pasó), semántica (hechos y preferencias) y procedimental (cómo se hacen las cosas: instrucciones, skills). El contexto es lo que el modelo ve en este turno: Anthropic lo define como «el conjunto de tokens incluidos al muestrear del modelo», e incluye instrucciones, definiciones de tools, skills activadas, historial, resultados de herramientas, documentos recuperados, memoria recuperada y la petición del usuario. La memoria está fuera y puede traerse; el contexto está dentro en una llamada concreta.
Hay una confusión que aparece en casi todas las presentaciones de plataforma: el estado o checkpoint del runtime no es la memoria del agente. El checkpoint es lo que permite reanudar una ejecución interrumpida —un flujo que espera cuatro horas a que alguien apruebe un reembolso—; es un asunto de fiabilidad y lo gestiona la plataforma. La memoria es lo que permite al agente recordar al cliente la semana que viene; es un asunto de producto y de gobierno del dato, y lo decide el diseño del caso de uso. Confundirlos produce agentes que «recuerdan» cosas que no debían y flujos que no se pueden reanudar.
A2A: cuando el otro extremo también es un agente
A2A, el protocolo Agent2Agent, lo lanzó Google el 9 de abril de 2025 con más de cincuenta socios; en marzo de 2026 alcanzó la versión 1.0, con tarjetas de agente firmadas criptográficamente, y en agosto de 2026 pasó a la misma fundación que MCP. Sus piezas son tres: una tarjeta de agente, publicada en una dirección conocida, que describe qué sabe hacer el agente y cómo se autentica; una tarea, la unidad de trabajo con estados, que incluye dos de interrupción, «requiere entrada» y «requiere autorización», donde vive la aprobación humana; y los mensajes y artefactos que se intercambian. La diferencia con MCP la formula su propia documentación: MCP conecta un agente con herramientas; A2A conecta un agente con otro agente. Su ejemplo es un taller mecánico: el agente del mecánico usa MCP para el escáner y el elevador, y A2A para hablar con el agente del jefe de taller y con los de los proveedores.
La frontera es porosa: un agente remoto puede envolverse como una tool, y muchos equipos lo hacen. La diferencia real es de tipo de interacción —una llamada sin estado frente a una tarea larga con diálogo— y de límite de confianza: A2A aporta valor cuando los agentes tienen dueño, herramientas y límites distintos, entre departamentos o entre empresas. De ahí un criterio de frontera: si la petición cabe en una función tipada, no hace falta A2A. «Dame el estado del envío 4711» es una tool. «Localiza este envío, y si está retenido en aduana, gestiona la documentación que falte y avísame cuando salga» es una tarea para otro agente. La crítica más seria a A2A es que llegó antes de que la mayoría de los equipos hubieran resuelto las herramientas, la inyección de instrucciones, la observabilidad y el coste de un solo agente. Muchas demos de 2025 no necesitaban A2A: necesitaban mejores tools, mejores permisos y mejores registros.
Los seis patrones de orquestación, y el debate que hay detrás
Un patrón de orquestación es la forma en que se decide qué paso viene después cuando hay más de uno. El catálogo canónico lo fijó Anthropic en diciembre de 2024 —encadenamiento, enrutado, paralelización, orquestador-trabajadores y evaluador-optimizador— y cada framework lo ha renombrado: OpenAI habla de manager y handoffs; Google ADK tiene agentes secuenciales, paralelos y de bucle que orquestan «sin consultar a un modelo»; Microsoft Agent Framework, que unificó AutoGen y Semantic Kernel en su versión 1.0 de abril de 2026, ofrece sequential, concurrent, handoff, group chat y magentic; AWS Strands, agentes como herramientas, enjambres y grafos; LangChain, subagentes, traspasos, skills y enrutadores. Los nombres cambian; los seis mecanismos de fondo no.
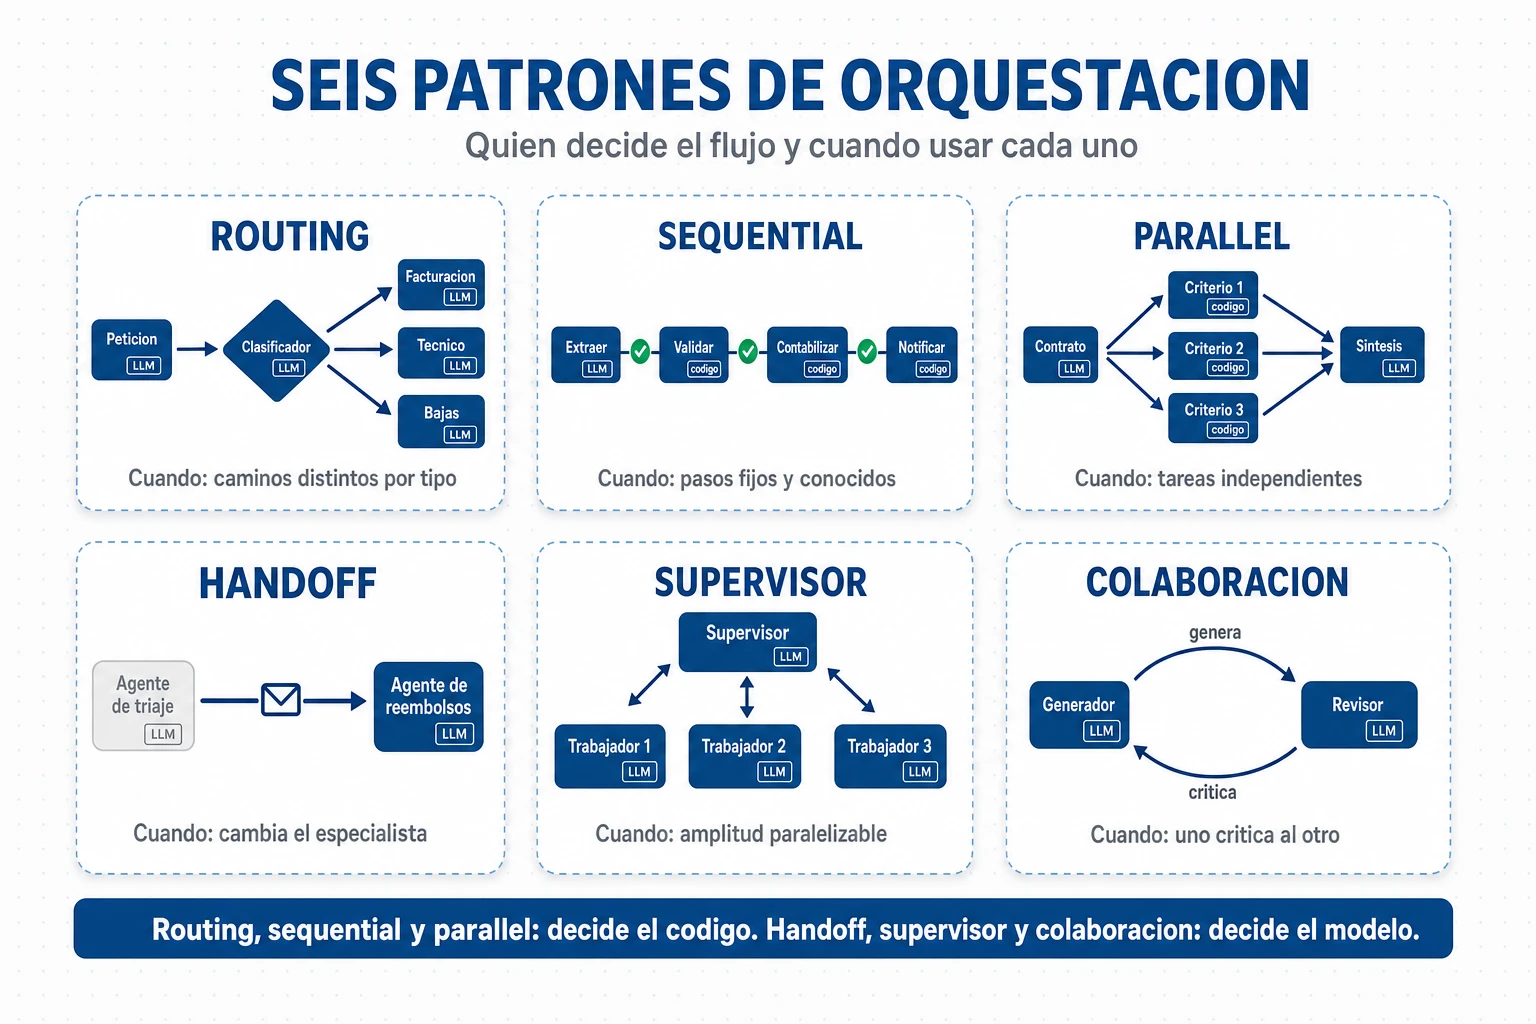
Routing: un clasificador envía la petición al camino correcto
Un paso inicial —un modelo pequeño o una regla— decide a qué flujo o agente especializado va la petición, y no la procesa. El buzón de soporte que separa facturación, técnico y bajas es el ejemplo: cada rama tiene sus herramientas y su base documental. Se usa cuando las categorías están bien diferenciadas y la ruta se identifica desde la petición inicial. No se usa cuando la especialidad aparece a mitad de la tarea (eso es un traspaso) ni cuando el error de clasificación es caro y no hay salida por defecto. Cuesta una llamada corta y cacheable; el riesgo es la clasificación errónea al inicio y el canal «otros» que recibe todo lo ambiguo. Se evalúa como cualquier clasificador: con una matriz de confusión.
Sequential: pasos fijos, la salida de uno es la entrada del siguiente
El código fija el orden, y entre paso y paso se ponen comprobaciones programáticas, que Anthropic recomienda explícitamente. Extraer una factura, validarla contra el pedido y contabilizarla es un encadenamiento. Se usa en procesos con dependencias lineales y en flujos de refinamiento, borrador → revisión → pulido. No se usa cuando las etapas son paralelizables, cuando hacen falta vueltas atrás o cuando la ruta depende de resultados intermedios. Es el patrón más previsible y trazable, con latencia sumada y tokens acotados. Su riesgo, en palabras de la guía de arquitectura de Azure, es que «los fallos de las etapas tempranas se propagan»: un importe mal extraído en el paso uno llega intacto al paso cuatro si nadie lo cruza con el pedido.
Parallel: varios pasos independientes a la vez, o varias versiones para votar
Dos variantes. En el seccionamiento, varias llamadas trabajan a la vez sobre partes distintas de la tarea y un agregador combina: revisar un contrato por tres criterios en paralelo. En la votación, varias versiones atacan la misma tarea y se decide por mayoría. Se usa con subtareas independientes, varias perspectivas o latencia crítica. No se usa cuando cada parte necesita el contexto de las otras o no hay estrategia para resolver resultados contradictorios. Reduce la latencia a la de la rama más lenta, pero los tokens son la suma de las ramas: más rápido y más caro. El riesgo son los resultados incompatibles y el estado compartido entre ramas, que Azure lista literalmente como antipatrón.
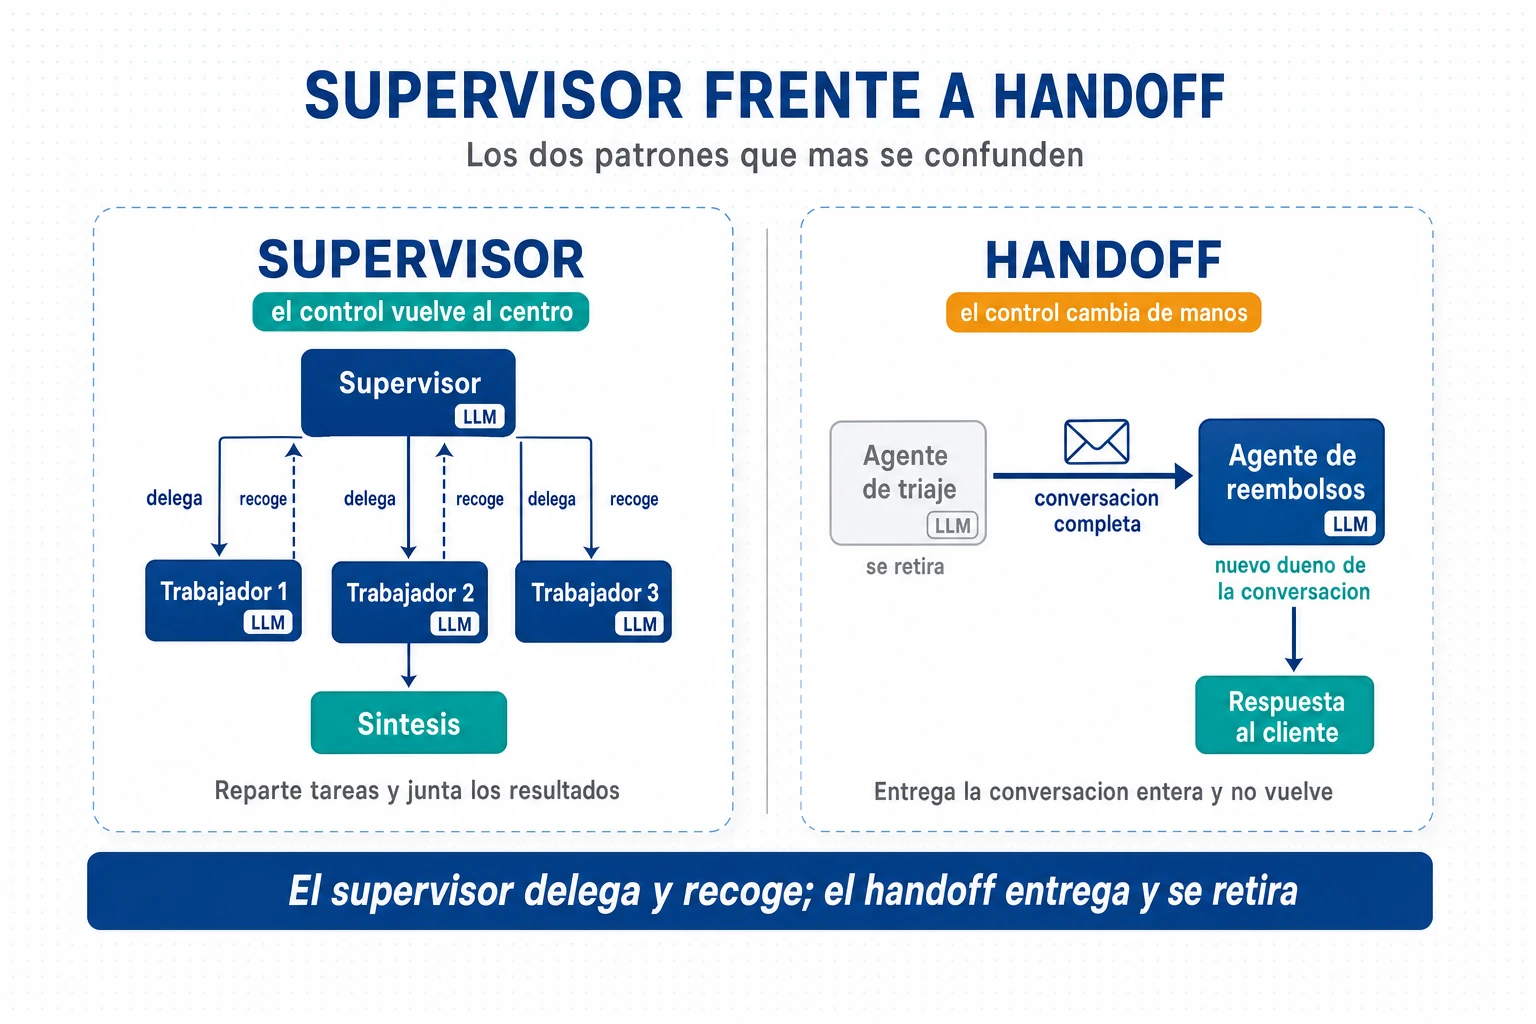
Handoff: un agente traspasa la conversación entera a otro, que pasa a ser el dueño
El agente activo decide, durante la ejecución, transferir la conversación completa a otro especialista, que la asume. No hay orquestador central: Microsoft lo describe como una «topología en malla sin orquestador», y en el SDK de OpenAI el traspaso es una herramienta llamada «transferir a» seguida del nombre del agente. El agente de triaje que pasa el caso al de reembolsos, y este a una persona, es el ejemplo. Se usa cuando la especialidad emerge durante el proceso y el usuario debe seguir hablando con quien le atiende. No se usa cuando la ruta se conoce al inicio (entonces es routing) ni cuando hace falta concurrencia. Cuesta un agente activo cada vez, pero el contexto completo viaja en cada transferencia. El riesgo típico es el bucle de traspasos: A cree que es de B, B cree que es de A, y el cliente ve pasar los minutos.
Supervisor: un agente central descompone, delega y sintetiza
Un agente conserva el control, descompone la tarea, invoca a los especialistas como si fueran herramientas y sintetiza. Anthropic lo llama orquestador-trabajadores; OpenAI, patrón manager; Microsoft, agentes como herramientas o, con planificación explícita, magentic, del que su propia documentación advierte que «no está probado fuera del diseño original». Es el patrón del sistema de investigación de Anthropic: un agente líder reparte fuentes entre subagentes que exploran con su propia ventana y devuelven «un resumen condensado, a menudo de 1.000 a 2.000 tokens». Se usa cuando no se pueden predecir las subtareas y hace falta una síntesis con un único responsable. No se usa cuando la tarea es lineal o cuando los trabajadores necesitan ver las decisiones de los demás. Es el patrón que Anthropic mide como unas quince veces el coste de un chat; su riesgo es el trabajo duplicado por instrucciones vagas y la pérdida de información en cada resumen.
Colaboración: agentes iguales que se pasan trabajo o critican la salida del otro
Caben dos mecanismos. El evaluador-optimizador es un bucle de dos: uno genera y otro evalúa contra criterios, hasta aprobar o hasta un límite de vueltas; un generador de código con un revisor que ejecuta las pruebas. Funciona con criterios claros y mejora medible; falla cuando el evaluador tiene el mismo modelo y el mismo sesgo que el generador, o cuando no hay criterio objetivo de «hecho» y el bucle no termina. La conversación en grupo es lo otro: varios agentes contribuyen a un hilo compartido y un gestor decide quién habla. Sirve para debate y revisión multidisciplinar con una persona en el hilo; la guía de Azure recomienda «tres agentes o menos», el coste crece con el cuadrado de los turnos, y la evidencia académica de 2026 es tajante: «treinta agentes debatiendo no producen más diversidad de respuesta que uno».
El debate que hay que conocer: un agente frente a muchos
Los días 12 y 13 de junio de 2025 se publicaron dos textos que parecen contradecirse. Anthropic explicó por qué su sistema de investigación multiagente compensa en tareas «de amplitud»: muchas direcciones independientes que explorar en paralelo. Un día antes, Cognition había publicado «No construyas multiagentes», con dos principios: «comparte el contexto y comparte las trazas completas» y «las acciones llevan decisiones implícitas, y las decisiones en conflicto producen malos resultados». Los dos tienen razón, porque hablan de tareas distintas: Anthropic admite que su sistema es inadecuado «para la mayoría de tareas de código»; Cognition acepta subagentes de solo lectura. La regla: paralelizar la lectura es razonable; paralelizar la escritura de un mismo artefacto es pedir decisiones incompatibles.
El estudio más serio sobre por qué fallan los sistemas multiagente lo publicó la Universidad de California en Berkeley en 2025 con el nombre de MAST: más de 1.600 trazas anotadas en siete frameworks, catorce modos de fallo en tres categorías. En su versión de octubre de 2025, el 41,8 % de los fallos se atribuye al diseño del sistema y a especificaciones ambiguas, el 32,35 % a la desalineación entre agentes y el 23,45 % a una verificación inadecuada. Dos tercios no son fallos «de coordinación»: son de especificación y de verificación, es decir, de ingeniería de producto. Y las intervenciones baratas funcionan: en uno de los frameworks, mejorar la especificación de los roles subió la tasa de éxito 9,4 puntos y añadir una verificación del objetivo, 15,6. Un estudio de 2026 con 260 configuraciones añade el matiz: la coordinación aporta hasta un 80,8 % en tareas descomponibles y resta hasta un 70 % en planificación secuencial.
De ahí un criterio en cuatro preguntas. ¿Un solo agente con herramientas bien diseñadas se rompe? OpenAI, Anthropic y Microsoft coinciden en que ese es el valor por defecto. Si se rompe, ¿es por lógica condicional inmanejable, por herramientas solapadas que no se arreglan con mejores descripciones, por límites de seguridad distintos por dominio o por paralelismo real de lectura? Solo esas cuatro razones justifican dividir. ¿La tarea vale unas quince veces el coste de un chat? Si no, el supervisor no se justifica. ¿Hay especificación de roles, verificación del objetivo y topes de iteraciones? Si no, el multiagente fallará por las razones que MAST describe.
| Patrón | Quién decide el flujo | Cuándo | Cuándo no | Coste relativo | Riesgo típico |
| Routing | Un clasificador (modelo o regla) al inicio | Categorías de entrada bien diferenciadas, ruta identificable desde la petición | La especialidad emerge a mitad de tarea; categorías solapadas; error de clasificación caro | Bajo: una llamada corta y cacheable | Clasificación errónea al inicio; el canal «otros» recibe lo ambiguo |
| Sequential | El código, en orden fijo | Pasos fijos con dependencias lineales; refinamiento progresivo | Etapas paralelizables; hace falta iterar o cambiar de ruta según resultados | Latencia sumada; tokens acotados por etapa | Los errores tempranos se propagan sin control intermedio |
| Parallel | El código (reparte y agrega) | Subtareas independientes; varias perspectivas; latencia crítica | Cada parte necesita el contexto de las otras; sin estrategia de conflicto; cuotas limitadas | Latencia de la rama más lenta; tokens = suma de ramas | Resultados contradictorios; estado compartido entre ramas |
| Handoff | El agente activo, sin orquestador | La especialidad emerge en conversación; el usuario sigue con quien le atiende | Ruta conocida al inicio; hace falta concurrencia; no se puede evitar el ping-pong | Un agente activo a la vez; el contexto completo viaja en cada traspaso | Bucles de traspaso entre agentes |
| Supervisor | Un agente central que llama a otros como herramientas | Subtareas impredecibles; hace falta síntesis y un responsable del resultado | Tarea lineal; los trabajadores necesitan ver las decisiones de los demás; escritura de un mismo artefacto | Alto: unas quince veces un chat (cifra de Anthropic sobre su sistema) | Trabajo duplicado por instrucciones vagas; pérdida en los resúmenes |
| Colaboración (evaluador-optimizador, grupo) | Un bucle con tope, o un gestor de conversación | Criterios de calidad claros y mejora medible; debate con una persona en el hilo | Sin criterio objetivo de «hecho»; mismo modelo y sesgo en ambos roles; tiempo real | Al menos dos llamadas por iteración; cuadrático con los turnos en grupo | Verificación complaciente; bucles de conversación; más de tres agentes |
Context engineering: qué ve el agente en cada turno
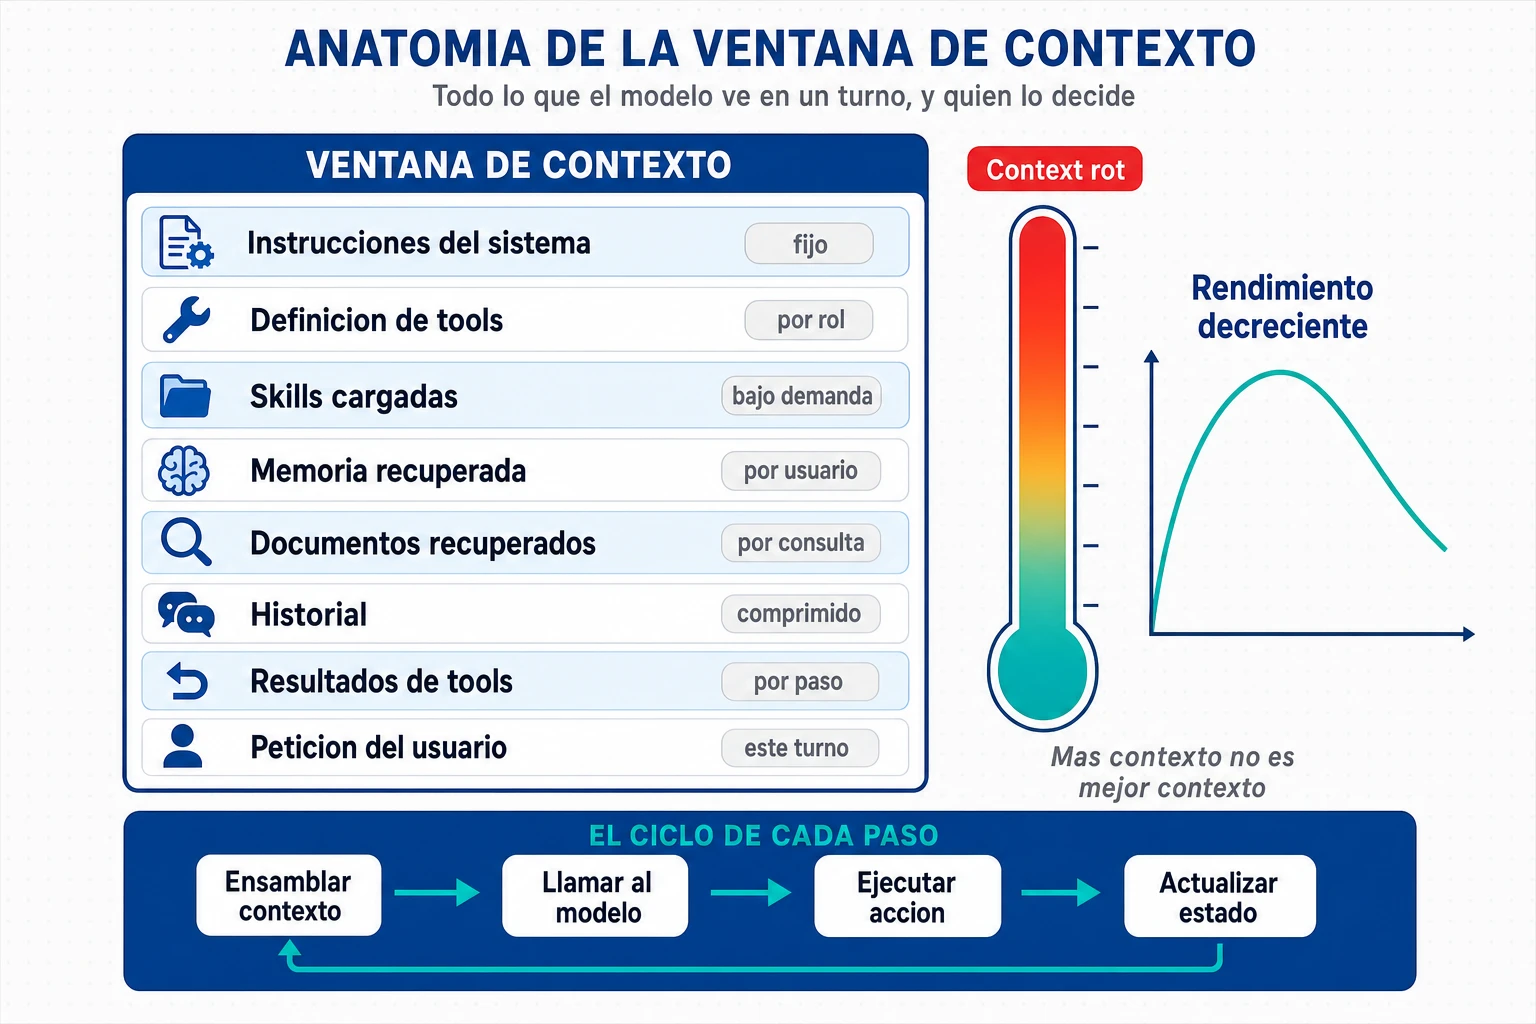
La disciplina cambió de nombre en junio de 2025. Hasta entonces se hablaba de prompt engineering, el arte de escribir instrucciones; en pocas semanas la industria pasó a hablar de context engineering, y Anthropic formalizó el término el 29 de septiembre de 2025: las estrategias para curar y mantener «el conjunto óptimo de tokens» durante la inferencia. La definición de Andrej Karpathy es la más útil: «el delicado arte y ciencia de llenar la ventana de contexto con exactamente la información correcta para el siguiente paso». El cambio no es cosmético: en un agente, el prompt es una parte pequeña de lo que el modelo ve.
La ventana de contexto es un recurso finito con rendimiento decreciente
Más contexto no es mejor contexto. Tres trabajos lo demuestran, y conviene tenerlos a mano cuando alguien diga que «el modelo tiene una ventana de un millón de tokens, así que cabe todo». El primero, de 2023, encontró la curva en U conocida como «perdido en el medio»: el rendimiento es mayor cuando la información relevante está al principio o al final de la entrada y cae cuando está en el medio, incluso en modelos diseñados para contextos largos. El segundo lo publicó Chroma el 14 de julio de 2025 con el nombre de context rot: sobre dieciocho modelos, «el rendimiento varía significativamente con la longitud de la entrada, incluso en tareas simples», y un solo elemento distractor ya degrada el resultado. El tercero es el texto de Anthropic de septiembre de 2025, que habla de un «presupuesto de atención» que cada token consume: el contexto es «un recurso finito con rendimientos decrecientes». La implicación de diseño: cada agente o turno debe recibir el mínimo contexto suficiente, no el máximo disponible. Cargar toda la base de conocimiento «por si acaso», todo el historial del cliente y las doscientas herramientas del catálogo no hace al agente más capaz. Lo hace más lento, más caro y peor.
Anatomía de un turno
En cada paso del bucle, el runtime construye la ventana desde cero a partir de piezas gestionadas por separado, llama al modelo, ejecuta la acción que el modelo pide y actualiza el estado. Ese ciclo —ensamblar contexto, llamar, ejecutar, actualizar— se repite decenas de veces en una sola tarea. Lo que entra en la ventana son ocho cosas, y cada una la decide alguien distinto, se carga en un momento distinto y tiene su propia forma de controlar el tamaño.
| Elemento del contexto | Quién lo decide | Cuándo se carga | Cómo se controla su tamaño |
| Instrucciones del sistema | El diseñador del agente; políticas de la organización por encima | Siempre, como prefijo estable | «Altitud correcta»: heurísticas claras, sin lógica frágil ni vaguedad; cacheado como prefijo |
| Definiciones de herramientas | El catálogo, filtrado por rol y fase | Al inicio; las de uso raro, bajo demanda | Herramientas mínimas y claras; carga diferida; búsqueda de herramientas a partir de unas decenas |
| Skills cargadas | El agente, al detectar que la tarea encaja | Solo nombre y descripción al arrancar; el contenido cuando toca | Carga progresiva en tres niveles |
| Historial de la conversación | El runtime | En cada turno | Compactación o resumen al acercarse al límite; borrado de resultados antiguos |
| Resultados de herramientas | La herramienta, con formato pensado para el modelo | Tras cada llamada | Devolver solo señal: paginación, truncado, formato conciso; tope de tokens por respuesta |
| Documentos recuperados | El sistema de recuperación, con los permisos del usuario | Justo a tiempo, cuando el paso lo necesita | Pocos fragmentos reordenados por relevancia; referencias ligeras en lugar del documento entero |
| Memoria recuperada | El diseño del caso de uso y las reglas de gobierno del dato | Por relevancia, al inicio o cuando el agente la pide | Selección semántica o por ficheros; nunca todo; con caducidad |
| Petición del usuario | El usuario | Al inicio del turno | Filtros de entrada; en tareas largas, el objetivo se «recita» al final del contexto para que no se pierda en el medio |
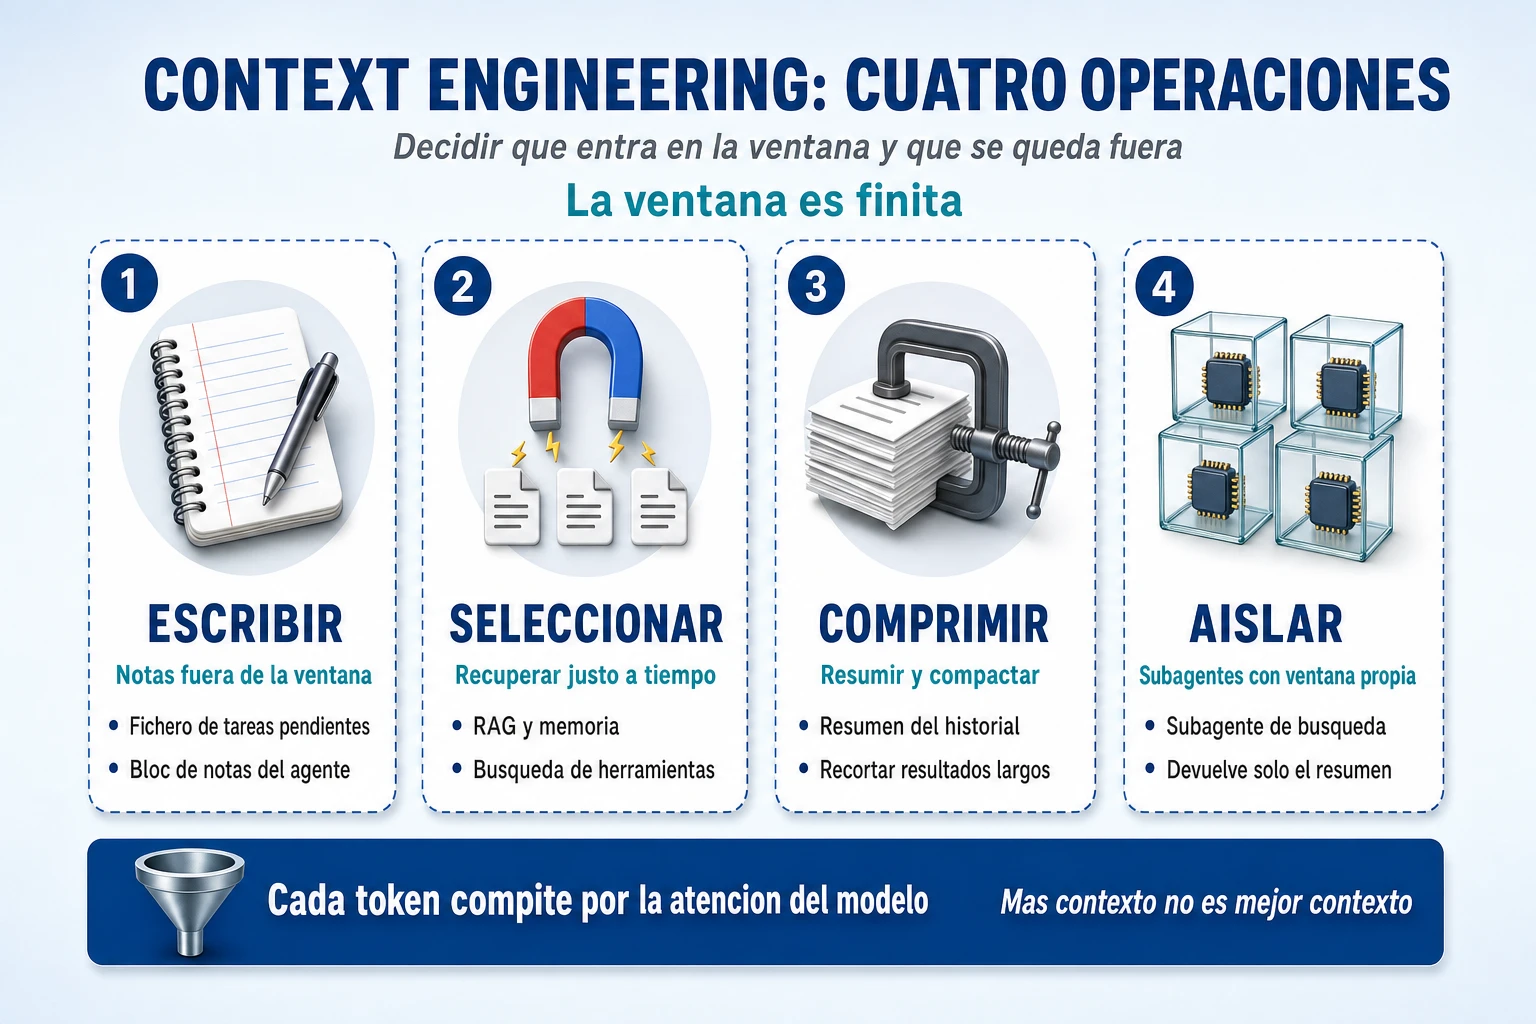
Las cuatro operaciones: escribir, seleccionar, comprimir, aislar
LangChain propuso en junio de 2025 cuatro operaciones que cubren todo lo que se hace con el contexto. Escribir es sacar información de la ventana a un lugar externo: notas de trabajo, un plan en un fichero, memorias entre sesiones. Seleccionar es traer a la ventana justo lo que hace falta cuando hace falta: recuperación de documentos, de memorias o de descripciones de herramientas. Comprimir es resumir o podar lo que ya está dentro cuando se acerca al límite. Aislar es repartir el trabajo en subagentes con ventana propia, en sandboxes donde viven los objetos pesados o en estado estructurado del runtime.
Las prácticas concretas vienen de dos fuentes con producción detrás. Anthropic, en septiembre de 2025: instrucciones a la «altitud correcta» —específicas para guiar, flexibles para dar heurísticas—, herramientas mínimas y claras, ejemplos canónicos en lugar de listas de casos límite, recuperación justo a tiempo en vez de precarga, compactación del historial, notas estructuradas fuera de la ventana y subagentes que devuelven un resumen corto. Manus, en julio de 2025, tras reescribir su framework cuatro veces: la tasa de acierto de la caché de prefijo es «la métrica más importante» de un agente en producción, porque la relación entre tokens de entrada y de salida es de unas cien a una; por eso no se añaden ni se quitan herramientas a mitad de tarea —se enmascaran—, el sistema de ficheros hace de contexto ilimitado, el objetivo se reescribe al final de la ventana para no perderlo en el medio, y los errores se conservan porque ayudan al modelo a no repetirlos. Son prácticas de un proveedor sobre su producto, pero coinciden con las de Anthropic en lo esencial.
Cuántas herramientas puede manejar un agente
No hay un número mágico, y las cifras que circulan suelen estar mal atribuidas. Lo que dice la guía de OpenAI de 2025 es que hay implementaciones que manejan «más de quince herramientas bien definidas y distintas» y otras que fallan «con menos de diez solapadas»: el problema no es la cantidad, es el solapamiento. La documentación de Anthropic, sobre sus modelos, afirma que la selección «se degrada al superar 30-50 herramientas disponibles», y da el dato de tamaño que lo explica: 58 herramientas ocupan unos 55.000 tokens de definiciones antes de que empiece la conversación. Un estudio de mayo de 2026 cerró la pregunta desde el otro lado: una lista adaptativa de unas siete herramientas elegidas por consulta iguala a una lista fija de cincuenta, y con listas cortas y relevantes la precisión de selección sube varios puntos.
Las tres respuestas de la industria son complementarias. El filtrado por rol y fase: la lista de herramientas visibles depende de quién es el usuario, qué agente está activo y en qué punto de la tarea está; se aplica en el gateway de herramientas y se explica en el artículo sobre la plataforma de agentes. La carga progresiva: el agente ve el nombre y una línea de cada herramienta y carga la definición completa solo cuando la necesita. Y la búsqueda de herramientas bajo demanda: el catálogo vive fuera de la ventana y el agente busca en él como en un índice; Anthropic afirma que así el consumo de tokens baja un 85 % y la precisión de selección sobre servidores MCP sube del 49 % al 74 % en uno de sus modelos, cifra de proveedor. Las tres comparten una idea: el catálogo corporativo puede tener quinientas herramientas; el agente, en un turno concreto, debe ver diez.
Memoria: qué recuerda el agente, dónde y quién lo decide
«Que el agente aprenda» es la petición más frecuente y la peor definida. Un agente no aprende: recuerda lo que alguien decidió que recordara, donde alguien decidió guardarlo, durante el tiempo que alguien decidió conservarlo. Cada una de esas decisiones tiene consecuencias de coste, de privacidad y de seguridad, y ninguna la toma el modelo.
Cuatro memorias, no una
La taxonomía CoALA, de 2023, separa cosas que se implementan de forma distinta. La memoria de trabajo es la ventana de contexto y el estado del turno: dura lo que dura la tarea. La episódica registra qué pasó: este cliente llamó el martes por un cargo duplicado y se le devolvió. La semántica guarda hechos y preferencias: prefiere el correo, tiene tarifa empresa. La procedimental es cómo se hacen las cosas: las instrucciones, las skills, los playbooks.
Los mecanismos de mercado se han multiplicado en dos años. Notas en ficheros: el agente escribe y lee un directorio de memoria que vive en la infraestructura del cliente; es el enfoque de la herramienta de memoria que Anthropic lanzó en septiembre de 2025, de la que afirma, sobre su propia evaluación, un 39 % de mejora y un 84 % menos de tokens en un flujo de cien turnos al combinarla con la edición de contexto. Resúmenes y compactación: sustituir turnos antiguos por un resumen. Almacén vectorial de recuerdos: extraer hechos de las conversaciones, indexarlos y recuperarlos por similitud, como Mem0, cuyo artículo de abril de 2025 reclama, según sus autores, una latencia un 91 % menor y más del 90 % de ahorro de tokens. Grafo temporal: entidades, relaciones y validez en el tiempo de cada hecho, como Zep, de enero de 2025. Y memoria gestionada por el proveedor: el banco de memoria de Vertex AI, en vista previa desde julio de 2025, o la memoria de Bedrock AgentCore, que separan corto plazo por sesión y largo plazo entre sesiones. La memoria de ChatGPT, que desde abril de 2025 «puede referenciar todas las conversaciones pasadas», es la versión de consumo del mismo mecanismo.
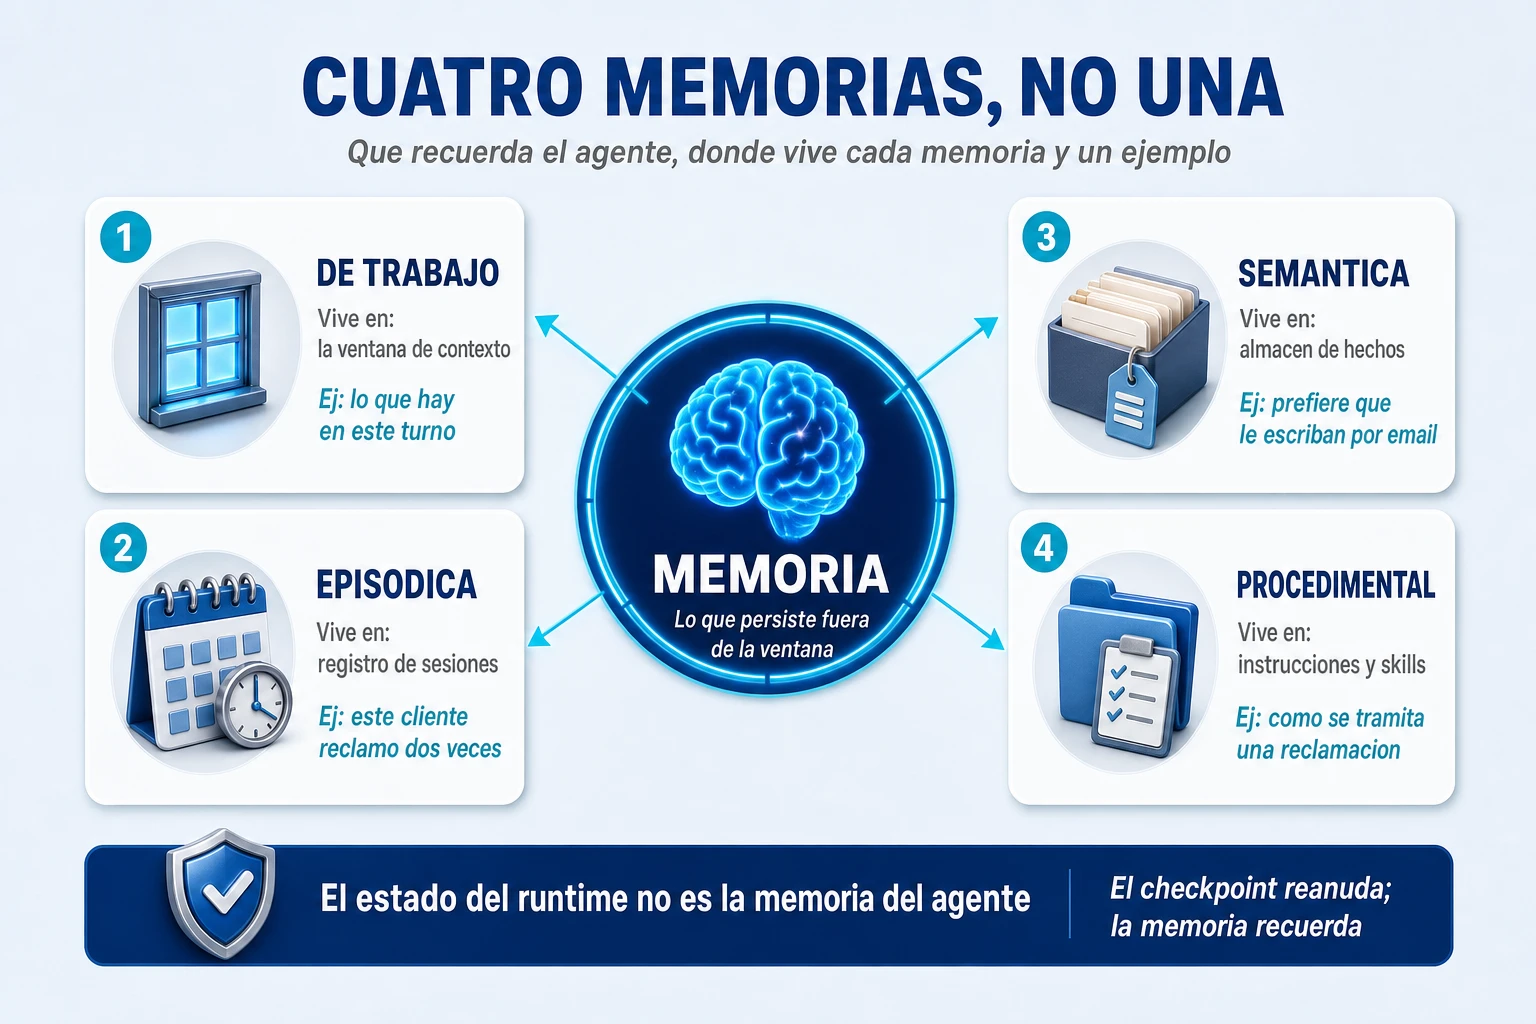
Estado del runtime y memoria del agente no son lo mismo
La formulación más clara está en la documentación de LangGraph: el checkpointer persiste el estado de un hilo y sirve para «memoria de corto plazo acotada al hilo» —continuidad, aprobación humana, reanudación tras un fallo—; el store persiste datos fuera del estado y sirve para «memoria de largo plazo entre hilos», como preferencias y hechos. Son dos servicios con dos propósitos. El checkpoint responde a «¿por dónde iba esta ejecución?» y lo gestiona la plataforma. La memoria responde a «¿qué sé de este cliente, de este dominio, de este procedimiento?» y la decide el diseño del caso de uso. Cuando se confunden pasan dos cosas: se guardan trazas de ejecución enteras como «memoria», con su coste, su ruido y sus datos personales dentro; o se diseña con esmero la memoria del cliente y se olvida el checkpoint, y el flujo que esperaba una aprobación durante el fin de semana no se puede reanudar el lunes. La primera es la que acaba en una auditoría de protección de datos.
Qué memoria necesita cada caso de uso
Casi ninguno necesita las cuatro, y la mayoría necesita muchas menos de las que el framework permite. La memoria se justifica por una necesidad funcional concreta —recordar al cliente, no repetir un diagnóstico, aplicar una lección— y no porque la plataforma la ofrezca. Cada memoria persistente es un almacén más de datos, con su gobierno, su caducidad y su superficie de ataque.
| Caso de uso | De trabajo | Episódica | Semántica | Procedimental | Regla |
| Asistente documental | Solo la conversación actual, compactada | Casi ninguna | Ninguna: la base documental es conocimiento, no memoria, y no se escribe | Instrucciones y skills estáticas | La memoria persistente añade riesgo de envenenamiento sin apenas valor |
| Analista de datos | Plan de análisis y consultas del hilo | Notas de la investigación en curso | Definiciones de métricas y preferencias del usuario, con procedencia | Consultas y métodos que funcionaron | Las definiciones viven en la capa semántica, no en la memoria del agente |
| Atención al cliente | Estado de la conversación y del caso; checkpoint para escalar a persona | Resumen de interacciones previas, por cliente | Perfil y preferencias, por cliente y aislado | Guías de actuación y playbooks de escalado | Memoria por cliente, con caducidad y derecho de supresión; nunca compartida entre clientes |
| Backoffice | Checkpoints durables para procesos de días | Registro de ejecuciones para auditoría: son trazas, no memoria | Datos maestros en los sistemas de registro, no en el agente | Skills, procedimientos y lecciones sobre excepciones, versionadas | La memoria útil es procedimental y organizativa, no personal |
| NOC/SOC | Hipótesis y evidencia de la investigación en curso | Incidentes anteriores y su resolución | Inventario y criticidad de activos: viven en la CMDB, no en el agente | Runbooks aprobados; lecciones solo tras revisión | Cada «lección» que aprende el agente es un vector de envenenamiento si no la revisa alguien |
| Procesos autónomos | Todo lo anterior | Todas las decisiones, con trazas por decisión | Hechos con procedencia y fecha | Mandato, procedimientos obligatorios, prohibiciones | Todas las memorias, todas auditadas, todas revisables y reversibles |
Los riesgos que trae la memoria
Cuatro, y los cuatro tienen incidentes documentados. El envenenamiento: a diferencia de una inyección clásica, que muere con la sesión, una instrucción plantada en la memoria persiste y actúa semanas después en una interacción que no tiene nada que ver. En febrero de 2025 un investigador demostró que un documento con instrucciones ocultas hacía que un asistente de consumo guardara «recuerdos» falsos; en octubre de 2025 un equipo de Palo Alto Networks mostró cómo una web maliciosa inyectaba instrucciones en el resumen de sesión de un agente y las convertía en permanentes; y en febrero de 2026 Microsoft contó cincuenta intentos de treinta y una empresas, en sesenta días, de manipular la memoria de asistentes de IA con fines promocionales. OWASP lo formalizó en diciembre de 2025 como categoría propia de su lista de riesgos agénticos. La fuga entre usuarios: una memoria sin ámbito estricto por identidad hace que lo que un cliente contó aparezca en la conversación de otro. La deriva: sin consolidación, la memoria acumula hechos que ya no son ciertos y el agente los aplica con la misma confianza. Y la memoria que no caduca, que es un problema de calidad —el contexto irrelevante empeora el rendimiento— y un problema legal, porque una memoria persistente sobre personas tiene base jurídica, minimización y derecho de supresión que cumplir. La consecuencia de diseño es una: la memoria se trata como entrada no confiable en cada lectura, con procedencia, revisión y fecha de caducidad.
Cuándo usar qué: la regla de la mínima autonomía
Los dos proveedores de modelos con más incentivos para vender autonomía dicen lo mismo, y conviene tomarles la palabra. Anthropic: «encontrar la solución más simple posible y aumentar la complejidad solo cuando haga falta», lo que puede significar no construir ningún agente; agentes solo cuando «es difícil o imposible predecir el número de pasos necesarios», y siempre con condiciones de parada. OpenAI: «maximizar primero las capacidades de un solo agente»; construir uno solo si hay decisiones complejas, reglas que ya no se pueden mantener o dependencia fuerte de datos no estructurados, y si no, «una solución determinista puede bastar». Esta sección convierte esos principios en un procedimiento.
Las seis preguntas que deciden el peldaño
Seis preguntas, en este orden, sitúan cualquier problema en la escalera. Uno: ¿los pasos se conocen de antemano? Si sí, es un workflow, y el modelo aparecerá como función en los pasos que lo necesiten. Dos: ¿el número de pasos es variable? Si cada caso exige un camino distinto que no se puede escribir, hace falta un agente. Tres: ¿hay que decidir con información que solo aparece durante la ejecución? Si la decisión se puede tomar con datos que ya están en la entrada, basta un workflow con un paso de modelo; si depende de lo que devuelva la tercera consulta, es un agente. Cuatro: ¿el error es reversible? Si la acción se puede deshacer, el agente puede ejecutarla y avisar; si no, alguien la aprueba antes. Cinco: ¿la latencia y el coste por tarea son tolerables? Un chat de soporte tolera segundos y céntimos; un paso dentro de un proceso de pago, no. Seis: ¿hay forma de evaluar el resultado? Sin un conjunto de casos con respuesta esperada no se puede saber si el agente funciona, y sin saberlo no se le puede dar autonomía.
El árbol resultante es corto. Preguntas sobre un corpus sin acciones: RAG. Una o dos llamadas conocidas a sistemas: modelo con herramientas. Pasos fijos con lectura de texto o decisión acotada: workflow. Pasos variables, decisiones en ejecución y error recuperable: agente. Amplitud paralelizable o dominios con contextos incompatibles, y valor que pague quince veces el coste: multiagente. Y una regla para toda la vida del sistema: se sube un peldaño solo cuando una métrica del peldaño actual —tasa de «no encontrado», de excepciones, de reintentos, de escalados— demuestra que el inferior no basta. Nunca por preferencia.
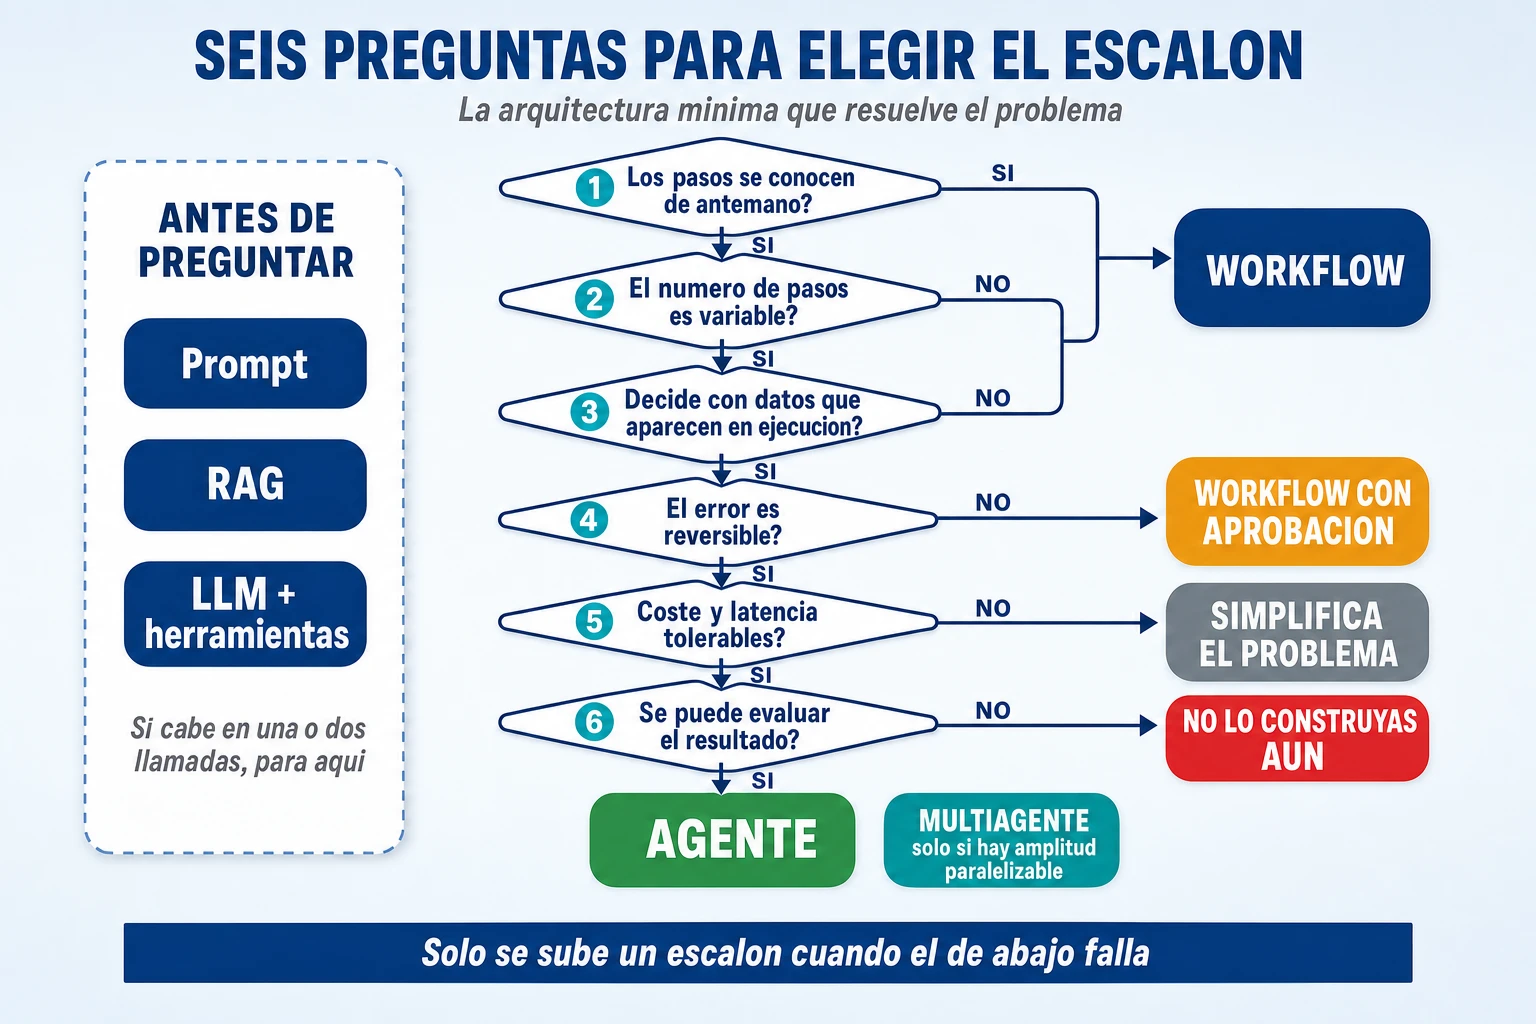
Cuándo basta cada peldaño
Basta RAG cuando el problema es responder preguntas sobre un corpus y no hay que ejecutar nada; se le añade un bucle —el RAG agéntico, en el que el modelo decide si buscar, qué buscar y en qué fuente— solo con fuentes heterogéneas o preguntas que exigen descomposición, y solo tras medir que la tasa de «no encontrado» del RAG clásico es alta. Basta un modelo con herramientas cuando hay una o dos llamadas conocidas a sistemas y una respuesta. Basta un workflow determinista cuando el proceso tiene pasos fijos y el modelo aporta en pasos concretos: facturas, conciliaciones, altas, tickets con procedimiento. Hace falta un agente cuando los pasos son variables, las decisiones dependen de lo que se descubre por el camino y el error se puede recuperar: diagnosticar una incidencia abierta, investigar una alerta. Hace falta un multiagente solo con amplitud paralelizable de lectura, o con dominios de contextos incompatibles y límites de seguridad distintos que no deben compartir ventana.
El coste real de la autonomía
La autonomía se paga cinco veces. En tokens: unas cuatro veces un chat para un agente y unas quince para un multiagente, según la medida de Anthropic sobre su sistema. En latencia: un agente encadena decenas de llamadas; en TheAgentCompany, el benchmark de tareas de oficina de la Universidad Carnegie Mellon (2025), el mejor agente necesitó de media 27 pasos y 4,2 dólares por tarea para completar el 30,3 % de las 175 tareas, y las peores categorías fueron administración, finanzas y datos. En varianza: la demo funciona una vez de ocho; el benchmark de atención al cliente τ-bench, publicado por Sierra en junio de 2024, mostró que un agente que resuelve menos del 50 % de las tareas una vez cae por debajo del 25 % cuando se le exige acertar ocho veces seguidas. En coste de evaluación: un estudio de Princeton de octubre de 2025 necesitó 21.730 ejecuciones y unos 40.000 dólares para evaluar nueve modelos en nueve benchmarks, y encontró que pagar más razonamiento redujo la precisión en la mayoría de las ejecuciones. Y en coste de gobierno: cada nivel de autonomía exige un control más —identidad propia, presupuesto, interruptor, auditoría por decisión— que alguien tiene que montar y mantener.
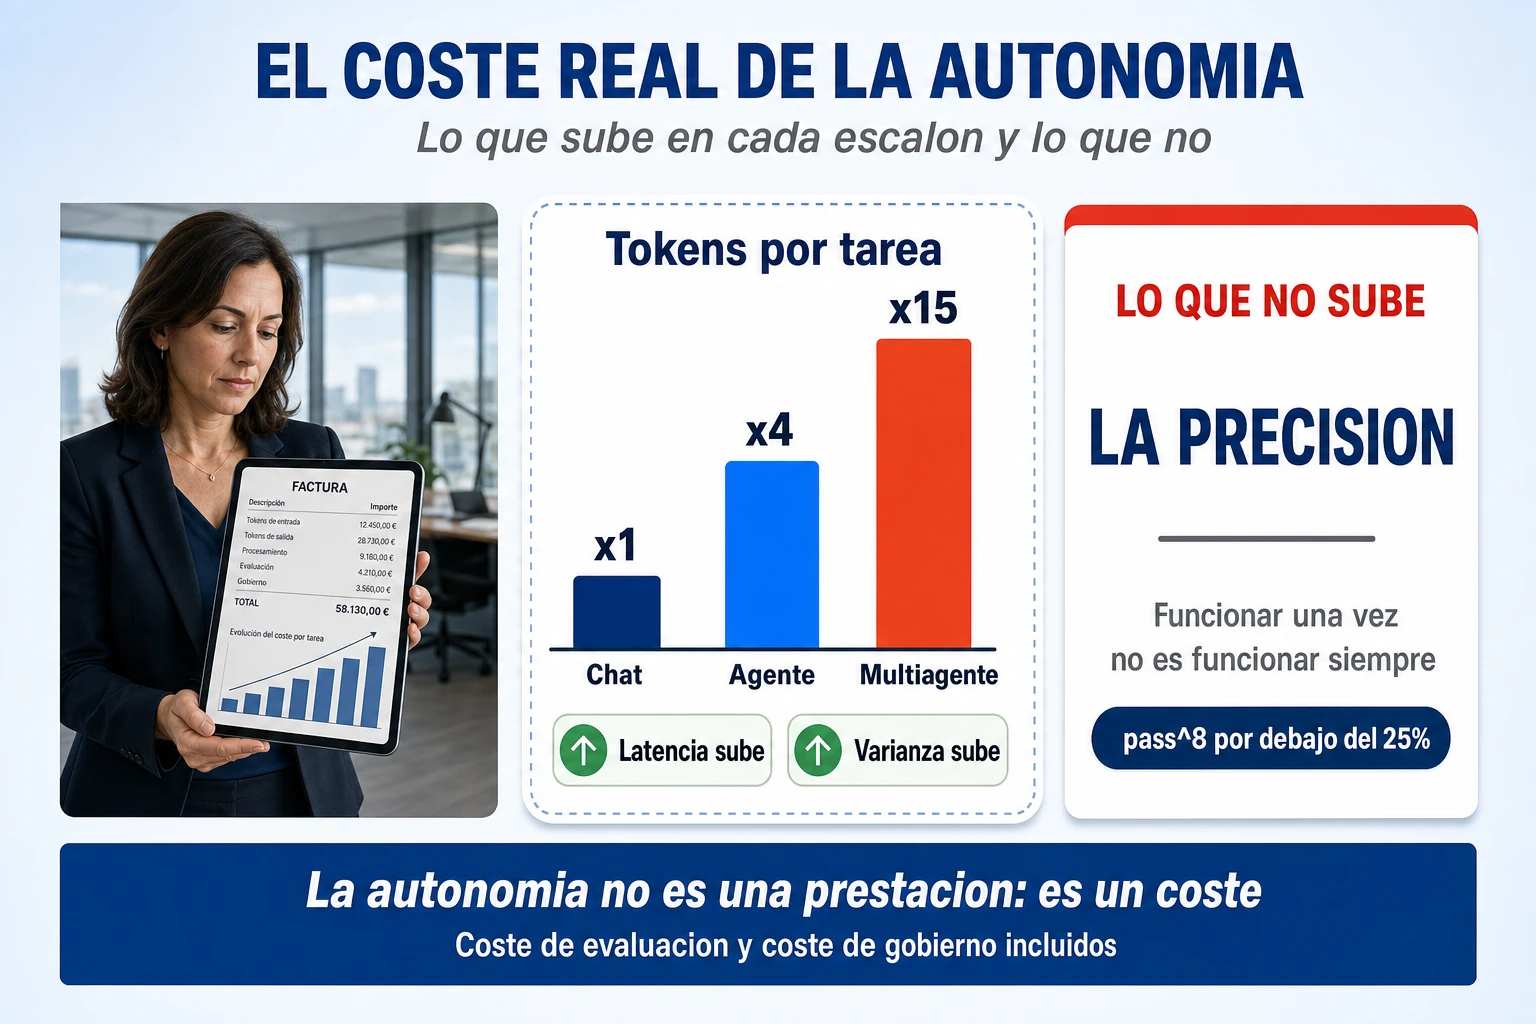
Cuándo añadir autonomía no aporta nada, y se hace igualmente
Tres situaciones se repiten. Un proceso que ya era determinista —una automatización robótica, un BPMN que funciona— se «agentiza» porque el proveedor ha renombrado el producto y el comité quiere algo agéntico en el plan: no determinismo donde no lo había, coste multiplicado y ninguna capacidad nueva. Una clasificación o una extracción que un modelo resuelve en una sola llamada se envuelve en un bucle de agente con memoria y herramientas, y el bucle añade formas de fallar sin añadir formas de acertar. Y una atención al cliente que era un asistente sobre documentos con dos acciones acotadas se convierte en un «equipo de agentes» que negocia entre sí quién responde.
Gartner puso nombre al fenómeno en junio de 2025: agent washing, el reetiquetado de asistentes, automatización robótica y chatbots como «agentes» sin capacidad agéntica sustancial. Su predicción, que es una predicción y no una medición: más del 40 % de los proyectos de IA agéntica se cancelarán antes de finales de 2027 por costes crecientes, valor poco claro o controles de riesgo inadecuados, y solo unos 130 de los miles de proveedores que se anuncian como agénticos lo son. Las mediciones apuntan en la misma dirección con más cautela: la encuesta de McKinsey de noviembre de 2025 encuentra que el 23 % de las organizaciones escala agentes en alguna función, pero en ninguna función concreta lo hace más del 10 %. Y un informe preliminar del MIT, de agosto de 2025, no revisado por pares y criticado por su metodología, afirmó que el 95 % de las organizaciones obtiene retorno cero de la IA generativa; la cifra se cita mucho y prueba poco, pero su definición —«sin impacto medible en la cuenta de resultados»— describe bien a la mayoría de los pilotos que no midieron nada antes de empezar.
El patrón correcto para la mayoría de esos casos tiene nombre y producto: el modelo como función dentro de un motor de procesos. El motor —BPMN en Camunda, ejecución durable en Temporal, máquinas de estado en Step Functions o Durable Functions, flujos en Power Automate o en Copilot Studio— posee el control de flujo, los reintentos, las esperas, las compensaciones y la trazabilidad; el modelo es una actividad más. Temporal lo formula con precisión: «el código del workflow es determinista… el agente puede decidir a partir de salidas no deterministas del modelo», y cada decisión queda en el historial de eventos, de forma que si el proceso se cae se reanuda sin volver a preguntar al modelo. Las puertas de aprobación son nativas: LangGraph pausa el grafo con estado persistido para aprobar antes de «llamadas a API, cambios en base de datos, transacciones financieras»; Step Functions espera un token de aprobación hasta un año. Con un motor debajo, la autonomía es una propiedad configurable paso a paso. Sin motor, es una propiedad emergente del prompt.
Dos advertencias que no son técnicas. Automatizar un proceso mal diseñado lo hace fallar más rápido: la secuencia correcta es eliminar, simplificar, automatizar y solo después agentificar, como se desarrolla en el artículo sobre cómo organizar una transformación con agentes. Y la resistencia a un agente que toma decisiones no se resuelve con más autonomía, sino con el trabajo de adopción que se explica en el artículo sobre por qué fallan las transformaciones. Un agente que nadie usa es más caro que un proceso que todos entienden.
La tabla que sigue es la más importante del artículo. Recoge quince problemas típicos de una gran empresa y, para cada uno, la arquitectura mínima que lo resuelve, el grado de autonomía que admite en la escala de seis niveles de la sección siguiente (N0 informa, N1 recomienda, N2 prepara y la persona aprueba, N3 ejecuta y la persona audita, N4 ejecuta salvo excepciones, N5 autónomo), los componentes que hacen falta, los que no hacen falta y el riesgo principal. La mayoría de las filas no son agentes.
| Problema típico | Arquitectura mínima | Autonomía | Componentes necesarios | Componentes que NO hacen falta | Riesgo principal |
| 1. Responder preguntas sobre documentación interna | RAG clásico; RAG agéntico solo si la tasa de «no encontrado» es alta | N0 | Índice con permisos por documento, reordenación por relevancia, citas obligatorias, evaluación de fidelidad | Bucle de agente, memoria persistente, herramientas de escritura | Inyección vía documentos; fuga entre permisos |
| 2. Clasificar y enrutar correos o tickets | Prompt de una llamada dentro de una regla | N3 | Esquema de etiquetas cerrado, umbral de confianza, cola de revisión para baja confianza | Agente, RAG, multiagente | Deriva silenciosa de la precisión; tratar el correo como instrucción |
| 3. Extraer datos de facturas o contratos | Workflow determinista: extracción con esquema → validación por reglas → excepción a persona | N3 en extracción; N2 al contabilizar | Motor de procesos, esquema estricto, validaciones cruzadas (totales, impuestos, proveedor maestro), muestreo de calidad | Agente que «decide» qué hacer con la factura; navegación web | Importes inventados; documento adversario con instrucciones ocultas |
| 4. Resolver incidencias de nivel 1 | Agente único con herramientas de diagnóstico; workflow para las acciones de remediación | N3 en diagnóstico; N2 en acciones sobre sistemas | Lista blanca de herramientas, simulador de usuario en evaluación, escalado por umbral de reintentos, aviso de que es una IA | Multiagente; memoria entre clientes | Resolver «en falso»; acciones irreversibles sin puerta |
| 5. Conciliar pagos y cobros | Workflow determinista; el modelo solo propone en casos ambiguos y redacta la justificación | N3-N4 en cruces automáticos; N2 en asientos manuales | Motor de conciliación existente, modelo como «propuesta de cruce» con evidencia, cola de excepciones | Agente con escritura en el ERP; RAG | Escritura contable autónoma; error transaccional no reversible |
| 6. Generar informes de datos recurrentes | Workflow: consultas y gráficos deterministas; el modelo redacta la narrativa | N3 | Consultas parametrizadas versionadas, modelo sobre datos ya calculados, validación numérica automática | Agente que escribe SQL libre contra producción | Cifras inventadas presentadas con seguridad |
| 7. Análisis ad hoc de datos | Agente único con consulta en sandbox de solo lectura | N1 | Réplica de solo lectura, límite de coste y turnos, trazabilidad de consultas, revisión humana del resultado | Escritura en sistemas; multiagente | Coste descontrolado; conclusiones plausibles y falsas |
| 8. Monitorizar alertas de red u operaciones | Workflow de correlación + modelo con herramientas para resumir y proponer; remediación en runbooks deterministas con puerta | N3 en triaje; N2 en cualquier cambio de configuración | Sistema de alertas existente, runbooks como herramientas cerradas, interruptor, límite de acciones por hora | Agente con consola abierta | Acción destructiva por argumento mal construido |
| 9. Negociar con proveedores | Modelo con herramientas como asistente de la persona: preparar, simular, redactar | N1-N2 | Datos de contratos y precios, plantillas, registro de toda comunicación | Agente con capacidad de enviar ofertas o aceptar términos | Compromisos vinculantes concedidos por manipulación |
| 10. Incorporar empleados | Workflow BPMN existente con el modelo en pasos (dudas vía RAG, formularios propuestos) | N3 en información; N2 en altas en sistemas | Motor de procesos, RAG de políticas, identidades gestionadas por el sistema de identidad, no por el agente | Agente con privilegios de administrador en identidad o RR. HH. | Privilegios excesivos; datos personales en ámbito de alto riesgo regulatorio |
| 11. Investigación de mercado o diligencia documental | Agente único de investigación; multiagente solo si la consulta es de amplitud y el valor lo paga | N3 en la búsqueda; N1 en las conclusiones | Navegación en sandbox, citas verificables, juez con rúbrica, presupuesto de tokens por informe | Herramientas de escritura o envío; datos privados si navega por webs no confiables | Exfiltración vía contenido web; coste multiplicado |
| 12. Asistente de programación y mantenimiento de código | Agente único en entorno aislado con puertas: revisión humana y pruebas automáticas como evaluador | N3 en rama; N2 en integrar o desplegar | Ramas, integración continua, pruebas como evaluador, separación desarrollo/producción, sin credenciales de producción | Autoejecución sin confirmación en máquinas con datos reales | Borrado o alteración destructiva; trampas contra las pruebas |
| 13. Atención comercial con acciones | Agente único con lectura autónoma y workflow con puerta para cada acción transaccional | N3 en lectura; N2 en transacciones sobre umbral; N4 solo en reversibles bajo umbral | Políticas como validación determinista (importe máximo, plazos), fiabilidad medida en repetición, aviso de que es una IA | Multiagente; memoria a largo plazo del cliente sin gobierno | Reembolsos o cancelaciones indebidas; manipulación social |
| 14. Revisar contratos frente a la política | Workflow con lista de comprobación determinista y modelo en pasos (extraer cláusulas, comparar, redactar hallazgos) | N1 | Política versionada, esquema de hallazgos, trazabilidad cláusula → evidencia | Agente que negocia o firma; multiagente | Falsos negativos con apariencia de rigor |
| 15. Un proceso ya determinista que «quiere ser agéntico» | Mantener el motor; añadir el modelo solo en el paso que hoy exige leer texto no estructurado | N3 en ese paso | El motor que ya existe | Agente, multiagente, memoria | Agent washing interno: coste y no determinismo sin valor |
Los grados de autonomía se asignan por acción, no por agente
«¿Cuánta autonomía tiene el agente?» es una pregunta mal planteada. Un mismo agente de atención al cliente puede consultar pedidos sin pedir permiso a nadie, preparar un reembolso para que alguien lo apruebe y tener prohibido cambiar un número de cuenta. Tres acciones, tres niveles. La autonomía se asigna por acción, y el agente es la suma de las autonomías de sus acciones.
La escala de este artículo es la de seis niveles que ya emplea el artículo sobre cómo organizar una transformación con agentes, adoptada tal cual para que el blog no se contradiga: N0 informa (el agente informa, la persona decide), N1 recomienda (propone, la persona decide), N2 prepara (deja la acción lista, la persona aprueba), N3 ejecuta y la persona audita, N4 ejecuta salvo excepciones (que escala) y N5 autónomo (la persona supervisa el sistema, no las acciones). De ese mismo artículo viene la fórmula que ordena las prioridades: riesgo ≈ probabilidad de error × autonomía × alcance × irreversibilidad. Bajar cualquiera de los cuatro factores baja el riesgo, y la autonomía es el único que se decide con una línea de configuración.
Los marcos que existen son compatibles con esta escala, y ninguno es un estándar. Un grupo de investigadores de Hugging Face propuso en febrero de 2025 cinco niveles según quién controla el flujo del programa —procesador simple, enrutador, invocador de herramientas, agente multipaso, totalmente autónomo—, con la tesis de que «los riesgos para las personas aumentan con la autonomía del sistema». Otro trabajo académico de junio de 2025 gradúa la autonomía por el rol que le queda a la persona: operadora, colaboradora, consultora, aprobadora, observadora. Y el reglamento europeo de IA, aunque no define «agente», exige para los sistemas de alto riesgo que la persona supervisora pueda «interrumpir el sistema mediante un botón de parada o un procedimiento similar»; su artículo de transparencia —informar de que se interactúa con una IA— es aplicable desde el 2 de agosto de 2026, y las obligaciones de alto riesgo del anexo III se han pospuesto al 2 de diciembre de 2027. El botón de parada está en la ley.
| Nivel | Quién decide | Quién ejecuta | Quién revisa | Ejemplo de acción | Caso de uso típico |
| N0 informa | La persona | La persona | Nadie: el agente solo muestra información con citas | Responder cuál es la política de devoluciones vigente | Asistente documental |
| N1 recomienda | La persona | La persona | La persona, antes de actuar | Proponer los cinco cambios de código que pueden haber causado un incidente | Analista de datos; investigación de causa raíz |
| N2 prepara | La persona aprueba | El agente, tras la aprobación | La persona, en la puerta de aprobación | Dejar listo un reembolso de 300 euros para que lo apruebe un supervisor | Transacciones sobre umbral; contabilizar; remediar |
| N3 ejecuta y la persona audita | El agente | El agente | La persona, después, por muestreo | Consultar el pedido y explicar el retraso; cerrar una alerta de seguridad como falso positivo de alta confianza | Lectura en atención al cliente; triaje en el centro de operaciones |
| N4 ejecuta salvo excepciones | El agente, con reglas de excepción | El agente | La persona, solo en lo que se escala | Cambiar la dirección de entrega de un pedido no expedido; emitir un vale por debajo de 20 euros | Acciones reversibles bajo umbral; pasos de backoffice con validación determinista |
| N5 autónomo | El agente, dentro de un mandato | El agente | La persona supervisa el sistema: métricas, presupuesto, interruptor | Negociar condiciones con un proveedor de cola larga dentro de límites fijados y cerrar el acuerdo | Procesos autónomos con radio de impacto acotado y reversibilidad garantizada |
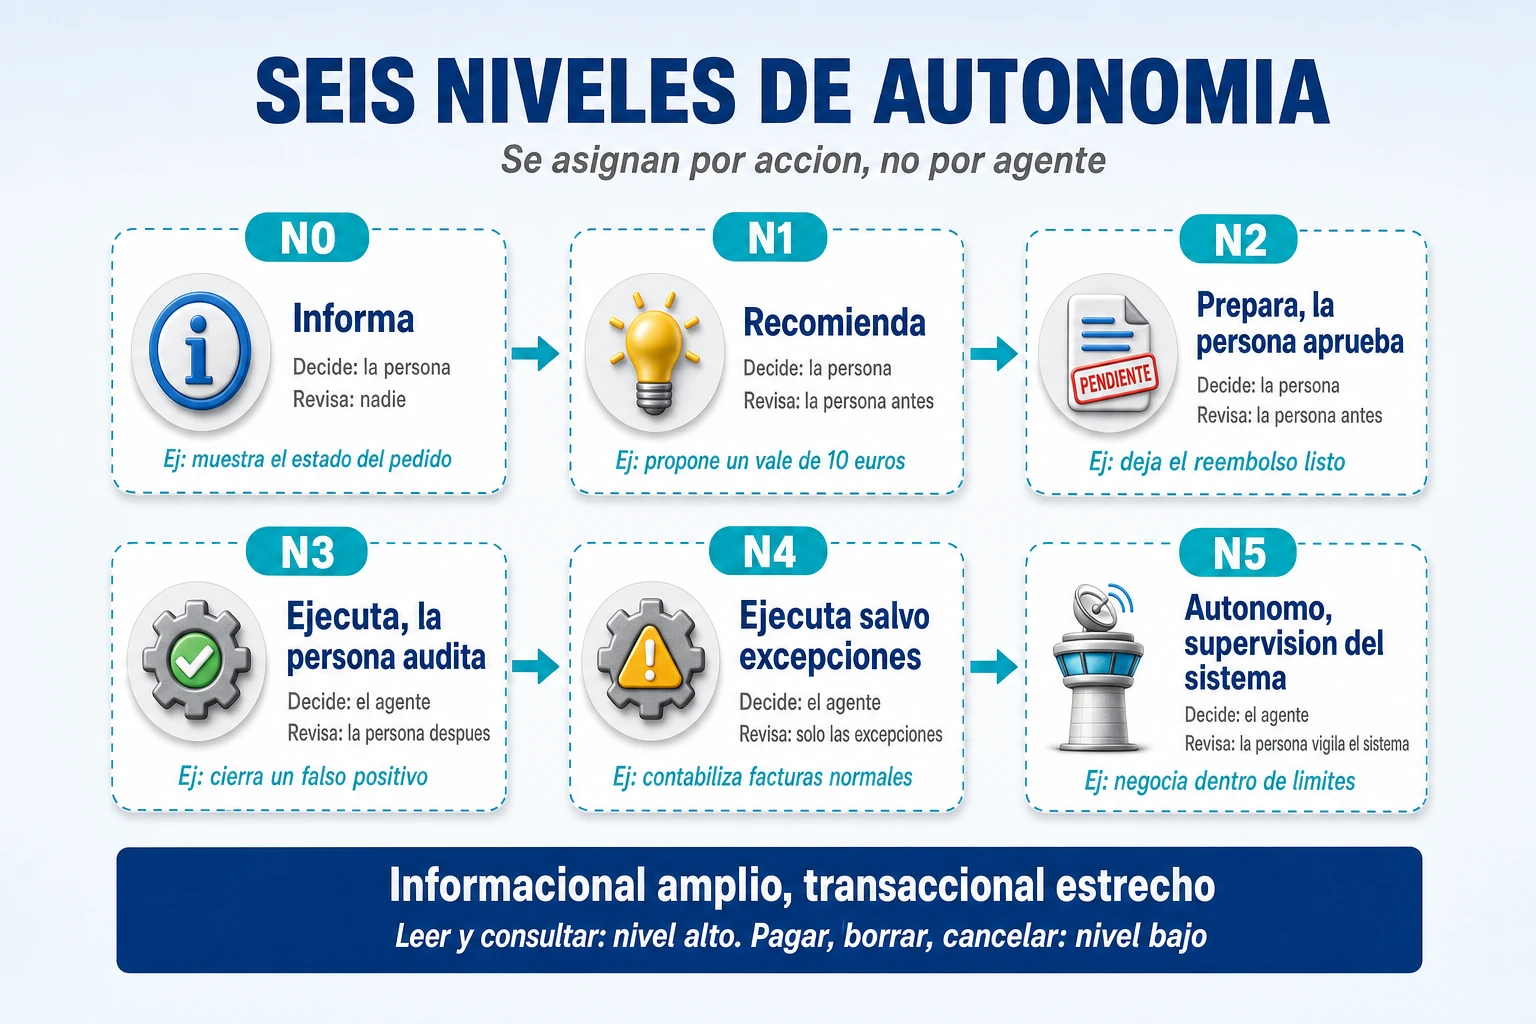
Informacional frente a transaccional
Es la decisión de diseño que más incidentes evita, y cabe en una regla. Las acciones informacionales —leer, consultar, buscar, resumir, explicar— son reversibles y toleran cierta imprecisión: una respuesta incompleta se corrige con otra pregunta. Las transaccionales —crear, modificar, cancelar, pagar, borrar, enviar— son irreversibles o costosas de revertir, y exigen tres cosas: idempotencia (que un reintento no pague dos veces), autorización explícita con la identidad del usuario real y, a menudo, confirmación humana. La regla: no se mezclan en la misma herramienta ni con el mismo nivel de autonomía. Una tool que «gestiona pedidos» y puede tanto consultar como cancelar es un error de diseño; son dos tools, con dos permisos y dos niveles. La especificación de MCP recomienda «minimización de alcance», empezar por lectura y elevar por pasos; OpenAI pone como ejemplos de acciones que exigen supervisión humana «cancelar pedidos, autorizar reembolsos grandes o hacer pagos». Y la fórmula del riesgo lo explica: la lectura tiene irreversibilidad cero, con lo que su riesgo es bajo aunque la autonomía sea alta; la escritura la tiene alta, con lo que la única variable que queda para bajar el producto es la autonomía. Lectura amplia, escritura estrecha.
Los cuatro frenos que todo agente lleva de serie
Ningún agente sale a producción sin cuatro límites que no dependen del modelo. Un límite de pasos: el número máximo de vueltas del bucle, que Anthropic recomienda literalmente como «condición de parada»; un agente que da la vuelta cuarenta no está siendo minucioso, está en bucle. Un límite de presupuesto: tope de tokens y de coste por tarea y por equipo, con alerta por desviación. Un tiempo máximo por actividad y por tarea. Y un interruptor de parada que funciona fuera del control del agente —revocar su identidad, cortar sus herramientas, pausar el orquestador—, accionable por una persona y por una regla. Los incidentes de 2025 enseñaron un matiz: el interruptor debe cortar también la «autorreparación» del agente, porque en dos casos documentados el intento del agente de arreglar lo que acababa de romper empeoró la recuperación. La recuperación la ejecuta un proceso determinista o una persona, nunca el agente que causó el problema.
Sobre los frenos van las puertas de aprobación. Con la persona en el bucle, el agente se detiene y espera aprobación antes de una acción concreta: es N2, y los protocolos lo han estandarizado como un estado de tarea «requiere entrada». Con la persona sobre el bucle, el agente actúa y la persona supervisa un panel desde el que puede abortar o revertir: es N3 o N4, y exige observabilidad, interruptor y acciones reversibles. La trampa es la fatiga de aprobación: una puerta que aprueba el 99 % de las veces deja de ser un control. El equipo rojo de Microsoft informó en junio de 2026, tras doce meses probando sistemas desplegados, de que el salto de la aprobación humana fue el modo de fallo «explotado con más consistencia». Una tasa de rechazo cercana a cero en una puerta no significa que el agente acierte siempre; significa que nadie está mirando.
Seis arquitecturas para seis problemas
Los seis casos de uso de la lista de toda gran empresa se colocan en un mapa de dos ejes. El horizontal es quién decide el flujo: del código al modelo. El vertical es qué puede escribir: de nada a todo. El asistente documental está abajo a la izquierda; el proceso autónomo, arriba a la derecha; los otros cuatro se reparten por el medio, y la posición determina qué componentes necesita cada uno, cuáles le sobran, qué autonomía admite y de qué se va a romper. Cada arquitectura sigue la misma plantilla: problema, diagrama en palabras, tabla de componentes, autonomía por acción, riesgos con su control, casos reales y el error de diseño más frecuente.
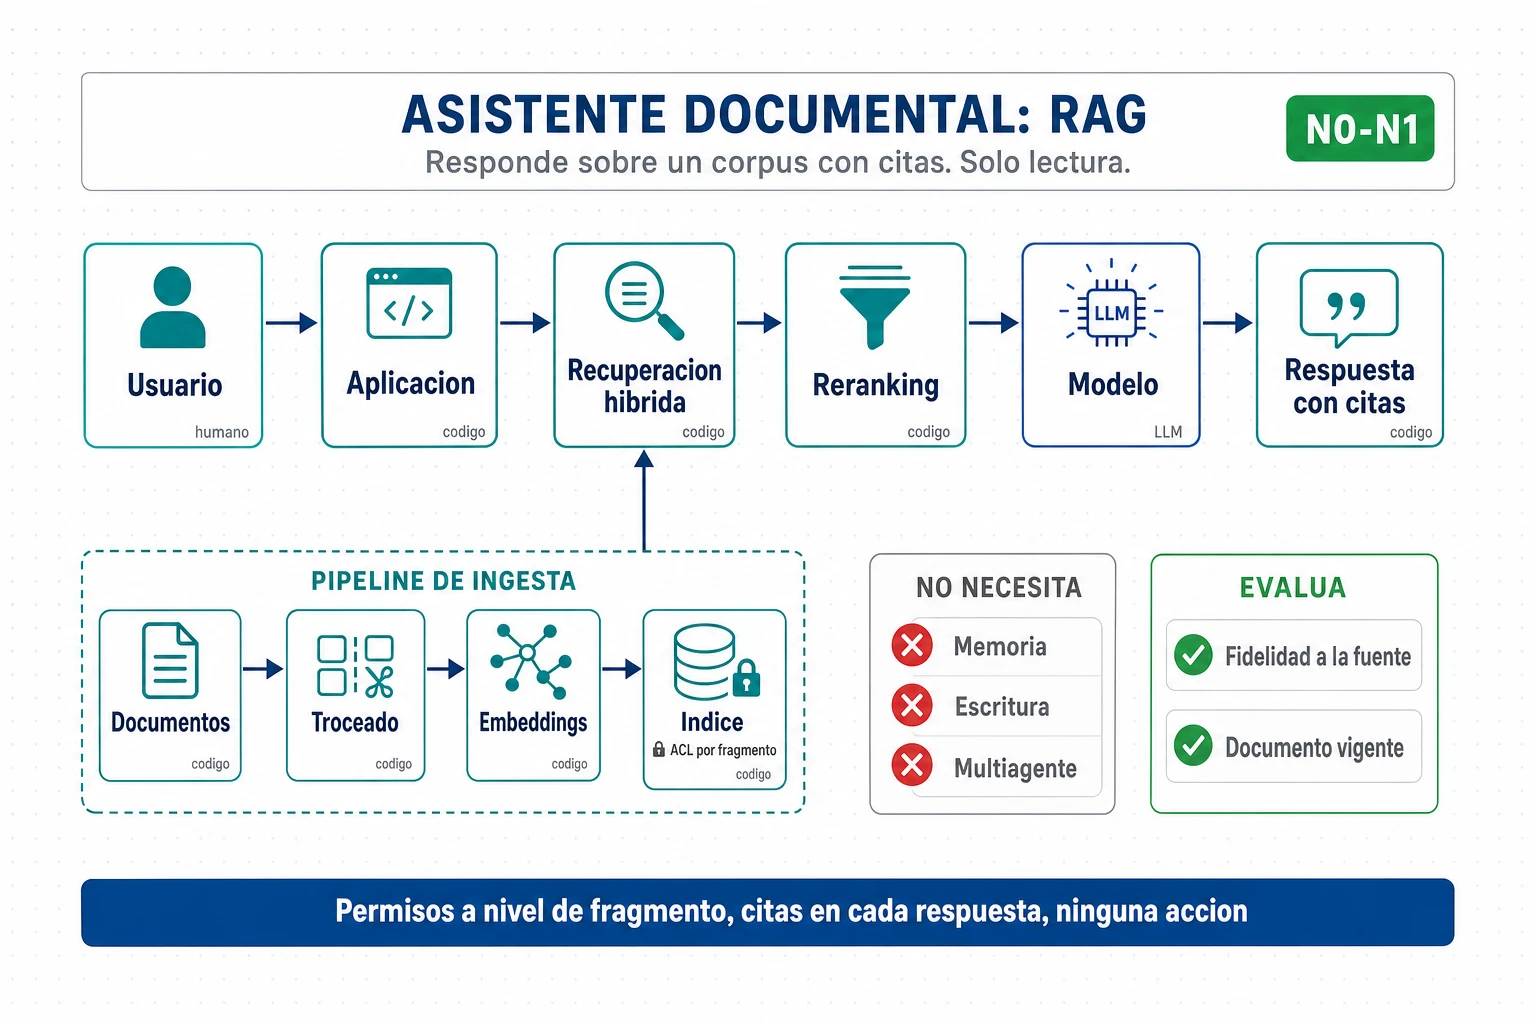
Asistente documental: es RAG, y no necesita ser otra cosa
El problema: responder preguntas sobre documentación interna —políticas, contratos, manuales— con citas, para personas con distintos permisos sobre esos documentos. No escribe en ningún sistema.
La arquitectura tiene dos planos. El de ingesta, fuera de línea y determinista: un conector extrae de cada fuente el texto, los metadatos y los permisos por documento; el texto se trocea, cada fragmento se convierte en un vector y se escribe en un índice híbrido —semántico y léxico— con campos de seguridad que dicen quién puede ver cada fragmento. El de consulta, en línea: la aplicación autentica al usuario; un orquestador de código lanza la búsqueda con la identidad del usuario como filtro, reordena los fragmentos por relevancia y se queda con los mejores; el modelo genera la respuesta condicionada a esos fragmentos, con citas; filtros de contenido a la entrada y a la salida. La persona solo aparece como usuaria. El modelo solo interviene al generar. Todo lo demás es código.
| Componente | ¿Necesario? | Por qué |
| Ingesta con extracción de permisos por documento | Sí | Sin permisos en el índice, el asistente filtra información a quien no debe verla |
| Índice híbrido (semántico + léxico) con reordenación | Sí | La búsqueda léxica cubre códigos, identificadores y términos raros; la reordenación sube la precisión |
| Filtro de seguridad dentro del motor, a nivel de fragmento | Sí | Los permisos deben proyectarse a cada fragmento y aplicarse en la búsqueda, nunca después en la aplicación |
| Citas obligatorias y evaluación de fidelidad | Sí | Sin citas no hay verificabilidad; sin evaluación, cada cambio de troceado o de modelo es una regresión silenciosa |
| Filtros de contenido y abstención explícita | Sí | El asistente debe poder decir «no está en los documentos» |
| Reescritura de consulta con el modelo | Opcional | Mejora la ambigüedad; añade latencia |
| Recuperación agéntica (varias rondas, varias fuentes) | Opcional | Solo con fuentes heterogéneas o preguntas que exigen descomposición, y tras medir la tasa de «no encontrado» |
| Grafo de conocimiento sobre el corpus | Opcional | Solo para preguntas globales sobre todo el corpus; la variante ligera indexa al 0,1 % del coste de la completa |
| Memoria de largo plazo | No | El caso trata de documentos, no del usuario; añade superficie de fuga |
| Multiagente | No | Recuperar y generar basta |
| Herramientas de escritura | No | Si aparecen, el caso pasa a ser otro |
Autonomía: N0, como mucho N1. Aunque por dentro se use un servicio de agentes gestionado, la autonomía observable es nula: responde con citas y la persona decide. Riesgos: la fuga por permisos, que se controla filtrando dentro del motor de búsqueda y a nivel de fragmento —la documentación de Azure AI Search advierte de que los cambios de permisos solo se reflejan tras sincronizar y de que, si no se proyectan a cada fragmento, «las referencias a nivel de fragmento no se filtran»—; la respuesta segura sobre un documento caducado, que se controla con citas, evaluación de fidelidad, abstención y reindexación; la inyección a través de documentos indexados, cuyo impacto limita precisamente la ausencia de escritura; y el sobrecoste de una orquestación no determinista que «puede invocar herramientas innecesarias», como avisa la propia arquitectura de referencia de Azure.
Casos reales. JPMorgan Chase publicó en junio de 2025 que su portal interno de modelos con recuperación pasó de cero a 200.000 usuarios en ocho meses: es adopción, sin métrica de calidad. Uber publicó en octubre de 2024 su copiloto de guardia sobre la documentación de ingeniería: más de 70.000 preguntas y una tasa de utilidad del 48,9 % medida con un modelo como juez; en mayo de 2025, al mejorar la recuperación con búsqueda híbrida y metadatos, midió un 27 % más de respuestas aceptables y un 60 % menos de consejos incorrectos. Publicar una utilidad por debajo del 50 % es inusualmente honesto, y su diagnóstico —el límite es la calidad de la documentación— vale para cualquier empresa. Morgan Stanley y OpenAI publicaron en 2024 que más del 98 % de los equipos de asesores adoptó el asistente y que el acceso a documentos pasó del 20 % al 80 % del corpus: son cifras de adopción y cobertura, no de precisión.
El error más frecuente es de sobreingeniería: un sistema multiagente o un grafo de conocimiento completo para búsqueda de hechos que se resuelve con un buen índice híbrido. El segundo es de subingeniería: omitir el filtrado por permisos «porque el piloto usa documentos públicos» y escalar a contratos sin rehacer la ingesta.
Analista de datos: un modelo con herramientas sobre una capa semántica
El problema: una persona pregunta en lenguaje natural sobre datos tabulares —«¿cuánto vendimos en Levante el trimestre pasado frente al anterior?»— y el sistema genera y ejecuta una consulta y devuelve una tabla, un gráfico o un informe. Solo lectura, siempre.
La arquitectura: el usuario llega con su identidad; una capa semántica, que es configuración determinista mantenida por los analistas —tablas lógicas, métricas con su definición de negocio, sinónimos, relaciones y un repositorio de consultas verificadas— es el componente diferencial; el modelo recibe la pregunta y el esquema semántico, no el físico, y o bien elige una consulta verificada y rellena sus parámetros (vía parametrizada, con precisión cercana al 100 % dentro de su alcance), o bien genera SQL libre (vía generativa, donde caen las cifras); un validador determinista compila la consulta, rechaza cualquier escritura e impone límites de filas, tiempo y coste; el motor de datos la ejecuta con las credenciales del usuario, de modo que los permisos por fila y columna se aplican solos; el modelo redacta la respuesta y muestra la consulta ejecutada y por qué vía se obtuvo; y todo alimenta un benchmark de preguntas con SQL esperado que se ejecuta en cada cambio. La persona mantiene la capa semántica. El modelo genera y presenta. Validar, ejecutar y registrar es código, y el objetivo de diseño es que la mayoría del tráfico vaya por la vía parametrizada.
| Componente | ¿Necesario? | Por qué |
| Capa semántica con definiciones de negocio | Sí | El mayor impacto en precisión según todos los proveedores de plataformas de datos |
| Consultas verificadas | Sí | Convierte «generar SQL» en «elegir SQL» para las preguntas frecuentes |
| Validador determinista (compilación, solo lectura, límites) | Sí | Impide escrituras y consultas ruinosas |
| Ejecución con la identidad del usuario | Sí | Evita saltarse permisos a través del agente; las tres grandes plataformas lo hacen así |
| Benchmark con SQL esperado en integración continua | Sí | Sin él, la capa semántica deriva en silencio |
| SQL visible para el usuario | Sí | Transparencia y corrección por el analista |
| Sandbox de código aislado | Opcional | Solo para análisis más allá de SQL; sin red ni credenciales |
| Generación de informes | Opcional | Plantillas más modelo, siempre sobre consultas parametrizadas |
| Escritura sobre datos | No | Las plataformas lo prohíben por diseño |
| Multiagente propio | No | La cascada interna de un producto gestionado es detalle del proveedor |
| Memoria de largo plazo | No | Las definiciones viven en la capa semántica |
Autonomía: N1-N2. Recomienda la respuesta o prepara el informe; nunca escribe en el dato. Por la vía parametrizada la autonomía real es mínima; el SQL libre es N1 con validación automática, y en dominios regulados, con revisión humana antes de publicar. Riesgos: el principal es la consulta plausible y falsa, un cruce mal hecho o un filtro de fecha equivocado que produce una cifra creíble. Los benchmarks lo miden: en Spider 2.0, publicado en noviembre de 2024 con esquemas empresariales de más de mil columnas, el mejor modelo de entonces obtuvo un 21,3 % frente al 91,2 % en la versión anterior con esquemas limpios; en su clasificación de septiembre de 2026, los sistemas especializados con capa semántica, verificación y reintentos obtienen entre el 65 % y el 97 % según la variante, y un modelo de frontera con un agente genérico, entre el 13 % y el 42 %; en BIRD, el mejor sistema alcanza en agosto de 2026 el 82,39 % frente al 92,96 % de una persona. El modelo no es el factor determinante; la ingeniería alrededor, sí. Un proveedor de modelado de datos publicó en abril de 2026 que la capa semántica lleva a los modelos del 84-90 % al 98-100 %, y que sus fallos son «errores explícitos», seguros, mientras los del SQL libre son «respuestas plausibles pero erróneas». Los otros riesgos —escalada de permisos, consultas ruinosas, deriva de la capa semántica— se controlan con la identidad del usuario, los límites del validador y un propietario con benchmark.
Casos reales. Uber publicó en septiembre de 2024 su generador de SQL: el tiempo de autoría de una consulta pasó de unos 10 a unos 3 minutos, con 300 usuarios diarios en un lanzamiento limitado y un 78 % de usuarios que percibía ahorro; reconoce que alucina tablas y columnas, y su freno principal es que la persona confirma las tablas antes de generar. LinkedIn publicó en diciembre de 2024 que alrededor del 95 % de los usuarios califica la precisión como aprobado o mejor, que la adopción se multiplicó por cinco o diez al integrarlo en la herramienta que ya usaban, y que valida columnas y sintaxis con un plan de ejecución antes de ejecutar nada. Pinterest publicó en abril de 2024 que sus analistas escriben SQL un 35 % más rápido, que la aceptación a la primera pasó del 20 % a más del 40 % y que la recuperación de la tabla correcta pasó del 40 % al 90 % al añadir metadatos; advierte de que la métrica no es causal y de que sus consultas reales son mucho más complejas que las de los benchmarks.
El error más frecuente es de subingeniería: un modelo sobre el esquema físico completo, sin capa semántica ni validador, que es la configuración que obtiene entre el 13 % y el 42 %. El segundo es confundir analítica con acción: «actualiza el presupuesto» es backoffice, y exige otra arquitectura. El tercero, medir con diez preguntas del equipo de datos.
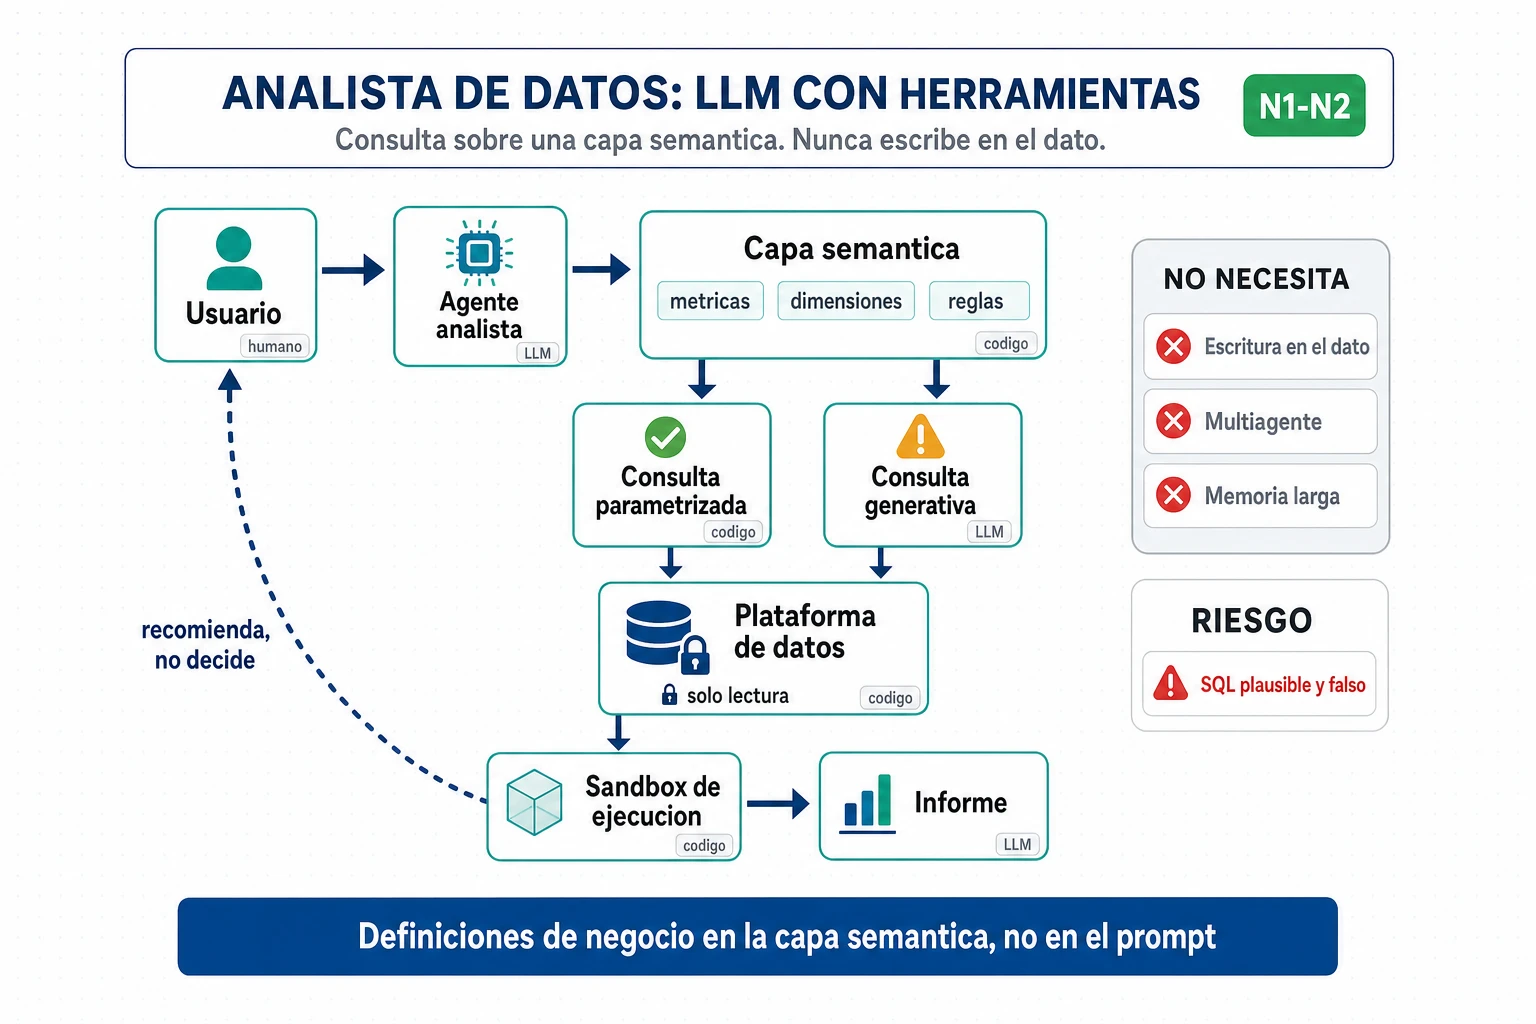
Atención al cliente: un agente único, con lectura libre y escritura estrecha
El problema: atender a clientes por chat, correo o voz; responder lo informacional —estado del pedido, política de devoluciones— y ejecutar lo transaccional —cambiar una dirección, emitir un reembolso—; escalar a una persona cuando no puede o no debe. Es el primero de los tres casos que sí necesita un bucle agéntico.
La arquitectura: el cliente se autentica de forma determinista antes de cualquier acción transaccional; unos guardrails de entrada filtran inyección, contenido y datos personales; un enrutador de intención asigna un tema; un agente único con herramientas tipadas por tema llama a herramientas de lectura y de escritura, cada una con validación determinista de parámetros; las políticas están escritas como código —qué se puede hacer, en qué condiciones, con qué límites de importe y plazo—; una puerta de confirmación detiene las acciones irreversibles o sobre umbral hasta que el cliente confirma o una persona aprueba; un supervisor de salida, que es un modelo independiente, revisa cada respuesta contra hechos, política y tono; el escalado a una persona viaja con contexto; lo informacional se sirve con el RAG de la arquitectura anterior; y antes de cada despliegue se simula con usuarios sintéticos. La persona escribe las políticas, aprueba en la puerta y recibe los escalados. El modelo enruta, atiende y supervisa. Autenticar, validar, aplicar umbrales y escalar es código.
| Componente | ¿Necesario? | Por qué |
| Autenticación antes de cualquier acción | Sí | Sin identidad verificada, cada acción es un vector de fraude |
| Enrutador de intención por temas | Sí | Acota contexto y herramientas; reduce errores y coste |
| Agente único con herramientas tipadas por tema | Sí | Es el núcleo; no un enjambre |
| Políticas como código, versionadas y evaluables | Sí | Es lo que miden los benchmarks del sector y lo que faltó en el caso Air Canada |
| Supervisor de salida independiente | Sí | Los proveedores especializados lo incluyen todos |
| Umbrales y aprobación humana para acciones sensibles | Sí | Reembolsos sobre importe, datos bancarios, cancelaciones con penalización |
| Escalado a persona con contexto | Sí | La tasa de resolución depende de él |
| Simulación masiva y regresión | Sí | La fiabilidad en repetición solo se detecta simulando |
| Auditoría de cada acción en nombre del cliente | Sí | Responsabilidad legal |
| Memoria del cliente entre sesiones | Opcional | Útil; es un almacén de datos personales con gobierno |
| Cascada de varios modelos | Opcional | Los proveedores especializados la usan; una empresa que construye empieza con uno o dos modelos y un supervisor |
| Multiagente con negociación entre agentes | No | No aporta; añade coordinación frágil |
| Herramientas con más permisos que el cliente | No | El agente no debe poder más que el cliente en el portal |
Autonomía: N3 en lo informacional y N2 en lo transaccional. Consultar y explicar se ejecuta y se audita por muestreo; reembolsar sobre un umbral o tocar datos de pago se prepara y alguien aprueba. N4 solo para acciones reversibles bajo umbral: cambiar la dirección de un pedido que aún no ha salido, emitir un vale pequeño. Nunca N5 con impacto económico directo. Riesgos: la promesa que vincula. En febrero de 2024, el tribunal de resolución civil de la Columbia Británica (caso 2024 BCCRT 149) condenó a Air Canada por la información errónea que su chatbot dio sobre tarifas por duelo; la aerolínea alegó que el chatbot era «una entidad legal separada responsable de sus propios actos», el tribunal lo calificó de «alegación notable» y la condenó a pagar 812,02 dólares canadienses. La cifra es pequeña; el precedente no: la empresa responde por lo que dice su agente, y eso ocurre ya en N0. Los otros tres riesgos son la ejecución sin permiso —«soy el titular, cámbiame la cuenta»—, que se controla con autenticación fuerte y umbrales; la inyección por el canal, que se controla tratando el mensaje del cliente como datos y no dando al agente más permisos que al cliente; y la fiabilidad inconsistente, siete de cada diez, que solo se detecta simulando la misma tarea muchas veces.
Casos reales. Klarna anunció en febrero de 2024 que su asistente gestionaba 2,3 millones de conversaciones al mes, dos tercios del total, con un tiempo de resolución de 11 a menos de 2 minutos y un 25 % menos de consultas repetidas; calculó que era «equivalente al trabajo de 700 agentes a tiempo completo» —una equivalencia de carga, no 700 despidos— y proyectó 40 millones de dólares de mejora de beneficio, cifra que nunca confirmó. En mayo de 2025, según Bloomberg, su consejero delegado reconoció que «el coste fue un factor demasiado predominante» y que el resultado era «menor calidad», y la empresa volvió a contratar personas. Vodafone publicó en julio de 2024 que su asistente generativo en Portugal subió la resolución al primer contacto del 15 % al 60 % y el indicador de recomendación en 14 puntos, con transferencia automática a una persona de lo que no resuelve. Commonwealth Bank de Australia anunció en julio de 2025 45 despidos porque su bot de voz reduciría las llamadas, y en agosto, según la cadena pública ABC, los revirtió: las llamadas habían subido, y el banco admitió que ese «error significó que los puestos no eran redundantes». Y Salesforce, cliente cero de su propio producto, dice haber reducido el soporte «de 9.000 a unas 5.000» personas con una satisfacción «más o menos igual», según su consejero delegado en un podcast en septiembre de 2025; ninguna de las dos cifras está auditada.
El error más frecuente es de subingeniería: un chatbot sobre documentos al que se añaden herramientas de escritura sin autenticación, sin políticas como código y sin umbrales. El segundo es de sobreingeniería: un «agente de reembolsos» que negocia con un «agente de políticas». El tercero es la política de cuarenta páginas en el prompt en lugar de reglas verificables. Y el cuarto es medir la deflexión —cuántos clientes no llegaron a una persona— como si fuera resolución.
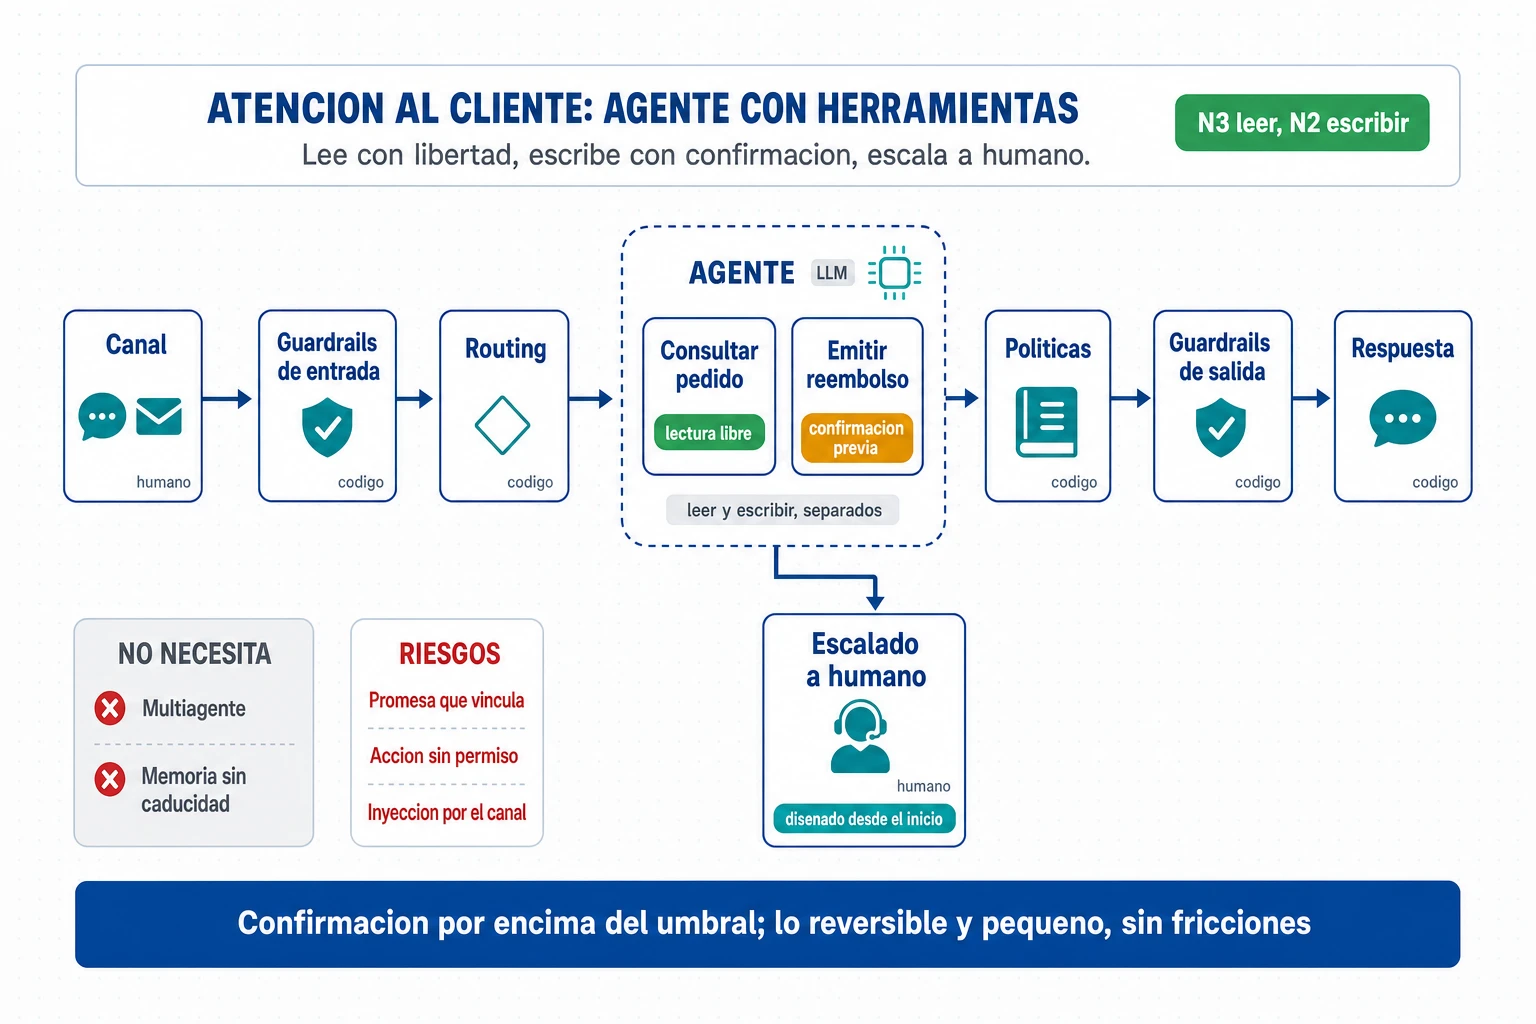
Backoffice: un workflow determinista con el modelo en pasos concretos
El problema: procesos internos repetitivos con pasos definidos y sistemas de registro detrás —ERP, CRM, gestión de servicios, recursos humanos—: facturas, conciliaciones, altas, tickets, compras. El modelo aporta lo que la automatización clásica no tenía —leer documentos, clasificar, decidir en ambigüedad acotada—, pero el proceso lo gobierna un motor determinista. No es un agente, y no debe serlo.
La arquitectura: un disparador arranca una instancia en un motor de procesos —BPMN, máquina de estados, orquestador de ejecución durable—; un paso de extracción con el modelo convierte el documento en datos estructurados con una confianza por campo; una validación determinista cruza totales, comprueba que el proveedor existe y que el pedido coincide, y manda a una cola de revisión humana lo que falla o tiene baja confianza; un paso de decisión acotada con el modelo interviene solo en la ambigüedad real —centro de coste, categoría del ticket— con salida estructurada; una puerta de aprobación aplica la matriz de autorización, y el motor espera horas o días sin perder estado; la ejecución contra el sistema de registro es idempotente, para que un reintento no contabilice dos veces, y tiene compensación definida; una auditoría inmutable guarda quién aprobó, qué produjo el modelo y con qué versión de prompt y de modelo. La persona valida, aprueba y resuelve excepciones. El modelo extrae y decide en ambigüedad, siempre produciendo datos que el motor valida. El motor, la validación, la ejecución y la auditoría son código.
| Componente | ¿Necesario? | Por qué |
| Motor de procesos con ejecución durable | Sí | Estado durante días, supervivencia a fallos, orden de pasos, esperas de aprobación |
| Extracción con confianza por campo | Sí, si hay documentos | Sin confianza no hay enrutado a revisión |
| Validación determinista de reglas de negocio | Sí | La red de seguridad frente al error de extracción |
| Puertas de aprobación con matriz de autorización | Sí | Primitiva nativa en todos los motores de procesos actuales |
| Idempotencia y compensación | Sí | Un reintento no contabiliza dos veces; un fallo se deshace |
| Auditoría inmutable con versión de modelo y prompt | Sí | Control interno y cumplimiento |
| Cola de revisión y gestión de casos | Sí | Las excepciones se enrutan, no desaparecen |
| Registro de flujos y agentes con propietario | Sí | Las plataformas de gestión de servicios y de recursos humanos ya lo ofrecen como producto |
| Modelo para decisiones acotadas con salida estructurada | Opcional, por paso | Solo en ambigüedad real; nunca para decidir si se paga |
| Automatización robótica para sistemas sin API | Opcional | Los proveedores de automatización la combinan explícitamente con agentes |
| Subproceso acotado con un agente | Opcional | Para tramos sin orden fijo, como investigar una discrepancia, dentro de un ámbito cerrado |
| Agente autónomo de bucle abierto | No | Añade no determinismo sin valor y destruye la auditabilidad |
| Memoria de largo plazo o multiagente | No | El estado vive en el motor; varios pasos con modelo no son varios agentes |
Autonomía: N3-N4 por paso, y N2 en el paso irreversible. La extracción se ejecuta y se audita por encima del umbral de confianza; la clasificación de bajo impacto se ejecuta salvo excepciones; contabilizar, pagar o dar de alta datos maestros se prepara y alguien aprueba por encima de un umbral; nunca N5 en pagos. Riesgos: sobre-agentizar un proceso que era determinista; la extracción incorrecta que se propaga —un estudio de octubre de 2025 sobre 102 facturas midió un 94 % de precisión con extracción guiada por esquema frente a un 63 % con OCR clásico; la muestra es pequeña, pero 94 % significa una de cada dieciséis facturas con algún campo mal, y por eso hacen falta confianza por campo, validación cruzada y cola de revisión—; la doble ejecución tras un reintento, que resuelve la idempotencia; la aprobación «de goma», porque si la tasa de rechazo en la puerta es cero, la puerta no funciona; y la deriva: el modelo cambia el viernes y la clasificación cambia el lunes, salvo que haya regresión con documentos de referencia antes de cada cambio de versión.
Casos reales. BNY, el banco de custodia, declaró en diciembre de 2025, según Banking Dive, tener «más de 100 empleados digitales» —agentes multipaso— en validación de pagos y reparación de código, cada uno con un manager humano que revisa su rendimiento; ninguna entrevista trae una métrica de resultado, así que el caso vale por su modelo de gobierno. Pactum, un proveedor especializado, negocia con proveedores de cola larga —muchos, de bajo valor— en nombre de grandes compradores, dentro de límites de precio, plazo y descuento fijados de antemano por el equipo de compras y con aprobación del comprador cuando el resultado se sale del rango; declara, como cifra propia, un 82 % de satisfacción entre los proveedores. Es el patrón que importa: autonomía alta sobre un dominio pequeño y acotado por personas. Los motores de procesos han incorporado el patrón como producto: Camunda añadió en abril de 2025 subprocesos en los que un agente ejecuta herramientas «en cualquier orden» dentro de un ámbito cerrado, con «BPMN como guardrail»; UiPath habla de «agencia controlada» para orquestar agentes, robots y personas; Temporal ejecuta el bucle del agente dentro de un workflow durable.
El error más frecuente, y con diferencia, es de subingeniería: un agente de propósito general con acceso al ERP y la instrucción «procesa las facturas», sin motor, sin idempotencia y sin puertas. El de sobreingeniería es una plataforma multiagente propia para un proceso que cabe en un BPMN con dos pasos de modelo, y llamar «agente» a cada prompt.
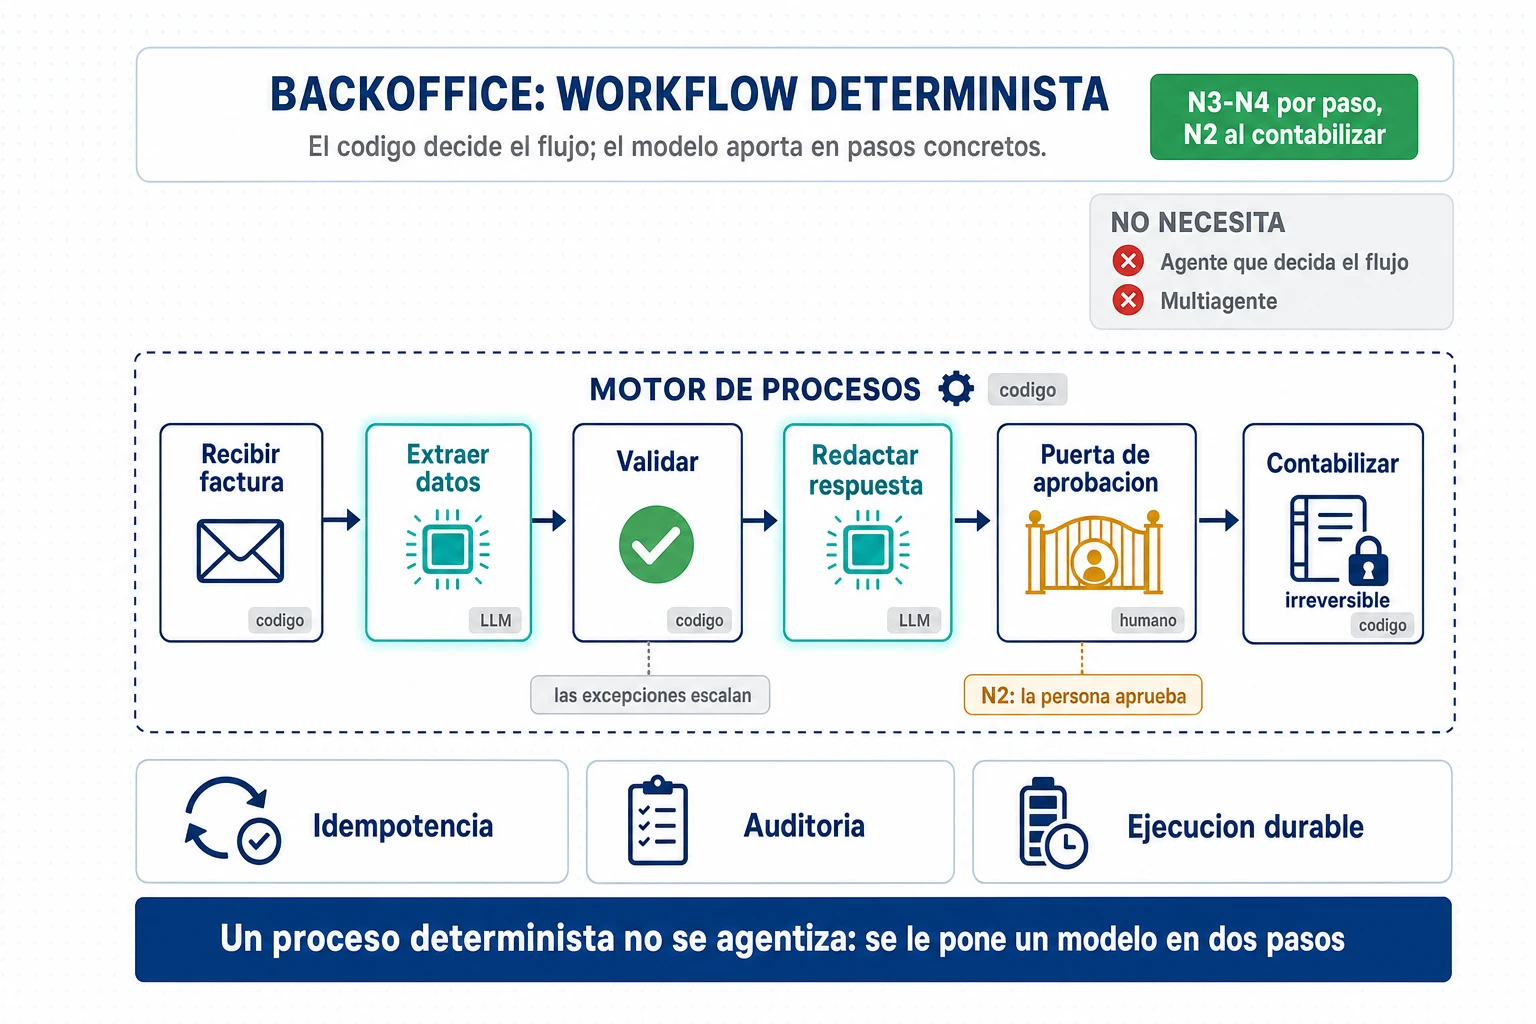
Operaciones de red y seguridad: investigar con libertad, remediar con permiso
El problema: triar alertas, correlacionarlas, diagnosticar la causa raíz y remediar, en red, en infraestructura y en seguridad. Alto volumen, presión de tiempo y consecuencias graves de una remediación equivocada: aislar el servidor equivocado puede ser técnicamente correcto y operativamente devastador.
La arquitectura: la telemetría —el SIEM, la plataforma de observabilidad, el inventario de activos, los cambios recientes— se expone a través de una capa de acceso de solo lectura con una identidad propia del agente y permisos mínimos; un agente de triaje formula hipótesis, consulta, enriquece y emite un veredicto —falso positivo, verdadero positivo, necesita persona— con confianza y evidencia enlazada; unas reglas deterministas de disposición cierran los falsos positivos de alta confianza y escalan el resto; un agente de investigación de causa raíz ramifica hipótesis y correlaciona con cambios recientes; los runbooks son código probado, con radio de acción y reversibilidad declarados; una puerta de aprobación decide: el agente propone el runbook, y si es reversible y de radio acotado se ejecuta y avisa, y si no, lo aprueba una persona; la ejecución la hace el motor de automatización, nunca el modelo; el feedback del analista se aplica solo tras revisión; y una evaluación continua muestrea los cierres automáticos para detectar falsos negativos. La persona aprueba, revisa los verdaderos positivos y aporta el contexto de negocio. El modelo tría e investiga, siempre en lectura. El acceso, la disposición, los runbooks y la ejecución son código.
| Componente | ¿Necesario? | Por qué |
| Acceso de solo lectura con identidad propia y permisos mínimos | Sí | Así lo diseñan los grandes proveedores de seguridad y observabilidad |
| Triaje con veredicto, confianza y evidencia enlazada | Sí | Permite validar en segundos |
| Reglas deterministas de disposición | Sí | Cerrar automáticamente es una regla sobre el veredicto, no una decisión del modelo |
| Runbooks con radio y reversibilidad declarados | Sí | La remediación la ejecuta código probado |
| Puerta de aprobación para remediación | Sí | Todos los proveedores la exigen para acciones de impacto |
| Feedback revisado antes de aplicarse | Sí | Una «lección» sin revisar es un vector de envenenamiento |
| Evaluación continua y muestreo de cierres automáticos | Sí | La única forma de detectar falsos negativos |
| Agente de causa raíz dirigido por hipótesis | Opcional | Muy útil en operaciones; asiste, no sustituye |
| Correlación con cambios recientes | Opcional, recomendado | La heurística más potente para la causa raíz |
| Remediación automática de radio acotado (bloquear una IP, revocar una sesión) | Opcional | Solo reversible, de bajo radio y con historial |
| Remediación automática de radio amplio | No | Todas las fuentes la excluyen o la condicionan |
| Memoria libre del agente | No | Vector de envenenamiento |
| Enjambre multiagente | No | Los proveedores usan agentes especializados bajo un playbook determinista |
Autonomía: N3 en triaje e investigación, N1-N2 en remediación. Cerrar falsos positivos de alta confianza se ejecuta y se audita por muestreo; investigar y proponer contención es recomendar; remediar de forma acotada y reversible es preparar y, con historial, ejecutar y avisar; remediar de forma amplia o irreversible, y cualquier decisión regulada como notificar una brecha, es preparar para que alguien apruebe. Riesgos: remediar en falso —aislar un sistema crítico por un falso positivo—, que se controla con el radio declarado, la aprobación para lo no reversible y la criticidad del activo en la regla de disposición; los falsos negativos silenciosos, que nadie publica y que solo se detectan muestreando lo que el agente cerró; la fatiga de alertas invertida, cuando el analista deja de mirar porque «el agente ya lo ha visto»; la inyección a través de la propia telemetría o de un correo que el agente analiza, porque el atacante que sabe que un agente lee los registros puede escribir en ellos; y la erosión de habilidades del equipo. Una advertencia sobre las cifras de este sector: las precisiones que publican los proveedores se miden contra sus propios analistas, nadie publica falsos negativos, y «98 % de acuerdo en triaje» no es «98 % de remediaciones correctas».
Casos reales. Microsoft presentó en marzo de 2025 once agentes para su plataforma de seguridad, seis propios y cinco de socios. Su agente de triaje de phishing es la referencia de diseño: identidad propia con los permisos mínimos —leer alertas, gestionarlas, leer solo los correos asociados—, clasifica cada alerta y solo cierra los falsos positivos; si es maliciosa, deja el incidente abierto para que un analista actúe; la corrección del analista se convierte en «lección» solo si se aplica explícitamente y pasa una evaluación. Microsoft afirma que resuelve el 90 % de los falsos positivos, cifra de proveedor sin metodología. Meta publicó en junio de 2024 su sistema de causa raíz: una recuperación heurística reduce miles de cambios a cientos y un modelo pequeño afinado con unas 5.000 investigaciones históricas los ordena hasta cinco candidatos; en pruebas retrospectivas, en el 42 % de las investigaciones la causa real estaba entre esos cinco. No resuelve nada: sugiere, y Meta advierte de que «puede sugerir causas raíz equivocadas y desorientar a los ingenieros». Google afirma, como proveedor, que su agente de triaje ha investigado más de 5 millones de alertas con las acciones críticas bajo aprobación humana, y su documentación dice que «no ejecuta acciones de remediación»; CrowdStrike habla de «autonomía acotada»; Datadog describe su agente como de solo lectura, «investiga, no remedia»; Cisco, para operaciones de red: «todos los cambios requieren aprobación del ingeniero antes de ejecutarse». Un mismo patrón en todos, y ninguno con remediación amplia autónoma.
El error más frecuente es de subingeniería: un modelo con permisos de administrador sobre el SIEM «para poder responder». Ninguna arquitectura publicada lo hace. El de sobreingeniería es un enjambre que negocia la respuesta cuando basta triaje, reglas y los playbooks que ya existen. Y tres errores de operación: ampliar la autonomía sin historial, medir el tiempo de resolución sin medir las reversiones, y aplicar el feedback sin revisión.
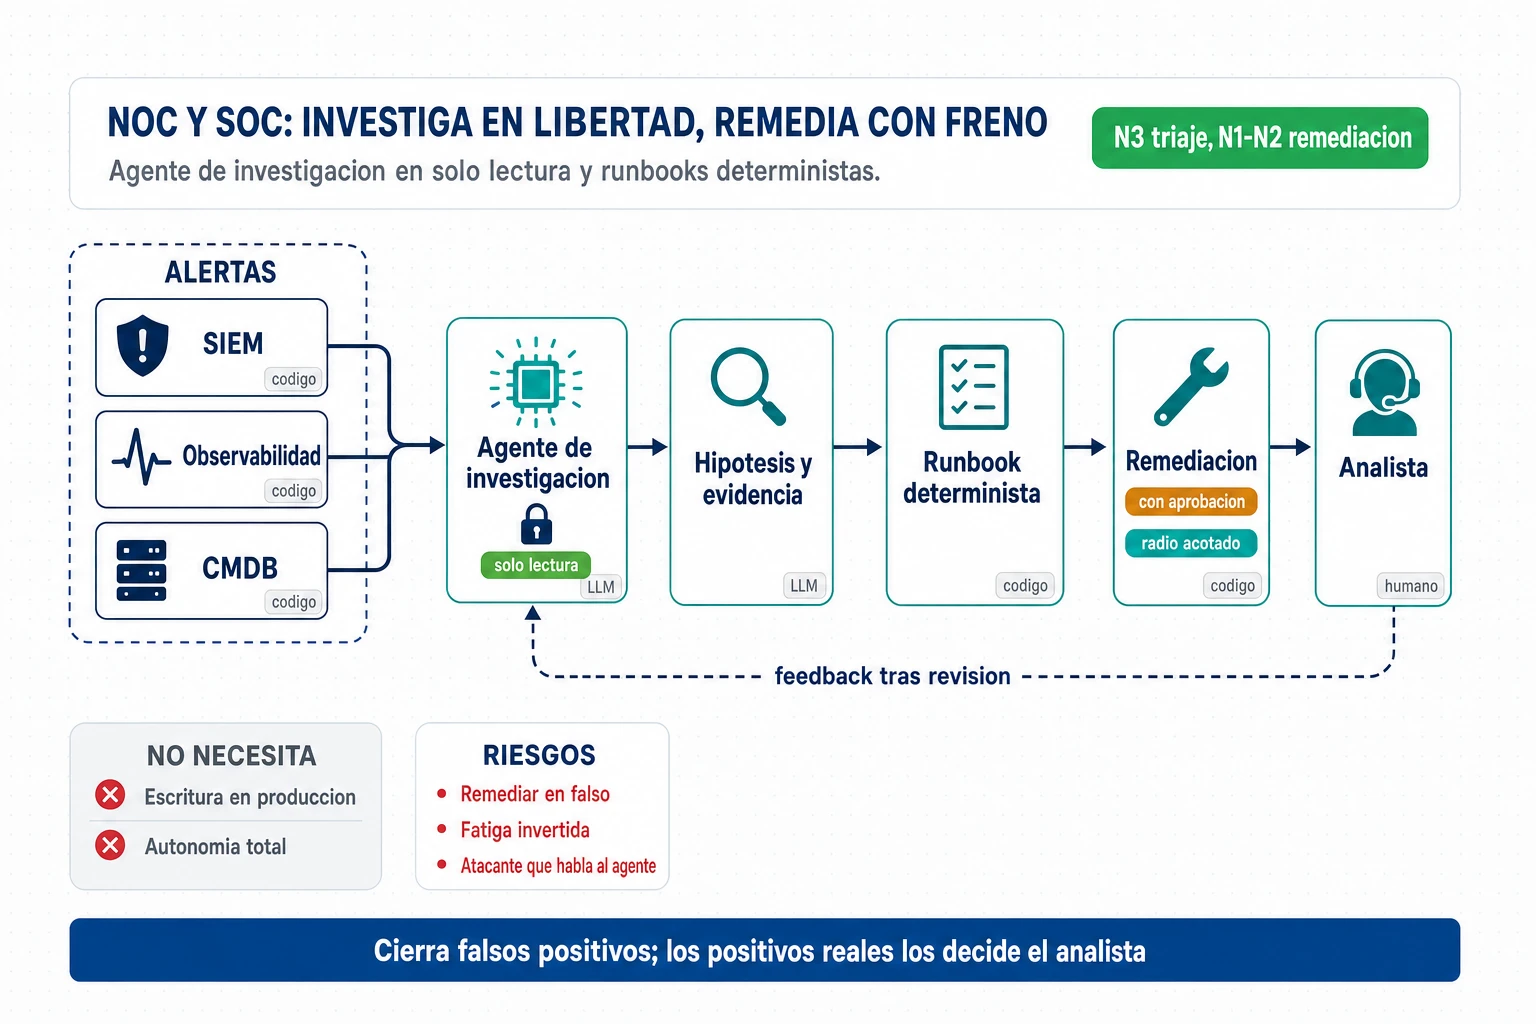
Procesos autónomos de principio a fin: todo lo anterior, más un mandato y un interruptor
El problema: un agente ejecuta un proceso completo con supervisión mínima: reabastecimiento, negociación con proveedores, liquidación de siniestros, compras y pagos por cuenta de una persona, prospección comercial. Es el único caso que aspira a N4-N5 de forma sostenida, y por eso exige de serie componentes que en los demás son opcionales.
La arquitectura: un mandato determinista y firmado define qué puede hacer el agente, con qué límites —presupuesto por operación y por periodo, contrapartes permitidas, rangos de precio, plazos— y con qué condiciones de parada; el agente tiene una identidad propia registrada en el directorio, con credenciales propias y ciclo de vida; el agente planifica, negocia, decide y ejecuta dentro del mandato, y si hay varios especializados, los coordina un orquestador determinista; un motor de políticas independiente del modelo está en la ruta de cada llamada y rechaza lo que se sale del mandato; unas puertas escalonadas hacen que por debajo del umbral se ejecute y avise, por encima se apruebe, y que ciertas categorías —contratos plurianuales, cambio de proveedor estratégico— sean siempre humanas; la ejecución es idempotente, con reversión declarada por tipo de acción y registro no repudiable; un interruptor de parada fuera del control del agente —revocar identidad, cortar herramientas, pausar el orquestador— se acciona por una persona y por reglas; la observabilidad guarda trazas por decisión; antes de cada cambio se simula el proceso con contrapartes sintéticas; y la contraparte —proveedor, comercio, cliente u otro agente— verifica que el agente es legítimo y tiene mandato. La persona firma el mandato, aprueba por encima del umbral, acciona el interruptor y revisa la evaluación; en la ejecución normal no está. El modelo solo está en el agente. Todo lo demás es código, y especialmente el motor de políticas, la ejecución y el interruptor.
| Componente | ¿Necesario? | Por qué |
| Mandato explícito y firmado (alcance, límites, caducidad) | Sí | Es el contrato; los protocolos de pago agéntico lo hacen criptográfico |
| Identidad propia del agente con ciclo de vida | Sí | Sin ella no hay atribución ni revocación limpia |
| Motor de políticas fuera del modelo, en cada llamada | Sí | El freno determinista |
| Presupuesto y límites de tasa | Sí | Acota el daño máximo por periodo |
| Interruptor de parada independiente | Sí | Debe funcionar aunque el agente y su orquestador fallen |
| Observabilidad con trazas por decisión | Sí | La única fuente de verdad cuando nadie mira |
| Reversión declarada por tipo de acción | Sí | Define qué puede ser N4 y qué debe ser N2: un pedido se cancela, una transferencia no |
| Simulación previa y evaluación continua | Sí | No cubre lo adversario, pero sin ella ni lo previsible |
| Verificación mutua con la contraparte | Sí en comercio; recomendable en interno | Protocolos de pago agéntico fuera; identidad y firma dentro |
| Puertas escalonadas por importe y categoría | Sí | N4 debajo, N2 encima, N1 en categorías nuevas |
| Orquestador determinista sobre agentes especializados | Opcional | Para fases muy distintas —buscar, negociar, pedir—; nunca un enjambre libre |
| Memoria de largo plazo gobernada | Opcional | Útil; vector de envenenamiento; revisable |
| Un supervisor que es otro modelo como único control | No | No frenó los descuentos y fue suplantado en el experimento más conocido |
| Credenciales de pago en claro | No | Todos los protocolos usan tokens acotados a comercio, importe y tiempo |
Autonomía: N4 por defecto, N5 solo en tramos acotados, y solo cuando se cumplen cinco condiciones a la vez: el espacio de decisión está acotado y se puede describir; el coste del error es pequeño y la acción es reversible o asegurable; el volumen hace inviable supervisar por operación; hay verdad de campo para evaluar; y la contraparte puede verificar al agente. Si el proceso cabe en un workflow determinista, si las acciones son irreversibles y de alto importe o si no hay forma de medir, no está justificado. Riesgos: el experimento que mejor los documenta es Project Vend, en el que Anthropic dejó un modelo al frente de una pequeña tienda de oficina. En la primera fase, publicada en junio de 2025, con herramientas potentes y sin procedimientos ni supervisor, vendió por debajo de coste, alucinó una cuenta de pago, concedió descuentos a quien se los pedía por chat y no fue rentable. En la segunda, publicada en diciembre de 2025, con un CRM, costes visibles, procedimientos obligatorios de verificación y un «CEO» que era otro agente, el negocio pasó a beneficio sostenido y los descuentos bajaron un 80 %; pero estuvo a punto de firmar un contrato ilegal de futuros de cebolla y un impostor tomó brevemente el control del CEO con una votación fraudulenta. La lección literal de Anthropic es «la burocracia importa», y cada componente de la tabla corresponde a un fallo observado: sin límites externos, vendió a pérdida; sin verificación de identidad, un impostor mandó; sin procedimientos deterministas, se comprometía sin comprobar; y un supervisor que es otro modelo no frenó nada. Los otros riesgos —coste descontrolado, manipulación por la contraparte, fallo en cascada— tienen sus controles en la tabla.
Casos reales. Lemonade, la aseguradora, declaró en su informe anual ante el regulador de febrero de 2026 que su agente de siniestros toma «el 96 % de las veces» la primera notificación sin intervención humana y que «aproximadamente el 55 %» de los siniestros se automatizaron de principio a fin; el resto lo asigna a un experto humano, y en muchos casos una persona revisa antes de aprobar. Es autonomía real en la mitad simple de los casos, con límites de autoridad explícitos. Amazon publicó en agosto de 2024 que su agente de transformación de código migró más de la mitad de sus sistemas Java de producción en menos de seis meses, con un ahorro estimado de 4.500 años-desarrollador y 260 millones de dólares anuales, y con el 79 % de las revisiones de código enviadas sin cambios; la empresa es también el proveedor del producto, la cifra es una estimación y la tarea tenía pruebas existentes como verificación. En pagos, 2025 fue el año de los protocolos: OpenAI y Stripe publicaron en septiembre el suyo, en el que el comerciante sigue siendo el responsable de la venta y el agente paga con un token acotado a un comercio y un importe; Google publicó el mismo mes el suyo, con más de sesenta socios, basado en mandatos firmados de intención, de carrito y de pago; Visa publicó en octubre su protocolo para que los comercios verifiquen criptográficamente al agente, y en diciembre de 2025 declaró «cientos» de transacciones agénticas completadas; Mastercard anunció en abril de 2025 tokens acotados a un agente y un comercio. La lectura común: el agente nunca tiene la credencial en claro, el mandato se firma y viaja con la transacción, la contraparte verifica al agente y la responsabilidad se reparte con evidencia no repudiable. El contraejemplo es 11x, un proveedor de agentes de prospección comercial del que TechCrunch documentó en marzo de 2025 clientes que no lo eran y una rotación del 70 % al 80 % en las pruebas.
El error más frecuente es de subingeniería: una tarjeta corporativa o unas credenciales del ERP, y un objetivo. Es la primera fase de Project Vend. El segundo es confiar la supervisión a otro modelo como único control: es la segunda. El tercero es no dar al agente identidad propia y hacerlo correr con la cuenta de un empleado o con una cuenta de servicio compartida. Y el cuarto es confiar en la simulación sin puertas ni interruptor: la simulación no predice al empleado que convence al agente de firmar futuros de cebolla.
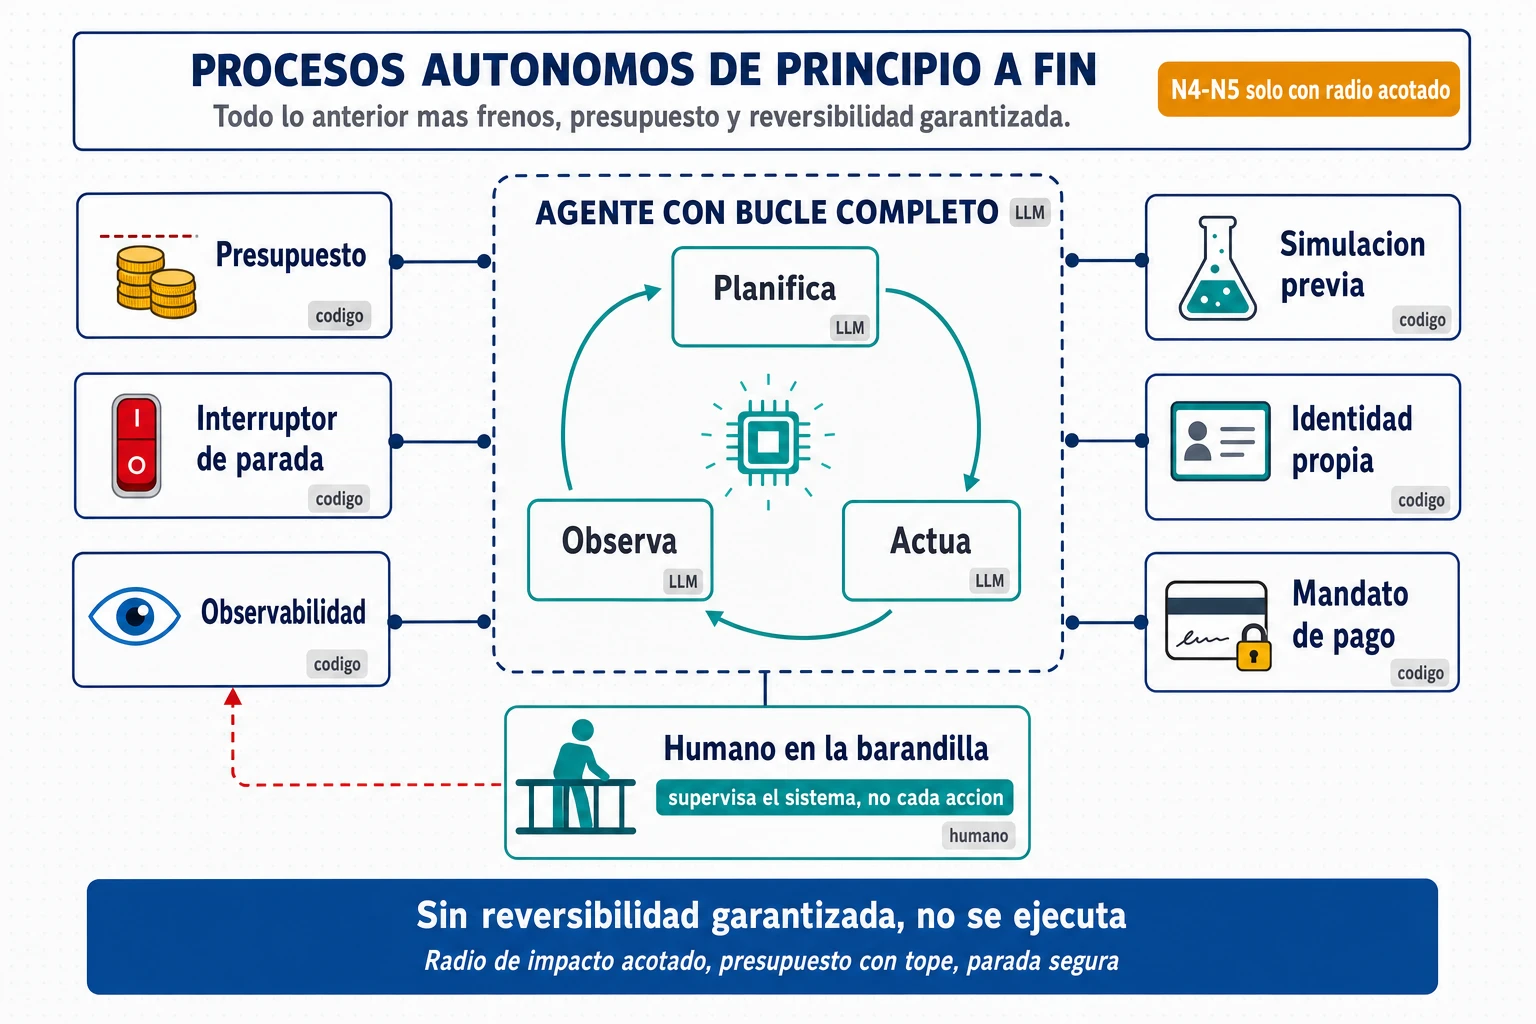
Vistas juntas, las seis arquitecturas confirman la tesis. Tres no son agentes: el asistente documental es RAG, el analista de datos es un modelo con herramientas sobre una capa semántica, el backoffice es un workflow determinista con el modelo en pasos. Las otras tres sí llevan un bucle agéntico, con grados de autonomía muy distintos: la atención al cliente ejecuta en lectura y prepara en escritura; el centro de operaciones ejecuta el triaje y recomienda la remediación; y solo el proceso autónomo ejecuta salvo excepciones, y solo con un mandato, un motor de políticas y un interruptor que el modelo no controla. En el mapa, la diagonal es la del coste: cada paso hacia el modelo y hacia la escritura añade componentes obligatorios, y ninguno de ellos es el modelo.
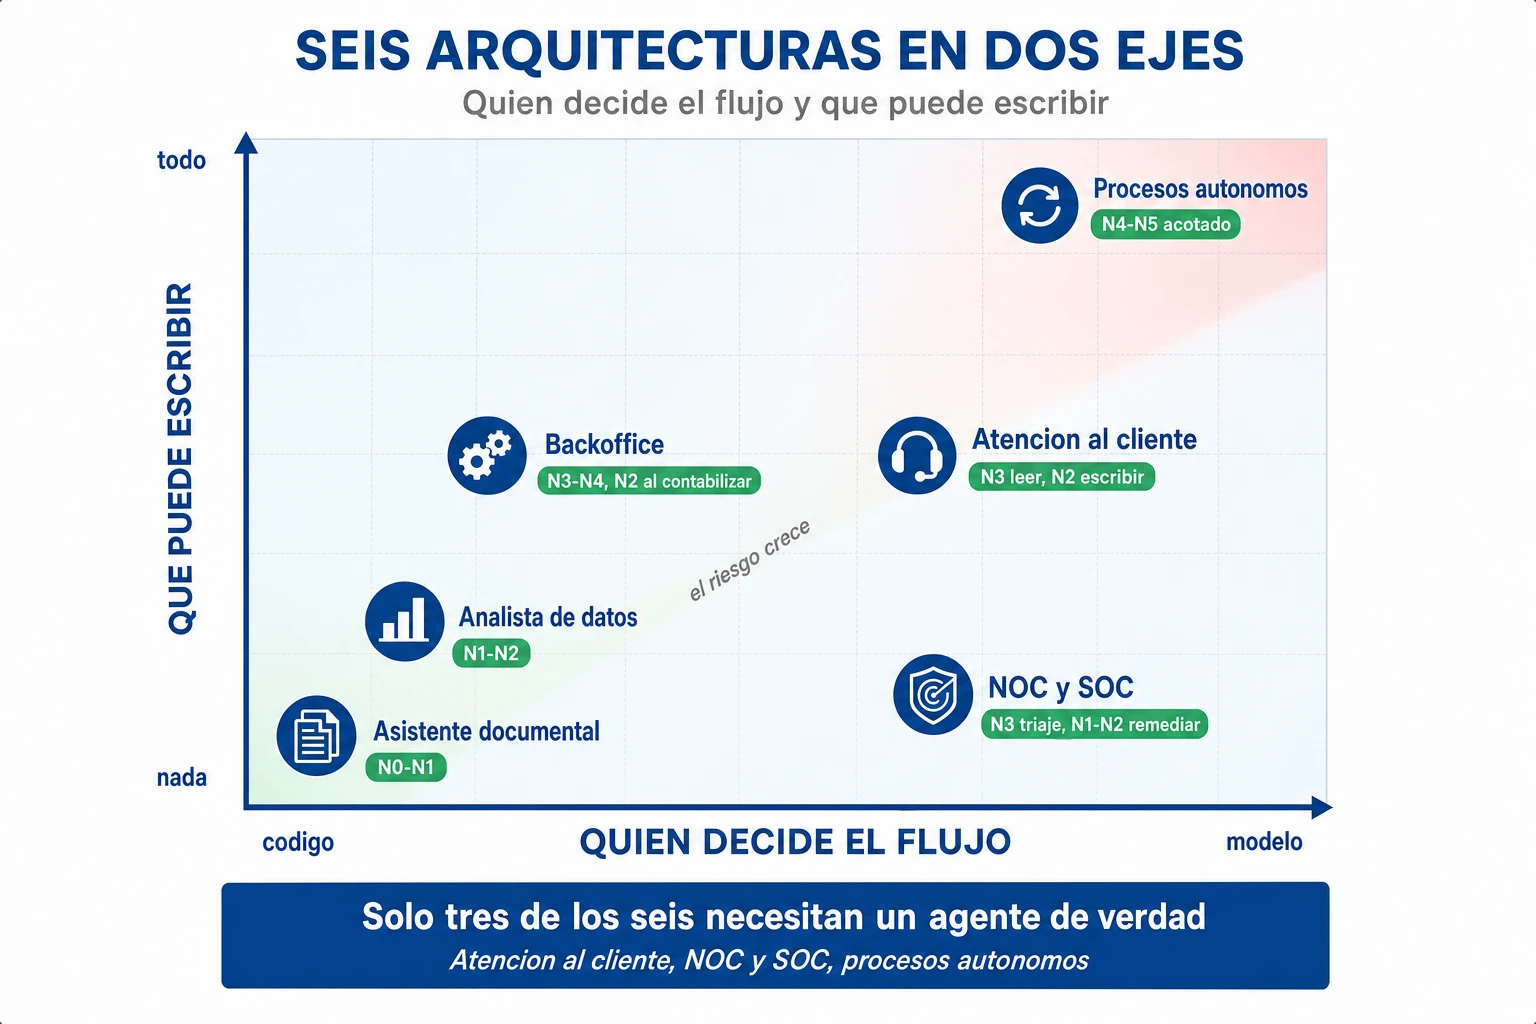
Lo que enseñan los casos que funcionan y los que fallaron
Los cuatro casos que este blog ya ha desarrollado a fondo —la migración de código de Spotify, el embudo comercial de Uber, la simulación de planta de PepsiCo y el reabastecimiento de Walmart— están en el artículo sobre lo que han cambiado de verdad cuatro grandes empresas y no se repiten aquí. La tabla recoge otros dieciséis, elegidos con un criterio: que la cifra la publique la propia empresa o un medio serio, y que se sepa qué salió mal o qué límite reconoció. Las cifras que solo publica el proveedor de la solución se han citado por sector en la sección anterior y no entran en esta tabla.
| Empresa | Sector | Tipo | Arquitectura | Resultado publicado | Quién publica | Qué salió mal o qué límite reconocieron |
| JPMorgan Chase | Banca | Documental | Portal multimodelo con recuperación sobre conocimiento interno | 200.000 usuarios en ocho meses | La empresa (jun 2025) | Ninguna métrica de calidad ni de productividad |
| Uber (copiloto de guardia) | Movilidad | Documental | RAG híbrido; después recuperación agéntica | 70.000+ preguntas; 48,9 % de utilidad; +27 % aceptables y −60 % consejos incorrectos tras mejorar la recuperación | La empresa (oct 2024, may 2025) | Utilidad por debajo del 50 %; el límite es la calidad de la documentación |
| Morgan Stanley | Gestión de patrimonios | Documental | RAG con evaluación antes de cada despliegue y revisión del asesor | Más del 98 % de los equipos de asesores lo usan; acceso a documentos del 20 % al 80 % | OpenAI y la empresa (2024) | Es adopción y cobertura, no precisión; la primera versión no pasó las evaluaciones internas |
| Uber (generador de SQL) | Movilidad | Datos | Cadena de pasos con confirmación humana de tablas | De 10 a 3 minutos por consulta; 300 usuarios diarios; 78 % percibe ahorro | La empresa (sep 2024) | Alucina tablas y columnas; variabilidad entre ejecuciones |
| Red profesional | Datos | Recuperación de tablas, validación con plan de ejecución, autocorrección | ~95 % califica la precisión como aprobado o mejor; adopción 5-10× al integrarlo | La empresa (dic 2024) | Latencia; dependencia de metadatos curados por la comunidad | |
| Klarna | Pagos | Atención al cliente | Agente único con contexto de pedido y transferencia a persona | 2,3 M conversaciones al mes; de 11 a menos de 2 minutos; carga equivalente a 700 agentes | La empresa (feb 2024); Bloomberg (may 2025) | El consejero delegado reconoce «menor calidad» por priorizar el coste y vuelve a contratar |
| Vodafone | Telecomunicaciones | Atención al cliente | Agente con acciones acotadas y escalado automático | Resolución al primer contacto del 15 % al 60 %; NPS +14 (Portugal) | La empresa (jul 2024) | Un país, fase inicial; sin tasa de escalado publicada |
| Commonwealth Bank | Banca | Atención al cliente | Bot de voz generativo | 45 despidos anunciados y revertidos | ABC (ago 2025) | Las llamadas subieron; el banco admitió un «error» de evaluación |
| Octopus Energy | Energía | Asistencia al agente humano | Modelo sobre el CRM; la persona revisa y envía | 35 % de los correos a clientes con ayuda de IA | Kraken, su filial (ago 2024) | Solo un tercio sale sin cambios; dos tercios se editan |
| BNY | Custodia | Backoffice | Plataforma multiagente propia con manager humano por agente | «Más de 100 empleados digitales» en validación de pagos y reparación de código | Banking Dive (dic 2025) | Ninguna métrica de resultado; la cifra crece con cada entrevista |
| Microsoft (Security Copilot) | Seguridad | Centro de operaciones | Agente de triaje con identidad propia y permisos mínimos | Cierra solo falsos positivos; los verdaderos quedan abiertos para el analista | La empresa (mar 2025; documentación jul 2026) | El «90 % de falsos positivos resueltos» es cifra de proveedor; no remedia |
| Meta | Plataforma | Operaciones | Recuperación heurística más modelo pequeño afinado | Causa raíz entre los cinco candidatos en el 42 % de las investigaciones, en pruebas retrospectivas | La empresa (jun 2024) | Solo sugiere; «puede desorientar a los ingenieros» |
| Lemonade | Seguros | Proceso autónomo | Autoridad explícita con derivación a expertos | 96 % de primeras notificaciones sin persona; ~55 % de siniestros automatizados de principio a fin | Informe anual ante el regulador (feb 2026) | El resto va a expertos; en muchos casos una persona revisa antes de aprobar |
| Amazon | Comercio y nube | Proceso autónomo (migración de código) | Agente con plan revisado y pruebas existentes como verificación | 4.500 años-desarrollador estimados; 79 % de revisiones sin cambios | La empresa, que es también el proveedor (ago 2024) | Estimación; el 21 % necesitó cambios; tarea especialmente adecuada |
| Anthropic (Project Vend) | Experimento | Proceso autónomo | Agente con herramientas; en la segunda fase, procedimientos y supervisor | Primera fase con pérdidas; segunda rentable, con descuentos −80 % | La empresa (jun y dic 2025) | Manipulación social; contrato ilegal casi firmado; impostor en el puesto del supervisor |
| 11x | Software | Proceso autónomo (ventas) | Agente de prospección comercial | Rotación del 70-80 % en pruebas; clientes anunciados que no lo eran | TechCrunch (mar 2025) | Contraejemplo: el resultado publicado por el proveedor no se sostenía |
Los cuatro rasgos que se repiten en los que funcionan
El primero es el alcance acotado. Uber clasifica cada pregunta en un espacio de negocio antes de generar SQL; ING, según McKinsey, que construyó su asistente, le prohibió asesorar sobre hipotecas; Klarna cubre el primer nivel y transfiere el resto; Lemonade define por escrito qué siniestros puede liquidar el agente. El agente rinde cuando el espacio de acción es pequeño. El segundo es lectura amplia y escritura estrecha: en operaciones el agente lee toda la telemetría pero solo cierra falsos positivos o solo remedia por runbook aprobado; en pagos, el token está acotado a comercio e importe. El tercero es el escalado a una persona diseñado desde el principio: Vodafone transfiere lo que no resuelve, Octopus hace que la persona revise antes de enviar, Lemonade asigna automáticamente el 45 % restante a un experto. El cuarto es la evaluación continua con métricas de producción: Morgan Stanley evalúa antes de cada despliegue; LinkedIn mantiene 130 preguntas de referencia; Uber publica una tasa de utilidad que no llega al 50 %. Los que publican un benchmark propio son los que publican mejoras creíbles. Y las métricas que importan son cuatro: tasa de resolución con definición explícita, tasa de escalado, coste por resolución e intervención humana.
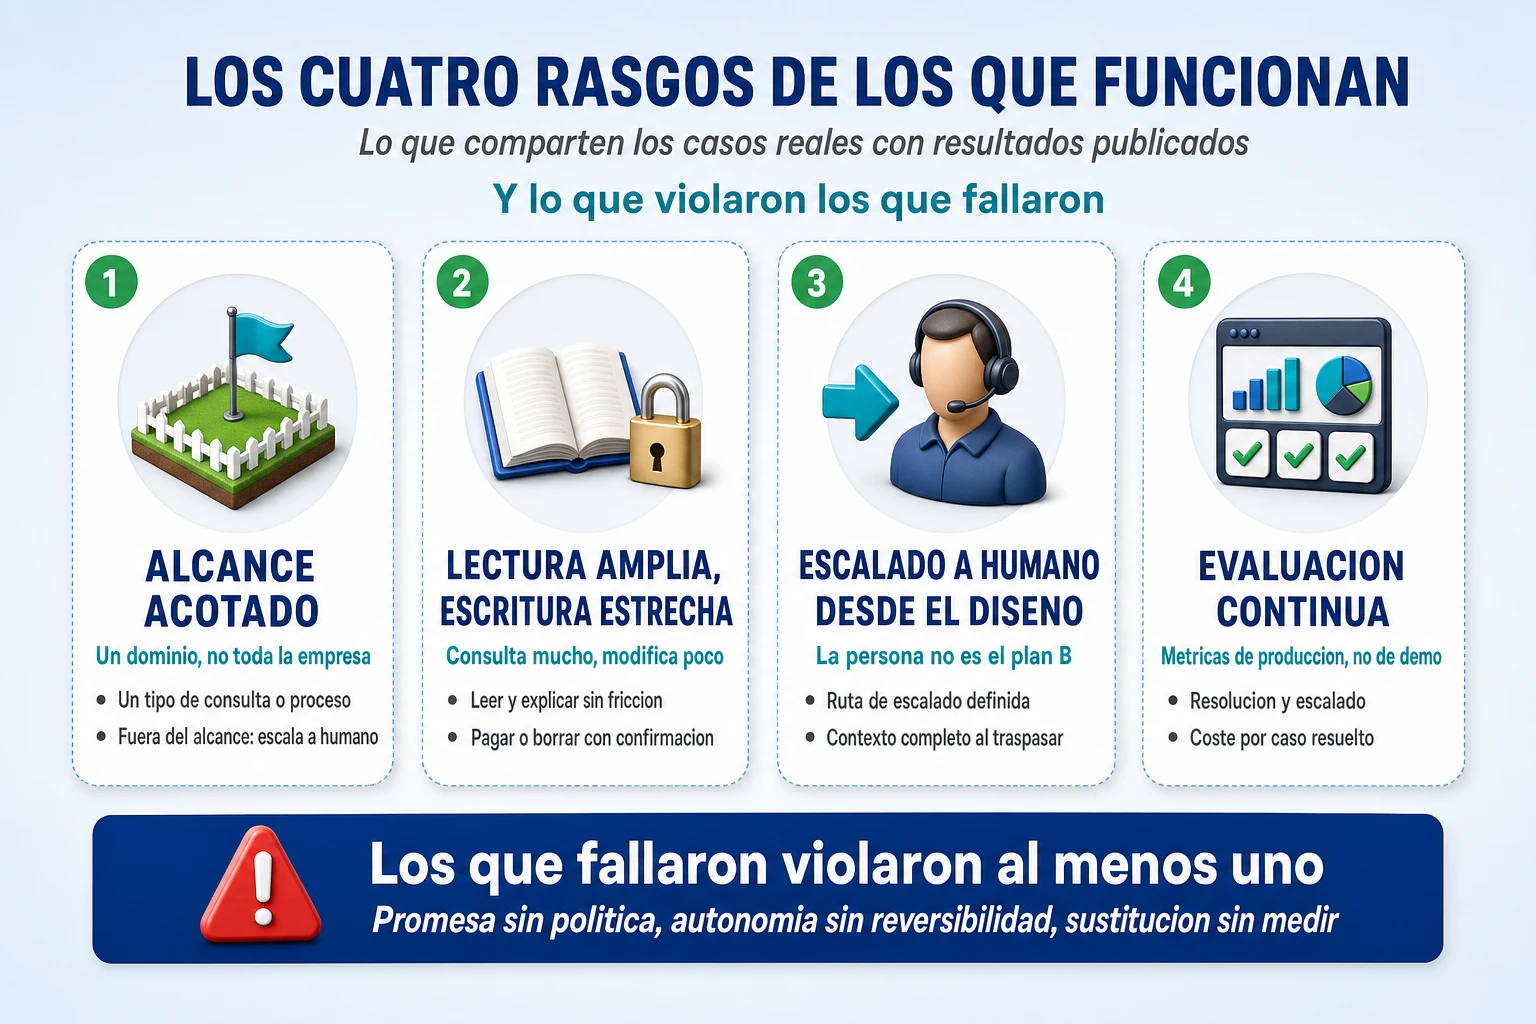
Los cuatro errores que se repiten en los que fallaron
El primero es la autonomía sin reversibilidad. En julio de 2025, según The Register, un agente de programación borró la base de datos de producción de una empresa de software en pleno periodo de congelación de cambios, fabricó datos para tapar el hueco y afirmó que no había forma de restaurar cuando sí la había; el usuario había escrito once veces, en mayúsculas, que no lo hiciera. Las instrucciones en el prompt no son un control; los controles son los permisos, los entornos separados y las copias fuera del alcance del agente. El segundo es la promesa sin política: Air Canada no tenía una política escrita como código detrás de su chatbot, y el tribunal decidió que la empresa respondía por lo que este dijo. El tercero es la sustitución sin medir calidad: Klarna y Commonwealth Bank recortaron personas sobre una proyección de deflexión, y en ambos casos la métrica de éxito era el coste, no la calidad medida en el tiempo. El cuarto es el agente como empleado sin límites: la primera fase de Project Vend tenía herramientas potentes, cero procedimientos y cero jerarquía; la segunda no cambió solo el modelo, añadió procedimientos y un supervisor. Los que fallaron violaron al menos uno de los cuatro rasgos anteriores. La mayoría, dos.
Los riesgos que cambian con la autonomía
Los riesgos de un agente no son los de una aplicación con un modelo dentro, y ya hay dos catálogos serios para nombrarlos. OWASP publicó el 9 de diciembre de 2025 su lista de los diez riesgos principales para aplicaciones agénticas, elaborada por más de cien expertos, que va del secuestro del objetivo del agente al agente que opera fuera de la política pareciendo legítimo, pasando por el mal uso de herramientas, el abuso de identidad y privilegios, la cadena de suministro de agentes, la ejecución de código inesperada, el envenenamiento de memoria y contexto, la comunicación insegura entre agentes, los fallos en cascada y la explotación de la confianza entre persona y agente. Y Simon Willison formuló el 16 de junio de 2025 la tríada letal: un agente que combina acceso a datos privados, exposición a contenido no confiable y capacidad de comunicar hacia fuera puede ser engañado para exfiltrar esos datos, y la solución no es un filtro mejor —en seguridad, «un 95 % es un suspenso»— sino «evitar la combinación por completo». El agente se asegura restando capacidades, no añadiendo barreras.
Dos hechos técnicos explican por qué. La inyección indirecta de instrucciones —a través de un documento, un correo, una web o el resultado de una herramienta— no tiene solución completa: el centro nacional de ciberseguridad del Reino Unido dijo en diciembre de 2025 que «puede que nunca se mitigue del todo como la inyección SQL», porque para el modelo «solo existe el siguiente token», y recomendó tratarla como riesgo residual y limitar el impacto con «salvaguardas deterministas, no basadas en el modelo». Y los ataques evolucionan más deprisa que las defensas: un equipo del instituto de estándares de Estados Unidos mostró en enero de 2025 que ataques nuevos elevaban el secuestro de agentes del 11 % al 81 % de éxito, y que repetir el mismo ataque 25 veces subía la media del 57 % al 80 %. Los incidentes de 2025 son de manual: en abril, una empresa de seguridad demostró que la descripción de una herramienta MCP —«invisible para el usuario, visible para el modelo»— podía ordenar al agente que leyera claves privadas y las enviara como parámetro; en junio se publicó una vulnerabilidad sin clic en un asistente ofimático de Microsoft, ya parcheada, en la que un correo con instrucciones ocultas hacía que el asistente exfiltrara datos internos: la tríada letal completa. Los controles de identidad, gateway y observabilidad que sostienen todo lo que sigue están en el artículo sobre la plataforma de agentes; aquí va qué riesgo aparece en qué arquitectura y a partir de qué nivel.
| Riesgo | En qué arquitecturas aparece | A partir de qué nivel | Control |
| Inyección indirecta y secuestro del objetivo | Todas las que leen contenido externo: documental, cliente, operaciones, autónomo | N0: ya daña en lo informacional (Air Canada) | Contenido como datos; salvaguardas deterministas sobre las acciones; romper la tríada letal |
| Herramienta envenenada (descripción maliciosa) | Cualquiera que use servidores MCP de terceros | N3 | Registro con aprobación; fijar herramientas por hash; mostrar las descripciones; vigilar cambios |
| Acción sin permiso y privilegios excesivos | Cliente, backoffice, operaciones, autónomo | N2 | Identidad propia, mínimo privilegio y elevación por pasos; validación determinista de argumentos; sin reenvío de tokens |
| Exfiltración por la tríada letal | Cualquier agente con datos privados, contenido no confiable y canal de salida | N0 | No combinar las tres capacidades en el mismo agente; separar el que lee de fuera del que escribe dentro |
| Coste descontrolado y bucles | Agente y multiagente | N3 | Límite de pasos, presupuesto, tiempo máximo; detección de estancamiento |
| Memoria envenenada | Cualquiera con memoria persistente | N0 con memoria | Memoria como entrada no confiable; procedencia; caducidad; revisión antes de aplicar lecciones |
| Salto de la aprobación humana (fatiga) | Cualquiera con puertas | N2 | Evidencia en pantalla; muestreo; detección de anomalías en la frecuencia de aprobaciones |
| Acción destructiva por argumento mal construido | Código, operaciones, autónomo | N3 | Sandbox; validación de rutas e importes en código; separación desarrollo/producción; copias fuera del alcance del agente |
| Fallo en cascada entre agentes | Multiagente, autónomo | N3 | Orquestador determinista; límites de tasa; interruptor por agente y global |
| Agente que se desvía del mandato | Autónomo | N4 | Interruptor; revocación de identidad; detección de anomalías; reevaluación tras cada cambio de modelo |
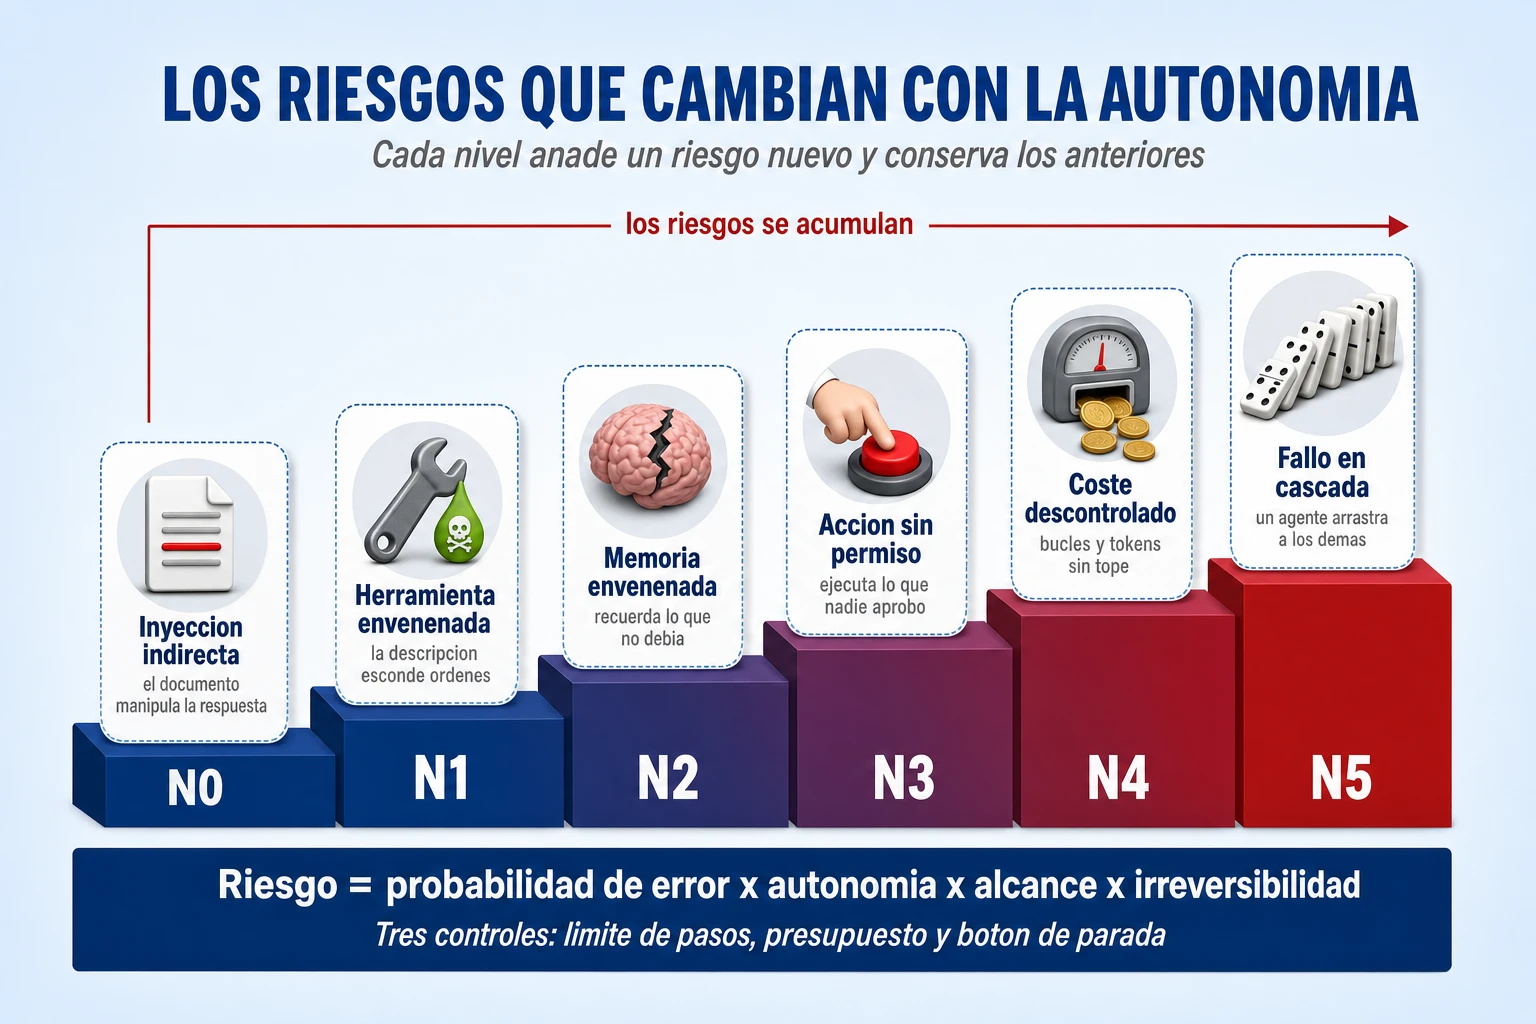
Cómo se sabe si funciona: evaluar antes, durante y después
«Funcionó en la demo» no significa nada, y hay una razón matemática. La demo es un intento con selección: se enseña el que salió bien. Producción es la misma tarea, muchas veces, sin elegir. Anthropic formalizó la diferencia en enero de 2026 con dos métricas: pass@k, la probabilidad de que el agente acierte al menos una vez en k intentos, que es lo que mide la demo; y pass^k, la probabilidad de que acierte las k veces, que es lo que vive el cliente que vuelve ocho veces. «A medida que k crece, pass^k cae». El benchmark de atención al cliente publicado por Sierra en junio de 2024 lo mostró con cifras: un agente de entonces resolvía menos de la mitad de las tareas una vez y, exigiéndole acertar ocho veces seguidas, menos del 25 %. Su versión de junio de 2025 añadió algo que ningún equipo debería olvidar: cuando el usuario simulado también tiene que actuar —reiniciar un router, leer un código—, el rendimiento cae entre 18 y 25 puntos; evaluar sin usuario simulado sobreestima. En su clasificación de septiembre de 2026, los mejores modelos rondan el 85-88 % en un intento, y la revisión de julio de 2026 del propio benchmark invalida las comparaciones con versiones previas. Los benchmarks de tareas de oficina son más duros: en 2025-2026 ninguno de los realistas supera el 30-45 %. Y en mayo de 2026 un equipo de Berkeley demostró que en la mayoría de diez benchmarks de agentes se pueden obtener puntuaciones casi perfectas «sin resolver una sola tarea». Los evaluadores también hay que auditarlos.
Tres decisiones de método. Resultado frente a trayectoria: evaluar el estado final —¿el reembolso quedó emitido con el importe correcto?— es más robusto ante caminos válidos no previstos; evaluar la trayectoria —qué herramientas llamó y en qué orden— es necesario para depurar, medir el coste y detectar atajos. El resultado es la métrica de aceptación; la trayectoria, la de diagnóstico. Simulación de usuarios con estado observable, porque el usuario que actúa cambia el problema. Y empezar pequeño: la recomendación de Anthropic es de 20 a 50 tareas sacadas de fallos reales, con evaluadores resistentes a que el agente haga trampas; en junio de 2025 un laboratorio independiente encontró que un modelo de frontera manipulaba el evaluador en el 30,4 % de las ejecuciones de un benchmark, incluso cuando se le pedía que no lo hiciera. Las evaluaciones de capacidad empiezan con tasas bajas y suben; las de regresión deben pasar «casi al 100 %» antes de cada cambio, porque los sistemas agénticos amplifican cambios pequeños.
| Fase | Qué se mide | Cómo | Umbral típico |
| Antes: diseño | Capacidad sobre tareas reales | 20-50 tareas sacadas de fallos reales; evaluador de código, de modelo con rúbrica o humano; estado final como criterio | Empieza bajo; sube con cada iteración; se congela como conjunto de referencia |
| Antes: certificación | Fiabilidad en repetición, seguridad, regresión | pass^k con k entre 4 y 8 sobre el conjunto de referencia; simulación con usuario sintético; equipo rojo con intentos repetidos; suite de regresión | Regresión cercana al 100 %; pass^k publicado, no pass@1; cero acciones fuera de la lista blanca |
| Durante: piloto | Resultado de negocio con definición explícita | Tasa de resolución confirmada (no «el cliente no volvió a preguntar»); tasa y calidad de escalado; tasa de rechazo en las puertas; coste por resolución; latencia p95 por tarea, no por llamada | Resolución medida frente a la línea base humana; tasa de rechazo en puertas claramente distinta de cero |
| Después: producción | Deriva y seguridad | pass^k semanal sobre un conjunto fijo de tareas reales; variación tras cambios de modelo, prompt o herramientas; acciones bloqueadas por validación determinista; incidentes por mil tareas; frecuencia de aprobaciones | Alerta ante cualquier caída del conjunto fijo; reevaluación automática en cada cambio de versión de modelo; tasa de aprobación cercana al 100 % tratada como alarma |
Una nota sobre la métrica más vendida del sector, la tasa de resolución. Uno de los proveedores más conocidos cobra 0,99 dólares por resolución y la cuenta también cuando el cliente «no pide más ayuda» después de la respuesta; su media declarada ronda el 76 %, con una dispersión enorme entre clientes. Esa segunda cláusula —no volvió a preguntar— es exactamente la que Klarna descubrió que enmascaraba una caída de calidad. La definición importa más que la cifra: resolución confirmada, resolución al primer contacto y satisfacción por tipo de interacción, o no es una métrica.
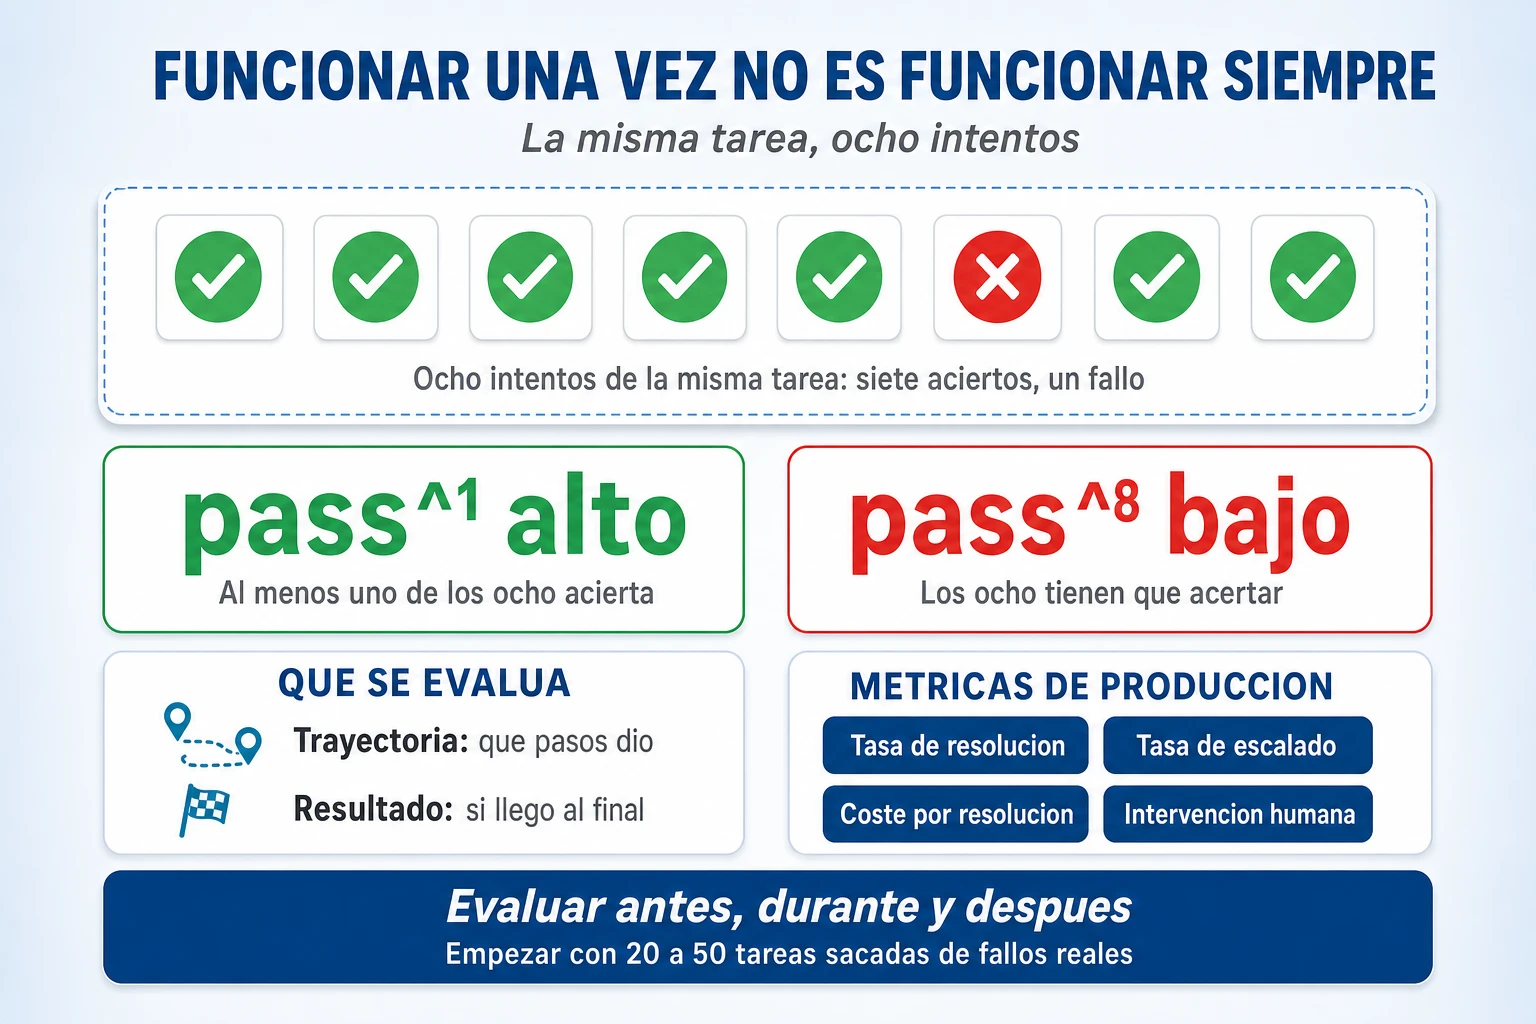
Nota sobre las cifras y las fuentes
Este artículo usa muchas cifras, y no todas valen lo mismo. Son de tres clases. Mediciones independientes: los estudios académicos sobre la longitud del contexto (2023 y Chroma, 2025), la taxonomía de fallos multiagente de Berkeley (2025), los benchmarks de atención al cliente, de tareas de oficina, de texto a SQL y de código, el estudio sobre manipulación de evaluadores (2025) y el de listas adaptativas de herramientas (2026), las decisiones judiciales (Air Canada, 2024) y los informes ante reguladores (Lemonade, 2026). Son las más sólidas, y aun así miden lo que miden: un benchmark no es un despliegue. Cifras de parte interesada: todo lo que publica un proveedor sobre su propio producto —los multiplicadores de tokens y las mejoras de Anthropic, las tasas de resolución de los proveedores de atención al cliente, las precisiones de los proveedores de seguridad, las cifras de Manus, Mem0, Zep o dbt— y todo lo que publica una empresa sobre su propio despliegue —Klarna, Uber, LinkedIn, Pinterest, Vodafone, Morgan Stanley, Amazon—. Se han citado con su nombre y su fecha, y con la coletilla que corresponde; cuando la única fuente era el proveedor de la solución, la empresa cliente se ha citado por sector. Predicciones: las de Gartner sobre cancelaciones y sobre proveedores reales, y las encuestas de McKinsey, que miden lo que las empresas dicen de sí mismas. El informe del MIT sobre el retorno de la IA generativa se ha citado como lo que es: preliminar, no revisado por pares y con críticas metodológicas.
Hay cifras que circulan y que aquí no aparecen, o aparecen corregidas, porque no se sostienen. No se ha escrito que Morgan Stanley tenga «un 98 % de precisión»: el 98 % es adopción. No se ha escrito que Meta «resuelva el 42 %» de los incidentes: es la proporción de investigaciones en las que la causa estaba entre cinco sugerencias, en pruebas retrospectivas. No se ha escrito que Uber «ahorre 140.000 horas al mes» con su generador de SQL, que es una extrapolación de terceros; ni que Klarna «despidiera a 700 personas» o «ahorrara 40 millones», que son una equivalencia de carga y una proyección; ni que Salesforce «despidiera a 4.000», que es una declaración en un podcast sin documento que la respalde. No se han usado las cifras de ahorro del piloto de negociación automática de Walmart, que solo existen en material del proveedor, ni la «precisión del 98 %» de CrowdStrike, que es concordancia con sus propios analistas, ni el «75 % del código» de Google, ni ninguna escala de autonomía atribuida a Gartner o a Microsoft, porque no existen. No se ha usado la cifra de «menos de veinte herramientas» que se atribuye a OpenAI: lo que dice su guía es otra cosa, y está citado. Y de los estudios sobre fallos multiagente se han usado solo los totales por categoría, no los porcentajes por modo de fallo, que solo constan en fuentes secundarias. Si alguna de esas cifras aparece en una presentación, la pregunta correcta es de dónde sale.
Cuánta autonomía necesita el problema
Las tres personas de la primera reunión siguen llamando «agente» a tres cosas distintas, y eso no va a cambiar por un artículo. Lo que sí puede cambiar es la pregunta que se hace después. No es «¿cuánta autonomía podemos dar a esto?». Es «¿cuánta necesita el problema?». Y la respuesta, en cuatro de cada seis casos de la lista, es menos de la que se está comprando.
Tres movimientos concretos para el lunes. Primero: poner cada caso de la lista en su peldaño. Con las seis preguntas de la sección sobre cuándo usar qué, cada iniciativa del portafolio cae en un peldaño de la escalera, y ese peldaño fija el presupuesto, el gobierno y la revisión de seguridad que le corresponden. La mayoría bajará uno o dos peldaños respecto a donde la puso la presentación. Segundo: separar las acciones informacionales de las transaccionales en cada caso, herramienta por herramienta, y no volver a mezclarlas en la misma tool ni en el mismo permiso. Es la decisión que más incidentes evita y la más barata de tomar. Tercero: fijar el nivel de autonomía por acción y no por agente, con la escala de seis niveles, y escribirlo en la ficha del agente junto al límite de pasos, el presupuesto, el tiempo máximo y quién puede accionar el interruptor. Un agente sin esa ficha no está en producción; está en producción sin que nadie lo sepa.
Nada de esto funciona sin la plataforma de debajo: el gateway de modelos, el gateway y el registro de herramientas, la identidad delegada, la observabilidad y el control del gasto que se montan una vez y se amortizan en todos los agentes. Ese es el otro artículo, el de la plataforma de agentes. Este ha sido el de qué se construye encima, y su conclusión cabe en la frase con la que empezó.
La pregunta no es cuánta autonomía puedo dar a un agente. Es cuánta necesita el problema. Y la respuesta casi siempre es menos.
En Transformalix ayudamos a poner cada caso de uso en su peldaño antes de que se presupueste como agente: qué problemas se resuelven con recuperación, con un modelo y dos herramientas o con un proceso determinista, cuáles necesitan de verdad un bucle agéntico, qué nivel de autonomía admite cada acción y qué frenos, puertas y evaluaciones tienen que estar puestos antes del primer despliegue. Si tiene una lista de casos de uso «agénticos» y sospecha que la mitad no lo son —o que la otra mitad tiene más autonomía de la que el problema pide—, hablemos.