A las ocho de la tarde del viernes 17 de marzo de 2000, un rayo cayó sobre una línea eléctrica de Nuevo México y provocó un incendio en la planta de semiconductores que Philips tenía en Albuquerque. Los trabajadores lo apagaron en unos diez minutos. El fuego apenas destruyó nada, pero el humo entró en la sala blanca y el agua de los rociadores hizo el resto, y la planta tardó semanas en volver a producir con normalidad. De aquella fábrica salían los chips de radiofrecuencia de los teléfonos de Nokia y de Ericsson, que entonces se repartían buena parte del mercado mundial de móviles.
Philips avisó a las dos empresas el mismo día, el lunes 20 de marzo. Lo que pasó después es la historia que abre el libro de Yossi Sheffi. Nokia puso los componentes afectados bajo vigilancia diaria, mandó un equipo de unas treinta personas, se aseguró la capacidad de otras fábricas de Philips y de otros proveedores, y rediseñó algunos chips para poder fabricarlos en otro sitio. Ericsson, que años antes había eliminado sus proveedores de respaldo para ahorrar costes, tardó semanas en entender lo que tenía delante. Nokia cumplió sus objetivos de producción y ganó cuota; Ericsson calculó en al menos 400 millones de dólares las ventas perdidas y, menos de un año después, dejó de fabricar sus propios teléfonos.
Veintiséis años después, la amenaza que preocupa a muchas empresas no es un incendio. Un chip de memoria DDR5 de 16 gigabits, de los que llevan los ordenadores y los servidores, costaba 4,89 dólares en el mercado al contado en octubre de 2024 y 61,27 dólares en octubre de 2026. La Raspberry Pi 5 con 16 gigabytes, un pequeño ordenador que se usa en miles de empresas para automatizar máquinas y procesos, ha pasado de 120 a 305 dólares en diez meses. No ha ardido ninguna fábrica: los fabricantes de memoria han dedicado su capacidad a los centros de datos de inteligencia artificial, que pagan más, y el comprador pequeño ha perdido la subasta. Los fabricantes de ordenadores han subido precios, los proveedores europeos de nube también, y las previsiones más serias no esperan precios normales antes de 2028.
Las dos situaciones se parecen más de lo que parece. En las dos, una empresa descubre que depende de algo que no controla, que su cadena de suministro tiene un punto por el que, si falla, falla todo, y que la diferencia entre salir dañada o salir reforzada se decidió antes de la crisis. Esa es la tesis de La empresa robusta (The Resilient Enterprise, MIT Press, 2005): la suerte de una empresa ante una disrupción grave depende más de las decisiones que tomó antes que de lo que haga en medio de ella. Y la más importante de esas decisiones no es acumular reservas, sino diseñar la empresa para que sea flexible, porque la flexibilidad, a diferencia del inventario de seguridad, también mejora el negocio cuando no pasa nada.
Este artículo ordena los conceptos del libro, los pone a prueba con los casos que cuenta Sheffi y con los que han venido después, y los aplica al momento actual y a una empresa de 30 a 100 personas. Está pensado para leerse a tres niveles. El resumen ejecutivo, justo después del índice, cuenta en unos minutos las ideas y lo que conviene hacer con ellas. El desarrollo explica cada concepto con su ejemplo, recorre más de veinte casos y analiza la crisis de la memoria de 2025-2026. Y al final quedan un método de noventa días, las preguntas para la próxima reunión de dirección, un glosario y la bibliografía, ordenada por temas.
Las ideas de La empresa robusta y qué hacer con ellas en 2026
Yossi Sheffi, director del Centro de Transporte y Logística del MIT, publicó The Resilient Enterprise en 2005, dos semanas después de que el huracán Katrina arrasara Nueva Orleans. El libro, traducido en España como La empresa robusta, parte de una observación: las empresas que mejor resisten una disrupción grave no son las que la vieron venir, sino las que estaban diseñadas para absorberla. Esa capacidad de recuperarse, que Sheffi llama resiliencia, se construye antes de la crisis y se apoya mucho más en la flexibilidad que en las reservas.
El razonamiento sigue cuatro pasos. El primero es entender la vulnerabilidad: qué puede fallar, con qué probabilidad y con qué consecuencias, y colocar cada amenaza en un mapa de dos ejes para decidir dónde poner la atención. El segundo es reducir la probabilidad de las disrupciones con seguridad en capas, colaboración con socios y, sobre todo, detección temprana. El tercero es construir resiliencia, por dos vías: la redundancia, que consiste en tener reservas de inventario, capacidad o proveedores, y la flexibilidad, que consiste en poder mover la producción, las personas y los pedidos de un sitio a otro. Y el cuarto es convertir esa capacidad en ventaja competitiva, porque quien se recupera antes se queda con los clientes de quien tarda.
La aportación más útil del libro es la comparación entre esas dos vías. La redundancia es una prima de seguro: cuesta todos los días y solo rinde el día del desastre. La flexibilidad se consigue con piezas, procesos y plantas estandarizadas, con productos que se terminan de definir lo más tarde posible, con personas capaces de cubrir más de un puesto, con relaciones profundas con los proveedores críticos y con una cultura que deja actuar a quien está cerca del problema. Y la flexibilidad rinde también cuando no hay crisis, porque las mismas capacidades sirven para atender los vaivenes normales de la demanda. Sheffi no rechaza la redundancia, que sigue siendo la única defensa ante algunos riesgos, pero sostiene que es la palanca más cara y la menos útil.
Toda disrupción sigue además un perfil reconocible de ocho fases, desde la preparación hasta el impacto a largo plazo. Lo más importante del perfil es que el golpe completo suele llegar con retraso, mientras se agotan los inventarios intermedios, y ese margen es justo el que aprovecharon Nokia en 2000 y Dell tras el terremoto de Taiwán de 1999. Diez años después, en El poder de la resiliencia (2015), Sheffi añadió una tercera dimensión a la probabilidad y al impacto: el margen de aviso con el que se detecta una disrupción.
Los casos posteriores al libro le han dado la razón en lo esencial. Toyota, que tras el terremoto de 2011 mapeó a sus proveedores hasta el tercer nivel y pidió reservas de chips de dos a seis meses, aguantó la escasez de 2021 durante meses mientras otros paraban, aunque acabó recortando su producción un 40 % en septiembre de 2021. Tesla, con su software propio, sustituyó chips y reescribió el firmware «en cuestión de semanas». Baxter, con una sola planta que fabricaba en torno al 60 % del suero intravenoso de Estados Unidos, recuperó la producción en cinco meses tras el huracán Helene, pero sus clientes vivieron casi ocho meses de racionamiento. Y los ciberataques que pararon Jaguar Land Rover durante más de cinco semanas en 2025 mostraron una vulnerabilidad que el libro no podía prever: el punto único de fallo de muchas empresas ya no es una fábrica, sino un sistema informático.
La crisis de la memoria de 2025-2026 es la última versión de la misma lección. El precio de contrato de la memoria DRAM convencional subió entre un 93 % y un 98 % en un solo trimestre, el primero de 2026, según TrendForce, y a finales de este año será del orden de seis veces el de finales de 2024. La causa no es un accidente, sino que la capacidad se ha ido a la inteligencia artificial. Las respuestas empresariales encajan una a una en las palancas de Sheffi: Lenovo acumuló inventario, los grandes compradores firmaron contratos de tres a cinco años con anticipos, NVIDIA redujo la memoria de sus diseños y los fabricantes de móviles empujaron a sus clientes hacia los modelos que podían servir. La pyme, que compra al final de la cadena y sin contrato largo, es la que soporta las subidas más fuertes, y sus mejores palancas son especificar por necesidad real, estandarizar equipos, adelantar compras críticas sin acaparar y apoyarse en un distribuidor o un proveedor de nube que sí tenga asignación.
Para una empresa de 30 a 100 personas, el artículo propone un método de noventa días en cinco pasos: mapear las dependencias por pieza, persona y sistema; medir para cada una cuánto tardaría en recuperarse y cuánto aguanta la empresa sin ella; decidir en cada caso entre redundancia y flexibilidad; ensayar con un ejercicio de mesa y restaurando una copia de verdad; y vigilar con un registro de casi incidentes y una revisión trimestral. La regla que lo ordena todo procede del trabajo de David Simchi-Levi en el MIT con Ford: hay que actuar donde el tiempo de recuperación supera al tiempo de supervivencia, y ordenar los riesgos por su impacto, no por lo que se gasta con cada proveedor, porque los que más daño pueden hacer suelen ser proveedores pequeños.
Yossi Sheffi y La empresa robusta: quién es el autor, de qué trata el libro y por qué vuelve a ser actual
Yossi Sheffi es catedrático del MIT, donde dirige desde hace décadas el Center for Transportation & Logistics, uno de los centros de referencia mundial en cadena de suministro. No es un teórico alejado de las empresas: ha fundado cinco compañías de software y consultoría logística, y creó la red de centros asociados del MIT que incluye el Zaragoza Logistics Center, motivo por el que la Universidad de Zaragoza le nombró doctor honoris causa en 2010. Esa doble condición de académico y empresario se nota en el libro, que está hecho de casos con nombre propio y de conversaciones con directivos más que de modelos matemáticos.
El libro nació de un proyecto de investigación que el MIT puso en marcha en 2002, financiado por el Gobierno británico y motivado por los atentados del 11 de septiembre. Durante cuatro años, el equipo de Sheffi estudió a 35 empresas asociadas al centro y a otras que habían sufrido disrupciones graves, con entrevistas, encuestas y seis conferencias en Estados Unidos y el Reino Unido. El resultado, publicado por MIT Press en septiembre de 2005, tiene 338 páginas organizadas en cinco partes: cómo y por qué fallan las cosas, un manual básico de cadena de suministro, cómo reducir la vulnerabilidad, cómo construir flexibilidad y cómo convertir la resiliencia en ventaja competitiva. Fue elegido libro de empresa del año 2005 por la revista ForeWord y se tradujo a siete idiomas; la edición española la publicó LID Editorial en 2006, en traducción de José Miguel Aguilar.
Conviene detenerse un momento en el título español, porque induce a un pequeño error. En el lenguaje de la gestión de riesgos, robustez y resiliencia no son lo mismo: un sistema robusto resiste el golpe sin deformarse, y uno resiliente se deforma y se recupera. Sheffi habla de lo segundo, de «la capacidad de recuperarse» (the ability to bounce back), y por eso el libro no promete empresas a las que nunca les pase nada, sino empresas que vuelven antes a funcionar. En este artículo se usa «resiliencia» en ese sentido y «la empresa robusta» como título del libro.
Las ideas del libro tampoco salieron de la nada, y es útil verlas evolucionar. En 2001, tras los atentados, Sheffi publicó un artículo sobre la cadena de suministro ante el terrorismo en el que la respuesta principal era añadir redundancias. Cuatro años de casos después, su conclusión había cambiado: la redundancia «tiene una utilidad limitada» y lo esencial es la flexibilidad y la cultura, como escribió en el resumen del libro que publicó en octubre de 2005. Ese mismo otoño apareció en MIT Sloan Management Review el artículo «A Supply Chain View of the Resilient Enterprise», firmado con James Rice, que condensa el libro con los mismos casos y que es hoy una de las referencias más citadas del campo.
Sheffi siguió trabajando el tema. En 2015 publicó The Power of Resilience (El poder de la resiliencia), la secuela, escrita a petición de varias empresas tras el terremoto de Japón y las inundaciones de Tailandia de 2011. Ese segundo libro añade lo que el primero no cubría: los riesgos en los niveles profundos de la cadena, la detección como dimensión propia, el ciberriesgo, la escasez de materias primas y los choques de precios, los riesgos de reputación y los riesgos sistémicos. Después vinieron un libro sobre la pandemia, The New (Ab)Normal (2020), y The Magic Conveyor Belt (2023), en el que defiende que las cadenas de suministro funcionaron mejor de lo que se dijo durante la COVID-19. En este artículo se cita la secuela cuando aporta algo que el libro de 2005 no tenía, y se dice siempre de cuál de los dos procede cada idea.
¿Por qué volver a un libro de hace veinte años? Porque cada gran disrupción desde entonces ha repetido sus lecciones, y porque 2026 está siendo un año de manual: la escasez de memoria, los precios de los procesadores, los desvíos de buques que duran ya casi tres años, los controles a la exportación de tierras raras y de chips, y una cadena de ciberataques que ha parado fábricas y cadenas de tiendas. Y porque el libro, a diferencia de buena parte de la literatura de continuidad de negocio, no plantea la resiliencia como un gasto defensivo que hay que justificar, sino como una forma de dirigir la empresa que también la hace mejor cuando no pasa nada.
La paradoja de la eficiencia: por qué una cadena de suministro ajustada concentra el riesgo
Durante las décadas anteriores al libro, las empresas industriales hicieron casi siempre lo mismo para ser más competitivas: reducir inventarios, trabajar con menos proveedores, concentrar la producción en menos plantas y la distribución en menos almacenes, y ajustar la capacidad a la demanda. Todas esas decisiones tenían sentido y casi todas mejoraron la rentabilidad. El problema es que cada una de ellas eliminaba un colchón que, sin que nadie lo hubiera decidido, también protegía a la empresa frente a lo imprevisto.
El caso de Ericsson lo muestra con claridad. A mediados de los años noventa, la empresa simplificó su cadena de suministro y eliminó los proveedores de respaldo para ahorrar costes. Cuando ardió la planta de Albuquerque, según contó el reportaje del Wall Street Journal que reconstruyó el caso, muchos de sus directivos eran nuevos en el puesto y ni siquiera sabían que la empresa dependía de un solo proveedor para aquellos chips. «No teníamos un plan B», reconoció su director de marketing de consumo. La vulnerabilidad no estaba escondida por descuido: estaba escondida dentro de una decisión de eficiencia que había funcionado bien durante años.
Sheffi y Rice dan otros ejemplos del mismo mecanismo. Tras el 11 de septiembre, Estados Unidos cerró fronteras y espacio aéreo, y Ford tuvo que parar varias líneas de montaje de forma intermitente porque los camiones con piezas de Canadá y México se acumulaban en la frontera: su producción del cuarto trimestre de 2001 fue un 13 % inferior a la planificada sin que ninguna de sus fábricas sufriera un rasguño. Toyota estuvo a pocas horas de parar su planta de Indiana esperando unos sensores que llegaban en avión desde Alemania. Una cadena justo a tiempo (just in time), diseñada para que no sobre nada, tampoco tiene margen para que falte algo.
¿Quiere eso decir que la producción ajustada es el problema? Sheffi responde que no, y el matiz importa. En su opinión, la redundancia es justo lo que destruye la eficiencia que buscan el sistema de producción de Toyota, el lean o Six Sigma, y volver del «justo a tiempo» al «por si acaso» llenaría las empresas de inventario, de capacidad ociosa y de descuido. Lo que propone es otra forma de protegerse que sea compatible con la eficiencia: la flexibilidad. Toyota, que es el modelo del lean, es también uno de los ejemplos favoritos del libro de empresa resiliente, como se cuenta en el artículo del blog sobre cómo Toyota construyó una ventaja competitiva basada en sistemas.
¿Cuánto cuesta una disrupción cuando llega? La mejor medición de la época es la serie de estudios de Kevin Hendricks y Vinod Singhal sobre cientos de empresas cotizadas estadounidenses que anunciaron problemas de suministro entre 1989 y 2000. En los días del anuncio, el valor de la acción caía de media un 10,3 % más que el de empresas comparables, y en los tres años que van de uno antes a dos después del anuncio, la diferencia acumulada se acercaba al 40 %. Las empresas no se recuperaban pronto: dos años después seguían por debajo de sus comparables en beneficio operativo, ventas y costes, y daba igual quién hubiera causado el problema o de qué sector fuera la empresa.
Esas cifras hay que leerlas con cuidado. Son empresas cotizadas que hicieron público su problema, así que reflejan disrupciones graves, y son de hace más de veinte años: una réplica con datos de 2001 a 2012 encontró un efecto medio en bolsa mucho menor, del 1,9 %, quizá porque los inversores se han acostumbrado a este tipo de noticias. Lo que sí resiste el paso del tiempo es la conclusión más útil para una pyme: el daño de una disrupción no es un bache de un trimestre, sino un deterioro que dura años y que no se recupera solo. Y un estudio posterior de los mismos autores encontró que las empresas con más holgura operativa en su cadena salían menos castigadas, lo que confirma que algo de colchón sí ayuda.
Los conceptos de Sheffi de un vistazo: vulnerabilidad, perfil de la disrupción, redundancia, flexibilidad y cultura
Antes de entrar en cada concepto conviene ver el conjunto, porque el libro tiene una arquitectura muy clara que la divulgación suele perder. Sheffi recorre un camino en cuatro etapas: entender la vulnerabilidad, reducir la probabilidad de que algo falle, construir capacidad para recuperarse y convertir esa capacidad en ventaja competitiva. Las cinco partes del libro siguen exactamente ese orden, con un manual básico de cadena de suministro intercalado para los lectores que no son especialistas.
Dentro de ese camino, la pieza central es la tercera etapa, y en ella la elección entre redundancia y flexibilidad. Sheffi dedica a la redundancia un solo capítulo y a la flexibilidad cinco: la intercambiabilidad de plantas, piezas y personas; el aplazamiento de la diferenciación del producto; las estrategias de aprovisionamiento flexible; la gestión de la relación con el cliente, y la cultura. La proporción ya dice lo que piensa el autor: la redundancia es necesaria a veces, pero la resiliencia de verdad se construye con flexibilidad. Y a lo largo de todo el recorrido aparece una herramienta para entender el tiempo, el perfil de la disrupción en ocho fases.
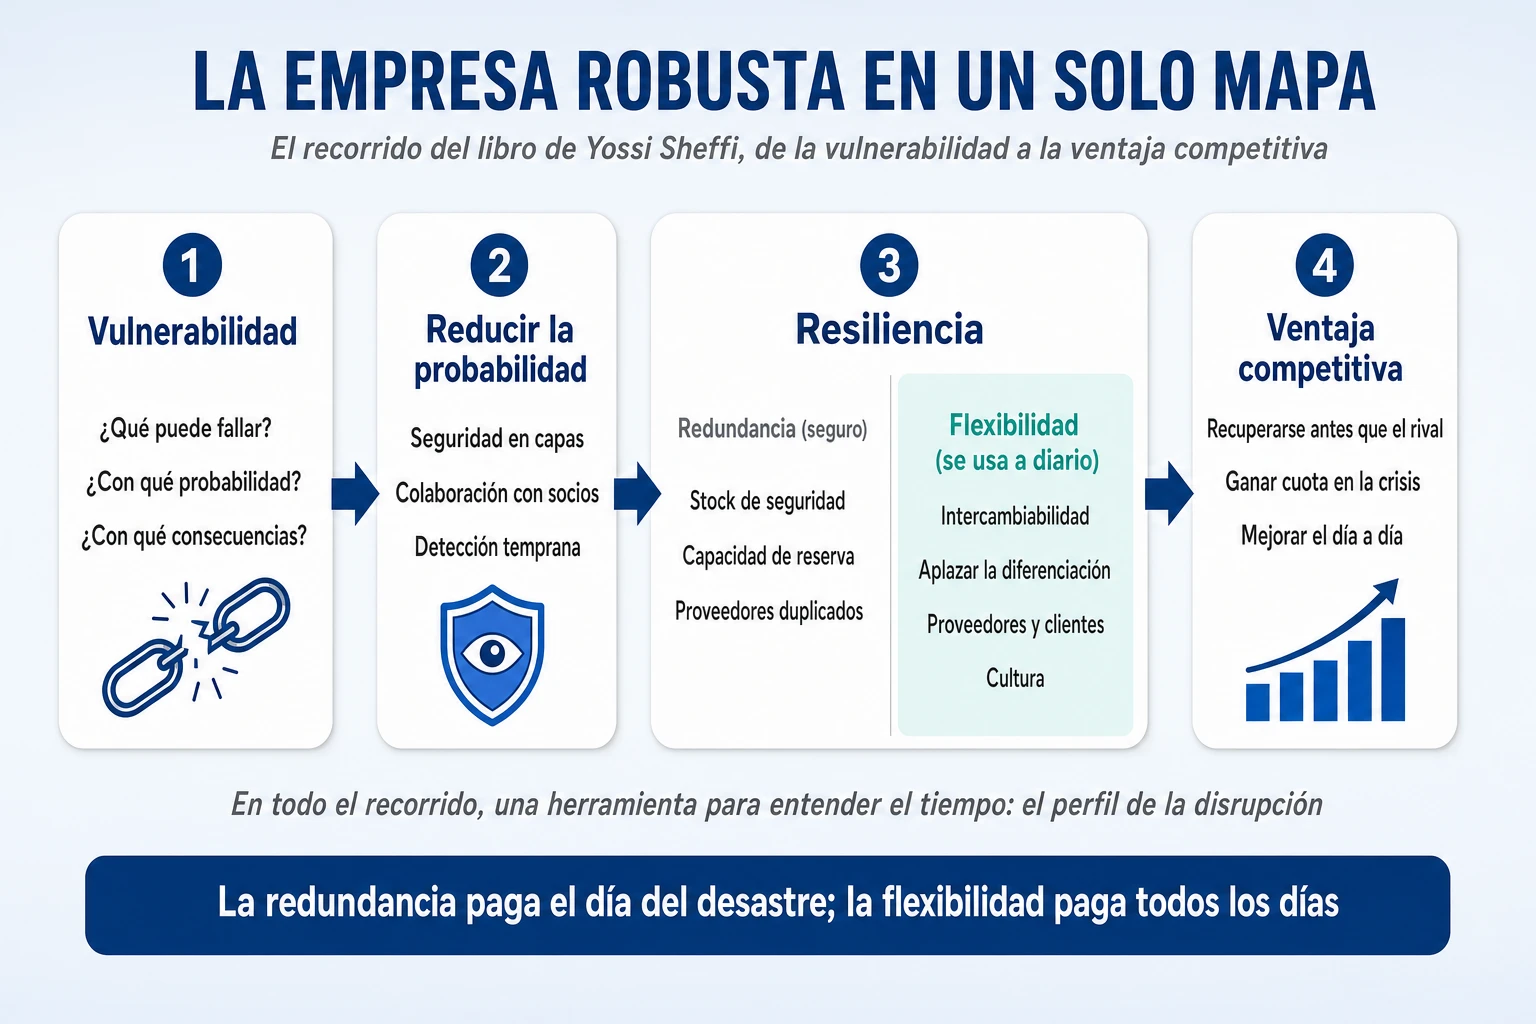
La tabla siguiente sirve de mapa para el resto del artículo. Cada concepto aparece con la pregunta de dirección que ayuda a responder y con la herramienta o el caso que mejor lo ilustra. Los nombres en inglés van entre paréntesis porque son los que permiten buscar más información, y al final del artículo hay un glosario con todos ellos.
| Concepto | Pregunta que ayuda a responder | Herramienta o caso de referencia |
| Mapa de vulnerabilidad (vulnerability map) | ¿Qué amenazas merecen atención y preparación fuera de la rutina? | Dos ejes, probabilidad y consecuencias, revisados por amenaza |
| Perfil de la disrupción (disruption profile) | ¿Qué hay que decidir en cada momento de una crisis? | Ocho fases; el margen entre el evento y el impacto total |
| Detección y margen de aviso (detection lead time) | ¿Cuándo nos enteramos y cuánto tiempo tenemos para reaccionar? | Nokia en 2000; la tercera dimensión de la secuela de 2015 |
| Seguridad | ¿Cómo reducimos la probabilidad de las disrupciones intencionadas? | Defensas en capas, colaboración con aduanas y socios |
| Redundancia | ¿Qué reservas necesitamos y cuánto nos cuestan? | Stock de seguridad, capacidad de reserva, proveedores duplicados, copias de seguridad |
| Intercambiabilidad (interchangeability) | ¿Podemos mover la producción, las piezas o las personas de un sitio a otro? | Intel y sus fábricas idénticas; UPS en Louisville; Southwest |
| Aplazamiento de la diferenciación (postponement) | ¿Podemos esperar a conocer la demanda para terminar el producto? | Benetton, HP, Dell |
| Relación con proveedores | ¿Es coherente el número de proveedores con la profundidad de la relación? | Toyota y Aisin frente a Land Rover y UPF-Thompson |
| Gestión de la demanda (sell what you have) | ¿Podemos llevar al cliente hacia lo que sí podemos servir? | Dell frente a Apple en 1999 |
| Cultura de la flexibilidad | ¿Puede decidir quien está cerca del problema sin esperar autorización? | Nokia, Toyota, UPS, Southwest, la Marina de Estados Unidos |
| Ventaja competitiva | ¿Cómo convertimos la crisis en una oportunidad frente a la competencia? | Nokia gana cuota; los beneficios colaterales de la seguridad |
Un aviso sobre lo que circula del libro. En internet abundan resúmenes que le atribuyen «siete enseñanzas», «cinco pilares», un «dividendo de la resiliencia» o una «ecuación del valor de la flexibilidad». Ninguna de esas expresiones es de Sheffi. Las «cinco facetas de la flexibilidad» sí existen, en el artículo de 2005 con Rice, y son el aprovisionamiento, la transformación, la distribución y la relación con el cliente, los sistemas de control y la cultura; el «dividendo de la resiliencia» es el título de un libro de Judith Rodin de 2014 sobre ciudades. La idea que esos resúmenes intentan expresar sí es de Sheffi, y él la llama beneficio colateral: las inversiones en resiliencia que mejoran también el negocio diario.
Caso práctico: un fabricante de cuadros eléctricos de 60 personas que descubre sus puntos únicos de fallo
Para aplicar los conceptos a una empresa del tamaño del lector, el artículo sigue a una empresa ficticia. Es un fabricante de cuadros eléctricos y equipos de control para naves industriales y granjas, con 60 personas y unos 9 millones de euros de facturación, instalado en un polígono de Castellón. Diseña sus equipos, compra los componentes, monta los armarios, los cablea, programa los controladores y prueba cada equipo antes de enviarlo. Le va bien: tiene una cartera de clientes fiel, un plazo de entrega competitivo y un margen razonable.
A finales de 2025, su cliente más importante, una cooperativa agroalimentaria que supone el 34 % de su facturación, le envía un cuestionario de homologación de proveedores. Una de las preguntas dice: «Describa qué haría si su principal proveedor dejara de suministrarle mañana». El director general convoca al comité de dirección, cinco personas, para responderla, y la conversación tarda poco en incomodar. Al repasar de dónde viene cada cosa, el comité descubre cinco dependencias en las que nunca había pensado como riesgos:
- Las placas de control, el corazón de cada equipo, las monta un único subcontratista a 20 kilómetros. Trabajan juntos desde hace doce años, sin contrato escrito, y los utillajes de montaje, que pagó la empresa, están en la nave del subcontratista.
- Las pantallas táctiles y los módulos de comunicaciones, que llevan memoria y procesador, se compran a un distribuidor nacional que trae dos marcas.
- El banco de pruebas final solo sabe programarlo y mantenerlo una persona, Marta, la técnica que lo diseñó.
- El ERP, con pedidos, compras y fabricación, funciona en un servidor de la oficina, y la copia de seguridad se hace cada noche en un disco de red que está en la misma sala.
- Los armarios metálicos los fabrica un taller de chapa del mismo polígono, aunque en el polígono hay otros dos talleres que podrían hacerlos.
A esas cinco se suma la propia cooperativa: un cliente que pesa más de un tercio de las ventas es, también, un punto único de fallo. Y en enero de 2026 llega otra noticia, esta vez del distribuidor: los módulos de comunicaciones suben un 40 % y el plazo de entrega de las pantallas pasa de cuatro a dieciséis semanas, por la escasez de memoria. A lo largo del artículo, la empresa irá aplicando cada concepto de Sheffi a estas dependencias, y en el capítulo del método se verá qué decidió hacer con cada una.
Mapa de vulnerabilidad (vulnerability map): cómo priorizar los riesgos por probabilidad y consecuencias
El primer concepto del libro responde a una pregunta muy práctica: con recursos limitados, ¿de qué amenazas debe ocuparse la dirección? Sheffi y Rice parten de tres preguntas clásicas de la gestión de riesgos: qué puede salir mal, con qué probabilidad y con qué consecuencias si ocurre. Y añaden una distinción que suele olvidarse: no todas las disrupciones son del mismo tipo, y la probabilidad se estima de forma distinta en cada una.
Las disrupciones pueden ser sucesos aleatorios, como un terremoto o una inundación, cuya probabilidad se estima con datos históricos; accidentes, como un incendio o una avería grave, para los que hay estadísticas del sector y de la propia empresa; o disrupciones intencionadas, como un sabotaje, un ataque o un conflicto laboral. Estas últimas son las más difíciles, porque son amenazas adaptativas: quien las provoca busca el máximo daño y cambia de estrategia según lo que haga la empresa. Hoy, con los ciberataques, esta tercera clase se ha vuelto la más frecuente para muchas pymes.
Con esas tres preguntas, el libro propone colocar cada amenaza en un mapa de dos ejes: la probabilidad de que ocurra y la gravedad de sus consecuencias. Lo importante es que son dos ejes y no una multiplicación. Sheffi y Rice rechazan expresamente reducir la vulnerabilidad a una cifra del tipo «probabilidad por impacto», porque los factores son «demasiado variados y matizados, y las herramientas para medirlos demasiado toscas». El mapa no sirve para calcular, sino para ordenar la atención de la dirección.
Cada zona del mapa pide un tratamiento distinto. Las amenazas probables y de consecuencias leves forman parte de la gestión diaria, de los imprevistos normales de cualquier operación. Las improbables y leves apenas merecen planificación. Las probables y graves son la vulnerabilidad máxima y exigen actuar ya. Y las improbables pero graves, que son el foco del libro, «requieren planificación y una respuesta fuera del ámbito de la actividad diaria», precisamente porque la rutina nunca las va a preparar. En esa esquina están el incendio del proveedor único, la inundación, el ciberataque que cifra todos los sistemas o el apagón general.
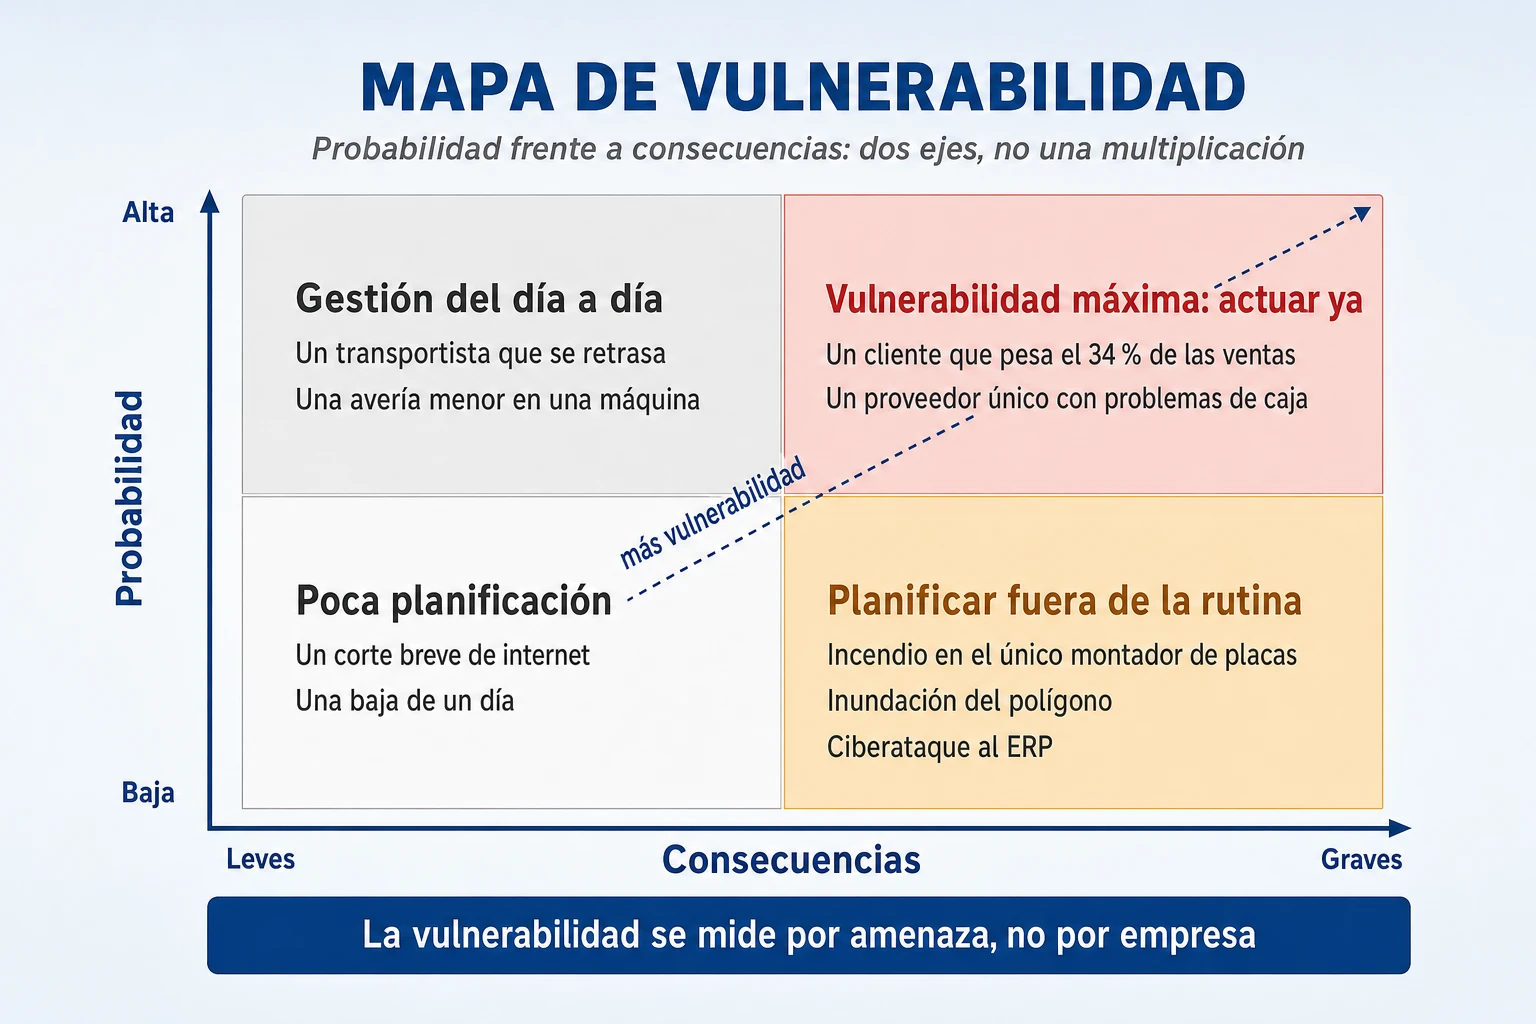
El artículo de 2005 añade un ejemplo que deshace un malentendido frecuente. Ante un atentado, una aerolínea como American Airlines era un objetivo probable y muy afectado; McDonald’s, un objetivo probable pero poco afectado, porque tenía más de 30.000 restaurantes; y Limited Brands, un objetivo improbable pero muy vulnerable, porque procesaba buena parte de su mercancía en un único centro de distribución. Pero McDonald’s, que resistía bien bombas y huelgas, «sería extremadamente vulnerable a un brote de la enfermedad de las vacas locas». La vulnerabilidad no es una propiedad de la empresa, sino de cada par empresa y amenaza, y por eso el mapa tiene que hacerse amenaza por amenaza y revisarse a medida que aparecen otras nuevas.
Sheffi y Rice proponen además un segundo cruce que la divulgación suele omitir y que es muy útil para una pyme: la capacidad de respuesta de la empresa frente a su posición en el mercado. En un mercado competitivo, quien responde rápido tiene la oportunidad de ganar cuota y quien responde despacio corre el riesgo de perderla; en un mercado donde la empresa domina, la respuesta rápida consolida el liderazgo y la lenta invita a los reguladores a intervenir. Para una empresa mediana en un mercado fragmentado, una disrupción que paraliza a sus competidores es una oportunidad tanto como un riesgo.
El mapa tiene un límite que el propio Sheffi reconocería años después: para los sucesos raros, la probabilidad es casi imposible de estimar. Por eso, en la secuela de 2015 distingue entre prepararse para las causas y prepararse para los efectos, y propone pensar «en posibilidades más que en probabilidades». Perder un proveedor es un efecto que puede tener cien causas distintas, de un incendio a una quiebra, y la preparación sirve para todas. Es el mismo giro que proponen David Simchi-Levi y sus colegas del MIT con la medición del tiempo de recuperación, que se explica más adelante.
En la empresa del caso, el comité tarda una mañana en hacer su primer mapa. Las amenazas probables y graves resultan ser dos que no tienen nada de catastrófico: la dependencia de un cliente que pesa el 34 % de las ventas y la situación del distribuidor de pantallas, que ya está racionando. En la esquina de lo improbable y grave quedan el incendio del montador de placas, una inundación del polígono como la de la DANA de Valencia de 2024 y un ataque de ransomware que cifre el servidor y el disco de copias, que están en la misma sala. El comité descubre algo que repetirá varias veces: casi nada de lo que le preocupa de verdad aparecía en la póliza de seguros.
Perfil de la disrupción (disruption profile): las ocho fases de una crisis y qué se decide en cada una
El segundo concepto es probablemente la aportación más original del libro. Según Sheffi y Rice, cualquier disrupción grave afecta al rendimiento de una empresa de forma predecible: si se dibuja en el tiempo cualquier indicador relevante, ya sean las ventas, la producción, el beneficio o el nivel de servicio, aparecen ocho fases reconocibles. Conocerlas permite gestionar cada una en lugar de improvisar, y sobre todo entender que una crisis no es un instante, sino una curva.
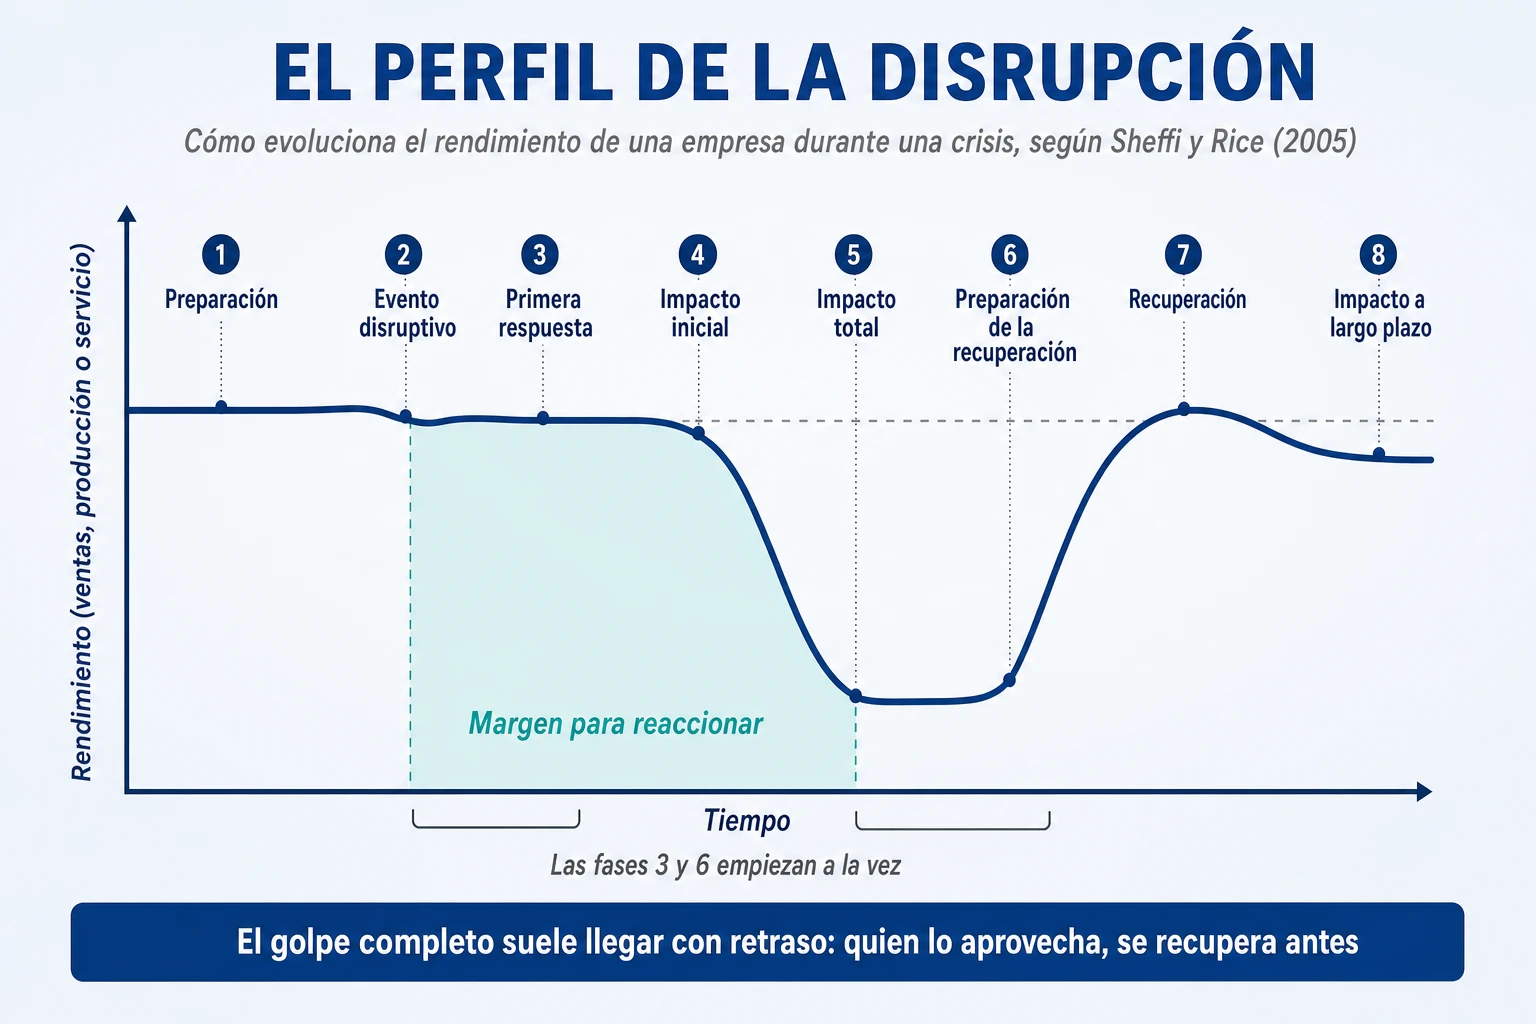
La tabla resume cada fase con el ejemplo que da el artículo de 2005 y con la decisión que corresponde a la dirección. Los nombres son los del original traducidos; algún resumen que circula llama «punto de máximo impacto» a la quinta fase, que en el texto de Sheffi y Rice es el «impacto total».
| Fase | Qué ocurre, con el ejemplo del libro | Qué decide la dirección |
| 1. Preparación | A veces hay aviso: General Motors tuvo 30 minutos antes de que un tornado alcanzara su planta de Oklahoma en 2003; el cierre de los puertos de la costa oeste de 2002 vino precedido de meses de negociación laboral | Qué señales vigilar y qué hacer con el aviso cuando llega |
| 2. Evento disruptivo | Llega el tornado, estalla la bomba, quiebra un proveedor o empieza una huelga | Nada: el evento ya no se puede decidir |
| 3. Primera respuesta | Controlar la situación, salvar vidas, apagar sistemas y evitar más daños | Quién manda en las primeras horas y con qué autonomía |
| 4. Impacto inicial | El rendimiento empieza a caer; a NUMMI, la fábrica conjunta de Toyota y GM en California, le costó cuatro días parar tras el cierre de los puertos | Cuánto tiempo queda hasta que se agoten los colchones |
| 5. Impacto total | El rendimiento cae en picado cuando se agotan inventarios y alternativas | A qué clientes y productos se da prioridad con lo poco que hay |
| 6. Preparación de la recuperación | Empieza a la vez que la primera respuesta: Nokia homologa proveedores, NUMMI trae piezas en avión, Dell vende lo que puede montar | Qué alternativas se activan y cuánto se está dispuesto a pagar por ellas |
| 7. Recuperación | Se trabaja por encima de lo normal, con horas extra y ayuda de proveedores y clientes; NUMMI recuperó una semana de cierre y acabó el año con ventas récord | Cómo se recupera el retraso sin quemar a la plantilla ni a los proveedores |
| 8. Impacto a largo plazo | Si se dañó la relación con los clientes, el daño perdura: las fábricas de calzado de Kobe perdieron el 90 % de su negocio tras el terremoto de 1995 y la mayoría de los compradores no volvió | Qué se aprende y qué se cambia para la próxima vez |
De la curva se desprenden dos lecciones. La primera es que el impacto total suele llegar con retraso, porque el material en tránsito y los inventarios intermedios amortiguan durante días o semanas. Ese tramo, entre el evento y el impacto total, es el margen para reaccionar, y la diferencia entre Nokia y Ericsson fue precisamente que una lo usó y la otra no. La segunda es que las fases tres y seis se solapan: la preparación de la recuperación tiene que empezar a la vez que la primera respuesta, no después, y a veces incluso antes del evento. Una empresa que primero apaga el fuego y luego empieza a pensar en alternativas ya ha perdido la mitad de su margen.
Diez años después, Sheffi convirtió esa idea en una dimensión propia. En un artículo de 2015 extraído de su segundo libro, escribe que las disrupciones no solo se diferencian por su probabilidad y su impacto, sino por «una tercera dimensión crucial: su margen de aviso» (detection lead time), el tiempo que pasa entre saber que el evento ocurrirá y su primer efecto en la empresa. Puede ser positivo, como un huracán anunciado con días o el vencimiento de un convenio; cero, como un incendio o un terremoto; o negativo, como una contaminación o un defecto de diseño que se descubren cuando ya han causado daño. En las cadenas globales, añade, una empresa atenta puede tener semanas de margen porque el material tarda en llegar.
En la empresa del caso, el ejercicio es revelador. Si mañana ardiera la nave del montador de placas, la fábrica seguiría produciendo unas cuatro semanas, las tres que cubre el stock de placas y la semana de pedidos en camino, y el impacto total llegaría en la quinta. Homologar otro montador, transferirle los utillajes y los programas de prueba y producir los primeros lotes llevaría unas doce. El comité ve por primera vez el hueco entre las dos cifras, y entiende que la decisión importante no es qué hacer el día del incendio, sino qué tener preparado antes para que ese hueco sea más pequeño.
Redundancia frente a flexibilidad: por qué Sheffi prefiere la flexibilidad y cuándo la redundancia es imprescindible
Este es el centro del libro. Para Sheffi y Rice, reducir la vulnerabilidad significa dos cosas: reducir la probabilidad de una disrupción y aumentar la resiliencia, «la capacidad de recuperarse». Y la resiliencia, a su vez, «se puede conseguir creando redundancia o aumentando la flexibilidad». Las dos vías protegen, pero tienen economías muy distintas, y ahí está el argumento principal del autor.
La redundancia consiste en mantener recursos en reserva para usarlos si algo falla. Sus formas más comunes, según el artículo de 2005, son el stock de seguridad, el uso deliberado de varios proveedores aunque los secundarios sean más caros y una utilización de la capacidad deliberadamente baja. Su coste incremental es, en palabras de Sheffi y Rice, «en la práctica, una prima de seguro»: se paga todos los meses y solo devuelve algo el día del desastre. Además, advierte Sheffi, mantener excesos de inventario, capacidad y personal suele llevar a operaciones descuidadas, peor calidad y costes mucho mayores.
La flexibilidad es otra cosa: construir capacidades propias para detectar las amenazas y responder deprisa, como poder mover la producción entre plantas, cambiar de proveedor, terminar el producto según lo que pida el mercado o reasignar personas. Y su ventaja decisiva es que esas capacidades sirven también cuando no hay crisis, porque una variación brusca de la demanda o el lanzamiento de un producto nuevo se gestionan con las mismas herramientas. Por eso Sheffi y Rice escriben que las inversiones en flexibilidad «pueden justificarse con los resultados normales del negocio, sin tener siquiera en cuenta los beneficios de mitigar riesgos». La versión corta, que no es una cita sino una buena paráfrasis, es que la redundancia paga el día del desastre y la flexibilidad paga todos los días.
La tabla siguiente compara las dos vías ante los mismos problemas. Es una síntesis de este artículo a partir de los ejemplos del libro, no una tabla de Sheffi.
| Ante este problema | Respuesta por redundancia | Respuesta por flexibilidad |
| Falla una planta | Tener una segunda planta parada o infrautilizada | Plantas idénticas que pueden fabricar lo de la otra (Intel) |
| Falla un proveedor | Comprar siempre a dos, aunque el segundo sea más caro | Piezas estándar que varios proveedores pueden hacer, y uno alternativo ya homologado |
| Falta una persona clave | Personal de reserva | Personas que dominan su puesto y el siguiente (UPS, Southwest) |
| La demanda cambia o falta un componente | Stock de producto terminado de todas las variantes | Producto genérico que se termina al final (Benetton, HP) y clientes orientados a lo disponible (Dell) |
| Cuándo rinde | Solo el día de la disrupción | También en el día a día |
Sería un error leer el libro como un alegato contra las reservas. Sheffi y Rice escriben que «algo de redundancia forma parte de toda estrategia de resiliencia», y ponen un ejemplo en el que la redundancia es tan barata y su ausencia tan grave que se ha convertido en práctica obligatoria: las copias de seguridad informáticas. La pregunta no es si hace falta redundancia, sino dónde. Y la investigación posterior ha dado algunos criterios para responderla.
El más citado es de Brian Tomlin, que en 2006 modelizó cuándo conviene cada estrategia. Su conclusión es que la naturaleza de la disrupción decide: cuando los cortes son frecuentes y cortos, conviene el inventario; cuando son raros pero largos, conviene tener ya otra fuente de suministro, porque ningún stock razonable aguanta meses. Y la flexibilidad «en caliente», como pedir a un segundo proveedor que suba su capacidad cuando el primero cae, funciona bien para golpes moderados, pero ante disrupciones raras y largas es mejor haber preparado la alternativa de antemano.
De ahí salen tres situaciones en las que la redundancia es casi la única defensa. La primera, los componentes sin sustituto: cuando una explosión paró en 2012 la planta de Evonik en Marl, en Alemania, principal proveedor mundial de una resina llamada nailon 12, los fabricantes de automóviles estuvieron seis meses sin una alternativa que se pudiera improvisar. La segunda, los riesgos de larga duración, como una nave inundada o un utillaje destruido, en los que la flexibilidad de proceso se agota en semanas. Y la tercera, los recursos físicos que no se pueden flexibilizar: ante un apagón, la flexibilidad es un generador; ante un ataque de ransomware, una copia de seguridad desconectada. Las dos son redundancia pura.
En su secuela de 2015, Sheffi dio a este debate una forma más precisa: la redundancia y la flexibilidad son opciones reales, derechos a actuar que tienen un valor aunque no se ejerzan, y la flexibilidad es «la opción definitiva» porque sirve ante muchos más escenarios. En la empresa del caso, el comité aplica la lógica con una regla sencilla: redundancia allí donde no hay forma de ser flexible a tiempo, como una copia del ERP fuera de la oficina y unas semanas más de stock de pantallas mientras dure la escasez, y flexibilidad en todo lo demás, empezando por las personas y los proveedores.
Palancas de flexibilidad: estandarización, aplazamiento de la diferenciación (postponement) e intercambiabilidad
Si la flexibilidad es el camino, ¿cómo se construye? El libro dedica cuatro capítulos a las palancas concretas, y el propio Sheffi las resumió en una presentación de 2007 en cuatro familias: la intercambiabilidad de plantas, piezas y personas; la velocidad, con procesos en paralelo en lugar de en secuencia; el aplazamiento de la diferenciación del producto, y la relación con proveedores y clientes. Las tres primeras se explican aquí y la cuarta tiene capítulo propio.
Estandarización e intercambiabilidad: Intel, UPS y Southwest
La primera palanca es hacer las cosas igual en todas partes para poder moverlas de un sitio a otro. El ejemplo más claro es Intel, que construye sus fábricas de semiconductores con la misma disposición de máquinas y los mismos procesos, una práctica que la empresa llama Copy Exactly!. Sheffi lo contó así en una entrevista de 2006: entras en una fábrica de Intel en Israel y después en otra en Malasia, y tienes una sensación de déjà vu, porque son idénticas, «incluso en su orientación respecto al sol». La práctica no nació como estrategia de resiliencia, sino para acelerar la puesta en marcha de las fábricas nuevas, pero durante el brote de SARS de 2003 permitió a Intel mover la producción de una planta a otra casi sin problemas. Es el mejor ejemplo de beneficio colateral: una práctica de calidad que resultó ser una práctica de resiliencia.
El segundo ejemplo es UPS. El 16 de enero de 1994, una ventisca excepcional cerró su centro aéreo de Louisville, en Kentucky, el corazón de su red, y la ciudad prohibió circular durante una semana. UPS desvió más de cien aviones y, como sus empleados locales no podían llegar al trabajo, trajo en avión a empleados de todo el país. Pudo hacerlo porque sus máquinas de clasificación, sus procesos y su forma de trabajar eran iguales en todos los centros, de modo que quien conocía uno podía operar cualquier otro. Sheffi y Rice lo resumen con una frase que vale para cualquier pyme con varias sedes: una empresa con cinco almacenes y cinco sistemas de gestión de almacén distintos es menos flexible que una que usa el mismo sistema en los cinco.
El tercero es Southwest Airlines, que solo vuela con Boeing 737. Cuando Boeing desarrolló una cabina digital, Southwest la aceptó con una condición: que la programaran para que se pareciera a los relojes analógicos de siempre, «porque queremos que cada piloto pueda entrar en cada cabina y volarla». «La fungibilidad es vital en el personal, igual que en las piezas», concluye Sheffi. La misma lógica le lleva a una recomendación que, como ingeniero, reconoce casi herética: usar piezas «suficientemente buenas» y comunes a varios productos en lugar de piezas diseñadas a medida, porque una pieza común se prevé mejor, admite varios proveedores y no se queda obsoleta si un producto fracasa.
Hay un contrapeso que conviene añadir y que no está en el libro: la estandarización también concentra el riesgo cuando el elemento estándar falla. Una flota de un solo modelo de avión queda entera en tierra si ese modelo tiene un problema de seguridad, y el mismo programa de seguridad instalado en todos los ordenadores convierte un error en un desastre general, como se vio con CrowdStrike en 2024. Estandarizar da flexibilidad para mover; no protege frente a un fallo del propio estándar.
Flexibilidad limitada y encadenamiento: por qué no hace falta que todos sepan hacer todo
Una objeción razonable a todo lo anterior es el coste: si cada planta debe poder fabricarlo todo y cada persona cubrir cualquier puesto, la flexibilidad sale carísima. Sheffi y Rice responden con un resultado de investigación operativa que es, probablemente, lo más útil del libro para una pyme. William Jordan y Stephen Graves, trabajando con datos de General Motors, demostraron en 1995 que una flexibilidad limitada, bien configurada, consigue la mayor parte de los beneficios de la flexibilidad total.
La clave está en cómo se configura. Si cada planta, o cada persona, añade un solo producto o puesto más a lo que ya hace, y esos segundos puestos se encadenan formando un círculo cerrado, el exceso de trabajo en un punto se puede ir empujando a lo largo de la cadena hasta donde haya capacidad libre. Es lo que se llama encadenamiento (chaining). En palabras de Sheffi y Rice, la mayor parte de la ganancia se logra pasando de uno a dos productos por planta, y a partir de ahí los rendimientos decrecen. Trabajos posteriores añadieron dos matices: el mayor beneficio llega al cerrar el último eslabón del círculo, y la cadena funciona relativamente mejor cuanto más pequeño es el sistema, una buena noticia para una empresa de pocas líneas.
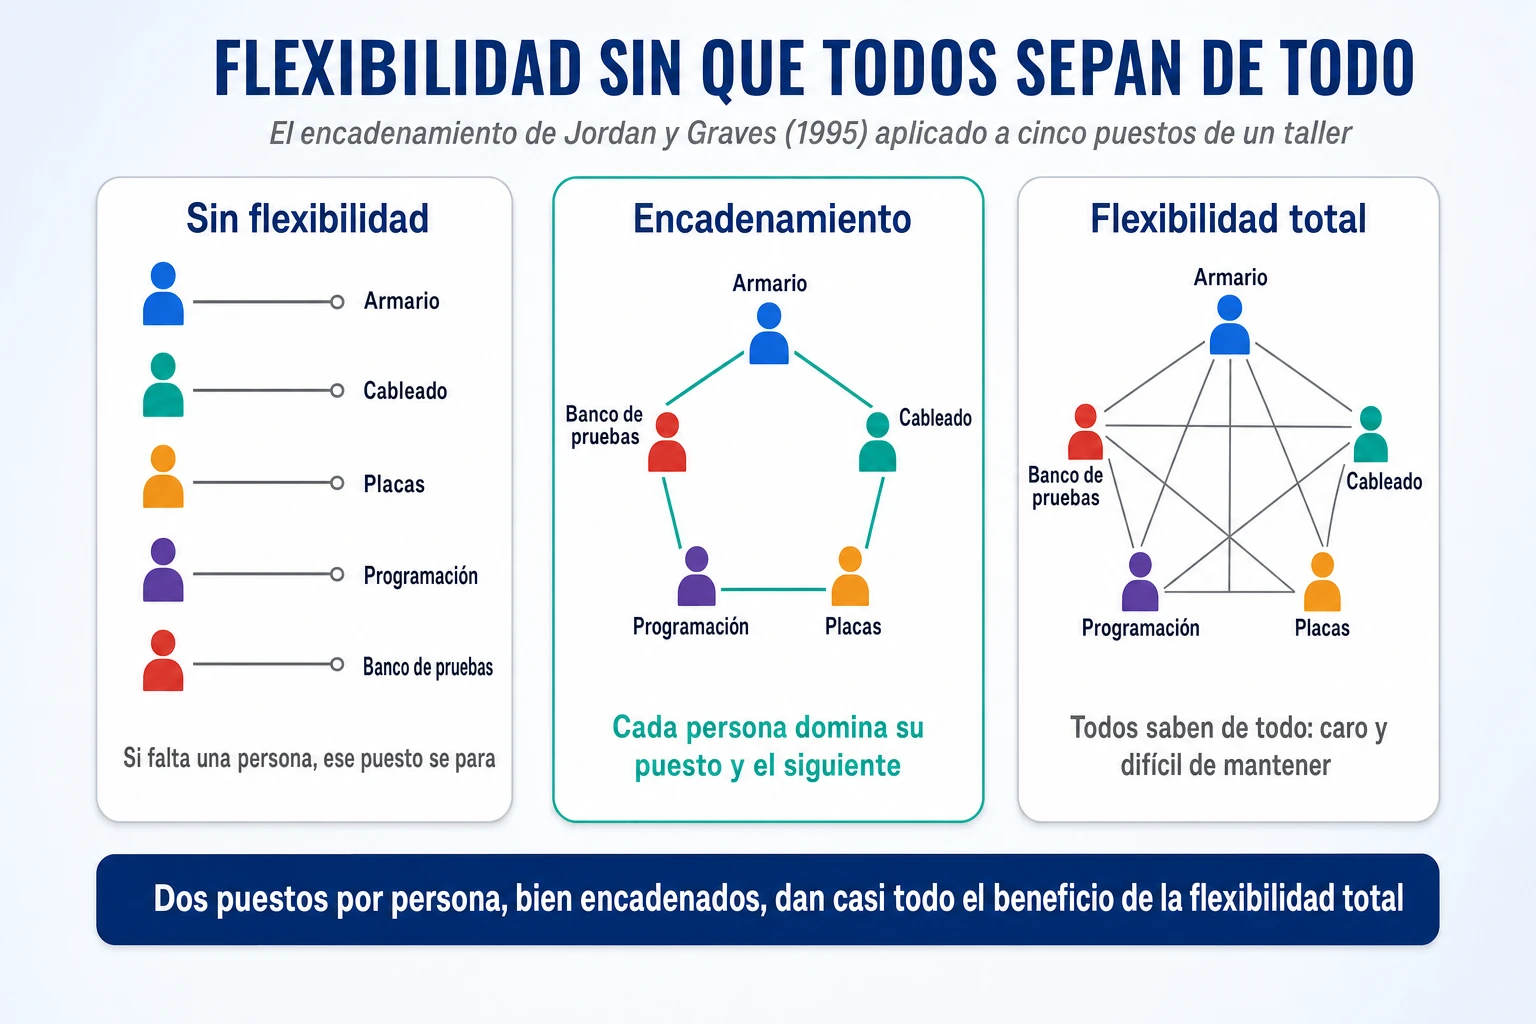
Un matiz de rigor: Jordan y Graves estudiaron la incertidumbre de la demanda, no la caída de una planta, y aplicar su resultado a las disrupciones es una extensión que hacen Sheffi y Rice, razonable pero no demostrada en aquel trabajo. En la empresa del caso, la traducción es inmediata. El taller tiene cinco puestos, del armario al banco de pruebas, y hasta ahora cada persona sabía hacer uno. El comité decide formar a una persona de cada puesto en el siguiente, de modo que quien cablea sepa montar placas, quien monta placas sepa programar, quien programa sepa manejar el banco de pruebas y quien prueba sepa montar armarios. No hace falta que todos sepan todo; hace falta que el círculo esté cerrado.
Aplazamiento de la diferenciación (postponement): Benetton, HP y Dell
La tercera palanca consiste en retrasar todo lo posible el momento en que un producto se convierte en una variante concreta. Mientras un producto está en forma genérica, se puede destinar a cualquier mercado o cliente; en cuanto se personaliza, queda atado. Benetton es el ejemplo clásico: rediseñó su fabricación para tejer algunas prendas en crudo y teñirlas después, cuando ya sabía qué colores se estaban vendiendo. Teñir la prenda terminada costaba más por unidad, pero compensaba con creces porque se vendía más y se rebajaba menos.
Hewlett-Packard hizo lo mismo con sus impresoras para Europa. Las fabricaba en Estados Unidos y Singapur con la fuente de alimentación, el enchufe, los manuales y el embalaje de cada país, y siempre se encontraba, según Sheffi, «con demasiadas impresoras eslovacas y no suficientes danesas». Pasó a enviar impresoras genéricas a un centro de distribución en los Países Bajos y a terminarlas allí para cada país. El ahorro de inventario fue la razón del cambio, pero la consecuencia para la resiliencia es igual de clara: una huelga en un país ya no deja montañas de producto inservible. Dell llevó la idea al extremo con su modelo de fabricación contra pedido, que no monta nada hasta que el cliente lo ha comprado.
En la empresa del caso, el aplazamiento resuelve un problema que la escasez de pantallas ha hecho visible. El catálogo usa siete modelos distintos de pantalla táctil, uno casi por cada familia de equipo, porque cada ingeniero eligió la que prefería. El comité decide reducirlos a dos, que puedan servir para todos los equipos, y cargar el programa específico de cada cliente al final, en el banco de pruebas. Con dos modelos, cada pantalla en stock sirve para cualquier pedido, el distribuidor tiene menos referencias que conseguir y la empresa puede comprar a dos marcas el mismo tipo de pantalla.
Relación con proveedores: cuándo un proveedor único es una fortaleza y cuándo un riesgo
La recomendación más repetida tras cualquier crisis de suministro es diversificar proveedores. Sheffi la matiza de una forma que sorprende a muchos directivos: «Los dos enfoques son correctos. La cuestión no es si usar un proveedor único o varios, sino alinear la relación con el proveedor con la estrategia de compras.» Si una empresa decide trabajar con un solo proveedor para una pieza, por calidad, por coste o porque la pieza es muy específica, tiene que desarrollar con él una relación profunda y trabajar muy cerca. Si no puede o no quiere, necesita una base de proveedores amplia.
El cruce entre el número de proveedores y la profundidad de la relación da cuatro situaciones, y solo una de ellas es de verdad peligrosa. La tabla resume la matriz que Sheffi presentaba en sus conferencias, con los casos del libro que mejor ilustran cada combinación.
| Número de proveedores | Relación superficial | Relación profunda |
| Uno | La combinación peligrosa: dependencia sin información ni influencia. Land Rover y UPF-Thompson | Viable si se cuida: el proveedor se vuelca en la crisis. Toyota y Aisin |
| Varios | Viable: si uno falla, el mercado ofrece alternativas. Piezas de catálogo | Difícil de sostener: mantener relaciones profundas con muchos proveedores es muy caro |
La combinación peligrosa tiene un caso de libro que se cuenta en detalle más adelante: el de Land Rover, que en diciembre de 2001 se encontró con que su proveedor único de bastidores para el Discovery había quebrado y el administrador concursal le exigía millones de libras por seguir sirviendo. Land Rover no tenía contrato de suministro por escrito ni un acuerdo sobre la propiedad del utillaje que ella misma había pagado. Sheffi lo resume en una frase: «Un seguimiento inadecuado de su base de proveedores casi le cuesta el negocio a Land Rover. Una relación más profunda la habría alertado antes de la crisis.»
La investigación posterior añadió un hallazgo que cambia la forma de priorizar. Cuando David Simchi-Levi y sus colegas del MIT analizaron con Ford unas mil plantas de sus proveedores, se encontraron con que había «poca correlación» entre lo que Ford gastaba en cada planta y el daño que causaría su caída. Alrededor de seis de cada diez plantas no habrían afectado al beneficio de Ford si fallaran, y en torno al 2 % lo habrían afectado mucho, y muchas de estas últimas eran proveedores a los que Ford compraba relativamente poco y que nadie tenía catalogados como críticos. Los datos estaban ligeramente alterados por confidencialidad, pero la lección es clara: una junta tórica de céntimos que solo fabrica una empresa puede parar una línea igual que el motor.
Eso obliga a revisar la segmentación habitual de proveedores, que clasifica a los «estratégicos» por volumen de compra. Simchi-Levi propone añadir una categoría que esa clasificación no ve: el riesgo oculto, los proveedores de poco gasto y mucho impacto, para los que recomienda stock adicional, exigir más de una planta, una segunda fuente o diseños más flexibles. Es exactamente la situación de Ericsson con los chips de Albuquerque, y la de los fabricantes de automóviles con la empresa Nexperia en 2025, que se cuenta en el capítulo de casos posteriores.
En la empresa del caso, el montador de placas encaja en la primera fila de la tabla, y el comité tiene que decidir en qué columna quiere estar. Elige quedarse con un único montador principal, pero en la columna de la relación profunda: firma un contrato que deja claro que los utillajes y los programas de prueba son de la empresa, pide al montador que comparta sus cuentas anuales y su plan ante emergencias, y encarga el 10 % de los lotes a un segundo montador de Valencia para mantenerlo homologado y con los programas cargados. Es más caro que comprarlo todo al de siempre, pero mucho más barato que doce semanas sin placas.
Detección temprana y cultura de la resiliencia: ver antes y decidir sin esperar a la cadena de mando
Sheffi termina la parte de la flexibilidad con el capítulo que considera más difícil de imitar: la cultura. En el resumen que publicó en 2005 lo dice sin rodeos: tras una disrupción, «el factor que distingue claramente a las empresas que se recuperan rápido, e incluso con beneficio, de las que fracasan es la cultura corporativa». Y antes de describir esa cultura, el libro plantea una pregunta más incómoda: ¿cuándo sabe una organización que algo grave está pasando?
Detectar pronto: la información incómoda y los casi incidentes
La respuesta de Sheffi y Rice es que no hay un instante en el que una empresa «sabe»: la información se va acumulando hasta que alguien la junta y alcanza para actuar. Detectar pronto la magnitud de una disrupción exige, escriben, «una cultura que permita escuchar, entender y actuar sobre la información disidente», la que contradice lo que todo el mundo da por cierto. El ejemplo opuesto a Ericsson es la frase de Pertti Korhonen, el directivo de Nokia que gestionó la crisis de Albuquerque: «Animamos a que las malas noticias viajen rápido. No queremos esconder los problemas».
La herramienta que propone el libro para entrenar esa atención viene de la seguridad industrial: el análisis de los casi incidentes (near misses), los sucesos que podrían haber causado un daño grave y no lo hicieron. Las industrias de procesos químicos aprendieron hace décadas que cada accidente grave viene precedido de muchos avisos pequeños, y que registrarlos y analizarlos es la forma más barata de evitar el grande. Sheffi propone hacer lo mismo con las disrupciones: prestar atención a las pequeñas como síntomas de problemas que se están formando, y corregir sus causas de raíz como hizo el movimiento de la calidad.
En 2015, Sheffi desarrolló la detección con mucho más detalle y enumeró las fuentes de las que se alimenta: vigilar el tiempo meteorológico y las noticias, leer los datos de los sensores, seguir la salud de los proveedores, visitarlos, analizar las materias primas, rastrear los productos, escuchar las redes sociales y seguir los cambios normativos. Señaló también el dilema de toda alarma: un sistema poco sensible avisa tarde, y uno demasiado sensible genera tantas falsas alarmas que la organización deja de hacerle caso. Su definición de la tarea es una buena síntesis: detectar es convertir las incógnitas relevantes en certezas visibles a tiempo.
Los rasgos de una cultura resiliente: Nokia, Toyota, UPS, Southwest y la Marina de Estados Unidos
Sheffi reconoce que Nokia, Toyota, UPS, Dell, Southwest y la Marina de Estados Unidos no parecen tener mucho en común, pero sostiene que comparten varios rasgos culturales. El primero es la comunicación continua entre empleados informados: en Dell, contaba Sheffi en 2006, cada directivo recibía cada dos horas un informe de producción de toda la empresa, de modo que cuando llegaba una disrupción todos sabían qué se vendía, dónde estaban los materiales y qué se intentaba hacer. El segundo es el poder distribuido: en Toyota cualquier operario puede parar la línea si ve un problema, y en los portaaviones de la Marina cualquier miembro de la tripulación puede detener las operaciones de vuelo si detecta una emergencia, porque quien está cerca de los hechos actúa antes de que el problema sea visible para los mandos.
El tercer rasgo es la pasión por el trabajo y por la misión, que Sheffi ilustra con una frase que citaba Herb Kelleher, de Southwest: lo importante es que el albañil entienda que está construyendo una casa, no solo poniendo ladrillos. Y el cuarto es el condicionamiento para la disrupción: las organizaciones que viven pequeñas interrupciones continuas aprenden a improvisar ante las grandes. «Las disrupciones son algo normal», decía un directivo de UPS, cuyos procesos de recuperación «se ponen a prueba a diario». En sus presentaciones de 2007, Sheffi añadía un quinto rasgo, la deferencia a la experiencia, que en una crisis consiste en que decida quien más sabe del problema, no quien tiene más rango.
Un ejemplo que Sheffi daba en la misma entrevista muestra cómo esa cultura se convierte en velocidad. En Zara y en la cadena japonesa World, los encargados de tienda recogían cada noche qué se vendía y por qué, y los diseñadores cambiaban los modelos y los enviaban a fabricación sin pasar por aprobaciones. Según Sheffi, el ciclo completo les llevaba tres semanas, frente a los nueve meses de Marks & Spencer, y la razón era que no había proceso de aprobación; las cifras son suyas, en una entrevista, no un dato auditado. Aceptaban errores porque el ciclo era tan corto que se corregían enseguida. Sobre Nokia, Sheffi y Rice recogen que los observadores atribuían su respuesta a lo que los finlandeses llaman sisu, una mezcla de aguante y determinación bajo presión, aunque no lo convierten en un concepto del libro.
La cultura es también lo que más tarda en construirse, y la conclusión de Sheffi es optimista: igual que las empresas cambiaron su cultura de la seguridad laboral y de la calidad, pueden cambiar la de la resiliencia. En la empresa del caso, el primer síntoma de cultura aparece en cuanto se pregunta: Marta, la técnica del banco de pruebas, cuenta que el montador de placas se retrasó tres veces en el último año por problemas con una máquina, y que lo resolvió cada vez con horas extra. Nadie lo había apuntado. El comité decide abrir un registro de casi incidentes, una hoja en la que cualquiera anota lo que estuvo a punto de parar la fábrica, y revisarlo quince minutos cada mes.
Seguridad y resiliencia: prevenir una disrupción no es lo mismo que recuperarse de ella
El libro nació tras el 11 de septiembre, y una parte de él se dedica a la seguridad. La distinción que establece Sheffi es sencilla y útil: la seguridad reduce la probabilidad de que algo ocurra; la resiliencia reduce el daño cuando ocurre. Las dos se refuerzan, porque una empresa que se recupera deprisa es un objetivo menos atractivo para quien quiere hacer daño, pero responden a preguntas distintas y requieren inversiones distintas.
Para la seguridad, Sheffi propone defensas en capas, de modo que superar una no baste para causar el daño; equilibrar cuánta seguridad es suficiente; analizar los perfiles de riesgo de envíos y personas; colaborar con las administraciones, los socios e incluso los competidores; construir una cultura de seguridad, y hacer simulacros. Y critica cómo la organizan las empresas: repartida en tres funciones aisladas, la continuidad de negocio, con un plan «que se queda en una estantería»; la seguridad física, la de «las armas, las vallas y los perros»; y la seguridad informática. Lo que le preocupaba, decía en 2006, es que ninguna de las tres estuviera incorporada a la estrategia de la empresa.
El ejemplo de colaboración que más usa es el programa estadounidense C-TPAT, en el que las empresas que aceptan aplicar ciertas medidas de seguridad en su cadena, y exigirlas a sus proveedores, pasan las aduanas mucho más deprisa. Según Sheffi, la certificación podía reducir el paso por aduanas «de dos semanas a dos días». Para una pyme exportadora española, el equivalente es la figura de Operador Económico Autorizado de la Unión Europea, que da ventajas parecidas en los controles a cambio de demostrar que la cadena de suministro es fiable.
Lo más interesante del capítulo es la idea con la que Sheffi lo cierra: los beneficios colaterales. Las medidas de seguridad, bien diseñadas, reducen los robos y las mermas, ordenan los procesos y mejoran la visibilidad del inventario y la relación con clientes, proveedores y administraciones. Sheffi lo llamaba «hacer limonada con los limones». Veinte años después, la seguridad que más preocupa a una pyme es la informática, que Sheffi desarrolló en su secuela de 2015, y el argumento se mantiene: una empresa que sabe qué sistemas tiene, quién accede a ellos y cómo restaurarlos no solo está más protegida, también funciona mejor.
Nokia frente a Ericsson tras el incendio de Albuquerque (2000): la detección y la velocidad deciden la crisis
El caso con el que Sheffi abre el libro merece contarse con detalle, porque casi todas las versiones que circulan lo simplifican en la dirección equivocada. Se suele decir que Nokia se enteró antes que Ericsson. No es así: las dos recibieron el aviso de Philips el mismo día, el lunes 20 de marzo de 2000, tres días después del incendio. La diferencia estuvo en lo que cada una hizo con él, y eso es lo que hace útil el caso.
En Nokia, el aviso llegó a Tapio Markki, jefe de compras de componentes, como una noticia menor: Philips había perdido «algunas obleas» y en una semana todo volvería a la normalidad. Pero los sistemas de Nokia ya mostraban que los pedidos de esa planta no cuadraban, y Markki subió la noticia a su jefe, Pertti Korhonen. Korhonen puso los cinco componentes que salían de Albuquerque en una lista de vigilancia especial, con seguimiento diario en lugar de semanal, y ofreció enviar ingenieros a la planta. El 31 de marzo, Philips admitió que necesitaría semanas para volver a producir y que el suministro se vería afectado durante meses. Korhonen calculó que Nokia podía dejar de fabricar casi cuatro millones de teléfonos, más del 5 % de sus ventas.
De los cinco componentes, dos eran imprescindibles, y uno de ellos, unos chips específicos de radiofrecuencia, solo lo fabricaban Philips y un subcontratista. Nokia formó en dos semanas un equipo de unas treinta personas repartidas por Europa, Asia y Estados Unidos. Su consejero delegado, Jorma Ollila, viajó con Korhonen a Ámsterdam para reunirse con el de Philips y exigir que la capacidad de todas sus fábricas se pusiera a disposición de Nokia: durante un tiempo, dijo un directivo, las dos empresas actuarían «como una sola» para esos componentes. Una planta de Philips en Eindhoven fabricó más de diez millones de esos chips, otra en Shanghái se reservó para Nokia, un proveedor japonés y otro estadounidense aceptaron pedidos con cinco días de plazo, y los ingenieros de Nokia rediseñaron algunos chips para poder producirlos en otro sitio.
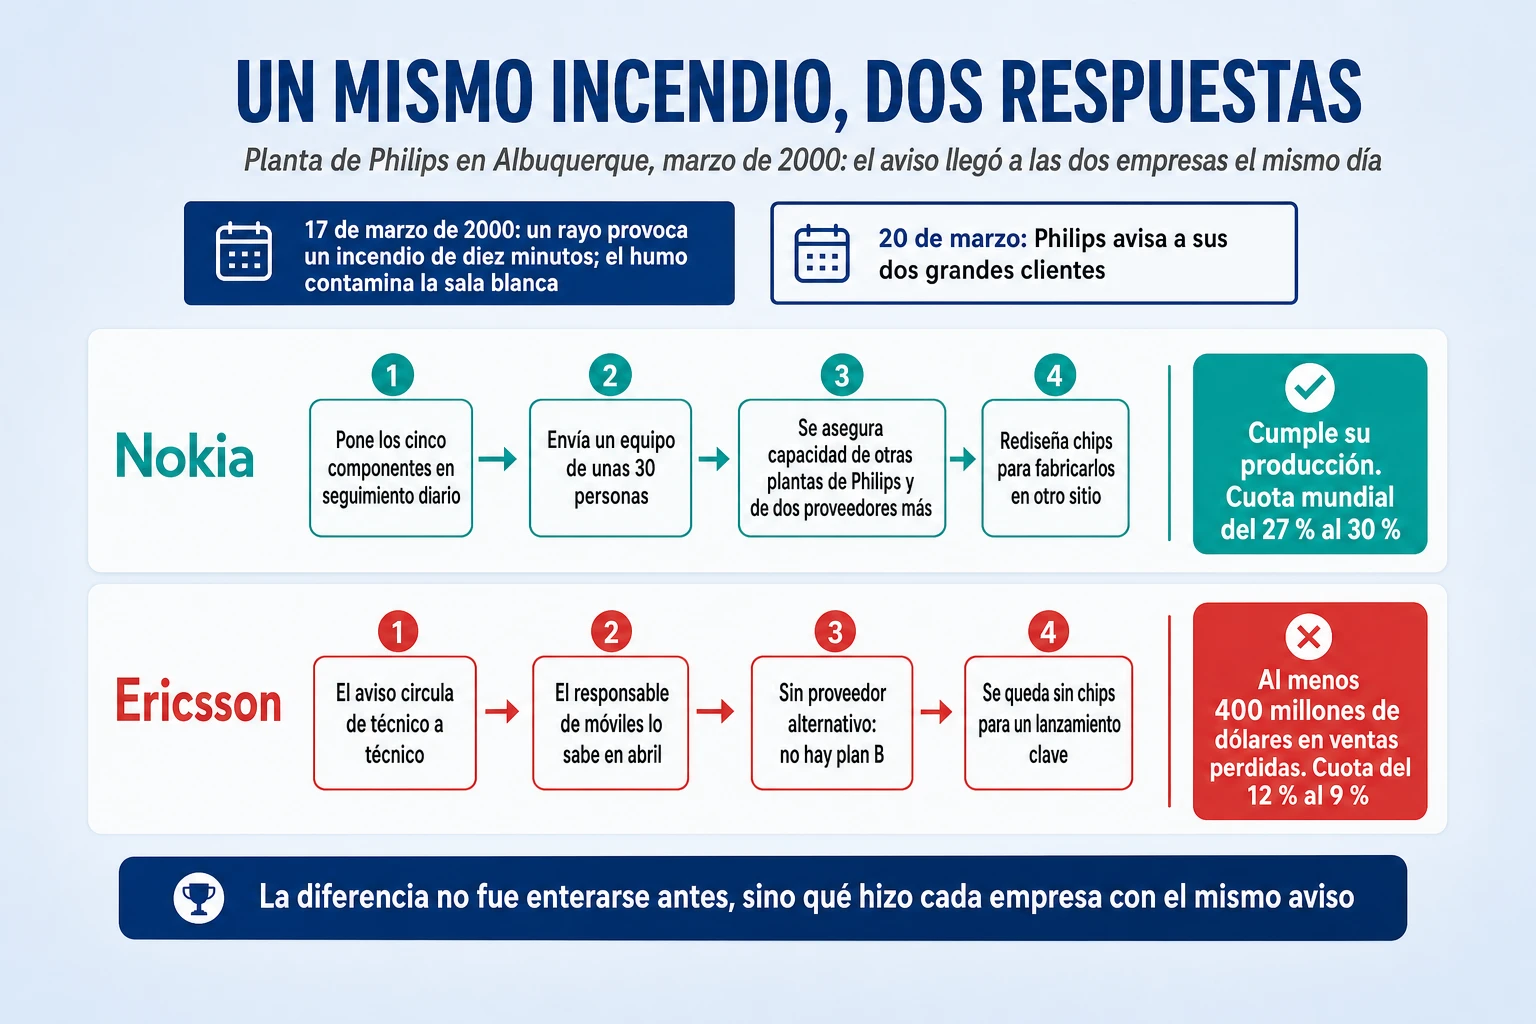
En Ericsson, el aviso circuló como una comunicación «de un técnico a otro» y no se percibió como una catástrofe. El responsable de la división de móviles, Jan Wareby, no se enteró hasta principios de abril. Para entonces, la capacidad alternativa del mercado ya estaba comprometida, en buena parte con Nokia, y Ericsson no tenía otro proveedor homologado porque había eliminado los de respaldo años antes. Se quedó sin millones de chips para el lanzamiento de un producto clave, y estimó sus ventas perdidas en al menos 400 millones de dólares, una parte cubierta por el seguro.
El final de la historia también se suele contar mal. Ericsson no «salió del mercado de móviles». Su división de terminales perdió en 2000 el equivalente a 1.680 millones de dólares, una pérdida que la propia empresa atribuyó a varias causas, entre ellas la escasez de componentes, una gama de productos equivocada y problemas de marketing. En enero de 2001 anunció que externalizaba toda la fabricación de teléfonos a Flextronics, y en octubre creó con Sony la empresa conjunta Sony Ericsson. Mientras tanto, la cuota mundial de Nokia pasó de alrededor del 27 % al 30 % y la de Ericsson cayó del 12 % al 9 %, aunque no todo ese trasvase se debió al incendio.
El caso enseña tres cosas que el libro desarrolla. La primera, que la detección no consiste en enterarse antes, sino en interpretar antes: Nokia leyó una noticia menor a la luz de sus propios datos y la escaló; Ericsson la dejó en el nivel técnico. La segunda, que la flexibilidad de diseño, poder rediseñar un chip para fabricarlo en otra planta, valió más que cualquier inventario. Y la tercera, menos citada, que el tamaño de Nokia como cliente pesó mucho: pudo exigir capacidad porque era imprescindible para Philips, una ventaja que una pyme no tiene y que obliga a buscar otras palancas. Ericsson aprendió la lección: según estudios posteriores, el incendio fue el origen de su sistema de gestión del riesgo de suministro, que exigía segundas fuentes para los componentes clave y que se convirtió en una referencia del sector.
Toyota y el incendio de Aisin (1997): un proveedor único y una red de proveedores que responde
El segundo gran caso del libro parece, a primera vista, la peor pesadilla del justo a tiempo. Antes del amanecer del sábado 1 de febrero de 1997, un incendio destruyó la fábrica de Aisin Seiki en Kariya, cerca de Nagoya. Aisin fabricaba todas menos el 1 % de las válvulas dosificadoras de presión de freno de Toyota, unas piezas del tamaño de un puño, de unos cinco dólares, que llevaban casi todos sus coches. Las plantas de Toyota tenían unas cuatro horas de esas válvulas, y todo el sistema, contando lo que había en camino, dos o tres días. La mayor parte de las 506 máquinas especializadas de la fábrica quedó inservible, había 200 variantes de la pieza y conseguir máquinas nuevas llevaría seis meses.
El momento no podía ser peor: Toyota trabajaba a plena capacidad, con horas extra, para atender los pedidos que se adelantaban a una subida de impuestos prevista para abril, y fabricaba unos 14.000 coches al día en Japón. Lo que ocurrió después lo reconstruyeron el Wall Street Journal y, sobre todo, Toshihiro Nishiguchi y Alexandre Beaudet en un estudio de 1998. Esa misma tarde, Toyota y Aisin reunieron a sus proveedores, repartieron los planos y los encargos por variantes, y cada empresa improvisó utillajes y líneas. El jueves siguiente, 36 proveedores, ayudados por más de 150 subcontratistas, tenían casi 50 líneas haciendo válvulas en pequeños lotes, entre ellas una de Brother, el fabricante de máquinas de coser, que adaptó una fresadora.
Las cifras de la recuperación varían según la fuente, y conviene darlas todas. Según Nishiguchi y Beaudet, las plantas de montaje de Toyota pararon solo dos días laborables; las primeras mil válvulas útiles llegaron el miércoles, cuarto día después del incendio, y las fábricas fueron arrancando poco a poco desde el quinto. Sheffi y Rice escriben que Toyota volvió «a plena producción en nueve días». Toyota perdió unos 72.000 vehículos, que en mayo decía tener casi recuperados con horas extra y turnos adicionales, y dio a sus proveedores una gratificación de unos 100 millones de dólares. Los proveedores, contó uno de ellos, no preguntaron cuánto iban a cobrar: confiaban en que se les pagaría.
Lo más interesante del caso es lo que Toyota decidió después. Tras analizarlo, mantuvo a Aisin como proveedor casi único, porque tener varios proveedores para esa pieza le costaba demasiado: «Hemos vuelto a aprender que nuestro sistema funciona», dijo un directivo. Sí redujo las variantes de la pieza, que habían complicado la recuperación, y Aisin escribió una guía de recuperación de emergencias con todo lo que había ocurrido desde el primer día. Para Sheffi, el caso es la mejor demostración de que un proveedor único no es frágil por sí mismo si la relación es profunda y si la red que lo rodea tiene conocimiento y confianza para improvisar. Nishiguchi y Beaudet añaden un matiz importante: la respuesta se coordinó casi sin mando central, gracias a las relaciones densas entre los propios proveedores, no solo entre cada uno de ellos y Toyota.
Dell frente a Apple, Land Rover y los puertos de la costa oeste: gestionar la demanda, el contrato y las alternativas
El libro cuenta decenas de casos más cortos. Tres de ellos completan el mapa de palancas porque ilustran, cada uno, algo distinto: la gestión de la demanda, el contrato con el proveedor y la capacidad de sustituir una ruta por otra.
Dell y Apple tras el terremoto de Taiwán (1999): vender lo que se tiene
El 21 de septiembre de 1999, el terremoto de Chi-Chi, el más grave en décadas en Taiwán, cortó la electricidad de los parques industriales donde se fabricaba buena parte de la memoria, las placas y las pantallas de los ordenadores del mundo. Según Sheffi y Rice, Apple no pudo cambiar las configuraciones de los iBook y los Power Mac G4 que ya tenía comprometidas, intentó enviar equipos con procesadores más lentos, recibió una avalancha de quejas y vio caer sus ventas ese trimestre. Dell, con solo unos cinco días de inventario y su modelo de venta directa, usó precios y recomendaciones de sus vendedores para llevar a los clientes hacia los equipos que sí podía montar, lo que Sheffi llama «vender lo que se tiene» (sell what you have).
El libro dice que Dell aumentó sus beneficios del trimestre un 41 %. Las cuentas de Dell matizan el dato: según su informe trimestral, lo que creció un 41 % fueron los ingresos, mientras que el beneficio neto bajó un 25 % por un cargo extraordinario ajeno a la crisis, y el margen bruto cayó 2,3 puntos por «un aumento inesperado y significativo del coste de la memoria». Y las de Apple también: su informe anual atribuye la falta de procesadores G4 a Motorola, no al terremoto, que solo afectó a los proveedores de portátiles en la última semana del trimestre. La lección de Sheffi sobre la gestión de la demanda sigue en pie, pero el caso es menos limpio de lo que cuenta el libro, y tiene un detalle que hoy resulta familiar: lo que golpeó a Dell fue el precio de la memoria.
Land Rover y UPF-Thompson (2001): el proveedor único sin contrato
UPF-Thompson fabricaba desde los años cincuenta los bastidores de Land Rover y era el proveedor único del chasis del Discovery, unos 70.000 al año. En diciembre de 2001 entró en suspensión de pagos por deudas ajenas a Land Rover, y el administrador concursal, KPMG, cuya obligación legal era sacar el máximo valor de los activos de la empresa, consideró que la dependencia de su cliente era uno de ellos. Antes de seguir sirviendo exigió unos 45 millones de libras, de ellos 35 en concepto de fondo de comercio, cuando el contrato valía unos 16 millones al año. El presidente de Land Rover habló de un intento de tener a su empresa «como rehén».
Sin bastidores, Land Rover habría tenido que parar el Discovery durante meses, hasta nueve según Sheffi y Rice, y hasta seis según dijo entonces su presidente, mientras otro fabricante preparaba utillajes nuevos; estaban en juego unos 1.400 empleos en su planta de Solihull y miles más en otros proveedores. Land Rover consiguió una orden judicial para mantener el suministro y acabó cerrando un acuerdo por unos 15 o 16 millones de libras, según la prensa británica. El fallo de fondo, según el libro, es que no había un contrato escrito ni un acuerdo sobre la propiedad de los utillajes, que había pagado la propia Land Rover. Es la lección más directamente aplicable a una pyme de todo el libro, y la que la empresa del caso aplicó a su montador de placas.
El cierre de los puertos de la costa oeste de Estados Unidos (2002): quien se preparó, sustituyó
El 27 de septiembre de 2002, en pleno conflicto con el sindicato de estibadores, la patronal portuaria cerró los 29 puertos de la costa oeste de Estados Unidos, por donde pasaba el 42 % de su comercio marítimo. Los muelles reabrieron el 9 de octubre por orden judicial, y despejar los atascos llevó semanas. Es el ejemplo del libro de una disrupción sistémica, que no afecta a una empresa sino a todas a la vez. NUMMI, la fábrica que Toyota y General Motors compartían en California, tardó cuatro días en tener que parar, trajo piezas en avión, recuperó la semana perdida y terminó el año con ventas récord.
Del cierre circula una cifra que conviene manejar con cuidado: unos 2.000 millones de dólares diarios de pérdidas para la economía estadounidense. Salió de un estudio encargado por la propia patronal, parte interesada en el conflicto, y un análisis posterior de Peter Hall concluyó que estaba muy inflada porque suponía que nadie podía sustituir nada. En la realidad, las empresas adelantaron importaciones en los meses de tensión, cambiaron de puerto o de medio de transporte, y la carga aérea de Estados Unidos creció un 19 % en octubre. Según una encuesta de la época, solo el 44 % de los responsables de cadena de suministro tenía un plan de contingencia. El dato que debilita la cifra refuerza la tesis de Sheffi: quien se había preparado, sustituyó.
De Fukushima a la escasez de chips (2011-2023): la redundancia selectiva de Toyota y la flexibilidad de diseño de Tesla
Seis años después del libro, el terremoto y el tsunami del 11 de marzo de 2011 en Japón pusieron a prueba sus ideas a una escala que nadie había previsto. Una de las plantas dañadas fue la de Renesas en Naka, que fabricaba microcontroladores para automóvil, unos chips que gobiernan desde el motor hasta los elevalunas; se le atribuía en torno al 40 % del mercado mundial de ese tipo de chips, aunque la cifra varía según la fuente. Toyota tardó unas tres semanas en saber qué proveedores y qué piezas estaban afectados, y su producción estuvo parada dos semanas y reducida durante meses. Los fabricantes de automóviles enviaron miles de técnicos a Naka para ayudar a reconstruirla, en una versión a gran escala del caso Aisin, y la planta volvió a producir en junio.
Ese mismo otoño, las inundaciones de Tailandia anegaron los polígonos donde se fabricaba buena parte de los discos duros del mundo y algunas piezas de automoción. Western Digital tuvo su planta principal bajo dos metros de agua hasta finales de noviembre, los precios de los discos se dispararon durante semanas y Honda tuvo su fábrica de Ayutthaya parada durante meses. 2011 fue el año en que la industria descubrió que su vulnerabilidad no estaba en sus proveedores directos, sino en los proveedores de sus proveedores, y es el año que llevó a Sheffi a escribir su segundo libro.
Toyota sacó dos lecciones de 2011 que funcionaron diez años después. La primera fue la detección: a partir de 2013 construyó con sus proveedores una base de datos llamada RESCUE que cartografía, pieza a pieza, quién fabrica qué y dónde, hasta los proveedores de segundo y tercer nivel. Según su responsable de compras, el sistema redujo el tiempo para localizar el origen de un problema «de dos semanas a solo doce horas». La segunda fue una redundancia selectiva: Toyota pidió a sus proveedores de chips que mantuvieran reservas de entre dos y seis meses para sus pedidos, no de todo, sino de los componentes de reposición más lenta.
La escasez de semiconductores que empezó a finales de 2020 puso las dos lecciones a prueba. Durante el confinamiento, los fabricantes de automóviles cancelaron pedidos de chips; las fundiciones dieron esa capacidad a la electrónica de consumo, y cuando la demanda de coches volvió no había hueco. La consultora AlixPartners previó en septiembre de 2021 que la industria dejaría de facturar unos 210.000 millones de dólares ese año y de fabricar 7,7 millones de vehículos; son ingresos no facturados según una previsión, no pérdidas, como a veces se publica. Toyota mantuvo casi intacta su producción durante la primera mitad de 2021 mientras otros paraban, y ese año vendió en Estados Unidos más vehículos que General Motors, la primera vez que GM no lideraba ese mercado desde 1931, aunque en buena parte porque las ventas de GM cayeron por la falta de chips.
El colchón compró meses, no inmunidad. En agosto de 2021, Toyota anunció un recorte de alrededor del 40 % de su producción mundial de septiembre, por los chips y por los confinamientos en el sudeste asiático. Algunos resúmenes dicen que «evitó los recortes durante tres trimestres» o que «sus reservas duraron dieciocho meses»; ninguna de las dos cosas es cierta. Lo que el caso demuestra es exactamente lo que dice Sheffi: la redundancia da tiempo, pero se agota, y solo tiene sentido si ese tiempo se usa para activar otra cosa.
Tesla eligió el otro camino. En la presentación de resultados de julio de 2021, Elon Musk lo explicó así: «Pudimos sustituir chips alternativos y después escribir el firmware en cuestión de semanas. No es solo cambiar un chip. También hay que reescribir el software». Con una arquitectura electrónica más centralizada y el software en casa, Tesla podía cambiar de componente sin depender de que un proveedor rediseñara su módulo, y entregó 936.222 vehículos en 2021, un 87 % más que el año anterior. Musk añadió otro detalle que Sheffi habría subrayado: Tesla nunca redujo sus previsiones de compra a los proveedores durante la pandemia, así que no perdió su sitio en la cola. La cifra de «diecinueve variantes de controladores» que circula en algunos resúmenes no aparece en ninguna de sus presentaciones de 2021.
Toyota y Tesla son, por tanto, dos respuestas legítimas a la misma crisis: redundancia dirigida a lo crítico, apoyada en un buen mapa, frente a flexibilidad de diseño, apoyada en capacidad de ingeniería propia. Ninguna es trasladable sin más a una pyme, pero las dos lo son en su lógica. La primera se traduce en saber qué componentes tienen plazos de reposición largos y guardar más de esos, no de todo. La segunda, en diseñar los productos para que un componente se pueda sustituir por otro equivalente, que es lo que la empresa del caso empezó a hacer con sus pantallas.
Ever Given, mar Rojo y Baltimore: los cuellos de botella logísticos y el valor de tener rutas alternativas
Una parte de la vulnerabilidad de cualquier empresa está en infraestructuras que no controla: canales, estrechos, puertos y puentes por los que pasa lo que compra o lo que vende. Los últimos cinco años han ofrecido tres casos de manual y un cuarto que sigue abierto.
El 23 de marzo de 2021, el portacontenedores Ever Given encalló en diagonal en el canal de Suez durante una tormenta de arena y lo bloqueó seis días, con unos 400 buques esperando al final. Se suele citar que el bloqueo costaba 9.600 millones de dólares al día, pero esa cifra, estimada por Lloyd’s List, es el valor de las mercancías que pasan cada día por el canal, no lo que se perdía: casi toda esa carga llegó, con retraso. El impacto real fue más largo que el bloqueo, porque los barcos llegaron a Europa en oleadas y congestionaron los puertos durante semanas, y algunos cargadores lo sufrieron durante meses: el propio Ever Given, retenido por Egipto hasta llegar a un acuerdo, llegó a Róterdam con 129 días de retraso. Para una empresa con unas semanas de stock y un cliente informado, seis días de bloqueo son una molestia; para una que trabaja sin colchón, una crisis.
El caso del mar Rojo es más largo y más instructivo. Desde finales de 2023, los ataques de los hutíes de Yemen contra buques mercantes llevaron a casi todas las grandes navieras, empezando por Maersk en diciembre de 2023, a desviar sus barcos por el cabo de Buena Esperanza, con diez a catorce días más de viaje entre Asia y Europa. En enero de 2024, Tesla paró dos semanas la mayor parte de su fábrica de Berlín y Volvo tres días la de Gante por falta de piezas. Maersk calculó que el desvío restaba entre un 15 % y un 20 % de capacidad al conjunto del sector en esas rutas, porque los mismos barcos tardaban más en cada vuelta, y tuvo que alquilar más de 125.000 contenedores adicionales: redundancia comprada a precio de crisis.
Lo que convierte el caso en una lección es su duración. A principios de 2026, tras el alto el fuego en Gaza, Maersk y Hapag-Lloyd empezaron a volver a Suez, y semanas después la guerra entre Estados Unidos, Israel e Irán les obligó a desviarse otra vez. En septiembre de 2026 volvieron a pasar parte de sus servicios por Suez, con la reserva de regresar al Cabo buque a buque si la situación empeora. Casi tres años después, la «primera respuesta» se ha convertido en el modo normal de operar, y esa es una categoría que Sheffi trató en su segundo libro: disrupciones que no se recuperan, sino que obligan a rediseñar. La misma guerra paralizó casi por completo el tránsito por el estrecho de Ormuz, por donde pasa en torno a una quinta parte del petróleo y del gas natural licuado que se comercia en el mundo, y en septiembre seguía habiendo restricciones; el golpe llegó incluso al helio que necesitan las fábricas de chips, aunque los contratos largos y las reservas de los fabricantes han evitado, por ahora, recortes de producción confirmados.
El tercer caso es el más rápido. En la madrugada del 26 de marzo de 2024, el portacontenedores Dali perdió la propulsión y chocó contra el puente Francis Scott Key de Baltimore, que se derrumbó y mató a seis trabajadores. El canal de acceso al puerto, el primero de Estados Unidos en movimiento de automóviles, quedó bloqueado, y no se reabrió del todo hasta el 10 de junio, once semanas después. Los buques de carga rodada se desviaron a otros puertos de la costa este, como Brunswick, Norfolk o Nueva York-Nueva Jersey. Quien ya tenía contratos o relaciones con varias terminales desvió antes: es la intercambiabilidad de instalaciones de Sheffi aplicada a los puertos.
Para una pyme española que importa componentes de Asia o exporta por un solo puerto, la pregunta útil de estos casos es sencilla: ¿por qué puerto, aeropuerto o carretera entra lo que compramos, y qué haríamos si se cerrara un mes? En la empresa del caso, la respuesta reveló que las pantallas llegaban todas en barco a Valencia, con dos semanas de viaje adicional desde que empezaron los desvíos, y que el distribuidor no había avisado de que había alargado sus plazos por eso.
Concentración oculta en la cadena de suministro: Spruce Pine, Baxter tras el huracán Helene y la crisis de Nexperia
Los casos más inquietantes de los últimos años no son los más espectaculares, sino los que revelan que una parte enorme de algo esencial dependía de un solo sitio que casi nadie conocía. Es la «vulnerabilidad oculta en la eficiencia» llevada a escala de sector: cada empresa había comprado a quien mejor y más barato fabricaba, y la suma de todas esas decisiones razonables había concentrado el riesgo en un punto.
Huracán Helene (2024): el cuarzo de Spruce Pine y el suero de Baxter
A finales de septiembre de 2024, el huracán Helene provocó inundaciones históricas en el oeste de Carolina del Norte, y en el mismo valle quedaron bajo el agua dos puntos únicos de fallo. El primero era Spruce Pine, un pueblo donde dos empresas extraen y purifican un cuarzo de pureza excepcional con el que se fabrican los crisoles en los que se funde el silicio de las obleas. Según el periodista Vince Beiser, entre el 70 % y el 90 % de esos crisoles del mundo se hacen con cuarzo de Spruce Pine; es una estimación de un autor, no de la industria, y se refiere a los crisoles, no a «los chips del mundo», como se ha llegado a publicar. Las dos empresas pararon antes del huracán, y una de ellas, Sibelco, anunció dos semanas después que volvía a producir. No hubo escasez visible de chips, porque había stock de cuarzo y de crisoles en la cadena: el punto único de fallo existía, pero los colchones intermedios lo absorbieron.
El segundo caso tuvo consecuencias mucho más visibles. La planta de Baxter en North Cove, la mayor de la empresa en el mundo, fabricaba más de un millón de bolsas de suero intravenoso al día, en torno al 60 % del que se usa en Estados Unidos, según la Asociación Americana de Hospitales. La rotura de un dique inundó la planta y destruyó los puentes de acceso. Baxter había activado su plan de huracanes, parado la planta, evacuado a la plantilla y llevado el producto terminado a terreno alto, y en las primeras 48 horas impuso cuotas a sus clientes para estirar el inventario. Lo que vino después, según la cronología que publicó la propia empresa, es casi un ejemplo de manual de las ocho fases de Sheffi.
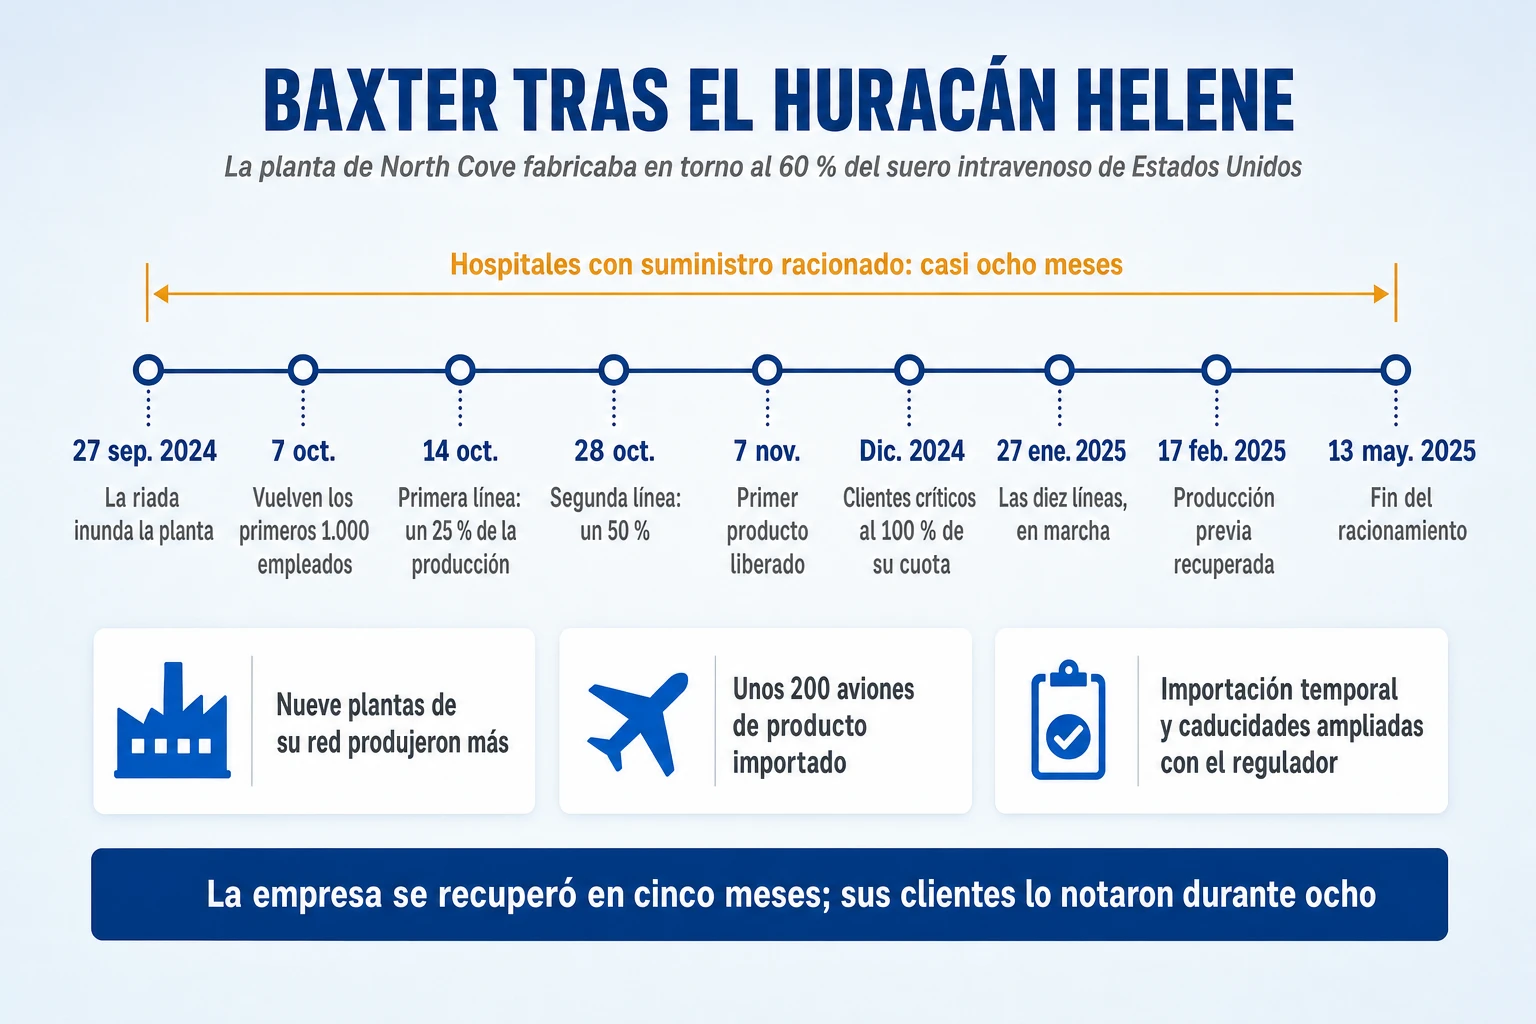
La primera línea volvió a producir a mediados de octubre, con una cuarta parte de la capacidad; las diez líneas estaban en marcha a finales de enero, y la producción anterior al huracán se recuperó a mediados de febrero de 2025, «menos de cinco meses después». Mientras tanto, Baxter activó nueve plantas de su red en otros países, trajo unos 200 aviones de producto y consiguió que el regulador autorizara importaciones temporales y ampliara la caducidad de más de 50 referencias: intercambiabilidad de instalaciones y colaboración con la administración, las dos palancas del libro. Pero las cuotas a los hospitales no se retiraron hasta el 13 de mayo de 2025, casi ocho meses después, y en ese tiempo se cancelaron operaciones programadas y se racionó el suero. Es la diferencia entre la recuperación de una empresa y la de sus clientes, que el perfil de Sheffi permite ver.
La concentración, además, era conocida: Estados Unidos ya había sufrido escasez de suero en 2017, tras el huracán María en Puerto Rico, donde Baxter también tenía plantas. Fue un casi incidente a escala de país que no se corrigió, exactamente el tipo de aviso que Sheffi propone tomarse en serio.
Nexperia (2025-2026): un chip de céntimos que puede parar una fábrica de coches
Si hay un caso que repite el de Albuquerque veinticinco años después, es el de Nexperia. Esta empresa con sede en Nimega, en los Países Bajos, procede de la antigua división de semiconductores de Philips, la misma empresa del incendio de 2000, y desde 2019 es propiedad del grupo chino Wingtech. Fabrica chips discretos y lógicos básicos, diodos y transistores que cuestan céntimos y que están en casi todas las centralitas de un coche, y una parte importante de su producción se encapsulaba y probaba en su planta de Dongguan, en China.
El 30 de septiembre de 2025, el Gobierno neerlandés tomó el control de la empresa con una ley de disponibilidad de bienes que no se aplicaba desde 1952, alegando graves deficiencias de gobierno y el riesgo de que su tecnología saliera del país. El 4 de octubre, China prohibió exportar los productos de Nexperia fabricados en su territorio. La patronal europea del automóvil avisó de que las paradas podían estar «a días» y de que homologar chips alternativos y subir su producción llevaría varios meses; a finales de octubre, Honda paró su planta mexicana de Celaya y redujo a la mitad la de Ontario. Tras el acuerdo comercial entre Estados Unidos y China de finales de octubre, Pekín se comprometió a reanudar las exportaciones y el Gobierno neerlandés suspendió su orden en noviembre, pero la disputa por el control siguió en los tribunales, que en febrero de 2026 ordenaron una investigación formal de la empresa.
El caso reúne casi todas las ideas del libro. Los fabricantes de coches no compraban a Nexperia: compraban a Bosch, Continental o ZF, que compraban a Nexperia, así que muchos descubrieron su dependencia del segundo o tercer nivel cuando el suministro ya estaba en riesgo, como Ericsson en 2000. El criterio para priorizar no era el precio de la pieza, sino el impacto de su falta: un diodo de céntimos con un solo proveedor homologado vale lo que vale el coche entero. Había alternativas técnicas, pero homologarlas en automoción lleva meses, y la flexibilidad que no se ha preparado antes no existe cuando hace falta. Y la disrupción fue geopolítica, sin ningún daño físico: la fábrica funcionaba, pero el producto no podía salir. Los controles chinos a la exportación de tierras raras de 2025, que obligaron a Ford a parar una semana su planta de Chicago por falta de imanes, siguen la misma lógica; su consejero delegado lo resumió diciendo que el suministro se decidía «día a día», con licencias aprobadas «una a una».
Disrupciones digitales: CrowdStrike y Delta, Jaguar Land Rover y Marks & Spencer, el riesgo que el libro no podía ver
En 2005, Sheffi trataba la informática sobre todo como herramienta de detección y las copias de seguridad como la redundancia más barata. Veinte años después, el punto único de fallo de muchas empresas ya no es una fábrica ni un proveedor, sino un sistema: el ERP que lo gestiona todo, cuya implantación ya es por sí misma un riesgo serio, como se cuenta en el artículo sobre grandes fracasos en la implantación de ERP; el programa que se instala en todos los ordenadores o el proveedor de servicios informáticos que tiene las llaves de la red. El marco del libro sigue sirviendo para analizarlo, y los casos recientes lo demuestran.
El 19 de julio de 2024, una actualización defectuosa del programa de seguridad Falcon, de CrowdStrike, bloqueó unos 8,5 millones de ordenadores con Windows en todo el mundo, según Microsoft, menos del 1 % del total, pero concentrados en aerolíneas, hospitales y bancos. Todas las grandes aerolíneas estadounidenses cayeron ese día, y la mayoría se recuperó en uno o dos. Delta tardó cinco. Su problema no fueron los ordenadores, que se restauraron en horas, sino su sistema de asignación de tripulaciones, que quedó desincronizado: miles de tripulantes no podían ser localizados ni reasignados. Según la comunicación de Delta a la SEC, canceló unos 7.000 vuelos en cinco días, perdió 380 millones de dólares de ingresos y gastó 170 millones más, sobre todo en compensaciones y tripulaciones. Es el caso Nokia-Ericsson en versión digital: el mismo evento para todos y recuperaciones muy distintas, decididas por un sistema interno que nadie había mirado como crítico.
El caso más caro de la historia británica llegó en 2025. A principios de septiembre, Jaguar Land Rover detectó un ciberataque y decidió apagar todos sus sistemas en todo el mundo, una primera respuesta correcta para contener el daño que, a cambio, paró sus fábricas del Reino Unido, Eslovaquia, Brasil e India durante más de cinco semanas, hasta el reinicio escalonado del 8 de octubre. Según sus resultados, los ingresos del trimestre cayeron un 24 % y los costes directos del ataque sumaron 196 millones de libras. Pero la parte más instructiva es la de los proveedores: cientos de pymes de las Midlands se quedaron sin pedidos ni cobros, JLR tuvo que adelantar una línea de financiación de 500 millones para pagarles, y el Gobierno británico garantizó un préstamo de 1.500 millones. Un organismo independiente estimó el coste para la economía británica en unos 1.900 millones de libras y más de 5.000 organizaciones afectadas.
El mismo año, un ataque que entró por un proveedor de servicios externo obligó a Marks & Spencer a suspender su venta en línea durante casi dos meses. Conviene leer bien sus cifras, porque ilustran la regla de preguntar siempre qué mide cada número: los 300 millones de libras que circularon eran la estimación inicial del impacto en el beneficio operativo del ejercicio; los costes directos fueron unos 136 millones, y la empresa reclamó 100 a su seguro. Asahi, en Japón, tuvo que volver a tomar pedidos por fax y teléfono tras otro ataque, y en 2022 el ataque a Kojima Industries, un proveedor de piezas de plástico, había parado durante un día las catorce plantas japonesas de Toyota: el caso Aisin en versión digital, con la diferencia de que, sin sistema de pedidos, ya no había planos que repartir.
Frente a estos casos, la mejor práctica preventiva que se ha documentado es la de las empresas que provocan fallos controlados para descubrir sus debilidades antes de que lo haga un atacante. La gestora de fondos Vanguard, por ejemplo, combina un análisis de modos de fallo simplificado con experimentos que apagan deliberadamente partes de sus sistemas, según contó junto a Amazon Web Services en 2022; no publicó resultados medidos, así que es un método, no una prueba de eficacia. Para una pyme, la traducción es más modesta y casi gratuita: restaurar de verdad una copia de seguridad una vez al trimestre y saber qué sistema hay que levantar primero. Lo que retrasó a Delta no fue recuperar los ordenadores, sino volver a poner en orden el sistema que asignaba las tripulaciones.
Empresas que se adaptaron a la disrupción: Inditex en 2020, TSMC en 2024 y lo que tienen en común
No todos los casos posteriores son de vulnerabilidad. Dos de los mejores ejemplos de las ideas del libro son de empresas que ya figuraban en él o en su entorno, y que demostraron que la capacidad de recuperarse se había construido años antes, y casi siempre por otros motivos.
Zara aparece en el libro como ejemplo de cultura y de rapidez. En 2020, la pandemia cerró durante semanas buena parte de las tiendas de Inditex en todo el mundo, y sus ventas totales cayeron un 24,5 % a tipo de cambio constante. Pero sus ventas en línea crecieron un 77 %, hasta 6.600 millones de euros, y 1.200 millones de esas ventas se sirvieron con prendas que estaban en las tiendas, gracias a un sistema de inventario único que integra el stock de tiendas y almacenes y a las etiquetas de radiofrecuencia que llevaban todas sus prendas. La tienda cerrada se convirtió en almacén.
Lo importante para la tesis de Sheffi es por qué existía ese sistema. Inditex no lo había desplegado para resistir una pandemia, sino para vender más y rebajar menos: saber en todo momento dónde está cada prenda reduce las roturas de stock y los saldos. Es el beneficio colateral en estado puro, una inversión que se pagaba en el día a día y que, el día de la crisis, permitió atender a los clientes por otra vía. Y es también un recordatorio de proporción: la flexibilidad amortiguó el golpe, pero no salvó el año, porque la empresa perdió una cuarta parte de sus ventas.
TSMC, el mayor fabricante de chips del mundo, permite comparar a la misma empresa ante dos terremotos separados por veinticinco años. Tras el de Chi-Chi, en 1999, TSMC comunicó cinco días después que el 20 % de sus equipos de fabricación había vuelto a producir; Sheffi y Rice destacan que abrió una línea de atención a clientes las 24 horas solo siete horas después del seísmo. Tras el terremoto de Hualien del 3 de abril de 2024, el más fuerte en Taiwán en 25 años, TSMC informó de que en diez horas había recuperado más del 70 % de sus equipos, más del 80 % en sus fábricas nuevas, y de que sus máquinas de litografía más críticas no habían sufrido daños; al tercer día la recuperación era completa. Perdió las obleas que estaban en proceso, unos 3.000 millones de dólares taiwaneses una vez descontado el seguro, y medio punto de margen bruto en el trimestre siguiente.
Pasar del 20 % en cinco días al 70 % en diez horas es exactamente el aprendizaje institucional que pide el libro: diseño antisísmico de las fábricas, aislamiento de los equipos, protocolos y simulacros periódicos. La resiliencia de TSMC no eliminó las pérdidas, las acotó: otro terremoto en enero de 2025 le costó cerca del doble. Y el caso tiene un reverso que conviene no olvidar. Una empresa puede ser extraordinariamente resiliente por dentro y ser, al mismo tiempo, uno de los mayores puntos únicos de fallo de la economía mundial, porque buena parte de la fabricación de chips avanzados está concentrada en una sola isla.
Un tercer caso de 2020 se cita a menudo y conviene situarlo bien. En marzo de ese año, LVMH convirtió sus fábricas de perfumes y cosméticos de Dior, Guerlain y Givenchy para producir gel hidroalcohólico y donarlo a los hospitales franceses. Demuestra flexibilidad de procesos, porque las líneas de mezcla y envasado de líquidos se pueden reutilizar con pocos cambios, pero fue un gesto de responsabilidad, no una estrategia de continuidad del propio negocio. Lo que tienen en común los tres casos es que la capacidad que usaron en la crisis ya existía antes de ella.
La DANA de Valencia y el apagón de 2025: lo que enseñan a una pyme española sobre la resiliencia
Los dos casos más cercanos al lector de este artículo no son de grandes multinacionales. Son dos disrupciones que golpearon a miles de pymes españolas en menos de seis meses, y de las que hay datos suficientes para sacar conclusiones.
La DANA de octubre de 2024: la planta grande se salvó y sus proveedores no
El 29 de octubre de 2024, la DANA inundó buena parte del sur de la comarca de Valencia. Según la Cámara de Comercio de Valencia, en los 24 municipios de la «zona cero» había 2.386 empresas industriales y 57 polígonos con daños graves, el 81 % de las empresas industriales afectadas eran microempresas, y los daños directos en las actividades económicas de los 87 municipios afectados superaron los 13.000 millones de euros, de ellos unos 4.500 en la industria.
El caso del automóvil es el más pedagógico. La fábrica de Ford en Almussafes no sufrió daños, pero sí «una parte significativa de sus proveedores», instalados a pocos kilómetros en polígonos inundados, con daños estimados en más de 1.100 millones de euros en el sector. Ford tuvo que parar por falta de piezas, con un expediente de regulación temporal de empleo por fuerza mayor, y volvió a parar del 20 al 26 de noviembre. En enero de 2025, más de la mitad de los 12.865 trabajadores en expediente temporal por la DANA en la industria de la provincia eran de la fabricación de vehículos. Es la paradoja de la eficiencia en versión geográfica: la cercanía de los proveedores que hace posible el suministro secuenciado justo a tiempo concentra también el riesgo de que una misma inundación los pare a todos.
El balance de la Cámara un año después añade la lección más útil para una pyme. En octubre de 2025, el 85 % de las empresas industriales de la zona cero estaba activo y alrededor del 6 % había cerrado por la riada; los comercios estuvieron cerrados una media de doce semanas para reparar, y uno de cada cinco seguía cerrado a causa de la riada. El 80 % de las industrias necesitó financiación externa para reactivarse, y la primera causa de los cierres fue la falta de tesorería. Las empresas con más «pulmón financiero», dice la Cámara, se recuperaron antes. La holgura de caja es la redundancia que Sheffi apenas trata y que, para una pyme, decide más que ninguna otra.
El apagón del 28 de abril de 2025: una infraestructura compartida como punto único de fallo
A las 12:33 del 28 de abril de 2025, la España peninsular y Portugal se quedaron sin electricidad. Según el informe de los gestores de red europeos, ENTSO-E, la red de transporte española estaba repuesta hacia las cuatro de la madrugada y la de distribución hacia las siete, unas quince y dieciocho horas después. Su informe final, de marzo de 2026, concluye que no hubo una causa única, sino una combinación de factores relacionados con el control de la tensión y las desconexiones en cascada de generación. Algunas industrias tardaron hasta 22 horas en recuperar el suministro, y las que trabajan con hornos o procesos continuos, varios días en volver a producir.
Las estimaciones de su coste para la economía van de menos de 400 a unos 1.600 millones de euros, según quién las haga, y todas son preliminares. Lo útil del apagón para una pyme no es esa cifra, sino las preguntas que obliga a hacerse, y que son las del tiempo de supervivencia: ¿cuántas horas aguanta la empresa sin luz y sin conexión?, ¿pierde producto en curso o en frío?, ¿sabe cobrar sin terminal de pago?, ¿quién decide mandar a la gente a casa? Es una disrupción de probabilidad imposible de estimar y de consecuencias muy distintas según el sector, el tipo de amenaza para la que el propio Sheffi acabó recomendando prepararse por los efectos y no por las causas.
La crisis de memorias y procesadores de 2025-2026: qué está pasando, por qué y hasta cuándo
Para entender la crisis actual conviene empezar por su punto de partida. En 2023, la memoria vivió su peor año en una década, los fabricantes recortaron producción e inversión, y a finales de 2024 los precios todavía bajaban: la consultora TrendForce, la referencia del sector, preveía para el primer trimestre de 2025 caídas de entre el 8 % y el 13 % en el precio de contrato de la memoria DRAM, la que usan como memoria de trabajo ordenadores, servidores y móviles. En menos de un año, el mismo mercado pasó de sobrarle memoria a no tener suficiente.
La causa no fue un incendio ni un terremoto. Fue la inteligencia artificial. Los grandes proveedores de nube, que construyen centros de datos a un ritmo sin precedentes, necesitan dos tipos de memoria: la de alto ancho de banda, conocida como HBM, que va pegada a los procesadores de IA, y enormes cantidades de memoria convencional para servidores. Los tres grandes fabricantes, Samsung, SK hynix y Micron, que suman en torno al 90 % de la facturación mundial de DRAM, dedicaron su capacidad a esos productos, que pagan más, «expulsando», en palabras de TrendForce, la capacidad destinada a ordenadores, móviles y electrónica de consumo. Además, la HBM necesita unas tres veces más obleas que la memoria convencional para producir la misma cantidad de bits, según Micron, así que cada oblea que pasa a la IA resta mucho más de lo que parece.
Los avisos llegaron durante 2025. En primavera, los fabricantes anunciaron el fin de la memoria DDR4, la de los equipos de los últimos años, y en julio un módulo DDR4 ya costaba más que uno DDR5. En septiembre, los plazos de entrega de los discos duros para centros de datos pasaron de unas semanas a más de un año, SanDisk subió sus precios y Micron dejó de dar cotizaciones. El 1 de octubre, OpenAI firmó cartas de intención con Samsung y SK hynix para su proyecto Stargate que hablaban de una demanda potencial de hasta 900.000 obleas de DRAM al mes, una intención y no un pedido. Y en diciembre, Micron anunció que abandonaba su marca de consumo, Crucial, para servir mejor «a sus clientes estratégicos más grandes». El proveedor eligió a sus clientes, y el pequeño no estaba entre ellos.
Los precios de contrato, los que pagan los grandes compradores, respondieron con subidas sin precedentes. Según las notas trimestrales de TrendForce, la DRAM convencional subió entre un 45 % y un 50 % en el último trimestre de 2025 y entre un 93 % y un 98 % en el primero de 2026, un récord histórico. Desde el verano, las subidas trimestrales se han moderado, con un 10 % a 15 % previsto para el último trimestre de 2026, pero sobre una base altísima: componiendo los datos de TrendForce, el precio de contrato a finales de 2026 será del orden de seis veces el de finales de 2024. Cuando un titular de octubre de 2026 dice que los precios de la memoria «se frenan», significa que siguen subiendo, más despacio.
El mercado al contado, donde compran y venden los distribuidores, muestra el golpe con más claridad, porque se adelanta y exagera al de contrato, y es el que más se parece a lo que paga una pyme. El gráfico recoge tres referencias del portal DRAMeXchange: un chip DDR5 de 16 gigabits ha multiplicado su precio por 12,5 en dos años, un chip DDR4 por más de 28, porque es la tecnología que los fabricantes abandonan, y una oblea de memoria NAND, la de los discos SSD, llegó a multiplicarlo por más de ocho antes de empezar a bajar en primavera de 2026, mientras su precio de contrato seguía subiendo.
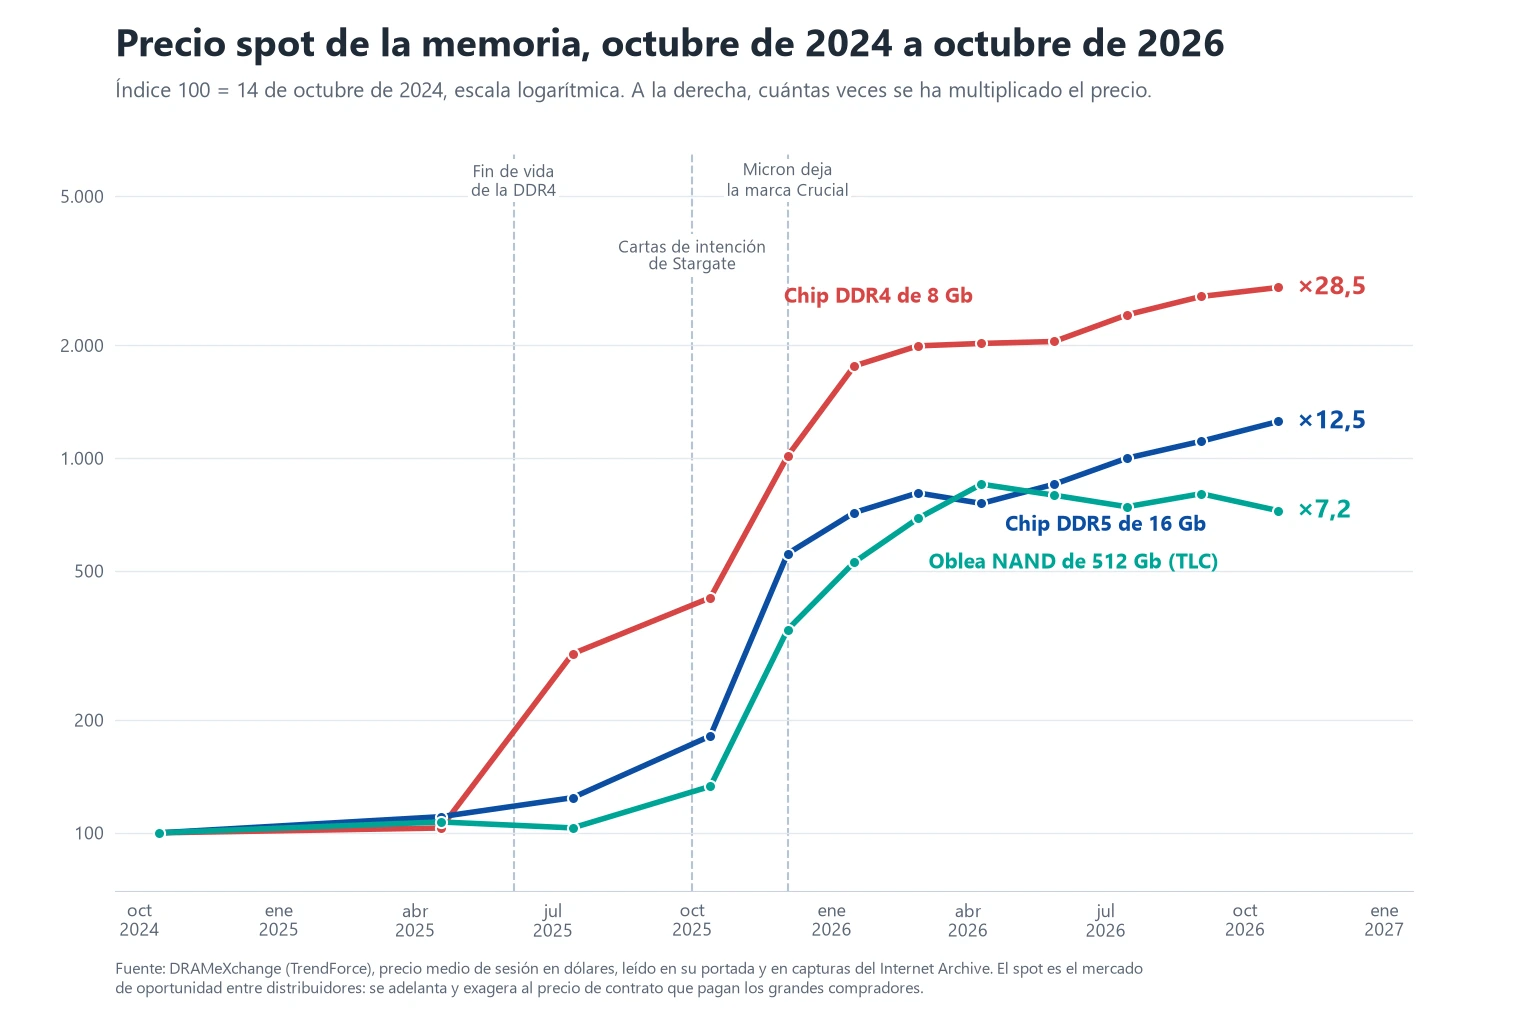
La memoria no es el único componente afectado. TSMC subió en 2026 los precios de sus procesos más avanzados y, según la prensa económica japonesa, prepara subidas de entre el 5 % y el 10 % para 2027 que incluyen procesos maduros, los de los chips «corrientes». Intel subió más de un 15 % algunos procesadores de portátil de gama de entrada. Los plazos de algunos componentes de servidor se acercan a un año, y la memoria de los programas internos de autómatas, routers y equipos industriales duplicó su precio en el primer semestre de 2026, según TrendForce, lo que afecta de lleno a fabricantes de maquinaria como la empresa del caso.
Los efectos llegan a todos los productos que llevan memoria. En un portátil de referencia de 900 dólares, el peso del procesador, la memoria y el disco en el coste de materiales ha pasado del 45 % a principios de 2025 al 68 % en el tercer trimestre de 2026, y TrendForce calcula que para mantener su margen el fabricante tendría que subirlo un 80 %. No lo ha hecho todavía porque está consumiendo inventario comprado barato. IDC prevé que los envíos de ordenadores caigan un 11,3 % en 2026 mientras su valor total sube, y lo resume así: «la era de los ordenadores baratos ha quedado atrás, por ahora». Dell subió precios entre un 15 % y un 20 % en diciembre de 2025, Apple subió toda su gama de portátiles MacBook en julio de 2026, y Sony y Nintendo encarecieron sus consolas.
¿Hasta cuándo? Una fábrica de memoria tarda entre dos y tres años desde que se decide hasta que produce en volumen, y las nuevas no empezarán a contribuir de forma sustancial hasta 2028, según TrendForce. Micron reconoció en septiembre que no tiene visibilidad sobre cuándo volverán a equilibrarse oferta y demanda, e IDC espera cierta relajación de precios desde 2028, sin volver a los niveles de 2025. Ningún análisis serio espera precios normales de memoria antes de 2028; la de los discos SSD podría aflojar antes, desde la segunda mitad de 2027. Y hay un riesgo en sentido contrario que también conviene tener presente: si los grandes proveedores de nube frenan su inversión, el mercado podría girar a la baja de golpe, como en 2023.
Leída con los conceptos de Sheffi, esta crisis tiene dos rasgos que la distinguen de los casos del libro. El primero es que no hay ningún daño físico: es un desplazamiento de capacidad hacia quien paga más, una disrupción provocada por la demanda de otros que se propaga a través de un proveedor común. Sheffi dedicó a este tipo de riesgo un capítulo de su segundo libro, sobre la escasez y los choques de precios. El segundo es que las señales tempranas estaban en el suministro y no en las previsiones: la previsión de TrendForce para el último trimestre de 2025 se multiplicó por cuatro en dos meses, pero los anuncios de fin de la DDR4, los plazos de los discos duros y las cotizaciones suspendidas llevaban meses advirtiéndolo. Quien esperó a que la previsión de precios confirmara el problema compró tarde.
Cómo responden las empresas a la escasez de memoria: inventario, contratos largos, rediseño y gestión de la demanda
Lo más interesante de esta crisis para quien ha leído a Sheffi es que las respuestas de las empresas encajan, una a una, en las palancas del libro, y que la mayoría de los grandes las está usando todas a la vez.
La primera es la redundancia. Lenovo, el mayor fabricante de ordenadores del mundo, reconoció en noviembre de 2025 que tenía en almacén alrededor de un 50 % más de componentes de lo habitual, y los fabricantes de ordenadores siguen comprando agresivamente en 2026 porque esperan que 2027 sea peor. Raspberry Pi tiene varios años de inventario de un tipo antiguo de memoria, y por eso sus modelos más viejos no han subido de precio. Pero la redundancia tiene los costes que describe el libro: el acopio de todos alimentó la propia escasez que se temía, y Michael Dell defiende lo contrario, su modelo de fabricación contra pedido, como protección por si la demanda de IA se hunde, mientras el flujo de caja operativo de su empresa caía un 13 % en el último trimestre. Es el dilema de Sheffi en estado puro: el inventario protege del corte de suministro y expone a la caída de la demanda.
La segunda es la relación con los proveedores, y aquí la crisis ha producido algo nuevo. Los contratos de memoria, que eran anuales o trimestrales, se han convertido en acuerdos de tres a cinco años con los grandes proveedores de nube, con anticipos de entre el 10 % y el 30 % de su valor y bandas de precio con un techo que protege al comprador y un suelo que protege al vendedor. Micron declaró en septiembre que tiene 32.000 millones de dólares en compromisos de clientes, en su mayoría depósitos en efectivo: el cliente financia la fábrica del proveedor a cambio de prioridad. Es la relación profunda con el proveedor que recomienda Sheffi, pero con un precio de entrada que solo pueden pagar los más grandes. TrendForce constata que, desde el verano, las subidas recaen sobre todo en quien no tiene uno de esos contratos.
La tercera es la flexibilidad de diseño. NVIDIA, el mayor comprador de memoria del sector, redujo a la mitad la memoria de uno de los módulos de su próxima plataforma al concluir que seguirá escaseando en 2027; los grandes proveedores de nube han pasado de módulos de servidor de 96 y 128 gigabytes a otros de 32 y 64; los móviles de gama baja vuelven a llevar 4 gigabytes, y HP ha reducido la memoria de algunas configuraciones. Los fabricantes de ordenadores están homologando como segunda fuente a CXMT, el fabricante chino de memoria, y diseñando equipos que puedan llevar procesadores de Intel o de AMD indistintamente. Si el mayor comprador del mundo diseña según la memoria disponible, cualquiera puede hacerlo.
La cuarta es la gestión de la demanda, la versión actual de lo que hizo Dell en 1999. Según Counterpoint, los fabricantes de móviles simplifican sus catálogos y empujan a los compradores hacia sus modelos más caros, donde el coste de la memoria pesa menos. Raspberry Pi ha lanzado versiones con menos memoria y pide abiertamente a sus clientes que no paguen por un margen de memoria que no necesitan. Y algunos fabricantes usan el precio para frenar pedidos y liberar capacidad. El caso de Raspberry Pi tiene además la ventaja de que se puede ver en un gráfico: cuanta más memoria lleva un mismo ordenador, más ha subido su precio, la prueba más limpia de que el problema es la memoria y no el resto del producto.
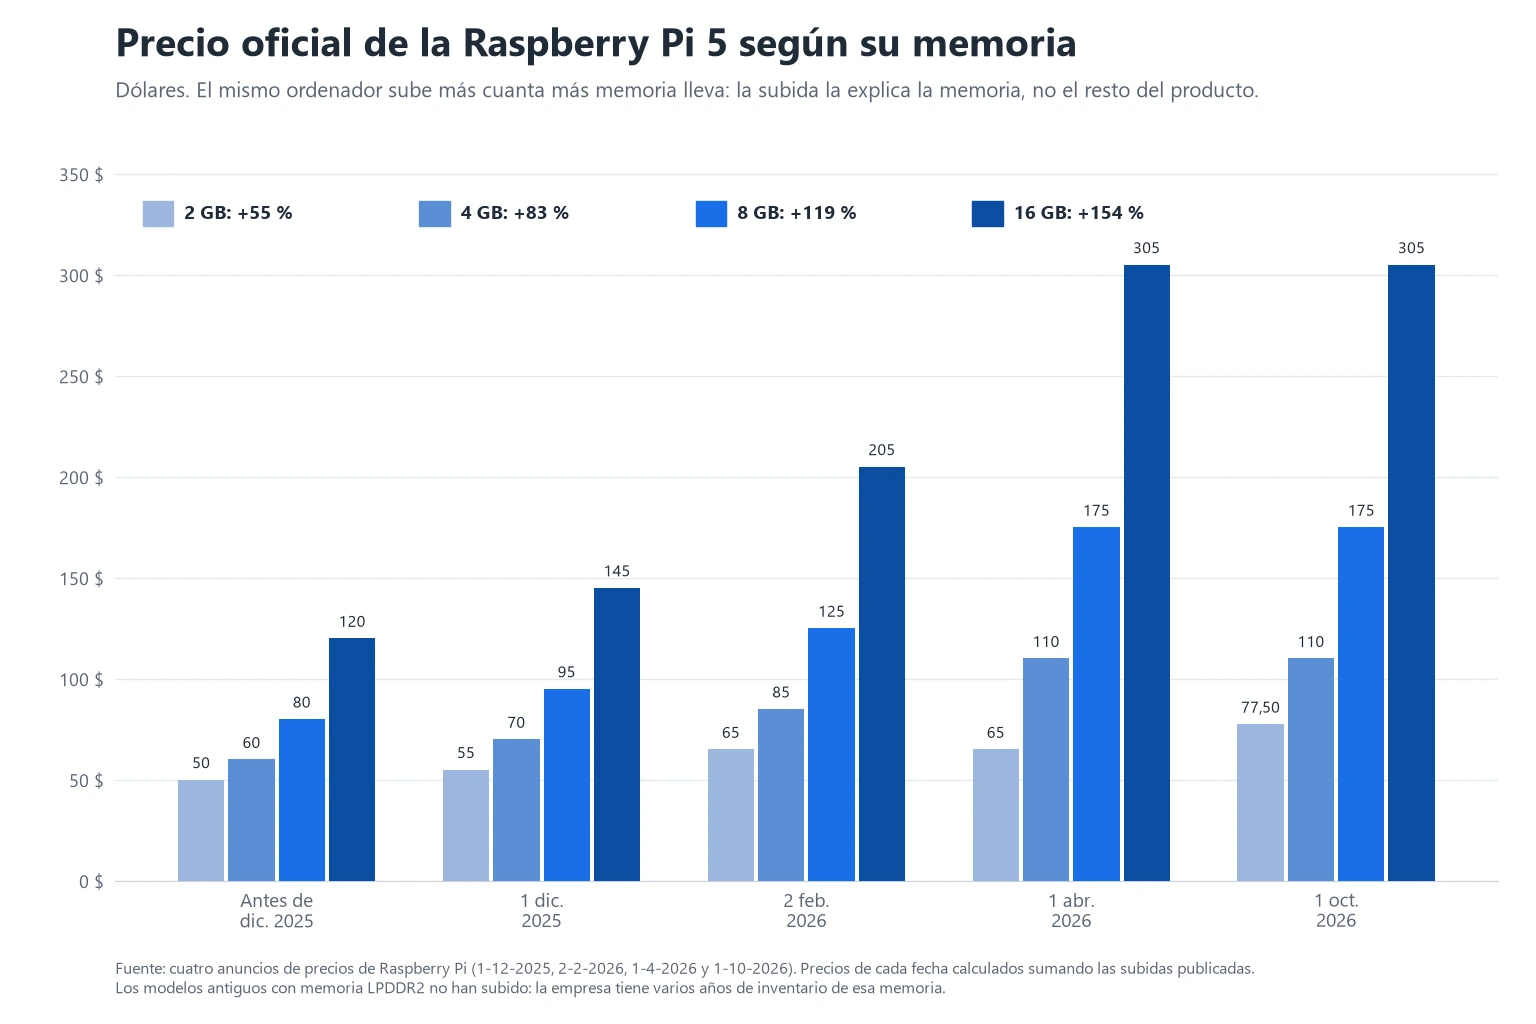
Qué puede hacer una pyme ante la subida de precios de memoria, ordenadores y servidores
La pyme compra al final de esa cadena. No tiene contratos de cinco años ni puede adelantar dinero a un fabricante, y compra a un distribuidor cuyo precio se parece más al del mercado al contado que al de contrato. Por eso es la que soporta antes y con más fuerza las subidas, y la que tiene menos margen de negociación: los fabricantes han reducido la validez de sus ofertas de 30 a 15 días y algunos han advertido de que los pedidos pendientes pueden cambiar de precio según la fecha de envío. Hay una paradoja añadida para quien eligió un proveedor de nube europeo por precio o por soberanía de los datos: OVHcloud y Hetzner subieron sus precios en abril de 2026, mientras que los grandes proveedores estadounidenses, protegidos por sus contratos largos, no habían subido a octubre sus servidores virtuales de uso general.
Las palancas de Sheffi se pueden aplicar a esa escala, con algo de disciplina. La primera es la detección: incluir la memoria y los plazos de entrega en el seguimiento de riesgos, mirar cada trimestre las notas de TrendForce y el precio al contado de DRAMeXchange, que son gratuitos, y pedir al distribuidor que avise de los cambios de plazo. La segunda es la gestión de la propia demanda: especificar los equipos por la necesidad real y no por si acaso, porque cada gigabyte de más es ahora lo más caro del equipo, y comprobar que el modelo «de siempre» no viene ahora con menos memoria por el mismo precio. Gartner recomienda comprar lo necesario con un colchón razonable, en torno a un 30 %, en lugar de acaparar.
La tercera es la estandarización: reducir los modelos de portátil y de servidor a muy pocos, para poder intercambiar piezas y equipos entre puestos y negociar mejor. La cuarta, una redundancia acotada: adelantar a 2026 las renovaciones críticas previstas para 2027, si el presupuesto lo permite, porque las previsiones apuntan a un 2027 más tenso, pero sin llenar el almacén. La quinta es alargar la vida de lo que funciona donde la seguridad lo permita, con reacondicionados para los puestos sencillos o con renting; Gartner prevé que las empresas alarguen un 15 % la vida media de sus ordenadores. Y la sexta, la más importante, es la versión de pyme del contrato largo: comprometerse a uno o tres años con un distribuidor, un proveedor de renting o de nube que sí tenga asignación, pactando por escrito precio y fecha de entrega, porque esa es la única forma que tiene una empresa pequeña de comprar algo parecido a la prioridad de los grandes.
Dos advertencias completan la lista. Los servidores propios son lo más expuesto: un módulo de memoria de 32 gigabytes para servidor ha pasado en el mercado al contado de 395 a 2.185 dólares en once meses, y ampliar un equipo antiguo con memoria DDR4 es especialmente caro. Y las empresas que fabrican productos con electrónica, como la del caso, tienen que revisar sus listas de materiales, porque la memoria de los programas de los equipos industriales también se ha encarecido. En la empresa del caso, el comité tomó tres decisiones: reducir las pantallas a dos modelos compatibles de dos marcas, comprar diez semanas de stock de esos dos modelos con un precio cerrado para todo 2026, y aplazar un año la renovación de los veinte portátiles de oficina mientras adelantaba la de los seis de ingeniería.
Cómo medir la resiliencia: tiempo de recuperación (TTR) y tiempo de supervivencia (TTS)
El libro de 2005 tiene una carencia que el propio Sheffi reconocía en 2006: «no tenemos buenas métricas para los riesgos operativos». Diez años después, otro profesor del MIT, David Simchi-Levi, propuso con sus colegas una forma de medir que hoy es la más usada y que encaja perfectamente con las ideas del libro. Se basa en dos tiempos que cualquier empresa puede estimar para cada uno de sus proveedores, instalaciones o sistemas críticos.
El primero es el tiempo de recuperación (time to recover, TTR): lo que tardaría ese elemento, o su sustituto, en volver a funcionar plenamente tras una disrupción. El segundo es el tiempo de supervivencia (time to survive, TTS): lo que la empresa puede seguir sirviendo a sus clientes sin él, con el inventario en almacén y en camino y con las alternativas que tenga a mano. La regla que los une es sencilla: si el tiempo de supervivencia es mayor que el de recuperación, ese elemento no pone en riesgo a la empresa; si es menor, su caída causará problemas serios salvo que haya un plan alternativo. Hay que actuar donde la recuperación tarda más que la supervivencia.
El método tiene una ventaja decisiva sobre el mapa de probabilidades: no necesita estimar la probabilidad de nada. Se centra en el impacto de que falle un elemento, sea cual sea la causa, porque, como escriben Simchi-Levi y sus colegas, las medidas para mitigarlo son igual de eficaces tanto si la causa es un incendio como una quiebra o un ciberataque. Es la misma idea que Sheffi formuló en su segundo libro cuando propuso prepararse para los efectos y no para las causas, y la misma lógica de lo que él llamó «espacio en blanco» (white-space): el hueco entre el momento en que se agota el inventario y el momento en que vuelve el suministro, valorado en dinero.
En su artículo de 2014, Simchi-Levi propone un cuestionario breve para recoger los datos de cada proveedor, y una pyme puede usarlo casi tal cual: dónde está la planta, qué piezas salen de ella y con cuántos días de inventario, qué productos las usan y con qué margen, cuál es el plazo de entrega, cuánto tardaría en recuperarse con y sin el utillaje destruido, cuánto costaría conseguir la pieza en otro sitio, si es fuente única y qué medidas de protección hay ya. Dos advertencias de su experiencia con Ford son igual de útiles: los proveedores tienden a declarar tiempos de recuperación optimistas, porque saben que el cliente no aceptará uno largo, así que conviene contrastarlos con lo que tardaron la última vez; y en algunos casos el tiempo de supervivencia era de más de cincuenta semanas por exceso de inventario, de modo que la medición también sirve para quitar colchón donde sobra.
El gráfico aplica el método a la empresa del caso. Los números son ficticios, pero el cálculo es el que haría cualquier comité: el taller de chapa no supone ningún riesgo, porque otro del polígono haría los armarios en una semana y hay stock para dos; el resto sí. Ordenados por lo que más duele, el primer riesgo no es ningún proveedor, sino Marta, la técnica del banco de pruebas, porque sin ella no sale ningún equipo de la fábrica y formar a otra persona llevaría meses.
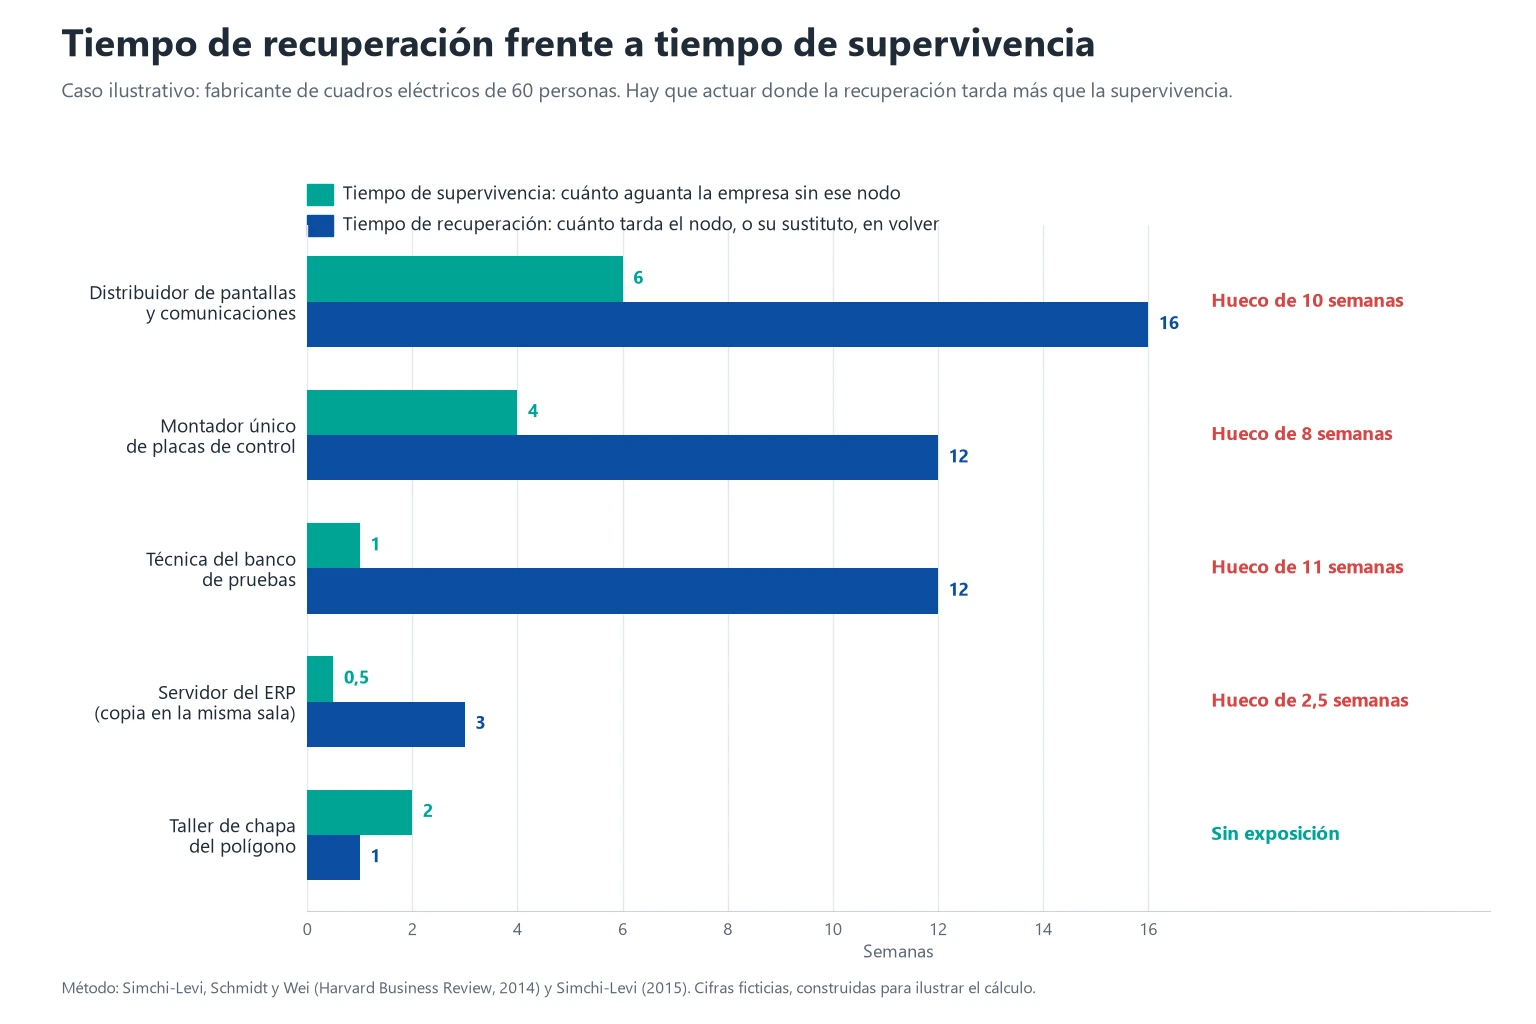
Quien ya conozca las normas de continuidad de negocio reconocerá la idea con otros nombres. El análisis de impacto en el negocio de la norma ISO 22301 fija para cada actividad el periodo máximo tolerable de interrupción, que es el equivalente del tiempo de supervivencia, y el objetivo de tiempo de recuperación, que es un tiempo de recuperación deseado y tiene que ser menor que el anterior; añade el objetivo de punto de recuperación, la cantidad de datos que se puede perder. La regla es la misma en los dos mundos: lo que se tarda en recuperarse tiene que ser menor que lo que se puede aguantar. La guía de continuidad de negocio del INCIBE lo explica para pymes paso a paso, y recuerda algo que muchos olvidan: la continuidad no es solo cosa de informática.
Cómo aplicar La empresa robusta en una empresa de 30 a 100 personas: método en cinco pasos y noventa días
El libro de Sheffi se escribió con casos de grandes multinacionales, y la investigación posterior tiene la misma limitación: una revisión de 91 estudios publicada en 2015 concluyó que casi toda la literatura sobre resiliencia de la cadena de suministro es conceptual o se refiere a grandes empresas de países desarrollados. Una pyme no puede montar una sala de crisis ni firmar contratos de cinco años, pero puede hacer casi todo lo demás en tres meses, sin crear un departamento y con unas pocas horas a la semana del comité de dirección. Lo que sigue es la propuesta de este artículo para hacerlo, construida con las herramientas del libro y de sus continuadores; no es un método del propio Sheffi.
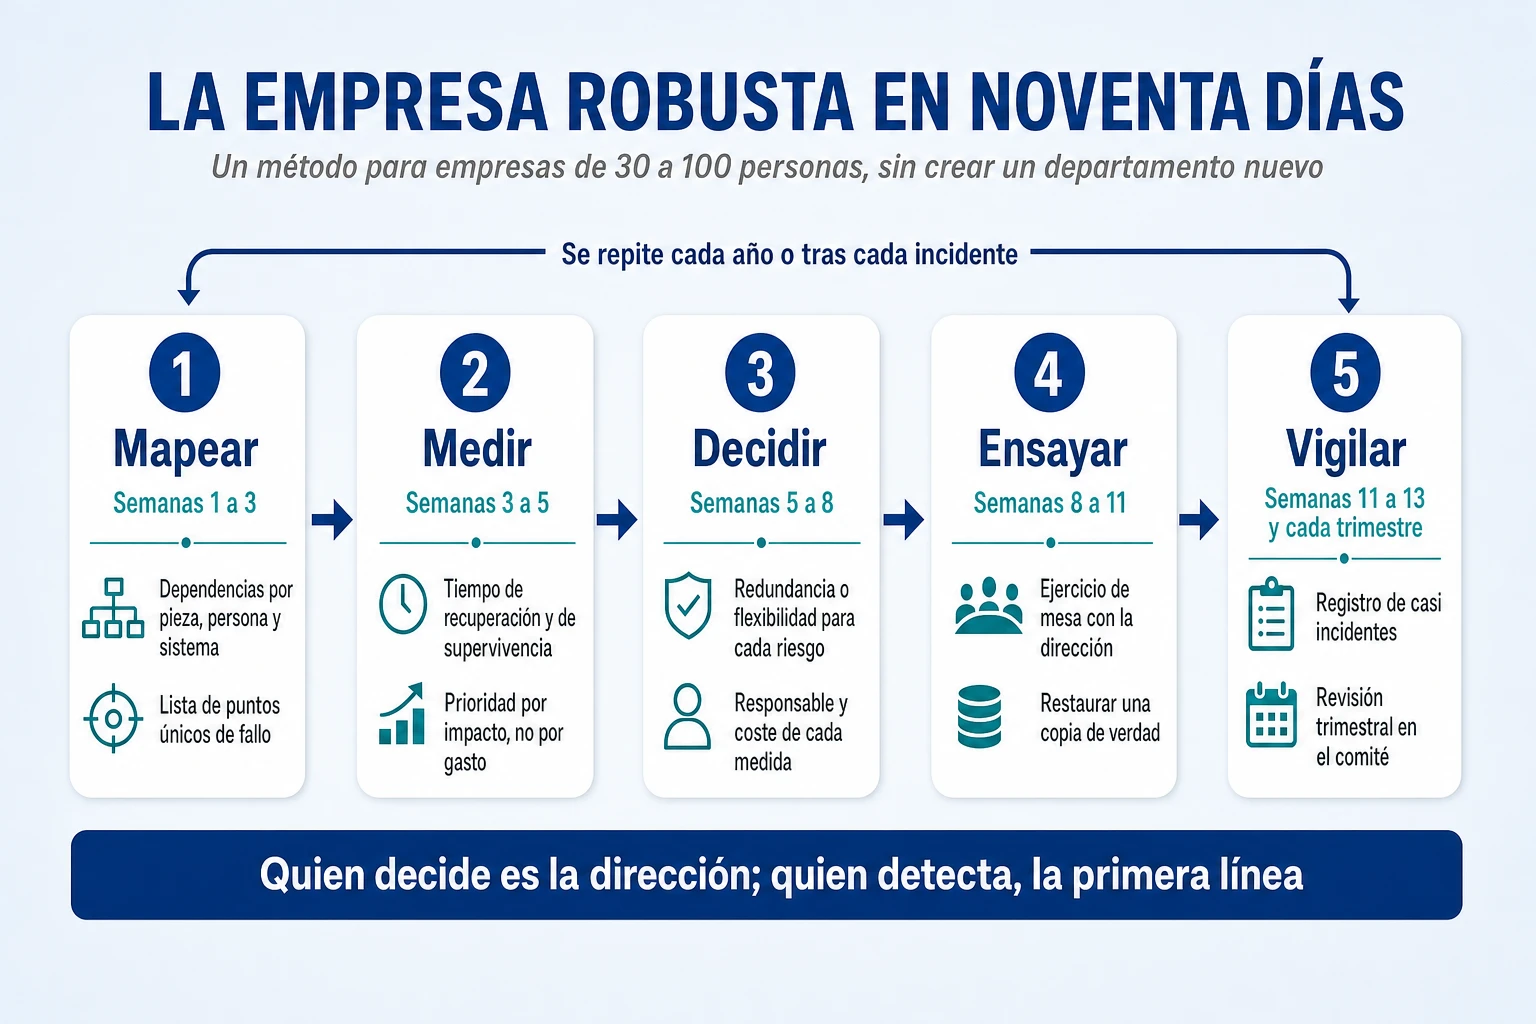
Antes de empezar hay que resolver quién lo lleva, porque la resiliencia afecta a compras, producción, sistemas, comercial y finanzas a la vez, y lo que es de todos acaba sin dueño. Sheffi insiste en que la resiliencia no puede quedarse en manos de los responsables de seguridad o de seguros, porque es una cuestión de estrategia. En una empresa de 30 a 100 personas, la fórmula que funciona es sencilla: el director general patrocina y decide; un directivo con visión de toda la operación, normalmente el de operaciones, es el dueño del método; y el equipo lo forman el comité de dirección más dos o tres personas que conocen el día a día, como la persona de compras, la de sistemas y un mando de producción.
| Paso | Pregunta que responde | Entregable | Quién decide |
| 1. Mapear (semanas 1 a 3) | ¿De qué dependemos y qué no tiene alternativa? | Lista de dependencias por pieza, persona, sistema, instalación y cliente, con los puntos únicos de fallo marcados | Dueño del método, validado por el comité |
| 2. Medir (semanas 3 a 5) | ¿Dónde tardaríamos más en recuperarnos de lo que podemos aguantar? | Tiempo de recuperación y de supervivencia de cada punto crítico, ordenados por impacto | Dueño del método, con compras y producción |
| 3. Decidir (semanas 5 a 8) | ¿Redundancia o flexibilidad en cada caso, y con qué coste? | Una medida por riesgo, con responsable, coste y fecha | Comité de dirección |
| 4. Ensayar (semanas 8 a 11) | ¿Funcionaría de verdad el día que haga falta? | Un ejercicio de mesa, una copia restaurada y una lista de huecos con responsable | Director general |
| 5. Vigilar (semanas 11 a 13 y cada trimestre) | ¿Qué está cambiando y qué estuvo a punto de fallar? | Registro de casi incidentes, indicadores de aviso y revisión trimestral | Comité de dirección |
El primer paso consiste en hacer la lista que la empresa del caso hizo por obligación: todas las dependencias, ordenadas por pieza o servicio y no por factura, incluidas las personas que son las únicas que saben hacer algo, los sistemas sin los que no se puede facturar ni fabricar, las instalaciones y suministros, y los clientes que pesan demasiado. Para las cinco a diez piezas más críticas conviene preguntar al proveedor de dónde saca él su material y en qué planta lo fabrica, porque cambiar de proveedor directo no sirve de nada si los dos dependen del mismo proveedor de segundo nivel. Según una encuesta del Business Continuity Institute de 2024, solo el 17 % de las organizaciones analizaba a sus proveedores hasta el cuarto nivel, y eso entre empresas que tienen especialistas en continuidad: llegar al segundo en lo crítico ya es avanzado para una pyme.
El segundo paso aplica la medición del capítulo anterior, y el tercero es el que da sentido a todo: para cada riesgo en el que la recuperación supera a la supervivencia, decidir la medida más barata que cierre el hueco, preguntándose primero si existe una opción flexible, que también sirva en el día a día, y recurriendo a la redundancia donde no la haya. El cuarto paso convierte los planes en algo que funciona. Un ejercicio de mesa de noventa minutos, con el comité y dos o tres mandos, en el que alguien narra un incidente por fases y en cada una se pregunta quién decide, con qué información y a quién se llama, descubre más huecos que cualquier documento; el centro británico de ciberseguridad ofrece gratis ejercicios preparados que se pueden adaptar. Y restaurar de verdad una copia de seguridad, en otra máquina, es la prueba más barata y más reveladora que existe.
El quinto paso mantiene vivo lo anterior. Un registro de casi incidentes, una hoja en la que cualquiera apunta lo que estuvo a punto de parar la empresa, revisado quince minutos al mes en el comité, es la forma más barata de detección que existe y la que propone Sheffi. Unos pocos indicadores de aviso, como los plazos de entrega de los proveedores críticos o el precio de los componentes más sensibles, y una revisión trimestral del mapa completan el método. Se repite cada año y después de cada incidente real, midiendo cuánto se tardó de verdad en recuperarse, que es el mejor dato que una empresa puede tener sobre sí misma.
El caso, seis meses después: qué decidió el fabricante y qué cambió
La empresa del caso siguió el método entre enero y marzo de 2026. Sus decisiones aplican, una por una, las palancas del libro, y sus resultados a los seis meses, ilustrativos y no medidos en una empresa real, muestran el tipo de cambio que cabe esperar.
- Banco de pruebas: flexibilidad por personas. Formó a dos técnicos más en el banco de pruebas y documentó sus programas, dentro de la polivalencia encadenada de los cinco puestos. El tiempo de recuperación ante una baja de Marta pasó de unas doce semanas a dos.
- Montador de placas: relación profunda y segunda fuente. Firmó un contrato que deja claro que los utillajes y programas son suyos, y encargó el 10 % de los lotes a un segundo montador ya homologado. Las placas le cuestan alrededor de un 4 % más, y el tiempo de recuperación ante un incendio del montador principal bajó de doce semanas a tres, por debajo de las cuatro que aguanta con su stock.
- Pantallas y comunicaciones: estandarización, segunda marca y redundancia acotada. Redujo de siete a dos los modelos de pantalla, homologó una segunda marca para cada uno y compró diez semanas de stock con precio cerrado para 2026. La exposición a la escasez de memoria sigue existiendo, pero ya no depende de un solo modelo ni de una sola marca.
- ERP: redundancia pura. Contrató una copia diaria fuera de la oficina y desconectada, y en el ejercicio de mesa restauró el sistema en otra máquina en unas cinco horas. Antes nadie sabía cuánto se tardaría.
- Cliente principal: el riesgo que no se resuelve en noventa días. El comité decidió no forzar nada con la cooperativa y fijó un objetivo comercial a tres años para que ningún cliente supere el 25 % de las ventas. Es una decisión de estrategia, no de operaciones, y por eso le corresponde al director general.
El efecto más visible no estuvo en ninguna de esas medidas, sino en el registro de casi incidentes. En tres meses recogió catorce anotaciones, entre ellas dos retrasos más del montador de placas por la misma máquina, que llevaron a pedirle un plan de mantenimiento, y un aviso de un comercial sobre un competidor que estaba perdiendo clientes por falta de pantallas, que la empresa aprovechó para captar dos. Es la tesis completa del libro en pequeño: la misma capacidad que protege frente a la crisis sirve para ganar cuando otros fallan.
Queda una pregunta que muchos directivos se hacen: ¿obliga alguna norma a una pyme a hacer todo esto? En general, no. Ninguna norma obliga a una empresa normal de 30 a 100 personas a tener un plan de continuidad de negocio, aunque la directiva europea de ciberseguridad NIS2 alcanzará a algunas medianas empresas de sectores concretos cuando España complete su transposición, y el reglamento europeo de ciberresiliencia de productos obliga desde septiembre de 2026 a los fabricantes de equipos conectados, como los del caso, a notificar vulnerabilidades explotadas, con obligaciones completas a partir de diciembre de 2027. Pero la vía por la que la resiliencia llega a la pyme suele ser otra: los clientes grandes trasladan sus exigencias por contrato, como hizo la cooperativa del caso con su cuestionario. La continuidad entra en la pyme más por la puerta comercial que por la legal.
Límites de La empresa robusta: lo que el libro no cubre y cómo lo amplió el propio Sheffi
Un libro de hace veinte años que ha resistido bien merece también una lectura crítica, y conviene separar las críticas que se sostienen de las que el propio autor ya resolvió. La primera limitación es de método: el libro es un estudio de casos y entrevistas, no un experimento. Sheffi y Rice lo declaran con honestidad, y reconocen que algunas empresas no quisieron hablar y que en esos casos recurrieron a fuentes públicas. Los casos tienden a elegir ganadores y perdedores claros, como Nokia y Ericsson, y algunos detalles, como el beneficio de Dell en 1999 o los nueve días de Toyota, son menos limpios en las fuentes originales que en el libro. Las ideas centrales, sin embargo, han sido confirmadas por la investigación posterior, empezando por el coste duradero de las disrupciones y el valor de la flexibilidad limitada.
La segunda limitación es de época, y es la que más se repite: el libro apenas habla de ciberseguridad, nube, plataformas digitales o inteligencia artificial. Es cierto para el texto de 2005, pero conviene saber que Sheffi dedicó su segundo libro, en 2015, precisamente a lo que faltaba: los riesgos en los niveles profundos de la cadena, la detección, la ciberseguridad, la escasez de materias primas y los choques de precios, los riesgos de reputación, los cambios a largo plazo y los riesgos sistémicos. Quien quiera aplicar sus ideas a 2026 debería leer los dos.
La tercera crítica afecta al centro de la tesis. La preferencia por la flexibilidad frente a la redundancia es correcta como regla general, pero no vale para todas las disrupciones: ante las raras y largas, o ante componentes sin sustituto, la redundancia es la única defensa real, como mostró Tomlin. Los datos recientes, además, dan un apoyo inesperado a Sheffi. Tras la pandemia se habló mucho del paso del «justo a tiempo» al «por si acaso», pero la relación entre inventarios y ventas de la industria estadounidense, que estaba entre 1,35 y 1,52 meses en 2017-2019, subió hasta 1,61 en abril de 2023 y en agosto de 2026 había vuelto a 1,48. Las empresas montaron colchones y los desmontaron en cuanto pasó el susto, exactamente lo que el libro predice de la redundancia; la flexibilidad y la cultura no se desmontan con la misma facilidad.
Algo parecido ocurre con la relocalización. El discurso de traer la producción de vuelta o acercarla a países aliados no se ve, a escala, en los datos de comercio: Laura Alfaro y Davin Chor concluyen que Estados Unidos se ha desacoplado de China pero no del mundo, con más compras a Vietnam, México o Taiwán, y otros trabajos muestran que los nuevos proveedores son a menudo los más integrados en las cadenas chinas. La dependencia se desplaza un eslabón, no desaparece, lo que confirma la lección de Simchi-Levi para una pyme: cambiar de país al proveedor directo no cambia nada si el proveedor de segundo nivel sigue siendo el mismo.
La cuarta crítica es conceptual y procede de Nassim Taleb, que en Antifrágil (2012) distingue entre lo frágil, lo robusto o resiliente, que aguanta el golpe y vuelve a su estado anterior, y lo antifrágil, que sale reforzado del desorden. Desde esa perspectiva, la «empresa robusta» se quedaría en el segundo escalón y además dependería de estimar probabilidades de sucesos raros, algo que Taleb considera imposible. La crítica es menos dura de lo que parece: Sheffi abandonó la probabilidad como guía en su segundo libro, y buena parte de sus casos, como Nokia ganando cuota o NUMMI terminando el año con ventas récord, describen empresas que salen mejor de la crisis. Taleb aporta un marco mental útil; Sheffi y Simchi-Levi aportan casos y herramientas para medir.
Queda una limitación que importa especialmente al lector de este blog: casi todos los ejemplos son de grandes empresas, y algunas de sus palancas dependen del tamaño, como la capacidad de Nokia para exigir la producción de Philips o la de los proveedores de nube para firmar contratos de cinco años. La adaptación a una pyme, que este artículo ha intentado, pasa por apoyarse en intermediarios que sí tienen ese peso, por cuidar la relación con los pocos proveedores que de verdad importan y por aprovechar la ventaja que sí tiene una empresa pequeña: que todo el mundo puede conocer la operación completa y que las decisiones se toman a pocos metros de los problemas. Con todo, la tesis central sigue en pie veinte años después: la diferencia entre salir dañado o reforzado de una crisis se decide antes, en cómo está diseñada la empresa.
Siete preguntas sobre resiliencia para la próxima reunión de dirección
Las ideas de Sheffi solo sirven si cambian alguna decisión, y la forma más rápida de comprobarlo es llevarlas al comité. Estas siete preguntas resumen el artículo en forma de agenda, y responderlas con datos, no con impresiones, es ya el primer paso del método.
¿Cuáles son nuestros cinco puntos únicos de fallo, contando las personas que son las únicas que saben hacer algo y los sistemas sin los que no podemos facturar ni fabricar? ¿En cuáles tardaríamos más en recuperarnos de lo que podemos aguantar, y cuánto nos costaría cada semana de diferencia? ¿Qué proveedor al que compramos poco podría pararnos, y qué sabemos de sus propios proveedores? ¿Tenemos por escrito el contrato y la propiedad de los utillajes, moldes y programas que están en manos de terceros? ¿Cuándo restauramos por última vez una copia de seguridad completa en otra máquina? ¿Qué equipos con memoria vamos a comprar en los próximos dieciocho meses, y con qué precio y plazo comprometidos? ¿Y quién puede tomar decisiones en una crisis sin esperar a la dirección general, y hasta dónde?
Si alguna respuesta es «no lo sabemos», ese es el punto por el que empezar. No hace falta un gran proyecto para hacer una empresa más robusta: hace falta mirar las dependencias con la misma atención con la que se miran los costes, y decidir antes de la crisis lo que nadie querrá tener que improvisar durante ella.
En Transformalix ayudamos a empresas de 30 a 100 personas a identificar sus puntos únicos de fallo, medir cuánto tardarían en recuperarse y rediseñar sus procesos y su relación con los proveedores para ganar flexibilidad sin perder eficiencia. Si quiere saber por dónde empezar en la suya, puede ver cómo trabajamos.