En julio de 2018, el consejero delegado de Lidl comunicó a su organización que el proyecto con el que la compañía llevaba siete años intentando sustituir su sistema de gestión de mercancías quedaba cancelado. La explicación cabía en una frase: los objetivos estratégicos definidos al principio no podían alcanzarse con un esfuerzo aceptable. Detrás de esa frase había más de 500 millones de euros, según la estimación que publicó la prensa económica alemana, varios despliegues piloto en países pequeños y una decisión que suele pasar desapercibida: Lidl no volvió a empezar con otro proveedor, sino que siguió desarrollando el sistema propio que pretendía jubilar. Siete años después de empezar, la empresa estaba exactamente donde había empezado, con un sistema más viejo y mucho menos dinero.
Unos meses antes, en febrero de ese mismo año y al otro lado del Atlántico, Revlon había puesto en producción su nuevo ERP en la planta de Oxford, en Carolina del Norte, una de sus instalaciones industriales más importantes. Lo que ocurrió después lo contó la propia compañía en su informe anual ante el regulador bursátil estadounidense: la planta perdió capacidad para fabricar y servir pedidos, la empresa calculó en unos 64 millones de dólares las ventas que no pudo atender durante el ejercicio y en 53,6 millones los costes extraordinarios que tuvo que asumir para recuperar el servicio. Y reconoció algo que pesa más que cualquiera de esas cifras: una debilidad material en sus controles internos, es decir, que durante un tiempo no tuvo la seguridad de controlar adecuadamente su propia información financiera.
Los dos episodios se cuentan a menudo como desastres informáticos, y los dos se suelen resumir con el nombre del fabricante del software. Esa lectura es cómoda, porque coloca la culpa fuera de la empresa, y es casi siempre equivocada. En ninguno de los dos casos el problema principal fue que el programa dejara de funcionar. En Lidl, el software hacía lo que había sido diseñado para hacer, pero lo que había sido diseñado para hacer no coincidía con la manera en que la empresa quería gestionar su negocio, y nadie consiguió resolver a tiempo cuál de las dos cosas tenía que cambiar. En Revlon, el sistema entró en una fábrica que no estaba preparada para trabajar con él, y la decisión de arrancar se tomó sin pruebas suficientes de que la operación completa iba a seguir funcionando.
Este artículo reconstruye siete grandes fracasos de este tipo: Lidl, Haribo, DHL, Asda, LeasePlan, Kingfisher y Revlon. Son casos muy distintos entre sí. Unos son proyectos cancelados después de consumir cientos de millones; otros son puestas en producción que dejaron fábricas, almacenes o tiendas sin poder funcionar con normalidad durante meses; y uno es una transformación comercial y organizativa en la que la tecnología fue solo una de las piezas que fallaron. Precisamente por esa variedad son útiles. Juntos permiten ver con bastante precisión dónde se tuercen los grandes programas de transformación, en qué momento se podría haber evitado y quién tenía en cada caso la autoridad para hacerlo.
El enfoque de lo que sigue no es tecnológico. Aparecerán SAP, los datos maestros, las interfaces y las migraciones cuando sean necesarios para entender lo que pasó, pero siempre al servicio de otra pregunta: cómo se dirige un gran proyecto de transformación empresarial. Porque eso es lo que tienen en común los siete casos. Implantar un ERP no consiste en instalar una herramienta nueva, sino en intervenir sobre la forma en que una empresa compra, fabrica, vende, distribuye, factura, controla sus operaciones y toma decisiones. Es una transformación empresarial que utiliza tecnología, no un proyecto informático al que se añade gestión del cambio al final.
Eso no significa atribuir todos los problemas a una mala dirección, que es la otra lectura cómoda y casi igual de inexacta que la primera. En algunos de estos casos hubo errores de diseño difíciles de anticipar, fallos de ejecución de proveedores, problemas técnicos genuinos y factores externos que coincidieron con el cambio de sistema. Haribo sufrió a la vez un error comercial que no tenía nada que ver con su ERP. Kingfisher atravesó en Francia unos meses de protestas nacionales que vaciaron las tiendas. Asda tenía que separarse de Walmart sí o sí, porque así se había pactado su venta. A lo largo del artículo se intentará distinguir, cuando la evidencia lo permite, qué fue una decisión empresarial, qué un error de diseño, qué un fallo de ejecución y qué una circunstancia ajena. Y se dirá también cuándo la evidencia no lo permite, que en estos casos ocurre más a menudo de lo que sugieren los titulares.
El recorrido tiene tres partes. La primera son los siete casos, cada uno contado como una historia empresarial: cómo era la compañía antes de la transformación, qué decidieron cambiar sus directivos, cómo se organizó el proyecto, cuándo aparecieron las primeras señales de alarma, qué ocurrió en el momento crítico, cuáles fueron las consecuencias reales y qué se debería haber hecho de otra manera. La segunda parte compara los siete casos y los ordena alrededor de diez factores de fracaso que se repiten, sin olvidar las diferencias, que son tan instructivas como los parecidos. Y la tercera convierte todo lo anterior en un método de gobierno en cinco fases para quien tenga que dirigir, patrocinar o supervisar una transformación de este tipo, con un apartado final sobre quién debe responder realmente de cada cosa.
Por qué fracasan las implantaciones de ERP: una transformación empresarial tratada como un proyecto informático
Implantar un ERP no consiste en cambiar un sistema informático, sino en transformar la manera en que funciona una empresa. Un ERP conecta compras, proveedores, inventarios, producción, logística, ventas, facturación y finanzas. Establece cómo circula la información, qué reglas gobiernan las operaciones y cómo se coordinan los departamentos. Por eso, cuando su implantación falla, las consecuencias no se limitan a incidencias tecnológicas: pueden detener fábricas, paralizar entregas, dejar tiendas sin productos o impedir que una compañía facture correctamente. El error fundamental es tratar como una sustitución de software lo que en realidad es una transformación del modelo operativo.
La primera gran decisión es qué debe cambiar: la empresa para adaptarse al ERP o el ERP para adaptarse a la empresa. Los sistemas comerciales incorporan procesos estandarizados que pueden simplificar las operaciones, reducir costes y facilitar futuras actualizaciones. Pero también pueden entrar en conflicto con prácticas que forman parte de la ventaja competitiva de la organización. Personalizar el sistema permite conservarlas, aunque introduce complejidad, costes y dependencia tecnológica. No existe una respuesta universal: hay que distinguir qué procesos aportan realmente valor y cuáles simplemente perpetúan hábitos heredados. El problema aparece cuando estas decisiones se toman por inercia, sin cuestionar cómo debería funcionar el negocio.
El segundo error es automatizar los procesos existentes sin rediseñarlos desde una perspectiva integral. Cada departamento tiende a defender sus procedimientos, sus excepciones y sus necesidades particulares. Pero un ERP no funciona como una colección de aplicaciones independientes: lo que hace Compras condiciona a Producción, lo que registra Logística afecta a Finanzas y un error en los datos puede propagarse por toda la organización. La transformación exige diseñar los procesos de extremo a extremo, eliminar complejidad innecesaria y establecer reglas comunes. Digitalizar un proceso ineficiente no lo convierte en eficiente: simplemente permite ejecutar más rápido sus errores.
Existe además una dimensión frecuentemente infravalorada: los datos, las integraciones y la continuidad de las operaciones. Un nuevo ERP puede estar técnicamente terminado y fracasar porque los datos migrados son incorrectos, porque los sistemas que deben comunicarse no lo hacen adecuadamente o porque las pruebas no han reproducido operaciones reales de principio a fin. No basta con comprobar que cada módulo funciona por separado. Hay que demostrar que la empresa puede recibir un pedido, fabricar o preparar el producto, entregarlo, facturarlo y cobrarlo sin interrupciones. La calidad de los datos, las pruebas integrales y los planes de contingencia no son detalles técnicos: son condiciones para mantener el negocio funcionando.
Otro error crítico es confundir la fecha de puesta en producción con la preparación real de la organización. La presión por cumplir calendarios puede llevar a activar sistemas cuando los procesos todavía presentan fallos, los empleados no dominan las nuevas herramientas o los mecanismos de soporte son insuficientes. Una implantación requiere gestionar el cambio, formar a las personas, validar escenarios críticos y decidir cuándo es seguro avanzar, cuándo conviene desplegar gradualmente y cuándo es necesario detenerse. El día del arranque no termina la transformación: comienza la prueba más exigente, cuando miles de operaciones reales sustituyen a los escenarios controlados del proyecto.
Finalmente, el éxito de una transformación ERP no puede medirse exclusivamente por el cumplimiento de plazos, presupuestos y funcionalidades entregadas. Esos indicadores permiten controlar el proyecto, pero no demuestran que la empresa funcione mejor. Lo verdaderamente importante es si mejora la productividad, se reducen los errores, se acortan los tiempos operativos, aumenta la capacidad de respuesta y se preserva el servicio a los clientes. Las dos mediciones pueden divergir peligrosamente: Asda completó formalmente su separación tecnológica de Walmart mientras sus operaciones comerciales sufrían graves problemas de abastecimiento; LeasePlan acumuló retrasos y sobrecostes en un programa cuyo valor para el negocio terminó cuestionándose.
La lección común es que la tecnología, por sí sola, no transforma una empresa. El resultado depende de acertar en el diseño del modelo operativo, simplificar los procesos, asegurar los datos, preparar a las personas, controlar los riesgos y mantener las decisiones alineadas con los objetivos empresariales. Un proyecto puede cumplir sus especificaciones técnicas y, aun así, destruir valor. Los siete casos que siguen muestran cómo errores de planteamiento, ejecución y liderazgo acabaron convirtiendo grandes inversiones tecnológicas en crisis empresariales.
Antes de empezar: ¿quién va a tomar las decisiones clave?
Hay una anécdota especialmente reveladora en el mundo de la consultoría de transformación. Un consultor experimentado contaba que, en la primera reunión de cualquier gran proyecto, su primera pregunta era siempre la misma: ¿quién va a tomar las decisiones? Si nadie podía darle una respuesta clara, se levantaba y se marchaba. No tenía sentido comenzar un proyecto de transformación si la organización ni siquiera había resuelto quién tenía autoridad para dirigirlo.
La anécdota encierra probablemente una de las lecciones más importantes de los grandes fracasos empresariales. Una transformación necesita un responsable único del resultado, con autoridad real para tomar decisiones que afectan a diferentes departamentos, resolver conflictos y asumir sus consecuencias. No basta con nombrar un director de proyecto, constituir un comité de seguimiento o contratar a una consultora prestigiosa. Cuando hay que decidir entre adaptar el ERP o cambiar un proceso, retrasar un lanzamiento, asumir un sobrecoste o renunciar a una particularidad del negocio, alguien debe tener la capacidad de decidir, incluso cuando la decisión perjudica los intereses de algún departamento.
Esto no significa que una sola persona deba decidirlo todo. Los responsables de negocio deben conservar la capacidad de decisión sobre sus procesos, los especialistas deben aportar sus conocimientos y el equipo del programa debe coordinar la ejecución. Pero debe existir una autoridad final, inequívocamente identificada, que responda del éxito global de la transformación y pueda desbloquear las decisiones que atraviesan las fronteras organizativas.
Sin esa figura, cada departamento puede defender razonablemente sus intereses, cada proveedor puede cumplir con su contrato y cada equipo puede alcanzar sus objetivos, mientras el proyecto en su conjunto camina hacia el fracaso. La responsabilidad puede distribuirse para ejecutar, pero no puede diluirse a la hora de responder por el resultado.
Cómo leer los siete casos de fracaso de ERP: tres tipos de fracaso y cinco cifras que no se pueden sumar
Antes de entrar en cada historia conviene hacer dos distinciones que evitan la mayor parte de las conclusiones equivocadas que circulan sobre estos casos. La primera es que no todos fracasaron de la misma manera. La segunda es que las cifras que se citan sobre ellos miden cosas muy distintas, y casi todos los titulares exagerados nacen de mezclarlas.
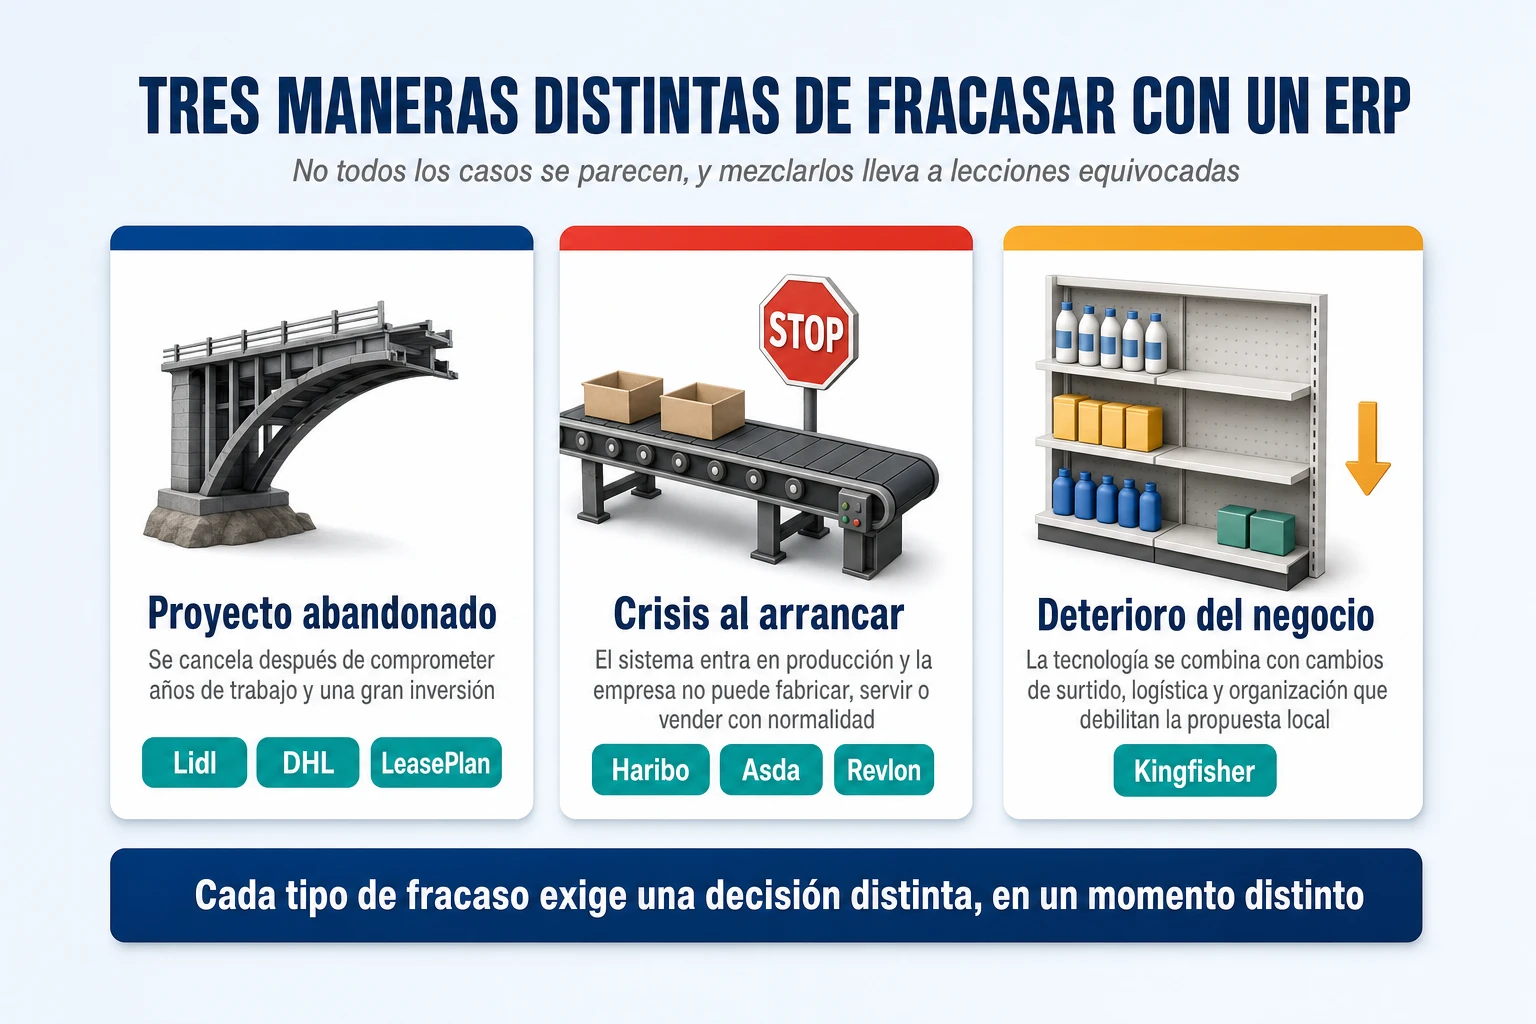
Los siete casos se reparten en tres tipos de fracaso. El primero es el proyecto abandonado: la empresa cancela o retira una solución después de haber comprometido años de trabajo e inversiones importantes, normalmente antes de desplegarla de forma generalizada. Es lo que ocurrió en Lidl, en DHL y en LeasePlan. El daño principal es económico y estratégico, el dinero gastado y el tiempo perdido, y no suele ir acompañado de una crisis visible para los clientes, porque la solución nunca llegó a sostener la operación entera. El segundo tipo es el despliegue con crisis operativa: el sistema entra en producción y la empresa pierde durante semanas o meses capacidad para fabricar, distribuir, vender o atender pedidos. Es el caso de Haribo, de Revlon y de Asda. Aquí el daño se ve desde fuera, en estanterías vacías y pedidos sin servir, y la empresa no abandona la tecnología, sino que la estabiliza con un coste alto. El tercer tipo es la transformación compleja con deterioro del negocio, en la que la tecnología se combina con cambios de surtido, de procesos, de organización y de modelo comercial, y es el conjunto el que falla. Es Kingfisher, y es probablemente el caso más interesante para un comité de dirección, porque la tecnología acabó funcionando y el error estuvo en lo que se le pidió que impusiera.
| Tipo de fracaso | Casos | Qué sucedió | Dónde estaba la decisión clave |
| Proyecto abandonado | Lidl, DHL, LeasePlan | Se canceló o retiró la solución tras comprometer inversiones significativas | Al principio, al validar el encaje con el negocio, y durante el programa, al revisar si seguía siendo viable |
| Crisis al arrancar | Haribo, Revlon, Asda | El cambio de sistema afectó a la capacidad de producir, distribuir, vender o atender pedidos | Justo antes de la puesta en producción, al decidir si la operación estaba preparada |
| Deterioro del negocio | Kingfisher | La tecnología se combinó con cambios de surtido, procesos y organización que debilitaron el negocio local | En la estrategia, al decidir qué debía ser común en todo el grupo y qué no |
La utilidad de esta clasificación no es académica. Cada tipo de fracaso se habría evitado con una decisión distinta, tomada en un momento distinto y por personas distintas. Los proyectos abandonados se juegan al principio, cuando se decide qué solución encaja con el negocio, y en las revisiones periódicas de viabilidad que casi nunca se hacen con honestidad. Las crisis operativas se juegan en las semanas previas al arranque, cuando alguien tiene que decidir si la empresa está preparada para cambiar de sistema y a menudo decide que sí porque la fecha ya estaba comprometida. Y el deterioro del negocio se juega en la estrategia, mucho antes de que se configure una sola pantalla. Mezclar los tres tipos lleva a recetas genéricas del estilo «hay que gestionar mejor el cambio», que son ciertas y no sirven para nada.
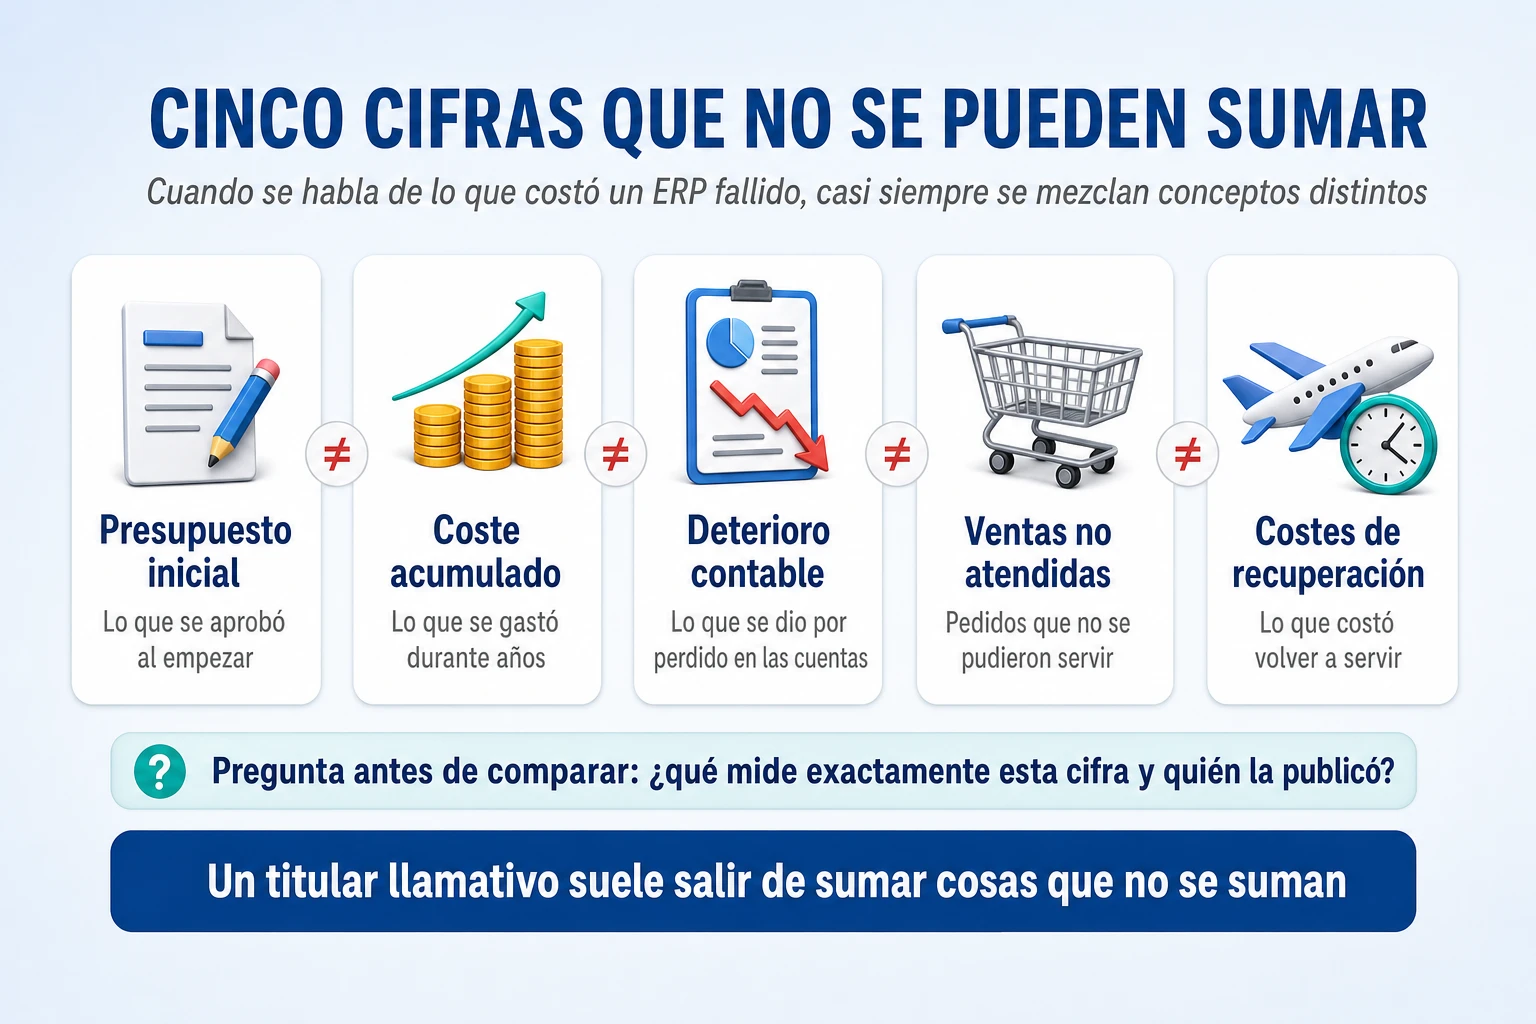
La segunda distinción es sobre las cifras. Cuando se dice que un ERP fallido «costó» una cantidad, esa cantidad puede ser al menos cinco cosas distintas. Puede ser el presupuesto inicial, lo que se aprobó al empezar y que casi nunca se publica. Puede ser el coste acumulado, lo que se gastó durante años en licencias, consultoría y equipos propios, que en el caso de Lidl es una estimación periodística y no una cifra contable de la empresa. Puede ser un deterioro contable, la parte de la inversión que la compañía da por perdida en sus cuentas porque ya no generará los beneficios esperados, que es lo que comunicaron DHL y LeasePlan con todo detalle. Puede ser una estimación de ventas no atendidas, ingresos que la empresa no pudo facturar porque no consiguió servir los pedidos, que es lo que calculó Revlon. Y pueden ser costes de recuperación, el dinero extra que hubo que gastar en transportes urgentes, horas adicionales y refuerzos para volver a servir, que Revlon también cuantificó por separado.
Estas cifras no se pueden sumar entre sí, y en algunos casos ni siquiera se pueden comparar. Las ventas no atendidas no son una pérdida de beneficio, porque esos productos tampoco tuvieron que fabricarse; para saber cuánto beneficio se perdió habría que aplicarles el margen. Un deterioro contable no es todo lo que se gastó, sino la parte del activo que se da por irrecuperable en un momento concreto. Y el coste acumulado de un programa como el de Asda no es dinero desperdiciado, porque al final la empresa terminó operando con sistemas propios, que era exactamente lo que necesitaba. La regla práctica es preguntar siempre, ante cualquier cifra, qué mide exactamente y quién la publicó. Si la publicó la propia empresa en sus cuentas o ante un regulador, tiene un valor probatorio muy superior al de una cifra que se repite de artículo en artículo sin documento de origen.
Esta precaución no es un tecnicismo. Sobre estos siete casos circulan cifras redondas y causas simples que no resisten una comprobación: una caída del 25 % en las ventas de los ositos de oro de Haribo que no aparece en ninguna fuente de la empresa, una quiebra de Revlon atribuida directamente a su ERP cuatro años después del arranque, o estimaciones de lo que habría costado hacerlo bien que nadie ha calculado nunca. Este artículo trabaja con lo que las compañías publicaron en sus cuentas, comunicados y entrevistas, con lo que recogió la prensa económica que siguió los casos y, en el de Revlon, con las alegaciones de una demanda de inversores que se presentan siempre como alegaciones. Cuando algo es una conclusión razonada y no un hecho acreditado, se dice. Es la única manera de que las lecciones sirvan para algo, porque una lección extraída de un hecho falso enseña a evitar un error que nadie cometió.
Caso Lidl: siete años y más de 500 millones intentando adaptar SAP al modelo de negocio de un distribuidor de descuento
El caso de Lidl es el más citado de todos los fracasos de ERP europeos y, probablemente, el peor contado. Se suele resumir como la historia de una empresa testaruda que se negó a cambiar un detalle contable y perdió por ello medio millar de millones. Hay algo de verdad en esa versión, pero deja fuera lo que lo hace instructivo para cualquier comité de dirección: la pregunta que el proyecto nunca llegó a responder no era técnica, sino estratégica, y era una pregunta legítima. ¿Qué parte de la forma de trabajar de Lidl era una ventaja competitiva que merecía la pena conservar, y qué parte era simplemente la forma en que siempre se habían hecho las cosas?
El modelo de Lidl antes de la transformación: pocos artículos, grandes volúmenes y un sistema propio
Lidl es una de las grandes cadenas de distribución alimentaria de Europa y pertenece al grupo alemán Schwarz. Su modelo de negocio es el del descuento: un surtido relativamente reducido, una proporción muy alta de marca propia, volúmenes enormes por referencia, una disciplina de costes extrema y procesos de compra, logística y reposición extraordinariamente estandarizados en todos los países donde opera. En ese modelo, el margen no se gana con la variedad ni con el servicio, sino con la precisión: comprar bien, mover la mercancía con el mínimo coste posible y saber en cada momento cuánto deja cada artículo. Para un distribuidor de descuento, el sistema que gestiona las mercancías no es una herramienta administrativa, es el instrumento con el que se gobierna el margen.
Ese instrumento era, desde hacía décadas, un sistema desarrollado por la propia empresa, conocido internamente como Wawi, abreviatura alemana de gestión de mercancías. Como ocurre con casi todos los sistemas propios longevos, Wawi era tecnológicamente antiguo y estaba profundamente adaptado a la manera de trabajar de Lidl, porque se había ido construyendo alrededor de ella. Cada informe, cada indicador que miraban los compradores y los controladores, cada regla de reposición estaba pensada con la lógica de la casa. Y como ocurre también con casi todos los sistemas propios longevos, mantenerlo tenía un coste creciente y una dependencia incómoda de las personas que lo conocían.
El proyecto eLWIS: por qué Lidl eligió SAP y qué pretendía conseguir
En 2011 Lidl decidió sustituir progresivamente Wawi por una solución basada en SAP for Retail sobre la tecnología HANA, que en ese momento era la gran apuesta del fabricante alemán. El nuevo entorno recibió el nombre de eLWIS, y entre las firmas que participaron en la implantación estaba la consultora KPS. La motivación tenía sentido y conviene no perderla de vista al juzgar lo que vino después: unificar la información de compras, mercancías, existencias y logística de un grupo internacional en plena expansión, reducir la dependencia de una aplicación construida en casa y apoyarse en un producto de mercado que evolucionaría con el tiempo sin que Lidl tuviera que pagar cada mejora.
Era, además, una decisión coherente con lo que se considera buena práctica: cuando un proceso no diferencia a la empresa, es más barato y más seguro adoptar la solución estándar del mercado que mantener un desarrollo propio. El problema es que esa regla solo funciona si se ha decidido antes, proceso a proceso, cuáles diferencian a la empresa y cuáles no. Elegir SAP no fue el error. El error fue elegirlo sin haber resuelto antes qué parte del modelo de Lidl estaba dispuesta a cambiar para encajar en él.
La valoración del inventario: el conflicto entre el estándar del ERP y el modelo económico de Lidl
Según las reconstrucciones que publicó la prensa económica y especializada alemana, el desacuerdo más visible estuvo en la forma de valorar las mercancías. Lidl gestionaba sus existencias con una lógica fuertemente orientada al precio de compra: cada artículo en el almacén valía lo que había costado comprarlo, y a partir de ahí se calculaban márgenes, se medía a los compradores y se construían los informes. El modelo diseñado para el nuevo sistema incorporaba otra lógica, la de valorar las existencias por su precio de venta, que es un método habitual en el comercio minorista porque permite controlar el inventario de tiendas con miles de artículos de forma sencilla.
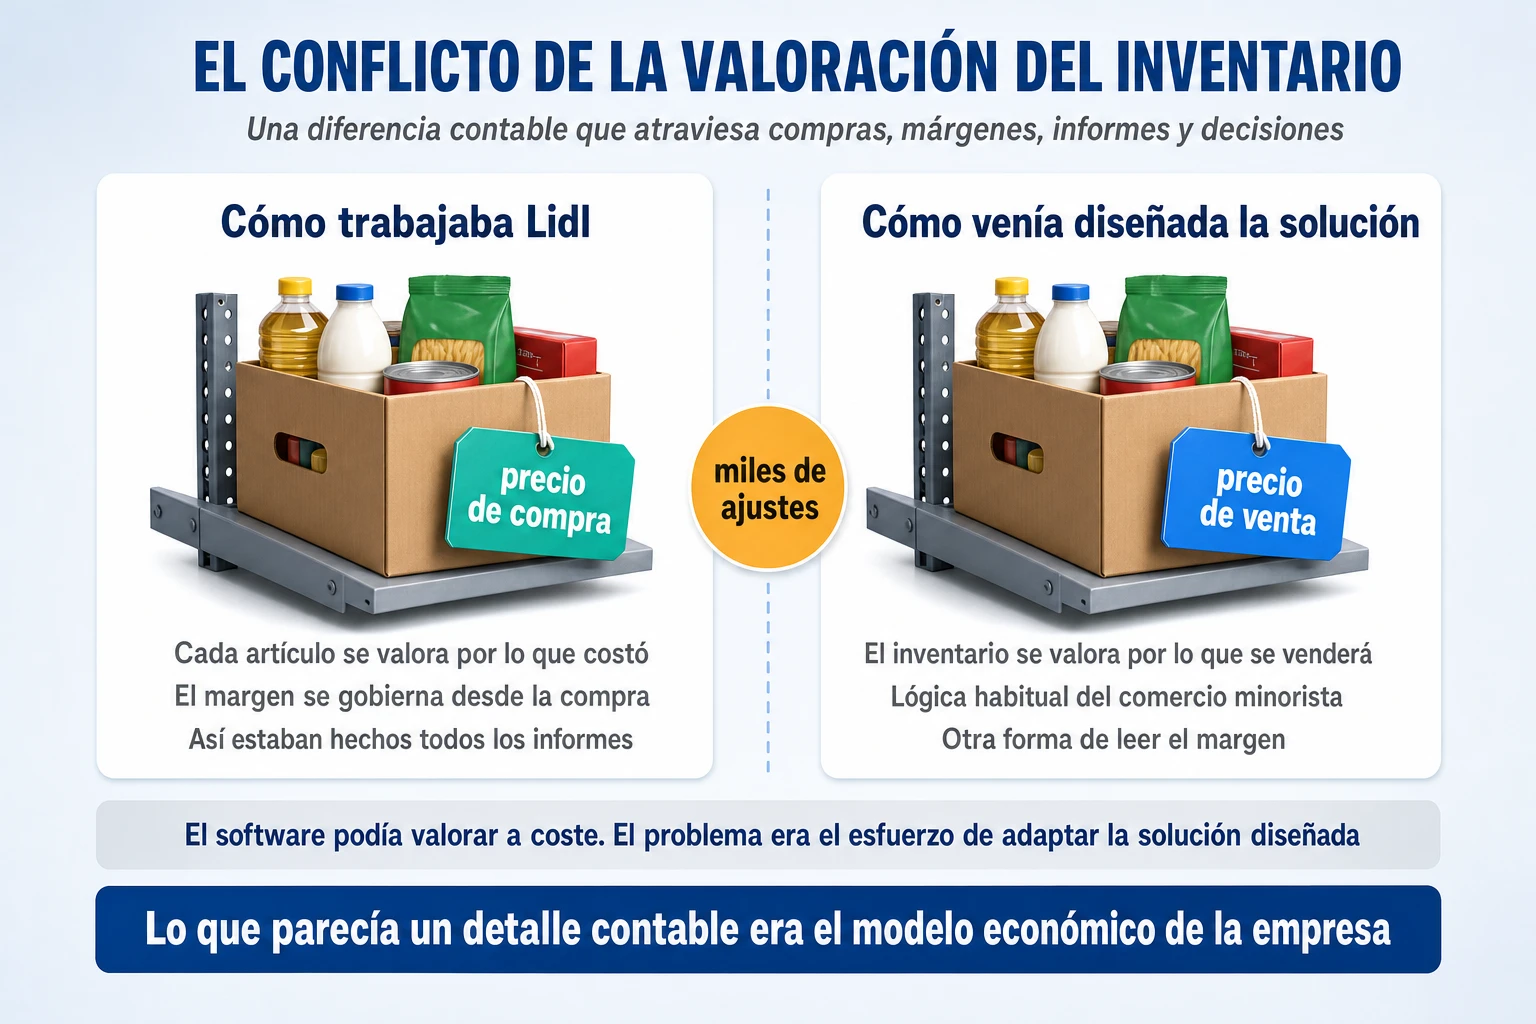
Explicado así parece una cuestión menor, un cambio de criterio que un buen equipo de contabilidad resuelve en unas semanas. No lo es, y entender por qué es la clave del caso. Cambiar la base de valoración del inventario cambia la manera de leer el margen de cada artículo, la forma de evaluar a cada comprador, el significado de cada informe que llega a la dirección y las reglas con las que se toman decisiones de precio y de surtido todos los días. En una empresa cuyo modelo entero se basa en gobernar el margen desde la compra, lo que desde el proyecto se veía como un parámetro de configuración era, desde el negocio, el sistema nervioso de la compañía.
Conviene precisar algo que las versiones simplificadas del caso suelen omitir. No significa que SAP fuera técnicamente incapaz de valorar existencias a coste de adquisición; puede hacerlo. El conflicto estaba en la solución concreta que se había proyectado, en los procesos asociados y en el esfuerzo de adaptación que hacía falta para que todo el resto del sistema funcionara con la lógica de Lidl. Y ese esfuerzo se multiplicaba, porque una decisión así no se queda en un módulo: arrastra cálculos, informes, interfaces y reglas por todo el sistema. La solución elegida necesitaba modificaciones y personalizaciones extensas, y la prensa especializada alemana identificó expresamente los costes de adaptación como el factor decisivo del desenlace.
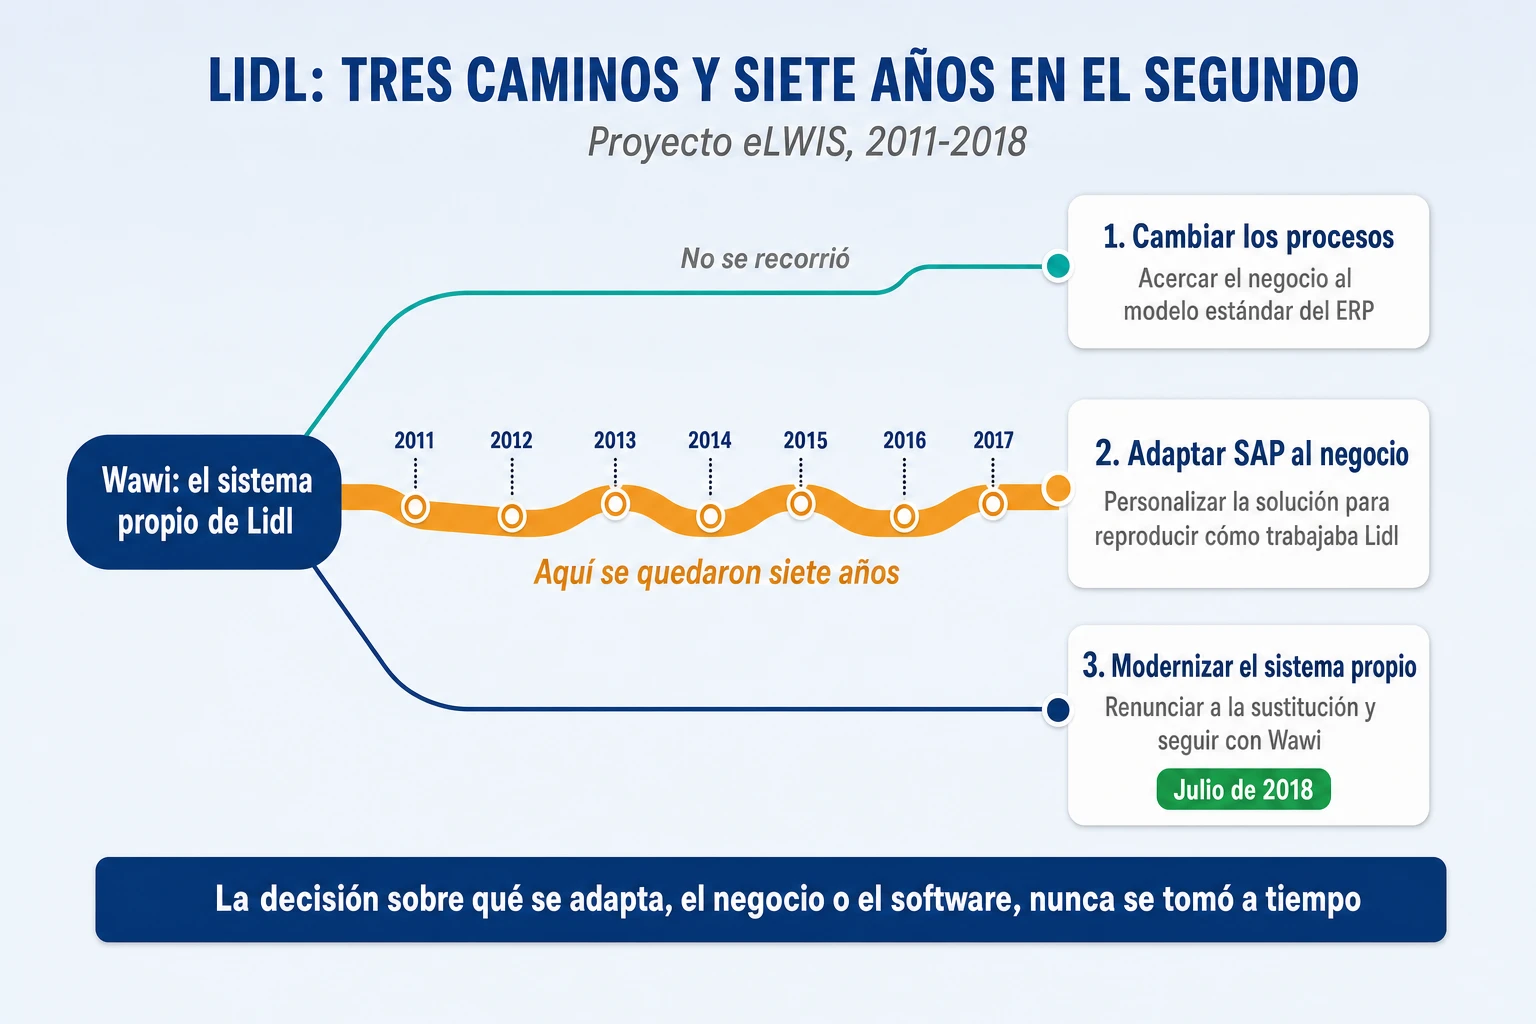
A partir de ahí, el proyecto quedó atrapado entre tres caminos posibles. El primero era cambiar los procesos consolidados de Lidl para acercarlos al modelo de referencia del software, aceptando trabajar de otra manera. El segundo era modificar profundamente la solución para que reprodujera el funcionamiento existente. El tercero era renunciar a la sustitución y modernizar el sistema propio. Durante años se avanzó por el segundo camino, que es el más caro de los tres, hasta que el tercero acabó imponiéndose. El primero, que es el que habría justificado elegir un ERP de mercado, no parece haberse recorrido nunca con convicción.
Por qué el proyecto duró siete años: las señales de alarma y la decisión que nadie tomó
La cronología que se puede reconstruir con las fuentes públicas es sencilla. Entre 2012 y 2016 se desarrollaron y ajustaron los procesos del nuevo sistema, y la adaptación al funcionamiento de Lidl resultó mucho más compleja de lo previsto. Entre 2016 y 2017 la implantación siguió sin consolidarse como plataforma generalizada en los grandes mercados del grupo. Existían despliegues piloto, pero de alcance reducido: Austria, Irlanda del Norte y Estados Unidos, donde Lidl abrió sus primeras tiendas en 2017. Alemania, el mercado de origen y el más grande, seguía funcionando con Wawi. En 2018 la dirección concluyó que los objetivos no podían alcanzarse con un esfuerzo razonable, y en julio canceló el proyecto.
Leída con la perspectiva de hoy, esa cronología contiene varias señales de alarma que estaban a la vista mucho antes del final. La primera es que, cinco o seis años después de empezar, el sistema seguía sin llegar a los mercados grandes, que son los que de verdad ponen a prueba un sistema de gestión de mercancías. Un piloto en un país pequeño o recién abierto demuestra que la solución funciona en condiciones favorables, pero no que funcione con el volumen, la variedad de casos y la historia acumulada de Alemania. Un programa que lleva años en pilotos pequeños sin dar el salto al mercado principal no está madurando: está evitando la prueba que decidiría si es viable.
La segunda señal es la propia naturaleza del trabajo que se estaba haciendo. Cuando la mayor parte del esfuerzo de un programa se dedica a conseguir que el software nuevo se comporte como el antiguo, el programa ha perdido su razón de ser sin que nadie lo declare. El argumento para comprar un producto de mercado es que el fabricante se encarga de mantenerlo y de mejorarlo; cada personalización profunda erosiona ese argumento, porque convierte el producto estándar en un desarrollo propio que además hay que reconciliar con cada nueva versión del fabricante. A partir de cierto punto, la empresa está pagando por tener dos cosas, el estándar y la adaptación, sin disfrutar de las ventajas de ninguna.
¿Por qué se mantuvo entonces el proyecto tanto tiempo? Las fuentes públicas no describen el proceso interno de decisión, así que lo que sigue es una conclusión razonada y no un hecho acreditado. Pero el patrón es tan común que merece describirse. Cada adaptación, tomada aisladamente, era defendible: resolvía un problema concreto que alguien del negocio había señalado con razón. Ninguna de ellas, por sí sola, justificaba replantear el programa. Y la suma de todas ellas no la miraba nadie con la autoridad suficiente para decir que el conjunto ya no tenía sentido. Los programas largos no se tuercen en una gran decisión equivocada, sino en cientos de pequeñas decisiones razonables que nadie suma. A eso se añade el peso de lo ya invertido, que en cada revisión hace más difícil admitir que el camino elegido no lleva a ninguna parte.
La cancelación de eLWIS en 2018: consecuencias económicas y organizativas
Cuando Jesper Højer, consejero delegado de Lidl, anunció la cancelación, lo hizo con la frase que resume el caso: los objetivos estratégicos definidos originalmente no podían alcanzarse con un esfuerzo aceptable. La compañía decidió seguir desarrollando Wawi, lo que implicaba invertir de nuevo en el sistema que se había querido sustituir. La prensa especializada alemana, que siguió el proyecto durante años, recogió con detalle el final del programa y la vuelta al sistema propio.
La cifra más citada, algo más de 500 millones de euros, corresponde al coste acumulado del programa durante siete años, incluidos desarrollos, consultoría y licencias, según la estimación que difundió la prensa económica alemana. Hay que tratarla como lo que es: una estimación periodística, no una amortización extraordinaria confirmada en las cuentas de Lidl. Tampoco se conoce un presupuesto inicial documentado, así que cualquier porcentaje de desviación que circule sobre este caso está inventado. Lo que sí se puede afirmar es que la cantidad fue lo bastante grande como para convertirse en el ejemplo europeo de referencia, y que la empresa no la desmintió.
El daño operativo fue, en cambio, mucho menor que en otros casos de este artículo, y merece decirse para no exagerar. No existe evidencia pública sólida de una crisis general de abastecimiento provocada por eLWIS. Las tiendas de Lidl en Alemania siguieron funcionando con normalidad porque nunca llegaron a depender del nuevo sistema. El perjuicio fundamental fue invertir siete años de trabajo y recursos en una solución que no llegó a implantarse de forma generalizada, con el coste de oportunidad que eso supone para una empresa que, durante ese tiempo, tuvo a muchos de sus mejores perfiles de negocio y de tecnología dedicados a un proyecto que no prosperó. Y probablemente la decisión de cancelar antes de desplegarlo de forma masiva evitó riesgos operativos mucho mayores, aunque es imposible estimar cuánto se habría perdido de haber continuado.
Qué debería haber hecho Lidl: resolver el conflicto entre estandarizar y diferenciar antes de invertir
La lección de Lidl suele formularse como un mandamiento: si tus procesos no encajan en el estándar del ERP, cambia tus procesos. Es una buena regla general y una mala lectura de este caso. Para una empresa de descuento, gobernar el margen desde el precio de compra puede ser perfectamente una ventaja competitiva que no conviene sacrificar. El error de Lidl no fue defender su forma de valorar el inventario, ni tampoco fue elegir SAP; fue no decidir explícitamente cuál de las dos cosas iba a ceder antes de comprometer siete años de inversión.
Ese conflicto tenía que haberse resuelto al principio, y había una manera concreta de hacerlo. Antes de aprobar el programa completo, la empresa debía haber exigido una demostración, con transacciones completas y datos reales, de que la solución elegida podía gestionar el modelo de valoración y de reposición de Lidl sin personalizaciones desproporcionadas. No una presentación del fabricante ni un prototipo sobre datos de ejemplo, sino el recorrido entero de una mercancía real, desde el pedido al proveedor hasta el informe de margen que lee el comprador, con la lógica de la casa. Si esa demostración salía bien, se seguía adelante. Si salía mal, la empresa tenía delante una decisión clara y barata, porque aún no había gastado casi nada: cambiar su forma de trabajar en ese proceso, aceptar una adaptación acotada y presupuestada solo para él, o descartar la sustitución.
Esa decisión, además, exigía una conversación que en muchas empresas no se produce nunca entre negocio y tecnología: qué parte del modelo de Lidl podía estandarizarse sin perder nada importante, y qué parte constituía una ventaja operativa que no debía tocarse. Es una conversación incómoda porque obliga a los responsables del negocio a distinguir entre lo que hacen por convicción y lo que hacen por costumbre, y obliga a tecnología a reconocer que no todo se resuelve configurando. Pero es la única que evita el camino del medio, el de adaptar el software poco a poco sin haber decidido nunca hasta dónde. Y debía ir acompañada de un criterio de parada escrito: qué tendría que ocurrir para que la empresa reconsiderara el programa. Con un criterio así, la señal de que el sistema no llegaba a Alemania después de cinco años habría obligado a una revisión formal mucho antes de 2018.
La lección de Lidl, formulada para quien dirige una transformación, es por tanto más precisa que el mandamiento habitual. Un ERP estándar aporta valor cuando simplifica procesos; si para implantarse tiene que reproducir mediante miles de excepciones todas las particularidades de un sistema antiguo, puede terminar siendo una sustitución muchísimo más cara que aquello que pretendía mejorar. Y la decisión sobre qué se adapta, el negocio o el software, no puede quedarse dentro del proyecto: tiene que tomarla la dirección, por escrito, antes de que el dinero empiece a gastarse.
Caso Haribo: cómo los datos maestros de una migración a SAP S/4HANA afectaron a la fabricación y al suministro
Si Lidl es el caso del proyecto que nunca llegó a producción, Haribo es el del proyecto que llegó y descubrió en las fábricas lo que no había descubierto en las pruebas. Y tiene una ventaja poco habitual para quien quiere aprender de él: es uno de los pocos fracasos de ERP explicados con franqueza por sus propios protagonistas, que reconocieron públicamente qué habían subestimado y no culparon al fabricante del software. Eso permite contar el caso con una precisión que en otros solo se puede suponer.
Haribo antes de la transformación: una industria de golosinas más compleja de lo que parece
Haribo es una empresa alemana de propiedad familiar, conocida en todo el mundo por sus golosinas y, sobre todo, por sus ositos de goma, los Goldbären. Desde fuera parece un negocio sencillo: fabricar caramelos y venderlos a supermercados. Desde dentro es una operación industrial de bastante complejidad, porque cada producto exige coordinar recetas, materias primas, formatos, embalajes, lotes, fechas de caducidad, planificación de la producción en varias plantas y pedidos de grandes distribuidores que no admiten demoras. Una referencia de golosinas no es solo un producto: es una combinación concreta de receta, materiales, envase, planta y cliente, y cada una de esas combinaciones tiene que estar bien descrita en el sistema para que la fábrica pueda producirla.
Esa complejidad se multiplica por la dimensión internacional del grupo. Antes de su transformación, Haribo trabajaba con sistemas distintos según países y plantas, con datos que no siempre seguían las mismas reglas y con procesos que se habían ido desarrollando de forma local. Para una empresa que quería crecer de forma coordinada, compartir capacidad entre fábricas y tener una visión común de su negocio, esa fragmentación era un freno evidente.
ONE Haribo: la apuesta por SAP S/4HANA con procesos estándar y pocas modificaciones
En 2015 Haribo puso en marcha una transformación internacional llamada ONE Haribo. Su propósito era armonizar datos, procesos y organización alrededor de una plataforma común, SAP S/4HANA, que entonces era una tecnología reciente. El alcance era ambicioso: alrededor de treinta países, dieciséis instalaciones productivas y cincuenta mercados comerciales. En noviembre de 2018, según la prensa especializada alemana, el equipo tecnológico del programa rondaba las 260 personas, y la planificación original preveía sustituir progresivamente los sistemas antiguos hasta 2020.
Lo más interesante del planteamiento es que era, sobre el papel, exactamente lo contrario de lo que hizo Lidl. La estrategia de Haribo buscaba aprovechar los procesos estándar del software con pocas modificaciones, es decir, adaptar la empresa al sistema y no al revés. Haribo había aprendido la lección que se suele extraer de Lidl, y aun así tuvo una crisis. Lo que demuestra el caso es que adoptar el estándar resuelve un problema, el de la personalización excesiva, pero no resuelve otro que viene antes y que es mucho menos visible: transformar los procesos no elimina las dificultades de trasladar la información antigua al sistema nuevo.
Entre 2015 y 2017 se preparó la plataforma global, con un sistema central, datos armonizados y procesos internacionales comunes. En 2018 llegó la sustitución de los sistemas anteriores en Alemania, con un alcance completo que iba desde la materia prima hasta el producto terminado. Y llegó en un momento cargado: en paralelo, Haribo estaba abordando otras transformaciones productivas y comerciales, entre ellas la puesta en marcha de una nueva fábrica en Grafschaft. Es decir, la empresa cambiaba a la vez el sistema que gobierna su producción y una parte de la capacidad productiva que ese sistema debía gobernar.
Finales de 2018: cuando los datos maestros impidieron fabricar
A finales de 2018 aparecieron los problemas. La fabricación y el suministro dejaron de funcionar con la fiabilidad esperada, y los distribuidores empezaron a experimentar faltas de producto. Las incidencias persistieron hasta febrero de 2019, y la dirección alemana reconocería después que los problemas de suministro habían llegado al 10 % o más. Coincidieron, además, con el tramo del año en el que un fabricante de golosinas se juega una parte importante de sus ventas, la campaña de final de año, lo que agravó el efecto comercial.
Qué falló exactamente lo explicó en noviembre de 2019, en una entrevista con el diario económico Handelsblatt, Andreas Patz, responsable de Haribo en Alemania. Patz reconoció que la empresa había subestimado la complejidad de la transformación. En sus fábricas se producían más de 1.500 referencias distintas, y cada una necesitaba información correcta sobre materiales, recetas, identificadores y procesos. Al migrar esos datos al nuevo sistema aparecieron referencias cuyos identificadores contenían errores o estaban incompletos. Según explicó, había productos que no podían empezar a fabricarse simplemente porque faltaba un número o se había introducido mal en los datos maestros.
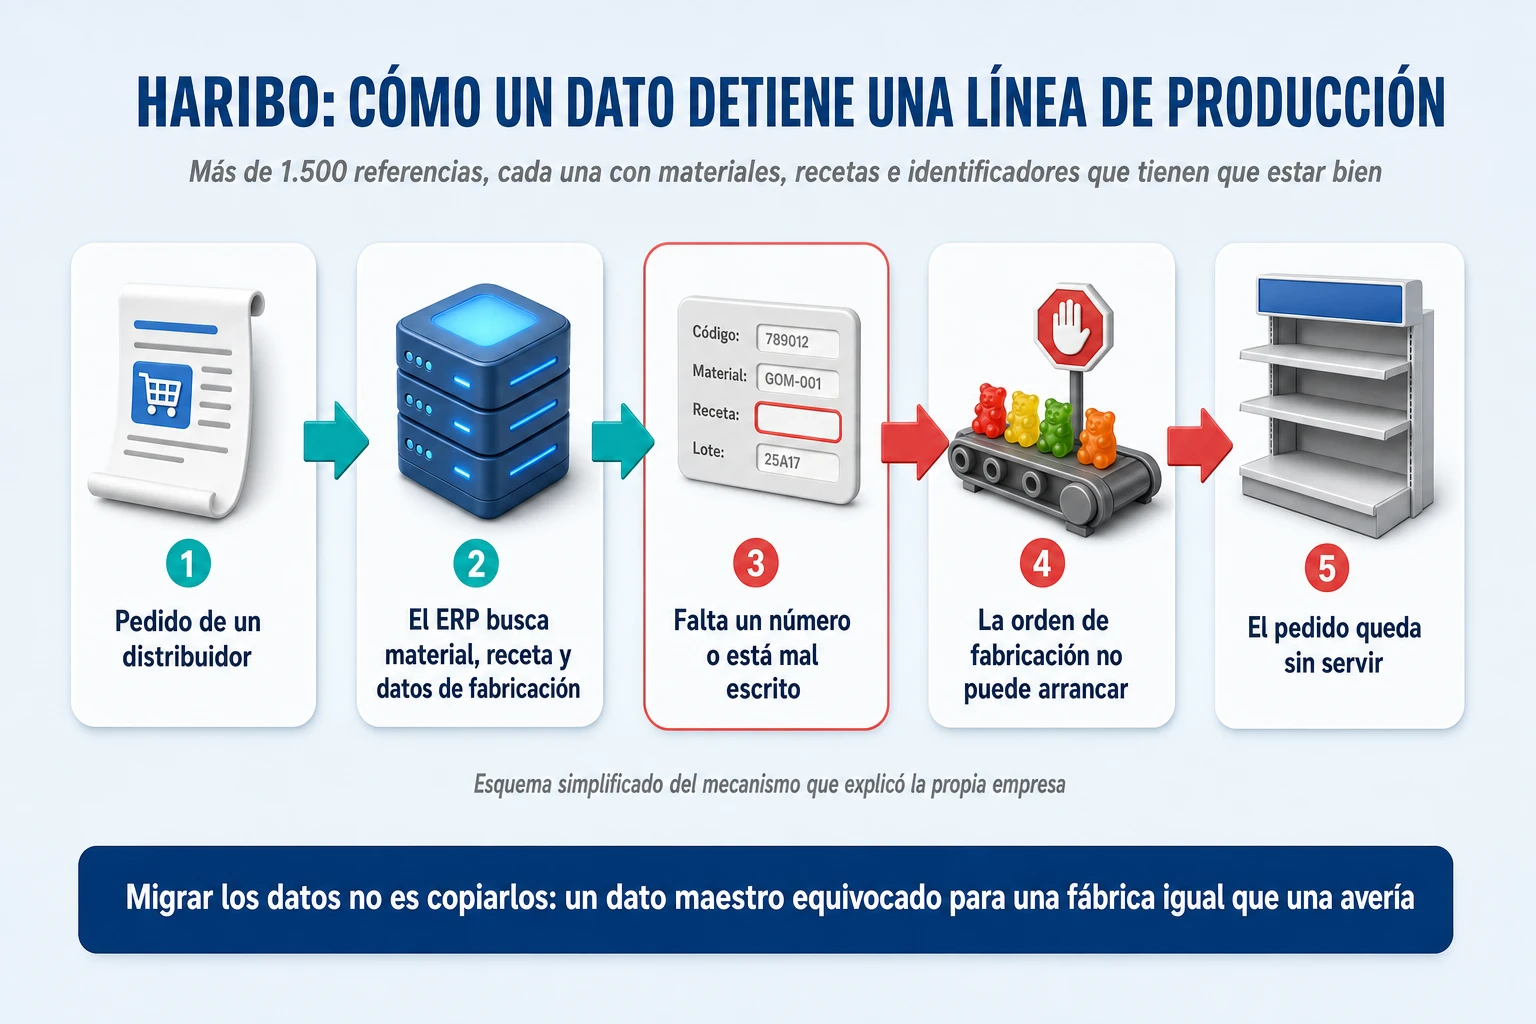
Ese detalle es el corazón del caso y merece detenerse en él. En un ERP integrado, cuando llega el pedido de un distribuidor, el sistema consulta el material, la receta y los datos de fabricación de la referencia pedida para poder planificar su producción. Si la referencia está incompleta o es incorrecta, la orden no puede procesarse con normalidad, la fabricación de ese producto se ve afectada, el producto no está disponible y el pedido queda sin atender. No estamos hablando de una pantalla lenta ni de un empleado que no encuentra un menú: el dato incorrecto se convirtió en una restricción física para la producción, con la misma eficacia que una avería mecánica en la línea. Con la diferencia de que una avería se ve y un dato mal migrado no se ve hasta que alguien intenta usarlo.
Patz fue también explícito en otro punto que las versiones dramáticas del caso suelen omitir: el nuevo sistema había permitido fabricar, expedir y facturar desde el primer día. Hubo una degradación significativa del servicio, no una paralización absoluta de la compañía. Y la entrevista identifica con claridad errores de migración y de calidad de datos, junto con una amplitud excesiva del alcance inicial, pero no ofrece evidencias para atribuir el fallo a una consultora concreta, a una formación deficiente o a un defecto del software estándar. La propia empresa no responsabilizó al fabricante.
Las consecuencias para distribuidores y ventas: una crisis de suministro y un error comercial a la vez
Haribo habló de una inversión en la transformación de un importe de tres cifras en millones de euros, es decir, de varios cientos de millones. No publicó un desglose que permita conocer el presupuesto original, el sobrecoste o la pérdida extraordinaria producida por la crisis. Sí se sabe que sus ventas en Alemania cayeron cerca de un 10 % en 2018, y aquí aparece el matiz más importante de todo el caso, porque la propia dirección identificó una causa que no tenía nada que ver con el ERP.
La compañía había dedicado demasiados recursos a productos con menos azúcar y había descuidado algunas de sus referencias tradicionales, en especial los ositos de oro. Es decir, en el mismo año Haribo sufrió una crisis de suministro provocada por la migración de datos y un error comercial independiente, y las dos se agravaron entre sí: los clásicos que la empresa había dejado de impulsar eran también los que el cliente echaba de menos en el lineal cuando la fábrica no conseguía servirlos. Por eso sería incorrecto afirmar que el ERP hizo caer un 10 % las ventas de Haribo, y lo es todavía más repetir la cifra del 25 % que circula en algunas recopilaciones y que no aparece en ninguna fuente de la empresa. La contribución de cada causa no se ha publicado de manera verificable.
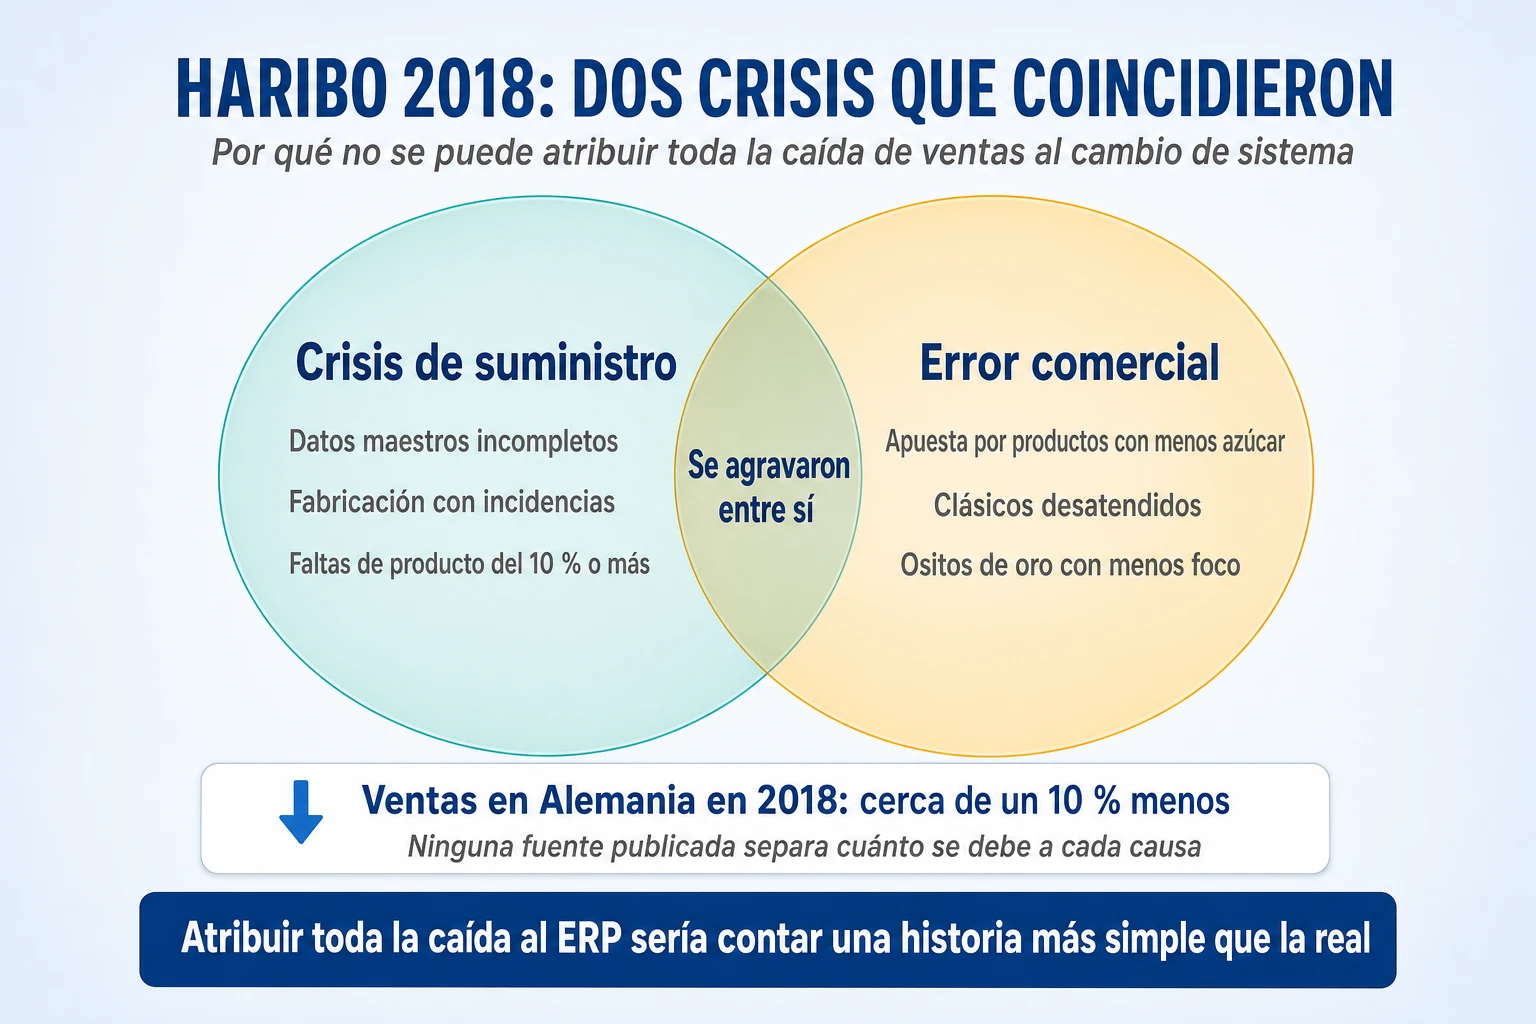
Esta coincidencia es instructiva más allá de Haribo. Cuando una gran transformación tecnológica coincide con otros cambios en el negocio, la tentación natural es atribuir todo lo malo a la tecnología, que es la novedad más visible, y todo lo bueno a la estrategia comercial. Esa atribución casi nunca es cierta y tiene un coste: si la dirección diagnostica mal la causa de una caída de ventas, corrige lo que no estaba roto y deja sin tocar lo que sí lo estaba. Haribo, en este sentido, hizo bien en separar públicamente los dos problemas.
Cómo se recuperó Haribo y qué debería haberse comprobado antes del arranque
La recuperación fue la que cabía esperar de un problema de datos y no de diseño. Haribo corrigió datos y procesos, estabilizó el suministro y recuperó progresivamente su actividad durante 2019. En la segunda mitad de ese año declaró superadas las principales dificultades técnicas. Y, a diferencia de Lidl, no abandonó la plataforma: mantuvo la estrategia de un sistema común y siguió adelante con él. El caso de Haribo no es el de una mala elección tecnológica, sino el de una buena elección puesta en producción antes de tiempo.
La decisión más cuestionable parece haber sido implantar a la vez demasiada profundidad funcional, abarcando toda la cadena industrial desde la materia prima hasta el producto terminado, sin tener antes una garantía suficiente sobre los datos. Y es una decisión de dirección, no técnica, porque la pregunta de fondo es cuánto riesgo está dispuesta a asumir la empresa en un único cambio y en qué momento del año. Cambiar a la vez el sistema que gobierna la producción, poner en marcha una fábrica nueva y hacerlo en el tramo comercialmente más importante del año acumula tres fuentes de riesgo que, por separado, podrían haberse gestionado.
El control que habría marcado la diferencia es concreto y verificable. Antes del arranque, la empresa debía haber demostrado que todas las referencias críticas podían recorrer correctamente el ciclo completo: planificación, orden de producción, fabricación, inventario y expedición. No que el módulo de producción funcionaba ni que los datos se habían cargado sin errores de formato, sino que cada una de las referencias que importan para el negocio atravesaba el proceso entero en el sistema nuevo y salía por el otro lado. Una carga de datos sin errores técnicos no demuestra nada; lo que demuestra que los datos están bien es que el negocio puede operar con ellos. Con más de 1.500 referencias, esa comprobación es laboriosa, pero es mucho más barata que descubrir en la fábrica, referencia a referencia, cuáles tenían un número equivocado.
A ese control se le pueden añadir otros dos que se desprenden del caso como recomendaciones razonadas, no como hechos acreditados. El primero es la secuencia: desplegar primero en una parte acotada del negocio, una planta o una familia de productos, permite descubrir los errores de datos con un coste limitado antes de exponer toda la producción. El segundo es el calendario: cuando el negocio tiene una temporada fuerte, la puesta en producción de un sistema crítico debe programarse lejos de ella, porque en esas semanas la empresa no tiene margen para absorber una degradación del servicio y cada día de retraso cuesta mucho más que en cualquier otro momento del año.
La lección de Haribo, en una frase, es que migrar los datos no es copiarlos. Una transformación aparentemente administrativa, cambiar el sistema en el que se registran los productos y las órdenes, puede interrumpir el funcionamiento de toda la cadena de valor cuando los procesos están fuertemente conectados entre sí. Y la única forma de saber si lo hará es probar esa cadena de punta a punta, con los datos reales, antes de que de ella dependan los pedidos de los clientes.
Caso DHL Global Forwarding: una plataforma global de 345 millones que no superó los países piloto
El caso de DHL tiene una particularidad que lo hace muy valioso: la cifra está acreditada al céntimo, porque la comunicó el propio grupo con su desglose, y en cambio casi todo lo demás es incierto. Se sabe cuánto se dio por perdido, cuándo y por qué en términos generales, pero no se conoce con precisión qué falló técnicamente ni qué efecto tuvo sobre los clientes. Precisamente por eso es un buen caso para aprender a separar lo que se sabe de lo que se cuenta, y para entender qué papel debería tener un despliegue piloto en un programa internacional.
DHL Global Forwarding: el negocio de organizar el transporte internacional de mercancías
Deutsche Post DHL es uno de los mayores grupos logísticos del mundo, pero este caso no tiene que ver con el reparto de paquetes por el que el público conoce la marca. El protagonista es DHL Global Forwarding, la división especializada en organizar el transporte internacional de mercancías por vía aérea, marítima y terrestre para empresas. Un transitario no es dueño de los aviones ni de los barcos: contrata espacio a las navieras y aerolíneas, coordina a operadores y agentes en origen y en destino, prepara la documentación aduanera, sigue la expedición en cada tramo, gestiona lo que sale mal y factura al cliente.
Es un negocio de coordinación y de excepciones. Una misma operación puede involucrar varios países, varios sistemas, varios agentes y varios proveedores, y cada país tiene sus reglas aduaneras, sus documentos y sus costumbres comerciales. El valor que vende un transitario es precisamente la capacidad de absorber esa variedad sin que el cliente la note, lo que significa que su operación real está llena de casos particulares que no aparecen en ningún diagrama de procesos de alto nivel.
New Forwarding Environment: la apuesta por una plataforma común para una red internacional
Para modernizar su actividad, DHL impulsó New Forwarding Environment, conocido por sus siglas, NFE: una plataforma global que debía sustituir progresivamente las aplicaciones que usaba la división en los distintos países. El objetivo era disponer de un entorno operativo integrado que mejorase la visibilidad de las expediciones, simplificase la documentación y permitiera estandarizar las operaciones internacionales. Para un grupo con una red enorme y sistemas heterogéneos, la ambición era razonable: una sola forma de trabajar, una sola fuente de información y la posibilidad de mejorar todo el negocio a la vez en lugar de país por país.
Conviene hacer una precisión que casi nunca se hace. NFE no era simplemente una implantación de un ERP, sino una plataforma de gestión logística construida sobre componentes tecnológicos que incluían software de SAP. Es decir, una parte importante de lo que había que construir era específica del negocio del transitario y no venía resuelta en ningún producto. Cuanto más de la solución hay que construir, más se parece el programa a un desarrollo a medida y menos aplicables son las ventajas que se atribuyen a comprar un producto de mercado. Es un dato relevante para entender el riesgo que se estaba asumiendo, aunque no aparezca en los resúmenes habituales del caso.
Los países piloto de NFE: qué se sabe del fallo y qué no se puede afirmar
En 2014 el desarrollo de NFE avanzaba como pieza central de la modernización de la división, y entre 2014 y 2015 se hicieron implantaciones en países piloto para probar el nuevo entorno operativo con expediciones reales. En los primeros meses de 2015 aparecieron problemas importantes de funcionamiento y de implantación, y el programa dejó de progresar según lo previsto. Por esas mismas fechas, el consejero delegado de la división, Roger Crook, dejó el cargo, una salida que la prensa económica relacionó con las dificultades del negocio y de su programa tecnológico.
Qué falló exactamente es la parte que la documentación pública no permite reconstruir con precisión. Lo que sí se puede describir es la naturaleza del desafío, porque se deduce del propio alcance del proyecto. NFE tenía que resolver a la vez tres problemas. El primero era estandarizar el proceso: una operación de transporte internacional tiene reglas y excepciones distintas según el país, la mercancía, el medio de transporte y el cliente, e implantar una misma plataforma obliga a decidir qué procedimientos serán realmente comunes y cuáles no. El segundo era integrar sistemas: la visibilidad de una expedición depende de recibir y correlacionar datos de muchas aplicaciones, operadores y agentes, y una plataforma puede funcionar técnicamente y, aun así, no ofrecer una operación fiable de punta a punta. El tercero era la transición de operaciones vivas: cambiar el entorno con el que se gestionan expediciones en curso introduce riesgos de interrupciones, pérdida de visibilidad y errores documentales.
Esas son las áreas de riesgo coherentes con lo que intentaba hacer NFE. Lo que no se puede afirmar con las fuentes disponibles es que una determinada interfaz aduanera fallara, que se perdiera el rastro de miles de contenedores o que la facturación de la división se colapsara, aunque algunas recopilaciones del caso lo den por hecho. Sería convertir una hipótesis técnica en un hecho. Tampoco hay una cuantificación pública sólida de ventas perdidas, envíos retrasados o penalizaciones causadas por NFE. El coste económico acreditado es mucho más claro que el impacto operativo concreto, y así hay que contarlo.
Octubre de 2015: 345 millones de euros y la retirada del sistema de los países piloto
En octubre de 2015 la dirección del grupo concluyó que era improbable obtener los beneficios esperados con el sistema en su estado de entonces, y el 28 de ese mes Deutsche Post DHL comunicó oficialmente un impacto extraordinario de 345 millones de euros. El comunicado tiene la virtud de distinguir las partidas: 308 millones correspondían al deterioro de los activos de NFE, es decir, a la parte de la inversión que se daba por irrecuperable, y 37 millones a una provisión para retirar el sistema de los países piloto, lo que suponía volver a las aplicaciones anteriores donde ya se había implantado.
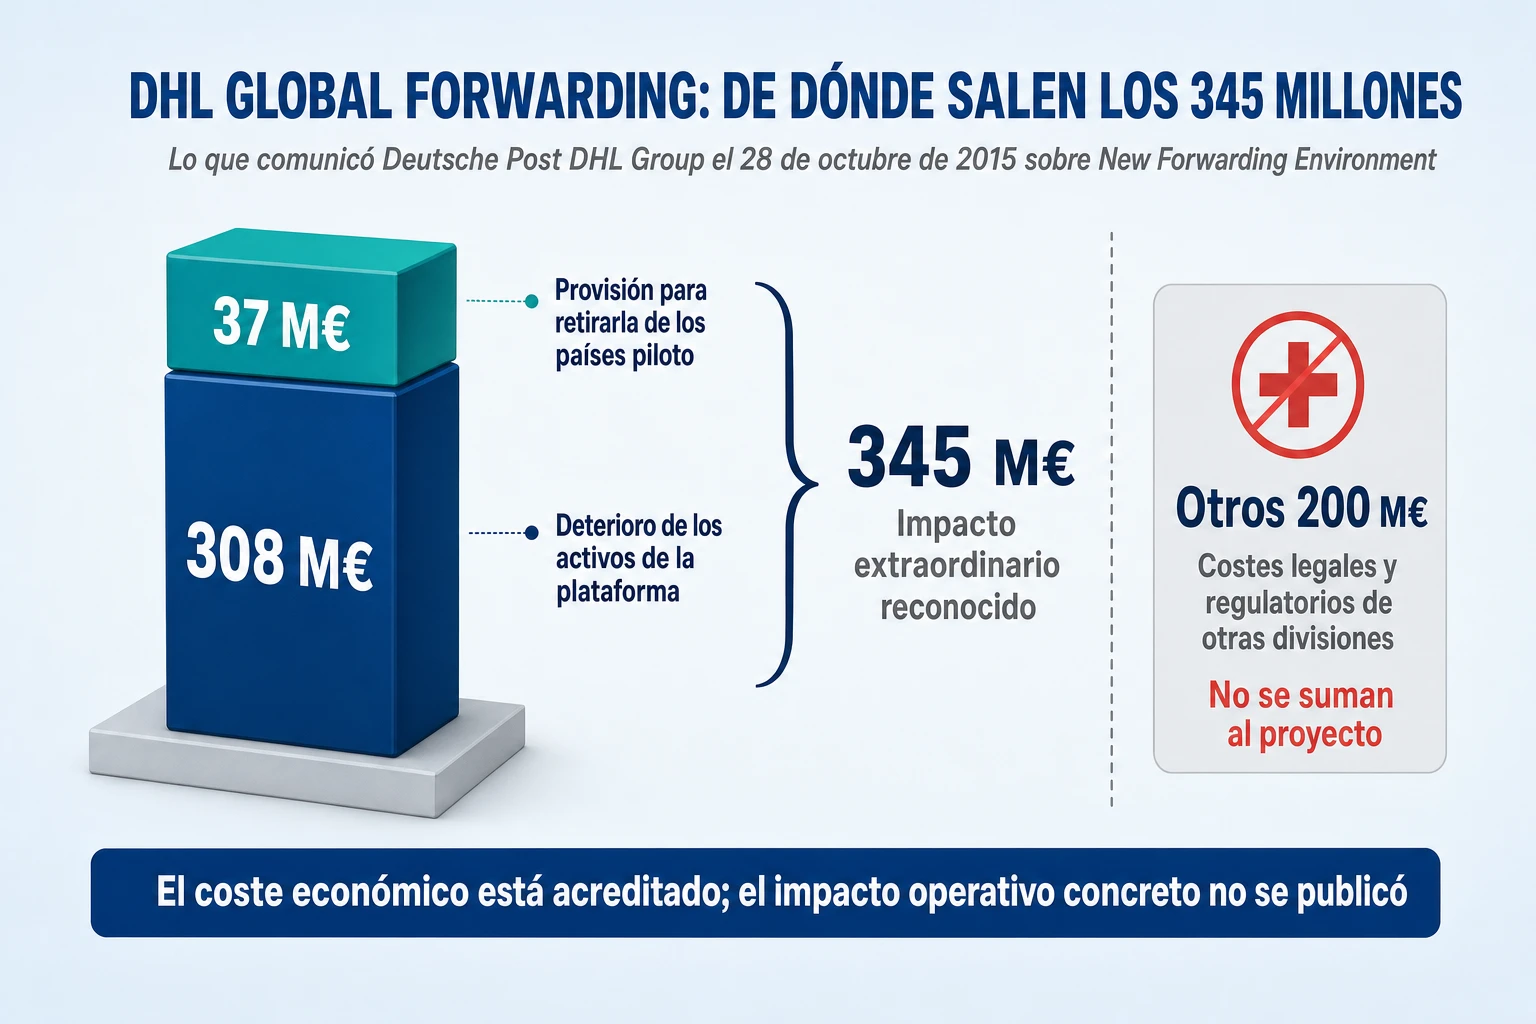
Ese mismo día el grupo anunció otros posibles costes extraordinarios cercanos a 200 millones de euros, relacionados principalmente con cuestiones legales y regulatorias de distintas divisiones. Esos 200 millones no deben sumarse a NFE como si fueran una pérdida adicional del proyecto, y es un error frecuente en las versiones del caso que hablan de más de 500 millones. El impacto del programa es el que el propio grupo atribuyó a él.
Frank Appel, entonces consejero delegado del grupo, reorientó el planteamiento hacia una renovación más gradual y basada en las necesidades operativas de la división. DHL abandonó la idea de transformar toda la operación de una vez mediante una plataforma global todavía no demostrada, y optó por una modernización incremental. La decisión fue económicamente dolorosa, pero evitó extender a toda la red un sistema cuya viabilidad ya se consideraba insuficiente, que habría sido mucho más caro. Detenerse en la fase piloto es exactamente lo que debe hacer un programa que no funciona; lo discutible es cuánto se había invertido antes de que el piloto diera su veredicto.
El reparto de responsabilidades entre DHL, SAP y el integrador
El caso es interesante también por las discrepancias públicas entre los participantes, que ilustran un problema que se repite en los grandes programas: cuando algo falla, la responsabilidad se diluye entre el cliente, el fabricante del software y el integrador. SAP suministró software de base y licencias, pero declaró que no actuaba como contratista principal de la implantación. La propia DHL señaló que, con la información de la que disponía entonces, el problema no parecía residir principalmente en el proveedor del software base, sino en la configuración, la ampliación y la implantación piloto. Y la prensa especializada identificó a IBM como probable contratista principal del programa, una atribución que DHL no confirmó públicamente cuando se le preguntó.
Es razonable, por tanto, mencionar a IBM como participante señalado por la prensa, pero no presentar su responsabilidad contractual como un hecho demostrado. Lo relevante para quien dirige una transformación no es repartir culpas a posteriori, sino lo que este intercambio revela: tres organizaciones implicadas y ninguna que asumiera públicamente la responsabilidad del resultado de negocio. Cuando eso ocurre después del fracaso, casi siempre es porque tampoco estaba asignada antes. La responsabilidad de que la plataforma funcionara técnicamente podía repartirse entre proveedores; la responsabilidad de que la operación de la división mejorara con ella solo podía ser de DHL.
Qué debería haber hecho DHL: usar el piloto para descubrir si la solución era viable, no para confirmarlo
Lo más cuestionable del programa fue intentar transformar una red internacional de operaciones mediante un modelo tecnológico global que todavía no había demostrado su viabilidad en los pilotos. Y aquí está la lección central del caso, que va más allá de DHL. Un piloto puede diseñarse para confirmar que una solución funciona o para descubrir si es realmente viable, escalable y replicable, y son dos ejercicios completamente distintos. El primero elige un entorno favorable, mide si el sistema hace lo que debe y trata los problemas como incidencias que hay que cerrar para poder seguir. El segundo elige los casos más difíciles, mide si el negocio mejora y trata los problemas como información sobre si conviene seguir.
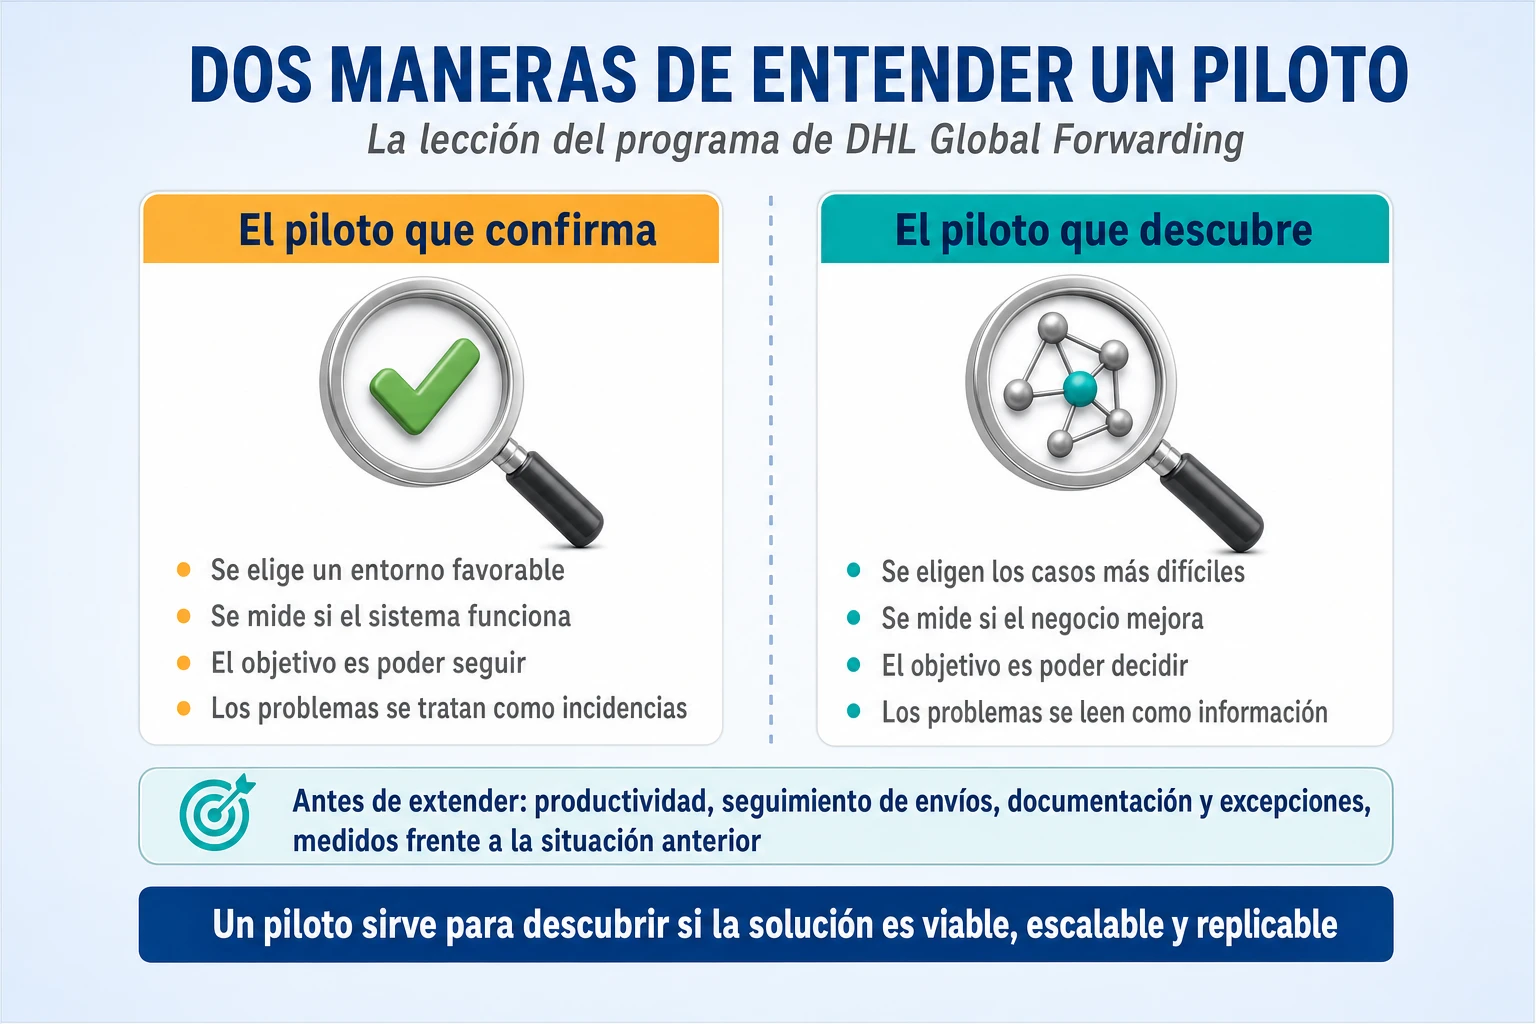
En la práctica, eso significa que antes de aprobar un despliegue amplio, NFE debía haber demostrado mejoras reales en lo que de verdad importa para un transitario: la productividad de quienes gestionan las expediciones, el seguimiento de los envíos, la gestión documental y el tratamiento de excepciones, medidos frente a la situación anterior en los mismos países. Y el diseño de los pilotos debía haber incluido deliberadamente la variedad que el sistema tendría que absorber después, con países de reglas aduaneras distintas, tipos de mercancía diferentes y los clientes más exigentes, no solo los entornos más manejables. Un piloto que solo funciona en condiciones favorables no ha demostrado nada sobre la red completa.
Hay una segunda lección, menos evidente, sobre la ambición del diseño. Cuando una plataforma pretende ser común para una red con la diversidad operativa de un transitario internacional, la pregunta decisiva no es si se puede construir, sino qué parte de la operación debe ser realmente común y qué parte necesita adaptarse a cada mercado. Una plataforma que estandariza la información, la contabilidad y los datos de las expediciones puede convivir perfectamente con variaciones locales en los procesos aduaneros y documentales; una que pretende uniformarlo todo multiplica los casos particulares que tiene que resolver antes de funcionar en cualquier sitio. Este dilema reaparecerá en LeasePlan y en Kingfisher. La lección de DHL, en una frase, es que integrar un negocio internacional no consiste en conectar aplicaciones, sino en demostrar que el nuevo modelo funciona en todas las operaciones que pretende soportar.
Caso Asda: la separación tecnológica de Walmart, más de 2.500 sistemas y 1.224 millones de libras
Asda es el caso más reciente de los siete y el que mejor representa la complejidad de una gran transformación en 2025: ERP en la nube, cientos de aplicaciones heredadas, comercio electrónico, almacenes, cajas, nóminas e integraciones entre todo ello. Es también el único en el que la empresa no tenía la opción de no hacerlo. Asda no decidió transformarse porque quisiera modernizar sus sistemas; tuvo que hacerlo porque al cambiar de dueño se quedó sin los sistemas que usaba. Eso hace que el caso no trate de si había que emprender el programa, sino de cómo se organizó, cuánto riesgo se concentró en él y qué se entendió por terminarlo.
Conviene advertir desde el principio que presentar Asda como la implantación de un ERP sería inexacto. El nuevo núcleo de SAP fue una pieza importante del programa, pero solo una entre muchas. Lo que Asda emprendió fue la separación completa de una infraestructura tecnológica corporativa, y los problemas más graves no aparecieron en el ERP, sino en los flujos que conectaban almacenes, tiendas y canal online.
Asda antes de la separación: un gran supermercado británico que funcionaba con la tecnología de Walmart
Asda es una de las mayores cadenas de supermercados del Reino Unido. Durante unas dos décadas formó parte de Walmart, y en ese tiempo se apoyó en la infraestructura tecnológica de su matriz para casi todo: finanzas, personal y nóminas, compras, gestión de productos, almacenes, tiendas, cajas, aplicaciones comerciales y comercio electrónico. Para una filial, esa dependencia es una ventaja mientras dura, porque disfruta de sistemas de escala mundial sin tener que construirlos ni mantenerlos. Y se convierte en un problema enorme el día que la filial deja de serlo.
Ese día llegó en 2021, cuando Walmart vendió la mayoría de Asda a los hermanos Issa y al fondo TDR Capital. La nueva propiedad necesitaba que el supermercado dejara de depender de los sistemas de Walmart, y para dar tiempo a hacerlo se pactó un periodo de servicios tecnológicos transitorios, durante el cual Walmart seguiría prestando esos servicios a cambio de un pago. El reloj de la transformación lo marcaba, por tanto, un acuerdo contractual con la antigua matriz, y cada mes adicional de dependencia tenía un coste directo.
Project Future: por qué la venta obligó a sustituir más de 2.500 sistemas
El programa de separación recibió el nombre de Project Future, y su alcance era enorme: más de 2.500 sistemas heredados que había que sustituir, independizar o reconstruir, incluidos los procesos financieros, de personal y nóminas, de compras, de tiendas y cajas, de almacenes, las aplicaciones comerciales, el comercio electrónico y la gestión de productos. Para el núcleo de gestión, Asda eligió SAP S/4HANA en su modalidad de servicio en la nube, con infraestructura relacionada en Microsoft Azure. Tata Consultancy Services participó en distintas actividades de transformación e integración, y hubo otros proveedores especializados para otras partes del programa.
Hay una decisión implícita en ese planteamiento que merece señalarse, aunque las fuentes públicas no expliquen cómo se tomó. Ante una separación forzosa, una empresa puede intentar dos cosas. Puede hacer una separación lo más parecida posible a lo que tenía, replicando sus sistemas para independizarse primero y transformarse después, con calma. O puede aprovechar la separación para sustituir los sistemas por otros nuevos y distintos, independizándose y transformándose a la vez. Asda hizo lo segundo, que es más ambicioso, potencialmente más rentable a largo plazo y mucho más arriesgado, porque suma al riesgo de la separación el riesgo de cambiar la forma de trabajar. No hay una respuesta correcta en abstracto, pero sí una consecuencia inevitable: un programa que separa y transforma al mismo tiempo acumula dependencias que una separación pura no tendría.
El presupuesto de referencia que difundió la prensa británica fue de unos 800 millones de libras. Es una estimación periodística y no debe confundirse con un presupuesto contractual auditado, pero sirve para dar escala a lo que vino después.
El calendario y las dependencias: separarse de Walmart mientras el supermercado sigue abierto
La cronología de Project Future muestra un programa que fue más lento de lo previsto durante años y que concentró al final su momento más delicado. En 2021 comenzó la separación. Entre 2022 y 2023 se construyó el nuevo entorno y se ejecutaron migraciones y proyectos paralelos de gran complejidad; la transición resultó más lenta de lo planificado. En enero de 2024 Asda sustituyó el entorno SAP heredado de Walmart por su nueva instancia de S/4HANA, un hito importante, pero el programa completo seguía abierto. A lo largo de 2024 se desplegaron de forma masiva nuevas cajas, herramientas de compra, sistemas de personal, plataformas de distribución y de comercio electrónico, y la propia empresa anunció miles de dispositivos instalados y la formación de un gran número de empleados.
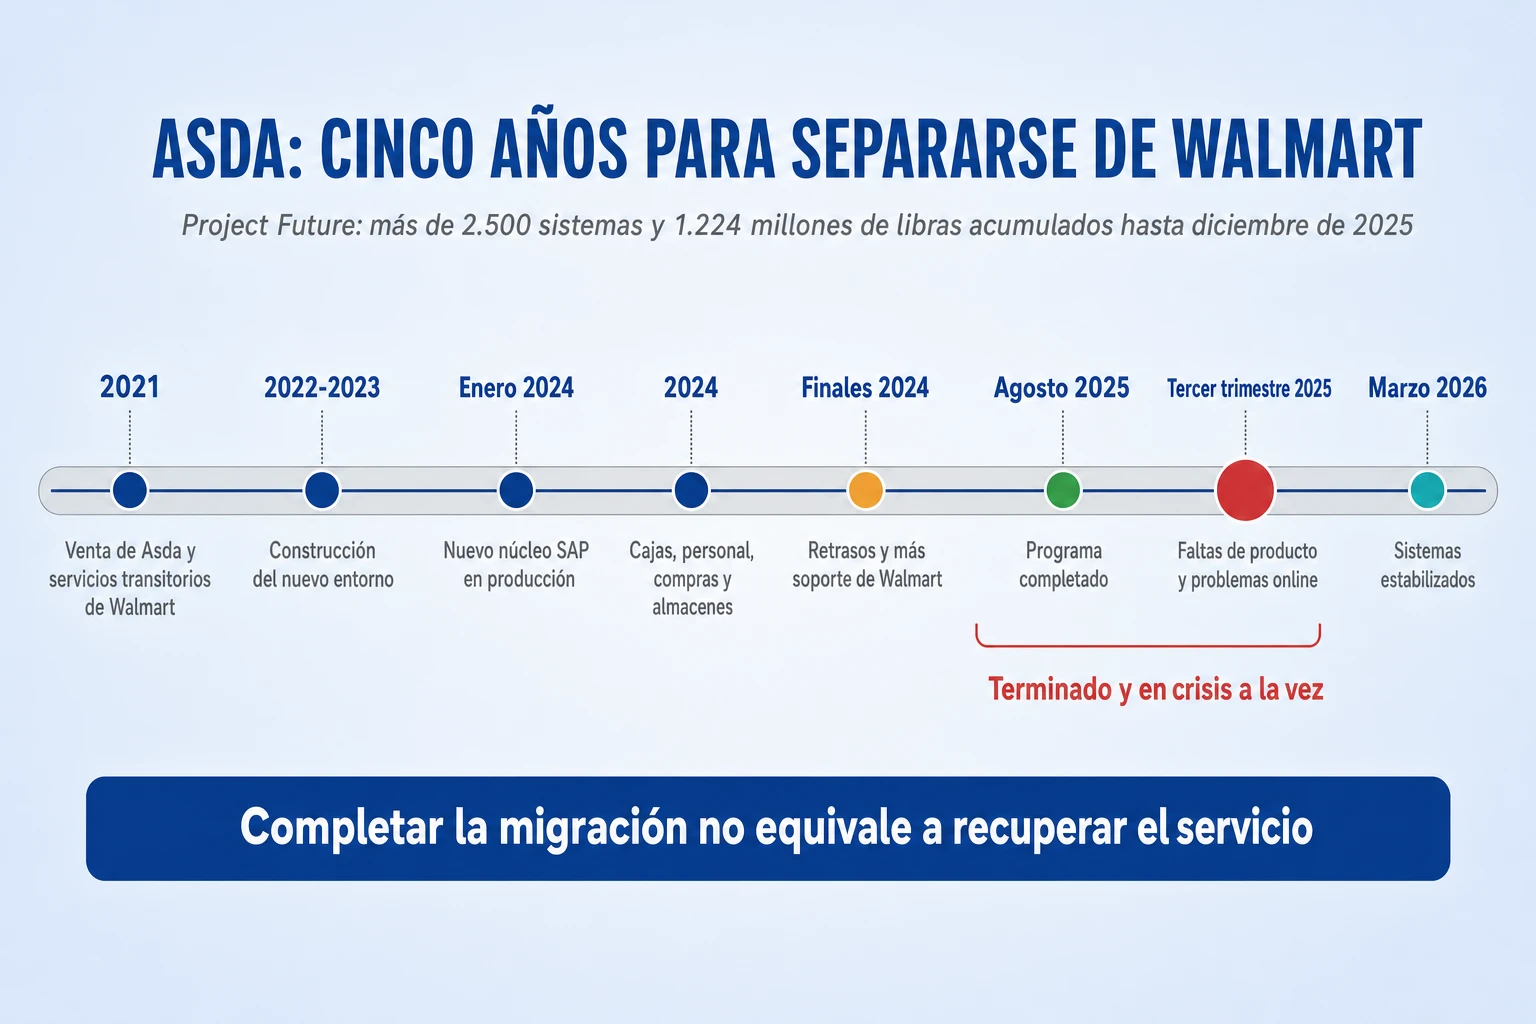
Ese mismo año aparecieron también los primeros efectos sobre las personas. La prensa británica y los sindicatos informaron de errores en el pago de nóminas a una parte de la plantilla tras el cambio de los sistemas de personal, un tipo de incidencia que en un supermercado con decenas de miles de empleados por hora tiene un impacto humano inmediato y un coste reputacional difícil de medir. A finales de 2024 y principios de 2025 determinadas migraciones se aplazaron y siguió siendo necesario el soporte transitorio de Walmart, lo que significaba seguir pagándolo.
En esa fase, el programa estaba sometido a una tensión que es típica de las separaciones corporativas. Por un lado, cada mes de retraso tenía un coste visible en forma de pagos a la antigua matriz, y la presión para terminar era legítima. Por otro, terminar significaba retirar la red de seguridad, porque una vez apagados los servicios de Walmart ya no había un sistema anterior al que volver. Cuando el plazo lo marca un contrato y la vuelta atrás desaparece al cumplirlo, la decisión de dar el último paso es la más importante de todo el programa, y es la que menos admite que se tome por calendario.
Agosto de 2025: el programa se completa y las tiendas se quedan sin producto
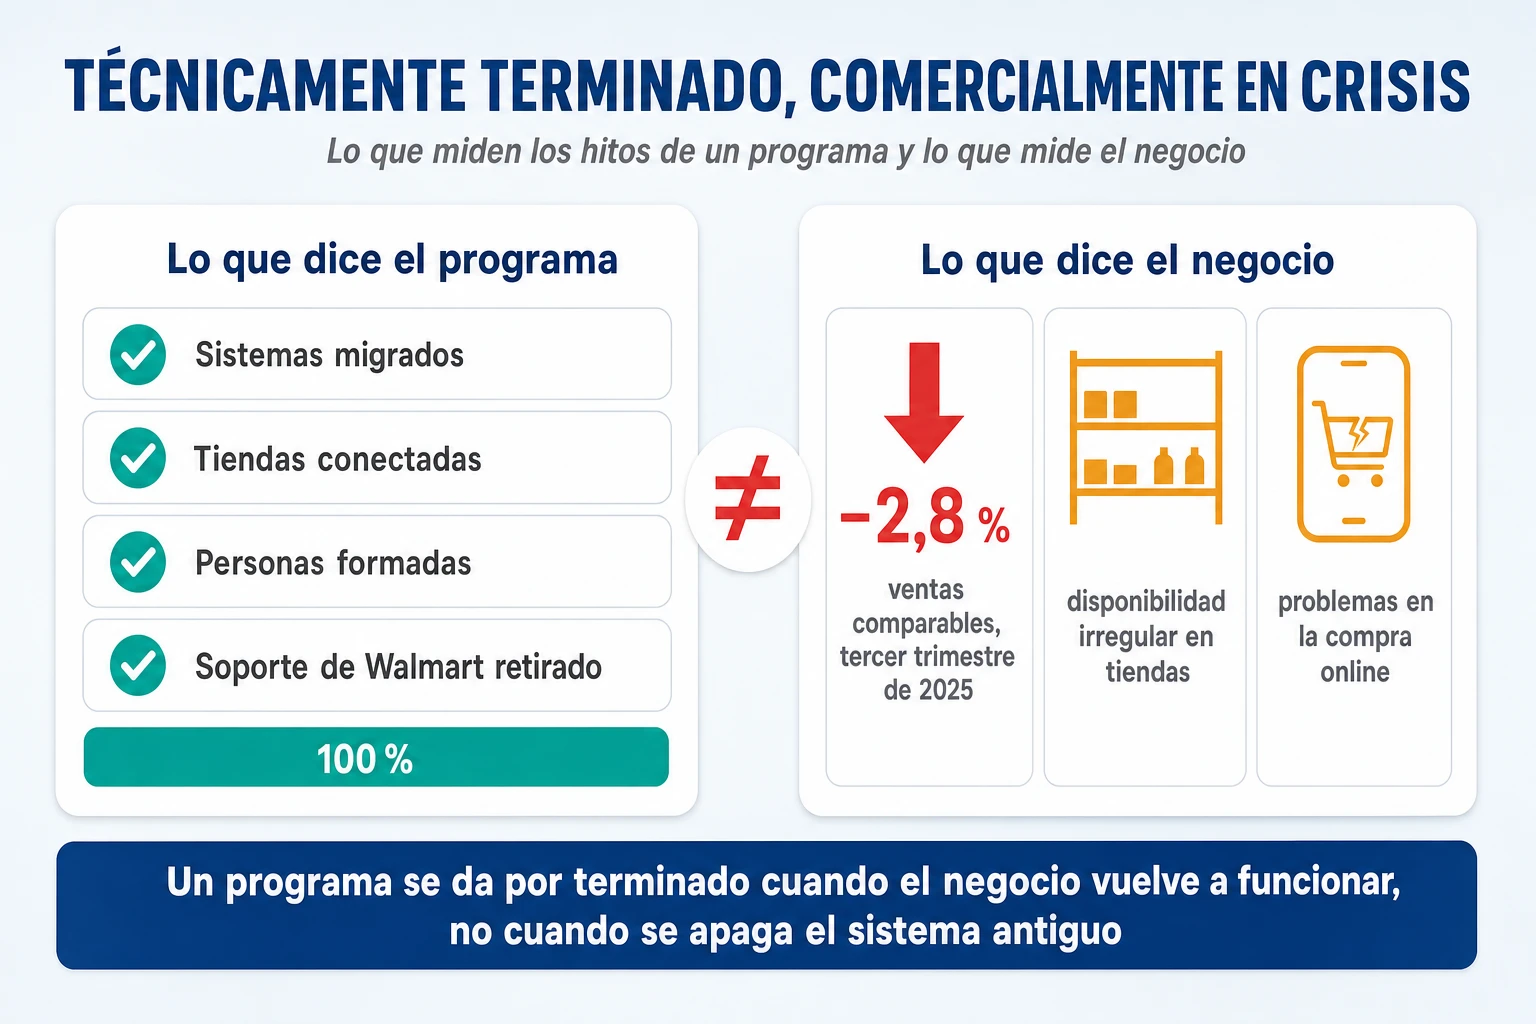
En agosto de 2025 Asda anunció la finalización del programa: todos sus centros principales y todas sus tiendas pasaban a funcionar sobre sistemas propios. Ese mismo mes lanzó su nueva web y su nueva aplicación de compra. Y en el tercer trimestre de 2025 llegó la crisis operativa. La transición provocó dificultades graves en la circulación de mercancías desde los almacenes a las tiendas y en la experiencia de compra digital. La empresa explicó que el cambio había afectado especialmente al movimiento de existencias entre centros de distribución y tiendas, lo que se tradujo en una disponibilidad irregular de productos en los establecimientos y en los pedidos a domicilio. Al mismo tiempo, la nueva web y la aplicación generaron problemas funcionales y dificultades para los clientes.
Este es el punto en el que Asda se separa de todos los demás casos. En Asda no se canceló nada después de años de trabajo, ni falló un dato maestro concreto en una fábrica. El problema fue desplegar un ecosistema tecnológico nuevo que, al entrar en operación completa, no garantizó adecuadamente los flujos comerciales y logísticos de los que vive un supermercado. Y en un supermercado esa diferencia se paga enseguida, porque el cliente no necesita conocer la causa de un fallo tecnológico: si no encuentra el producto o la compra online le da problemas, simplemente va a otro establecimiento, y no siempre vuelve.
Lo más valioso del caso es que la propia dirección explicó por qué había ocurrido. Allan Leighton, presidente ejecutivo de Asda, reconoció públicamente que los problemas habían sido autoinfligidos, y según recogió la prensa especializada señaló tres causas: integraciones deficientes, pruebas insuficientes antes del despliegue y problemas de planificación de la capacidad. No es una explicación construida a posteriori por consultores externos ni por la competencia. Es la dirección de la empresa reconociendo debilidades de ejecución, lo que la hace especialmente útil. El problema estructural, en cualquier caso, era el que ya se ha descrito: Asda no estaba haciendo una migración aislada, sino desconectándose de Walmart mientras sustituía a la vez numerosos sistemas fundamentales para vender y operar.
Las consecuencias económicas de Project Future: inversión acumulada, ventas y resultados
Las cuentas de Asda sitúan los desembolsos acumulados de Project Future en 1.224 millones de libras hasta el 31 de diciembre de 2025, frente a los 800 millones que se habían citado como referencia. Es una cifra de inversión y de costes de separación, no una pérdida contable ni dinero necesariamente desperdiciado, porque al final Asda terminó operando con una plataforma propia, que era lo que necesitaba. Para evaluar el fracaso hay que separar esa inversión del deterioro temporal del negocio.
En la comunicación oficial de resultados de noviembre de 2025, Asda informó de una caída del 2,8 % en sus ventas comparables del tercer trimestre y afirmó que los problemas tecnológicos habían perjudicado materialmente sus resultados comerciales de ese periodo, sobre todo por las faltas de producto y la mala experiencia online. En el conjunto de 2025, la compañía registró una caída del 3,3 % en las ventas sin combustible y una reducción del 33,1 % en su resultado bruto de explotación ajustado. Aquí hay que aplicar la misma prudencia que en Haribo: sería incorrecto imputar todo ese descenso al programa tecnológico, porque en ese periodo Asda también afrontaba una fuerte presión competitiva, inversiones en precios y otros problemas de recuperación de su negocio que venían de antes.
La recuperación de Asda y lo que habría que haber validado antes del último corte
Durante los últimos meses de 2025 Asda concentró sus esfuerzos en estabilizar las plataformas y restablecer el funcionamiento de almacenes, tiendas y canal online. En noviembre informó de que la disponibilidad de producto volvía a superar el 95 %. En marzo de 2026 declaró completado Project Future y estabilizados sus sistemas principales, aunque la recuperación comercial seguía siendo una tarea pendiente. Y hay un dato especialmente revelador sobre lo que cuesta realmente un programa así: la empresa atribuyó a los problemas de la transición un retraso de unos seis meses en sus objetivos de recuperación comercial. Ese es el coste que no aparece en la cifra de 1.224 millones y que, para una cadena que estaba intentando recuperar cuota de mercado, probablemente pesó más.
La separación de Walmart era una necesidad contractual y empresarial, y no podía simplemente aplazarse para siempre. Pero el programa parece haber concentrado demasiado riesgo en una transición que combinaba muchos sistemas y canales a la vez, y haber validado mejor cada aplicación por separado que la operación completa. El control que habría marcado la diferencia consiste en comprobar no solo que cada sistema funciona, sino que los recorridos completos del negocio mantienen su rendimiento en condiciones reales: el pedido al proveedor, la recepción en el almacén, la asignación a cada tienda, la reposición, la compra presencial u online, la entrega y la contabilización. Ninguno de esos pasos pertenece a un solo sistema, y por eso ninguna prueba de un solo sistema puede demostrar que el recorrido funciona.
A eso se añaden dos controles que el propio diagnóstico de la dirección señala. El primero es demostrar la capacidad bajo picos de demanda antes de retirar la red de seguridad, porque un supermercado no tiene semanas tranquilas en las que absorber una degradación, y la planificación de capacidad fue una de las causas reconocidas. El segundo es limitar los despliegues simultáneos: lanzar una web y una aplicación nuevas el mismo mes en que se completa la separación de los sistemas logísticos multiplica las cosas que pueden fallar a la vez y complica enormemente saber cuál ha fallado. Un programa de este tamaño necesita una secuencia que permita aislar los problemas, y una regla explícita para no acumular cambios críticos en la misma ventana.
La lección de Asda es quizá la más contemporánea de las siete. Una transformación puede estar técnicamente terminada y comercialmente fracasando al mismo tiempo; completar la migración no equivale a recuperar el servicio. Y en los programas complejos, con muchas dependencias y plazos difíciles de mover, la gestión del riesgo no consiste en cumplir la fecha, sino en organizar las piezas para que, si algo falla, falle una sola cosa cada vez y haya todavía un lugar al que volver.
Caso LeasePlan: 98 millones en un núcleo común de SAP que dejó de servir a la estrategia digital
LeasePlan es el caso menos espectacular de los siete y uno de los más útiles para un consejo de administración. No hubo fábricas paradas ni tiendas vacías. No hubo clientes afectados de forma visible. Hubo un programa que, mientras se construía, dejó de ser la respuesta correcta a la pregunta que la empresa se estaba haciendo, y una dirección que acabó reconociéndolo. Es la historia de cómo una inversión puede volverse inadecuada sin que nada falle, simplemente porque la estrategia se mueve más deprisa que el proyecto.
LeasePlan antes de la transformación: una federación de filiales con unos 35 sistemas de gestión
LeasePlan, de origen neerlandés, era uno de los mayores especialistas del mundo en renting y gestión de flotas de vehículos. Su actividad iba mucho más allá de financiar coches: incluía el mantenimiento, los seguros, los servicios a los conductores, la gestión de los contratos durante toda su vida y la reventa de los vehículos al terminar. Es un negocio en el que cada país tiene su fiscalidad, sus normas sobre vehículos, sus productos y sus costumbres comerciales, y en el que un mismo cliente multinacional puede querer condiciones homogéneas en todos ellos.
Históricamente, muchas filiales habían desarrollado su propio modelo operativo, y eso se reflejaba en sus sistemas. En 2017 la organización mantenía alrededor de 35 sistemas de gestión principales repartidos entre sus empresas: en Países Bajos utilizaba Oracle FLEXCUBE, en varios países europeos soluciones de White Clarke, y en Australia existía una implantación de SAP Leasing. LeasePlan era, en la práctica, una federación de empresas relativamente autónomas con una marca común, y esa fragmentación dificultaba integrar la información, compartir procesos y mejorar la eficiencia del conjunto.
En 2016 la compañía pasó a manos de un consorcio de inversores liderado por TDR Capital, el mismo fondo que años después participaría en la compra de Asda. La llegada de nuevos propietarios aceleró la ambición de convertir esa federación en un negocio mucho más integrado, con una plataforma común. Es un patrón que se repite en varios de estos casos: un cambio de propiedad o de perímetro, una adquisición o una venta, suele ser el detonante de la transformación y también la fuente de su presión de calendario.
Core Leasing System: extender a todo el grupo la solución SAP que funcionaba en Australia
La propuesta consistía en tomar como referencia la solución SAP que funcionaba en Australia y extenderla internacionalmente como núcleo común de gestión del grupo, el Core Leasing System. HCL Technologies fue seleccionada como socio estratégico de integración. El diseño contemplaba SAP Leasing, S/4HANA y otras soluciones del ecosistema del fabricante, con infraestructura en la nube y portales para empleados, clientes y proveedores.
El razonamiento tenía una lógica atractiva: si algo ya funciona en una filial, extenderlo al resto parece más seguro que construirlo desde cero. Pero el antecedente australiano contenía una advertencia que no debía pasarse por alto. LeasePlan Australia había implantado SAP Leasing entre 2010 y 2013, y había necesitado varios años para estabilizar por completo su funcionamiento. Es decir, la referencia que iba a servir de modelo para todo el grupo había sido, en su propio país, una implantación larga y difícil. Que una solución termine funcionando en una filial demuestra que puede funcionar allí, no que sea la arquitectura adecuada para un grupo con decenas de países, productos y regulaciones distintas.
Un calendario que el propio responsable tecnológico llamó extremadamente agresivo
El programa internacional comenzó a finales de 2016, y en mayo de 2017 la empresa presentó un plan muy ambicioso: pilotos, implantación en unos quince países y grandes despliegues dos veces al año. Ese mismo mes, Alfonzo Venturi, responsable tecnológico de LeasePlan Australia, describió públicamente el calendario como extremadamente agresivo. Explicó que el plan incluía despliegues de una sola vez, en formato de gran arranque, en buena parte de los países, con excepciones para los negocios demasiado complejos, e identificó la gestión del cambio como un desafío central, porque empleados, clientes y colaboradores tendrían que adoptar nuevas maneras de trabajar.
Esas declaraciones no prueban que las prisas fueran la causa directa de la cancelación, y sería un error presentarlas así. Pero muestran algo importante para cualquier comité: la dificultad organizativa y la agresividad del calendario estaban identificadas por las propias personas del programa desde el principio, y se dijeron en público. Cuando quien conoce mejor la implantación de referencia califica el calendario de extremadamente agresivo en el mismo mes en que se presenta, esa frase debería convertirse en un riesgo formal con un responsable y un plan, no en una anécdota de una entrevista. Antes de la cancelación hubo, además, una auditoría que advirtió de debilidades en los controles de acceso y en la gestión de cambios, otro aviso de que la organización no tenía todavía la disciplina que un núcleo común iba a exigirle.
2019: por qué LeasePlan concluyó que el núcleo común no servía al negocio digital
Entre 2017 y 2018 el programa siguió desarrollándose y preparándose. Pero mientras tanto, la estrategia del negocio estaba cambiando. LeasePlan había empezado a presentarse como una empresa de coche como servicio, y su apuesta de movilidad evolucionaba hacia servicios digitales que exigían cambios rápidos, integraciones flexibles con aplicaciones y terceros, y la capacidad de lanzar productos distintos según el mercado. En el primer semestre de 2019, una revisión estratégica concluyó que el nuevo núcleo no resultaba adecuado para el entorno digital al que se dirigía el negocio. La documentación financiera de la compañía lo dice con claridad: el sistema no sería apto para el entorno digital emergente y no generaría los beneficios económicos previstos. En el segundo trimestre de 2019, la dirección encabezada por Tex Gunning abandonó el desarrollo del Core Leasing System.
Conviene ser preciso sobre lo que esto significa y lo que no. No hay evidencia pública suficiente para concluir que la cancelación se debiera a una mala programación, a errores de migración o a una incapacidad general de SAP Leasing. El fracaso fue principalmente arquitectónico y estratégico: la solución perseguida dejó de considerarse adecuada para el modelo de negocio que LeasePlan quería desarrollar. Un gran núcleo común, pensado para concentrar todas las capacidades en un mismo sistema, encajaba mal con una estrategia que necesitaba cambiar deprisa piezas concretas sin tocar el resto.
Tampoco hay evidencias públicas de una crisis en el servicio a los clientes. No aparecen problemas generalizados de entrega de vehículos, contratos perdidos ni interrupciones de mantenimiento atribuibles a este programa, y sería incorrecto describir una paralización internacional de LeasePlan, como hacen algunas recopilaciones. La consecuencia verificable fue financiera y estratégica: se canceló un programa central, hubo que replantear la arquitectura y se retrasó la transformación prevista.
Los 98 millones de LeasePlan: qué se dio por perdido y qué se conservó
Las cuentas del primer semestre de 2019 permiten desglosar el impacto con precisión. LeasePlan reconoció un deterioro de 92 millones de euros en los activos intangibles del Core Leasing System, es decir, la parte de lo invertido que se daba por perdida, y una provisión de 6 millones por contratos onerosos, incluido el mantenimiento, que correspondía a costes inevitables pendientes de pagar por algo que ya no iba a aportar valor. En total, 98 millones de impacto identificado.
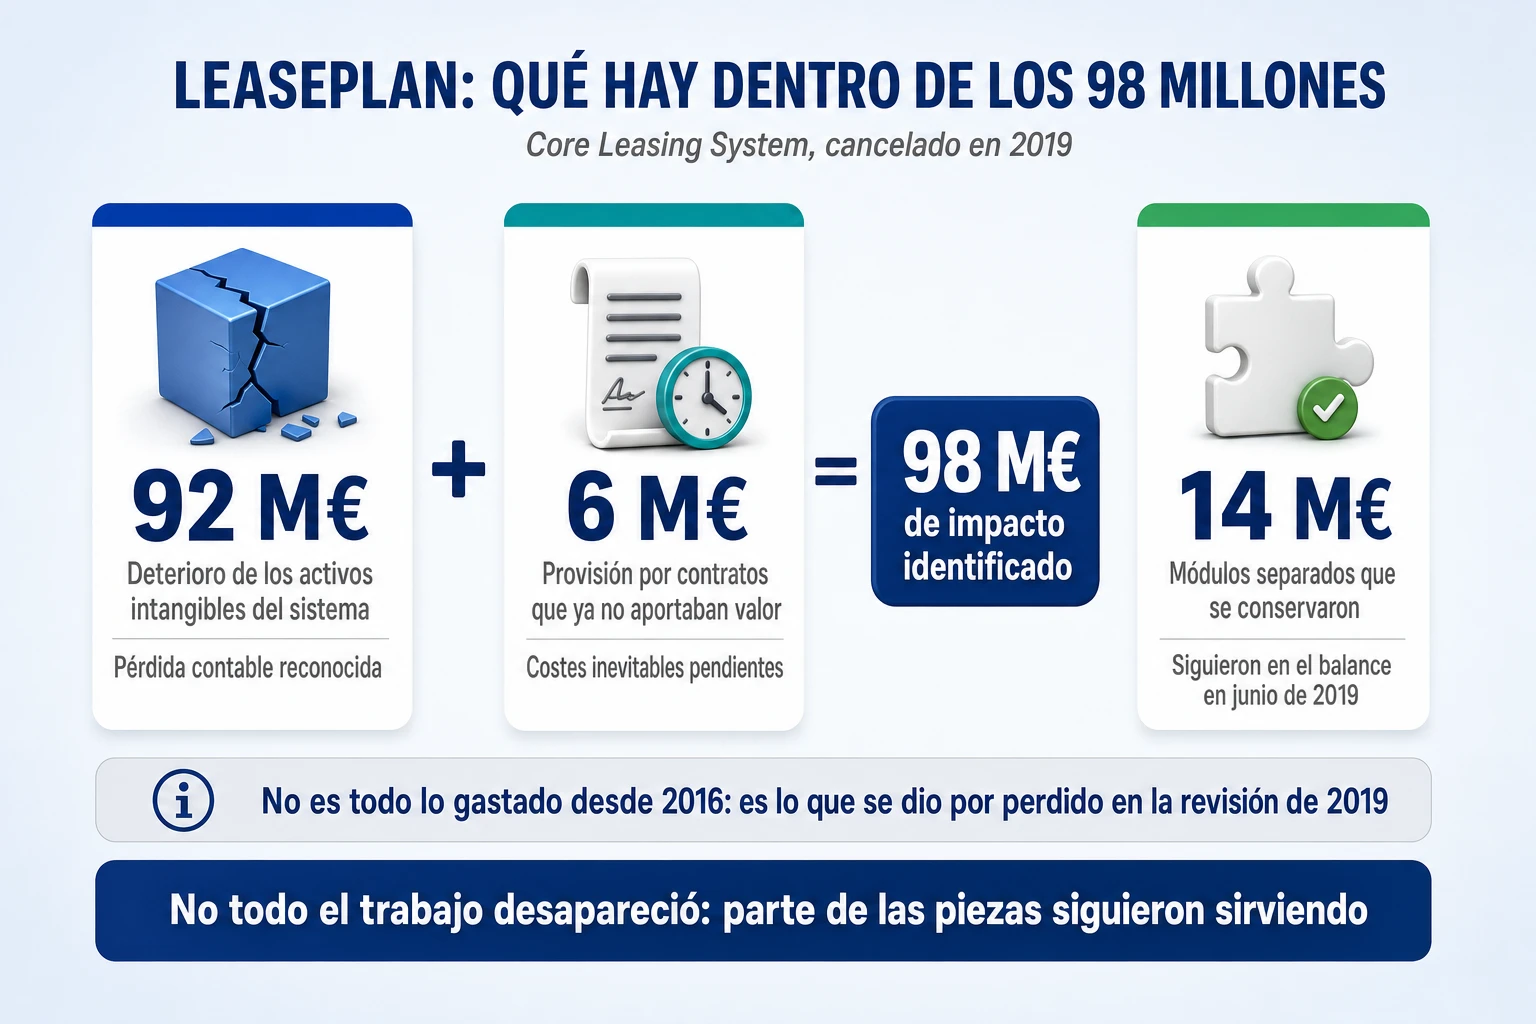
Hay un tercer dato en esas cuentas que casi nunca se menciona y que es muy instructivo: 14 millones correspondientes a módulos separados del programa seguían registrados como activo a junio de 2019, porque la compañía consideraba que podían seguir aportando valor. No todo el trabajo desapareció, y eso indica que el problema no era cada pieza, sino la idea de reunirlas todas en un único núcleo. Además, los 98 millones no representan necesariamente todo el dinero gastado desde el inicio del programa: son el deterioro y la provisión identificados en la revisión de 2019. Cualquier comparación con el presupuesto inicial, que no se publicó, carece de base.
La reacción de la compañía fue orientarse hacia una arquitectura digital más modular, abandonando el objetivo de concentrar todas las capacidades en un mismo núcleo. La lógica era separar componentes, permitir integraciones entre ellos y facilitar desarrollos más independientes, de modo que cada parte del negocio pudiera evolucionar a su ritmo. La corrección, por tanto, no consistió en renunciar a la inversión digital, sino en cambiar su estructura.
Qué debería haber hecho LeasePlan: revisar la viabilidad del programa y no solo su avance
La decisión que debió tomarse antes de comprometer el programa era demostrar que el núcleo propuesto podía incorporar con rapidez, y sin una complejidad creciente, las variaciones del negocio en los distintos países. No bastaba con acreditar que SAP funcionaba en Australia. Había que justificar que era la plataforma correcta para una organización internacional con múltiples productos, contratos y regulaciones, y que seguiría siéndolo si la estrategia cambiaba, como estaba empezando a cambiar. Una prueba razonable habría consistido en tomar dos o tres países muy distintos entre sí y medir cuánto costaba, en tiempo y en desarrollo, incorporar sus particularidades al núcleo común.
Pero la lección más importante de LeasePlan está en lo que ocurre durante el programa, no antes. En cada revisión de un programa largo se suele hacer una pregunta: cuánto falta para terminar. Es una pregunta legítima, pero insuficiente, porque da por supuesto que lo que se está construyendo sigue siendo lo que el negocio necesita. La pregunta que hay que hacer en cada revisión es otra: si hoy empezáramos desde cero, con lo que sabemos ahora sobre nuestra estrategia, ¿aprobaríamos este programa tal como está? Si la respuesta es no, lo ya invertido no es una razón para seguir invirtiendo, por mucho que pese en la discusión. Es una idea sencilla que las organizaciones suelen convertir en una negociación de varios años.
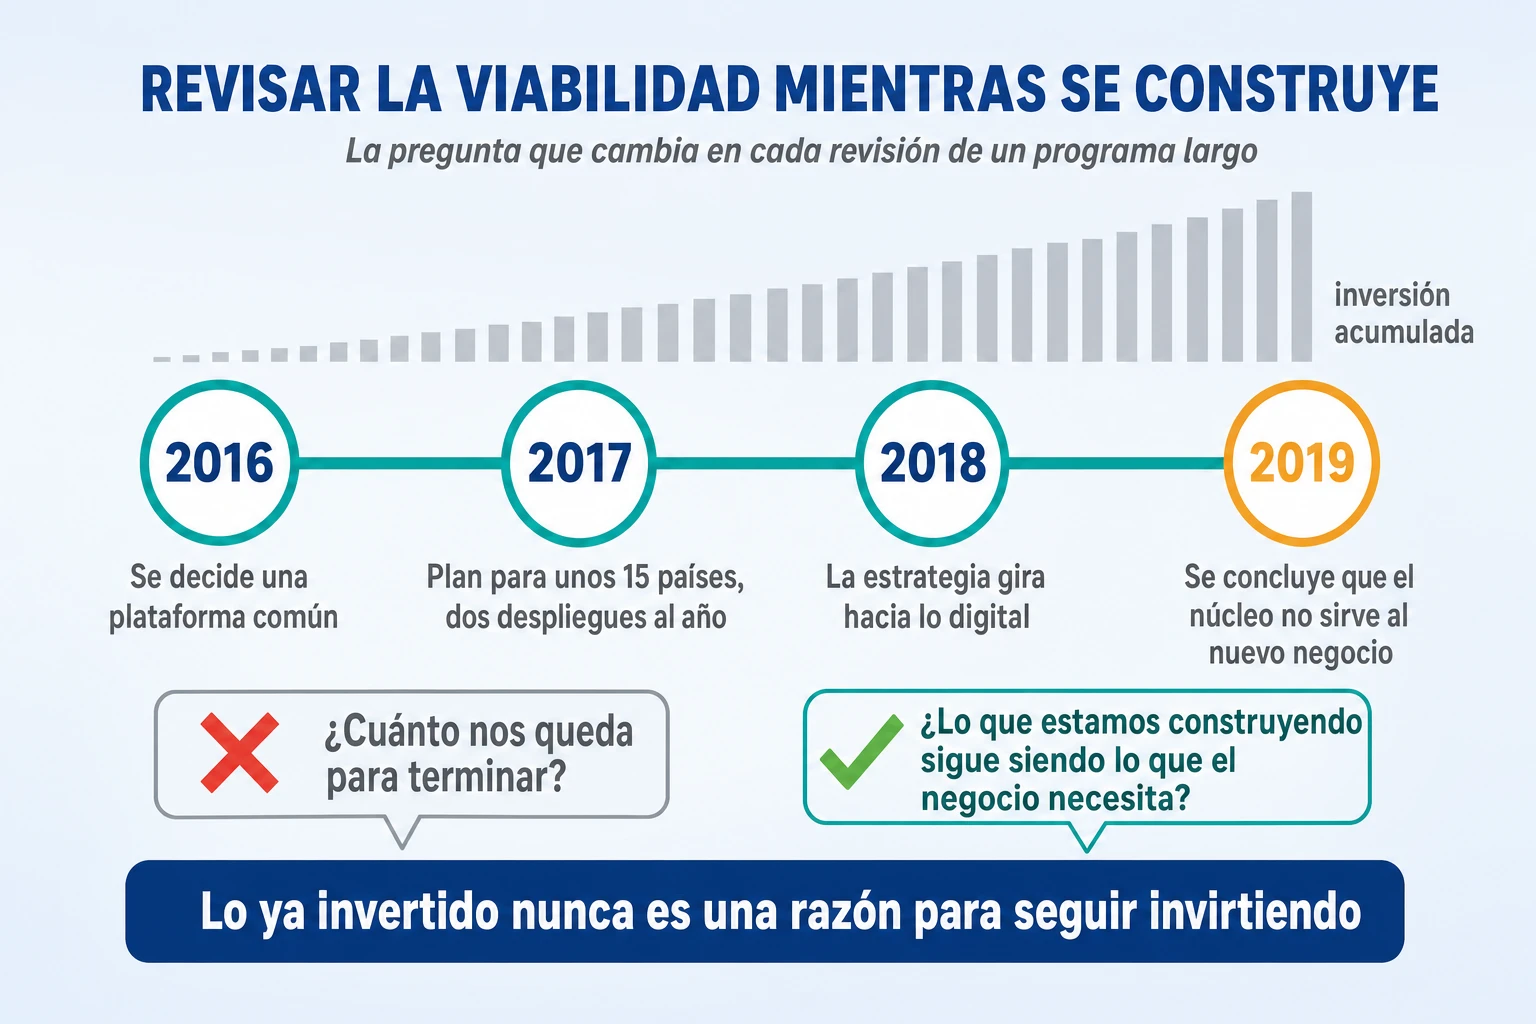
Visto así, LeasePlan merece un juicio más matizado que los demás casos. La empresa canceló el programa cuando concluyó que no servía, y esa decisión, aunque tardía, fue correcta y valiente: reconocer 98 millones de pérdidas en las cuentas es mucho más difícil que seguir gastando. Lo que cabe discutir es cuánto tiempo y cuánto dinero hizo falta para llegar a esa conclusión, y si la información que la provocó, el giro de la estrategia hacia lo digital, no estaba disponible antes. Reconocer el fracaso a tiempo es una competencia directiva, y como cualquier competencia se puede organizar: con revisiones de viabilidad periódicas, separadas de las revisiones de avance y con capacidad real para rediseñar o detener el programa. La lección de LeasePlan, en una frase, es que una solución puede haber tenido éxito en una filial y ser una mala arquitectura para el conjunto del grupo, y que esa diferencia hay que buscarla antes de construir, no descubrirla después.
Caso Kingfisher: cuando la estandarización de ONE Kingfisher chocó con el negocio de Castorama en Francia
De los siete casos, el de Kingfisher es el que menos se parece a un fracaso informático y el que más enseña sobre estrategia. La plataforma SAP no se abandonó: acabó implantándose y funcionando. Lo que falló fue el conjunto de decisiones de negocio que esa plataforma tenía que hacer posibles, y la forma en que se ejecutaron a la vez. Es, probablemente, el ejemplo más claro de confundir la estandarización que genera eficiencias con la uniformidad que destruye capacidades competitivas, y por eso merece leerse con atención en cualquier grupo con varias marcas, países o formatos.
Kingfisher antes de la transformación: un grupo de enseñas nacionales de bricolaje con clientes distintos
Kingfisher es el grupo británico propietario de varias enseñas de bricolaje y mejora del hogar, entre ellas B&Q y Screwfix en el Reino Unido, y Castorama y Brico Dépôt en Francia. En los años de este caso contaba también con negocios en Polonia, en España y Portugal a través de Brico Dépôt, y en otros mercados. Durante mucho tiempo funcionó como un conjunto de negocios nacionales con bastante autonomía, cada uno con su surtido, sus proveedores, su forma de comprar y sus sistemas.
Esas enseñas no eran intercambiables, y ese es el punto de partida del caso. Castorama tenía un posicionamiento más orientado a los proyectos de mejora del hogar y a los surtidos amplios, con un cliente que va a la tienda a planificar una reforma. Brico Dépôt operaba con una propuesta de descuento más marcada, con una actividad promocional característica y un cliente muy sensible al precio, incluidos muchos profesionales. Y el cliente francés y el británico no compraban lo mismo, ni de la misma manera, ni bajo las mismas normas técnicas. La diferencia entre las enseñas no era una ineficiencia acumulada, era una parte de la razón por la que cada una tenía sus clientes.
ONE Kingfisher: unificar surtido, compras, procesos y tecnología para ganar escala
En enero de 2016 Kingfisher anunció su programa estratégico ONE Kingfisher, impulsado por su consejera delegada, Véronique Laury. La intención era aprovechar mejor el tamaño del grupo mediante una unificación mucho mayor de productos, compras, aprovisionamiento, herramientas tecnológicas y organización, con un objetivo ambicioso de mejora del beneficio a cinco años. El proyecto no consistía solo en implantar SAP: buscaba una transformación comercial y operativa de gran alcance, en la que la plataforma tecnológica común era el instrumento para que todo el grupo comprara, gestionara y repusiera de la misma manera.
La propuesta estratégica era atractiva y tenía fundamento. Si distintas marcas nacionales compran y venden más referencias comunes, pueden negociar mejor con los proveedores, simplificar la cadena de suministro, reducir la duplicación de equipos y mejorar los márgenes. Es la lógica de escala que cualquier grupo con varias filiales reconoce. Pero había un problema evidente que la dirección no resolvió de forma suficiente: el nuevo modelo centralizado corría el riesgo de debilitar justo lo que diferenciaba a Castorama de Brico Dépôt, y a las dos del mercado británico. Reducir las diferencias entre enseñas podía aumentar el poder de negociación del grupo, pero también disminuir la adecuación de los productos a cada mercado.

Entre 2017 y 2018 se intensificaron las modificaciones de surtidos, de procesos de aprovisionamiento y de sistemas tecnológicos. Y aquí está la clave operativa del caso: muchos cambios importantes se hacían a la vez, en las mismas tiendas y sobre los mismos equipos. Cambiaba qué se vendía, quién decidía qué se vendía, cómo se compraba, cómo se reponía y con qué sistema se hacía todo eso. Cuando tantas cosas cambian al mismo tiempo, cualquier problema se vuelve difícil de diagnosticar, porque nadie sabe con certeza cuál de los cambios lo ha provocado.
Castorama Francia: cómo la transformación se tradujo en problemas de existencias, surtido y disponibilidad
En el ejercicio 2018/19 el deterioro se hizo visible en Castorama Francia. La compañía reconoció problemas logísticos, ineficiencias en la gestión de existencias y disrupciones relacionadas con la transformación. Para entender el caso conviene distinguir tres niveles de fallo que se superpusieron. El primero fue comercial: la estrategia de unificación alteró surtidos y dinámicas de compra, y el cliente francés dejó de encontrar algunos de los productos y marcas que buscaba. El segundo fue logístico: los nuevos procesos de abastecimiento y de gestión de mercancías contribuyeron a dificultades de disponibilidad y a una peor eficiencia del inventario. El tercero fue tecnológico: la plataforma SAP y sus procesos asociados necesitaban ajustes para funcionar correctamente en determinadas actividades de Castorama Francia.
Sobre el tercer nivel hay un dato preciso: la propia Kingfisher acabaría admitiendo que necesitaba corregir 18 problemas prioritarios del modelo SAP utilizado en Castorama. Es una cifra útil porque da una idea del tamaño del problema técnico, que existía y no era menor. Pero no puede afirmarse con rigor que esos 18 problemas expliquen todas las pérdidas comerciales, ni que existiera un único defecto técnico responsable de la crisis. La transformación combinó tecnología, estrategia de producto, organización y logística, y precisamente por eso es uno de los casos más interesantes para un público directivo: el sistema fue, a la vez, una causa de los problemas y el lugar donde se hicieron visibles los errores de las otras tres capas.
En 2019 Véronique Laury dejó la dirección del grupo y Thierry Garnier asumió el cargo de consejero delegado, con el encargo de reorientar la estrategia. Los problemas no desaparecieron de inmediato: persistieron durante el ejercicio 2019/20, mientras la nueva dirección diagnosticaba qué partes del programa había que mantener, cuáles corregir y cuáles detener.
Lo que dicen las cuentas de Kingfisher: cuánto pesó la transformación en las ventas de Castorama
Kingfisher es, entre los siete casos, el que mejor permite medir cuánto pesó la transformación, porque el propio grupo lo cuantificó en sus informes. En el ejercicio 2018/19, Castorama Francia registró ventas de 2.246 millones de libras, con una caída del 7,3 % en términos totales y del 7,1 % en términos comparables. El grupo atribuyó ese descenso a varios factores a la vez: menor afluencia de clientes, el reposicionamiento de precios, los problemas de la transformación y las protestas nacionales que vivió Francia en el último trimestre de ese ejercicio, que redujeron las visitas a las tiendas en muchas ciudades.
En 2019/20 las ventas de Castorama bajaron a 2.145 millones de libras, con un descenso comparable del 3,3 %. Y aquí el informe anual hizo algo poco habitual: estimó que las actividades de transformación explicaban aproximadamente dos puntos porcentuales negativos de ese descenso, y que otro punto aproximadamente procedía de los cambios en el posicionamiento de precios. Es una atribución mucho más útil que limitarse a señalar la caída global, porque separa lo que se debe al programa de lo que se debe a otras decisiones, y porque la hizo la propia empresa en un documento que responde ante sus accionistas.

El caso de Brico Dépôt enseña que no conviene meter a todas las enseñas en el mismo saco. En 2018/19 la enseña de descuento obtuvo en Francia resultados comerciales relativamente mejores que Castorama. En 2019/20 sus ventas comparables bajaron un 3,1 %, pero el grupo vinculó unos tres puntos de ese descenso a la reducción deliberada de promociones, no a problemas de sistemas. No hay, por tanto, fundamento para afirmar que las dos cadenas sufrieran el mismo colapso por culpa de SAP. El riesgo más importante para Brico Dépôt era estratégico: perder los rasgos distintivos de su modelo comercial por una centralización excesiva. Y su migración a la plataforma SAP global se aplazó, incluida la de sus operaciones en España y Portugal, lo que es en sí mismo una forma de reconocer que la secuencia del programa necesitaba revisarse.
El cambio de rumbo: devolver decisiones a las enseñas, corregir SAP y hacer menos cosas a la vez
La recuperación de Kingfisher es especialmente reveladora porque muestra qué consideró la nueva dirección que estaba mal, a través de lo que decidió cambiar. Thierry Garnier modificó el rumbo del grupo con una estrategia que después se denominaría Powered by Kingfisher, cuya idea central era conservar las ventajas de escala del grupo, pero devolver a cada enseña una mayor capacidad para decidir cómo competir. Entre las medidas concretas estuvieron interrumpir proyectos tecnológicos no críticos y reducir los cambios de surtido, concentrar los recursos en estabilizar SAP en Castorama Francia, corregir los 18 problemas prioritarios del sistema, incorporar más de 25 perfiles críticos al equipo logístico francés, reintroducir productos y marcas relevantes para los mercados locales y recuperar la identidad comercial y promocional de Brico Dépôt.
Cada una de esas medidas responde a uno de los niveles del fallo. Reducir los cambios simultáneos responde a la acumulación de transformaciones; estabilizar SAP y corregir sus problemas prioritarios responde al nivel tecnológico; reforzar el equipo logístico responde al nivel operativo; y devolver autonomía comercial a las enseñas responde al nivel estratégico, que era el de fondo. Es notable que la primera medida no fuera tecnológica, sino de alcance: hacer menos cosas a la vez.
En 2020/21 las ventas comparables crecieron un 6,2 % en Castorama Francia y un 3,8 % en Brico Dépôt Francia, y el grupo informó de una mayor estabilidad logística. Hay que leer esas cifras con la misma prudencia que las anteriores, porque coincidieron con el efecto extraordinario de la pandemia sobre el bricolaje, cuando millones de personas confinadas se dedicaron a reformar sus casas. No se pueden atribuir íntegramente al nuevo modelo de gestión. Lo que sí está claro es que la plataforma SAP no se abandonó: Kingfisher completó su despliegue en Castorama Francia y en otras operaciones, modificando el ritmo y corrigiendo sus problemas.
Qué debería haber decidido Kingfisher: qué es común en el grupo y qué conserva cada negocio
Centralizar las compras y la tecnología puede tener mucho sentido en un grupo como Kingfisher. Pretender que distintos países y cadenas operen como si sus clientes fueran iguales puede destruir parte de su propuesta de valor. La dirección tenía que haber separado con rigor dos preguntas que ONE Kingfisher trató como una sola. La primera es qué procesos comunes generan una ventaja económica real para el grupo: la negociación con grandes proveedores, la información financiera, los datos de producto, la tecnología de base, la logística compartida donde tiene sentido. La segunda es qué diferencias entre marcas y mercados forman parte de la ventaja competitiva y deben mantenerse aunque cuesten algo de eficiencia: el surtido que busca cada cliente, la forma de hacer promociones, el posicionamiento de precio, la relación con el profesional local.
Responder a esas dos preguntas exige que en la mesa se sienten quienes conocen a los clientes de cada enseña con la misma autoridad que quienes diseñan el modelo del grupo, y eso es una decisión de gobierno, no de diseño técnico. Cuando las decisiones comerciales se trasladan de las empresas locales a la estructura central sin ese contrapeso, el grupo gana coherencia y pierde la información que solo tienen quienes están cerca del cliente. La señal de alarma, en un programa así, no es que las filiales se quejen, porque siempre se quejan; es que las quejas empiecen a aparecer en los indicadores de ventas comparables y de disponibilidad. En Castorama aparecieron en 2018/19, y la corrección de fondo no llegó hasta el cambio de dirección.
La lección de Kingfisher, en una frase, es que estandarizar el soporte no exige uniformar toda la experiencia comercial, y que la eficiencia central puede convertirse en ineficiencia local si destruye la capacidad de adaptación. El ERP puede y debe ser común en muchos procesos de un grupo; lo que no puede ser es el instrumento con el que se imponen decisiones de negocio que nadie ha validado con los mercados que van a sufrirlas.
Caso Revlon: la puesta en producción de SAP en Oxford, 64 millones en pedidos sin servir y una debilidad de control interno
Revlon es el caso con mejor documentación de los siete, y también el que más se ha deformado al contarse. Su documentación es excepcional porque, al cotizar en Estados Unidos, la compañía tuvo que explicar el episodio con detalle ante el regulador bursátil, y porque una demanda de inversores aportó después una versión de lo ocurrido desde dentro. Y se ha deformado porque es tentador unir dos hechos que tienen cuatro años de distancia: Revlon tuvo una crisis con su ERP en 2018 y se declaró en quiebra en 2022, pero ningún documento público establece que lo primero causara lo segundo. Contar bien este caso exige separar con cuidado lo que la empresa reconoció, lo que alegaron sus accionistas y lo que se ha añadido después.
Revlon antes de la implantación: una multinacional de cosmética con una tecnología fragmentada por las adquisiciones
Revlon es una multinacional de cosmética y productos de belleza cuyas marcas se venden sobre todo a través de grandes distribuidores y cadenas de farmacia y perfumería. En su negocio, servir los pedidos de esos grandes clientes en plazo es una condición de supervivencia, porque un distribuidor que no recibe la mercancía no deja el hueco vacío: lo ocupa con la marca de la competencia. Y su estructura tecnológica arrastraba una fragmentación agravada por sucesivas adquisiciones, la más importante de ellas la de Elizabeth Arden, cerrada en 2016 por unos 870 millones de dólares.
Según las alegaciones recogidas en el procedimiento judicial posterior, en 2014 la compañía manejaba 21 sistemas ERP distribuidos entre 50 entidades empresariales. Ese año decidió avanzar hacia un ERP común de SAP, con el objetivo de concentrar los procesos en una solución integrada, con información compartida para producción, distribución, compras y finanzas, y de apoyar la integración de los negocios adquiridos y la obtención de eficiencias operativas. Era, como en los demás casos, una decisión con todo el sentido: una empresa con veintiún sistemas de gestión no puede ver su propio negocio con claridad ni operar como una sola compañía.
Las pruebas de Oxford en 2017: aplazamientos y advertencias según la demanda de inversores
Entre 2016 y 2017 continuaron los trabajos de integración empresarial y de preparación de la plataforma. El punto crítico iba a ser la planta de Oxford, en Carolina del Norte, una instalación industrial y de distribución fundamental para la compañía. Y aquí es donde la demanda presentada después por los inversores aporta la parte más interesante del caso, que hay que leer siempre como lo que es: alegaciones recogidas por un tribunal, no hechos probados.
Según los demandantes, durante las pruebas previas se detectaron dificultades relevantes en el entorno de Oxford, y el arranque se aplazó en varias ocasiones antes del lanzamiento definitivo. Sostuvieron también que la dirección decidió seguir adelante pese a problemas no resueltos, y que se estaba reutilizando una configuración de SAP procedente de una empresa adquirida sin haber demostrado suficientemente que fuera adecuada para una instalación industrial de la complejidad de Oxford. Identificaron, además, problemas de integración entre producción y almacenes y una formación insuficiente de los empleados. Si esas alegaciones son ciertas, el momento en el que el desastre se podía haber evitado está perfectamente localizado: las semanas en las que las pruebas seguían mostrando problemas y alguien decidió que eso no bastaba para volver a aplazar.
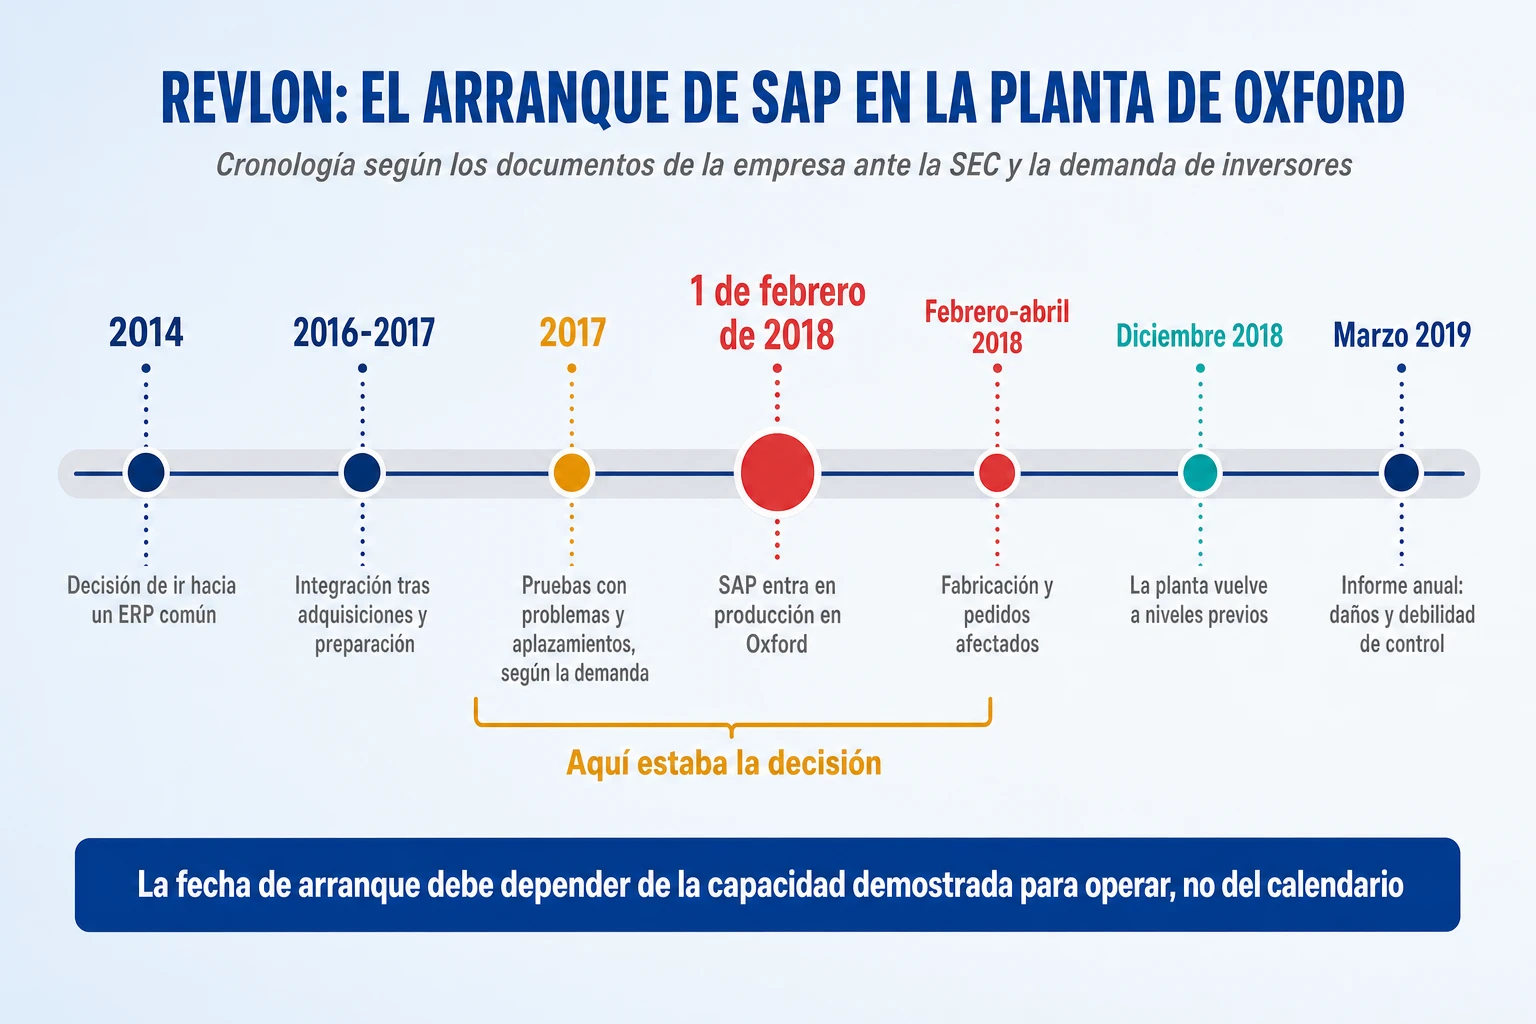
Febrero de 2018: el arranque en la planta de Oxford y los pedidos que no se pudieron servir
El 1 de febrero de 2018 SAP entró en producción en Oxford. La existencia de la crisis que vino después no es una alegación: la confirmó la propia Revlon en sus comunicaciones oficiales. El despliegue provocó dificultades que redujeron la capacidad de la planta para fabricar determinados volúmenes de productos terminados y para atender los pedidos de los grandes distribuidores. Entre febrero y abril de 2018 aparecieron disrupciones graves de fabricación y distribución, y la empresa tuvo que movilizar recursos extraordinarios para estabilizar las operaciones, incluidos envíos urgentes y otros refuerzos.
El impacto no quedó encerrado en la fábrica, y entender cómo se propagó es la parte más útil del caso. Cuando un fabricante de cosméticos no puede atender los pedidos de sus distribuidores, se pone en marcha una cadena: faltan productos en los canales comerciales, baja el inventario disponible en los clientes, se acumulan pedidos pendientes, y hay que hacer esfuerzos extraordinarios, y caros, para recuperar el servicio antes de que los distribuidores reasignen el espacio a otras marcas. Un ERP que falla en una planta crítica no produce un problema informático: produce un problema comercial que llega hasta el lineal del cliente final.
En abril de 2018 Revlon comunicó avances significativos en la recuperación de la capacidad industrial, aunque los efectos de la interrupción siguieron afectando a los pedidos y al abastecimiento durante los meses siguientes. A finales de diciembre de 2018 informó de que la instalación de Oxford operaba de nuevo a niveles anteriores a la implantación, si bien todavía estaba reconstruyendo existencias en determinados canales internacionales. En total, casi un año entre el arranque y la vuelta a la normalidad operativa.
64 millones de ventas no atendidas y 53,6 millones de costes extraordinarios: dos cifras que no se suman
En su informe anual de 2018, presentado ante el regulador bursátil estadounidense en marzo de 2019, Revlon cuantificó los daños. Estimó en alrededor de 64 millones de dólares las ventas netas correspondientes a pedidos que no había podido atender durante el ejercicio. Y registró además 53,6 millones de dólares de gastos incrementales, relacionados principalmente con las actuaciones necesarias para recuperar los niveles de servicio. Son las cifras más sólidas de los siete casos, porque proceden de un documento regulatorio y no de una estimación de prensa.

Precisamente por ser sólidas conviene leerlas bien. No sería correcto sumar ambas cantidades y presentar 117,6 millones como pérdida de beneficio. Una es una estimación de ventas no realizadas y la otra es un coste efectivamente reconocido. Las ventas no realizadas no son beneficio perdido, porque esos productos tampoco tuvieron que fabricarse ni enviarse; para calcular cuánto beneficio se perdió habría que aplicarles el margen. Los costes extraordinarios, en cambio, sí son dinero que salió de la empresa. Y tampoco es correcto atribuir al ERP la pérdida neta de 294,2 millones que Revlon registró ese año, una cifra que algunas recopilaciones presentan como consecuencia del episodio y que respondía a muchos más factores, entre ellos el elevado endeudamiento que la compañía arrastraba desde hacía años.
La debilidad material de control interno: lo que Revlon reconoció ante el regulador
Más importante que las cifras es lo que la compañía reconoció sobre sus controles internos, porque eso describe la causa de fondo mejor que cualquier alegación. Revlon admitió una debilidad material en su control interno sobre la información financiera relacionada con el despliegue, y la descompuso en tres deficiencias. La primera fue una evaluación de riesgos insuficiente: la empresa no había desarrollado un proceso eficaz y continuado para identificar y valorar los riesgos que la nueva implantación introducía en el control financiero. La segunda, carencias en el número y la capacitación de las personas responsables de determinadas actividades y controles. La tercera, controles operativos y contables deficientes en el registro y la contabilización de inventarios, cuentas a cobrar, ventas, coste de ventas, conciliaciones contables y determinados asientos manuales.
Leídas en orden, esas tres deficiencias son casi un resumen de lo que debe preparar cualquier organización antes de cambiar un sistema crítico: entender qué riesgos introduce el cambio, tener suficientes personas preparadas para operarlo y controlarlo, y asegurarse de que los controles que funcionaban en el sistema anterior siguen funcionando en el nuevo. No son fallos del software; son fallos de preparación de la organización que el software hizo visibles. Algunas versiones del caso añaden que Revlon despidió a personal experto de la planta justo antes del arranque; lo que está documentado es la carencia de personas suficientes y preparadas, no un despido concreto, y conviene no ir más allá de eso.
La empresa aclaró que esas deficiencias no habían producido una incorrección material en sus estados financieros consolidados de 2018. Eso no disminuye la gravedad del problema: simplemente significa que las cuentas publicadas no tuvieron que considerarse erróneas por ese motivo. Y en 2019 Revlon anunció medidas específicas para reforzar la evaluación de riesgos, la supervisión de las implantaciones informáticas, la formación, los controles financieros y la documentación de los procesos, es decir, exactamente lo que había faltado antes del arranque.
La demanda de inversores y la quiebra de 2022: lo que el caso demuestra y lo que no
Los problemas desembocaron en una demanda colectiva de inversores que cuestionaba las comunicaciones de la compañía y de sus directivos, a quienes acusaban de no haber informado adecuadamente de los problemas de la implantación. En septiembre de 2020 el tribunal desestimó las pretensiones principales, por considerar insuficientemente fundamentadas las alegaciones necesarias para establecer responsabilidad por fraude bursátil. Esa sentencia no demuestra que el ERP se implantara bien: el tribunal reconoció los graves problemas operativos, pero eso no bastaba para acreditar los elementos jurídicos que exige una reclamación por fraude. Lo que sí impide es afirmar, como hacen algunas versiones, que la dirección ocultó deliberadamente el fallo a los inversores.
En cuanto a la quiebra de 2022, Revlon se acogió a la protección del capítulo 11 de la ley concursal estadounidense en junio de ese año, después de una pandemia que hundió las ventas de maquillaje, de tensiones en las cadenas de suministro y de años de un endeudamiento muy elevado. El episodio del ERP debilitó a la empresa en 2018, pero presentarlo como la causa de una quiebra que se produjo cuatro años después, con todos esos factores en medio, es contar una historia más simple y más dramática que la real. Para un comité de dirección, el caso ya es suficientemente grave sin esa exageración: un cambio de sistema que deja sin servir 64 millones de dólares en pedidos, cuesta 53,6 millones en recuperar el servicio, tarda casi un año en normalizarse y obliga a reconocer ante el regulador que la empresa no controlaba adecuadamente su información financiera.
Qué debería haber hecho Revlon: demostrar que la operación completa estaba preparada antes de arrancar
La decisión crítica fue poner en marcha una plataforma que debía controlar la fabricación, el inventario y la distribución de una planta fundamental sin disponer de garantías suficientes de que la operación iba a seguir funcionando y de que los controles iban a seguir controlando. Y lo que había que demostrar antes de arrancar era mucho más que la capacidad del sistema para procesar transacciones. Hacían falta pruebas rigurosas de la integración entre fábrica y almacén, preparación real de los usuarios, conciliaciones contables cerradas en el sistema nuevo, procedimientos para gestionar las excepciones y un plan para recuperar la operación si algo fallaba.
A eso se añaden dos decisiones de gobierno que se desprenden del caso como recomendaciones razonadas. La primera es quién decide el arranque. Si las pruebas mostraban problemas y el lanzamiento ya se había aplazado varias veces, la decisión final no podía depender de quien llevaba meses empujando para cumplir la fecha; necesitaba a los responsables de la operación de la planta, de la cadena de suministro y de finanzas con capacidad real de decir que no. La segunda es dónde se arranca. Elegir como primer gran despliegue la instalación más crítica de la empresa concentra todo el riesgo en el peor sitio posible; un despliegue en una instalación menos crítica, o con la posibilidad de volver al sistema anterior durante un periodo, habría permitido descubrir los problemas con un coste mucho menor.
La lección de Revlon es la más directa de las siete y probablemente la más aplicable. El día de la puesta en producción no debe venir determinado por el calendario del proyecto, sino por la capacidad demostrada de operar el negocio sin perder el control. Y demostrar esa capacidad es responsabilidad de la empresa, no del integrador: el integrador puede certificar que el sistema funciona, pero solo quien dirige la operación puede certificar que la operación está preparada para funcionar con él.
Comparativa de los siete fracasos de ERP: transformación perseguida, problema principal, consecuencia y lección de dirección
Contados uno a uno, los siete casos parecen siete historias distintas, y en buena medida lo son. Puestos uno al lado del otro, aparece algo más útil: un mismo recorrido que se repite con variaciones. Casi todos los fallos operativos que se ven al final se incubaron en decisiones de dirección tomadas mucho antes, y casi siempre en el mismo orden. Primero una decisión estratégica que no se toma del todo, como qué se transforma y qué se conserva. Después un gobierno que no tiene a nadie del negocio con autoridad para resolver los conflictos que esa indefinición produce. Luego un diseño y una preparación que se quedan incompletos porque nadie sabe exactamente qué tenían que demostrar. Y finalmente una decisión de arranque, o de continuar, que se toma por calendario y no por evidencia. El fallo operativo y las pérdidas son solo la última pieza de esa cadena, la única que todo el mundo ve.
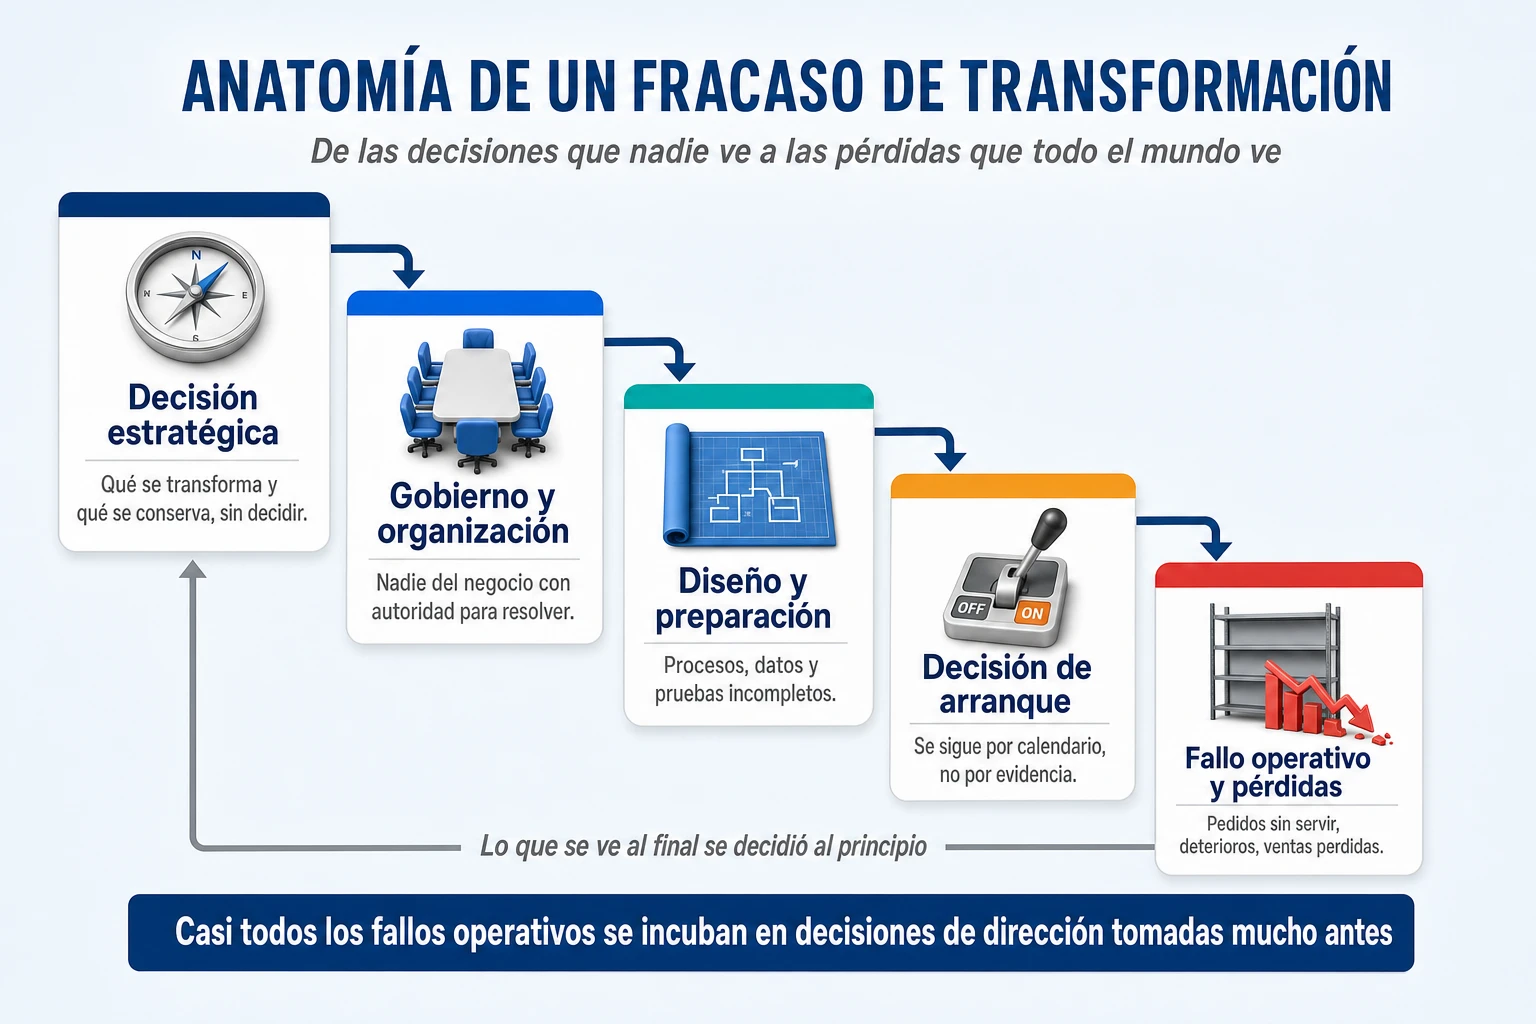
La tabla siguiente resume los siete casos con la información que más importa a quien dirige una transformación: qué se quería conseguir, qué falló principalmente, qué consecuencia está demostrada y qué lección de dirección deja cada uno. Las consecuencias se expresan en las monedas y en los conceptos en que las publicaron las empresas o la prensa, sin convertirlas ni sumarlas, porque como se explicó al principio miden cosas distintas.
| Empresa | Transformación perseguida | Principal problema | Consecuencia demostrada | Lección de dirección |
| Lidl (2011-2018) | Sustituir el sistema propio de gestión de mercancías por SAP para unificar el grupo | Conflicto no resuelto entre el modelo de valoración y abastecimiento de Lidl y la solución diseñada; personalización costosa | Cancelación en 2018 y vuelta al sistema propio; más de 500 M€ según la prensa alemana | Decidir qué se adapta, el negocio o el software, antes de invertir |
| Haribo (2015-2019) | Armonizar datos, procesos y organización en S/4HANA | Datos maestros erróneos o incompletos y un alcance inicial excesivo | Faltas de suministro del 10 % o más hasta febrero de 2019; la plataforma se mantuvo | Certificar los datos haciéndolos recorrer el proceso completo |
| DHL (2014-2015) | Una plataforma global común para el transporte internacional de mercancías | Implantación y modelo común no viables en los países piloto | 345 M€ de deterioro y provisión; retirada de los pilotos | Usar el piloto para decidir, no para confirmar |
| Asda (2021-2026) | Separarse de Walmart sustituyendo más de 2.500 sistemas | Integraciones, pruebas y capacidad insuficientes en una transición con muchos cambios simultáneos | 1.224 M£ acumulados; faltas de producto y ventas comparables del −2,8 % en el tercer trimestre de 2025 | Validar los recorridos completos y limitar los cambios simultáneos |
| LeasePlan (2016-2019) | Un núcleo de gestión común para unos 35 sistemas nacionales | Arquitectura inadecuada para la estrategia digital que el negocio estaba adoptando | 98 M€ de deterioro y provisión; cancelación del núcleo | Revisar la viabilidad del programa, no solo su avance |
| Kingfisher (2016-2021) | Unificar surtido, compras, procesos y sistemas del grupo | Una centralización que debilitó la propuesta local, con problemas logísticos y de SAP | Castorama, −7,1 % de ventas comparables en 2018/19 y unos 2 puntos atribuidos a la transformación en 2019/20 | Separar lo que debe ser común de lo que diferencia a cada negocio |
| Revlon (2014-2019) | Un ERP común tras años de adquisiciones | Arranque en una planta crítica sin preparación operativa ni controles suficientes | 64 M$ en ventas no atendidas, 53,6 M$ de costes y una debilidad material de control | Arrancar por capacidad demostrada, no por calendario |
La segunda tabla cruza los siete casos con los diez factores de fracaso que se analizan en el apartado siguiente. Está construida con una regla deliberadamente estricta: solo se marca un factor cuando hay evidencia suficiente en el caso, y se distingue entre dos niveles. El círculo lleno indica que el factor está acreditado: lo reconoció la propia empresa, figura en documentación oficial o lo reconstruyó de forma coincidente la prensa que siguió el caso sin que la compañía lo desmintiera. El círculo vacío indica que hay indicios, alegaciones judiciales o una deducción razonada a partir de los hechos acreditados. Una casilla en blanco no significa que el factor no estuviera presente, sino que no hay base pública para afirmarlo.
| Factor de fracaso | Lidl | Haribo | DHL | Asda | LeasePlan | Kingfisher | Revlon |
| 1. Estrategia y propósito | ○ | ● | ● | ||||
| 2. Modelo operativo objetivo | ● | ○ | ○ | ● | |||
| 3. Estandarización frente a diferenciación | ● | ○ | ○ | ● | |||
| 4. Liderazgo y propiedad del cambio | ○ | ○ | ○ | ||||
| 5. Gobernanza y decisiones difíciles | ○ | ○ | ○ | ○ | ○ | ||
| 6. Ambición y complejidad | ● | ○ | ● | ○ | ● | ||
| 7. Método de ejecución y secuencia | ○ | ○ | ○ | ● | ○ | ||
| 8. Preparación de la operación | ● | ○ | ● | ● | ● | ||
| 9. Gestión del cambio y adopción | ○ | ○ | ● | ||||
| 10. Gestión del riesgo y del valor | ○ | ○ | ○ | ● | ● |
Leída por columnas, la matriz muestra que ningún caso se explica por un solo factor, y que los casos con más marcas no son necesariamente los más graves, sino los mejor documentados. Kingfisher acumula muchas porque la propia empresa explicó con detalle lo que corrigió; DHL acumula círculos vacíos porque sabemos cuánto perdió pero no exactamente por qué. Leída por filas, muestra algo más interesante: los factores se agrupan según el tipo de fracaso. Los tres primeros, los de estrategia, modelo operativo y estandarización, se concentran en los proyectos abandonados y en Kingfisher. Los de preparación de la operación y ambición se concentran en las crisis al arrancar. Y el de gestión del riesgo y del valor atraviesa los dos grupos, porque es el que decide cuándo se detecta que algo va mal y qué se hace entonces.
Las diferencias entre los siete casos: no todos fracasaron por las mismas razones ni con el mismo resultado
Tan importante como lo que se repite es lo que no se repite, porque las recetas genéricas nacen precisamente de ignorar las diferencias. La primera diferencia es si la tecnología era el problema. En Lidl y en LeasePlan el software no falló en el sentido habitual: hacía lo que se le pedía, pero lo que se le pedía no encajaba con el negocio o dejó de encajar con la estrategia. En Haribo, Asda y Revlon el sistema estaba bien elegido y lo que falló fue la preparación para ponerlo en marcha. En Kingfisher hubo problemas técnicos reales, los 18 que la empresa tuvo que corregir, pero eran el síntoma de una decisión de negocio, no su causa. Solo en DHL la tecnología, entendida como la plataforma a medida que había que construir, aparece como parte central del problema, y aun así la propia empresa lo situó en la configuración y la implantación más que en el software de base.
La segunda diferencia es el desenlace. Tres empresas abandonaron la solución, Lidl, DHL y LeasePlan, y en los tres casos el abandono fue la decisión correcta en el momento en que se tomó; lo discutible es cuánto se tardó en tomarla. Las otras cuatro, Haribo, Asda, Kingfisher y Revlon, mantuvieron la plataforma y la estabilizaron, con costes altos pero sin renunciar a ella. Hay una observación que merece hacerse con prudencia, porque son pocos casos para generalizar: las tres empresas que explicaron públicamente con franqueza lo que habían hecho mal, Haribo, Asda y Kingfisher, son también las que se recuperaron sin abandonar su plataforma. No demuestra que una cosa cause la otra, pero sí sugiere que un diagnóstico honesto y rápido es parte de la recuperación, no un ejercicio de relaciones públicas.
La tercera diferencia es el detonante, y aquí aparece un patrón que pocas veces se menciona. En al menos tres de los siete casos, la transformación nació de un cambio de propiedad o de perímetro: Asda tuvo que separarse de Walmart tras su venta, LeasePlan aceleró su ambición de integración con la llegada de nuevos propietarios, y Revlon necesitaba unificar una estructura fragmentada por sucesivas adquisiciones. Esos detonantes traen consigo calendarios marcados desde fuera del programa, por un acuerdo de servicios transitorios, por un plan de inversión o por la promesa de sinergias, y un calendario que viene de fuera del programa es un calendario que el programa no puede defender cuando la evidencia lo contradice. No es casualidad que en los tres aparezcan problemas de ritmo.
La cuarta diferencia es el tipo de daño. En los proyectos abandonados, el daño fue sobre todo económico y de oportunidad, y apenas lo vieron los clientes. En las crisis al arrancar, el daño fue operativo y comercial, y lo vieron enseguida: estanterías sin ositos de goma, supermercados sin producto, distribuidores sin cosméticos. En Kingfisher, el daño fue más lento y más difícil de ver, una erosión de las ventas de una enseña durante varios ejercicios. Esa diferencia importa porque determina qué indicadores habrían avisado antes. Un proyecto que puede acabar abandonado se vigila con indicadores de viabilidad y de valor; uno que puede acabar en crisis operativa se vigila con indicadores de preparación de la operación; y uno que puede erosionar el negocio se vigila con los indicadores comerciales de cada mercado afectado. Casi ningún programa vigila los tres.
Los diez factores de fracaso en una transformación ERP: qué tienen en común Lidl, Haribo, DHL, Asda, LeasePlan, Kingfisher y Revlon
Los diez factores que siguen no son una lista de buenas prácticas, sino los diez lugares en los que los siete programas se torcieron, ordenados desde las decisiones más tempranas hasta las más tardías. Ninguno de ellos es un error de programación. Todos son decisiones de dirección, o ausencias de decisión, que solo la dirección podía haber tomado. Para cada uno se explica en qué consiste, cómo se manifestó en al menos dos de los casos y qué señal temprana habría permitido detectarlo cuando todavía era barato corregirlo.
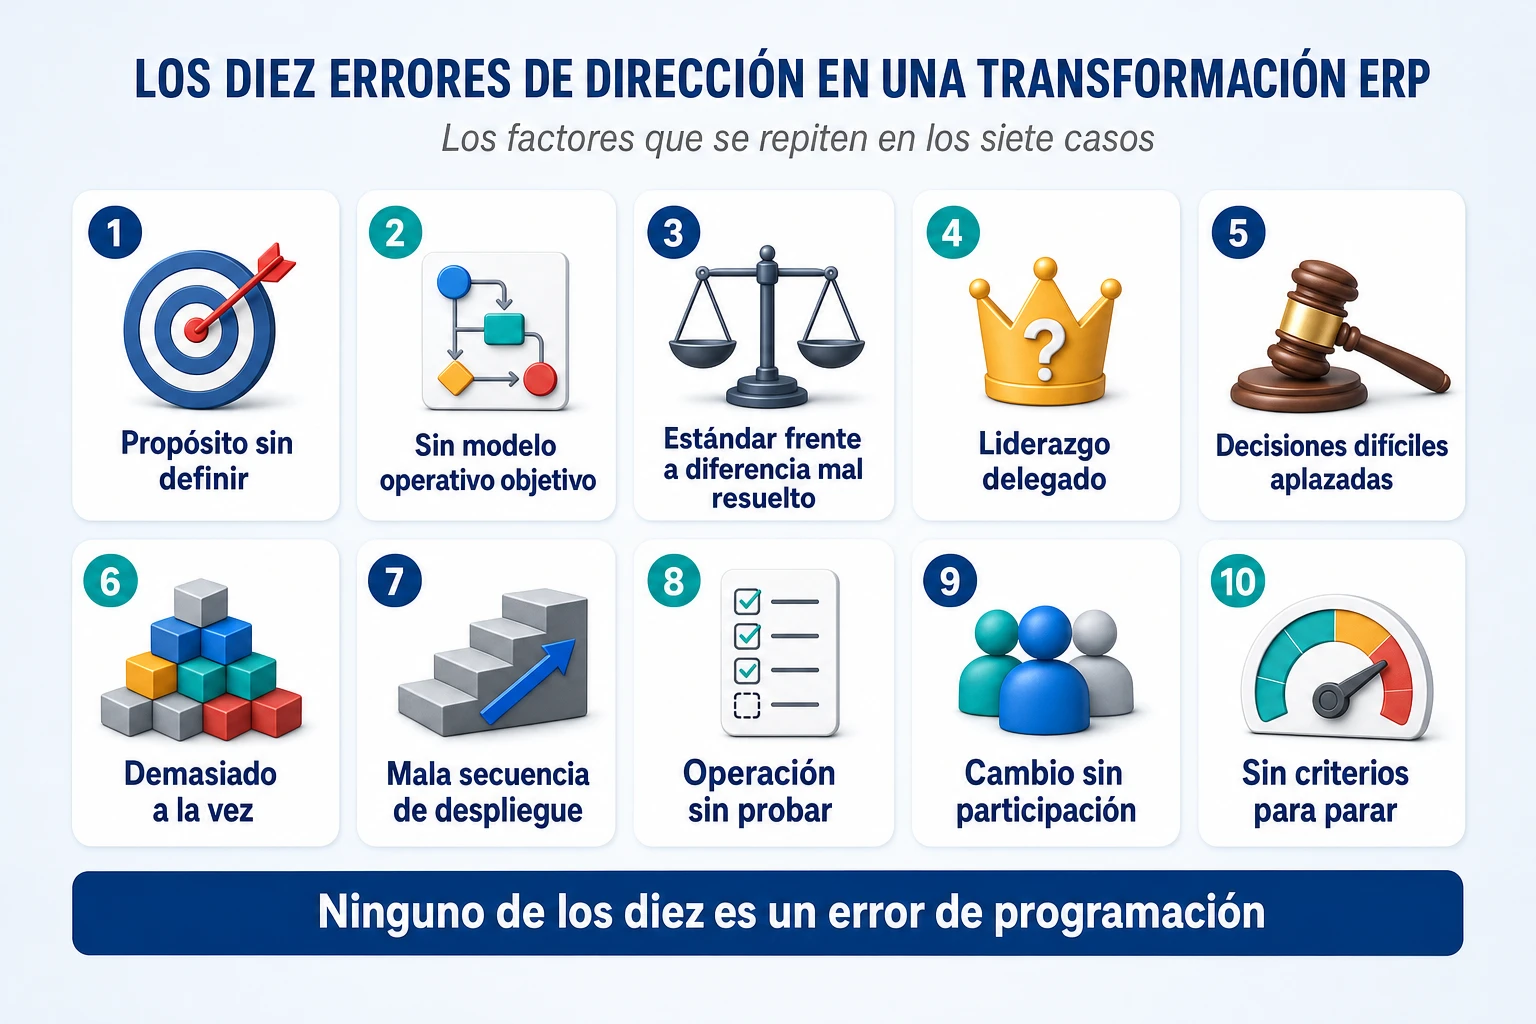
1. Estrategia y propósito: qué problema de negocio se quiere resolver y qué capacidades hay que conservar
Todas las transformaciones de este artículo tenían un propósito razonable en su formulación general: unificar sistemas, ganar escala, modernizar una plataforma, independizarse de una matriz. El problema es que un propósito así no orienta ninguna decisión difícil. «Unificar los sistemas del grupo» no dice qué hacer cuando el sistema común choca con la forma en que una filial gana dinero. Un propósito útil define tres cosas a la vez: el problema de negocio que se quiere resolver, los resultados medibles que se esperan y las capacidades que la transformación no debe destruir. La tercera es la que casi siempre falta, y es la que habría evitado buena parte de estos fracasos.
En Kingfisher, el propósito de ganar escala mediante la unificación se formuló sin delimitar qué rasgos de cada enseña había que proteger, y la centralización se llevó por delante parte de lo que hacía que los clientes franceses eligieran Castorama o Brico Dépôt. En LeasePlan, el propósito de integrar una federación de filiales se mantuvo mientras la estrategia del negocio se movía hacia servicios digitales que pedían otra cosa, y nadie volvió a preguntar si el programa seguía sirviendo al propósito nuevo. En Lidl, la capacidad que estaba en juego, gobernar el margen desde el precio de compra, nunca se declaró como intocable ni como sacrificable, y por eso el proyecto osciló entre las dos posturas durante años. Quien quiera profundizar en por qué un objetivo general no es una estrategia encontrará el argumento desarrollado en el artículo sobre cómo distinguir la buena de la mala estrategia. La señal temprana de este factor es sencilla: si los responsables del programa no saben responder en una frase qué no debe cambiar, el propósito todavía no está definido.
2. Modelo operativo objetivo: cómo debe trabajar la empresa después de implantar el ERP
El segundo factor es la ausencia de un modelo operativo objetivo, es decir, de una descripción clara de cómo va a trabajar la empresa cuando la transformación termine: quién decide qué, en qué orden ocurren las cosas, qué se centraliza y qué no, qué información necesita cada área y qué controles existen. Sin esa descripción, la implantación de un producto se confunde con el diseño del negocio, y el sistema acaba decidiendo por defecto cómo se trabaja. A veces lo decide en la dirección del estándar del fabricante, sin que nadie del negocio lo haya validado; otras veces en la dirección de reproducir el pasado, porque es lo único que todo el mundo conoce.
Lidl es el ejemplo del segundo camino: sin un modelo operativo futuro decidido, cada área pidió que el sistema nuevo hiciera lo que hacía el viejo, y el proyecto se convirtió en una costosa reproducción de Wawi. Kingfisher es el ejemplo de un modelo operativo objetivo que sí existía, el de un grupo integrado con surtido común, pero que no se contrastó con la realidad de los mercados antes de imponerlo. En DHL, la indefinición sobre qué parte de la operación del transitario debía ser común en todos los países es coherente con las dificultades que aparecieron en los pilotos, aunque las fuentes no permiten afirmarlo con certeza. Como se explicaba en el artículo sobre reingeniería de procesos, automatizar un proceso sin rediseñarlo no lo mejora: lo congela. La señal temprana es que el programa tenga diagramas del sistema y no tenga una descripción, aprobada por el negocio, de cómo trabajará la empresa.
3. Estandarización frente a diferenciación: qué procesos deben ser comunes y cuáles son ventaja competitiva
El tercer factor es el más característico de los ERP, y aparece en los siete casos con dos caras opuestas. Una cara es el exceso de adaptación: la empresa considera diferencial todo lo que hace y obliga al software a reproducirlo, con un coste que crece sin límite. La otra es el exceso de estandarización: la empresa, o el grupo, impone un modelo común también en aquello que de verdad la diferenciaba, y destruye ventaja competitiva para ganar eficiencia. Las dos son el mismo error visto desde lados distintos: no haber decidido proceso a proceso qué es estandarizable y qué es diferencial.
Lidl cayó en la primera cara, Kingfisher en la segunda, y DHL y LeasePlan probablemente en una mezcla de ambas, porque pretendían una plataforma común para negocios nacionales muy distintos sin haber separado lo común de lo local. La regla práctica que se desprende de los cuatro casos no es «adapte siempre sus procesos al estándar» ni «proteja siempre lo que le hace distinto», sino algo más exigente: la mayoría de los procesos de soporte deberían ser estándar, unos pocos procesos diferenciales deberían protegerse por decisión explícita de la dirección, y esa lista corta debería existir por escrito antes de elegir la solución. La señal temprana de este factor es el número de adaptaciones pedidas por el negocio que nadie ha clasificado como diferenciales o no: cuando esa lista crece sin que un comité la revise, el programa está derivando hacia uno de los dos extremos.
4. Liderazgo y propiedad del cambio: por qué la transformación no se puede delegar en tecnología ni en el integrador
El cuarto factor es quién es realmente dueño de la transformación. En los programas que fracasan suele haber un patrocinador formal en la dirección, un equipo de tecnología que lleva el peso del trabajo y un integrador que pone la mayor parte de las personas. Lo que suele faltar es un responsable de negocio con autoridad real sobre el resultado, alguien que no responda de que el sistema funcione, sino de que la empresa funcione mejor con él. Cuando esa figura no existe, la transformación se convierte de hecho en un proyecto de tecnología con un patrocinador que firma, y las decisiones de negocio las toman por defecto quienes no tienen autoridad para tomarlas.
El intercambio público de DHL con SAP y el integrador después del fracaso es el síntoma más visible: tres organizaciones implicadas y ninguna asumiendo el resultado de negocio. En Kingfisher, el liderazgo existía y era fuerte, pero estaba concentrado en el centro del grupo, sin un contrapeso con autoridad equivalente en los mercados; el cambio de consejero delegado fue, en la práctica, el momento en que esa autoridad se redistribuyó. En Revlon, según las alegaciones de los inversores, la decisión de arrancar se mantuvo pese a las advertencias de las pruebas, lo que apunta a una propiedad del cambio en la que el calendario pesaba más que la operación. La señal temprana de este factor es la composición del comité que aprueba los hitos: si en él no hay responsables de las operaciones afectadas con capacidad de veto, la transformación no tiene dueño de negocio.
5. Gobernanza y decisiones difíciles: resolver conflictos, limitar el alcance y detener a tiempo
El quinto factor no es la falta de reuniones de seguimiento, que en todos estos programas había en abundancia, sino la falta de mecanismos para tomar las decisiones que nadie quiere tomar: resolver un conflicto entre dos áreas, decir que no a una adaptación que el negocio pide con razón, recortar el alcance, revisar si el programa sigue siendo viable o detenerlo. Un comité de seguimiento que solo revisa el avance frente al plan no es un órgano de gobierno, es un órgano de información, y en los programas largos esa diferencia se paga en años.
Lidl es el ejemplo extremo: siete años en los que el conflicto central del proyecto no se resolvió, y en los que cada adaptación se aprobó por separado sin que nadie sumara el conjunto. LeasePlan muestra la versión más moderada del mismo problema, un programa que tardó dos años en ser cuestionado a fondo aunque la estrategia del negocio había cambiado en medio. DHL, en cambio, muestra que el mecanismo puede funcionar: el grupo detuvo el programa en la fase piloto y asumió la pérdida, aunque cabe preguntarse cuánto se había invertido antes de que los pilotos dieran su veredicto. El artículo sobre cómo arrancar un proyecto de transformación desarrolla cómo organizar los derechos de decisión antes de empezar, que es cuando resulta más barato hacerlo. La señal temprana de este factor es el número de decisiones abiertas que lleva más de un mes sin resolverse: es la deuda de decisión del programa, y crece en silencio.
6. Ambición y complejidad: demasiadas transformaciones simultáneas y calendarios impuestos sin evidencia
El sexto factor es la acumulación de riesgo. Ninguna de las empresas de este artículo emprendió una sola transformación: casi todas cambiaron a la vez el sistema, los procesos, la organización y, a menudo, una parte del negocio. Cada cambio por separado podía gestionarse; juntos, multiplicaban las dependencias y hacían imposible saber qué fallaba cuando algo fallaba. La complejidad de un programa no crece con el número de cambios, sino con el número de combinaciones entre ellos, y eso convierte un alcance ambicioso en un alcance ingobernable sin que nadie lo decida.
Haribo cambió el sistema que gobierna su producción mientras ponía en marcha una fábrica nueva y abordaba otros cambios comerciales, y su propio responsable en Alemania reconoció un alcance inicial excesivo. Asda se separaba de Walmart mientras sustituía más de 2.500 sistemas y lanzaba una web y una aplicación nuevas el mismo mes en que completaba la separación. Kingfisher cambiaba surtido, compras, aprovisionamiento, organización y sistema en las mismas tiendas, y la primera decisión de la nueva dirección fue hacer menos cosas a la vez. LeasePlan se planteó implantar en unos quince países con dos grandes despliegues al año, un calendario que su propio responsable tecnológico llamó extremadamente agresivo. Para quien quiera ver cómo la complejidad acumulada se convierte en un problema de gestión por sí misma, el caso de Starbucks y su complejidad operativa lo muestra fuera del mundo de los ERP. La señal temprana es un plan en el que varios cambios críticos coinciden en la misma ventana sin que nadie haya evaluado qué pasa si fallan juntos.
7. Método de ejecución: desplegar por fases, países, procesos o unidades de negocio
El séptimo factor es la secuencia. Un ERP puede desplegarse de golpe en toda la organización, por países, por plantas, por procesos o por unidades de negocio, y cada opción tiene ventajas y riesgos. El despliegue de golpe evita convivir durante meses con dos sistemas y dos formas de trabajar, pero concentra todo el riesgo en un solo momento. El despliegue por etapas permite aprender y corregir antes de exponer todo el negocio, pero alarga el programa y obliga a mantener interfaces temporales. No hay una secuencia correcta en general; hay una secuencia correcta para cada nivel de riesgo, y el error es elegirla por comodidad del proyecto en lugar de por el riesgo para el negocio.
Revlon eligió como gran despliegue una de sus instalaciones más críticas, que es el peor sitio posible para descubrir los problemas. LeasePlan planeaba despliegues de una sola vez en buena parte de los países. Asda concentró varios cambios críticos en la misma ventana al final del programa. En el lado contrario, Kingfisher corrigió su secuencia sobre la marcha, aplazando la migración de Brico Dépôt y de sus operaciones en España y Portugal hasta estabilizar Castorama, y Haribo habría podido descubrir sus errores de datos con mucho menor coste empezando por una parte acotada de su producción. La señal temprana de este factor es que el primer despliegue real sea también el más importante: si el programa no tiene un primer paso pequeño del que aprender, tiene una apuesta, no una secuencia.
8. Preparación de la operación: procesos completos, datos, excepciones y escenarios reales de carga
El octavo factor es el que explica las tres crisis al arrancar, y es el más concreto de todos. La operación no estaba preparada para funcionar con el sistema nuevo, aunque el sistema funcionara. Las pruebas habituales de un proyecto comprueban que cada módulo hace lo que debe; lo que había que comprobar era que el negocio podía operar de punta a punta, con sus datos reales, sus excepciones, sus volúmenes y sus personas. Son dos preguntas distintas y la segunda casi nunca se hace de forma completa, porque cruza las fronteras de todos los equipos del proyecto y no pertenece a ninguno.
Haribo descubrió en sus fábricas que referencias con un número mal migrado no podían producirse. Asda descubrió en sus tiendas que los flujos de mercancía entre almacenes y establecimientos no funcionaban como debían, y su presidente ejecutivo citó expresamente pruebas insuficientes y problemas de planificación de capacidad. Revlon descubrió en su planta que la integración entre producción y almacén fallaba y reconoció ante el regulador carencias de personas preparadas y de controles. En los tres casos, lo que falló estaba en la frontera entre áreas, en el punto donde un proceso pasa de un equipo o de un sistema a otro. La señal temprana de este factor es que el plan de pruebas esté organizado por módulos y no por recorridos de negocio: si nadie es responsable de probar el recorrido completo de un pedido, nadie lo está probando.
9. Gestión del cambio y adopción: participación temprana del negocio y formación conectada con el trabajo real
El noveno factor es el que todo el mundo menciona y casi nadie trata como lo que es. La gestión del cambio no es un plan de comunicación y formación que se añade al final del proyecto, sino la participación del negocio en las decisiones desde el principio, para que el sistema que llegue sea uno que la gente reconoce como suyo y sabe usar en su trabajo real. La formación que enseña las pantallas del sistema prepara para usarlo; la que enseña a resolver con él las situaciones reales del puesto, incluidas las que salen mal, prepara para trabajar con él. Solo la segunda evita lo que ocurrió en varios de estos casos.
Revlon reconoció formalmente carencias en el número y la capacitación de las personas responsables de determinadas actividades y controles, que es la forma regulatoria de decir que la organización no estaba preparada para trabajar con el sistema nuevo. En LeasePlan, el propio responsable tecnológico identificó la gestión del cambio como un desafío central desde el primer día, porque empleados, clientes y colaboradores tendrían que trabajar de otra manera. Y en Kingfisher, la recuperación incluyó incorporar más de 25 perfiles críticos al equipo logístico francés y devolver decisiones a los mercados, dos medidas que apuntan a que el cambio se había diseñado lejos de quienes tenían que vivirlo. Los modelos clásicos de gestión del cambio, que se analizan en el artículo sobre por qué fallan las transformaciones empresariales, coinciden en lo esencial: el cambio no se comunica, se construye con quienes lo van a vivir. La señal temprana de este factor es que los usuarios clave conozcan el sistema por primera vez en la formación previa al arranque.
10. Gestión del riesgo y del valor: indicadores tempranos, contingencia y criterios para continuar o abandonar
El último factor es el que decide cuánto cuesta cada uno de los nueve anteriores. Todos los programas tienen problemas; la diferencia entre un problema y un fracaso es si se detecta a tiempo y si existe un mecanismo para actuar cuando se detecta. Eso exige tres cosas que casi nunca están presentes a la vez: indicadores tempranos que miren al negocio y no solo al proyecto, planes de contingencia que permitan aislar un fallo o volver atrás, y criterios objetivos, escritos antes de empezar, para decidir cuándo continuar, cuándo replantear y cuándo abandonar. Un criterio de parada escrito antes de que haya dinero invertido es mucho más fácil de aplicar que uno que se discute cuando ya se han gastado cientos de millones.
Revlon reconoció que no había desarrollado un proceso eficaz para evaluar los riesgos que la implantación introducía en su control financiero, que es exactamente este factor dicho en lenguaje de auditoría. LeasePlan documentó que el sistema no generaría los beneficios económicos previstos, una conclusión de valor que llegó después de dos años de construcción. Lidl tardó siete años en concluir que los objetivos no eran alcanzables con un esfuerzo aceptable. Y Asda retiró su red de seguridad, los servicios de Walmart, sin una forma de volver atrás si los flujos de las tiendas fallaban. En los cuatro casos, la información que acabó provocando la decisión existía mucho antes de que la decisión se tomara. La señal temprana de este factor es la ausencia de una pregunta en las revisiones del programa: qué tendría que ocurrir para que lo paráramos. Si nadie sabe responderla, el programa no tiene un criterio de parada, y sin criterio de parada solo se detiene cuando el daño ya es evidente.
Cómo orquestar una transformación ERP: un método de gobierno en cinco fases
Los siete casos permiten convertir sus errores en un método práctico para quien tenga que dirigir, patrocinar o supervisar una transformación de este tipo: directores generales, responsables de operaciones, líderes de transformación, oficinas de programa y consultores. El método se organiza en cinco fases, desde la concepción hasta la estabilización, y cada una termina con un entregable esencial y con una decisión de avance que debe tomarse con evidencia y no con una fecha. La idea que lo recorre entero es sencilla: cada fase existe para tomar una decisión que, en alguno de los siete casos, se tomó tarde, se tomó mal o no se tomó.
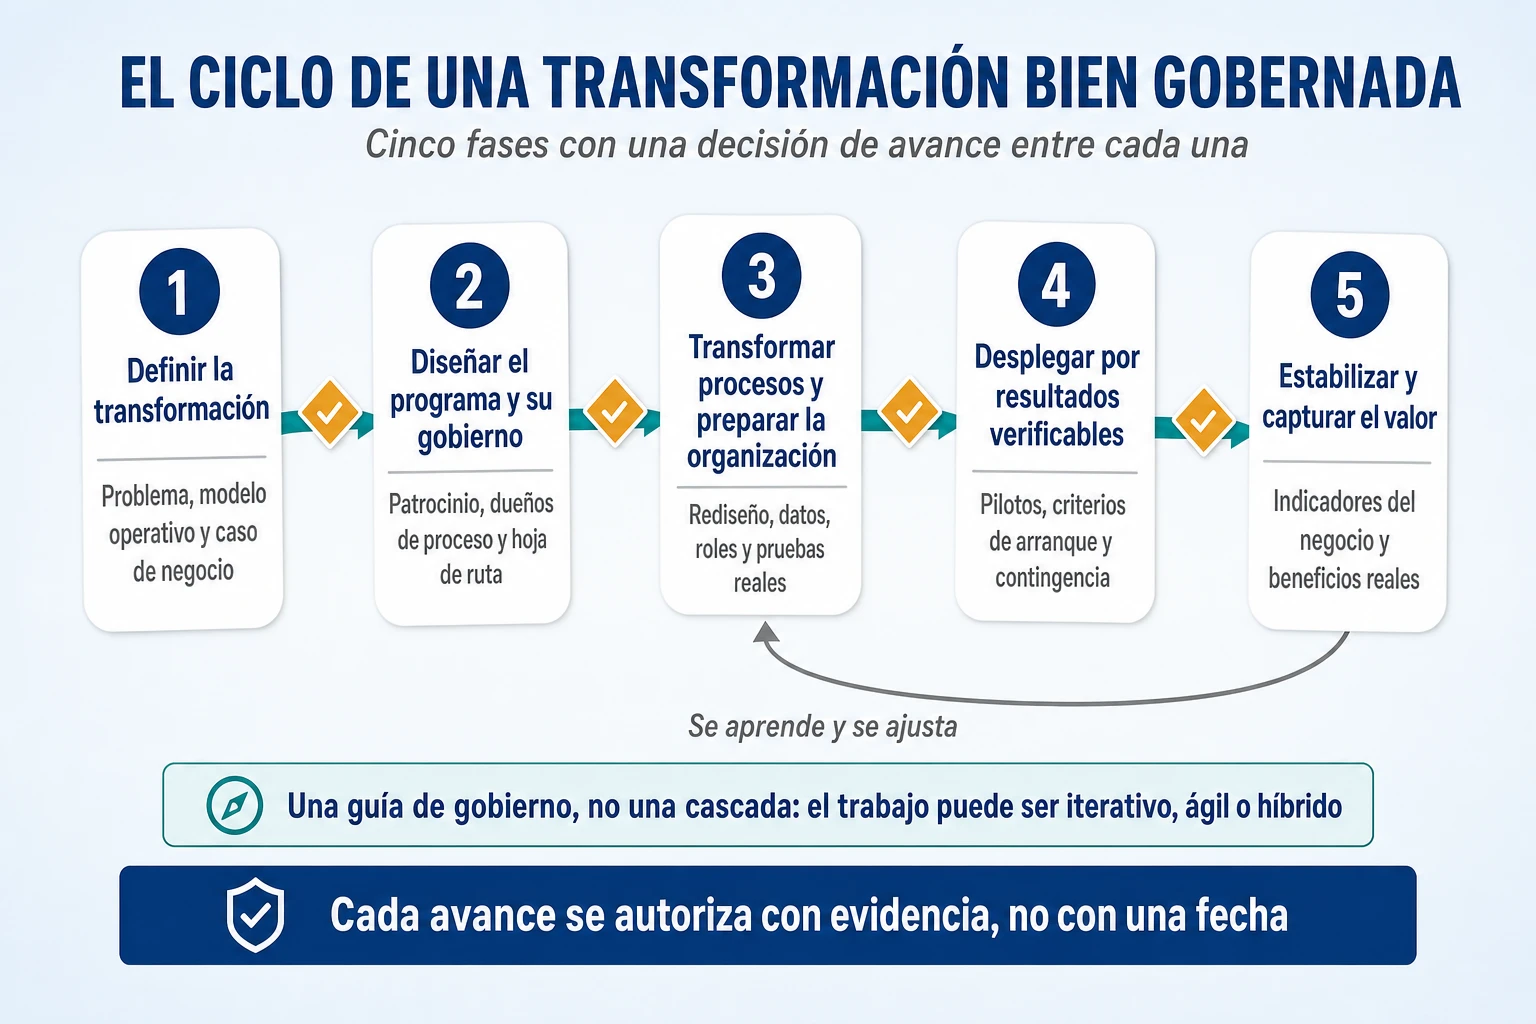
Conviene aclarar desde el principio lo que este método no es. No es una metodología de desarrollo en cascada, en la que cada fase termina por completo antes de que empiece la siguiente. Es una guía de gobierno: describe qué decisiones hay que tomar, en qué orden y con qué evidencia, y deja libre la forma de organizar el trabajo. Dentro de cada fase, el trabajo puede organizarse de forma iterativa, ágil o híbrida según su naturaleza, y es habitual que la configuración del sistema avance por incrementos mientras el diseño de los procesos se va cerrando, o que un piloto de la fase cuatro obligue a revisar decisiones de la fase tres. Lo que el método exige no es una secuencia rígida, sino que ninguna decisión de avance importante se tome sin la evidencia que le corresponde.
Tampoco es un método para elegir proveedor ni para configurar un producto concreto. Las fases son las mismas si la empresa implanta SAP, Oracle, Microsoft o una plataforma más modular, porque las decisiones que importan son de negocio. Y no sustituye al conocimiento técnico del integrador, que sigue siendo imprescindible. Lo que hace es colocar ese conocimiento al servicio de un programa que dirige la empresa, y no al revés.
Fase 1 de una transformación ERP: definir la transformación antes de elegir la herramienta
La primera fase es la que más se acorta y la que más cuesta haber acortado. Su objetivo es definir qué transformación necesita la empresa antes de decidir con qué herramienta hacerla, y su enemigo habitual es la prisa por empezar a configurar algo. Todo lo que no se decida en esta fase se decidirá después por defecto, dentro del proyecto, por personas sin autoridad para decidirlo y cuando cambiar de opinión ya cuesta mucho más. Lidl, LeasePlan y Kingfisher pagaron precisamente decisiones que pertenecían a esta fase.
El primer trabajo es diagnosticar el modelo operativo actual: cómo se compra, se fabrica, se vende, se distribuye y se controla hoy, con qué sistemas, con qué datos y con qué problemas reales. No el proceso que describen los manuales, sino el que se ejecuta de verdad, que casi siempre tiene más excepciones, más esperas y más trabajo manual del que la dirección cree. A partir de ese diagnóstico, el segundo trabajo es identificar los problemas que merecen resolverse y las oportunidades que justifican la inversión, y traducirlos en objetivos de negocio con resultados medibles. «Tener una plataforma común» no es un resultado; reducir el plazo de servicio de un pedido, cerrar el mes en menos días o poder lanzar un producto en un país nuevo en semanas sí lo son.
El tercer trabajo, y el más importante, es diferenciar las capacidades estratégicas de los procesos estandarizables. La mayoría de los procesos de una empresa no la diferencian de su competencia, y en ellos lo inteligente es adoptar el estándar del mercado con las mínimas adaptaciones posibles. Unos pocos procesos sí forman parte de cómo compite, y esos deben identificarse uno por uno, justificarse y protegerse por decisión explícita de la dirección. En Lidl ese proceso era la forma de gobernar el margen; en Kingfisher, la propuesta comercial de cada enseña. Una forma práctica de hacerlo es clasificar cada proceso según dos preguntas, si diferencia a la empresa frente a la competencia y si es complejo o crítico para la operación, y tratar cada cuadrante de forma distinta.
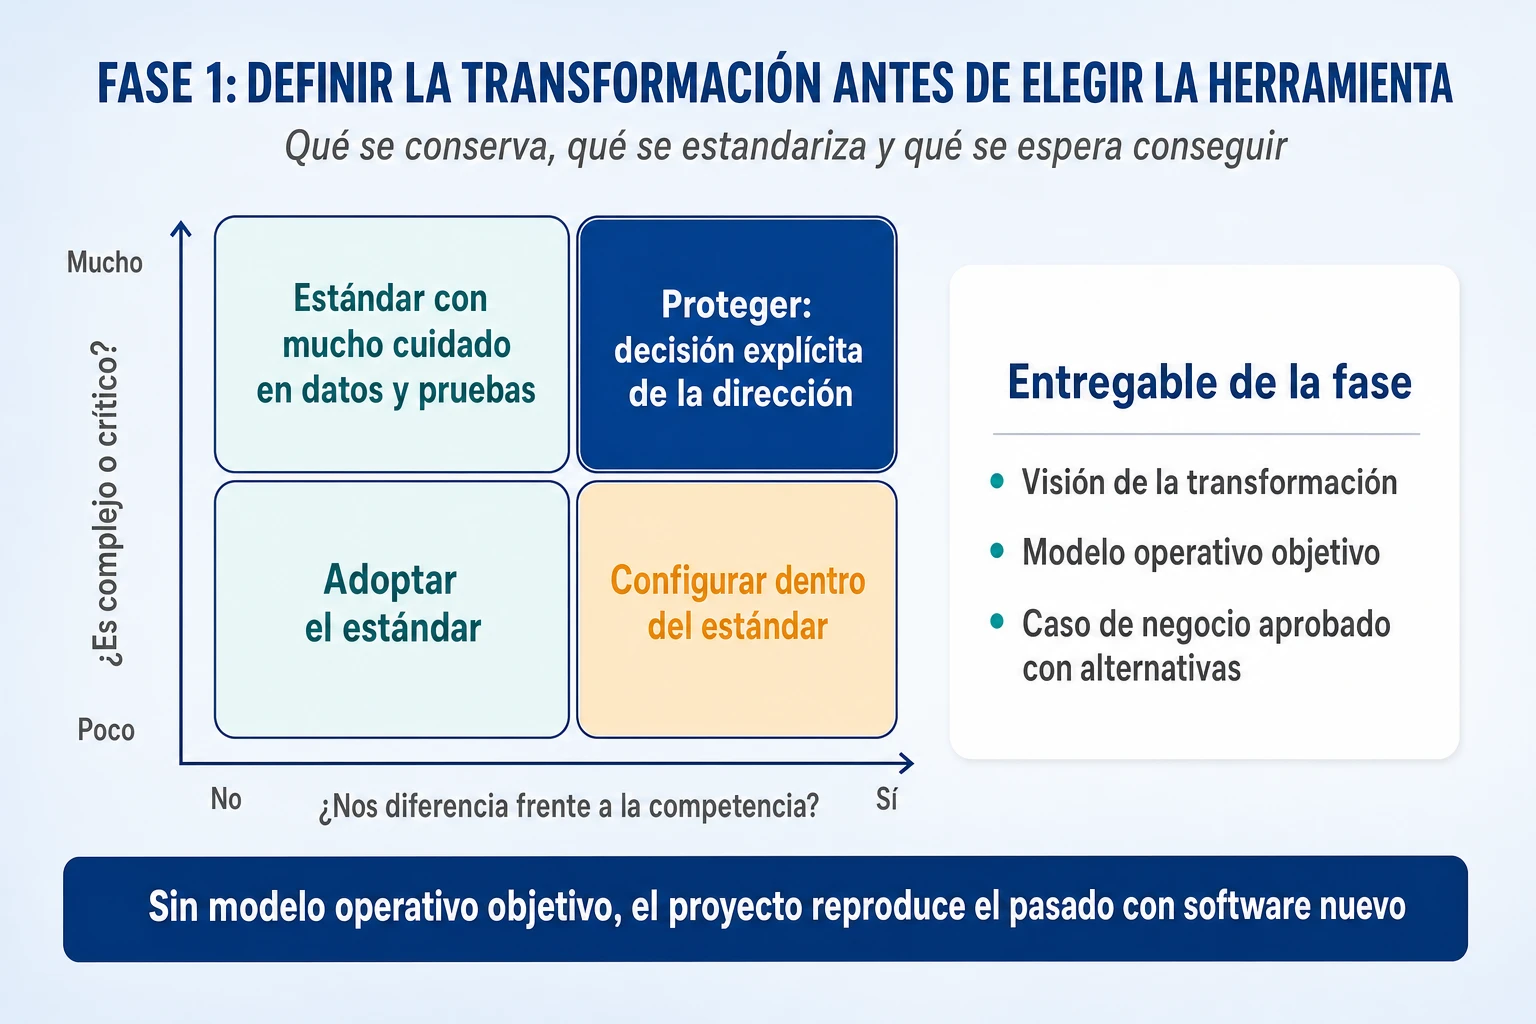
Con esa clasificación ya es posible diseñar el modelo operativo futuro, que es el cuarto trabajo de la fase: cómo trabajará la empresa cuando la transformación termine, qué se centralizará y qué quedará en cada unidad, quién decidirá qué, qué información necesitará cada área y qué controles existirán. No hace falta un diseño detallado de cada proceso, que pertenece a la tercera fase, pero sí un diseño suficiente para que cualquier decisión posterior pueda contrastarse con él. El modelo operativo objetivo es el documento con el que se juzgará después cada petición de adaptación, y sin él no hay forma de saber si una petición es una necesidad del negocio o una costumbre que alguien quiere conservar.
El último trabajo es construir el caso de negocio y analizar alternativas. El caso de negocio no debe limitarse a justificar la inversión elegida, sino comparar opciones reales: sustituir el sistema actual, modernizarlo, combinar un núcleo estándar con soluciones especializadas, o hacerlo por etapas. Lidl acabó eligiendo en 2018 la alternativa de modernizar su sistema propio; si esa opción se hubiera evaluado en serio en 2011, junto a las demás, la decisión de entonces habría estado mejor informada. Y el caso de negocio debe incluir, desde el principio, los criterios que llevarían a reconsiderar el programa, porque es el único momento en que se escriben sin la presión de lo ya invertido.
El entregable esencial de la fase es triple: una visión de la transformación, un modelo operativo objetivo y un caso de negocio aprobado. La decisión de avance que la cierra es si la empresa sabe qué quiere conseguir, qué está dispuesta a cambiar y qué no, y si la inversión se justifica frente a las alternativas. Si alguna de las tres respuestas es vaga, el programa no está listo para elegir solución, por mucha presión que haya para empezar.
Fase 2 de una transformación ERP: diseñar el programa, su gobierno y la selección de socios
La segunda fase organiza el programa que hará realidad la transformación definida en la primera. Su objetivo es que cada decisión difícil que vaya a aparecer tenga, de antemano, un dueño con autoridad para tomarla y un foro donde tomarla. Es la fase que habría cambiado más el desenlace de los siete casos con menos dinero, porque casi todos los fracasos analizados son, en el fondo, decisiones que nadie tenía claro a quién correspondían.
El primer trabajo es establecer un patrocinador ejecutivo real. Real significa tres cosas: que responde del resultado de negocio y no solo del proyecto, que dedica tiempo de verdad al programa y no solo firma sus hitos, y que tiene autoridad sobre las áreas afectadas para resolver sus conflictos. Un patrocinador que no puede imponer una decisión a una dirección de operaciones que se resiste no es un patrocinador, es un portavoz. El segundo trabajo es designar responsables de procesos de punta a punta, personas del negocio que responden de que un recorrido completo, como del pedido al cobro o de la compra al pago, funcione en el modelo futuro, con independencia de cuántos departamentos y sistemas atraviese. Estos dueños de proceso son la pieza que faltaba en las tres crisis al arrancar, porque los fallos aparecieron justo en las fronteras entre áreas que nadie tenía asignadas.
El tercer trabajo es clarificar las responsabilidades entre negocio, tecnología, integradores y proveedores, y hacerlo por escrito. El caso de DHL, con tres organizaciones implicadas y ninguna asumiendo el resultado, muestra lo que ocurre cuando esa clarificación se deja para después del fracaso. El integrador responde de lo que construye y de cómo lo construye; el fabricante del software responde de su producto; la empresa responde de que su negocio funcione con todo ello, y esa responsabilidad no se puede contratar fuera. El cuarto trabajo es establecer un comité con autoridad real para resolver conflictos entre áreas, limitar el alcance, aprobar o rechazar adaptaciones y revisar la viabilidad del programa, con una regla para las decisiones que no se resuelven en un plazo razonable.
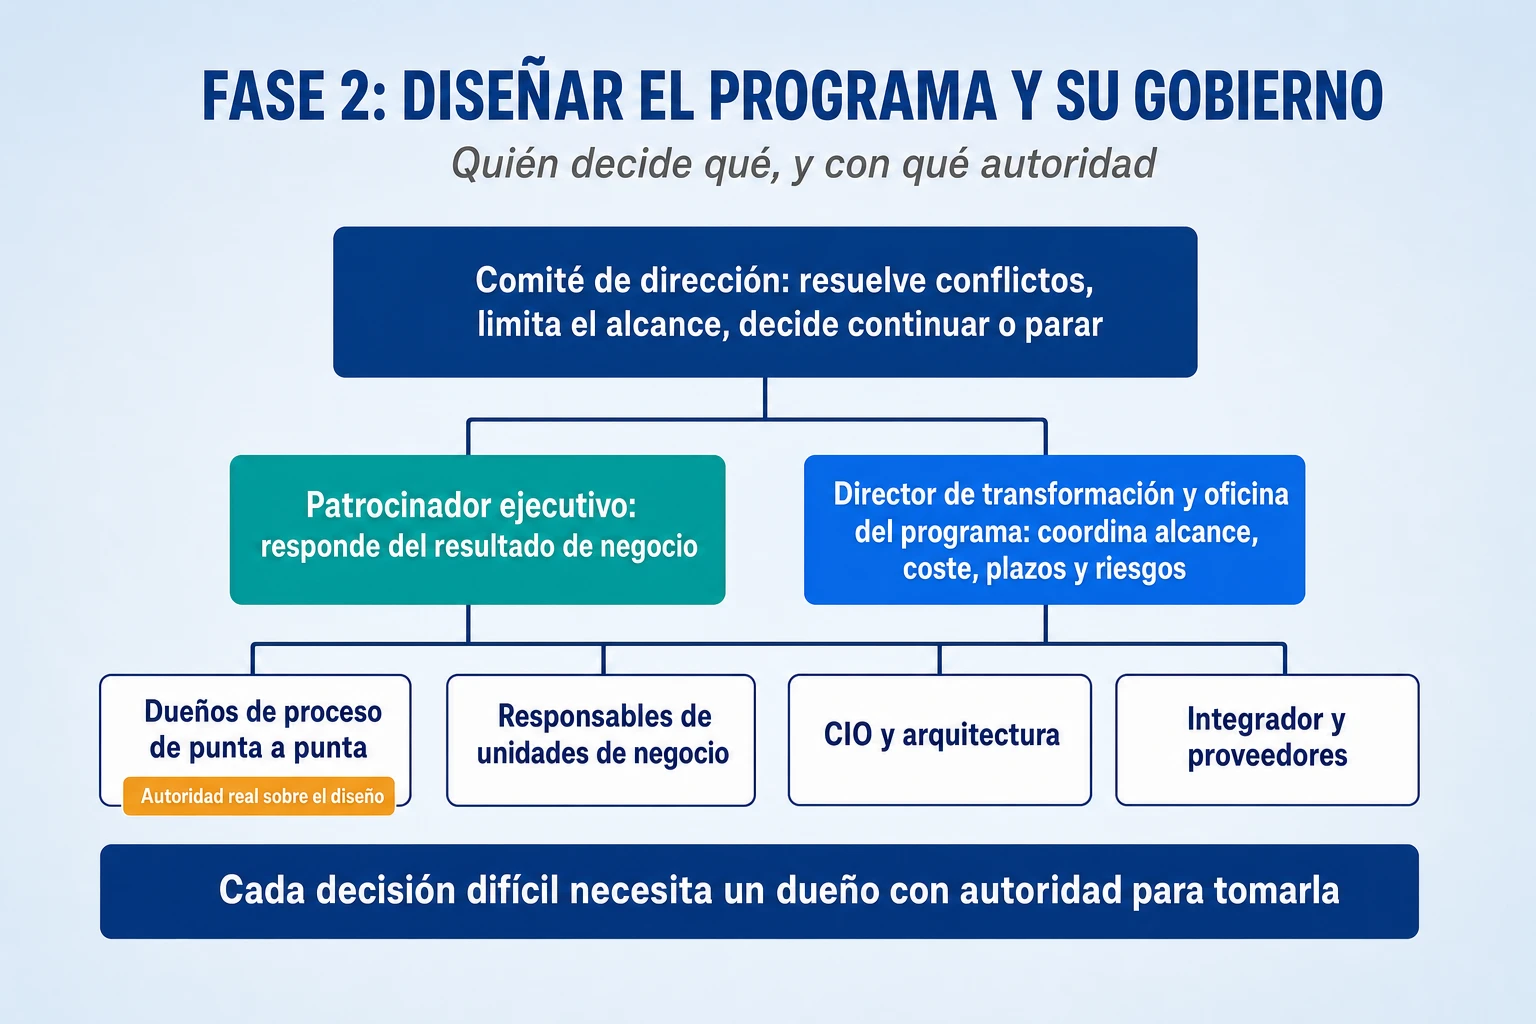
Con el gobierno definido, el quinto trabajo es fijar el alcance, las prioridades, las dependencias y los recursos del programa, incluido lo que queda deliberadamente fuera. Aquí es donde se decide cuánta transformación se aborda a la vez, y donde los casos de Haribo, Asda y Kingfisher enseñan que la ambición debe medirse por las combinaciones de cambios que la organización puede absorber, no por lo que el plan de inversión querría capturar cuanto antes. El sexto trabajo es seleccionar la solución y los socios considerando su adecuación al negocio y no solo sus funcionalidades. La prueba de adecuación más útil no es una demostración preparada por el proveedor, sino el recorrido completo de los procesos diferenciales de la empresa, con sus datos reales, en la solución candidata, que es exactamente la prueba que habría resuelto el conflicto de Lidl en su primer año. Y conviene exigir la misma prueba sobre la variedad: si la solución tiene que servir a muchos países o negocios, hay que comprobar cuánto cuesta incorporar sus diferencias, que es lo que LeasePlan no comprobó.
El séptimo trabajo es determinar qué decisiones requieren la intervención de la dirección y cuáles se resuelven dentro del programa. No todas las decisiones deben subir al comité, porque eso lo paralizaría, pero algunas deben subir siempre: cualquier adaptación de un proceso clasificado como diferencial, cualquier cambio de alcance que afecte al caso de negocio, cualquier retraso que comprometa una dependencia externa y cualquier señal que active un criterio de parada. Escribir esa lista al principio evita que las decisiones importantes se tomen por acumulación de decisiones pequeñas, que es como se torció Lidl.
El entregable esencial de la fase es un gobierno de la transformación con responsabilidades asignadas, una hoja de ruta y unos criterios de éxito acordados. La decisión de avance que la cierra es si cada decisión difícil previsible tiene un dueño y un foro, si la solución elegida ha superado la prueba de adecuación con los procesos diferenciales y si la hoja de ruta acumula un riesgo que la organización puede absorber.
Fase 3 de una transformación ERP: rediseñar los procesos, preparar los datos y preparar a la organización
La tercera fase es donde la transformación se vuelve concreta. Su objetivo es que los procesos futuros estén diseñados, validados por quienes los van a ejecutar y probados con datos reales, y que la organización esté preparada para trabajar con ellos. Es la fase en la que más trabajo se hace y en la que más fácil resulta confundir actividad con avance, porque se puede configurar mucho sistema sin haber cerrado ninguna de las decisiones que de verdad importan.
El primer trabajo es rediseñar los procesos, evitando simplemente automatizar los existentes. La tentación de pedir al sistema nuevo que haga lo mismo que el viejo es enorme, porque es lo que todo el mundo conoce y lo que menos resistencia genera, y es exactamente el camino que llevó a Lidl a reproducir Wawi durante siete años. Rediseñar significa preguntarse, en cada proceso, qué pasos aportan algo y cuáles existen solo porque el sistema anterior obligaba a hacerlos, qué aprobaciones controlan un riesgo real y cuáles son costumbre, y qué esperas se pueden eliminar. Automatizar un proceso desordenado no lo ordena: solo acelera el desorden y lo hace más difícil de cambiar.
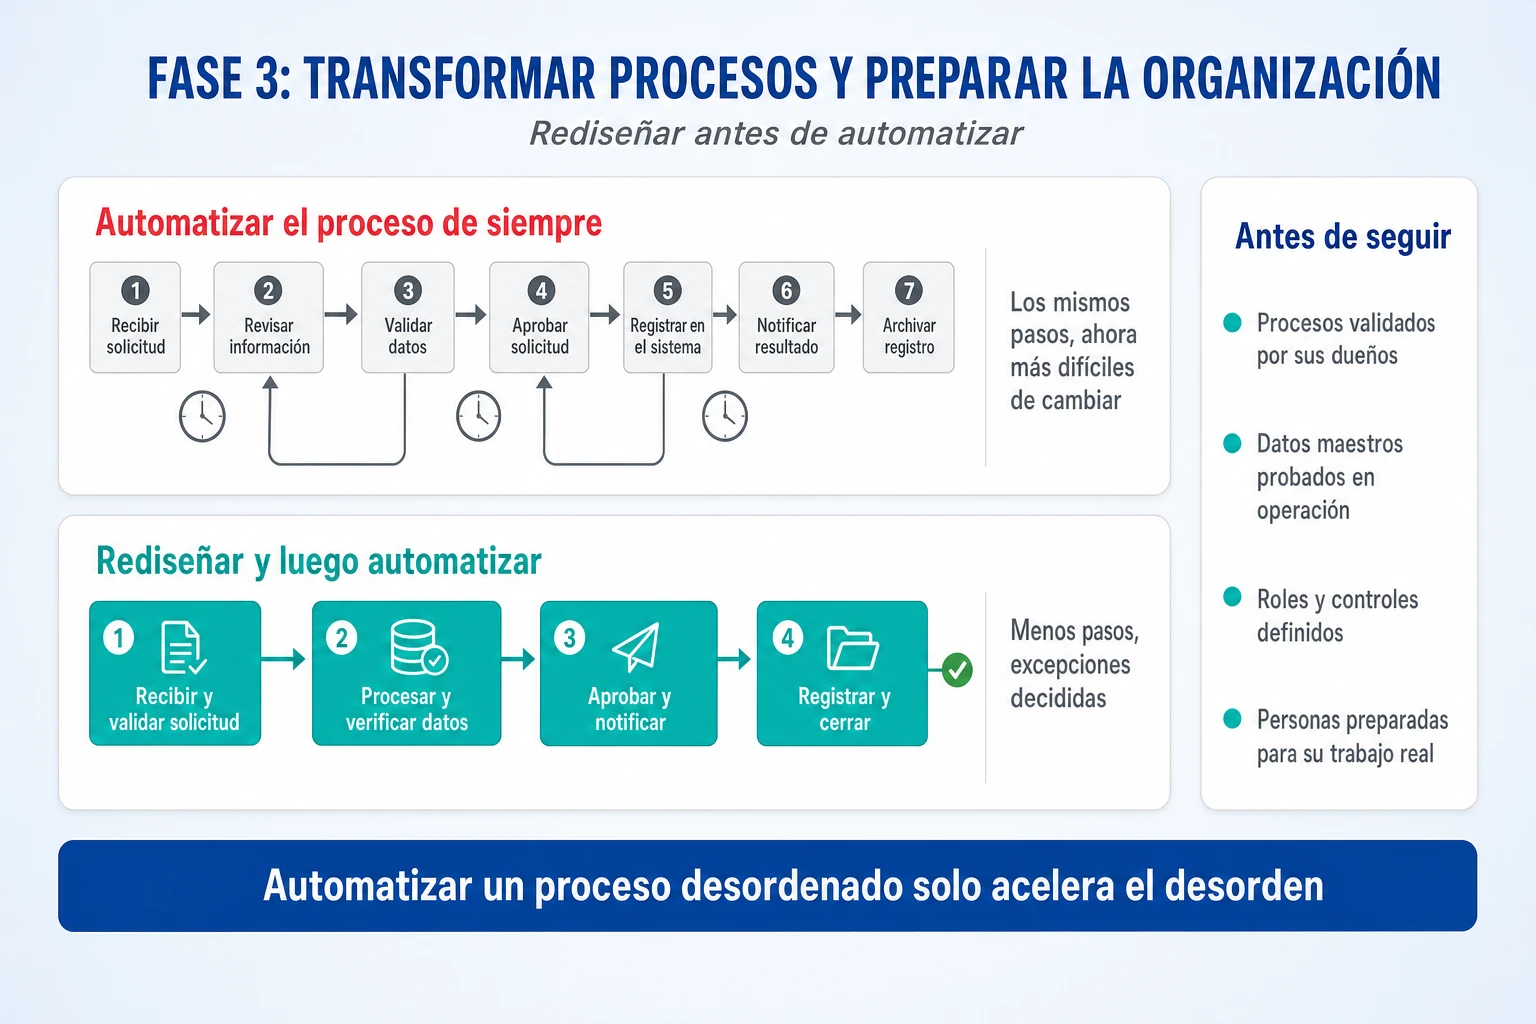
El segundo trabajo es decidir conscientemente las excepciones y las particularidades. Todo proceso real tiene casos que no siguen el camino principal: un cliente con condiciones especiales, un producto con una receta distinta, un país con un documento aduanero propio. El proceso estándar del software resuelve el camino principal; las excepciones hay que decidirlas una a una. Algunas se eliminan, porque ya no tienen sentido; otras se resuelven dentro del estándar con un poco de configuración; y unas pocas justifican una adaptación, si afectan a un proceso diferencial. Lo que no puede ocurrir es que las excepciones se descubran en producción, que es lo que le pasó a DHL en un negocio hecho casi entero de excepciones.
El tercer trabajo es validar los procesos con sus responsables y con los usuarios que los ejecutan. No basta con que el dueño del proceso apruebe un diagrama: hay que comprobar con quienes hacen el trabajo cada día que el proceso diseñado resuelve sus situaciones reales, incluidas las que salen mal. El cuarto trabajo es preparar los datos, los roles, los controles y las relaciones entre departamentos. Los datos no están preparados cuando se han cargado sin errores, sino cuando el negocio puede operar con ellos, y eso solo se demuestra haciéndolos recorrer el proceso completo, que es la lección de Haribo. Los roles definen quién hace qué en el sistema nuevo; los controles aseguran que lo que antes se controlaba se siga controlando, que es la lección de Revlon; y las relaciones entre departamentos fijan qué recibe cada área de la anterior y qué entrega a la siguiente.
El quinto trabajo es gestionar el impacto sobre las personas, la estructura y las capacidades. Un ERP nuevo cambia puestos de trabajo, elimina tareas, crea otras y desplaza poder de decisión de unas áreas a otras. Hay que saber cuántas personas harán falta durante la transición, que casi siempre son más y no menos, qué capacidades nuevas necesitan y quién pierde capacidad de decidir con el nuevo diseño. Revlon reconoció carencias precisamente en el número y la preparación de las personas responsables de ciertas actividades y controles, y Kingfisher tuvo que reforzar su equipo logístico francés para estabilizar. Reducir plantilla en las áreas afectadas justo antes o durante una transición es apostar a que no habrá problemas, y los siete casos demuestran que siempre los hay.
El sexto trabajo es preparar pruebas que reproduzcan operaciones reales: recorridos completos de negocio, con datos reales, excepciones, volúmenes de un día fuerte y las personas que de verdad van a hacer el trabajo. Es la preparación de la que depende la fase siguiente, y su diseño debe hacerse aquí, con los dueños de proceso, y no improvisarse en las semanas previas al arranque. El entregable esencial de la fase es un conjunto de procesos futuros validados y una organización preparada para ejecutarlos. La decisión de avance que la cierra es si los procesos diferenciales funcionan con sus datos reales, si las excepciones importantes están decididas y si existe un plan de pruebas organizado por recorridos de negocio y no por módulos.
Fase 4 de una transformación ERP: desplegar mediante pilotos, criterios de arranque y planes de contingencia
La cuarta fase es la que decide si un programa termina en una crisis operativa. Su objetivo es que cada paso del despliegue se autorice por la preparación real del negocio y no por el cumplimiento de una fecha. Haribo, Asda y Revlon arrancaron con sistemas razonables y organizaciones que no estaban preparadas para usarlos, y en los tres casos la decisión que lo habría evitado pertenecía a esta fase.
El primer trabajo es elegir una secuencia de despliegue acorde con el riesgo. La pregunta no es qué secuencia es más cómoda para el proyecto, sino dónde conviene descubrir los problemas que inevitablemente aparecerán. Un primer despliegue en una planta, un país o una unidad de negocio acotados permite aprenderlos con un coste limitado; un primer despliegue en la instalación más crítica de la empresa, como hizo Revlon, los descubre en el peor sitio posible. El segundo trabajo es ejecutar pilotos representativos, que es la lección de DHL. Un piloto representativo no es el entorno más fácil, sino uno que contiene la variedad que el sistema tendrá que absorber después, y se diseña para decidir si conviene seguir, no para demostrar que se puede.
El tercer trabajo es definir criterios objetivos de arranque, lo que en los proyectos se suele llamar decisión de sí o no. Esos criterios deben escribirse antes de que la fecha se acerque y medirse sobre el negocio, no sobre el proyecto. No tiene sentido fijar aquí umbrales universales, porque dependen de cada empresa y de cada proceso, pero sí el tipo de evidencia que debe exigirse: que las referencias, clientes o expedientes críticos recorran el proceso completo en el sistema nuevo; que las conciliaciones contables se cierren; que la capacidad se haya probado con el volumen de un día fuerte; que las personas clave sepan resolver las situaciones reales de su puesto; y que exista un plan probado para aislar un fallo o volver atrás. Si la evidencia no está, la fecha se mueve; si la fecha no se puede mover, se reduce lo que entra en producción.
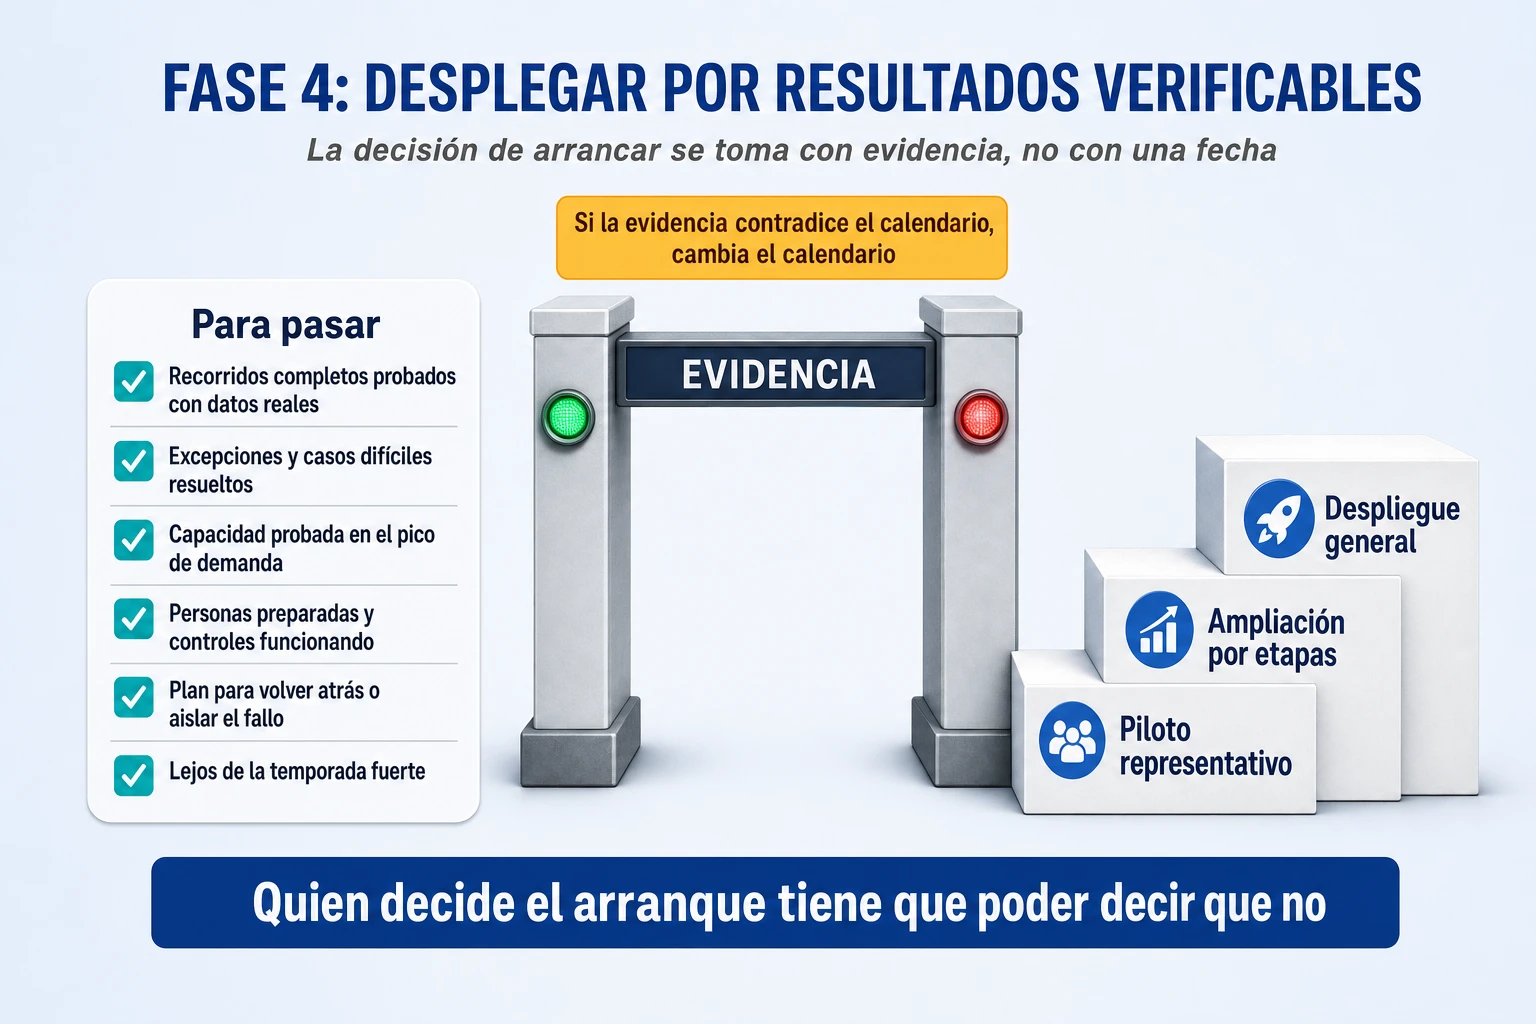
El cuarto trabajo es comprobar los procesos de punta a punta, que es la traducción práctica de los criterios anteriores. En un supermercado, el recorrido va del pedido al proveedor a la recepción en el almacén, la asignación a cada tienda, la reposición, la compra presencial u online, la entrega y la contabilización; en una fábrica, de la planificación a la orden de producción, la fabricación, el inventario y la expedición. Ninguno de esos pasos pertenece a un solo sistema, y por eso ninguna prueba de un solo sistema demuestra que el recorrido funciona.
El quinto trabajo es preparar planes de contingencia y de recuperación. Antes de arrancar hay que saber qué se hará si algo falla: cómo se aísla el fallo, qué procesos pueden seguir funcionando de forma manual o con el sistema anterior durante un tiempo, quién decide volver atrás y en qué condiciones. Asda retiró su red de seguridad, los servicios de Walmart, en el mismo movimiento en que completaba la separación, y cuando los flujos de las tiendas fallaron no había un lugar al que volver. Cuando la vuelta atrás desaparece al dar el paso, ese paso exige más evidencia que ningún otro.
El sexto y el séptimo trabajo son dos disciplinas que se aplican durante toda la fase: evitar el despliegue masivo cuando los resultados de los pilotos no son concluyentes, y replanificar cuando la evidencia contradiga el calendario. A ellos se añade una regla de sentido común que Haribo habría agradecido: programar los arranques críticos lejos de la temporada fuerte del negocio, porque en esas semanas la empresa no tiene margen para absorber ninguna degradación. Y una regla de gobierno que Revlon habría necesitado: la decisión final de arrancar tiene que contar con los responsables de la operación afectada, y esos responsables tienen que poder decir que no.
El entregable esencial de la fase es una autorización de despliegue basada en la preparación real del negocio, no en el cumplimiento de una fecha. La decisión de avance que la cierra, en cada paso del despliegue, es si la evidencia acordada está disponible y si quienes van a operar el negocio con el sistema nuevo aceptan formalmente el riesgo que queda. La pregunta útil para un comité no es solo si el sistema está preparado, sino qué pruebas hay de que el negocio seguirá funcionando y quién acepta por escrito el riesgo residual.
Fase 5 de una transformación ERP: estabilizar la operación, medir resultados y capturar el valor
La quinta fase empieza cuando el sistema entra en producción y termina cuando el negocio funciona mejor que antes, que casi nunca es el mismo día. Su objetivo es estabilizar la operación, comprobar que se obtienen los resultados prometidos y devolver la responsabilidad a la operación ordinaria cuando está preparada para asumirla. Asda declaró terminado su programa en agosto de 2025 y vivió su peor crisis en los meses siguientes; un programa no termina cuando se apaga el sistema antiguo, sino cuando el negocio vuelve a funcionar.
El primer trabajo es establecer un periodo de estabilización con responsables claros, recursos reservados y una duración realista. Revlon tardó casi un año en devolver Oxford a sus niveles anteriores; Haribo, varios meses; Asda, otros tantos. Un plan que prevé pocas semanas de estabilización y retira enseguida al equipo del proyecto está apostando a que todo irá bien. El segundo trabajo es supervisar indicadores operativos y de experiencia de cliente, no solo de incidencias técnicas: disponibilidad de producto, porcentaje de pedidos servidos completos y a tiempo, productividad de plantas y almacenes, desviaciones de inventario, conciliación financiera y capacidad de recuperación tras un incidente. Los indicadores del programa, como el porcentaje implantado o el número de incidencias abiertas, no sustituyen a los del negocio, y pueden estar en verde mientras las tiendas se quedan sin producto.
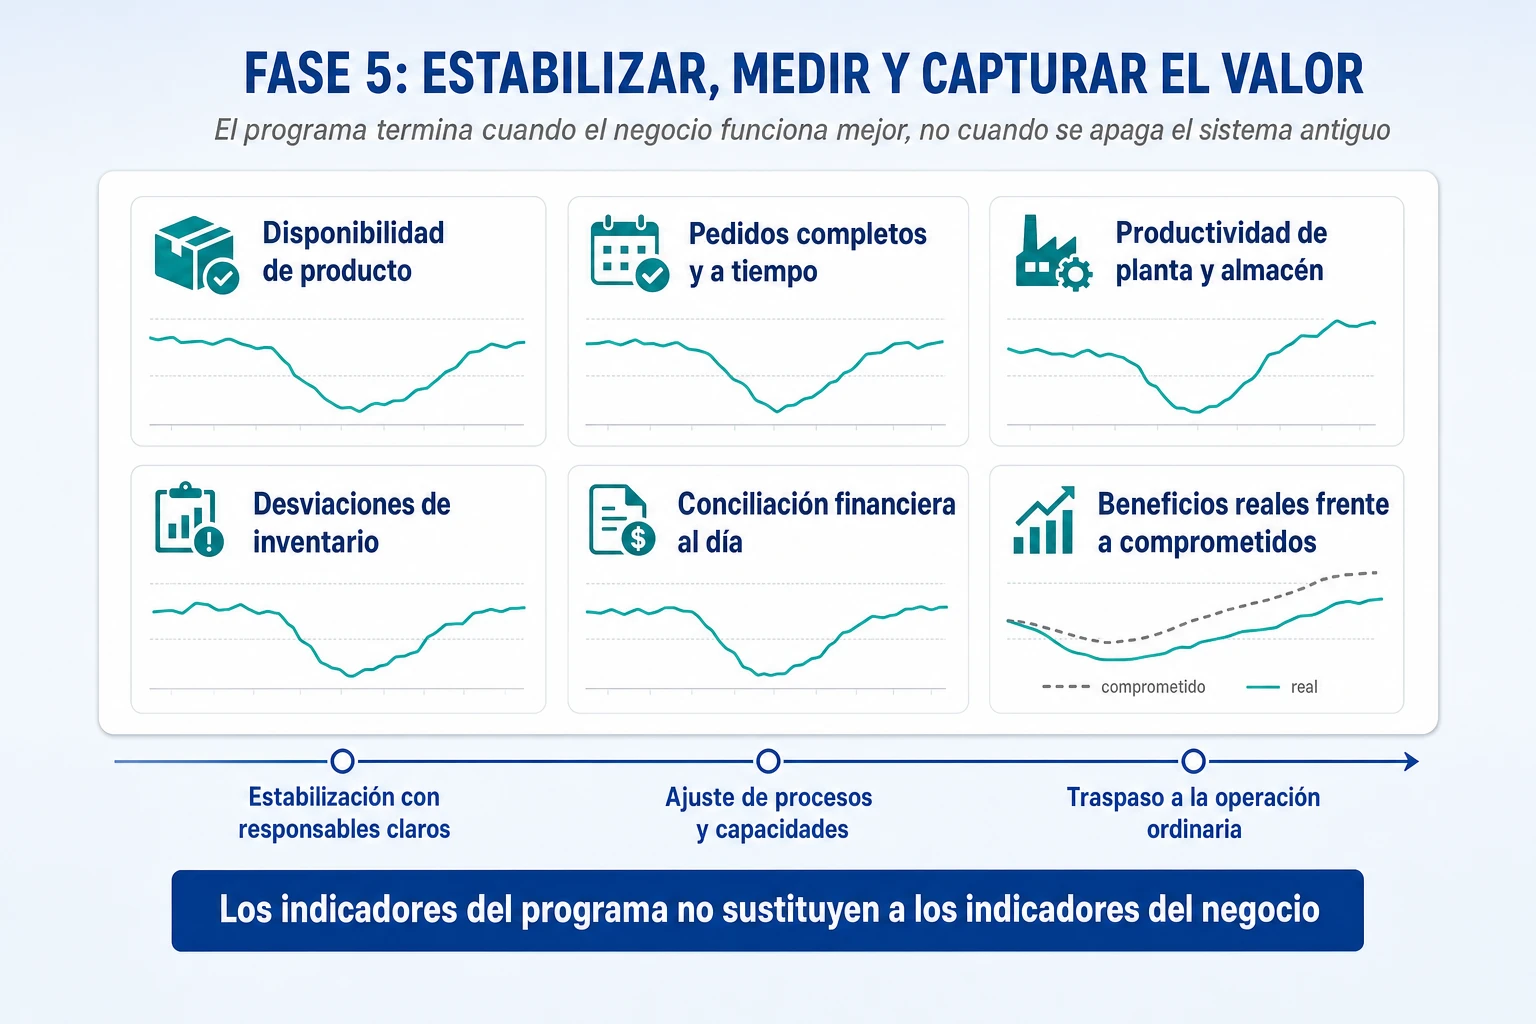
El tercer trabajo es distinguir las incidencias puntuales de las estructurales. Una incidencia puntual se resuelve y no vuelve; una estructural vuelve una y otra vez porque nace de un error de diseño, de datos o de organización, y hay que tratarla corrigiendo su causa, no su síntoma. Los 18 problemas prioritarios del modelo SAP de Castorama eran estructurales, y Kingfisher solo los resolvió cuando dejó de abrir frentes nuevos y concentró los recursos en ellos. El cuarto trabajo es revisar los beneficios reales frente a los comprometidos en el caso de negocio, con la misma honestidad con que LeasePlan acabó reconociendo que su sistema no los generaría. Si los beneficios no llegan, hay que saber por qué: si es un problema de tiempo, de diseño o de que la hipótesis de partida era equivocada.
El quinto trabajo es ajustar procesos, organización y capacidades a lo que se ha aprendido en producción, porque ningún diseño sobrevive intacto al contacto con la operación real. Y el sexto es transferir la responsabilidad a la operación ordinaria cuando, y solo cuando, esté preparada para asumirla, con los indicadores estabilizados y las personas capaces de resolver sin el equipo del proyecto lo que antes resolvía él. El entregable esencial de la fase es una operación estabilizada y unos resultados de negocio verificados. La decisión que la cierra es si el negocio funciona al menos tan bien como antes en todos los indicadores críticos, y si los beneficios comprometidos se están obteniendo o hay un plan creíble para obtenerlos.
La tabla siguiente resume el método. Para cada fase indica la decisión que la cierra, el entregable esencial y el caso que muestra el coste de no haberla tomado bien.
| Fase | Decisión que la cierra | Entregable esencial | Caso que muestra el coste de saltársela |
| 1. Definir la transformación | ¿Sabemos qué queremos conseguir, qué cambiamos y qué protegemos? | Visión, modelo operativo objetivo y caso de negocio con alternativas | Lidl y Kingfisher |
| 2. Diseñar el programa y su gobierno | ¿Tiene cada decisión difícil un dueño y un foro, y la solución ha superado la prueba de adecuación? | Gobierno, responsabilidades, hoja de ruta y criterios de éxito | DHL y LeasePlan |
| 3. Transformar procesos y preparar la organización | ¿Funcionan los procesos diferenciales con datos reales y está decidida cada excepción importante? | Procesos futuros validados y organización preparada | Haribo y Revlon |
| 4. Desplegar por resultados verificables | ¿Está la evidencia acordada y acepta la operación el riesgo residual? | Autorización de despliegue basada en la preparación real | Revlon y Asda |
| 5. Estabilizar y capturar el valor | ¿Funciona el negocio mejor que antes y llegan los beneficios comprometidos? | Operación estabilizada y resultados verificados | Asda y Kingfisher |
Quién debe dirigir una transformación ERP: responsabilidades del comité ejecutivo, el patrocinador, los dueños de proceso, el CIO y el integrador
Si hubiera que resumir en una idea lo que falló en la organización de los siete programas, sería esta: se repartieron bien las tareas y mal las responsabilidades. En todos había personas encargadas de configurar el sistema, de migrar los datos, de formar a los usuarios y de seguir el plan. Lo que escaseaba era alguien que respondiera, con autoridad suficiente, de que el negocio funcionara mejor al final. Una transformación ERP exige tres responsabilidades distintas, y el éxito necesita las tres, pero ninguna sustituye a las otras.
La primera es la responsabilidad tecnológica: conseguir que la plataforma funcione correctamente, que esté bien configurada, integrada con los demás sistemas, que sea segura y que rinda con el volumen previsto. Corresponde al responsable de tecnología, a la arquitectura y al integrador. La segunda es la responsabilidad del programa: coordinar el alcance, el coste, los plazos, los riesgos y las dependencias entre todos los equipos implicados. Corresponde al director de la transformación y a la oficina del programa. La tercera es la responsabilidad empresarial: garantizar que el modelo operativo futuro es viable y que consigue los resultados esperados. Corresponde al patrocinador, a los responsables de las unidades de negocio y a los dueños de los procesos. Los siete casos fallaron, sobre todo, en la tercera, que es la única que no se puede contratar fuera.
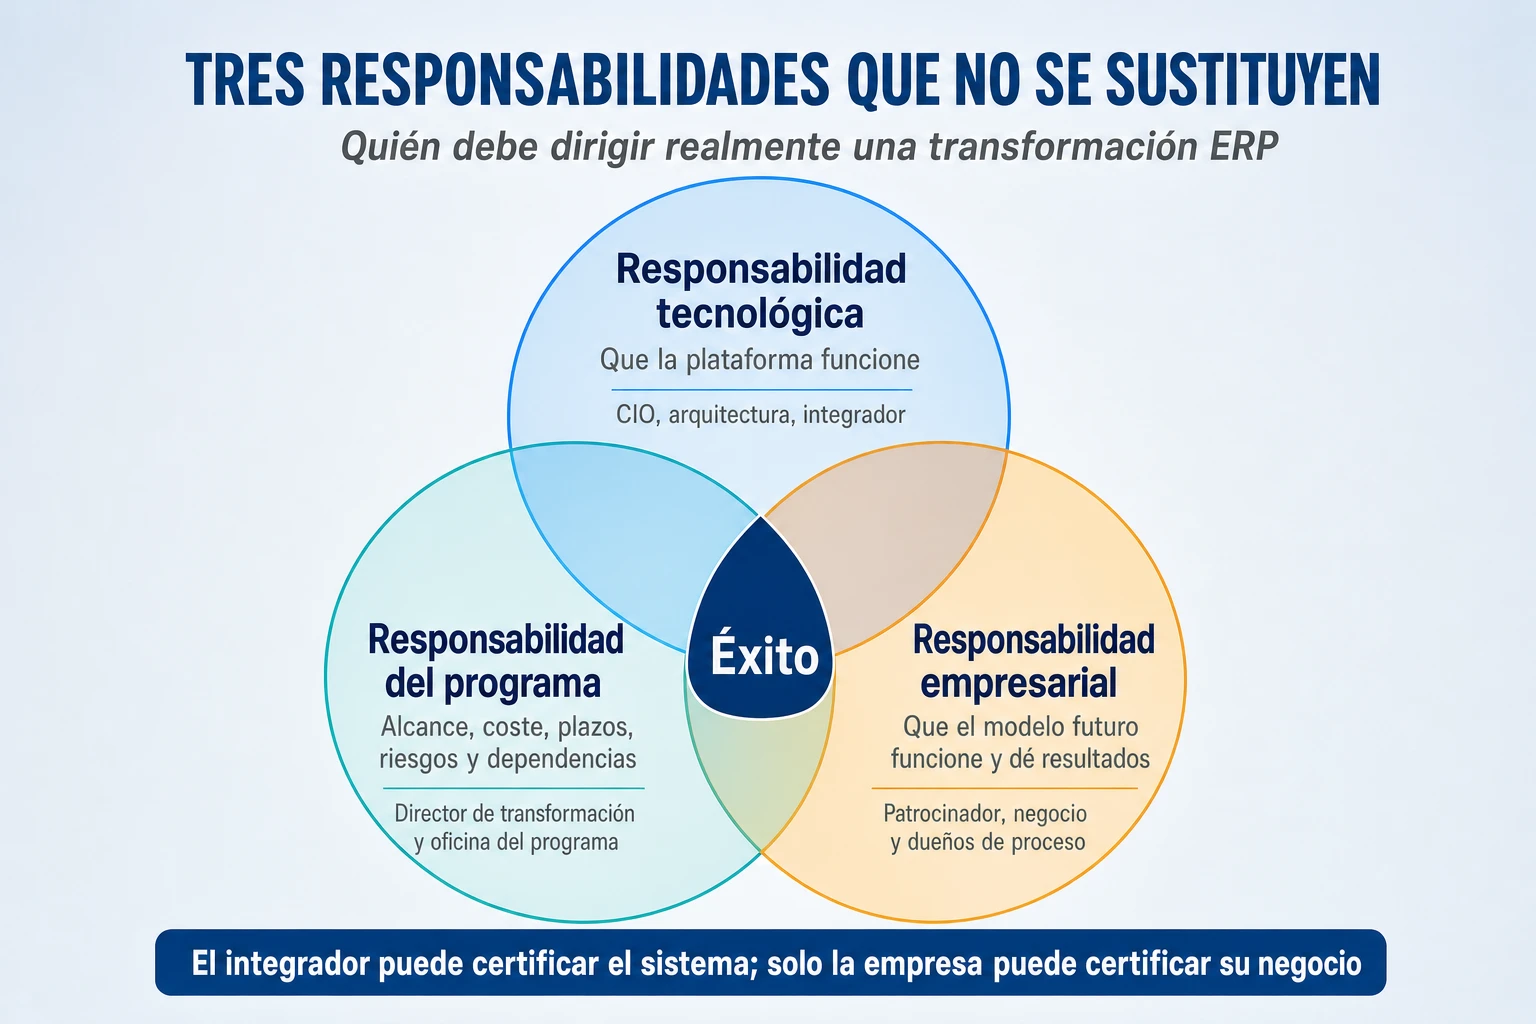
La confusión entre las tres es la causa más frecuente de los fracasos analizados. Cuando la responsabilidad empresarial se da por cubierta porque existe un buen equipo de tecnología, el programa acaba entregando un sistema que funciona y un negocio que no, que es lo que ocurrió en Asda en el tercer trimestre de 2025. Cuando se da por cubierta porque existe una oficina del programa que controla bien el plan, el programa cumple sus hitos mientras deja de tener sentido, que es lo que le ocurrió a LeasePlan. Y cuando se da por cubierta porque el integrador es una firma prestigiosa, la empresa descubre después del fracaso, como DHL, que nadie había asumido el resultado.
La tabla siguiente reparte esas responsabilidades entre los papeles habituales de un programa, con lo que cada uno decide y el error típico que los siete casos muestran en cada papel.
| Papel | De qué responde | Qué decide | Error típico |
| Consejero delegado y comité ejecutivo | De que la transformación sirva a la estrategia de la empresa | Qué se protege y qué se estandariza, el nivel de riesgo aceptable, continuar o detener | Aprobar el programa y no volver a preguntarse si sigue teniendo sentido |
| Patrocinador ejecutivo | Del resultado de negocio del programa | Los conflictos entre áreas que el programa no puede resolver solo | Patrocinar sin tiempo ni autoridad sobre las áreas afectadas |
| Director de transformación | De que el programa avance de forma coherente con el modelo objetivo | La secuencia, las prioridades y qué decisiones suben al comité | Medir el avance del plan en lugar del avance del negocio |
| Responsables de unidades de negocio | De que su unidad funcione con el modelo futuro | Qué necesita realmente su negocio y qué es costumbre | Pedir que el sistema nuevo haga lo mismo que el viejo |
| Dueños de proceso de punta a punta | De que un recorrido completo funcione en todas las áreas que atraviesa | El diseño del proceso, sus excepciones y si está preparado para arrancar | No existir, de modo que las fronteras entre áreas no son de nadie |
| Responsable de tecnología | De que la plataforma funcione, sea segura y pueda evolucionar | La arquitectura y la integración con el resto de sistemas | Asumir decisiones de negocio porque nadie del negocio las toma |
| Oficina del programa | De la coordinación de alcance, coste, plazos, riesgos y dependencias | Cómo se informa y cómo se escalan los riesgos | Informar del semáforo sin dar las malas noticias a tiempo |
| Integrador y proveedores | De lo que construyen y de cómo lo construyen | Cómo se implementa técnicamente lo que la empresa ha decidido | Llenar con su criterio el vacío de decisión del cliente |
| Responsables de gestión del cambio | De que las personas sepan y quieran trabajar con el modelo nuevo | Cómo se prepara a cada colectivo y cuándo está listo | Llegar al final con un plan de comunicación y formación en pantallas |
Cómo evitar las responsabilidades difusas entre la empresa, el fabricante del software y el integrador
El intercambio público entre DHL, SAP y el integrador es el ejemplo de un problema que no depende de la mala fe de nadie, sino de cómo se estructura la relación. Cuando un programa falla, cada parte puede sostener con razón que hizo lo que le correspondía: el fabricante entregó un producto que funciona, el integrador construyó lo que se le pidió y la empresa pagó lo que se le facturó. La responsabilidad difusa no aparece después del fracaso: estaba en el contrato, en el gobierno y en las pruebas de aceptación desde el primer día.
Evitarla exige varias decisiones que conviene tomar antes de firmar. La primera es que la empresa conserve dentro capacidad suficiente para entender, evaluar y, si hace falta, rechazar lo que entregan sus proveedores. Un cliente que no puede juzgar técnicamente lo que recibe depende por completo del criterio de quien se lo entrega, y en un programa largo esa dependencia se convierte en que el integrador acaba tomando decisiones de negocio porque nadie más está en condiciones de tomarlas. La segunda es definir los criterios de aceptación en términos de negocio y no solo técnicos: un entregable no está terminado cuando cumple su especificación, sino cuando el proceso al que sirve funciona con él. La tercera es vincular, en la medida de lo posible, los pagos a hitos verificados por el negocio, de modo que el avance que se paga sea el que la empresa reconoce como avance. Y la cuarta es escribir quién responde de cada recorrido completo de negocio, de forma que cada frontera entre áreas y entre sistemas tenga un dueño en el cliente, aunque el trabajo lo hagan varios proveedores.
Ninguna de estas medidas elimina el riesgo, pero todas cambian quién lo ve y cuándo. El integrador puede certificar que el sistema funciona; solo la empresa puede certificar que su negocio funciona con él. Esa frase, aplicada en serio, habría cambiado el desenlace de al menos cuatro de los siete casos.
Los siete casos analizados permiten extraer una conclusión práctica: para evitar que una implantación ERP fracase, no basta con gestionar correctamente el proyecto tecnológico; hay que gobernar la transformación completa del negocio. Esto implica tomar una serie de decisiones en el momento adecuado, comprobar sus resultados con evidencias y mantener la capacidad de corregir o detener el programa cuando sea necesario.
Las siguientes doce acciones constituyen una guía aplicable a cualquier implantación ERP, independientemente del fabricante, el tamaño de la empresa o el sector. Recogen las principales lecciones de Lidl, Haribo, DHL, Asda, LeasePlan, Kingfisher y Revlon.
Cómo evitar las responsabilidades difusas entre la empresa, el fabricante del software y el integrador
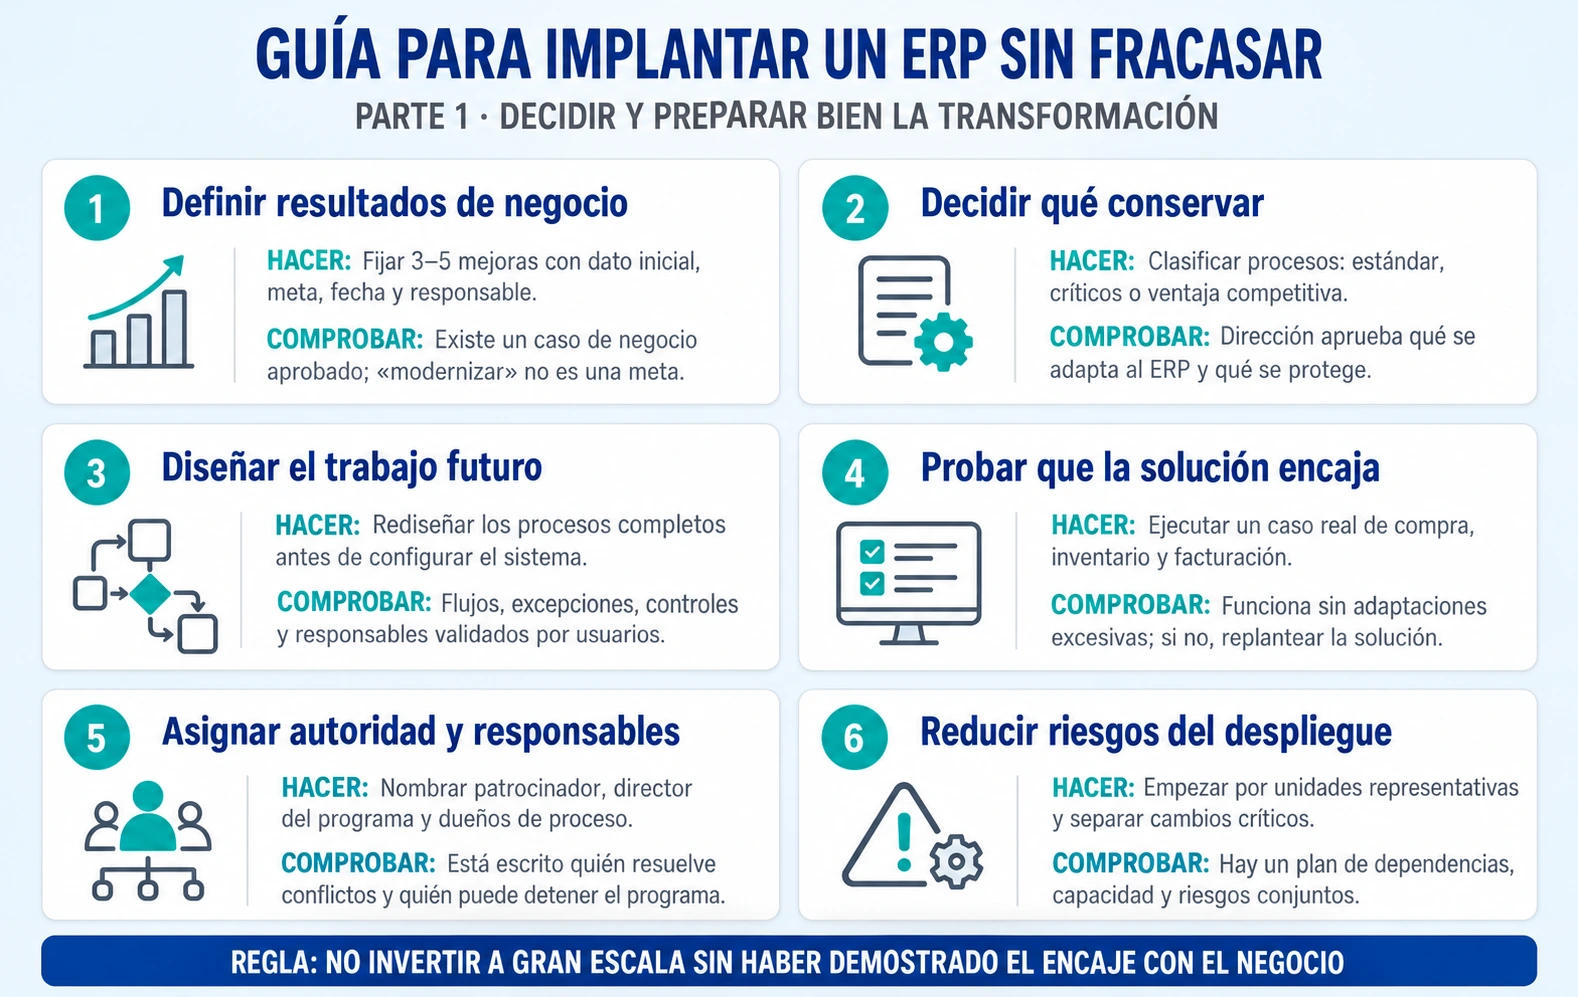
Antes de empezar: definir qué transformación necesita realmente la empresa
1. Definir objetivos de negocio concretos y medibles. Antes de seleccionar el ERP, establecer qué problemas se quieren resolver y qué beneficios se esperan: reducir los días de inventario, acelerar la facturación, mejorar la productividad o disminuir los errores. Modernizar la tecnología o unificar plataformas no son resultados suficientes. Cada beneficio debe tener un indicador, una situación de partida y un responsable.
2. Decidir qué procesos se estandarizan y cuáles deben protegerse. Identificar los procesos que constituyen una ventaja competitiva y distinguirlos de los que pueden adoptar las prácticas estándar del ERP. Por ejemplo, la gestión administrativa puede estandarizarse mientras se conserva un modelo de aprovisionamiento que proporciona una ventaja demostrable en costes. Lidl muestra el riesgo de adaptar excesivamente el software; Kingfisher, el riesgo contrario de uniformar aquello que diferenciaba a sus negocios.
3. Diseñar el modelo operativo futuro antes de configurar el sistema. Definir cómo funcionarán compras, producción, logística, ventas y finanzas; qué actividades se centralizarán, quién tomará las decisiones y cómo se coordinarán los departamentos. El punto de partida debe ser el proceso que la empresa necesita, no las pantallas del ERP ni una reproducción automática de las prácticas actuales. Primero se rediseña y simplifica el trabajo; después se digitaliza.
4. Demostrar el encaje de la solución antes de comprometer grandes inversiones. Realizar pruebas de concepto con datos reales y procesos críticos, especialmente aquellos que diferencian a la empresa. Por ejemplo, comprobar que una operación completa de compra, almacenamiento, reposición y cálculo de márgenes funciona correctamente antes de abordar un despliegue internacional. La lección de Lidl es clara: las incompatibilidades importantes deben descubrirse al principio, cuando todavía es posible cambiar de solución sin asumir costes desproporcionados.
Durante la implantación: organizar correctamente el programa y preparar la operación
5. Establecer un responsable ejecutivo único del resultado. Nombrar un patrocinador con autoridad real sobre las áreas afectadas, acompañado de un director de transformación y responsables de procesos de extremo a extremo. Si Finanzas y Operaciones discrepan sobre cómo debe funcionar el inventario, alguien debe tener capacidad para resolverlo. El integrador responde de construir correctamente la solución; la dirección de la empresa responde de que la transformación produzca resultados.
6. Reducir la complejidad y evitar cambios simultáneos innecesarios. Dividir la transformación en etapas manejables y evitar concentrar cambios de sistemas, procesos, proveedores, organización y modelo comercial en una misma fecha. Por ejemplo, migrar un ERP mientras se abre un nuevo almacén y se reorganiza la logística multiplica los riesgos. Asda, Haribo y Kingfisher muestran las dificultades de acumular demasiadas transformaciones al mismo tiempo. Los despliegues deben secuenciarse según el riesgo para el negocio, no únicamente según la comodidad del proyecto.
7. Depurar los datos y validar su utilidad operativa. Revisar datos maestros de productos, clientes, proveedores, inventarios y condiciones comerciales antes de migrarlos. No basta con que cien mil referencias se carguen sin errores informáticos: deben contener las unidades, precios, recetas y relaciones necesarias para operar. Haribo demuestra que un dato técnicamente válido puede provocar un problema industrial si no es correcto desde el punto de vista del negocio.
8. Probar procesos completos con operaciones y volúmenes reales. Las pruebas deben recorrer todos los sistemas y departamentos implicados. Por ejemplo, desde la recepción de un pedido hasta la comprobación del inventario, la preparación, la expedición, la entrega, la facturación y el cobro. También deben incluir devoluciones, excepciones y picos de demanda. Revlon y Asda muestran que la suma de módulos que funcionan correctamente no garantiza que el proceso empresarial completo funcione.
9. Preparar a las personas y preservar los controles internos. Incorporar desde el diseño a quienes ejecutarán los procesos, formarles mediante situaciones reales y comprobar que conocen cómo resolver incidencias y excepciones. También hay que revisar permisos, responsabilidades y controles financieros, y prever personal adicional durante la transición. Revlon evidencia que una organización insuficientemente preparada puede convertir un arranque tecnológico en una crisis operativa y de control.
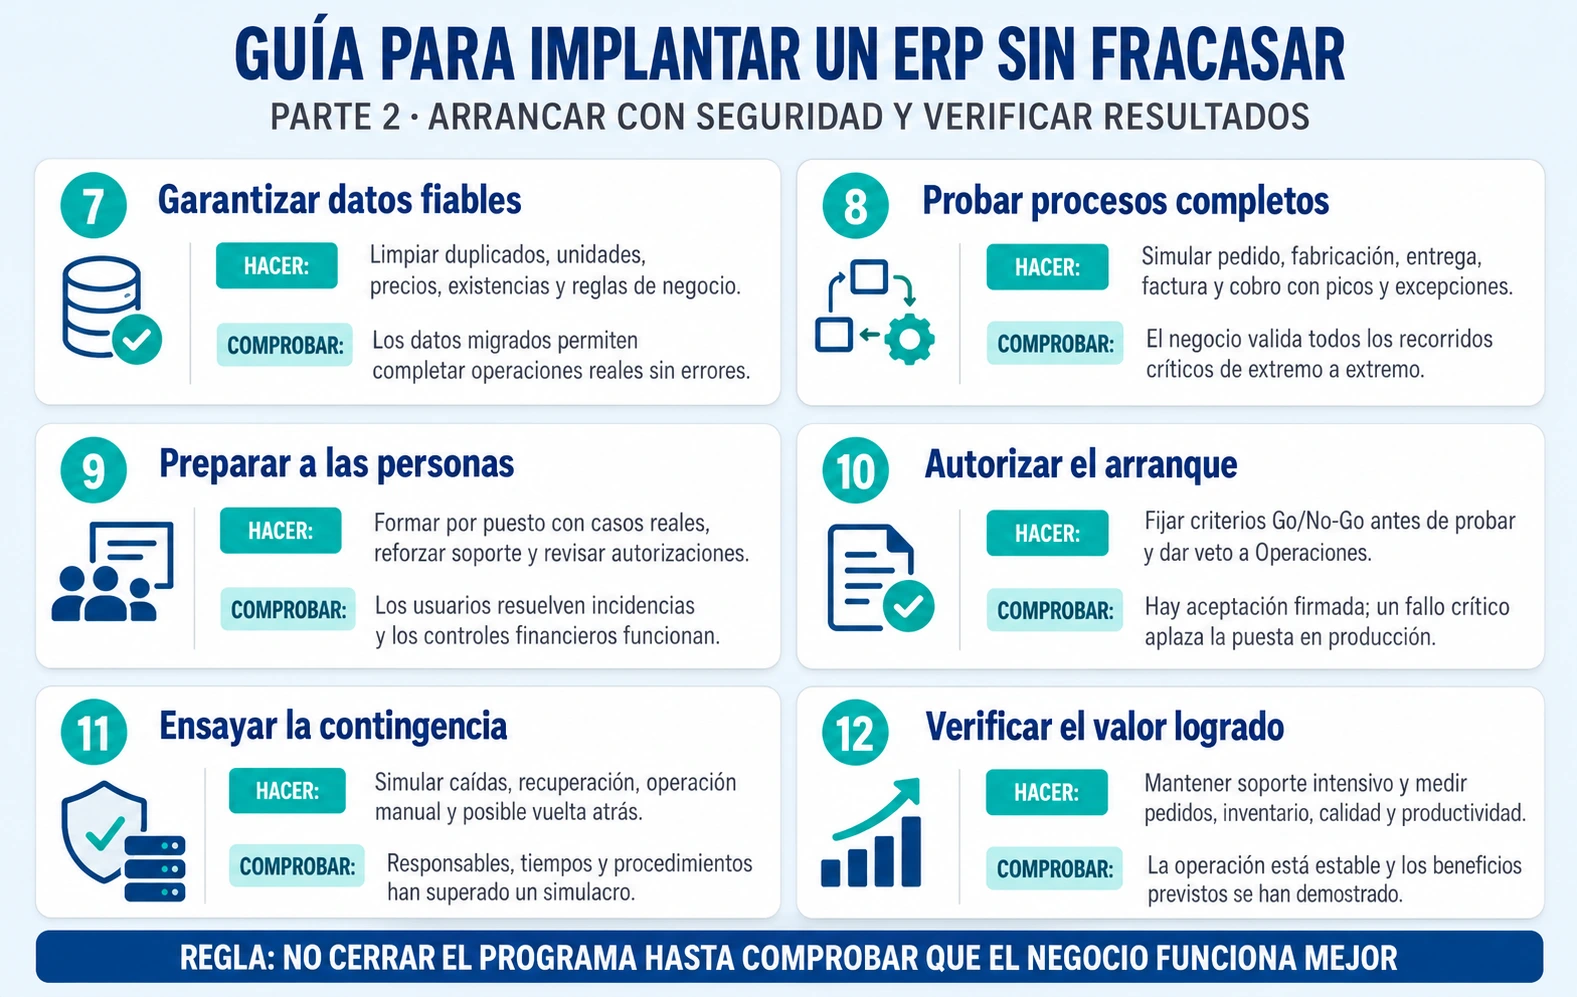
Antes del arranque: demostrar que el negocio puede seguir funcionando
10. Establecer una autorización formal de puesta en producción (Go/No-Go). Definir previamente qué pruebas deben estar superadas, qué incidencias resultan aceptables y qué indicadores deben alcanzar los niveles mínimos acordados. La decisión debe contar con la aprobación de los responsables de las operaciones afectadas, que deben poder bloquear el arranque si existen riesgos críticos. Una fecha comprometida no es una prueba de que la empresa esté preparada. Si no se cumplen los criterios, debe retrasarse el despliegue o reducirse su alcance.
11. Preparar y ensayar planes de contingencia y recuperación. Antes de cada despliegue hay que saber cómo mantener las operaciones si algo falla, qué alternativas manuales o temporales pueden utilizarse, quién coordina la recuperación y en qué condiciones se decide volver atrás. No basta con documentar estos planes: hay que comprobar que son ejecutables. La experiencia de Asda recuerda que cuanto menos reversible resulta una migración, mayores garantías deben exigirse antes de realizarla.
Después del arranque: estabilizar y comprobar que llegan los beneficios
12. Mantener la transformación abierta hasta conseguir los resultados esperados. Reservar recursos para la estabilización y supervisar indicadores operativos y comerciales: pedidos servidos correctamente, productividad, exactitud del inventario, tiempos de entrega, errores de facturación y satisfacción del cliente. Un ERP puede tener una disponibilidad técnica excelente mientras el porcentaje de pedidos entregados a tiempo se desploma. El proyecto no termina cuando se desconecta el sistema anterior, sino cuando el negocio funciona correctamente y se comprueba que obtiene las mejoras comprometidas.
Cinco puntos de control que la dirección no debería saltarse
Estas doce acciones deben traducirse en cinco decisiones formales de avance, basadas en evidencias verificables. No se trata de introducir burocracia adicional, sino de asegurar que ninguna fase importante se inicia sin resolver las condiciones de la anterior. Los trabajos pueden desarrollarse de forma iterativa o ágil; lo que debe mantenerse es la disciplina de decisión.
| Momento de decisión | Qué debe demostrarse | Responsable de aprobar |
| 1. Antes de elegir el ERP | Objetivos cuantificados, modelo operativo futuro y procesos diferenciales identificados. | Comité ejecutivo |
| 2. Antes de comprometer la implantación | Solución validada en procesos críticos, caso de negocio viable, responsabilidades y riesgos definidos. | Patrocinador y CIO |
| 3. Antes de iniciar los despliegues | Procesos rediseñados, datos preparados, pruebas integrales y usuarios formados. | Dueños de proceso y Operaciones |
| 4. Antes de cada puesta en producción | Pruebas superadas, contingencia ensayada y riesgos residuales aceptados expresamente. | Dirección operativa y patrocinador |
| 5. Antes de cerrar el programa | Operación estabilizada y beneficios empresariales contrastados con los objetivos iniciales. | Comité ejecutivo |
Además, durante todo el programa debe revisarse periódicamente si la inversión sigue teniendo sentido. El avance del calendario no demuestra que el proyecto siga siendo viable. LeasePlan y Lidl muestran la importancia de replantear una transformación cuando la estrategia, los costes o las dificultades técnicas hacen que desaparezca su justificación original.
Tres reglas que resumen todas las lecciones
Primera: no aprobar lo que no se haya demostrado. Los informes de progreso, las presentaciones del proveedor y las funcionalidades entregadas no sustituyen las pruebas reales de funcionamiento del negocio.
Segunda: no continuar solamente porque ya se ha invertido mucho. Una pregunta que debería repetirse periódicamente en el comité de dirección es: ¿aprobaríamos hoy este proyecto, con su coste, alcance y riesgos actuales, si todavía no hubiéramos invertido nada? Si la respuesta es negativa, hay que reconsiderarlo.
Tercera: no declarar el éxito hasta que el negocio funcione mejor. Cumplir las fechas, respetar el presupuesto y entregar las funcionalidades comprometidas es importante, pero no suficiente. El éxito debe demostrarse mediante mejoras operativas y económicas verificables, sin deteriorar las capacidades que hacen competitiva a la empresa.
En definitiva, una implantación ERP debe dirigirse como una inversión en la transformación del negocio, con objetivos medibles, decisiones explícitas, pruebas operativas y criterios para avanzar, corregir o detenerse. Es una disciplina que no elimina todos los riesgos, pero permite identificarlos antes, limitar su impacto y evitar que un proyecto tecnológicamente exitoso termine convirtiéndose en un fracaso empresarial.
Diez preguntas que un comité de dirección debe hacer antes de autorizar la puesta en producción de un ERP
Todo lo anterior se puede condensar en diez preguntas que un comité de dirección debería hacer, y exigir que se respondan con evidencia, antes de autorizar un arranque importante o la continuación de un programa largo. Cada una sale de uno de los siete casos, y cada una habría obligado a una conversación que, en ese caso, no se tuvo a tiempo. Si alguna respuesta es «no lo sabemos», todavía no es el momento.
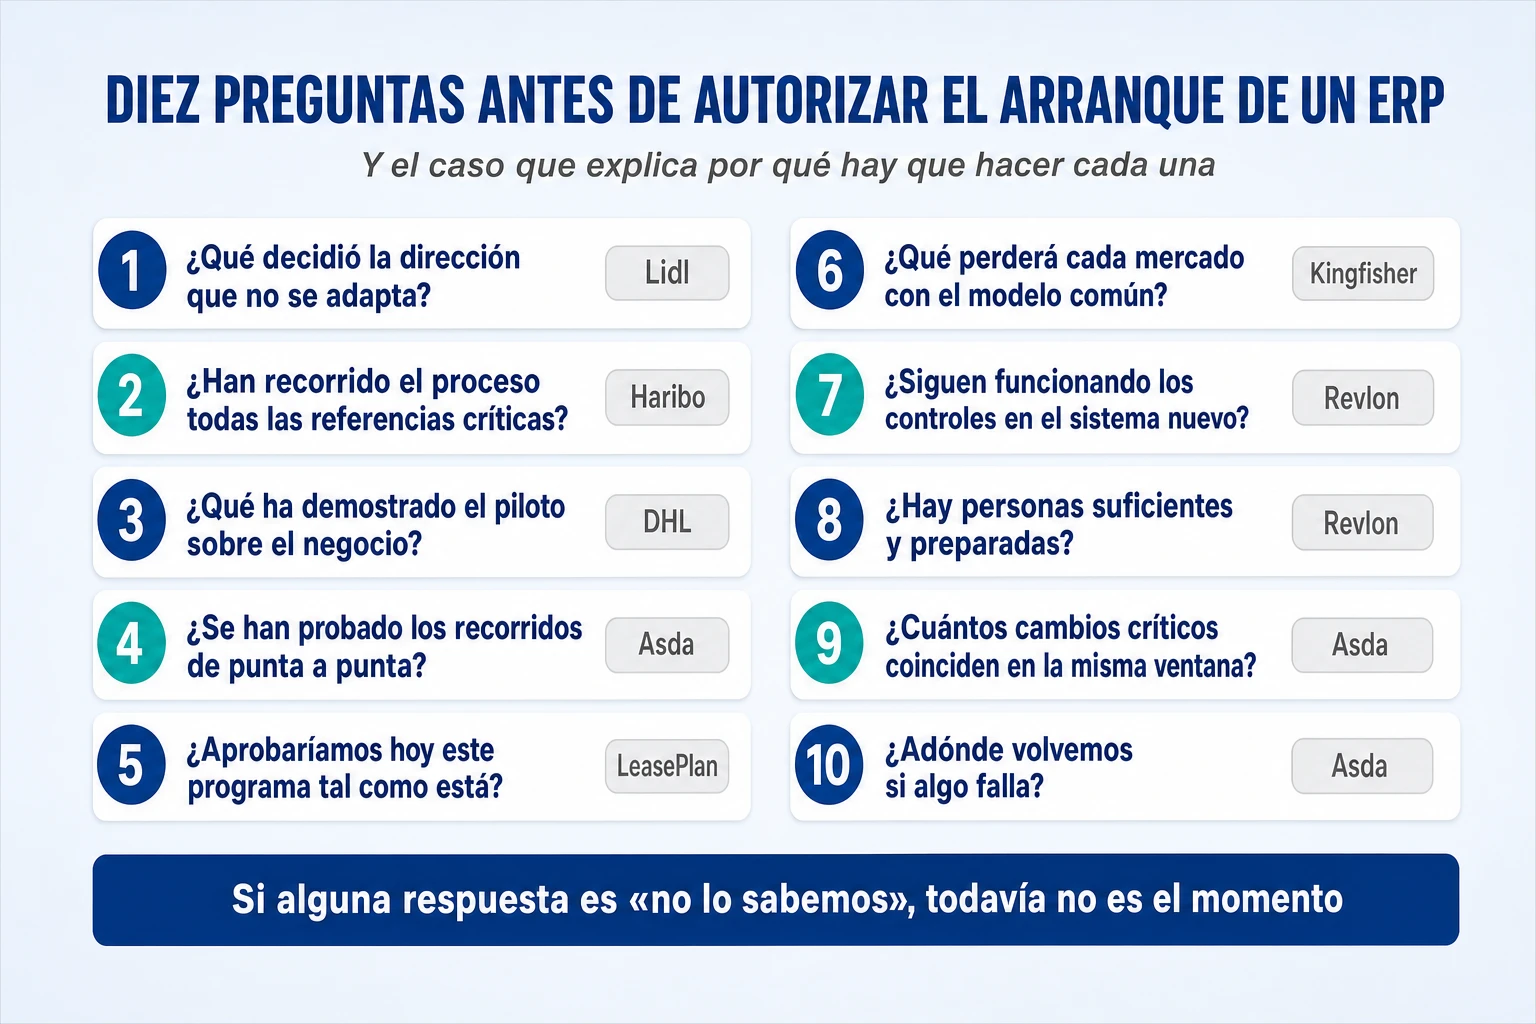
¿Qué ha decidido la dirección que no se adapta, y qué ha decidido que sí? Es la pregunta de Lidl. Si la lista de procesos diferenciales protegidos no existe por escrito, cada petición de adaptación se resuelve sola y el programa deriva hacia la reproducción del sistema antiguo.
¿Han recorrido el proceso completo, en el sistema nuevo y con sus datos reales, todas las referencias, clientes o expedientes críticos? Es la pregunta de Haribo. Una carga de datos sin errores técnicos no demuestra que el negocio pueda operar con ellos.
¿Qué ha demostrado el piloto sobre el negocio, y no solo sobre el sistema? Es la pregunta de DHL. Si el piloto se eligió por ser manejable y mide si el sistema funciona, no ha demostrado nada sobre la red completa.
¿Se han probado los recorridos de punta a punta con el volumen de un día fuerte? Es la primera pregunta de Asda. Ninguna prueba de un solo sistema demuestra que funciona un recorrido que atraviesa varios.
¿Aprobaríamos hoy este programa tal como está, con lo que sabemos ahora sobre nuestra estrategia? Es la pregunta de LeasePlan. Si la respuesta es no, lo ya invertido no es una razón para seguir.
¿Qué perderá cada mercado, enseña o unidad de negocio con el modelo común, y lo han validado sus responsables? Es la pregunta de Kingfisher. La eficiencia del grupo no puede pagarse con la propuesta de valor de los negocios que la generan.
¿Siguen funcionando en el sistema nuevo todos los controles que funcionaban en el anterior? Es la primera pregunta de Revlon. Si no se ha comprobado, la empresa puede descubrir después del arranque que no controla su propia información financiera.
¿Hay personas suficientes y preparadas para operar, controlar y corregir durante la transición? Es la segunda pregunta de Revlon. Una transición necesita más personas que la operación normal, no menos.
¿Cuántos cambios críticos coinciden en la misma ventana, y qué pasa si fallan a la vez? Es la segunda pregunta de Asda, y también de Haribo y de Kingfisher. Cuando varias cosas fallan juntas, es casi imposible saber cuál ha fallado.
¿Adónde volvemos si algo falla, y quién decide volver? Es la última pregunta de Asda y la que resume todas las demás. Si no hay respuesta, el arranque no es una decisión de gestión del riesgo, sino una apuesta.
Conclusión: la lección de los siete fracasos de ERP es someter la tecnología a pruebas de viabilidad del negocio
El patrón común de los siete casos no es haber elegido un ERP equivocado. Es haber tomado decisiones de transformación sin disponer de evidencias suficientes sobre su viabilidad empresarial. En Lidl, la dirección acabó reconociendo que no podía adaptar razonablemente una solución a su modelo, después de siete años sin decidir cuál de los dos debía ceder. En LeasePlan, el problema fue una arquitectura que dejó de servir a la estrategia mientras se construía. En Kingfisher, la centralización amenazó los rasgos comerciales que diferenciaban a sus marcas. Haribo demostró que un dato maestro puede convertirse en un problema industrial. Revlon, las consecuencias de arrancar sin la preparación ni los controles suficientes. DHL, la complejidad de integrar operaciones internacionales y el valor de detenerse en la fase piloto. Y Asda, quizá el ejemplo más actual, recuerda que una transformación tecnológica puede terminarse formalmente mientras sus consecuencias comerciales siguen agravándose.
Ninguna de esas lecciones trata del software. Todas tratan de decisiones que correspondían a la dirección: qué se protege y qué se estandariza, quién responde del resultado, cuánto riesgo se acumula, cuándo se arranca y con qué evidencia, y cuándo se reconoce que un programa ha dejado de tener sentido. Y todas tienen algo en común con lo que el blog ha analizado en los errores que hacen caer a una empresa: rara vez se trata de un golpe de mala suerte, y casi siempre de señales que estaban a la vista y que nadie con autoridad quiso o pudo leer a tiempo.
La lección más importante para un directivo no es aprender los nombres de los ERP ni de las consultoras que participaron en estos casos. Es entender que la tecnología debe someterse a pruebas de viabilidad del negocio, y no al revés. Porque los proyectos no se recuperan con una presentación que explica que la implantación se ha completado al cien por cien. Se recuperan cuando las fábricas producen, los almacenes abastecen, los clientes reciben sus pedidos y las cuentas reflejan los beneficios que se prometieron.
Si hubiera que llevar este artículo a una reunión de comité en un solo párrafo, sería este:
Implantar un ERP no es instalar una herramienta, es cambiar cómo la empresa compra, fabrica, vende, factura y decide. Por eso las decisiones que lo hacen fracasar no son técnicas, sino de dirección: qué procesos se protegen porque nos diferencian y cuáles adoptan el estándar, quién del negocio responde del resultado, cuántos cambios hacemos a la vez, qué evidencia exigimos antes de arrancar y qué tendría que ocurrir para que paráramos. Lidl, DHL y LeasePlan perdieron cientos de millones por no resolver a tiempo si lo que construían seguía teniendo sentido. Haribo, Asda y Revlon dejaron de servir a sus clientes por arrancar antes de que la operación estuviera preparada. Kingfisher debilitó su negocio en Francia por uniformar lo que debía seguir siendo distinto. La regla es una: el calendario no autoriza nada; lo autoriza la evidencia de que el negocio seguirá funcionando, firmada por quien va a operarlo.