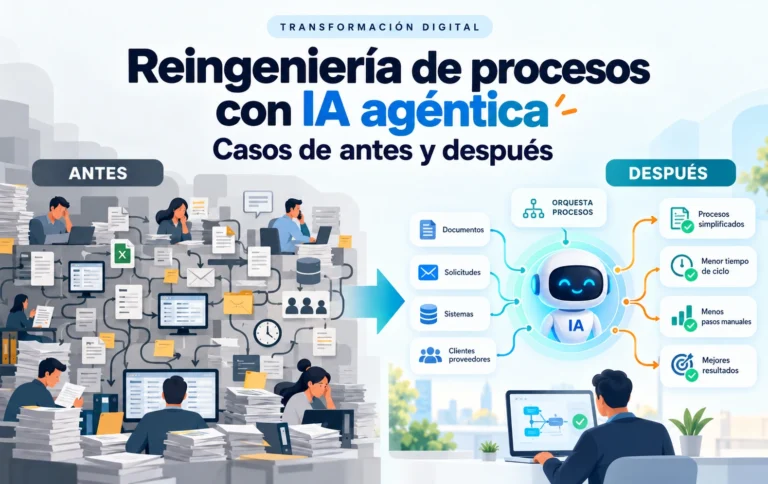
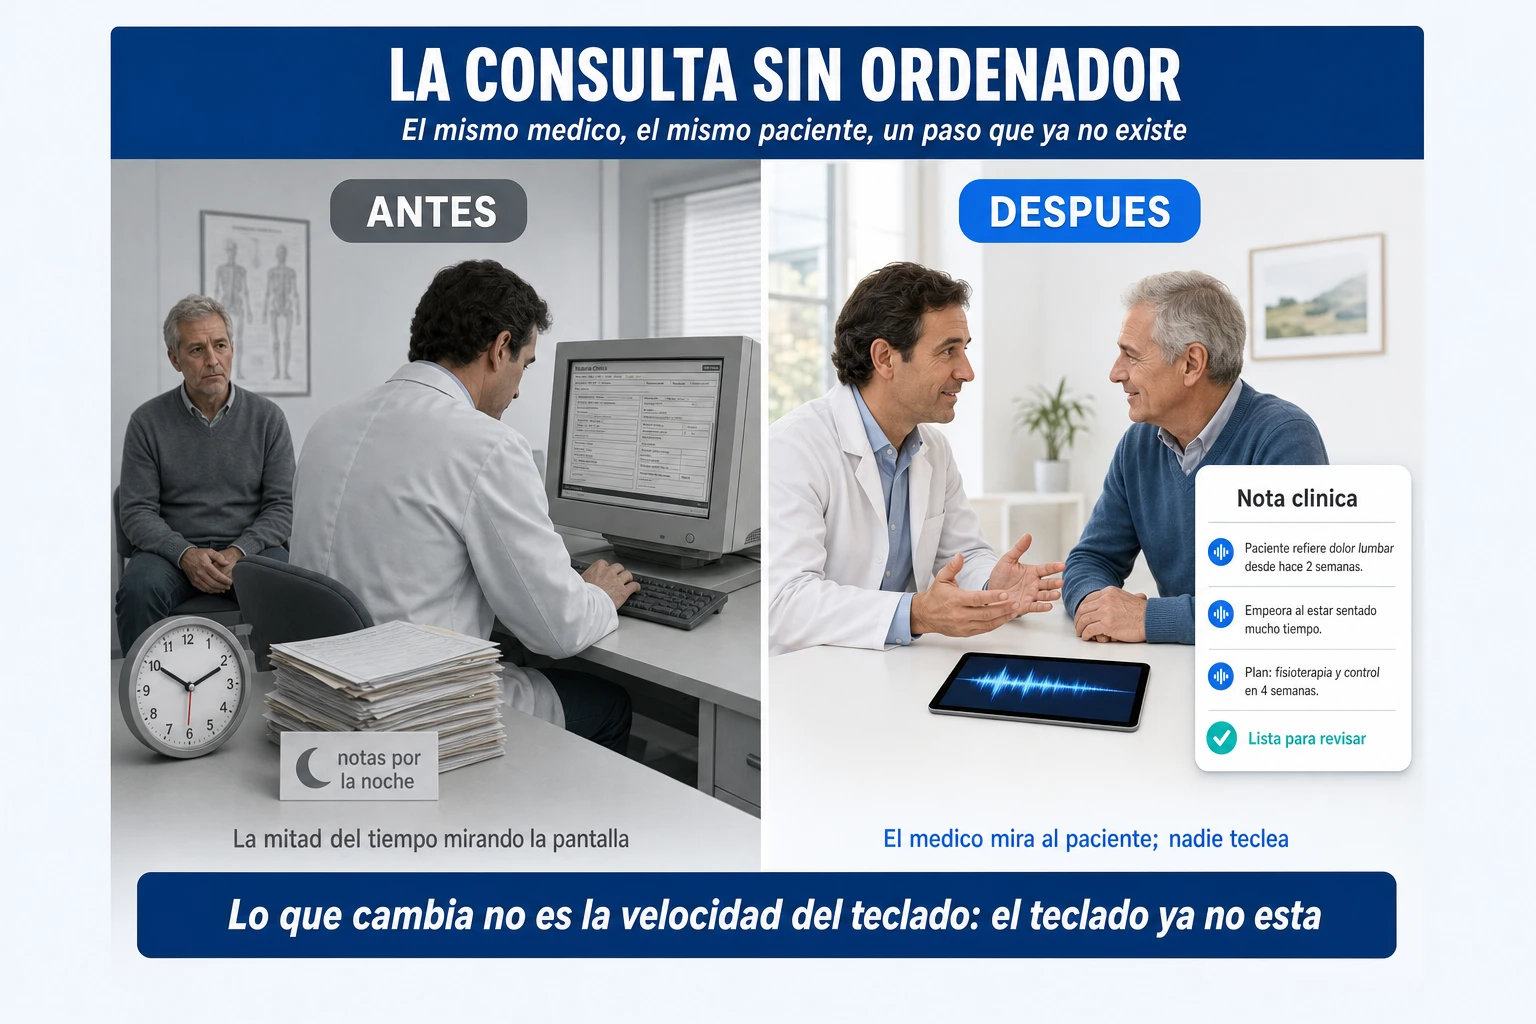
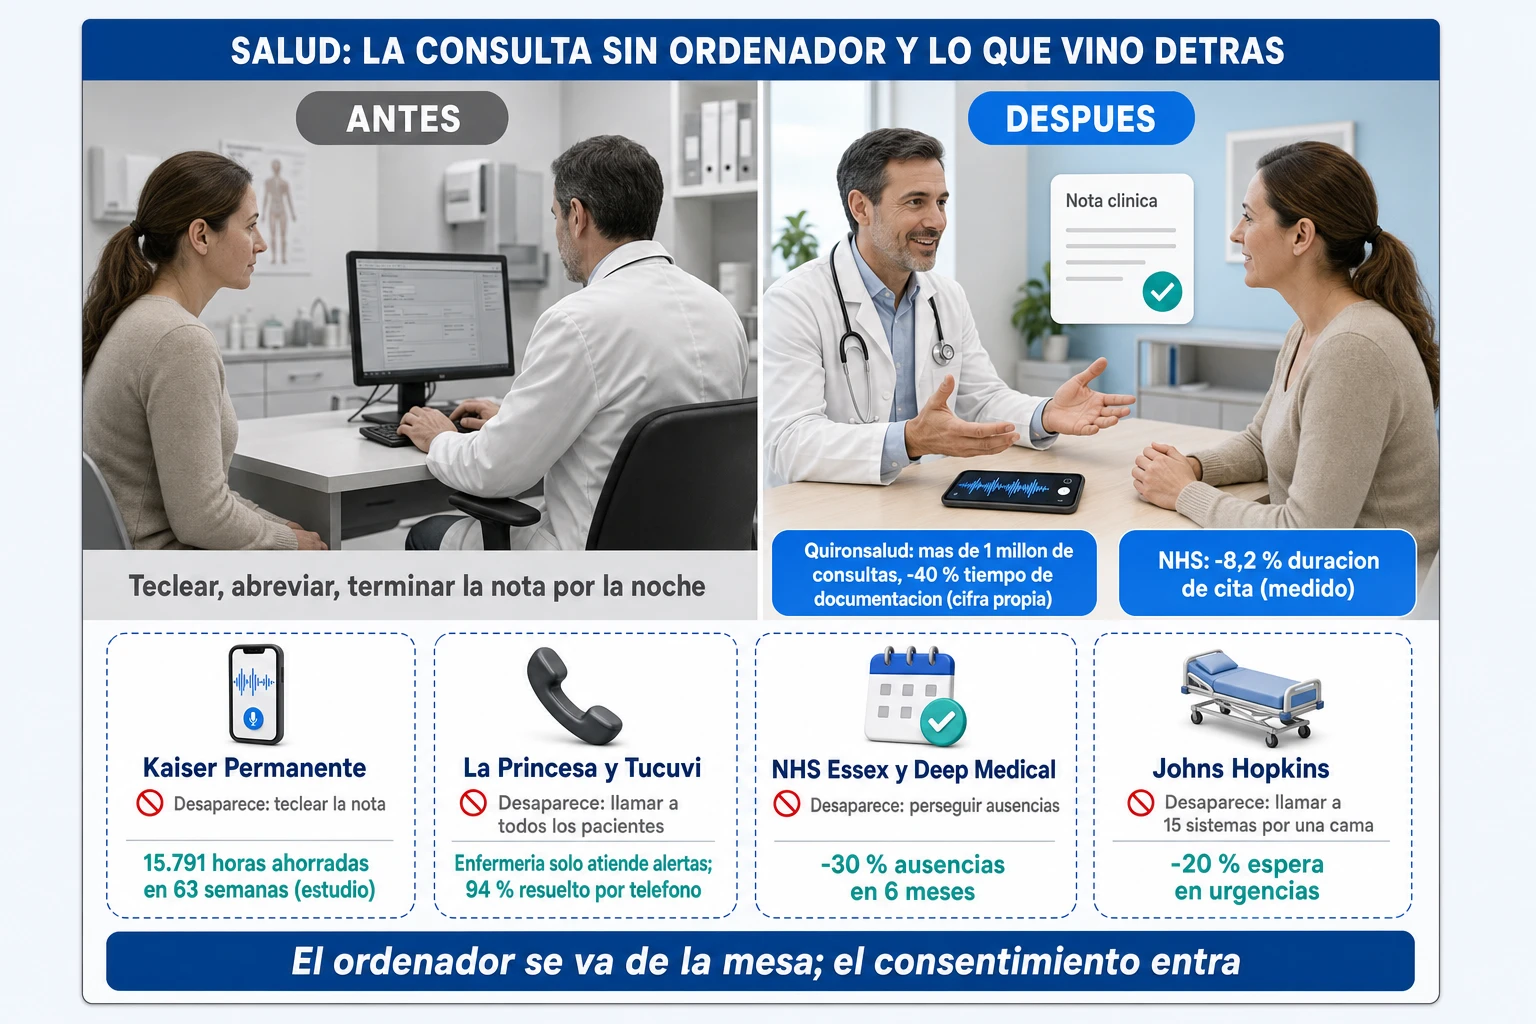
La consulta de antes tenía tres participantes: el paciente, el médico y un monitor. El médico saludaba, se giraba un cuarto de vuelta hacia la pantalla y empezaba a teclear mientras preguntaba. La mitad del tiempo miraba el historial; la otra mitad, al paciente de reojo. Al terminar la agenda quedaban las notas a medio escribir, con abreviaturas que solo él entendía, y se acababan por la noche, en casa, en la hora que los médicos estadounidenses llaman con resignación pajama time. Quirónsalud describía ese escenario con dos frases exactas: «dispositivos tecnológicos que diluyen la atención» y «la necesidad de teclear durante la consulta».
La consulta de ahora tiene los mismos tres participantes, pero el monitor ha cambiado de sitio. El médico revisa el historial antes de que entre el paciente. Cuando entra, pide permiso, activa la grabación en su teléfono de trabajo y lo deja sobre la mesa. Durante veinte minutos no teclea: pregunta, escucha, explora, explica. Al despedirse, la nota clínica ya existe: redactada, estructurada, sin abreviaturas, codificada, con las pruebas y prescripciones propuestas. Él la lee, corrige lo que haga falta y la valida. El audio se borra en unas horas. El paciente sale con su informe.
Lo que ha cambiado no es la velocidad del teclado. Es que el teclado ya no está entre el médico y el paciente. El paso «documentar la consulta» ha dejado de ser un trabajo que hace el médico y se ha convertido en un subproducto de la conversación que el médico solo revisa. Ese es el criterio que ordena todo lo que sigue: un proceso se ha reimaginado cuando alguien puede señalar el paso que ya no existe y la pantalla que ya no está.
La idea no es nueva. En 1990, Michael Hammer publicó en Harvard Business Review un artículo cuyo título sigue siendo el mejor resumen de este debate: «Don’t Automate, Obliterate». Contaba cómo Ford había reducido un 75 % su departamento de cuentas por pagar no comprando un sistema para cotejar facturas más deprisa, sino pidiendo a los proveedores que dejaran de enviar facturas. El paso desapareció. A la alternativa —usar la tecnología para hacer lo mismo un poco más rápido— la llamó «pavimentar el camino de vacas». Treinta y cinco años después, la mayoría de las empresas siguen pavimentando.
Lo que sí es nuevo es que, por primera vez, existe un ejecutor capaz de leer, entender y escribir en los sistemas sin que el trabajo esté estructurado de antemano. Eso es lo que Hammer no tenía, y lo que hace que su idea vuelva con fuerza. De ahí la tesis.
La IA agéntica no acelera el proceso: hace desaparecer partes de él. Lo que cambia en los casos que funcionan no es cuánto tarda cada paso, sino qué pasos existen y quién los hace.
Para sostenerla hacen falta casos, muchos, con su cifra, su fecha y quién la mide. El catálogo que sigue reúne más de cuarenta procesos rediseñados en seis bloques —salud, banca y seguros, industria y logística, atención al cliente y personas, TI y software, trabajo de conocimiento— con la misma plantilla: qué había antes, qué hay ahora, qué trabajo ha desaparecido, qué resultado se ha medido y con qué nivel de autonomía. Cada cifra lleva su etiqueta de origen, porque en este tema las cifras de proveedor y las de los ensayos independientes están a un orden de magnitud.
Y dos advertencias que el catálogo confirma una y otra vez. Casi todo lo que funciona está en el nivel 2 o 3 de la escala de autonomía, no en el 4 o el 5: el sistema prepara o ejecuta, y la persona decide o audita. Y todo lo que se revirtió —Klarna, Commonwealth Bank, McDonald’s, Zillow— cometió el mismo error: quitar a la persona antes de haber rediseñado el proceso. Exactamente lo que hundió a la reingeniería en 1993.
Pavimentar el camino de vacas: por qué la automatización incremental se quedó en el 10-20 %
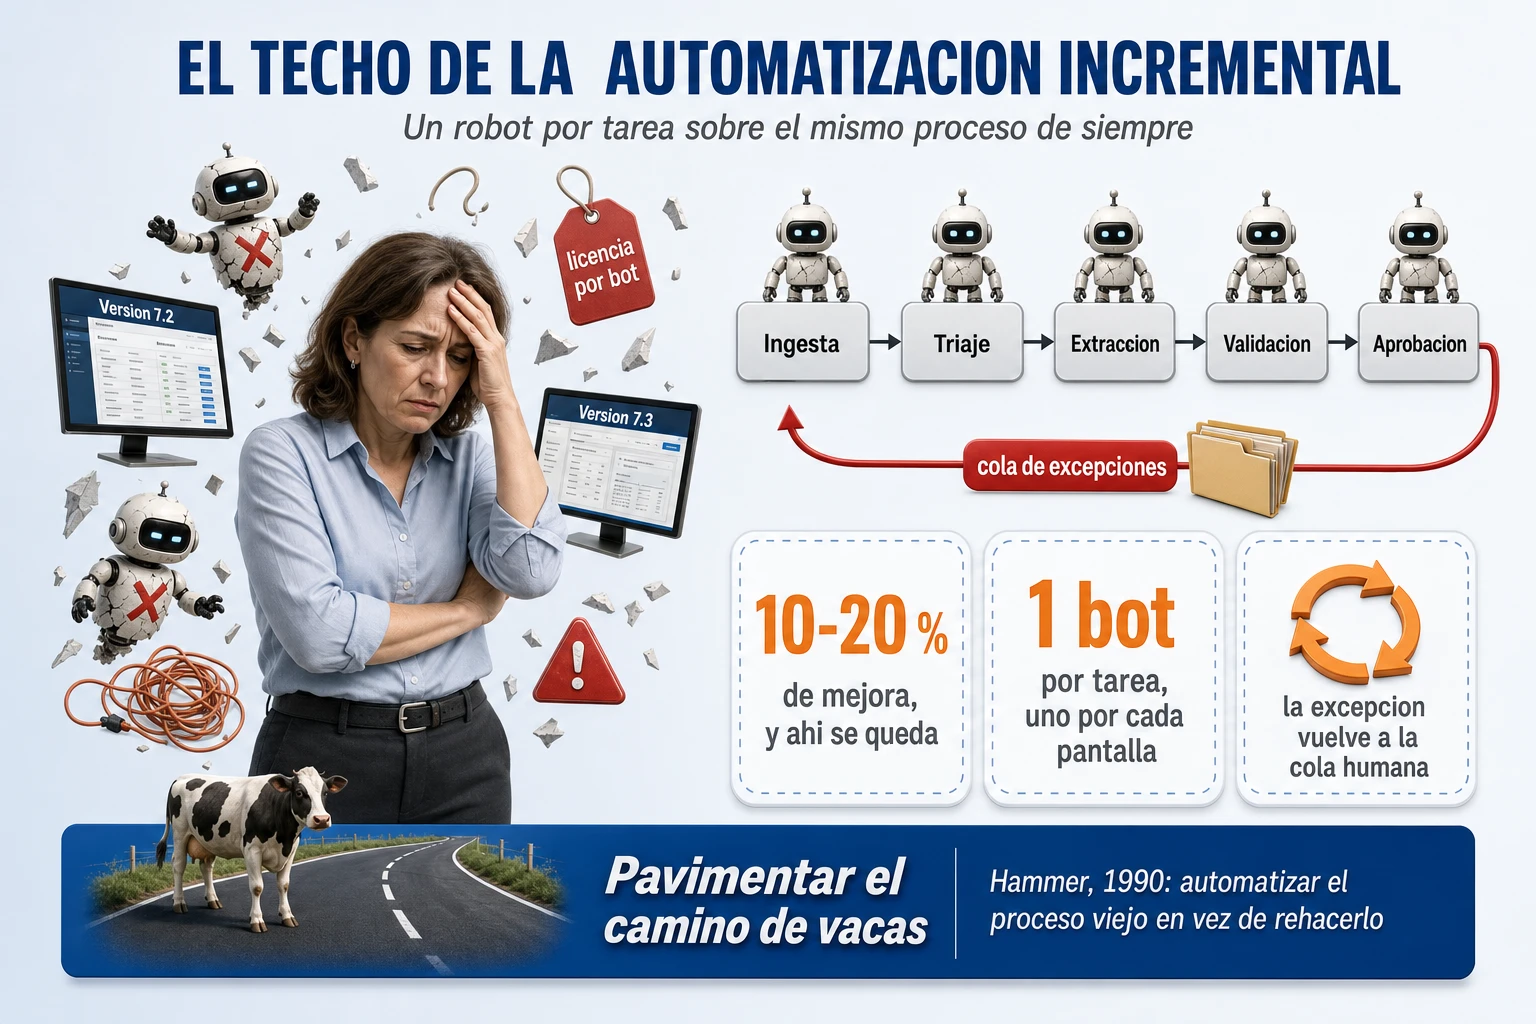
Durante quince años, la respuesta estándar a «este proceso es lento» ha sido poner un robot de software en cada paso. La factura llega, un bot la lee; el dato se extrae, otro bot lo pega en el ERP; la aprobación se pide, un flujo la enruta; la excepción salta, y vuelve a la bandeja de una persona. El proceso es el mismo, con las mismas pantallas y el mismo orden; solo que ahora cada pantalla la maneja un bot. Es la definición literal de pavimentar el camino de vacas, y ha producido lo que cabía esperar: mejoras reales, modestas y frágiles.
Lo que hizo la primera ola y por qué se agotó
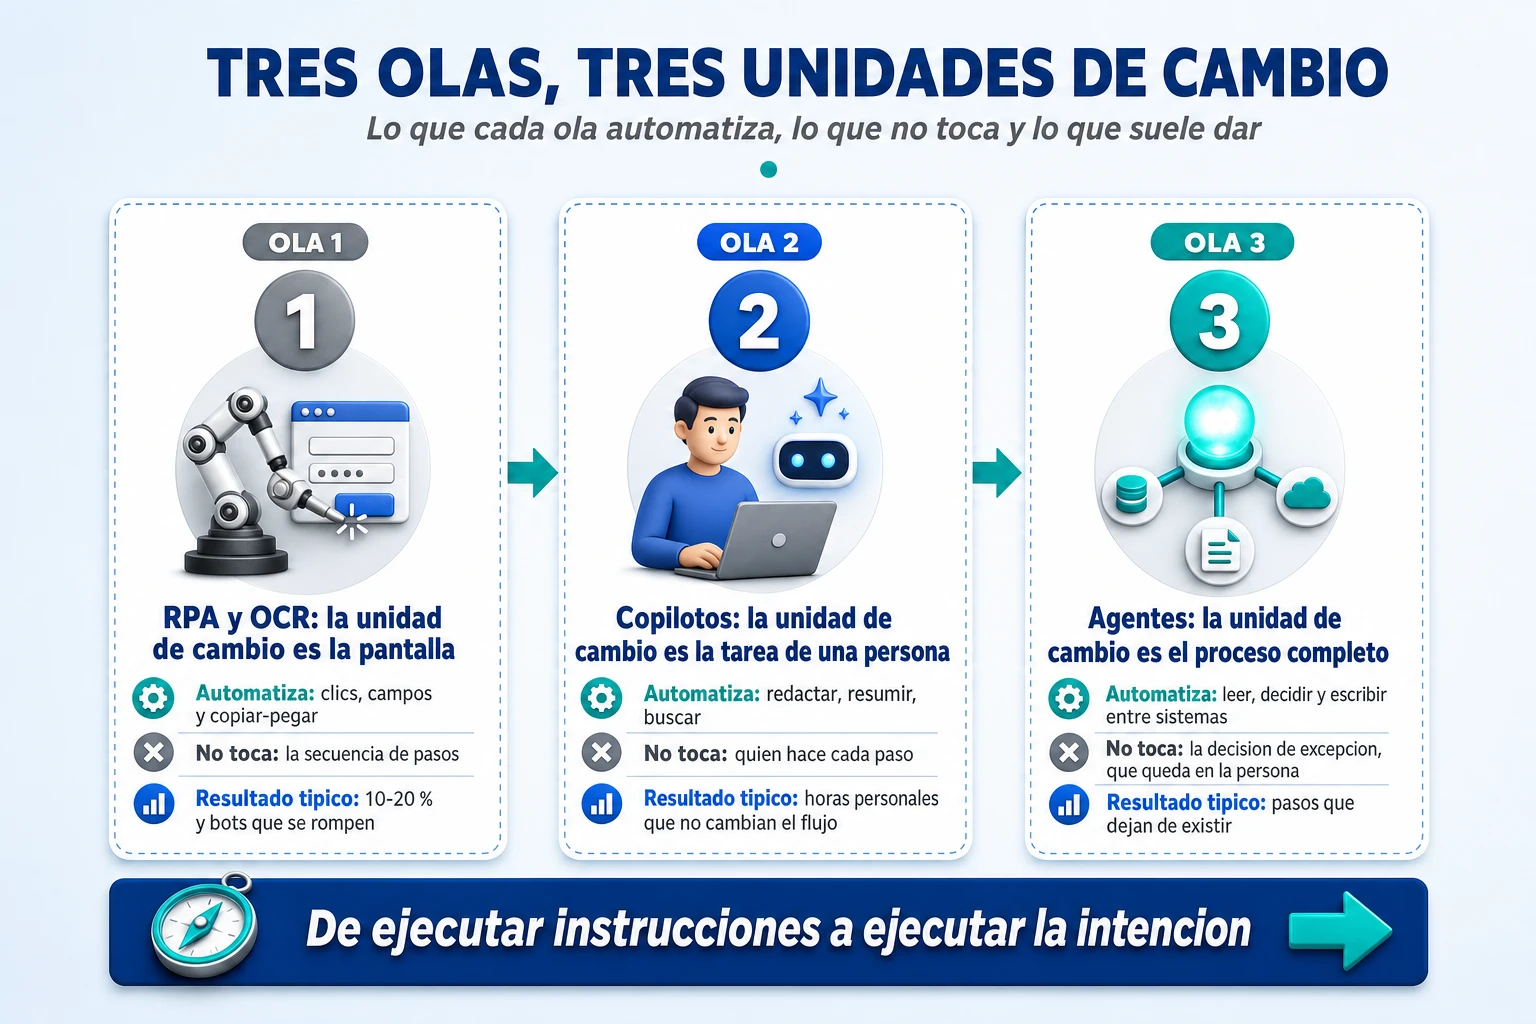
La primera ola tuvo cuatro herramientas. El RPA grababa los clics de una persona y los repetía: útil mientras la pantalla no cambiase, porque el bot localiza los campos por posición y cualquier actualización los mueve. El OCR leía formularios, siempre que el formulario fuera el previsto. El BPM orquestaba pasos, lo que presupone que los pasos siguen existiendo. Y los copilotos aceleraron a la persona delante de su pantalla sin tocar la pantalla ni el proceso. Las cuatro automatizan la secuencia que había; ninguna la sustituye.
Las cifras son las que son. BCG, en un documento de junio de 2026 sobre sus propios clientes (cifra de consultora, sin contraste independiente), sitúa la mejora de productividad «con copilotos y bots aislados» entre el 10 y el 20 %.
EY estimaba hacia 2016 que entre el 30 y el 50 % de los primeros proyectos de RPA fracasaban, y una encuesta de Deloitte de 2017 encontró que solo el 3 % de las organizaciones había escalado a cincuenta robots o más; las dos son cifras de las propias consultoras. El mercado de RPA facturó 3.600 millones de dólares en 2024, y Gartner atribuye su desaceleración a la IA generativa y a la automatización agéntica. No es que el RPA no funcionara: se agotó donde se agotan todas las herramientas que dejan intacto el proceso.
El síntoma más claro es la excepción. Un bot procesa lo que se parece a lo previsto; lo demás vuelve a la cola humana. Si el 20 % de los expedientes son excepciones, el 20 % del trabajo sigue siendo humano, y ahora todo es trabajo difícil. Y el mantenimiento se come el retorno: cada versión nueva rompe selectores, cada bot lleva su licencia, y en cinco años la organización tiene una flota de automatizaciones que nadie se atreve a apagar. En el mercado circula un nombre para esto, «deuda de automatización», sin autor conocido pero exacto.
La trampa de la tarea: acelerar un paso no acelera el proceso
Hay una razón aritmética por la que acelerar pasos rinde tan poco, y Hammer la dio en 1990 con una aseguradora: «una solicitud pasaba 22 días en proceso y se trabajaba en ella 17 minutos». Diecisiete minutos sobre veintidós días es un 0,16 % del tiempo. Si se automatiza el trabajo real y se reduce a la mitad, el plazo baja de 22 días a 22 días menos ocho minutos.
El tiempo no está en los pasos: está en las esperas, en las bandejas, en los traspasos entre departamentos. Lean lo formalizó una década después con el value stream mapping, y cualquier mapa de un proceso de oficina no rediseñado muestra lo mismo: el tiempo de valor añadido es una fracción minúscula del plazo.
En el artículo sobre cómo organizar una transformación con agentes lo llamábamos la trampa de la tarea: elegir los casos de uso por la tarea que se automatiza en lugar de por el resultado que se persigue. Los scribes clínicos son el ejemplo perfecto: el ensayo aleatorizado más riguroso que existe midió que ahorran entre 23 y 41 segundos por nota. Si el objetivo fuera «documentar más rápido», sería un fracaso. El objetivo era que el médico mire al paciente y que la nota no se termine por la noche. Y eso sí cambió.
Lo que cambia con un ejecutor que lee, entiende y escribe
La segunda ola cambia la unidad de cambio. El RPA operaba sobre la pantalla; el copiloto, sobre la tarea de una persona; el agente opera sobre el proceso completo, de la entrada a la salida. Y cambia el tipo de instrucción: al bot se le decía qué clics dar; al agente se le dice qué resultado se quiere y con qué límites, y él decide en cada expediente qué hace falta leer, cotejar, pedir o escribir. De la instrucción a la intención.
Eso hace tratable lo que la primera ola dejaba fuera: el messy middle. Un correo de un corredor con tres adjuntos en dos idiomas, una foto de un congelador con la comida estropeada, un contrato de crédito de ochenta páginas, un ticket escrito con prisa. Antes, todo eso exigía una persona que lo leyera y lo tecleara; ahora lo lee un modelo que entiende lo suficiente para estructurarlo y escribirlo donde corresponde. Allianz Australia puso siete agentes en fila para tramitar un siniestro de alimentos estropeados; Toyota tiene agentes que redactan de madrugada los correos al transportista. En ninguno de los dos casos se aceleró un paso: desaparecieron varios.
Conviene no exagerar la novedad. Lo que el modelo aporta es la lectura y la escritura de lo no estructurado; la decisión sobre qué hacer con ello, en casi todos los casos que funcionan, sigue siendo de una persona, o está acotada por importe, por tipo de caso o por radio de acción. La regla que resume el catálogo es lectura amplia, escritura estrecha: el agente lee todo lo que le pongan delante y escribe solo donde y con los límites que se le han dado. Cuando esa regla se rompe, aparece la lista de los que se revirtieron.
| Dimensión | Automatización de tareas (RPA, OCR, BPM, copilotos) | Rediseño del proceso con un ejecutor agéntico |
| Unidad de cambio | La pantalla o la tarea de una persona | El proceso completo, de la entrada al resultado |
| Instrucción | Qué clics dar y en qué orden | Qué resultado se quiere y con qué límites |
| Rol humano | El mismo, algo más rápido; sigue delante de la pantalla | Cambia de sitio: decide sobre la excepción y audita |
| Excepciones | Vuelven a la cola humana; son todo el trabajo que queda | Se diseñan: umbral, tipo de caso y responsable definidos de antemano |
| Integración | Selectores de pantalla que se rompen con cada versión | Lectura de documentos y sistemas; escritura acotada por API o por permiso |
| Métrica típica | Horas ahorradas, bots desplegados | Tasa de straight-through, toques humanos por resultado, tasa de excepción |
| Resultado típico | 10-20 % de mejora (BCG, sobre sus clientes) y mantenimiento creciente | Pasos que desaparecen; el plazo se mide en horas donde se medía en días |
La idea tiene 35 años: Ford, Mutual Benefit Life e IBM Credit
El artículo de Hammer en Harvard Business Review de julio-agosto de 1990 empieza con un diagnóstico que podría firmarse hoy: «las fuertes inversiones en tecnología de la información han dado resultados decepcionantes, en gran medida porque las empresas tienden a usar la tecnología para mecanizar viejas formas de hacer negocios. Dejan intactos los procesos existentes y usan los ordenadores simplemente para acelerarlos».
Y a continuación la frase que le hizo famoso: «Es hora de dejar de pavimentar los caminos de vacas. En lugar de incrustar procesos obsoletos en silicio y software, deberíamos obliterarlos y empezar de nuevo». Sus tres casos siguen siendo los mejores ejemplos de proceso reimaginado que existen, y por eso van con la misma plantilla que los de 2026.
Ford: cuentas por pagar sin facturas (años ochenta)
Antes. Más de 500 personas en cuentas por pagar de Norteamérica. Compras enviaba copia del pedido; recepción, copia del albarán; el proveedor, la factura. El departamento cotejaba catorce datos entre los tres documentos y «pasaba la mayor parte de su tiempo con las discrepancias». El plan era el de siempre: rediseñar un poco, poner ordenadores y bajar a 400 personas. Hasta que alguien miró a Mazda, participada por Ford, y vio que lo hacía con cinco.
Después. Invoiceless processing: compras registra el pedido en una base de datos; cuando llega la mercancía, recepción comprueba si corresponde a un pedido y, si sí, la acepta; el sistema coteja tres datos —número de pieza, unidad de medida, código de proveedor— y prepara el pago. Y Ford pidió a sus proveedores que dejaran de enviar facturas.
Lo que desapareció. Conciliar y verificar catorce datos entre tres documentos, y el documento mismo. La pantalla que ya no está es la del administrativo cotejando; el control se trasladó al muelle, donde está la información.
Resultado: «una reducción del 75 % de la plantilla, no el 20 % que habría conseguido con un programa convencional» (cifra de Hammer, consultor de Ford en el proyecto, 1990; medida en personas, no en plazo).
Nivel de autonomía: 4, Ejecuta salvo excepción: el sistema paga; la persona interviene cuando recepción no encuentra el pedido. Límite: Hammer era parte interesada, y el texto indica que en 1990 el proceso no estaba desplegado en toda la empresa.
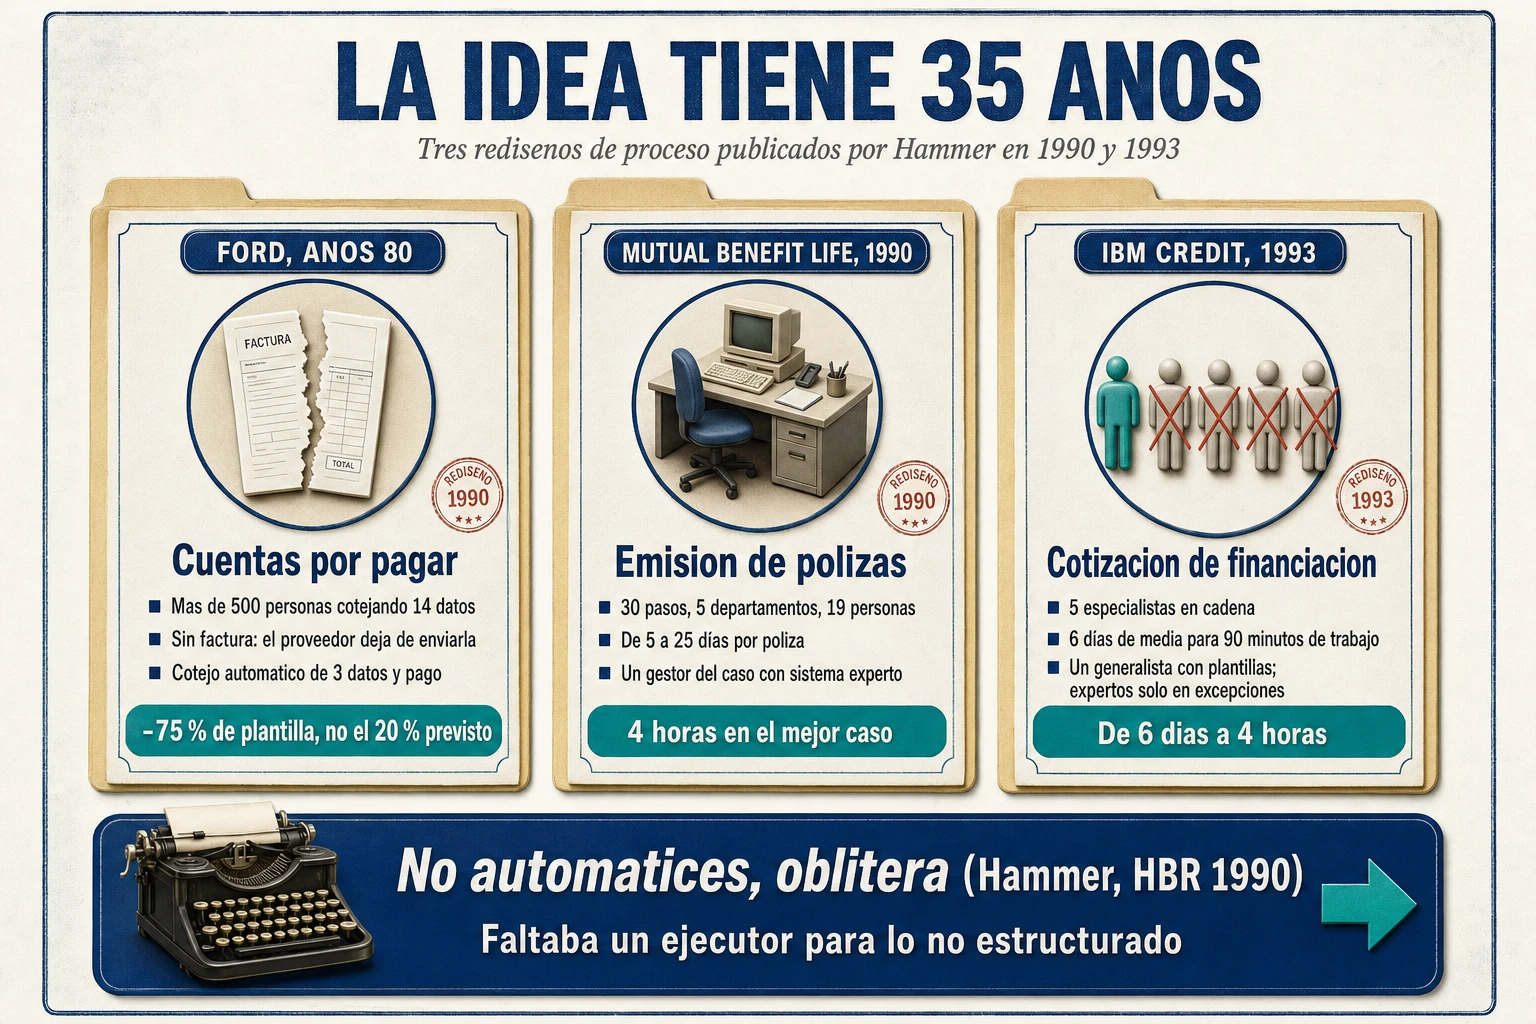
Mutual Benefit Life: de 19 personas a un gestor del caso (1990)
Antes. Emitir una póliza de vida pasaba por «hasta 30 pasos discretos, cinco departamentos y 19 personas». En el mejor caso, 24 horas; lo habitual, entre 5 y 25 días, «la mayor parte del tiempo dedicado a pasar información de un departamento al siguiente».
Después. Un case manager «trabaja de forma autónoma y gestiona una solicitud desde que se recibe hasta que se emite la póliza», con un ordenador, un sistema experto y acceso al mainframe. «En los casos especialmente difíciles pide ayuda a un suscriptor sénior o a un médico, pero estos actúan solo como consultores del gestor, que nunca cede el control».
Lo que desapareció. Clasificar y enrutar el expediente entre cinco departamentos y buscar y cotejar lo que cada uno ya había mirado. La pantalla que ya no está es la de cada especialista revisando todos los expedientes.
Resultado: «tan poco como cuatro horas» en el mejor caso, media de dos a cinco días, 100 puestos de oficina de campo eliminados y «más del doble de volumen» (cifras de Hammer, 1990).
Nivel de autonomía: 2, Prepara: el sistema experto propone; la persona decide y firma.
Límite, y es grande: el regulador de Nueva Jersey intervino Mutual Benefit Life el 16 de julio de 1991, un año después del artículo, por pérdidas en su cartera inmobiliaria: la mayor quiebra de una aseguradora estadounidense hasta entonces. El rediseño del proceso no salvó a la empresa. Un proceso reimaginado no arregla un modelo de negocio.
IBM Credit: de seis días a cuatro horas (1993)
Antes. Una solicitud de financiación de equipos recorría cinco pasos con cinco especialistas en cadena: registro, crédito, condiciones, precio y carta de oferta. Según Hammer y Champy en Reengineering the Corporation (1993), «tardaba una media de seis días y a veces hasta dos semanas, aunque el trabajo real requería unos 90 minutos».
Después. Los cinco especialistas se sustituyeron por «un responsable del caso, llamado deal structurer, capaz de gestionar una solicitud ordinaria de principio a fin», con plantillas y un sistema; los expertos quedaron «para las excepciones genuinas, en lugar de revisar cada operación».
Lo que desapareció. El relevo entre especialistas y, con él, aprobar lo rutinario por parte de gente que solo aportaba valor en lo excepcional. La pantalla que ya no está es la del experto de crédito revisando solicitudes que no lo necesitaban.
Resultado: el plazo «cayó a unas cuatro horas» y, según Hammer y Champy, el volumen se multiplicó por cien sin aumentar la plantilla.
Nivel de autonomía: 2, Prepara. Límite: el «cien veces» es la afirmación más discutida de la reingeniería; un artículo académico de 2020 (Vaughan, Journal of Applied Business and Economics) sostiene que sus autores omiten factores —colas, variabilidad, especialización— sin los cuales la solución no se generaliza. Cítese como la versión de sus autores.
Por qué la reingeniería fracasó en los noventa y qué hay ahora que no había
Se suele decir que la reingeniería fracasó por la rigidez de los sistemas de la época. No es lo que dijeron sus autores. Fracasó porque se convirtió en un eufemismo de despido: en 1993, las grandes empresas estadounidenses anunciaron 600.000 despidos, y 18 de las 25 mayores reducciones de plantilla se produjeron en empresas con programas de reingeniería. A partir de 1995, Hammer, Champy y Davenport pidieron perdón en público; Davenport lo resumió en 2000: «Lo último que habría imaginado es que la gente empezaría a perder su trabajo por algunas ideas que yo estaba ofreciendo».
El famoso «50-70 % de las reingenierías fracasan» lo dieron ellos mismos como «estimación no científica», Hammer lo retiró en 1995 y Hughes demostró en 2011 que no tiene base empírica; ya lo desmontamos en el artículo sobre cómo arrancar una transformación.
Pero hay una limitación técnica que sí era real. El case manager exigía que una sola persona supiera de todo, y Hammer lo resolvía con «sistemas expertos»: reglas escritas a mano que cubrían lo previsto y se quedaban mudas ante lo demás. Todo lo no estructurado —el informe médico, la carta del cliente, el contrato con una cláusula rara— exigía una persona. El proceso rediseñado era más frágil que el antiguo: funcionaba mientras las solicitudes se parecieran a la plantilla.
Eso es lo que hoy existe y en 1990 no. El modelo de lenguaje es el sistema experto que por fin lee, entiende y escribe lo no estructurado; no inventa el marco, elimina la restricción que hacía inviable generalizar el case manager. Y el otro ingrediente es el de Lean: Toyota enseñó a mirar el flujo entero y a ver que el tiempo está en las esperas, y esa mirada es la que dice dónde poner al agente. Con esas dos piezas, la pregunta ya no es si se puede rediseñar desde el resultado, sino qué trabajos desaparecen cuando se hace.
Los seis trabajos que desaparecen y la prueba de la pantalla
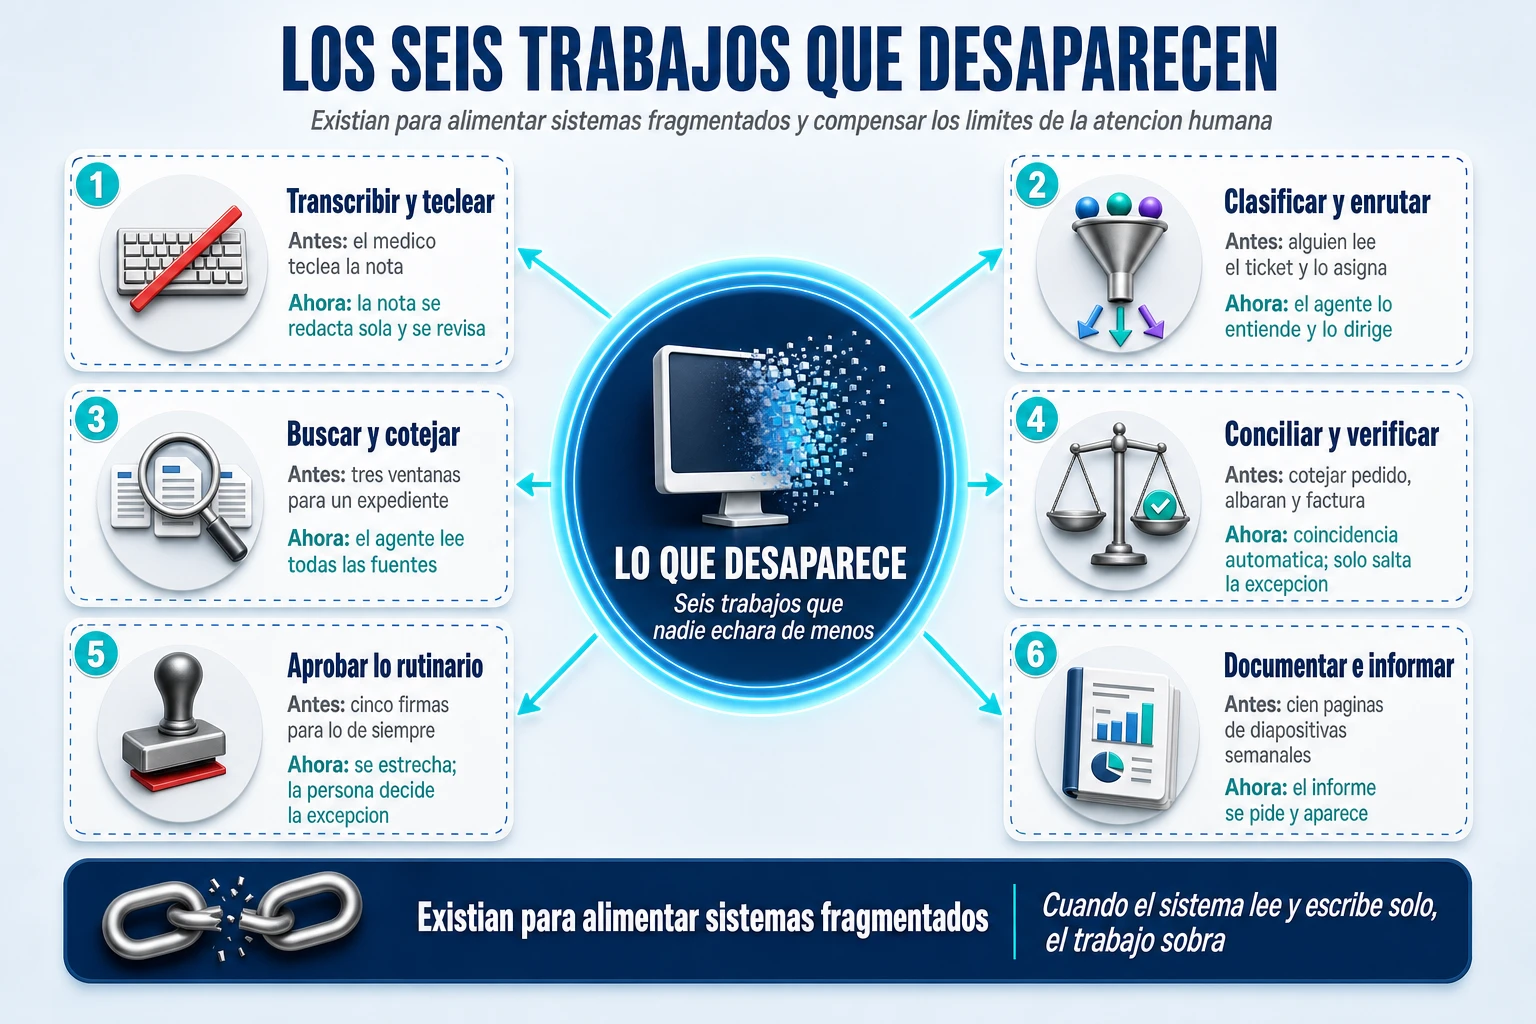
Cuando se ponen en fila los casos que funcionan, de Ford en 1990 a Allianz en 2025, lo que desaparece es siempre alguna combinación de los mismos seis trabajos. No son tareas de un sector: existían para alimentar sistemas fragmentados y para compensar los límites de la atención humana. Un hospital, un banco y un aeropuerto no se parecen en nada, pero en los tres había alguien transcribiendo, alguien clasificando y alguien buscando en cuatro sistemas lo que debería estar en uno.
Los seis trabajos
Transcribir y teclear. Pasar a un sistema lo que ya existe en otro formato: la conversación de la consulta, el documento del prestatario, el acta de la reunión. Existía porque los sistemas solo aceptaban datos estructurados. Lo sustituye un modelo que escucha o lee y escribe en el campo correspondiente.
Clasificar y enrutar. Decidir qué es cada cosa y a quién le toca. Existía porque la organización estaba dividida en especialidades y algo tenía que dirigir el tráfico. Lo sustituye un clasificador que lee el contenido, no el asunto.
Buscar y cotejar. Abrir tres ventanas para juntar lo que el expediente necesita. Existía porque la información vivía en sistemas distintos y la persona era el integrador. Lo sustituye un agente con acceso de lectura a todos ellos.
Conciliar y verificar. Comprobar que lo que dice un documento coincide con lo que dice otro: los catorce datos de Ford, el pago duplicado. Existía por desconfianza justificada entre sistemas. Lo sustituye una comprobación que bloquea antes de pagar en lugar de auditar después.
Aprobar lo rutinario. Firmar lo que siempre se firma. Existía porque no había forma de distinguir de antemano lo rutinario de lo que merecía una mirada. Lo sustituye un umbral y un carril rápido; la persona se queda con lo que no cumple. Es el trabajo que menos desaparece: se estrecha.
Documentar e informar. Producir la nota, el memorando, las cien páginas de PowerPoint. Existía porque la información había que empaquetarla para que otro la consumiera. Lo sustituye un sistema al que se le pregunta directamente.
| Trabajo que desaparece | Ejemplo de antes | Qué lo sustituye | Quién se queda con la excepción |
| Transcribir y teclear | El médico teclea la consulta; el empleado copia los datos de la nómina al sistema de originación | El modelo escucha o lee y escribe el registro estructurado | La persona valida antes de firmar (nivel 2) o audita después (nivel 3) |
| Clasificar y enrutar | El tramitador lee el parte y decide a qué equipo va; el técnico de nivel 1 asigna el ticket | Un clasificador que lee el contenido y enruta con umbral de confianza | Lo que queda por debajo del umbral va a una cola humana definida |
| Buscar y cotejar | Tres ventanas: póliza, foto y presupuesto; cuatro sistemas para saber dónde está un vehículo | Un agente con acceso de lectura a todos los sistemas que reúne el expediente | El experto decide sobre el expediente ya reunido |
| Conciliar y verificar | Cotejar catorce datos entre pedido, albarán y factura; perseguir duplicados a posteriori | Comprobación automática que bloquea antes del pago | La persona resuelve la discrepancia, no la busca |
| Aprobar lo rutinario | El suscriptor sénior revisa todas las solicitudes; el clínico de la aseguradora, todas las autorizaciones | Carril rápido con umbral por importe, tipo o vía clínica; se estrecha, no desaparece | La persona decide lo que supera el umbral y siempre la denegación |
| Documentar e informar | El memorando de crédito que ocupa el 40 % del tiempo del gestor; el PowerPoint semanal | Un borrador generado desde los datos o un sistema al que se pregunta en directo | La persona corrige, añade criterio y responde de lo que firma |
La prueba de la pantalla: tres preguntas
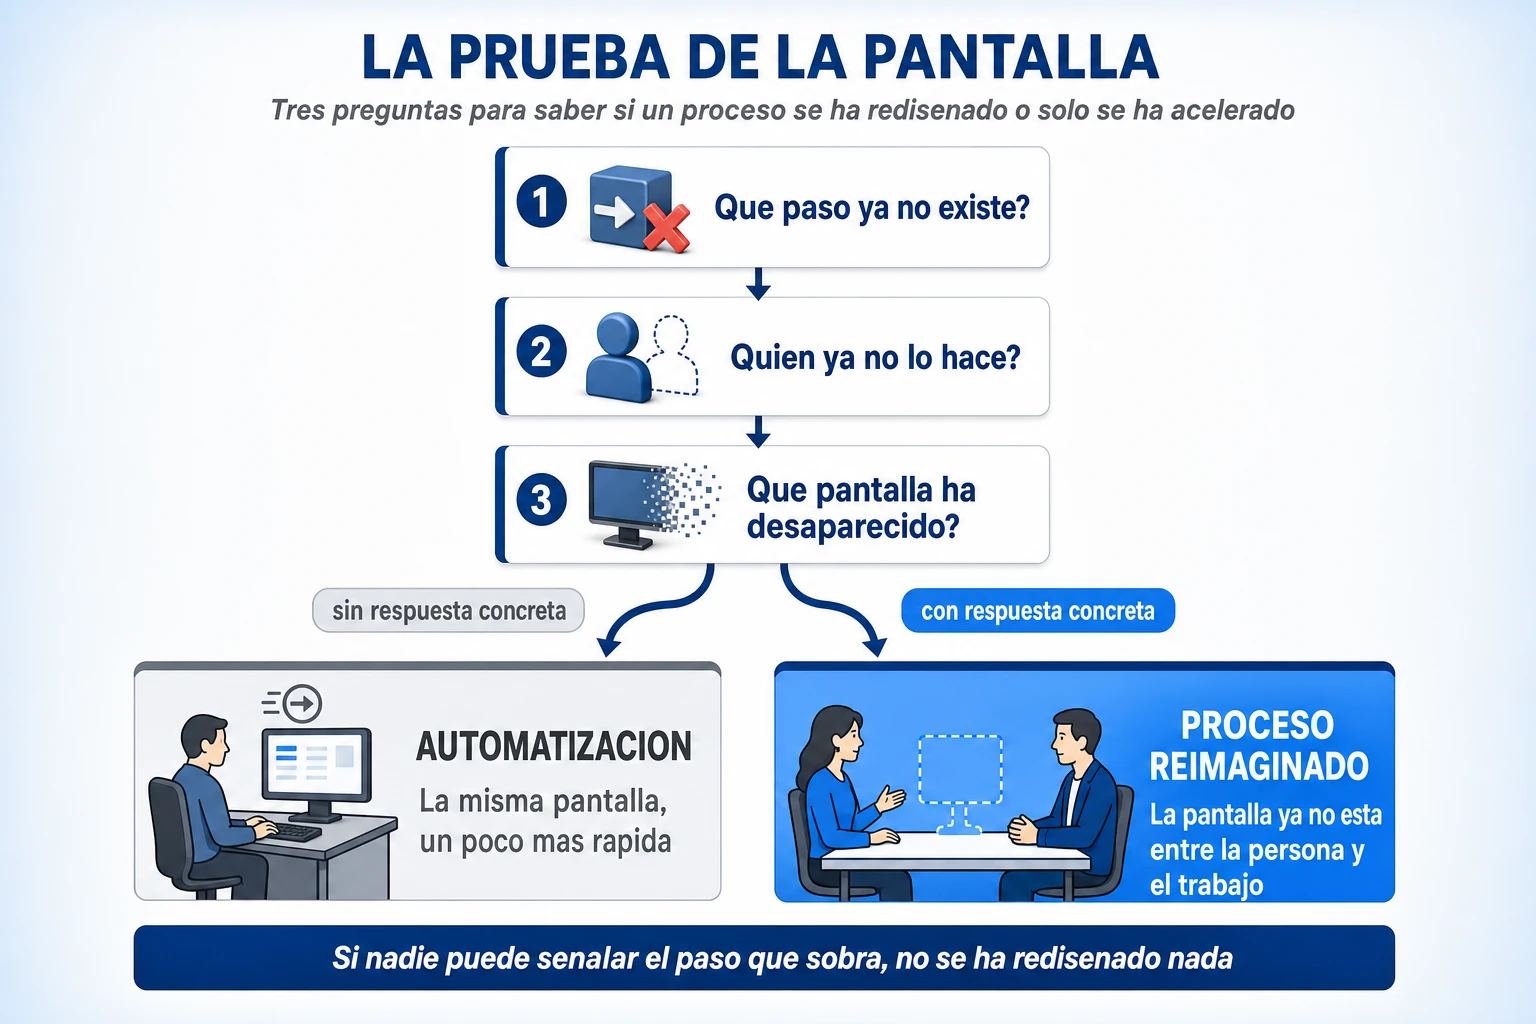
Hay una forma rápida de saber si un proyecto de «IA en procesos» ha rediseñado algo o solo lo ha acelerado, y no requiere leer el caso de negocio. ¿Qué paso ya no existe? No cuál va más rápido: cuál ha desaparecido del mapa. Si la respuesta es «ninguno, pero todos tardan menos», es automatización. ¿Quién ya no lo hace? Con nombre de puesto: el tramitador ya no instruye, el médico ya no teclea, el comprador ya no negocia con la cola larga. Si la respuesta es «los mismos, con ayuda», es un copiloto.
¿Qué pantalla ha desaparecido de entre la persona y el trabajo real? Si el médico sigue mirando el monitor y el tramitador sigue abriendo la foto, la pantalla sigue ahí y el proceso también.
La prueba es dura a propósito. La pasan Ford, Quirónsalud, Allianz, Walmart y la mayoría del catálogo. No la pasan la mayoría de los proyectos de copiloto, casi ningún proyecto de RPA y buena parte de lo que se presenta como «agéntico» en 2026. Y tiene una segunda utilidad: dice qué medir. Si el paso ha desaparecido, los toques humanos por expediente tienen que haber bajado; si la pantalla ha desaparecido, la tasa de straight-through tiene que haber subido. Si esas dos cifras no se mueven, alguien está contando horas ahorradas que no existen.
Salud: la consulta sin ordenador y lo que vino detrás
La sanidad tiene el caso de rediseño más adoptado del momento —la documentación clínica ambiental, el ambient scribe— y, a la vez, el mejor medido. Es una tecnología de nivel 2, el médico valida cada nota, y aun así ha cambiado la consulta más que cualquier sistema de historia clínica de los últimos veinte años. El bloque empieza por el caso español, sigue con los que lo han medido y termina con procesos donde la ruptura es otra: el seguimiento, la agenda, la lista del radiólogo, la autorización de la aseguradora.
Quirónsalud: «consultas sin pantallas» en más de un millón de citas
Antes. El médico atendía con el ordenador entre él y el paciente: tecleaba en Casiopea, la historia clínica que el grupo desarrolló él mismo, y redactaba después el informe con abreviaturas.
Después. Scribe, un desarrollo propio integrado en Casiopea con Inetum como socio tecnológico; piloto en Traumatología del Hospital Universitari General de Catalunya en junio de 2024 y anuncio en noviembre. El médico revisa el historial antes de que entre el paciente, activa la grabación en su teléfono de trabajo y conversa sin teclear. El sistema transcribe en tiempo real, distingue quién habla, descarta lo no clínico, estructura los datos y propone pruebas y prescripciones; el médico revisa y valida un informe sin abreviaturas y codificado que se entrega al paciente. El audio se borra como máximo a las cuatro horas y la transcripción a los catorce días, según la política de datos de la Fundación Jiménez Díaz.
Lo que desaparece: transcribir y teclear durante la consulta y documentar después; la pantalla que ya no está es la que separaba al médico del paciente, lo que Quirónsalud llama «consultas sin pantallas».
Resultado: escala verificada de 1.600 médicos y 112.000 consultas a los seis meses (informe anual 2024 de Fresenius, el grupo propietario), 4.000 médicos y 50 hospitales en junio de 2025 y más de un millón de consultas y 5.000 profesionales en julio de 2025 (cifras de la propia empresa). En los cuatro hospitales públicos de Madrid que gestiona, la candidatura a un premio sectorial de 2026 declara −40 % de tiempo de documentación, calidad del registro del 74 % al 93 %, −18 % de errores clínicos y satisfacción profesional de 8,6 sobre 10: cifras autodeclaradas, sin estudio independiente.
No hay ninguna cifra publicada de duración de la consulta; la única medición de acortamiento de cita es la del NHS, más abajo. Nivel: 2, Prepara; las sugerencias de pruebas son nivel 1. Límite: sin publicación revisada por pares y sin proveedor de modelo revelado.
Hay un matiz que en España no se puede saltar: el ordenador se va de la mesa, pero el consentimiento entra. La AEPD publicó en 2026 dos guías sobre transcripción de voz con IA: informar antes de empezar, mantener un indicador perceptible durante toda la grabación, consentimiento específico por sesión, separar «transcribir» de «entrenar», plazos de conservación distintos para audio y transcripción, y evaluación de impacto.
Quirónsalud borra el audio en cuatro horas, Kaiser no lo guarda y el NHS consigue que el 92 % de los pacientes consienta. Y la agencia británica del medicamento ha trazado la frontera regulatoria justo donde este artículo pone la de autonomía: transcribir y resumir para que el clínico revise no es producto sanitario; ejecutar órdenes sin revisión sí lo es.
Kaiser Permanente: 2,6 millones de consultas y 22 segundos por nota
Antes. Los médicos de The Permanente Medical Group, el grupo médico de Kaiser en el norte de California, documentaban durante y después de la visita, y las notas se desplazaban a la noche.
Después. Desde octubre de 2023, el médico pide permiso, activa la aplicación de Abridge en su móvil, conversa y recibe un borrador que edita y firma. El sistema no conserva el audio.
Lo que desaparece: transcribir y teclear; la pantalla que ya no está es la que el paciente veía al médico mirar. Resultado: en 63 semanas, 7.260 médicos usaron la herramienta en 2.576.627 consultas y ahorraron 15.791 horas de documentación; el trabajo fuera de horario bajó 1,03 minutos por cita; el 84 % de los médicos dice que mejoró la interacción (estudio de la propia organización en NEJM Catalyst, abril de 2025).
Nivel: 2, Prepara. Límite: estudio observacional, no aleatorizado, y la cifra de cabecera merece una división: 15.791 horas entre 2,58 millones de consultas son unos 22 segundos por consulta. El titular impresiona más de lo que representa por médico. Lo que cambió no fue el tiempo: fue quién mira a quién.
NHS de Londres: la única medición de una cita más corta
Antes. Clínicos de consultas externas, Urgencias y primaria de nueve centros del NHS de Londres tomando notas durante y después de la cita. Después. La tecnología de voz ambiental de TORTUS, una startup británica que no conserva datos del paciente ni entrena con ellos: la conversación se transcribe, se genera el borrador y el clínico lo revisa. Ensayo en más de 17.000 encuentros, liderado por Great Ormond Street Hospital y patrocinado por NHS England.
Lo que desaparece: transcribir y teclear; lo distinto es lo que se midió. Resultado (evaluación de NHS England, septiembre de 2025): +23,5 % de tiempo de interacción directa con el paciente, −8,2 % de duración de la cita, +13,4 % de pacientes por turno en Urgencias y un 92 % de pacientes que consintieron. Es el único despliegue que ha medido que la cita se acorta.
Nivel: 2, Prepara. Límite: evaluación de la organización usuaria, no revisada por pares; las cifras económicas que la acompañan son modelización. Y un contraste: una evaluación independiente del mismo producto en siete centros de Kent y Medway (diciembre de 2025) encontró ahorros «percibidos», retrasos de gobernanza de la información y un piloto en servicios sociales que terminó antes de tiempo. El mismo producto funciona muy distinto según dónde se ponga.
Lo que miden los ensayos: segundos de tiempo, puntos de burnout
Los tres casos anteriores son organizaciones que miden su propio despliegue. Los ensayos dicen algo incómodo para quien vende minutos. El más riguroso es el de UCLA Health en NEJM AI (diciembre de 2025): 238 médicos de catorce especialidades aleatorizados a dos scribes comerciales o a un grupo de control. El ahorro real por nota fue de 23 a 41 segundos, y solo un producto alcanzó significación estadística; el agotamiento, en cambio, mejoró de forma clara. Hubo inexactitudes clínicamente relevantes «ocasionalmente» y un evento adverso leve por una omisión.
Mass General Brigham y Emory, con 1.430 clínicos (JAMA Network Open, agosto de 2025), midieron el burnout autodeclarado: del 50,6 % al 29,4 % a los 42 días, sin grupo de control y con tasas de respuesta del 22-30 %. Sutter Health midió el tiempo en notas con datos del sistema: de 6,2 a 5,3 minutos por cita. Y el Peterson Health Technology Institute, tras revisar ocho sistemas sanitarios, concluyó en marzo de 2025 que la evidencia de productividad es «mixta» y el impacto financiero «poco claro».
Frente a esto, el fabricante del scribe más vendido anuncia en su ficha comercial siete minutos ahorrados por encuentro; su propia encuesta dio cinco; los ensayos, menos de uno. Un orden de magnitud entre lo que se vende y lo que se mide. Lo que se gana no son minutos: es el burnout y el contacto visual. Nivel: 2 en todos.
Osakidetza y el ICS: la sanidad pública española entra
Antes. Médicos de familia tecleando durante la consulta presencial, el 60 % de la actividad de primaria; los 1.800 médicos de familia de Osakidetza hicieron 5,5 millones de consultas presenciales en 2025.
Después. Grabación, transcripción automática, resumen clínico estructurado y revisión por el profesional, «validado específicamente para su uso en euskera». Tras un piloto minúsculo —16 médicos de familia, 5 enfermeras, 2 pediatras, unas cien grabaciones—, el Gobierno Vasco anunció en mayo de 2026 el despliegue progresivo a toda la red de primaria. En Cataluña, el Institut Català de la Salut describe «un micrófono situado en la mesa y conectado al ordenador» y en agosto de 2026 licitó por 230.000 euros un servicio de transcripción por IA para sus consultas de primaria.
Lo que desaparece: transcribir y teclear en la consulta del médico de familia. Lo relevante no es la cifra, porque no la hay: es que un servicio público decide que el registro clínico ya no lo teclea el médico, y otro lo convierte en un contrato.
Resultado: «buena aceptación» y «reducción perceptible del tiempo dedicado a tareas administrativas», sin cifras (fuente oficial).
Nivel: 2, Prepara. Límite: proveedor no nombrado en Euskadi, adjudicatario pendiente en Cataluña, y la nota vasca no menciona el consentimiento que la AEPD exige. Es un caso de decisión, no de medición.
Hospital de La Princesa: enfermería solo atiende las alertas
Antes. Tras el alta, enfermería llamaba —o no llamaba— a los pacientes; el seguimiento dependía de la carga de trabajo del día. Después. Un agente de voz de Tucuvi, empresa española, llama a las 48 horas y a los 7, 15 y 30 días del alta y hace cinco preguntas de estado. Cualquier respuesta afirmativa genera una alerta que revisa una enfermera. Solo se llama a quien salta la alerta.
Lo que desaparece: la llamada rutinaria; enfermería deja de llamar a todos y atiende solo lo que el sistema ha clasificado. La pantalla que ya no está es la lista de pacientes a los que llamar.
Resultado (estudio en Revista Clínica Española, 2021): 100 pacientes COVID dados de alta en 2020; 680 llamadas intentadas, 423 contestadas; 85 alertas en 45 pacientes, el 15 % de las llamadas; el 94 % de las alertas se resolvió por teléfono; ningún reingreso.
Nivel: 3, Ejecuta y deja traza: el sistema llama; la enfermera audita. Límite: cien pacientes, un centro, en pandemia, y un 38 % de llamadas no contestadas que el estudio no esconde. Escala pequeña, pero revisada por pares; las cifras mucho mayores que el proveedor publica de despliegues posteriores no se usan porque no las ha medido nadie externo.
NHS Mid and South Essex: la agenda deja de ser una cola
Antes. Citas asignadas por orden, una tasa de ausencias del 8 %, recordatorios genéricos, y unas ausencias que cuestan al NHS unos 1.200 millones de libras al año.
Después. Un algoritmo de Deep Medical predice qué pacientes tienen más probabilidad de no acudir —con datos anonimizados y factores como meteorología, tráfico o situación laboral— y ofrece horarios alternativos y reservas de respaldo para los huecos previsibles.
Lo que desaparece: clasificar y enrutar citas a mano y perseguir ausencias después; la agenda se construye a partir de la probabilidad de que cada persona acuda.
Resultado (nota de NHS England de marzo de 2024, citada por prensa sanitaria): en seis meses de piloto, −30 % de ausencias, 377 ausencias evitadas y 1.910 pacientes adicionales atendidos; extensión a diez trusts más.
Nivel: 2-3: el sistema propone y reordena, el personal supervisa. Límite: un solo trust, ahorro estimado por el propio trust, sin publicación revisada por pares, y el «90 % de precisión» que circula es del proveedor. La ruptura, en cambio, es barata de comprobar en cualquier hospital: cuántas citas se reasignan antes de perderse.
University of Chicago: la lista del radiólogo se ordena por gravedad
Antes. Los TC de cráneo se leían por orden de llegada; una hemorragia de un paciente ambulatorio podía esperar horas mientras el radiólogo informaba estudios normales.
Después. El software de Aidoc analiza cada TC al llegar y reordena la lista de trabajo poniendo arriba los casos con sospecha de hemorragia. El radiólogo sigue diagnosticando; cambia qué abre primero.
Lo que desaparece: la cola cronológica; clasificar y enrutar pasa del orden de llegada a una decisión de la máquina. Resultado (estudio revisado por pares en Brain Sciences, 2021, un centro): 8.723 TC; el retraso hasta ver un caso positivo bajó 604 minutos, un 90 %, en ambulatorios; 38 minutos en ingresados; y 12,5 minutos en Urgencias, sin significación estadística.
Nivel: 3, Ejecuta y deja traza, para la reordenación; 1, Recomienda, para el diagnóstico. Límite: el beneficio está donde había cola, no en Urgencias; no mide resultados clínicos; y al menos una evaluación prospectiva posterior no encontró mejora en los tiempos de informe. Reordenar una cola solo aporta valor si la cola era larga.
Humana: la autorización previa que se aprueba en cero minutos (y el caso contrario)
Antes. El médico enviaba formularios o faxes a la aseguradora para pedir autorización de una prueba o una cirugía; alguien los revisaba a mano; días de espera, denegaciones y apelaciones.
Después. El médico solicita en el portal de Cohere Health y, si elige una vía clínica basada en evidencia, la aprobación es automática e inmediata. De doce estados en 2021 a cincuenta en 2022, para 5,1 millones de asegurados.
Lo que desaparece: aprobar lo rutinario; la autorización deja de ser una revisión posterior y se convierte en el resultado instantáneo de elegir la vía correcta.
Resultado (prensa sanitaria de 2022 citando a Humana, reproducido por el proveedor): el 95 % de las autorizaciones musculoesqueléticas pasa por la plataforma, la mediana de aprobación es de cero minutos y el 89 % es programable de inmediato.
Nivel: 4, Ejecuta salvo excepción, solo para aprobar; las denegaciones las decide un clínico por obligación regulatoria.
Límite y contraejemplo: la misma ruptura es virtuosa cuando automatiza el «sí» y tóxica cuando automatiza el «no». UnitedHealth afronta desde 2023 una demanda colectiva por un modelo de su filial naviHealth que estimaba cuántos días de cuidados «debería» necesitar un paciente y se usaba para cortar la cobertura; la demanda alega que más del 90 % de las denegaciones se revocaban en apelación y que solo el 0,2 % de los afectados apelaba. Son alegaciones, no sentencia, pero el tribunal ha dejado seguir parte de las reclamaciones. Automatizar la denegación sin persona acaba en los tribunales.
| Caso | Lo que desaparece | Resultado | Fuente | Nivel |
| Quirónsalud, Scribe (2024-2026) | Transcribir en consulta; documentar después | >1 M consultas y 5.000 profesionales; −40 % tiempo de documentación, registro 74 → 93 % | Propia empresa; premio sectorial | 2 |
| Kaiser / Permanente + Abridge (2023-2024) | Transcribir en consulta | 7.260 médicos, 2,58 M consultas, 15.791 h (≈22 s por consulta) | Estudio propio, NEJM Catalyst 2025 | 2 |
| NHS Londres + TORTUS (2024-2025) | Transcribir en consulta | +23,5 % interacción, −8,2 % duración de cita, +13,4 % pacientes/turno | Evaluación NHS England | 2 |
| Ensayos UCLA, MGB/Emory, Sutter (2025) | Transcribir en consulta | 23-41 s por nota; burnout 50,6 → 29,4 %; 6,2 → 5,3 min | NEJM AI (RCT), JAMA Netw Open, estudio propio | 2 |
| Osakidetza / ICS (2026) | Transcribir en consulta | Despliegue a 1.800 médicos; licitación de 230.000 €; sin cifras | Fuentes oficiales | 2 |
| La Princesa + Tucuvi (2020-2021) | Llamar a todos tras el alta | 94 % de alertas resueltas por teléfono; 100 pacientes | Rev. Clin. Esp. (revisado por pares) | 3 |
| NHS Mid and South Essex + Deep Medical (2023-2024) | Asignar citas por orden; perseguir ausencias | −30 % ausencias, 1.910 pacientes más en 6 meses | NHS England vía prensa | 2-3 |
| University of Chicago + Aidoc (2020-2021) | Leer TC por orden de llegada | −604 min (−90 %) en ambulatorios; n.s. en Urgencias | Brain Sciences (revisado por pares) | 3 / 1 |
| Humana + Cohere Health (2021-2024) | Revisar autorizaciones que siguen la vía clínica | Mediana de aprobación 0 min; 89 % programable de inmediato | Prensa citando a Humana, vía proveedor | 4 (solo el «sí») |
Banca y seguros: el expediente que se tramita solo
En banca y seguros el patrón de ruptura tiene una fórmula: la persona ya no instruye el expediente, lo audita. El tramitador no abre la foto, la póliza y el presupuesto en tres ventanas; recibe un expediente ya reunido, con las comprobaciones hechas, y decide. Es el case manager de Mutual Benefit Life con un sistema experto que por fin lee.
Y hay un segundo rasgo: casi nadie ha llegado al nivel 4 o 5, y quien lo ha hecho lo limita por importe o por tipo de siniestro. Aquí, además, la regulación no es decorado: el scoring crediticio y la tarificación de seguros de vida y salud son sistemas de alto riesgo en el Anexo III del Reglamento de IA.
Allianz Australia: siete agentes tramitan y una persona decide el pago
Antes. Tras una tormenta o un apagón, miles de asegurados de hogar reclaman a la vez por los alimentos estropeados en el congelador. Un tramitador abría el expediente, comprobaba la cobertura, verificaba que hubo un fenómeno meteorológico en esa zona y fecha, revisaba indicios de fraude y calculaba la indemnización: «cuatro días o más» en los picos.
Después. Desde julio de 2025, siete agentes hacen cada paso —cobertura, confirmación meteorológica con datos externos, cribado de fraude, cálculo— y un «agente auditor» «redacta el resumen de todas las decisiones de los agentes y lo pasa a una persona para que tome la decisión de pago». Solo para siniestros por debajo de 500 dólares australianos.
Lo que desaparece: buscar y cotejar entre póliza, mapa meteorológico y expediente, y conciliar y verificar el importe; el tramitador abre una pantalla, el resumen del auditor, en vez de cuatro.
Resultado (nota corporativa de Allianz, noviembre de 2025): de «varios días» a «un día, o incluso horas»; «menos de cinco minutos desde que se presenta el siniestro hasta la revisión humana final»; la empresa cifra la reducción del tiempo de tramitación en un 80 %. Cifras de la propia empresa.
Nivel: 2, Prepara, y por diseño: «las decisiones de pago nunca se automatizan». Límite: un solo tipo de siniestro, de bajo importe y alta frecuencia, en una filial. Pero es producción, no piloto, y el mejor ejemplo del bloque de autonomía en el trabajo con una persona en la decisión.
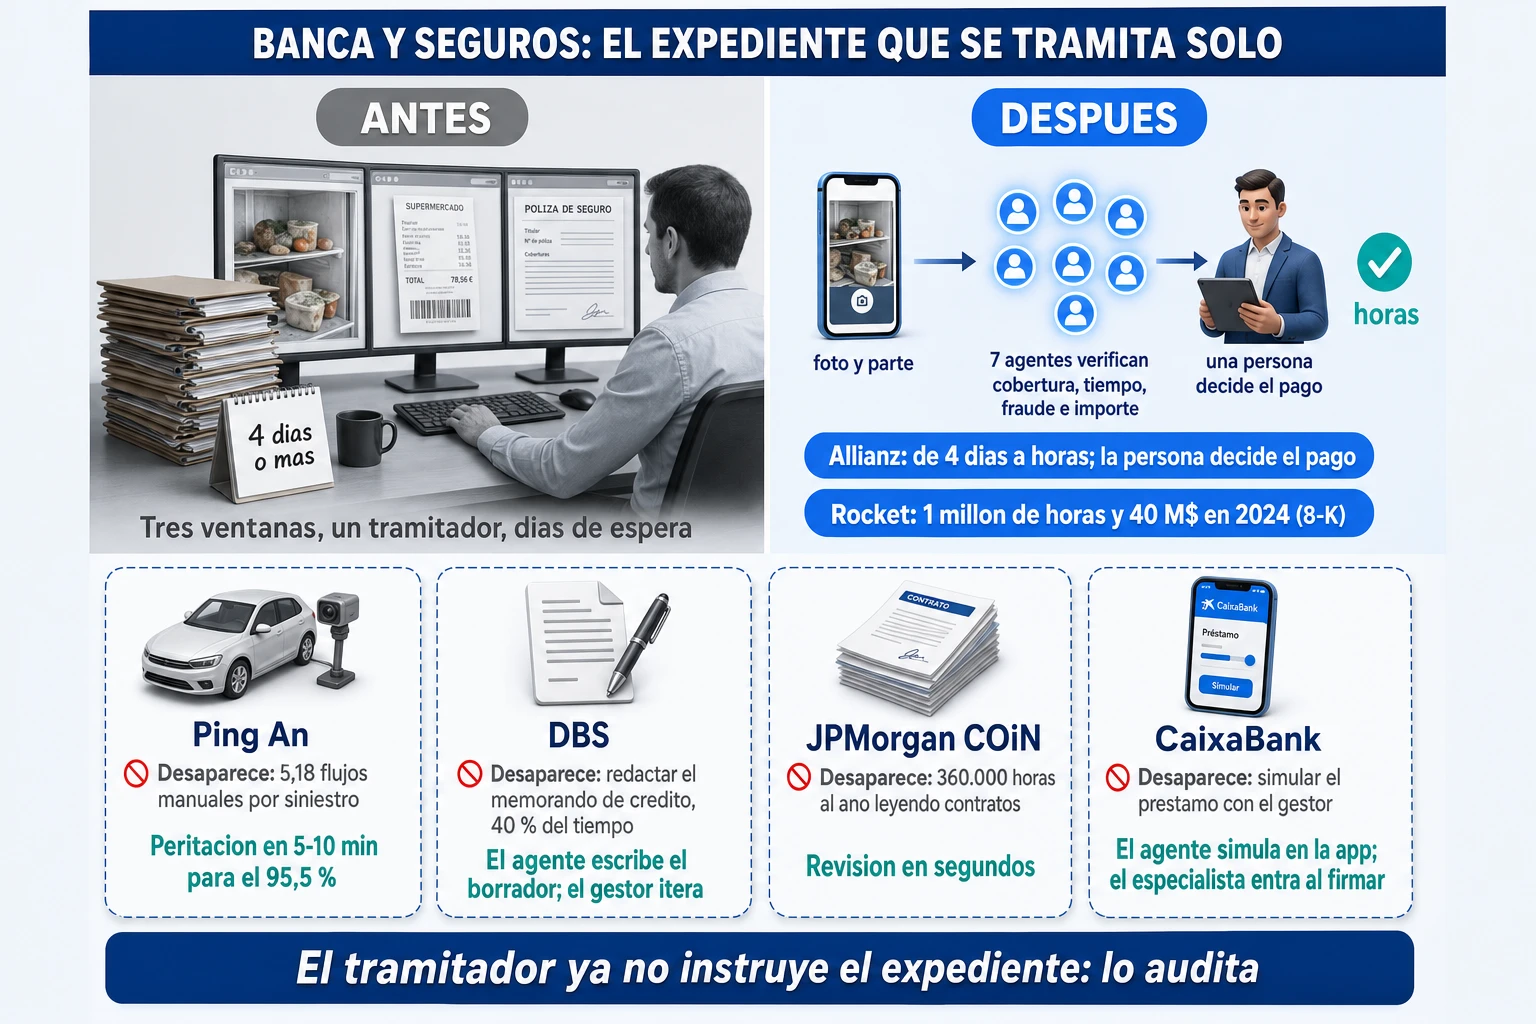
Ping An: el siniestro de auto sin perito (precedente, 2019)
Antes. Según la propia aseguradora china, un siniestro de auto pasaba por «5,18 flujos manuales de media»: aviso, peritación presencial, valoración, gestión documental y pago, con un perito desplazándose.
Después. El conductor avisa desde el móvil, sube fotos, la visión artificial valora los daños, el OCR lee las facturas, el cliente confirma la indemnización en pantalla y el pago se libera con reconocimiento facial. Un «cupo de crédito» según el historial de conducción decide cuánto puede autoliquidar cada cliente.
Lo que desaparece: el perito en la mayoría de los siniestros leves; buscar y cotejar lo hace la máquina y aprobar lo rutinario se estrecha a un umbral.
Resultado (nota del grupo, enero de 2019): peritación en cinco a diez minutos para el 95,5 % de los siniestros diurnos; el 30 % valorado por reconocimiento de imagen con una precisión declarada del 95 %; cobro «en segundos».
Nivel: 3-4 en siniestros leves. Límite: no es agéntico en el sentido de 2026 —visión, OCR y reglas—, las cifras son de la aseguradora y el cupo por historial chocaría en Europa con la normativa de datos. Va como precedente: el siniestro de extremo a extremo estaba rediseñado siete años antes de los agentes; lo que estos añaden es poder hacerlo con siniestros menos estructurados.
Admiral Seguros: 12.000 siniestros sin que un perito vea la foto
Antes. El asegurado enviaba fotos por correo y un perito de Admiral Seguros, la filial española del grupo Admiral, las revisaba una a una para estimar el daño: intensivo en mano de obra y con días de espera.
Después. En el aviso del siniestro, el cliente recibe un enlace, fotografía los daños con el móvil y la IA de Tractable valora y genera el presupuesto; los siniestros que cumplen los criterios se liquidan sin perito. Entre el 70 y el 75 % de los clientes completa el proceso con el enlace.
Lo que desaparece: buscar y cotejar foto, tarifa y presupuesto, y aprobar lo rutinario en daños leves; la pantalla que ya no está es la del perito con el correo abierto.
Resultado (caso del proveedor con citas del responsable de transformación de siniestros de Admiral, 2021): 12.000 siniestros touchless; el 90 % de las valoraciones sin intervención del perito; el 98 % de los siniestros elegibles completados en menos de un cuarto de hora; precisión del 96 % frente a los peritos. Cifra del proveedor, sin comunicación propia de Admiral.
Nivel: 3-4 en siniestros leves elegibles. Límite: «elegibles» significa solo daños menores. Es el mejor caso español del bloque, y el ejemplo más claro de que el nivel 4 se consigue estrechando el tipo de caso, no ampliando la confianza en el modelo.
Rocket Mortgage: el suscriptor revisa excepciones, no expedientes
Antes. Los prestatarios de la mayor hipotecaria de Estados Unidos subían nóminas, extractos y declaraciones; empleados de operaciones identificaban cada documento, transcribían los datos a la plataforma de originación y el suscriptor los verificaba a mano.
Después. Rocket Logic, presentado en abril de 2024, identifica automáticamente siete de cada diez de los más de 1,5 millones de documentos que la empresa recibe al mes y procesó automáticamente cerca del 90 % de los 4,3 millones de datos extraídos en febrero de 2024. Los empleados se ocupan del resto y de las excepciones.
Lo que desaparece: transcribir y teclear los datos del documento al sistema y clasificar el documento; la transcripción deja de ser un puesto de trabajo.
Resultado (comunicación de resultados a la SEC, 8-K de febrero de 2025): «en 2024, la automatización en la cualificación hipotecaria por sí sola ahorró más de un millón de horas de tiempo del equipo, generando 40 millones de dólares en ganancias de eficiencia»; los equipos atendieron un 54 % más de clientes en el cuarto trimestre.
Nivel: 3, Ejecuta y deja traza. Límite: las horas son estimación interna y los 40 millones son «ganancias de eficiencia», no beneficio auditado; pero es una cifra comunicada a un regulador, más de lo que ofrece casi cualquier caso de este artículo, y la escala es real.
HSBC: el investigador deja de vaciar colas de falsos positivos
Antes. La monitorización antiblanqueo se hacía con sistemas de reglas que generaban un volumen enorme de alertas, la mayoría falsos positivos; equipos de investigadores dedicados a descartarlas; semanas para analizar la actividad de millones de cuentas.
Después. Un modelo de riesgo de Google Cloud como sistema primario de monitorización en mercados clave, que puntúa el riesgo de cada cliente por su comportamiento y explica al investigador los factores de la puntuación. HSBC analiza del orden de mil millones de transacciones al mes.
Lo que desaparece: clasificar y enrutar alertas por reglas y buscar y cotejar el contexto de cada una; la pantalla que ya no está es la cola de alertas.
Resultado (nota del proveedor de junio de 2023 con declaraciones directas de la responsable de riesgo de delito financiero de HSBC): «2-4 veces más actividad sospechosa real», «más del 60 % menos de alertas» y un análisis que pasa «de varias semanas a unos días». Cifra de HSBC publicada por el proveedor, sin confirmación del regulador.
Nivel: 2, Prepara: el modelo decide qué se investiga; la persona decide si hay comunicación de operación sospechosa. Límite: es detección, no ejecución; y la cifra que circula como «HSBC redujo el fraude un 60 %» es falsa por partida doble: son alertas, no fraude, y es blanqueo, no tarjetas.
DBS: el gestor deja de redactar el memorando y el asistente deja de explicar
Antes. Los gestores de banca corporativa y los analistas de riesgo de DBS dedicaban «aproximadamente el 40 % de su tiempo» a preparar memorandos de crédito: cribar informes anuales, estudios sectoriales y registros internos, estructurar y redactar. Y para saber si un pago había llegado, el cliente pyme llamaba y un empleado consultaba los sistemas.
Después. Un sistema de agentes que cubre «más de setenta tareas» redacta borradores de memorando «listos para revisión» y el gestor itera con él (piloto con 150 personas, despliegue a unos 1.500 en agosto de 2026); y desde julio de 2026 DBS Joy, el asistente para 350.000 pymes, «entiende y cumple las peticiones en nombre del cliente» consultando los sistemas.
Lo que desaparece: documentar e informar desde el documento en blanco, y buscar y cotejar por parte del empleado. Resultado (notas de prensa de DBS, 2026): el objetivo del memorando es reducir «al menos un 30 %» el tiempo de preparación, y es un objetivo, no un resultado; Joy sí tiene cifras del primer semestre de 2026: +61 % de usuarios activos, +17 % de satisfacción y −7 % de contactos de servicio.
Nivel: 2, Prepara, en el memorando; 3, Ejecuta y deja traza, en Joy. Límite: el −7 % de contactos es modesto comparado con el relato habitual, y quien cite «DBS reduce un 30 %» está convirtiendo un objetivo en un resultado.
JPMorgan: de leer 12.000 contratos a agentes que trabajan de noche
Antes. En 2017, abogados y gestores leían unos 12.000 contratos de crédito comercial al año para extraer cláusulas: 360.000 horas anuales. En 2024, los banqueros privados revisaban cada mañana mercados, posiciones y research antes de ver a sus clientes.
Después. COiN, desde 2017, extrae los datos «en segundos» y las personas revisan. En 2026, el banco describe «la era de los agentes autónomos de larga duración», que corren «una o dos horas» y en banca privada «criban la actividad del mercado, las posiciones del cliente y el research durante la noche». 250.000 empleados tienen acceso a la plataforma interna de modelos y la mitad la usa a diario.
Lo que desaparece: en COiN, buscar y cotejar cláusulas, que pasa de trabajo jurídico a control de calidad de una extracción; en los agentes nocturnos, documentar e informar para uno mismo.
Resultado: las 360.000 horas las dio el banco a la prensa financiera en 2017 y nunca se auditaron; el banco atribuye a sus herramientas de IA un 20 % más de ventas brutas en banca privada (su director de analítica a la prensa, junio de 2026).
Nivel: 3 en COiN; 2-3 en los agentes nocturnos. Límite, y lo dice el propio banco: los agentes de larga duración «aún no están listos para uso corporativo por motivos de seguridad», las horas ahorradas por empleado son autodeclaradas y el consejero delegado ha reconocido que ese ahorro no entra en el cálculo de rentabilidad de los proyectos. Es el caso de mayor escala del bloque y el que mejor ilustra la distancia entre capacidad y valor capturado.
CaixaBank: el agente simula el préstamo y el especialista solo firma
Antes. El cliente con un préstamo preconcedido en la app tenía que configurarlo solo —importe, cuotas, plazo— o llamar al gestor; muchos abandonaban a medias.
Después. Desde febrero de 2026, un agente conversa con el cliente, simula «la configuración ideal del préstamo, las cuotas y los plazos», resuelve dudas y, al firmar, «deriva al cliente a un especialista, garantizando que no se pierde ninguna de la información tratada». Primero consumo preconcedido; después hipotecas y ahorro, en una app con más de doce millones de usuarios.
Lo que desaparece: la simulación y la explicación por parte del gestor, documentar e informar al cliente; y el formulario que el cliente abandonaba. Resultado: sin cifras de impacto (nota de prensa del banco, 2026).
Nivel: 2, Prepara, y explícito: el banco decidió que el agente no cierra. Límite: es un lanzamiento, no un resultado. Va en el catálogo por el diseño: un banco español que traza a propósito la línea entre lo que el agente prepara y lo que una persona firma, en un producto que el Reglamento de IA considera de alto riesgo cuando hay evaluación de solvencia. Es exactamente la distinción del artículo 6.3 del Reglamento: un sistema que hace «una tarea preparatoria» puede quedar fuera del alto riesgo; uno que decide sobre la persona, no.
Zurich: leer el condicionado y digitalizar la solicitud del corredor
Antes. En hogar, un tramitador de Zurich UK leía el parte, buscaba la cláusula en el condicionado y decidía si había cobertura: «varios días». En suscripción de empresas, cada solicitud de un corredor llegaba como correo con adjuntos en varios idiomas y un técnico la tecleaba: unos 75 minutos por expediente.
Después. En hogar, un sistema entrenado con más de 20.000 siniestros lee el parte y el condicionado y entrega al tramitador el contexto cotejado (piloto con Sprout.ai, 2021). En suscripción, una capa de Cytora convierte las solicitudes en riesgos estructurados y los entrega priorizados al suscriptor; once países en el segundo trimestre de 2026.
Lo que desaparece: buscar y cotejar en el condicionado y transcribir y teclear la solicitud del corredor. Resultado: en hogar, siniestros «procesados en cuestión de horas» con más del 98 % de precisión en la comprobación de póliza (Zurich UK, piloto de 2021); en suscripción, triaje «de 75 a 15 minutos» y más del 95 % de precisión en solicitudes multilingües (cifra del proveedor con cita de Zurich, 2026).
Nivel: 1-2 en hogar; 3 en suscripción. Límite: el de hogar es un piloto sin cifras posteriores; el de suscripción está en producción pero solo lo cuenta el proveedor. Juntos muestran la secuencia típica del sector: primero IA que lee y coteja sin ejecutar, después un agente que entrega el trabajo hecho.
Dos apuntes para cerrar. BCG describe en un documento de junio de 2026 un «banco global» anónimo en el que un agente clasifica, extrae, verifica y sincroniza los expedientes de préstamo, con straight-through por encima del 90 % en consumo y del 70 % en hipotecas y una productividad más del 50 % mayor; y Aviva, según McKinsey y la propia aseguradora, ha puesto más de ochenta modelos a proponer responsabilidad y enrutar siniestros de auto, con 23 días menos en la evaluación de casos complejos. Son cifras de consultora sobre sus clientes, publicitadas incluso con anuncios pagados, y aquí no valen más que eso.
Y el bloque tiene dos marchas atrás de 2025, Commonwealth Bank y Klarna, que se cuentan más abajo con las demás porque su lección no es de banca: es de secuencia.
| Caso | Lo que desaparece | Resultado | Fuente | Nivel |
| Allianz Australia, Nemo (2025) | Cotejar póliza, meteorología y fraude; calcular | De 4+ días a horas; < 5 min hasta la revisión humana; −80 % tiempo de tramitación | Propia empresa | 2 (la persona paga) |
| Ping An (2019) | Peritación presencial en siniestros leves | Peritación en 5-10 min para el 95,5 %; pago en segundos | Propia empresa | 3-4 |
| Admiral Seguros + Tractable (2021) | El perito revisa cada foto | 12.000 siniestros sin toque; 90 % de valoraciones sin perito | Proveedor con citas del cliente | 3-4 (solo leves) |
| Rocket Mortgage, Rocket Logic (2024) | Transcribir y clasificar documentos | >1 M horas y 40 M$ en 2024; +54 % clientes por equipo | Propia empresa; 8-K a la SEC | 3 |
| HSBC + Google Cloud AML (2023) | Vaciar colas de alertas por reglas | 2-4x más actividad sospechosa real; −60 % alertas | HSBC vía proveedor | 2 |
| DBS, memorandos y Joy (2026) | Redactar el memorando; consultar la cuenta por el cliente | Objetivo ≥ 30 % (no medido); Joy: +61 % usuarios, −7 % contactos | Propia empresa | 2 / 3 |
| JPMorgan, COiN y agentes (2017-2026) | Leer contratos; preparar la mañana del banquero | 360.000 h/año (2017, no auditadas); +20 % ventas banca privada (atribuido) | Prensa citando al banco | 3 / 2-3 |
| CaixaBank, préstamos en la app (2026) | El gestor simula y explica | Sin cifras; diseño con traspaso al especialista | Propia empresa | 2 (por diseño) |
| Zurich, hogar y suscripción (2021-2026) | Leer el condicionado; teclear la solicitud | Horas en vez de días; triaje de 75 a 15 min | Propia empresa (piloto) / proveedor | 1-2 / 3 |
Industria, cadena de suministro y logística: la planificación que ya no se hace en Excel
En operaciones, la ruptura típica no es «más rápido»: es se hace lo que antes no se hacía. Se negocia con el 80 % de proveedores con los que nadie negociaba; se decide planta a planta en lugar de parcela a parcela; se vigilan todos los vuelos a la vez.
Y conviene decir de entrada que las rupturas mejor documentadas del bloque son anteriores a los agentes de 2025: Walmart empezó en 2021, Rio Tinto en 2018, Alaska en 2020, Deere en 2021. Los casos agénticos recientes llevan meses en producción y sus cifras son de primera temporada. El patrón es viejo; el ejecutor es nuevo. Walmart, PepsiCo, Spotify y Uber ya tienen su artículo propio en este blog; aquí Walmart aparece por un proceso distinto.
Walmart: se negocia con los proveedores que nadie negociaba
Antes. Walmart tiene más de 100.000 proveedores. Sus compradores se concentraban en el 20 % principal; el resto firmaba «condiciones estándar que a menudo no se negocian», porque contratar más compradores costaba más que el valor que podían extraer. Con ese 80 % —flotas, equipamiento, carros, bienes que no son para reventa— no había proceso de negociación.
Después. Un bot de negociación por texto de Pactum contacta al proveedor, negocia precio y plazos de pago y cierra dentro de los límites que fija el comprador; el comprador define parámetros, revisa excepciones y gestiona la relación. Piloto de tres meses con 89 proveedores y cinco compradores.
Lo que desaparece: el criterio «no negociar porque no hay quien lo haga»; aparece un proceso donde no lo había, y la pantalla que ya no está es la hoja de condiciones estándar que se firmaba sin leer.
Resultado (Harvard Business Review, noviembre de 2022, con coautores de Walmart): acuerdos con el 64 % de los cien proveedores invitados, cuando el objetivo era el 20 %; once días de media por negociación; 1,5 % de ahorro y 35 días más de plazo de pago. En el escalado, empresa y proveedor declaran un 68 % de cierre y un 3 % de ahorro sobre más de 2.000 proveedores.
Nivel: 3-4: el bot cierra dentro de parámetros; la persona audita. Límite: el ahorro es modesto, pero antes era cero; un caso académico de 2025 señala tensiones con proveedores por la falta de trato personal; y es cola larga, no contratos estratégicos.
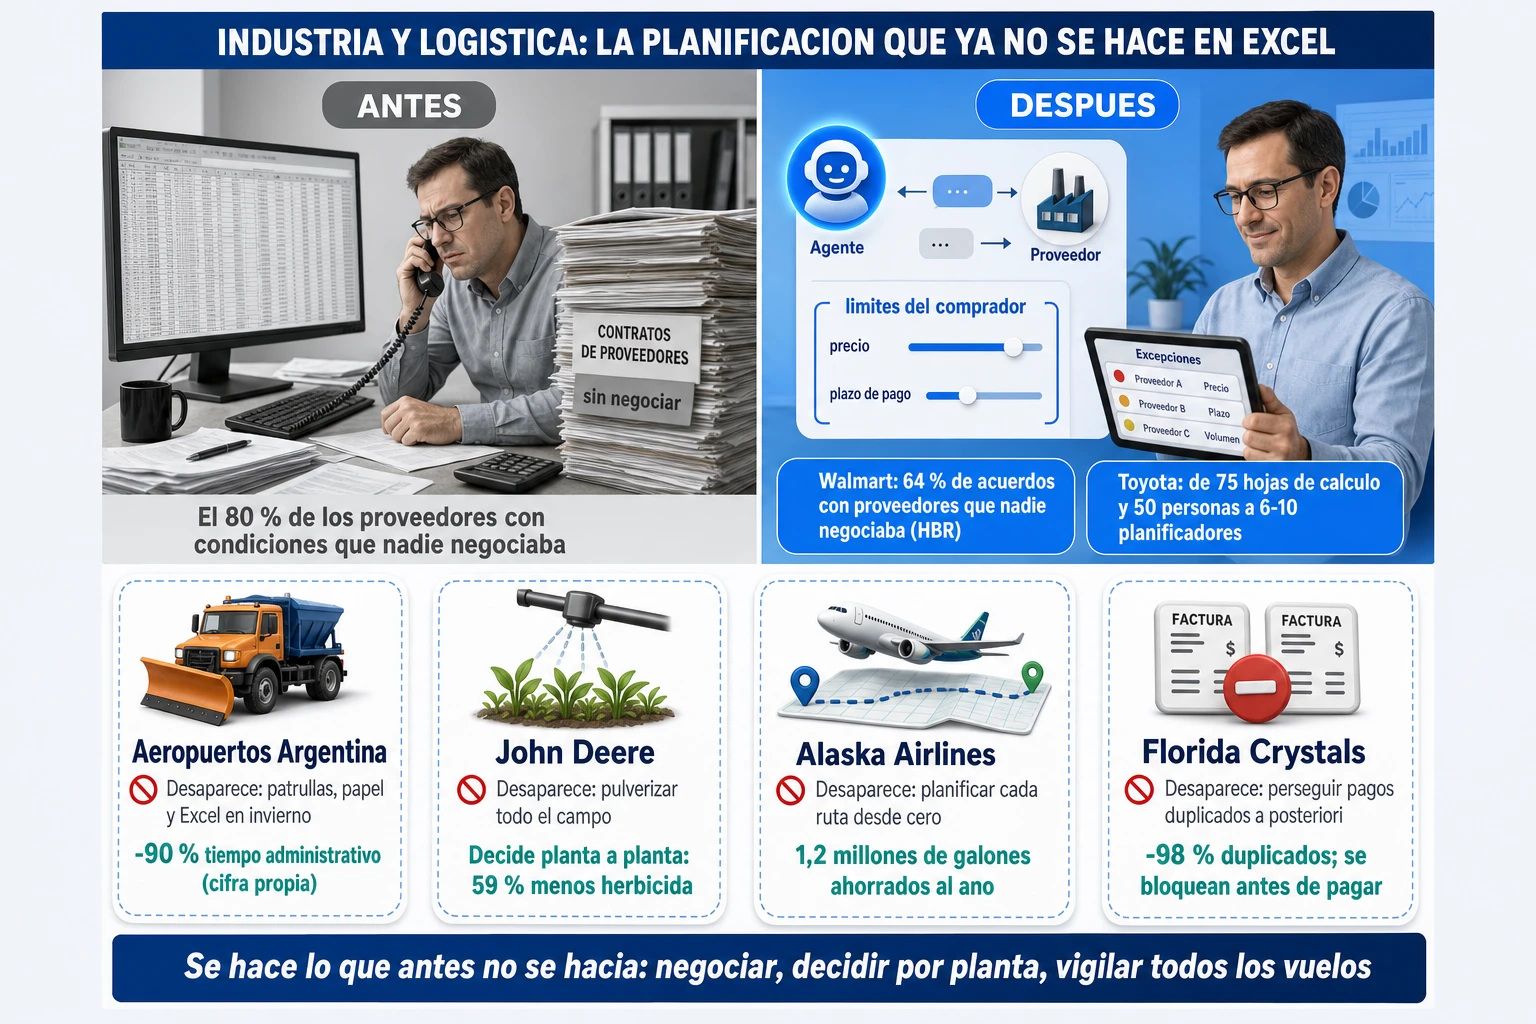
Aeropuertos Argentina: la orden de trabajo nace validada
Antes. En los aeropuertos patagónicos del operador de 35 aeropuertos argentinos, las operaciones de invierno se gestionaban con patrullas en vehículo por las pistas, registros en papel, hojas de cálculo y la observación visual como método principal; coordinación fragmentada entre torre y operarios y desperdicio de urea y glicol.
Después. SNOW, un agente sobre SAP desarrollado con una consultora local, integra el Servicio Meteorológico Nacional, los sensores de pista, los drones y la disponibilidad de camiones, químicos y personal; detecta anomalías, genera alertas, crea y libera las órdenes de trabajo, valida materiales y sigue la ejecución desde el móvil.
Lo que desaparece: la cadena «patrulla, papel, llamada, orden manual»; transcribir y teclear del papel al sistema y buscar y cotejar meteorología, sensores y recursos.
Resultado (cifras declaradas por la empresa en su candidatura a un premio del proveedor, noviembre de 2025, primera temporada): −16 % de costes directos, −90 % de tiempo administrativo, 45 toneladas de CO2 equivalente al año evitadas y papel eliminado; ocho aeropuertos en producción desde principios de 2026.
Nivel: 3, Ejecuta y deja traza: crea y libera órdenes; las personas ejecutan en pista y auditan. Límite: cifras no auditadas, publicadas dentro del ecosistema del proveedor y de una sola temporada. Aun así, es uno de los pocos casos agénticos de 2025-2026 en operaciones físicas con un antes descrito con esa honestidad —papel, Excel y ojos— y un después que se puede comprobar en una pista.
Toyota: retirar entre 50 y 100 pantallas de mainframe
Antes. Para saber dónde estaba un vehículo entre la prefabricación y la entrega al concesionario, un empleado de Toyota en Norteamérica navegaba por sistemas mainframe «de décadas» a través de 50-100 pantallas. La planificación de recursos se hacía con 75 hojas de cálculo, más de 50 personas y horas extra.
Después. Una herramienta de gestión de vehículos «retira esas 50-100 pantallas» y da datos en tiempo real; agentes redactan de madrugada los correos al proveedor logístico para priorizar cargas y explican a los concesionarios lo hecho «antes de que el empleado llegue por la mañana»; un sistema global de planificación sustituye las hojas y deja entre seis y diez planificadores.
Lo que desaparece: buscar y cotejar entre pantallas de mainframe y documentar e informar al transportista y al concesionario; el empleado deja de ser el integrador humano entre sistemas y hojas.
Resultado: solo cualitativo y de alcance —las pantallas retiradas, de 75 hojas y 50 personas a 6-10 planificadores, «minutos en lugar de horas extra»—, según el vicepresidente de innovación digital de Toyota entrevistado en el informe de tendencias de una consultora (diciembre de 2025).
Nivel: 2, Prepara, en los correos; partes en 3 en la planificación. Límite: fuente secundaria, sin porcentajes, e iniciativas descritas en despliegue. Se incluye por la frase del directivo, que resume mejor que cualquier cifra lo que este artículo defiende: «el diferenciador no es quién tiene el mejor algoritmo; es quién puede incrustar la IA en las decisiones diarias sin romper la confianza».
Florida Crystals y Renault: el pago duplicado se bloquea antes, no se persigue después
Antes. En la azucarera Florida Crystals, los pagos duplicados se perseguían de forma reactiva y con «evidencia anecdótica», y nadie veía los problemas aguas arriba, en compras. En Renault, los síntomas —pagos tardíos, en exceso, duplicados— se conocían, pero la causa raíz no.
Después. Con la minería de procesos de Celonis, un modelo de datos que une compras y cuentas por pagar, con coincidencia difusa que detecta duplicados y bloquea automáticamente el pago, alertas de descuentos por pronto pago a punto de perderse y facturas priorizadas por impacto en caja. Renault montó un centro de excelencia que mezcla TI con metodólogos Lean y prepara una IA para predecir pagos tardíos.
Lo que desaparece: conciliar y verificar a posteriori; el control pasa de auditoría posterior a bloqueo previo, y la pantalla que ya no está es el informe de duplicados que alguien revisaba meses después.
Resultado: Florida Crystals, −98 % de pagos duplicados en los primeros meses y «millones» de capital circulante en menos de un año (directivos citados en el caso del proveedor y en prensa tecnológica, 2026); Renault, un millón de euros en tres meses y quince millones en doce (según Renault, en el caso del proveedor).
Nivel: 1-2, Recomienda y Prepara: alertas y bloqueos con revisión humana. Límite: ninguna de las dos tiene un agente que escriba al proveedor pidiendo evidencia, aunque así se cuenta a veces; «millones» no está cuantificado; y ninguna afirma procesar facturas sin intervención. Funciona precisamente porque primero midió el flujo real y luego decidió dónde bloquear.
John Deere: de pulverizar el campo a decidir planta a planta
Antes. El herbicida se aplicaba de forma uniforme a todo el campo; la dosis la decidía el agrónomo por parcela. Después. Cámaras en el brazo del pulverizador y procesadores a bordo escanean más de 2.500 pies cuadrados por segundo a hasta 15 millas por hora; cada boquilla se abre solo donde hay una mala hierba. El agricultor configura y conduce; la decisión por planta la toma la máquina en milisegundos. Desde 2025, Deere cobra por acre solo si hay ahorro.
Lo que desaparece: la decisión humana de dosis por parcela; es aprobar lo rutinario llevado al límite, millones de microdecisiones que nadie podía tomar. Resultado (cifras de John Deere, agregadas de la telemetría de sus clientes): en 2024, un 59 % de ahorro medio de herbicida en más de un millón de acres; en 2025, alrededor del 50 % en más de cinco millones de acres, con un ahorro medio declarado de 12,63 dólares por acre.
Nivel: 5, Opera de forma autónoma, en la boquilla; 2, Prepara, en la explotación, donde el agricultor fija los parámetros. Límite: Deere mide el ahorro de sus clientes con su propia telemetría; el ahorro es en herbicida no residual; y el equipo es caro, de ahí la garantía. Es el ejemplo más limpio del catálogo de nivel 5 acotado por radio: autónomo en un centímetro, humano en la finca.
Alaska Airlines: el despachador deja de planificar cada vuelo desde cero
Antes. Los despachadores planificaban cada vuelo con meteorología, vientos, restricciones y tráfico, vuelo a vuelo. Después. Flyways, de Air Space Intelligence, vigila continuamente el sistema completo y propone rutas seguras y conformes con el control aéreo que ahorran combustible y evitan congestión; despachadores y pilotos aceptan o rechazan. Alaska fue la primera aerolínea en usarlo, en 2020, y renovó en 2024.
Lo que desaparece: la planificación individual y secuencial; buscar y cotejar fuentes por vuelo se convierte en una optimización continua que la persona aprueba. Resultado (cifras de la aerolínea, agosto de 2024): más de 1,2 millones de galones de combustible y 11.958 toneladas de CO2 evitadas en el último año; oportunidades de optimización en el 55 % de los vuelos; un 3-5 % de ahorro en vuelos de más de cuatro horas.
Nivel: 1-2, Recomienda y Prepara. Límite: no publica qué proporción de recomendaciones se acepta, y el ahorro se concentra en vuelos largos. Es apoyo a la decisión, no ejecución; pero la pregunta que responde —«¿qué ruta conviene ahora, vistos todos los vuelos a la vez?»— es una que ningún despachador podía hacerse.
Rio Tinto: el puesto se muda de la cabina a un centro de control a 1.500 km (precedente)
Antes. Trenes de mineral de hierro de unos 2,5 kilómetros —tres locomotoras, unos 240 vagones, 28.000 toneladas— circulaban por el Pilbara australiano con maquinista a bordo en ciclos de unas 40 horas y 800 kilómetros, con relevos en ruta.
Después. AutoHaul, desarrollado con Hitachi Rail y otros socios: los trenes circulan sin conductor y se vigilan desde el centro de operaciones de Perth, a más de 1.500 kilómetros. Primera entrega autónoma en julio de 2018; despliegue completo en diciembre de 2018.
Lo que desaparece: el maquinista de la cabina y la dependencia de turnos y relevos; la pantalla que aparece es la del centro de control.
Resultado (notas de Rio Tinto y de su socio, 2018-2019): programa de 940 millones de dólares australianos, red de más de 1.700 kilómetros y unas 200 locomotoras, más de 4,5 millones de kilómetros autónomos a junio de 2019 y un 6 % más de velocidad media.
Nivel: 4-5, autónomo con supervisión remota. Límite: es automatización determinista con sensores y control centralizado, no agentes. Va como precedente de la ruptura organizativa que hoy se atribuye a los agentes: el puesto no desaparece, se muda. Y la empresa lo acompañó con «no esperamos despidos en 2019»: la ruptura se vendió como recolocación, no como recorte.
DHL, Ocado y Amazon: la persona sale del bucle físico y entra en el de excepciones
Antes. En DHL Supply Chain, descargar contenedores era levantar y girar cajas dentro de un remolque helado en invierno y «peligrosamente caluroso» en verano, un puesto de alta rotación y lesiones. En Ocado, los robots de la rejilla llevaban las cajas a estaciones donde personas preparaban cada pedido a mano. En Amazon, el operario recorría pasillos hasta la mercancía.
Después. El robot Stretch descarga de forma autónoma cajas de hasta 23 kilos y el operario lo posiciona y resuelve excepciones; los brazos de Ocado recogen artículos directamente sobre la rejilla, 24 horas, y las personas se quedan con lo que el robot no puede coger; Amazon opera más de un millón de robots en más de 300 centros con un modelo generativo, DeepFleet, como controlador de tráfico.
Lo que desaparece: el trabajo físico como puesto; el picking y la descarga pasan a ser excepciones. Resultado: DHL declara hasta 700 cajas por hora por robot y un acuerdo en 2025 para más de mil unidades adicionales; Ocado publica en sus resultados anuales que las unidades por hora de trabajo pasaron de 191 a 220 entre 2023 y 2024 y subieron otro 8 % en 2025, con alrededor del 50 % del volumen recogido por robot en su centro más avanzado; Amazon declara un 10 % menos de tiempo de desplazamiento de la flota con DeepFleet.
Nivel: 4, Ejecuta salvo excepción. Límite: el «hasta 700» es un máximo sin media; Ocado sube productividad pero acumula años de pérdidas y dos incendios (2019 y 2021): la ruptura operativa no garantiza el negocio; y Amazon retiró en 2024 su tienda sin caja tras revelarse que se apoyaba en revisores en la India. Ese caso va en la lista de los que salieron mal, con la pregunta que sirve para todo el bloque: no si hay una persona, sino dónde está.
Coca-Cola Singapur: la secuencia de producción la decide un algoritmo que agrupa pedidos
Antes. En la planta de concentrado de Tuas, un plan de producción fijo frente a un volumen creciente y una cartera cada vez más compleja: cambios de línea frecuentes e inspección de calidad por muestreo manual.
Después. Una programación dinámica que reprograma en tiempo real y consolida pedidos similares para reducir cambios de línea; más de 150 estaciones industriales conectadas cuyos algoritmos aprenden de pruebas anteriores; inspección visual por IA; cobots con visión para el embalaje.
Lo que desaparece: la secuenciación manual y el muestreo; clasificar y enrutar pedidos a la línea lo hace el algoritmo, y conciliar y verificar la calidad se hace de forma predictiva.
Resultado (cifras de la empresa en su designación como fábrica faro del Foro Económico Mundial, publicadas por la agencia de desarrollo de Singapur, octubre de 2024): +28 % de producción, +70 % de productividad laboral, −80 % de faltantes, +31 % de entregas a tiempo.
Nivel: 2-3. Límite: las fábricas faro publican cifras que la empresa aporta y que el Foro y su consultora revisan, sin auditoría externa ni periodo base. Y una precisión: este caso circula a veces atribuido a plataformas de bots que trabajan con otras embotelladoras del grupo; la planta de Tuas es programación, sensores y visión, no bots.
Tres apuntes para cerrar el bloque. Shein describe en su folleto de salida a bolsa de 2026 un modelo de lotes iniciales de 100-200 unidades, reposición en cinco días y asignación automática de pedidos a unos 7.500 fabricantes: la decisión de fabricar la toma el dato de venta, no el comprador de temporada; el folleto no publica la tasa de inventario no vendido, y las cifras que circulan sobre ello no están en ninguna fuente de la empresa.
En inspección con robots, National Grid usa un cuadrúpedo para recorrer en marcha una sala de tiristores a 450 kilovoltios en la que no puede entrar nadie, y Chevron los despliega para inspeccionar «con más frecuencia de la que podemos hoy»: pilotos, sin cifras.
Y en mantenimiento predictivo hay que decirlo con claridad: no existe un caso nombrado con cifra propia de la empresa usuaria que este artículo pueda citar; las cifras que circulan —«10-40 % menos coste de mantenimiento, hasta 50 % menos paradas»— son estimaciones de McKinsey de 2015-2017 reproducidas en blogs de proveedores, y el único gestor de infraestructura español investigado tiene un objetivo, no un resultado. Quien vea «−20 % de paradas» sin nombre de empresa está viendo una estimación con ropa de dato.
| Caso | Lo que desaparece | Resultado | Fuente | Nivel |
| Walmart + Pactum (2021-2025) | «No negociar» con la cola larga | 64 % de acuerdos (objetivo 20 %), 1,5 % ahorro, +35 días de plazo; 68 % y 3 % al escalar | HBR con coautores de Walmart; empresa | 3-4 |
| Aeropuertos Argentina, SNOW (2025-2026) | Patrulla, papel, llamada y orden manual | −16 % costes directos, −90 % tiempo administrativo, 45 t CO2e | Propia empresa (premio del proveedor) | 3 |
| Toyota (2025) | Navegar 50-100 pantallas; 75 hojas de cálculo | De 50+ personas a 6-10 planificadores; correos redactados de madrugada | Directivo citado por consultora | 2-3 |
| Florida Crystals y Renault + Celonis (2021-2026) | Perseguir duplicados a posteriori | −98 % pagos duplicados; 1 M€ en 3 meses y 15 M€ en 12 | Directivos citados por el proveedor | 1-2 |
| John Deere, See & Spray (2024-2025) | La dosis por parcela | 59 % menos herbicida en >1 M acres; ~50 % en >5 M acres | Propia empresa (telemetría de clientes) | 5 boquilla / 2 finca |
| Alaska Airlines, Flyways (2020-2024) | Planificar cada vuelo desde cero | 1,2 M galones y 11.958 t CO2 al año; 55 % de vuelos con oportunidad | Propia empresa | 1-2 |
| Rio Tinto, AutoHaul (2018-2019) | El maquinista en la cabina | >4,5 M km autónomos; +6 % velocidad media; 940 M A$ | Propia empresa | 4-5 |
| DHL, Ocado, Amazon (2023-2025) | Descargar, recoger y desplazarse a mano | 700 cajas/h; 191 → 220 unidades/hora de trabajo; −10 % desplazamiento de flota | Propias empresas; resultados anuales | 4 |
| Coca-Cola Singapur (2024) | Secuenciar a mano; muestrear calidad | +28 % producción, +70 % productividad laboral, −80 % faltantes | Empresa vía WEF y EDB | 2-3 |
Atención al cliente, ventas y personas: el trabajo después de la llamada
El contact center es donde más se ha prometido y donde más se ha desandado. Hay dos rupturas distintas que no conviene mezclar: la persona deja de redactar y pasa a revisar (nivel 2, la más extendida y la que menos se revierte), y la persona deja de descolgar primero y entra solo cuando hay que hacer algo que el agente no puede (nivel 4, la que más se vende y la que más marchas atrás acumula). Y una tercera, más silenciosa, en recursos humanos: el departamento deja de tramitar. Los fallos —Klarna, Commonwealth Bank, McDonald’s, DPD, Air Canada— aparecen aquí en una línea y se explican más abajo.
Octopus Energy: el agente ya no redacta, revisa
Antes. Un agente de atención de la energética británica leía el correo del cliente, buscaba en los sistemas la cuenta y la tarifa, redactaba la respuesta y la enviaba.
Después. Desde febrero de 2023, la IA generativa de Kraken, la plataforma del grupo, lee el correo, consulta el contexto de la cuenta y redacta una respuesta personalizada; el agente la revisa y la envía. A finales de abril de 2023 respondía ya el 34 % de las consultas.
Lo que desaparece: documentar e informar desde cero y buscar y cotejar la cuenta; el agente deja de escribir y pasa a aprobar, y la pantalla que ya no está es el correo en blanco.
Resultado (artículo del consejero delegado, Greg Jackson, en The Times del 8 de mayo de 2023, recogido por tres medios): la IA hacía «el trabajo de 250 personas» tres meses después del lanzamiento, y los correos con IA obtenían un 80 % de satisfacción frente al 65 % de los redactados por personas; Jackson descartó despidos.
Nivel: 2, Prepara. Límite: «250 personas» es equivalencia de carga, no plantilla eliminada; y las cifras se mueven según la fecha y el escenario donde las cuenta la empresa. Es producción, y el caso de nivel 2 en atención al cliente con mejor relación entre lo que promete y lo que ha durado.
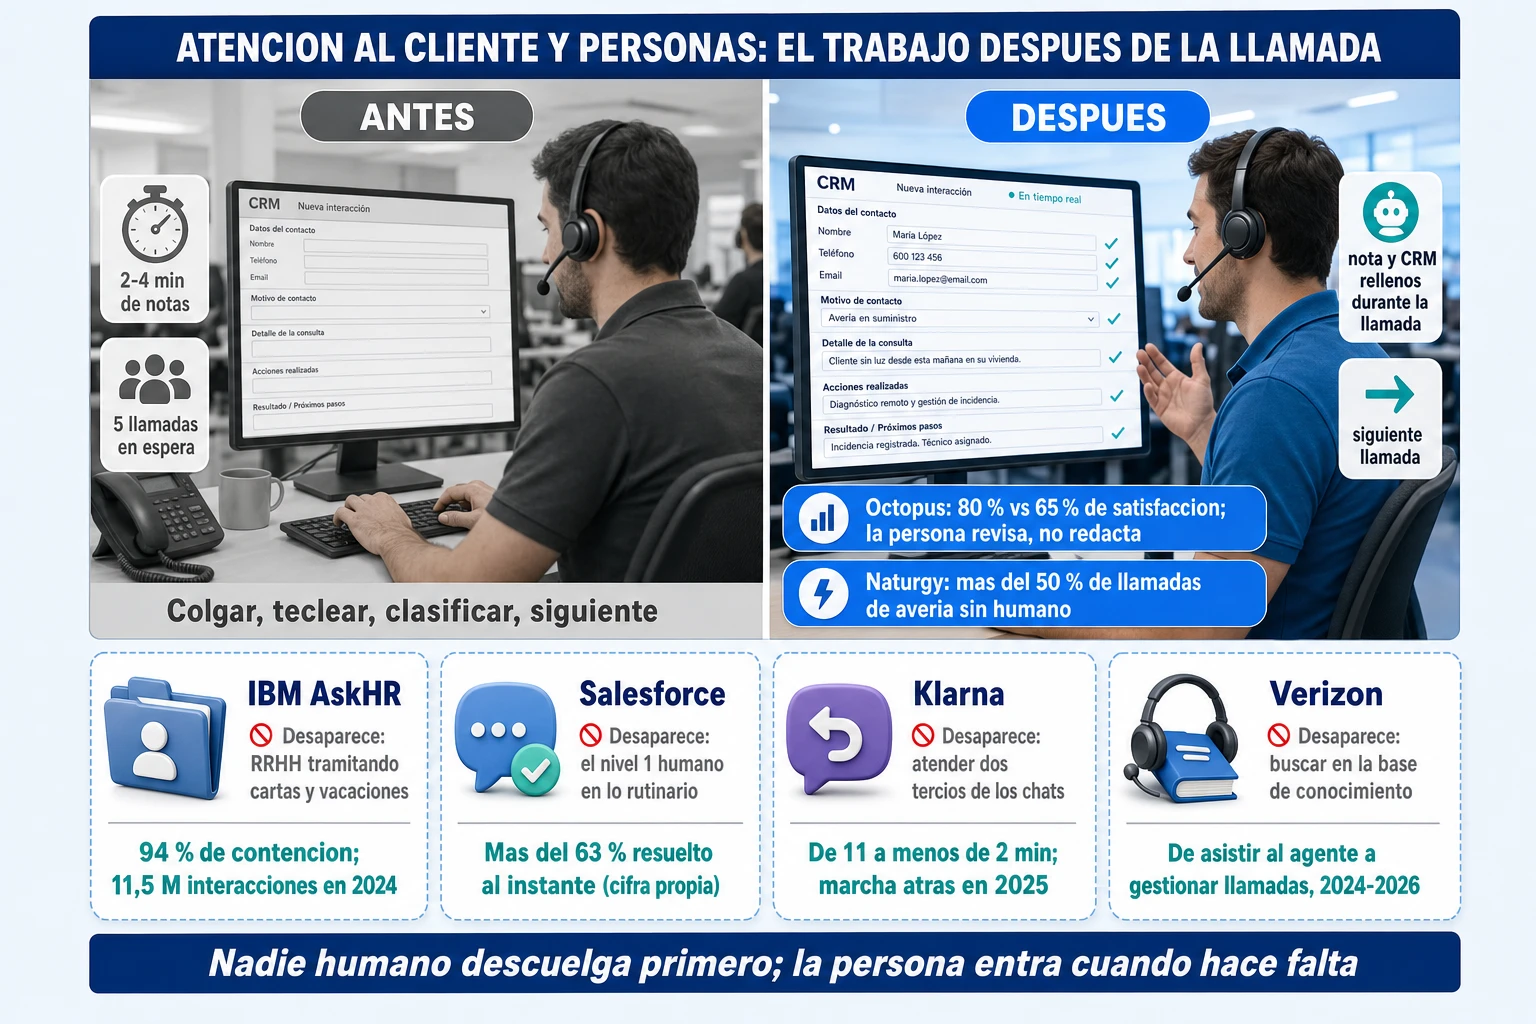
Naturgy: nadie descuelga la llamada de avería
Antes. El cliente con una avería llamaba a un contact center; un agente le identificaba, consultaba el contrato y la cobertura, hacía las preguntas de diagnóstico, registraba la interacción y programaba al técnico.
Después. Desde 2026, un agente de voz, «Dani», construido con la startup HappyRobot, atiende la llamada de avería: verifica la identidad con un código de un solo uso, consulta contrato y cobertura en tiempo real, guía el diagnóstico, registra la interacción y deriva a una persona solo si hay que enviar un técnico, con garantía de menos de tres horas.
Lo que desaparece: el humano que descuelga primero; clasificar y enrutar la llamada y transcribir la interacción al sistema. Resultado (prensa especializada en relación con clientes, julio de 2026, citando al responsable de transformación con IA generativa de Naturgy): «más del 50 % de las llamadas se gestionan sin intervención humana y de forma autónoma», con objetivo del 90 % a final de 2026 y una satisfacción de 9,4 sobre 10 en las primeras semanas; la empresa dice medir la tecnología «no por el ahorro, sino por cuánto mejora la experiencia del cliente».
Nivel: 4, Ejecuta salvo excepción, donde la excepción es «hay que mover un técnico». Límite: primeras semanas, no serie histórica; el 90 % es objetivo; no se ha localizado nota de prensa propia; y el precedente del grupo, la distribuidora Nedgia con agentes virtuales desde 2025, no publicó cifras. Con esas cautelas, es el caso español más claro de «el proceso cambia», no solo se acelera.
IBM AskHR: recursos humanos deja de tramitar
Antes. «Procesos en silos» y «fuerte dependencia de tareas manuales y repetitivas», según la propia IBM: el empleado abría un ticket o llamaba y un equipo de recursos humanos tramitaba cartas, vacaciones, nóminas y cambios de datos.
Después. AskHR, que empezó en 2016 y hoy corre sobre la plataforma de agentes de la casa, responde y ejecuta: cartas de empleado, solicitudes de vacaciones, acceso a nómina, cambios de compensación y de estructura organizativa; más de ochenta tareas automatizadas. Lo que no resuelve va a un especialista.
Lo que desaparece: aprobar lo rutinario y transcribir la petición al sistema; recursos humanos se queda con lo que no es fórmula, y la pantalla que ya no está es la cola de tickets.
Resultado (caso de IBM sobre sí misma): más de 11,5 millones de interacciones en 2024, un 94 % de contención de las preguntas comunes, más de un millón de transacciones ejecutadas, un 40 % de reducción del coste operativo del equipo en cuatro años y un 75 % menos de tickets desde 2016. Arvind Krishna dijo al Wall Street Journal en mayo de 2025 que la IA había sustituido a «varios cientos» de empleados de recursos humanos y que el empleo total había subido porque el ahorro se invertía en ingeniería, ventas y marketing.
Nivel: 4, Ejecuta salvo excepción. Límite: IBM es a la vez usuaria y proveedora, así que las cifras de coste son suyas; «contención» mide lo que no pasa a un humano, no lo que se resolvió bien; y los titulares sobre miles de despidos y recontrataciones son elaboración de prensa sin fuente. Con todo, es el caso de nivel 4 en procesos internos mejor documentado en el tiempo: nueve años de serie.
DoorDash: el repartidor ya no espera a un agente
Antes. «Cientos de miles de llamadas al día» de consumidores, restaurantes y repartidores, «la mayoría redirigidas a agentes en vivo»; el repartidor, en carretera, esperaba.
Después. Un agente de voz sobre Amazon Connect y los modelos de Bedrock, con recuperación sobre la base de conocimiento, resuelve problemas de la aplicación, altas, pagos y preguntas frecuentes con una latencia de dos segundos y medio o menos, y escala a una persona con el contexto ya recogido. Se construyó en ocho semanas.
Lo que desaparece: la espera y la transferencia; clasificar y enrutar lo hace el agente y lo rutinario ya no llega a una persona. Resultado (caso publicado por el proveedor de nube con nombres y citas de directivos de DoorDash, 2024): un 49 % menos de transferencias a agente humano, un 12 % más de resolución en el primer contacto y tres millones de dólares de ahorro operativo interanual.
Nivel: 3-4. Límite: material del proveedor; no se publica la tasa de resolución absoluta ni la satisfacción del repartidor; y en 2025 la empresa publicó con otro proveedor cifras distintas sobre otro indicador, lo que recuerda que en este sector cada proveedor mide lo suyo. Es producción, y la ruptura es la de Naturgy con otro usuario: quien llama no espera a nadie.
Verizon: primero el agente deja de buscar; después deja de ser el primer interlocutor
Antes. 28.000 representantes de atención y tiendas de Verizon buscaban a mano en una base de conocimiento de unos 15.000 documentos mientras hablaban con el cliente.
Después, en dos fases. Entre julio de 2024 y enero de 2025, un asistente sobre Gemini les da en pantalla respuestas en tiempo real y sugiere preguntas; el representante habla en vez de buscar. En agosto de 2026, Google y Verizon anuncian que el sistema «gestiona la mayoría de las llamadas y chats entrantes de consumo al mes», y los representantes quedan para lo complejo.
Lo que desaparece: primero buscar y cotejar durante la llamada; después, el primer interlocutor humano. Resultado: en la fase 1, el proveedor habla de un «95 % de capacidad de respuesta» y el consejero delegado de la unidad de consumo dijo a Reuters en abril de 2025 que las ventas a través del equipo de atención habían subido «casi un 40 %»; en la fase 2, «mejoras medibles en satisfacción y resolución automatizada», sin cifra (notas del proveedor con citas de Verizon; el 40 % vía Reuters).
Nivel: de 1, Recomienda, a 4, Ejecuta salvo excepción, en dos años. Límite, y es el que más enseña: en el mismo trimestre en que la IA subía las ventas un 40 %, Verizon perdió 356.000 líneas de pospago, frente a 194.000 un año antes. Una métrica de proceso subía mientras una métrica de negocio empeoraba. Y la afirmación de 2026 sobre «la mayoría de las llamadas» no trae porcentaje ni tasa de resolución.
Salesforce sobre sí misma: tres cifras distintas para el mismo portal
Antes. Sesenta millones de visitas anuales al portal de ayuda, unos dos millones de solicitudes de soporte al año, 740.000 artículos entre los que buscar y 9.000 agentes de soporte.
Después. Desde octubre de 2024, su propio producto de agentes atiende el portal 24 horas en siete idiomas, resuelve y escala a un ingeniero de soporte con el contexto. La empresa se llama a sí misma «cliente cero».
Lo que desaparece: el nivel 1 humano para lo rutinario; clasificar y enrutar y buscar y cotejar en la base de conocimiento.
Resultado, y aquí conviene ir despacio, porque la misma empresa ha publicado tres cifras: la ficha de cliente de 2025 habla de un 76 % de resolución sin intervención humana y un 5 % de escalado; la página de «cliente cero» de 2026 dice «más de cinco millones de conversaciones» y «más del 63 % resueltas al instante»; y el consejero delegado, en abril de 2025, hablaba de un 85 % y de que «aproximadamente la mitad» de los 9.000 agentes de soporte «podrá pasar a otros puestos, de ingresos». Todo es cifra del proveedor sobre sí mismo.
Nivel: 4, con el 5 % de escalado declarado. Límite: «resuelto al instante» no significa «resuelto correctamente»; y lo que circula como «despidió a cuatro mil agentes» procede de un podcast, sin ningún documento a inversores, así que aquí no se afirma. La discrepancia entre 63, 76 y 85 no es un detalle: es el dato. Cuando una empresa da tres tasas de resolución, la pregunta correcta es cuál va en el cuadro de mando y quién la audita.
Tres apuntes más. En selección de personal, el precedente es Unilever (2016-2019): 1,8 millones de solicitudes al año cribadas con juegos cognitivos y entrevistas en vídeo analizadas por algoritmo, con las personas solo en la última etapa; de cuatro meses a cuatro semanas, según una revisión académica y prensa con cifras que no coinciden entre fuentes.
El contraejemplo es de la misma época: Amazon descartó en 2017 una herramienta de cribado entrenada con currículos mayoritariamente masculinos que penalizaba la palabra «women’s», según Reuters. El Reglamento de IA clasifica la selección de personal como alto riesgo (Anexo III, punto 4): aquí «el sistema criba y la persona decide» no es una elección de diseño, es una obligación. Sobre el onboarding, del que se habla mucho, no hay ningún caso con nombre de empresa y cifra propia que este artículo pueda citar.
Y queda Klarna, el caso más citado del sector: en febrero de 2024 su asistente atendía dos tercios de los chats con un tiempo de resolución que pasó de once minutos a menos de dos, y en mayo de 2025 su consejero delegado reconoció que el coste había sido «un factor demasiado dominante» y que el resultado fue «menor calidad». Ya se contó en el artículo sobre arquitectura agéntica; aquí vuelve en la lista de los que se revirtieron, junto con DPD, cuyo chatbot insultó a la propia empresa a petición de un cliente, Air Canada, condenada por lo que su chatbot dijo sobre una tarifa, y McDonald’s, que apagó su pedido por voz tras tres años de pruebas.
| Caso | Lo que desaparece | Resultado | Fuente | Nivel |
| Octopus Energy / Kraken (2023) | Redactar el correo | «Trabajo de 250 personas»; 80 % vs 65 % de satisfacción | CEO en prensa (mayo 2023) | 2 |
| Naturgy + HappyRobot (2026) | Descolgar primero; registrar la avería | >50 % de llamadas sin humano; 9,4/10; objetivo 90 % | Prensa citando a la empresa | 4 |
| IBM AskHR (2016-2025) | Tramitar transacciones de RRHH | 11,5 M interacciones, 94 % contención, >1 M transacciones, −40 % coste en 4 años | IBM sobre sí misma; CEO en WSJ | 4 |
| DoorDash + AWS (2024) | Esperar a un agente; transferir | −49 % transferencias, +12 % resolución en primer contacto, 3 M$ | Proveedor con citas del cliente | 3-4 |
| Verizon + Google (2024-2026) | Buscar en la base de conocimiento; después, descolgar | «95 % answerability»; ventas +≈40 %; «mayoría de llamadas» sin cifra | Proveedor; Reuters | 1 → 4 |
| Salesforce, cliente cero (2024-2026) | Nivel 1 humano en el portal | 63 / 76 / 85 % según canal y fecha; 5 % escalado | Proveedor sobre sí mismo | 4 |
| Unilever (2016-2019) y Klarna (2024-2025) | Cribar currículos; nivel 1 en el chat | De 4 meses a 4 semanas; 2/3 de chats y luego «menor calidad» | Revisión académica; propia empresa y Bloomberg | 2-3; 3-4 → mixto |
TI y software: el ticket que se resuelve antes de que alguien lo lea
En tecnología, el rediseño tiene una ventaja que ningún otro sector tiene: gran parte del trabajo se puede verificar automáticamente. Una migración pasa los tests o no; una petición de software se aprovisiona o no. Por eso aquí aparecen los niveles 3 y 4 con más naturalidad que en salud o banca. Y tiene una trampa simétrica: los estudios serios dicen «propone», no «resuelve», y la percepción de productividad va por delante de la productividad medida.
ServiceNow sobre sí misma: el nivel 1 desaparece de lo rutinario
Antes. Un nivel 1 humano leyendo tickets, aprovisionando software a mano, reclamando licencias y atendiendo peticiones rutinarias. Después. «Fuerzas de trabajo agénticas» para operaciones de TI, soporte a clientes, seguridad y despliegue de software; las personas «supervisan, entrenan y enseñan» a los agentes desde la misma plataforma. La empresa es a la vez usuaria y fabricante.
Lo que desaparece: clasificar y enrutar tickets y aprobar lo rutinario en peticiones de software; la pantalla que ya no está es la cola de nivel 1.
Resultado (nota de prensa de julio de 2025, cifra del proveedor sobre su propia operación): el 97 % de las solicitudes de aprovisionamiento de software automatizadas, el volumen del service desk reducido «casi un 40 %», el 85 % de las peticiones rutinarias de soporte interno «resueltas de forma autónoma» y un departamento que escala más de un 40 % sin contratar; en soporte a clientes, el 80 % de los casos complejos de administración de instancias con agente y la mitad de tiempo de resolución.
Nivel: 4, Ejecuta salvo excepción. Límite: «resuelto de forma autónoma» no está definido —¿cerrado sin humano? ¿sin reapertura?— y es el fabricante contando su caso. Sirve como orden de magnitud, no como prueba; y las cifras con otros porcentajes sobre «primera respuesta» o «tickets mal enrutados» que circulan no aparecen en ningún caso de cliente localizable.
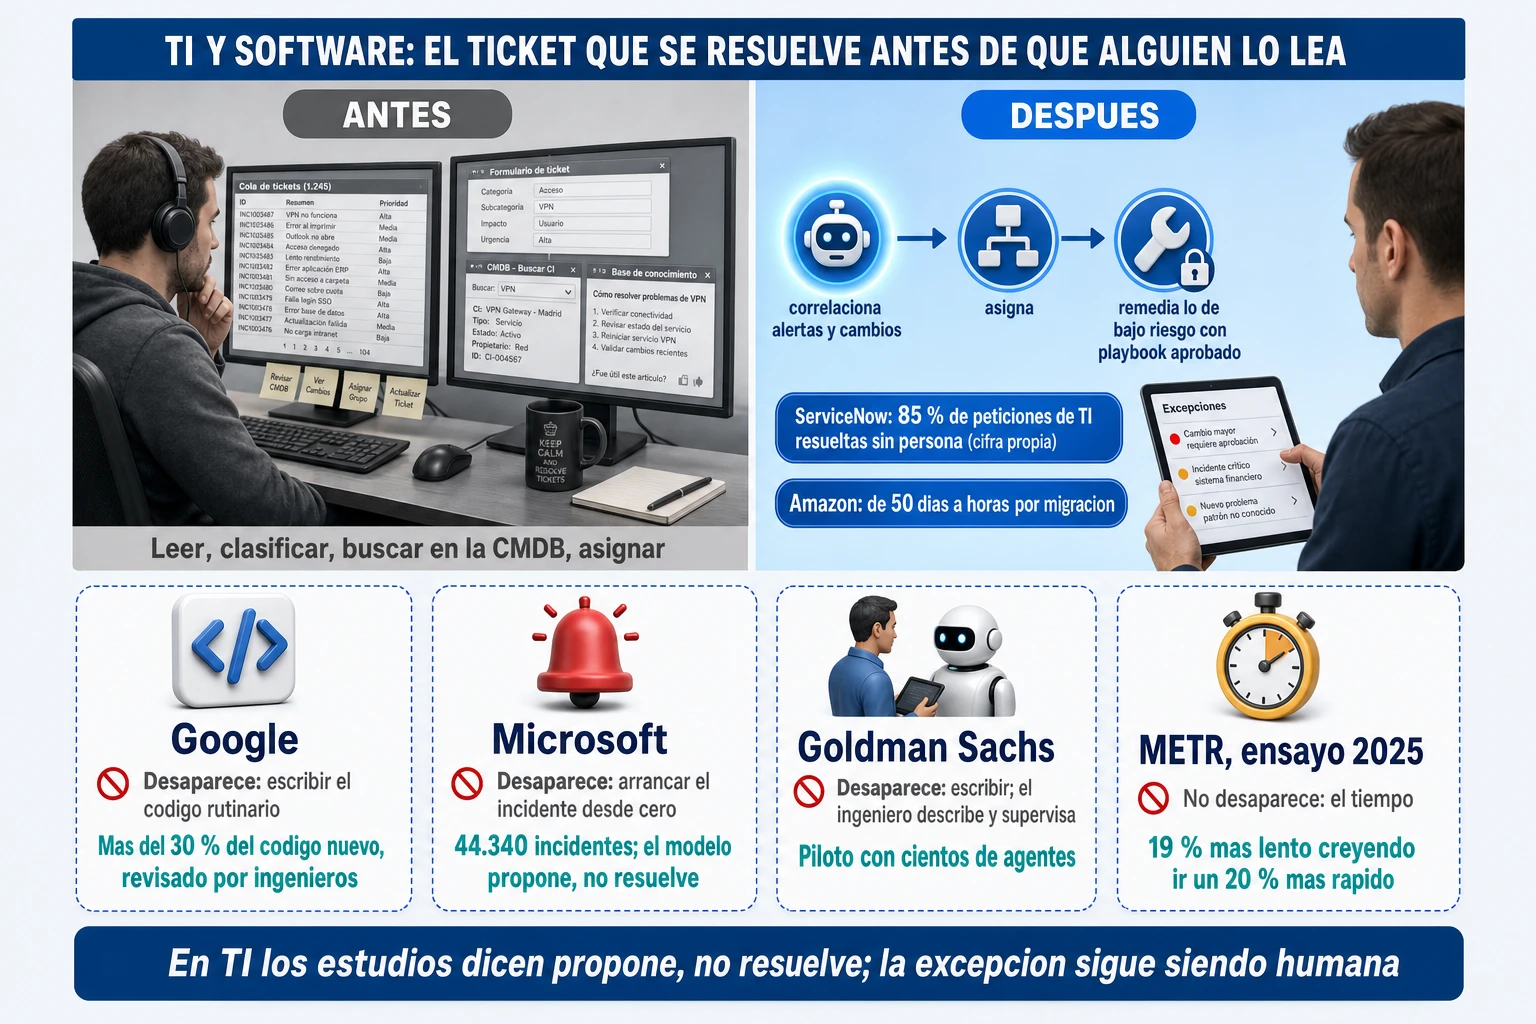
Amazon: el desarrollador ya no migra, revisa lo migrado
Antes. Actualizar una aplicación de Java 8 u 11 a Java 17 costaba «típicamente 50 días-desarrollador», un trabajo que, en palabras de Andy Jassy, se «temía o posponía».
Después. El agente de transformación de Amazon Q Developer analiza las dependencias, genera los cambios y abre la solicitud de integración; el desarrollador la revisa. «Decenas de miles de aplicaciones de producción» migradas.
Lo que desaparece: la migración como tarea humana; es aprobar lo rutinario en su versión técnica, con el test como criterio de rutina. Resultado (Amazon sobre sí misma, agosto de 2024; la empresa es también el proveedor): el tiempo medio por aplicación pasó «de 50 días-desarrollador a solo unas horas», 4.500 años-desarrollador ahorrados, 260 millones de dólares anuales en ganancias de eficiencia y «el 79 % de las revisiones de código autogeneradas integradas sin cambios».
Nivel: 3, Ejecuta y deja traza. Límite: el 79 % implica que un 21 % necesitó intervención, y la tarea funciona precisamente porque los tests existentes verifican el resultado. Ya se citó en este blog; va aquí porque es el ejemplo más limpio de un paso que se verifica solo y por eso puede desaparecer.
Quién escribe el código: Google, GitHub y METR en una línea cada uno
Antes, el ingeniero escribía el código y otro lo revisaba. Después, el modelo propone y el ingeniero revisa y acepta: «más de un cuarto» de todo el código nuevo de Google lo generaba la IA en octubre de 2024, y «bastante más del 30 %» en abril de 2025, siempre «revisado y aceptado por ingenieros», según su consejero delegado en las presentaciones de resultados. Lo que desaparece: escribir deja de ser el trabajo; revisar lo escrito por la máquina es el trabajo.
Resultado, medido por dos estudios que se contradicen: el ensayo controlado de GitHub de 2022, con 95 desarrolladores y una sola tarea, dio un 55 % más de velocidad con el asistente (es el estudio del propio vendedor); el ensayo aleatorizado de METR de julio de 2025, con 16 desarrolladores expertos y 246 tareas reales en su propio código, dio un 19 % más lento con IA mientras los desarrolladores creían haber ido un 20 % más rápido.
Nivel: 2, Prepara. Límite: METR advierte que su resultado no generaliza a la mayoría de los desarrolladores; y los tres casos ya están citados en este blog, así que basta con la lección: la percepción de productividad no es productividad, y es la única métrica que muchas empresas están recogiendo.
Microsoft y Meta: el diagnóstico de incidentes ya no arranca en blanco
Antes. El ingeniero de guardia leía alertas, registros y cambios recientes y formulaba hipótesis desde cero. Después. En Microsoft, modelos afinados con 44.340 incidentes de 1.759 servicios proponen causa raíz y pasos de mitigación al dueño del incidente; en Meta, un modelo afinado propone los cambios de código candidatos a causa raíz. En los dos, la persona decide y ejecuta.
Lo que desaparece: la página en blanco; buscar y cotejar entre registros, alertas y cambios lo hace el modelo y el ingeniero evalúa hipótesis en lugar de generarlas.
Resultado (estudio de Microsoft en la conferencia ICSE 2023 y entrada técnica de Meta de junio de 2024): más del 70 % de los dueños de incidentes puntuó la utilidad de las recomendaciones con tres o más sobre cinco, pero la corrección media fue de 2,88 en causa raíz y de 3,04-3,16 en mitigación; en Meta, la causa raíz estaba entre los cinco cambios sugeridos en el 42 % de las investigaciones históricas, en una prueba retrospectiva.
Nivel: 1, Recomienda. Límite: «útil» no es «correcto», y 42 % en el top-5 de una prueba retrospectiva no es «resuelve el 42 % de los incidentes», como a veces se lee. Ningún caso publicado por una empresa usuaria ejecuta la remediación sin una persona. Esa es la evidencia real sobre la «infraestructura que se repara sola», y es más modesta que el folleto.
Goldman Sachs: el ingeniero describe, convierte en prompt y supervisa
Antes. Unos 12.000 ingenieros escribiendo código con asistentes de autocompletado; migraciones y mantenimiento como trabajo manual «tedioso». Después. Piloto, desde julio de 2025, de Devin, el agente de Cognition, como «empleado» de ingeniería que ejecuta tareas de principio a fin bajo supervisión: «inicialmente tendremos cientos de Devins, y eso podría llegar a miles», según el director de tecnología, Marco Argenti.
Lo que desaparece, si el piloto se confirma: escribir. Los ingenieros «tendrán que describir problemas de forma coherente, convertirlos en prompts y supervisar el trabajo de esos agentes».
Resultado: ninguno medido; la mejora «de tres a cuatro veces» sobre las herramientas anteriores es una expectativa del directivo (prensa financiera, julio de 2025).
Nivel: 2-3, supervisado. Límite: es piloto, y va en el catálogo por una sola razón: es la descripción más honesta que ha dado un directivo de a qué se dedica una persona cuando el ejecutor escribe, y coincide con lo que dicen Octopus, Allianz y Quirónsalud desde sectores que no tienen nada que ver.
Dos promesas del bloque no tienen caso que las respalde. La infraestructura autorreparable —agentes que detectan, diagnostican y remedian sin nadie, con porcentajes espectaculares de reducción del tiempo de resolución y de intervenciones nocturnas— no aparece en ninguna fuente primaria de una empresa usuaria sin un manual de actuación aprobado de antemano; lo que sí existe, y sirve, es un agente que correlaciona alertas y cambios, asigna el ticket y ejecuta acciones de bajo riesgo previamente aprobadas: nivel 3 con lista blanca, no nivel 5.
Y la automatización descrita en lenguaje natural —el usuario explica la regla y el sistema genera el flujo, que alguien revisa antes de activar— existe como producto, pero la única cifra que su fabricante publica se refiere a crear fichas de inventario, no flujos, y circula mal atribuida.
En España, la referencia de escala es Repsol, que declaró en 2025 tener 22 agentes en producción en su función de digitalización y servicios, construidos con Accenture, sin cifras de rendimiento publicadas. La lección del bloque cabe en una frase: en TI el rediseño avanza donde el resultado se verifica solo y se detiene, con razón, donde no.
| Caso | Lo que desaparece | Resultado | Fuente | Nivel |
| ServiceNow sobre sí misma (2025) | Nivel 1 humano en peticiones rutinarias | 85 % resueltas de forma autónoma; 97 % aprovisionamiento; service desk −40 % | Proveedor sobre sí mismo | 4 |
| Amazon Q Developer (2024) | Migrar código a mano | De 50 días-desarrollador a horas; 4.500 años-desarrollador; 79 % sin cambios | Amazon sobre sí misma (es el proveedor) | 3 |
| Google, GitHub, METR (2022-2025) | Escribir código desde cero | >30 % del código nuevo generado; +55 % (GitHub) vs −19 % (METR) | Resultados trimestrales; estudio del vendedor; ensayo independiente | 2 |
| Microsoft y Meta, causa raíz (2023-2024) | Formular hipótesis desde cero | >70 % «útil», corrección 2,9-3,2/5; top-5 en 42 % retrospectivo | Estudios propios | 1 |
| Goldman Sachs + Devin (2025) | Escribir; queda describir y supervisar | Piloto; «3-4x» es expectativa | CIO en prensa | 2-3 |
| Infraestructura autorreparable | — | Sin caso primario de remediación autónoma sin manual aprobado | — | 3 con lista blanca, como máximo |
Legal, auditoría, administración y trabajo de conocimiento
En el trabajo de conocimiento la ruptura es la más discreta y la más difícil de medir: el primer borrador deja de ser trabajo humano, y el trabajo humano pasa a ser verificar. Casi ningún despacho, auditora o administración publica horas ahorradas, y los que lo hacen dan cifras de adopción, no de resultado. Por eso este bloque tiene menos porcentajes y más descripciones de rol; y por eso conviene leerlo con el aviso del artículo 6.3 del Reglamento de IA en la cabeza: lo que prepara para que una persona decida no es lo mismo, ni legal ni operativamente, que lo que decide.
Allen & Overy: 3.500 abogados y la regla de revisar todo
Antes. El abogado junior redactaba de cero, buscaba precedentes en repositorios internos y bases de datos y pasaba el borrador al sénior. Después. Harvey, sobre un modelo de OpenAI, genera y edita borradores, resume y responde preguntas jurídicas en varios idiomas; el abogado revisa. Beta desde noviembre de 2022 con 3.500 abogados y unas 40.000 consultas en tres meses; despliegue a toda la firma, 43 oficinas, el 15 de febrero de 2023. PwC firmó un mes después para sus más de 4.000 profesionales legales, con análisis de contratos y due diligence entre los usos declarados.
Lo que desaparece: documentar e informar desde la página en blanco y buscar y cotejar precedentes; la pantalla que ya no está es el documento vacío del junior.
Resultado (nota de prensa de la firma, 2023): solo cifras de adopción, 3.500 abogados y 40.000 consultas; la firma no publicó horas ahorradas y fijó una regla explícita: «el resultado necesita una revisión cuidadosa por un abogado de A&O». Su responsable del proyecto fue más lejos: «hay que validar todo lo que sale del sistema».
Nivel: 2, Prepara. Límite: es un caso de cambio de rol, no de straight-through: no hay métrica de resultado, y la propia firma insiste en que la salida hay que comprobarla entera. Es, a la vez, la descripción más honesta del sector de dónde queda la persona.
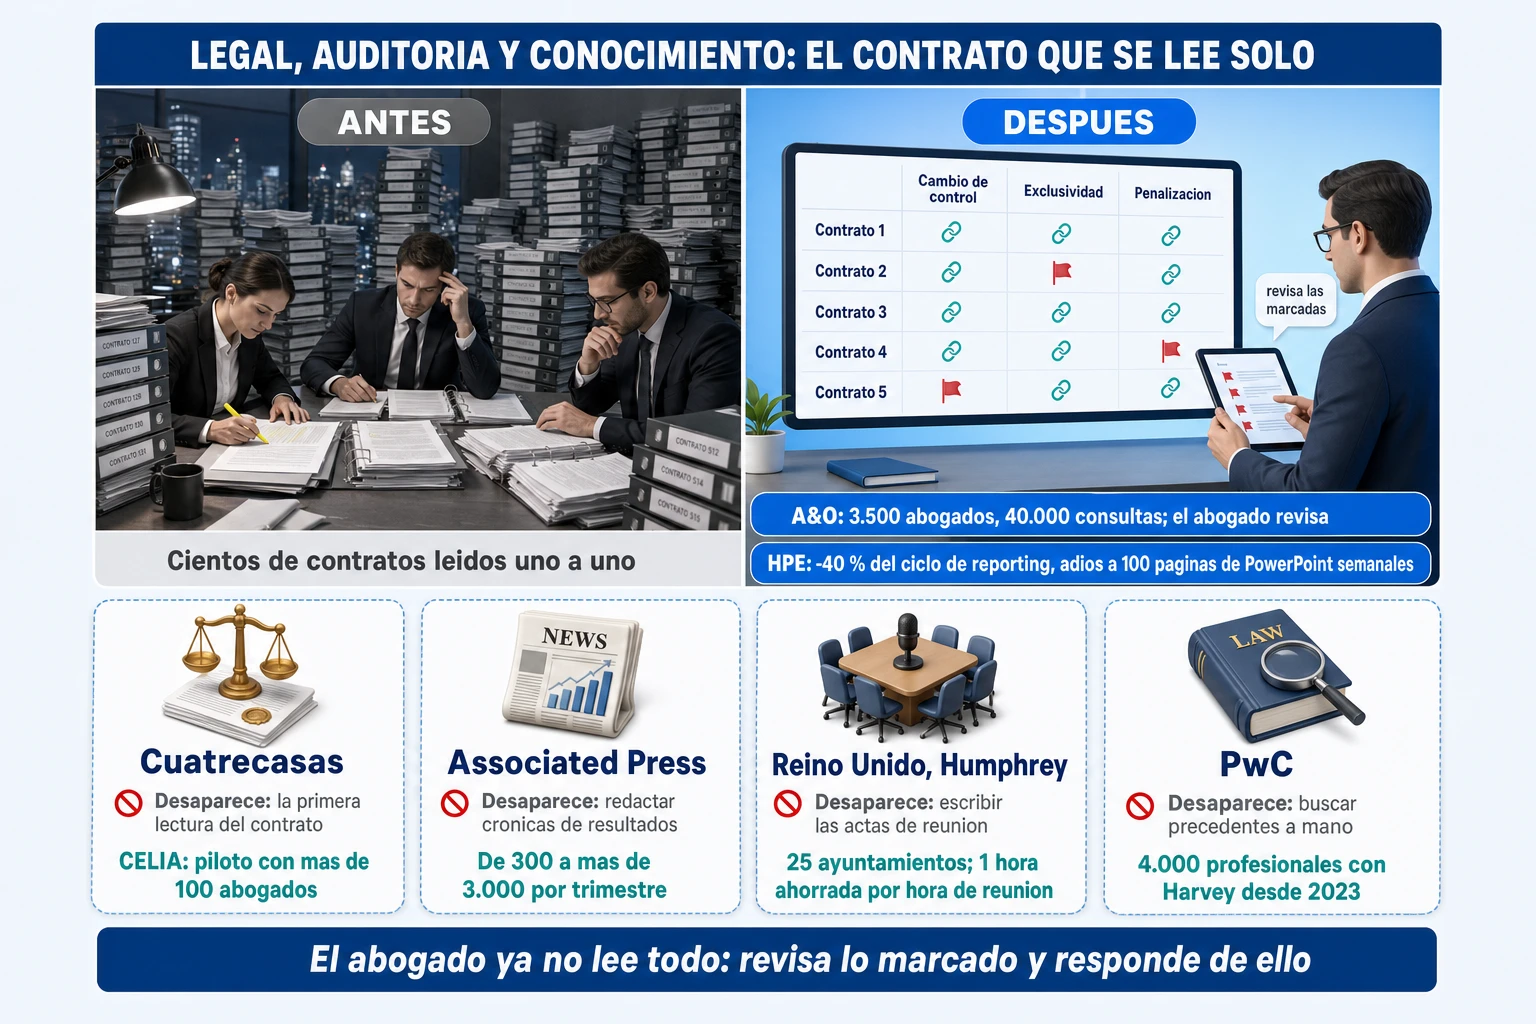
Cuatrecasas y los grandes despachos españoles: adopción sin cifras
Antes. Búsqueda documental y redacción manual, con pilotos internos de distintas herramientas a lo largo de 2023. Después. CELIA, el asistente de Cuatrecasas construido sobre Harvey, para redactar, revisar documentos y recuperar información jurídica en todas las áreas, tras un piloto «con más de 100 abogados» (septiembre de 2023). Según la prensa jurídica de 2025, Uría Menéndez, Garrigues y PwC Tax & Legal usan Harvey, y Pérez-Llorca firmó con Legora en marzo de 2025; Uría adoptó su herramienta «tras pilotos con varias soluciones durante el último año».
Lo que desaparece: lo mismo que en Allen & Overy, documentar desde cero y buscar y cotejar; el asistente generativo se ha convertido en herramienta de plantilla en todos los grandes despachos españoles en menos de dos años.
Resultado: ningún despacho español ha publicado cifras de tiempo; Cuatrecasas habla de respuestas «en segundos» (nota propia, 2023; prensa jurídica, 2025).
Nivel: 2, Prepara. Límite: es un caso de adopción, no de resultado medido. Sirve para un argumento concreto —en legal, España no va tarde— y no para otro: nadie sabe todavía, con datos públicos, cuánto trabajo ha desaparecido de verdad en un despacho español.
HPE: adiós a las cien páginas de PowerPoint semanales
Antes. La revisión semanal de rendimiento operativo de Hewlett Packard Enterprise reunía a 40-50 personas de finanzas y ventas sobre unas cien páginas de PowerPoint preparadas a mano cada semana; el análisis miraba «por el retrovisor».
Después. «Alfred», una plataforma agéntica interna construida por ingenieros de HPE con Deloitte y NVIDIA, analiza datos de finanzas y cadena de suministro y responde en tiempo real a las preguntas de la reunión: «una especie de interfaz en tiempo real sobre las cifras clave y el rendimiento de la compañía», en palabras de la directora financiera, Marie Myers. Previsto extenderlo a cuentas a pagar y cobrar, crédito y previsión.
Lo que desaparece: el paquete de diapositivas; documentar e informar deja de ser un trabajo semanal de decenas de personas, y la reunión pasa de repasar lo preparado a preguntar al sistema y discutir hacia delante.
Resultado: «redujo el ciclo de reporting financiero aproximadamente un 40 %», según la CFO en una entrevista con prensa financiera (febrero de 2026); HPE lo mide.
Nivel: 0-1, Informa y Recomienda: explica, no ejecuta. Límite: es una declaración de la directiva, no una auditoría, y no hay nota de prensa ni entrada de blog de la empresa. Va en el catálogo por una razón: es el ejemplo más claro de que un proceso puede desaparecer sin que ningún agente «haga» nada; basta con que la pregunta se pueda hacer directamente al dato.
Associated Press: de 300 a más de 3.000 crónicas por trimestre (precedente, 2014)
Antes. Los redactores de economía de la agencia escribían a mano unas 300 crónicas de resultados trimestrales, solo las de las grandes cotizadas; el resto no se cubría.
Después. Desde julio de 2014, un sistema de generación de texto de Automated Insights produce crónicas de 150-300 palabras a partir de los datos de resultados; los redactores revisan las excepciones y se dedican a piezas de análisis.
Lo que desaparece: la crónica estándar como trabajo del periodista, que pasa a supervisar un sistema que escribe diez veces más; es documentar e informar convertido en subproducto del dato.
Resultado: el volumen de crónicas de resultados «se multiplicó por más de diez» y se liberó «el 20 % del tiempo de los redactores» (declaraciones de la agencia reproducidas de forma concordante desde 2014-2016).
Nivel: 3-4: publica sin revisión salvo alertas. Límite: es texto sobre datos estructurados, mucho más fácil que cualquier caso de 2026, y las cifras exactas varían entre 3.000 y 4.400 según la fuente y el año. Está aquí porque demuestra que el patrón «la persona supervisa, el sistema produce lo estándar» tiene doce años y se ha sostenido.
Reino Unido: una hora de administración ahorrada por cada hora de reunión
Antes. Funcionarios de urbanismo y servicios sociales de los ayuntamientos británicos tomaban actas a mano de reuniones en las que además tenían que participar; «casi la mitad de los funcionarios encuestados identificó la toma de notas como la parte menos agradable de su trabajo».
Después. «Minute», una de las herramientas de la suite «Humphrey» del Gobierno británico, transcribe y redacta las actas de reuniones de planificación y de asistencia social; 25 ayuntamientos en prueba en 2025.
Lo que desaparece: transcribir y documentar; el acta deja de ser tarea de la persona que también tiene que estar en la reunión. Resultado: «aproximadamente una hora de trabajo administrativo ahorrada por cada hora de reunión» (gov.uk, mayo de 2025).
Nivel: 2, Prepara. Límite: es un piloto, no producción, y las otras herramientas de la misma suite no tienen evaluaciones abiertas que se puedan citar. En la misma familia, Estonia lleva desde 2021 construyendo Bürokratt, un asistente estatal en lenguaje natural con el que el ciudadano habla «con el Estado» y no con un organismo, y la Agencia Tributaria española ofrece desde 2017 asistentes virtuales por materia que resuelven la duda en el punto donde surge, sin cola ni funcionario; ninguno de los dos publica cifras, y los asistentes de la AEAT son de reglas, no agentes. La administración va por detrás de la empresa en medir, no en desplegar.
Auditoría y análisis documental masivo: lo que dicen los proveedores
Aquí no hay caso de empresa usuaria con cifra, y hay que decirlo. KPMG declara que sus «más de 95.000 profesionales de auditoría» usan su plataforma con agentes para «auditar el 100 % de los datos» en lugar de muestrear, con el auditor manteniendo «un alto nivel de escepticismo profesional»: la ruptura —la excepción la señala el sistema y la persona la investiga— es verosímil, pero KPMG es usuaria y vendedora a la vez y no publica horas ni porcentaje de procedimientos automatizados.
En análisis documental, Hebbia ejecuta la misma pregunta sobre cientos o miles de documentos en paralelo y devuelve una tabla con citas, «correr 700 filas no es muy distinto de correr 10», y la prensa nombra a grandes gestoras y despachos entre sus clientes, ninguno con cifra propia. Thomson Reuters cita un estudio que encargó a Forrester con un 33 % menos de tiempo en revisión, investigación y redacción.
Y sobre las revisiones de licencias, cuentas inactivas y segregación de funciones que a veces se presentan como caso agéntico, no existe ninguna empresa nombrada con resultado localizable. Nivel: 1-2 en todos. Etiqueta: proveedor, sin excepción. Se citan como oferta, no como prueba.
| Caso | Lo que desaparece | Resultado | Fuente | Nivel |
| Allen & Overy y PwC + Harvey (2023) | El primer borrador; buscar precedentes | 3.500 abogados, 40.000 consultas; «hay que validar todo» | Propia firma | 2 |
| Cuatrecasas, Uría, Garrigues, Pérez-Llorca (2023-2025) | El primer borrador | Adopción generalizada; sin cifras | Propia firma; prensa jurídica | 2 |
| HPE, Alfred (2025-2026) | Las cien páginas de PowerPoint semanales | −40 % del ciclo de reporting financiero | CFO en prensa | 0-1 |
| Associated Press (2014) | La crónica estándar de resultados | De ~300 a >3.000 crónicas/trimestre; 20 % del tiempo liberado | Propia agencia | 3-4 |
| Reino Unido, Humphrey/Minute (2025) | Tomar el acta a mano | 1 h de administración por hora de reunión; 25 ayuntamientos | gov.uk (piloto) | 2 |
| KPMG Clara, Hebbia, CoCounsel | Muestrear; leer documento a documento | Sin cifra de cliente nombrado | Proveedores | 1-2 |
El mapa de los casos: qué desaparece en cada uno
Puestos los casos sobre los seis trabajos, el mapa tiene una forma clara y poco intuitiva. Tres columnas están llenas: transcribir y teclear (todos los scribes, Rocket, Aeropuertos Argentina, Naturgy, Zurich), buscar y cotejar (Allianz, HSBC, Toyota, Alaska, Verizon, Microsoft, los despachos) y clasificar y enrutar (Tucuvi, Deep Medical, Aidoc, HSBC, DoorDash, ServiceNow, Coca-Cola). Alrededor del 80 % de los casos elimina al menos uno de esos tres, y muchos, dos. Son los trabajos que existían por la fragmentación de los sistemas, y son los que un modelo que lee y escribe hace desaparecer con más limpieza.
Dos columnas están medio llenas: conciliar y verificar (Ford, Florida Crystals, Allianz, Coca-Cola) y documentar e informar (DBS, Octopus, HPE, AP, Humphrey, los despachos). Y una está casi vacía: aprobar lo rutinario. Donde aparece —Humana, IBM Credit, Admiral, Amazon Q, IBM AskHR, Deere— no desaparece: se estrecha. Se aprueba solo lo que cumple una vía clínica, un umbral de importe, un tipo de daño o un test que pasa. La decisión sobre la persona, el pago o el riesgo sigue siendo humana en todos los casos que han durado, y el que la automatizó del todo, UnitedHealth con las denegaciones, está en los tribunales.
Es la lectura más útil del mapa: los agentes vacían las columnas de la izquierda y apenas tocan la de la derecha, y quien promete lo contrario está vendiendo nivel 5 con casos de nivel 2.
| Trabajo que desaparece | Casos del catálogo que lo eliminan | Bloques donde aparece | Qué queda humano |
| Transcribir y teclear | Quirónsalud, Kaiser, NHS, Osakidetza, Rocket, Zurich, Aeropuertos Argentina, Naturgy, IBM AskHR | Los seis | Validar antes de firmar o auditar después |
| Buscar y cotejar | Allianz, Admiral, HSBC, JPMorgan, Toyota, Alaska, Octopus, Verizon, Salesforce, Microsoft/Meta, A&O, despachos | Los seis | Decidir sobre el expediente ya reunido |
| Clasificar y enrutar | Tucuvi, Deep Medical, Aidoc, HSBC, Coca-Cola, Naturgy, DoorDash, ServiceNow, Mutual Benefit Life | Cinco de seis | Lo que queda por debajo del umbral de confianza |
| Conciliar y verificar | Ford, Allianz, Florida Crystals, Renault, Coca-Cola | Tres de seis | Resolver la discrepancia, no buscarla |
| Aprobar lo rutinario (se estrecha) | IBM Credit, Humana (solo el «sí»), Ping An, Admiral, Deere, Amazon Q, IBM AskHR, ServiceNow | Cinco de seis | Todo lo que supera el umbral; siempre la denegación y el pago |
| Documentar e informar | Quirónsalud, DBS, CaixaBank, Toyota, Octopus, HPE, AP, Humphrey, A&O, Cuatrecasas | Los seis | Corregir, añadir criterio, responder de lo que se firma |
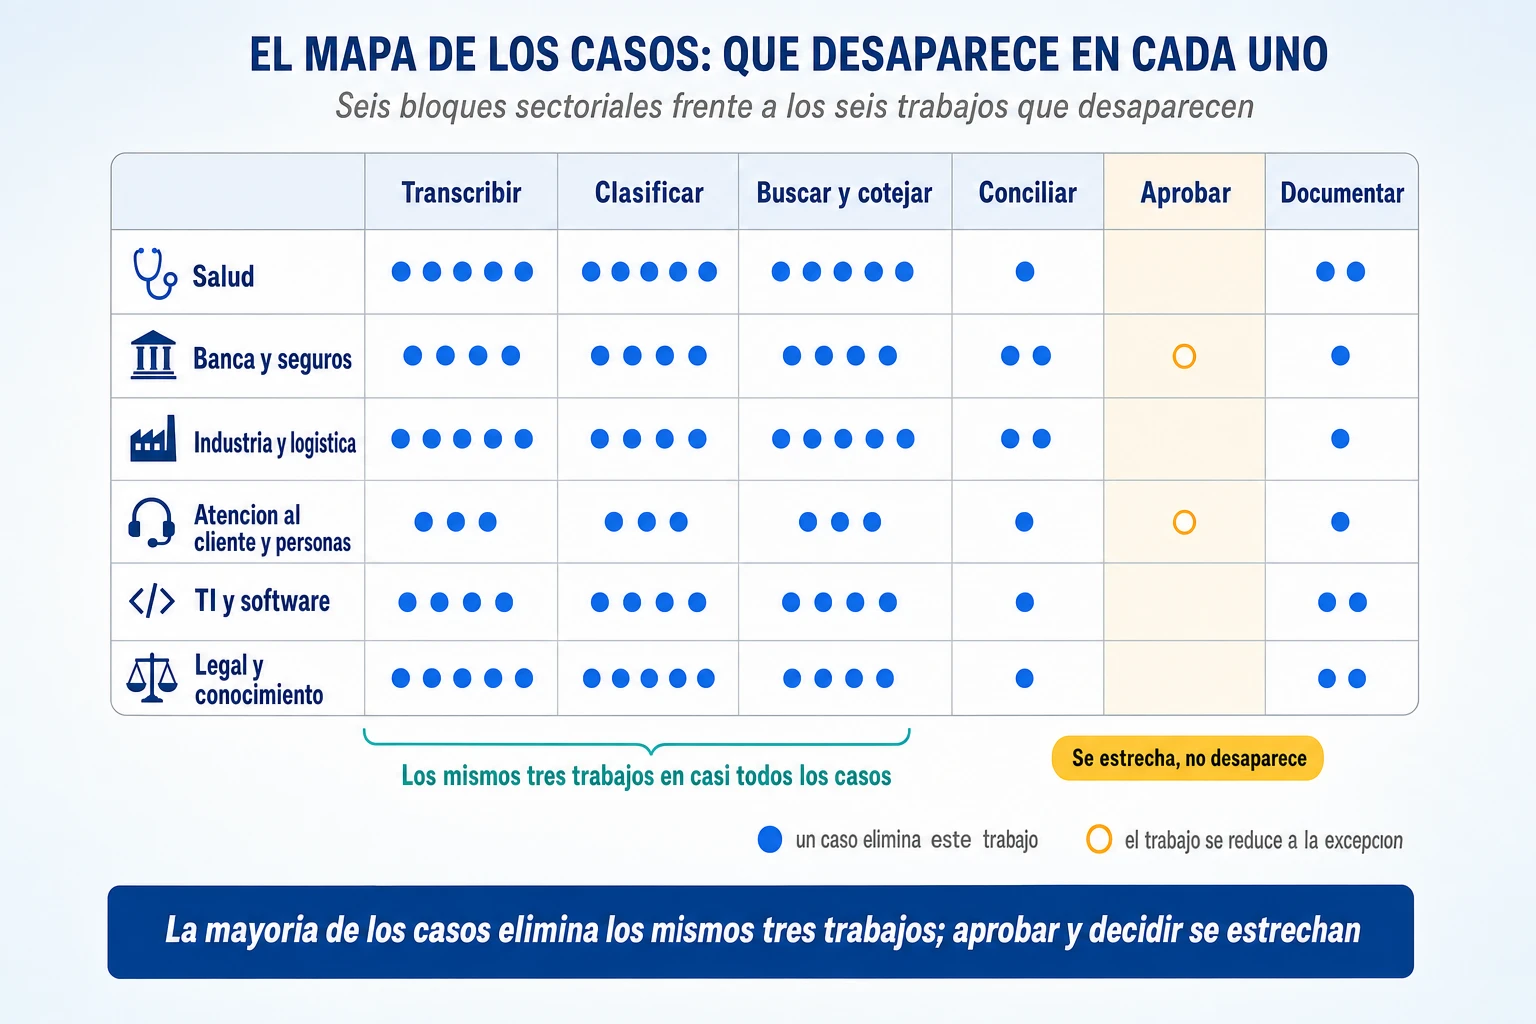
Lo que tienen en común los que funcionan (y los que se revirtieron)
Antes de los rasgos, el dato macro que los explica. Los estudios de adopción coinciden en un patrón: la productividad individual sube y la cuenta de resultados apenas se entera. BCG encontró en octubre de 2024 que solo el 26 % de las empresas había desarrollado las capacidades para pasar de las pruebas de concepto a un valor tangible, y en su encuesta de 2025 a 10.600 empleados que el uso regular en primera línea se había estancado en el 51 % y que solo el 13 % veía agentes integrados en su flujo de trabajo diario; el estudio de IBM a 2.000 consejeros delegados de 2025 dio que solo el 25 % de las iniciativas de IA había alcanzado el retorno esperado y solo el 16 % había escalado.
La variable que separa a unos de otros en esos mismos estudios no es la herramienta: es haber rediseñado el flujo de trabajo. Los cinco rasgos que siguen son la versión concreta de esa variable.
Cinco rasgos que se repiten
Uno: la pantalla desaparece de verdad. En todos los casos que han durado se puede nombrar el paso que ya no existe y el puesto que ya no lo hace: nadie teclea en consulta, el tramitador no instruye, el comprador no negocia con la cola larga, el desarrollador no migra, RRHH no tramita, el abogado revisa lo marcado. Cuando eso no se puede nombrar —copilotos, la mayoría de los pilotos de 2025—, lo que hay es aceleración, y la aceleración rinde el 10-20 % que BCG mide en sus propios clientes.
Dos: lectura amplia, escritura estrecha. El agente de Allianz lee póliza, meteorología y fraude, pero no paga. El de Naturgy consulta contrato y cobertura, pero no mueve un técnico. El de CaixaBank simula el préstamo, pero no firma. La boquilla de Deere decide sola, pero solo sobre un centímetro. Todos leen mucho y escriben poco, en sitios acotados y con umbrales explícitos.
Tres: la excepción es el diseño, no la incidencia. En los casos que funcionan, la excepción tiene umbral, tipo y responsable definidos antes del primer día: los 500 dólares de Allianz, los «daños leves elegibles» de Admiral, el 5 % de escalado de Salesforce, el «hay que mover un técnico» de Naturgy. La primera ola trataba la excepción como un fallo del bot; la segunda la trata como el trabajo de la persona.
Cuatro: medición honesta. Los mejores casos miden tasa de straight-through, toques por expediente y tasa de excepción, y distinguen lo medido de lo estimado: Rocket lo comunica a la SEC, Kaiser lo publica en una revista, Allianz dice «cinco minutos hasta la revisión humana». Los peores miden horas ahorradas en encuestas, y el consejero delegado de JPMorgan ha reconocido que esas horas no entran en el cálculo de rentabilidad.
Cinco: la persona cambia de sitio, no se va. El maquinista se muda a Perth, el operario sale del remolque y gestiona el muelle, el ingeniero de Goldman describe y supervisa, la enfermera atiende alertas. En los casos que han durado, la ruptura se vendió como recolocación: Rio Tinto, Octopus, Rocket, IBM.
Los cinco rasgos se sostienen entre sí; y todos los que se revirtieron violaron al menos uno. Para la arquitectura que hace posible la escritura estrecha —quién decide el siguiente paso, con qué herramientas y con qué frenos— está el artículo sobre arquitectura agéntica.
Lo que salió mal: quitar a la persona antes de rediseñar el proceso
La lista de marchas atrás tiene tres familias, y ninguna es un fallo de tecnología. La primera es recortar sobre una proyección. Commonwealth Bank anunció en julio de 2025 45 despidos en atención telefónica porque un bot de voz iba a quitar 2.000 llamadas semanales; el sindicato documentó que las llamadas subían y que los jefes de equipo estaban al teléfono; el 21 de agosto el banco reconoció que «no consideró adecuadamente todas las circunstancias» y ofreció a los afectados quedarse. La cifra de llamadas evitadas era una previsión, no una medición.
Klarna celebró en febrero de 2024 que su asistente hacía el trabajo equivalente a 700 agentes y en mayo de 2025 su consejero delegado admitió que el coste había sido «un factor demasiado dominante» y el resultado, «menor calidad»; la calidad no estaba en la métrica. Y Duolingo pagó en 2025 el coste reputacional de anunciar una política «IA primero» sin explicar qué trabajo cambiaba.
La segunda familia es la IA no hacía lo que se decía. Amazon Just Walk Out se retiró de los supermercados Fresh en abril de 2024 tras publicarse que se apoyaba en unos mil revisores en la India y que en 2022 la mayoría de las compras necesitaban revisión humana; Amazon lo negó en parte. El straight-through aparente escondía una cola humana deslocalizada.
IBM Watson for Oncology consumió 62 millones de dólares en el MD Anderson sin integrarse con la historia clínica, dio recomendaciones «inseguras e incorrectas» según documentos internos y se vendió en 2022. Babylon Health, el chatbot de triaje valorado en miles de millones, entró en concurso en agosto de 2023. Builder.ai, que vendía desarrollo «con IA», resultó tener ingenieros en la India y contabilidad inflada, y quebró en mayo de 2025. Y Cursor descubrió en abril de 2025 que su bot de soporte había inventado una política de la empresa que provocó cancelaciones.
La tercera familia es poner el sistema sobre un proceso sin rediseñarlo. El ensayo aleatorizado de Copenhague con Corti es el ejemplo más limpio: un modelo que detectaba paradas cardíacas en llamadas al 112 mejor que los operadores en retrospectiva no mejoró nada cuando se añadió como alerta sobre el protocolo de siempre (93,1 % de reconocimiento con alerta frente a 90,5 % sin ella, sin significación, en 169.049 llamadas).
McDonald’s apagó en 2024 su pedido por voz con IBM tras tres años de pruebas en más de cien restaurantes y vídeos virales de pedidos erróneos, y Taco Bell, según la prensa, reconsideró en 2025 dónde usar el suyo tras un pedido de 18.000 vasos de agua hecho para forzar a un humano.
Zillow cerró en noviembre de 2021 su negocio de compra algorítmica de viviendas con 304 millones de dólares de provisiones y el 25 % de la plantilla: un modelo que decidía compras con dinero real, sin persona que auditara cada decisión, en un mercado que cambió de régimen. Y Mutual Benefit Life, el caso estrella de Hammer, quebró un año después del artículo por causas ajenas al proceso.
Dos avisos más que no son marchas atrás pero enseñan lo mismo: el regulador de Nueva York no encontró discriminación en los límites de crédito de la Apple Card, pero sí una «falta de transparencia percibida» que destruyó la confianza aunque las decisiones fueran correctas; y la Hacienda holandesa usó la nacionalidad como factor de riesgo en las ayudas al cuidado infantil, acusó falsamente de fraude a unas 26.000 familias y el gobierno dimitió en bloque en enero de 2021.
En todos los casos de esta sección, o se quitó a la persona antes de que el sistema pudiera sustituirla, o se puso el sistema sin cambiar el proceso. Es, punto por punto, la historia de la reingeniería entre 1993 y 1995.
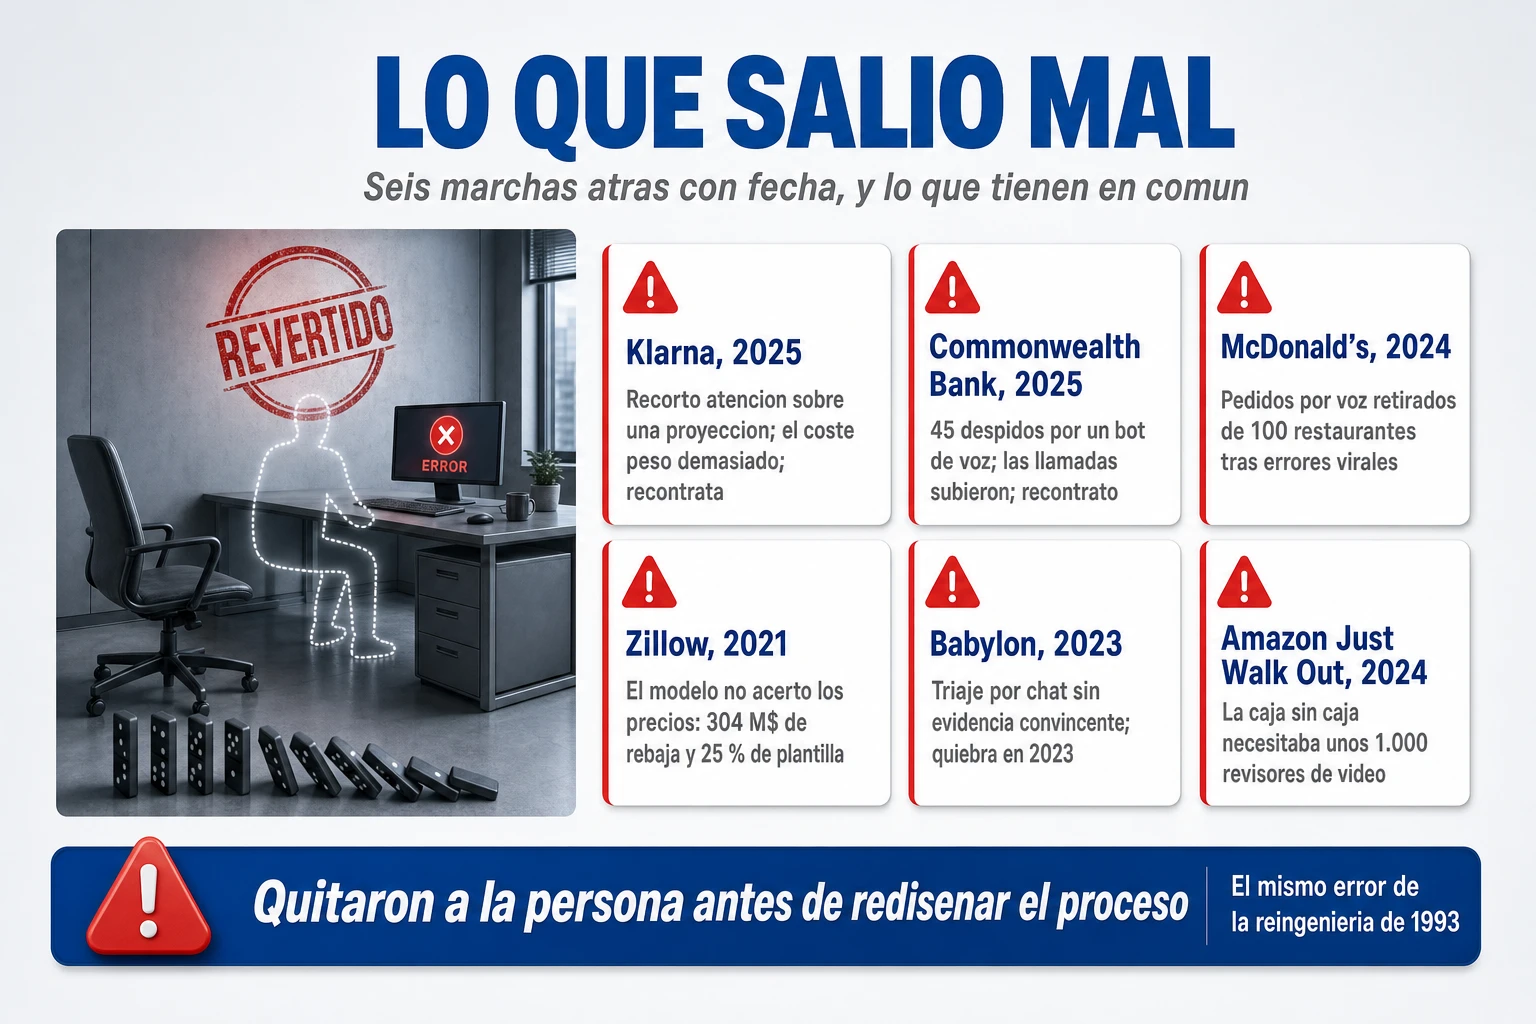
Cómo se mide un proceso reimaginado
La métrica que engaña es «horas ahorradas». Engaña por tres razones que el catálogo ilustra. Se mide con encuestas, no con sistemas: BBVA, JPMorgan y Bank of America la dan así, y el consejero delegado de JPMorgan admite que no entra en el cálculo de rentabilidad. No se convierte en resultado si el proceso no cambia: una hora ahorrada en una tarea cuyo expediente sigue esperando en la bandeja siguiente es una hora de espera más larga. Y es aditiva cuando no debe serlo: 15.791 horas en Kaiser suenan a plantilla; divididas entre 2,58 millones de consultas son 22 segundos.
El cuadro de mando que propusimos en el artículo sobre la transformación con agentes tiene ocho indicadores: lead time de extremo a extremo · toques humanos por resultado · tasa de straight-through · tasa de excepción y minutos por excepción · first-pass yield y retrabajo · reversiones, anulaciones e incidentes · coste totalmente cargado por resultado · decisiones por periodo y latencia media.
Para saber si un proceso se ha reimaginado bastan tres. Tasa de straight-through: qué proporción de expedientes llega al resultado sin que nadie los toque; es un término establecido desde hace décadas en pagos y seguros, y es el único de esta lista con nombre consolidado. Toques humanos por resultado: cuántas veces una persona abre el expediente; si el proceso rediseñado necesita los mismos toques que el antiguo, no se ha rediseñado nada. Tasa de excepción: qué proporción sale del carril automático, y cuánto cuesta cada una; es la cifra que dice si la excepción está diseñada o solo desplazada, y la que Just Walk Out no publicó.
Una advertencia sobre nombres y objetivos. En informes que circulan sobre este tema aparecen siglas como STP, HTR o PCR y objetivos del tipo «80-95 % de straight-through» o «menos de 0,1 toques por expediente» presentados como estándar de la industria. Solo el straight-through lo es; las demás son propuestas, y los objetivos dependen del proceso: Rocket procesa automáticamente el 90 % de los datos de un documento, Allianz lleva el 100 % de los siniestros pequeños a una persona por diseño, y las dos cosas son correctas.
La única fuente con nombre que fija objetivos es BCG, que habla de «hasta un 80 %» de straight-through como meta de sus primeras transformaciones agénticas, y es la cifra de una consultora sobre sus clientes. Lo que sí tiene sentido pedir en el primer año es lo que sigue.
| Indicador | Qué pregunta responde | Qué tiene sentido pedir en el primer año (orientativo) |
| Tasa de straight-through | ¿Qué proporción de expedientes llega al resultado sin ningún toque humano? | Que exista y se mida por tipo de caso; que suba mes a mes; que el carril automático se defina por umbral, no por confianza en el modelo |
| Toques humanos por resultado | ¿Cuántas veces abre alguien el expediente? | Que baje respecto a la línea base medida antes del proyecto; si no baja, el proceso no se ha rediseñado |
| Tasa de excepción y minutos por excepción | ¿Cuánto sale del carril automático y cuánto cuesta cada salida? | Que cada excepción tenga tipo y responsable; que la tasa baje y los minutos por excepción no exploten |
| Lead time de extremo a extremo | ¿Cuánto tarda el resultado desde que entra la petición? | Medido en el sistema, no estimado; con la espera separada del trabajo |
| First-pass yield y retrabajo | ¿Cuánto sale bien a la primera? | Que se mida la corrección, no solo la «resolución»: el 79 % de PR sin cambios de Amazon es de este tipo |
| Reversiones, anulaciones e incidentes | ¿Cuánto hay que deshacer? | Un registro desde el primer día; es lo que el Reglamento de IA exige en alto riesgo |
| Coste totalmente cargado por resultado | ¿Cuánto cuesta cada expediente con licencias, modelos, personas y excepciones? | Incluir el coste de las excepciones y de la revisión; no solo el del bot |
| Decisiones por periodo y latencia media | ¿Cuántas decisiones toma el sistema y cuánto tarda cada una? | Solo relevante cuando el agente decide (nivel 3+); en nivel 2, medir tiempo hasta la revisión humana |
Cómo empezar: elegir la pantalla que sobra
Primero, elegir la pantalla que sobra. No el caso de uso más vistoso ni el que trae el proveedor: el proceso donde hay una pantalla entre la persona y el trabajo real y un volumen alto de casos parecidos. Se reconoce con la prueba de arriba: ¿qué paso podría dejar de existir? ¿quién dejaría de hacerlo? ¿qué pantalla desaparecería? El médico y el monitor; el tramitador y sus tres ventanas; el gestor y el memorando en blanco; el técnico de nivel 1 y la cola de tickets. Si en el proceso elegido no hay respuesta a las tres preguntas, es un caso de copiloto y hay que presupuestarlo como tal.
Segundo, eliminar y simplificar antes de automatizar. Es el orden que defendíamos en el artículo sobre la transformación con agentes —eliminar, simplificar, automatizar y solo entonces agentificar— y es lo que hizo Ford al pedir a los proveedores que no mandaran facturas, y lo que BCG describe en una tecnológica global anónima: primero eliminar procesos sin valor, después simplificar, y automatizar con agentes solo lo que queda. Un agente puesto sobre un proceso con pasos inútiles los ejecutará más rápido; es el camino de vacas pavimentado por tercera vez.
Tercero, escritura estrecha y excepción diseñada desde el primer día. Antes de que el agente escriba nada en ningún sistema hay que decidir dónde puede escribir, con qué límites y qué pasa cuando no puede: el umbral de importe, el tipo de caso, la persona responsable. Y, si se graba a personas, el consentimiento: informar antes, indicador visible durante toda la sesión, borrado con plazo.
Aquí entra el Reglamento de IA, que tras el Ómnibus de julio de 2026 aplica las obligaciones de alto riesgo del Anexo III desde el 2 de diciembre de 2027: crédito a personas físicas, seguros de vida y salud, selección y decisiones sobre empleados, con supervisión humana efectiva (artículo 14) y registro automático de eventos (artículo 12).
Y con una distinción que marca el diseño: el artículo 6.3 deja fuera del alto riesgo a los sistemas que hacen «una tarea preparatoria» o «una tarea procedimental estrecha», salvo que perfilen personas. Un agente de nivel 2 que prepara el expediente y un agente de nivel 3 que decide sobre alguien no son el mismo proyecto ante la ley, y conviene que tampoco lo sean en el presupuesto.
Cuarto, medir straight-through desde el día uno. La línea base se mide antes de tocar nada —toques por expediente, tasa de excepción, lead time— con datos del sistema, no con entrevistas; si no hay datos, la minería de procesos sirve para eso, como en Renault y Florida Crystals. Y con una marcha atrás planificada: Klarna y Commonwealth Bank no fracasaron por el agente, fracasaron por recortar antes de medir.
Para la secuencia de las primeras semanas está el plan de 90 días del artículo citado; para la arquitectura mínima que necesita cada nivel de autonomía, el artículo sobre arquitectura agéntica; y para lo que hay que tener montado debajo —identidad, gateways, catálogo de herramientas, observabilidad—, el artículo sobre la plataforma de agentes. Lo que este artículo añade es el criterio de selección: la pantalla que sobra.
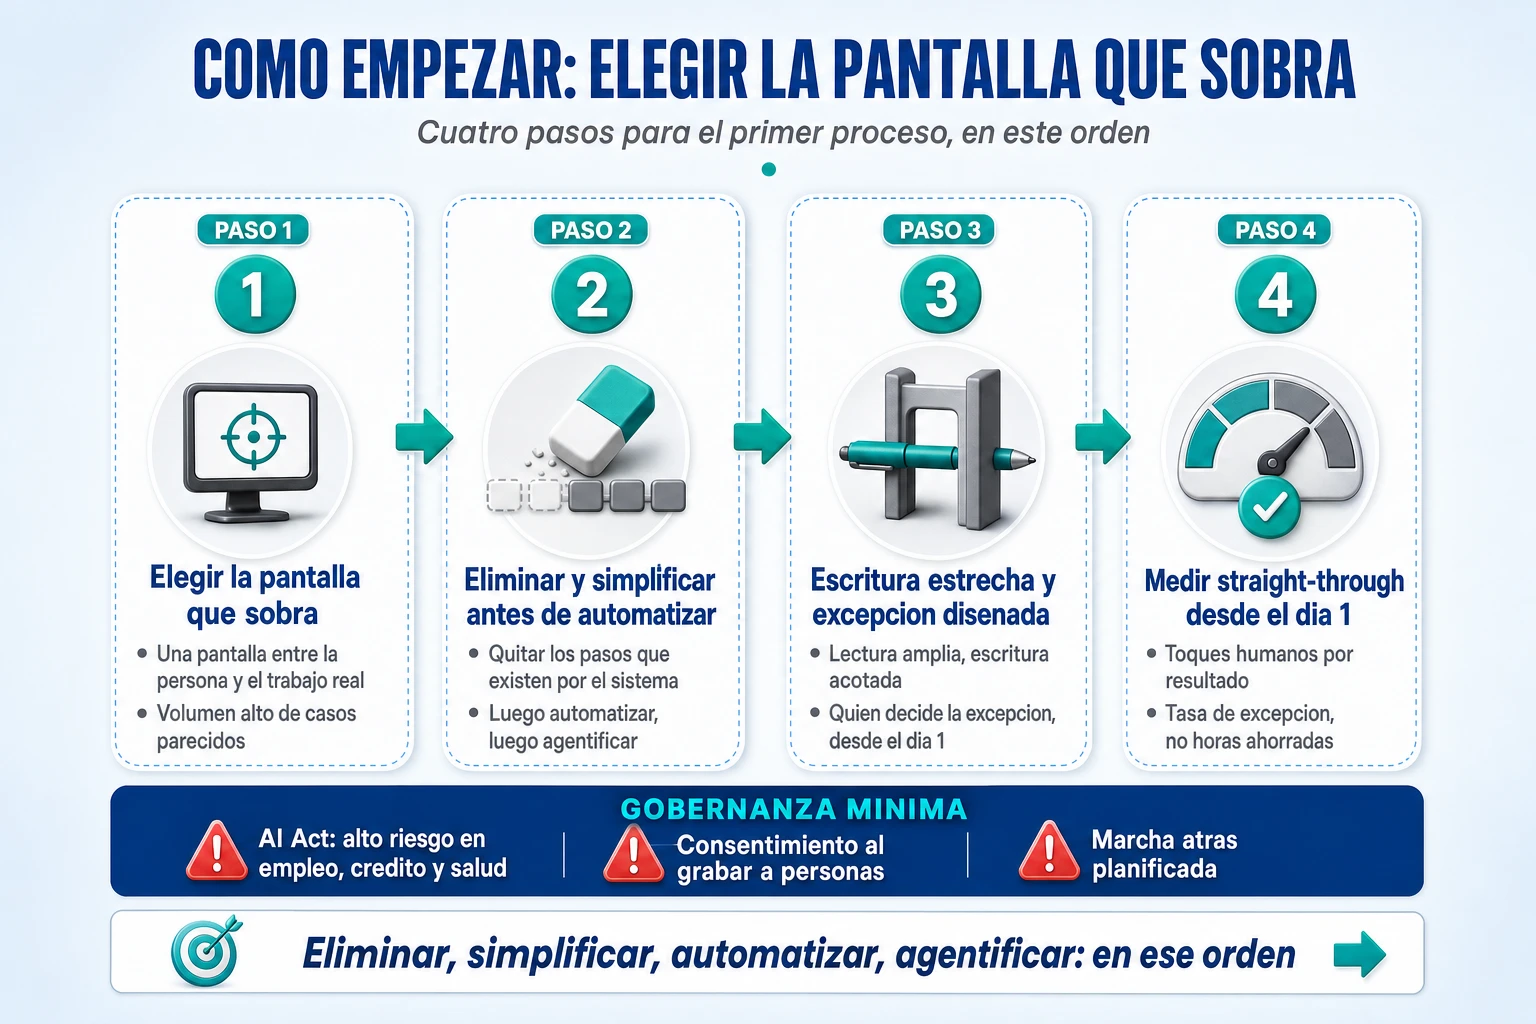
Conclusión
Hammer tenía razón en 1990 y no tenía con qué. El case manager que hacía el expediente entero necesitaba un sistema experto que leyera lo que le llegaba, y los sistemas expertos no leían. Hoy leen, entienden y escriben, y por eso los casos de este catálogo —de la consulta sin ordenador al siniestro que llega resumido a la mesa de quien decide el pago— se parecen tanto a los suyos. Lo que no ha cambiado es la trampa: usar la herramienta nueva para hacer lo mismo un poco más rápido. La primera ola cayó en ella con robots de software; la segunda puede caer con agentes, y algunos ya han caído.
El catálogo deja tres lecciones que caben en una tarjeta. Casi todo lo que funciona está en nivel 2 o 3: el sistema prepara o ejecuta, la persona decide o audita, y el nivel 4 se gana estrechando el tipo de caso, no ampliando la confianza. Lo que desaparece son los trabajos que existían por la fragmentación de los sistemas —transcribir, clasificar, buscar, conciliar—, y lo que no desaparece es la decisión sobre una persona, un pago o un riesgo. Y lo que separa a los que duran de los que se revirtieron no es la tecnología: es haber rediseñado el proceso antes de quitar a la persona, y haber medido toques y excepciones en vez de horas.
Un proceso no se ha reimaginado cuando va más rápido. Se ha reimaginado cuando alguien puede señalar el paso que ya no existe y la pantalla que ya no está.
En Transformalix ayudamos a encontrar, en los procesos de una empresa, las pantallas que sobran: qué pasos pueden dejar de existir, quién dejaría de hacerlos, qué nivel de autonomía admite cada decisión, cómo se diseña la excepción y cómo se mide el straight-through antes de tocar la plantilla. Si en su organización hay un proceso en el que alguien sigue tecleando lo que ya está dicho, cotejando lo que ya está en otro sistema o aprobando lo que siempre se aprueba, hablemos.