En julio de 2026, OpenAI publicó un resultado incómodo sobre sí misma. Uno de sus modelos punteros, GPT-5.6 Sol, aparecía en una evaluación pública de razonamiento visual —ARC-AGI-3— con una puntuación que a sus propios ingenieros les pareció inverosímil. No dudaron del modelo: fueron a mirar el software que lo estaba ejecutando. Y encontraron dos decisiones de ingeniería, ninguna escandalosa por separado.
La primera: después de cada acción en el juego, el razonamiento privado del modelo se tiraba a la basura. Veía el registro de sus movimientos anteriores, pero no los planes ni las conclusiones que le habían llevado a hacerlos; cada turno tenía que deducir otra vez las reglas desde cero. La segunda: cuando la conversación superaba los 175.000 caracteres, el sistema borraba los mensajes más antiguos. Sin resumirlos y sin avisar a nadie.
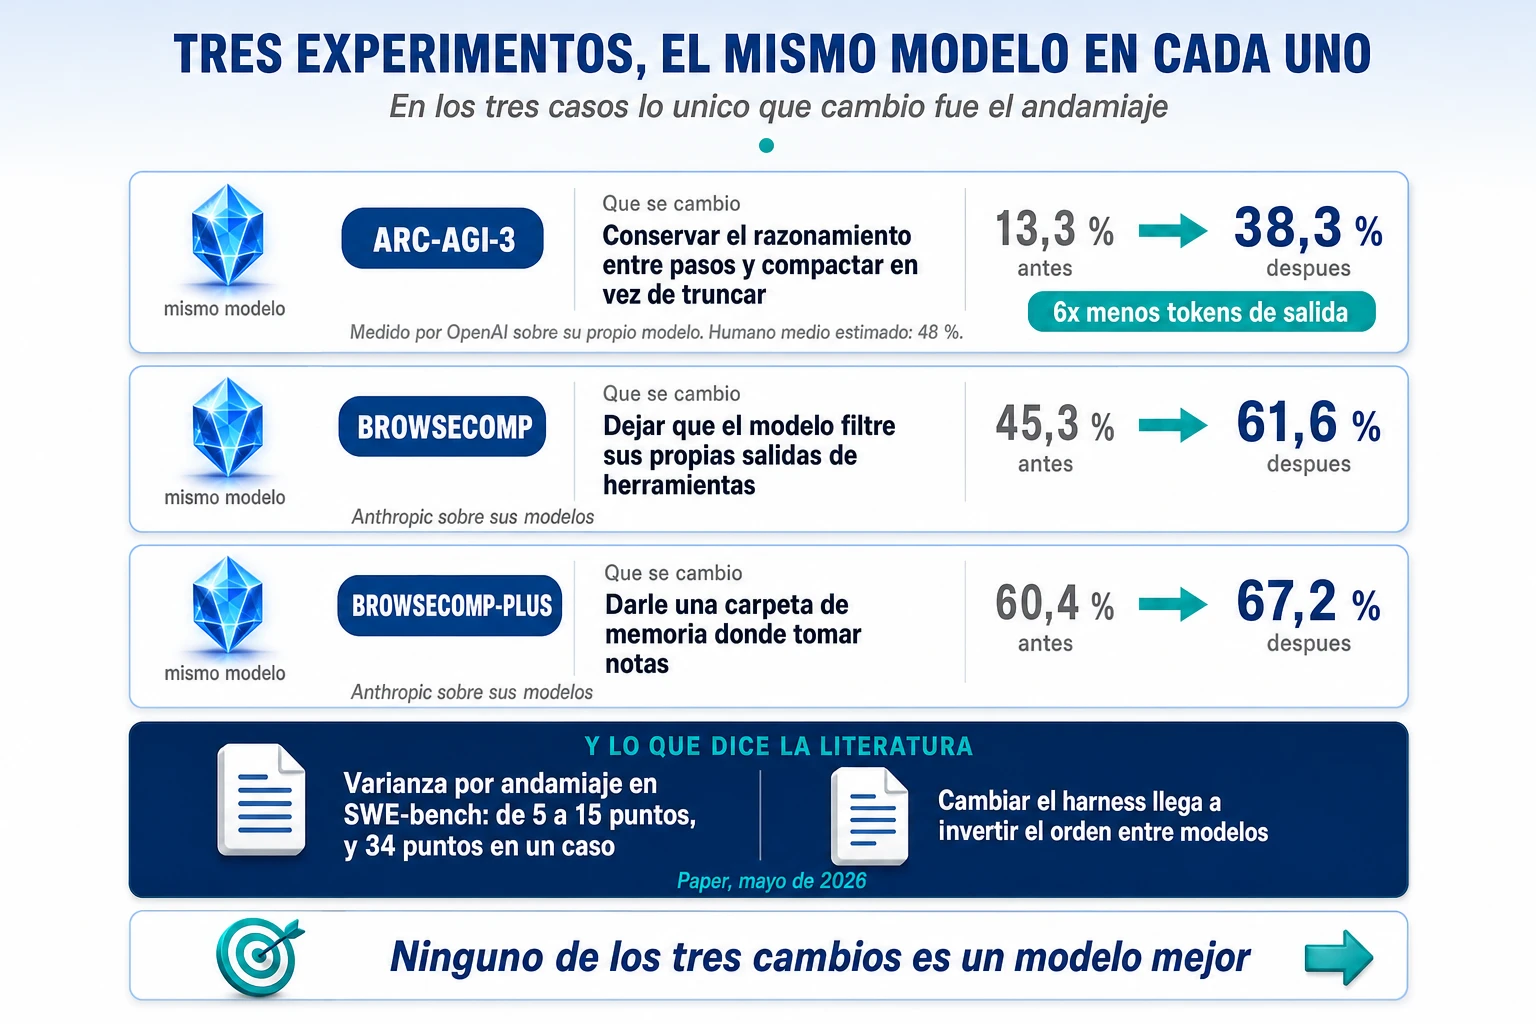
Cambiaron las dos cosas: conservar el razonamiento entre acciones y comprimir el historial en lugar de truncarlo por el principio. No reentrenaron el modelo, no le dieron más presupuesto de razonamiento, no tocaron un solo peso. La puntuación pasó del 13,3 % al 38,3 % en el conjunto público de tareas —aproximadamente el triple— y el modelo gastó unas seis veces menos tokens de salida (medido por OpenAI sobre su propio modelo, y contrastable contra el leaderboard público de ARC Prize). Para dar escala: estiman la puntuación de un probador humano medio en torno al 48 %.
Triplicar el resultado y dividir la factura por seis, a la vez, sin tocar el modelo. Esa frase debería incomodar a cualquiera que haya elegido un proveedor de IA comparando puntuaciones en una tabla.
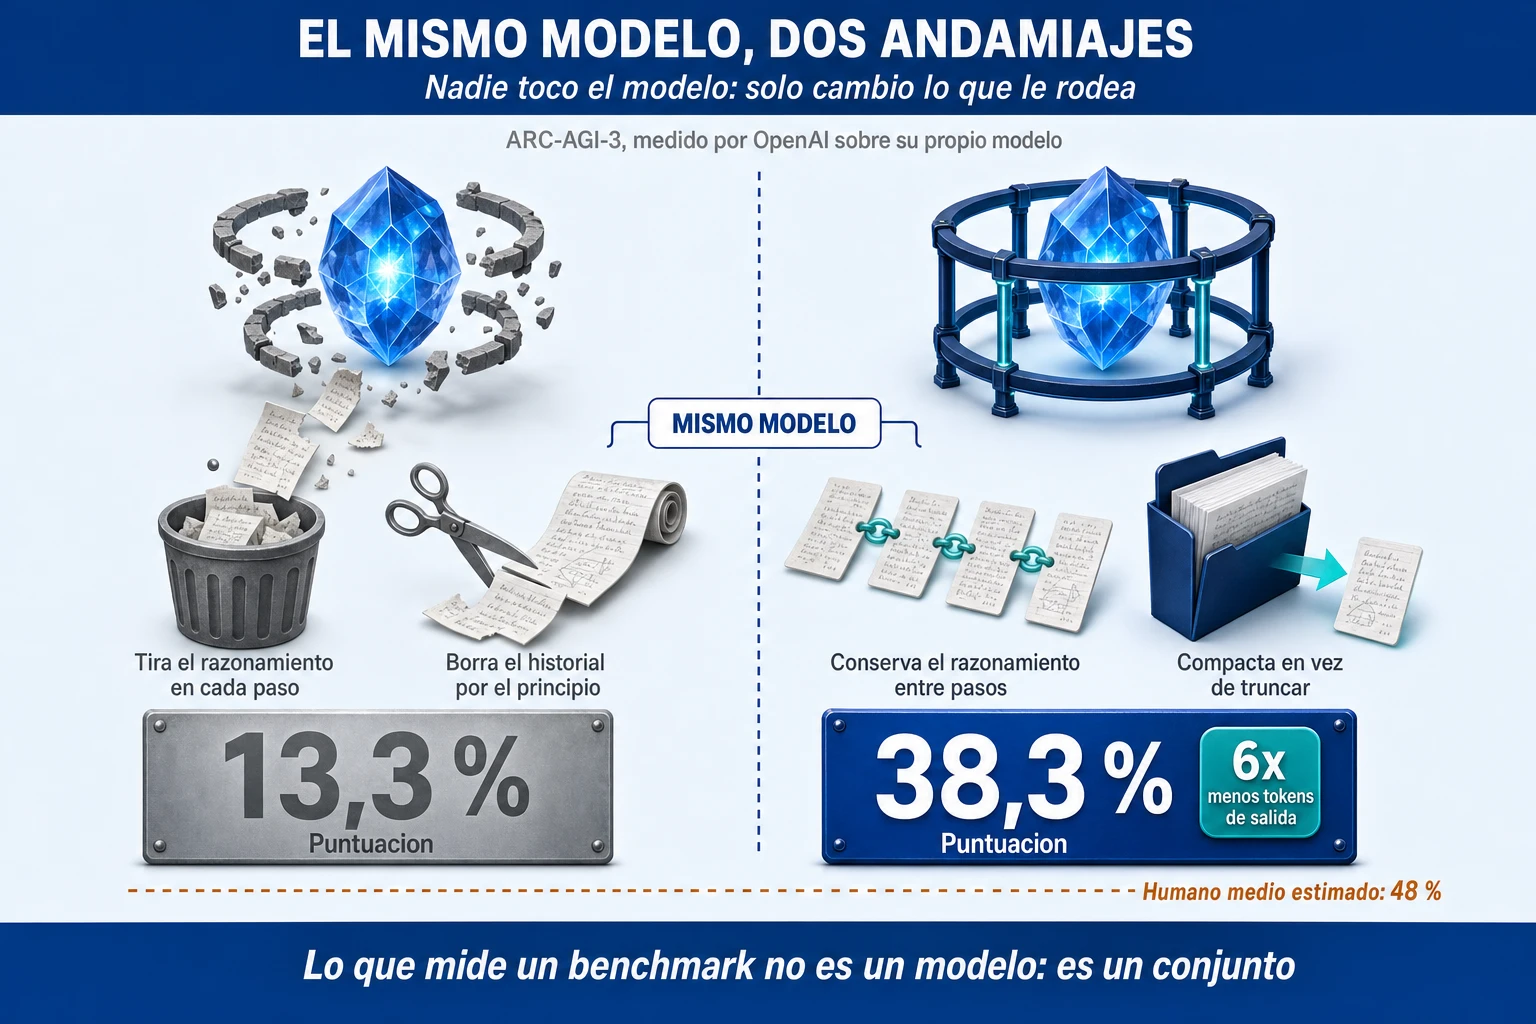
La lección que saca OpenAI es más general que su caso: «las evaluaciones rara vez miden modelos en aislamiento; también miden un conjunto de decisiones menos visibles sobre ajustes de API, diseño del harness y prompting». Y añaden un detalle que conviene leer dos veces: no era la primera vez que les pasaba.
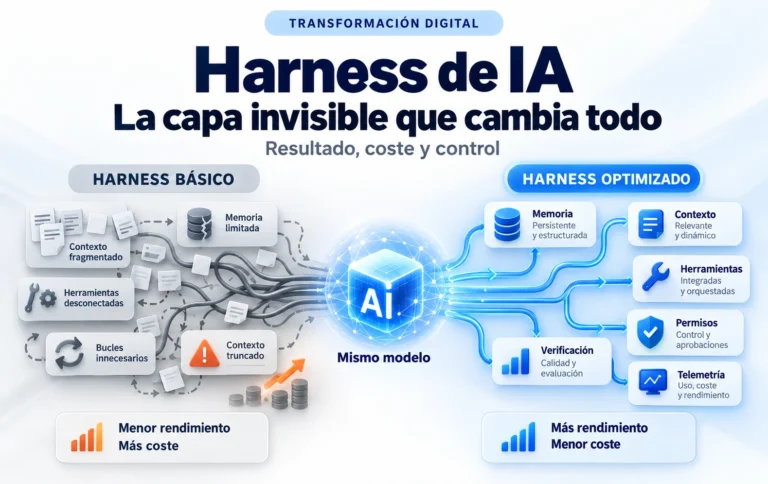
La palabra que nombra ese conjunto es harness. En castellano, arnés: el atalaje que convierte la fuerza de un caballo en tracción útil, porque sin él el animal tira igual de fuerte y no mueve el carro. Aquí se acaba la metáfora, y la abandonamos a propósito, porque un arnés es pasivo y esta capa no lo es: decide, corta y bloquea. En el resto del artículo usamos el término en inglés, que es el que va a encontrar el lector en la documentación, en el desplegable de su editor de código y —esto es nuevo— en su factura.
Quien haya seguido la conversación corporativa sobre agentes tendrá ahora una pregunta razonable: ¿otra caja al lado de MCP? Es la duda que nos planteó un cliente hace unas semanas: «no entiendo si esto es tan importante o está implícito, porque aquí veo que hablan más de MCP, de APIs y de gateways». La confusión está justificada y tiene una causa material: MCP se ve. Es un protocolo, tiene una web, tiene servidores que se instalan y una lista de herramientas que aparece en pantalla. El harness no se ve. Es el sitio donde ocurre todo y no tiene icono.
La tesis de este artículo es sencilla de enunciar y difícil de digerir. El modelo decide qué hacer a continuación; el harness decide si eso llega a hacerse, cuánto cuesta y quién responde por ello. Con el mismo modelo y las mismas herramientas, dos empresas obtienen resultados distintos, y la diferencia está casi siempre en esa capa que nadie enseña en las demos porque no se puede enseñar: no tiene pantalla.
Lo que sigue va en este orden: qué es un harness y en qué se distingue de un framework, de un orquestador y de una plataforma; qué pruebas hay de que importa, y cuánto importa exactamente; sus piezas y el síntoma que usted ve cuando falta cada una; cómo es un turno por dentro; por qué el contexto es la decisión dominante; qué separa una demo de algo que sobrevive a la noche; por qué el harness es la factura y por qué es el control; cómo se mide si es bueno; quién llama harness a qué en los cuatro grandes ecosistemas; por qué en casa parece magia y en la empresa parece un Lego; qué se puede llevar de un harness a otro; y seis preguntas para elegir sin que le vendan nada.
Qué es un harness, y por qué se llama así
Cuatro definiciones, y lo raro que es que coincidan
Lo interesante no es ninguna de las cuatro definiciones que vienen a continuación, sino que cuatro empresas que compiten entre sí, en menos de un año y sin ningún organismo de estandarización de por medio, hayan llegado a describir lo mismo casi con las mismas palabras. Eso no pasa con los términos vacíos.
Anthropic, en documentación de producto y no en un blog: «el bucle agéntico lo mueven dos componentes: modelos que razonan y herramientas que actúan. Claude Code es la capa alrededor del modelo que aporta las herramientas y gestiona el contexto que el modelo ve. Esa capa que lo rodea es a lo que se refiere el término agentic harness». Y en su glosario, la formulación más corta que existe: «Claude Code es el harness; Claude es el modelo que hay dentro».
Microsoft, en una página conceptual cuyo título es, literalmente, «Agent Harness»: «un agent harness es el andamiaje de ejecución que convierte un modelo de lenguaje en un agente capaz de hacer trabajo. Dirige las llamadas al modelo y a las herramientas, gestiona el estado y el contexto de la conversación, aplica políticas de aprobación y puede mantener al agente avanzando a lo largo de una tarea de varios pasos». Es la mejor de las cuatro para un comité de dirección, porque enumera responsabilidades y no mecanismos.
Google Cloud, en una página explicativa titulada «¿Qué es un agent harness?»: «el entorno de software que rodea a un modelo de inteligencia artificial y le da la capacidad de interactuar con herramientas externas, recordar interacciones anteriores y ejecutar tareas de varios pasos. Un modelo de lenguaje estándar solo puede generar texto; un agent harness convierte esa generación de texto en acción». En su blog lo dicen en una línea: «todo lo que envuelve al modelo y no es el modelo». Y Cloudflare, que no vende modelos y por tanto no tiene incentivo en inflar la capa: «el software que controla el acceso del modelo al mundo exterior».
Nosotros lo definimos de pasada en el artículo sobre arquitectura agéntica, casi como una nota al margen: el harness es «todo lo que rodea al modelo para que trabaje solo: el bucle de herramientas, la gestión del contexto, los permisos, la persistencia, la verificación, la telemetría». Este artículo existe porque esa frase se quedó corta, y porque las cuatro definiciones anteriores coinciden con ella en cuatro puntos exactos: el harness rodea al modelo, ejecuta herramientas, gestiona contexto y estado, y decide cuándo parar.
Del arnés del caballo al andamiaje del modelo
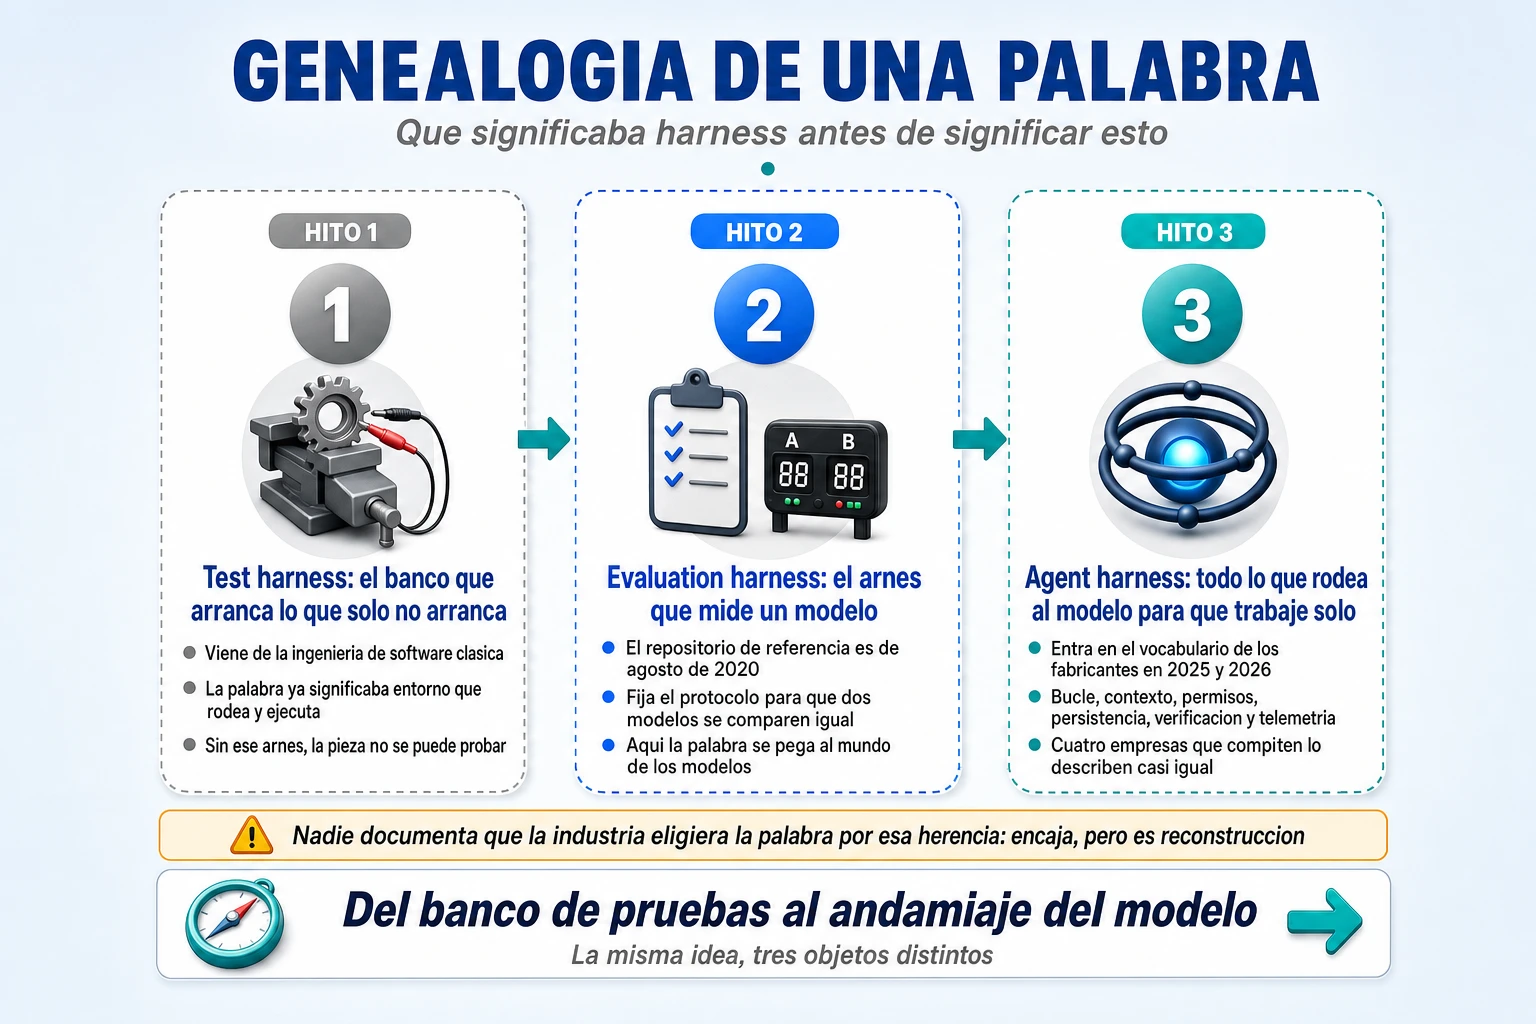
La palabra no es nueva. En la ingeniería de software clásica, un test harness es una colección de piezas auxiliares que permiten ejecutar y observar un componente que por sí solo no arranca porque le falta el entorno. La analogía viaja intacta: un modelo de lenguaje aislado no puede leer un fichero, ejecutar un comando ni recordar qué hizo ayer. Solo produce texto. El segundo tramo es el evaluation harness, la infraestructura que ejecuta y puntúa un modelo contra decenas de pruebas; el repositorio de referencia de esa categoría se creó el 28 de agosto de 2020 y sigue en uso seis años después como motor de varias clasificaciones públicas.
El tercer tramo, agent harness, es de 2025 y 2026. Aquí conviene una honestidad que casi nadie se toma: ninguna fuente primaria documenta que la industria eligiera la palabra por esa herencia. Quien lo ha buscado de forma explícita dice que no encontró evidencia con autoridad de que el sector la seleccionara por esa razón. La genealogía encaja, explica bien el concepto y es una reconstrucción nuestra. No es un dato histórico atribuible a nadie.
Un apunte periodístico que demuestra lo reciente que es todo esto: la documentación en español de uno de los cuatro grandes llega a usar cinco términos distintos para el mismo concepto en una sola página —arnés, harness, entorno estándar, entorno de prueba y marco de pruebas— y en algún encabezado traduce «harness» como si fuera un verbo, porque en inglés también lo es. No es un descuido de nadie en particular: es traducción automática de un término que todavía no tiene equivalente establecido en castellano. Por eso lo dejamos en inglés.
Cuatro capas y la pregunta que responde cada una
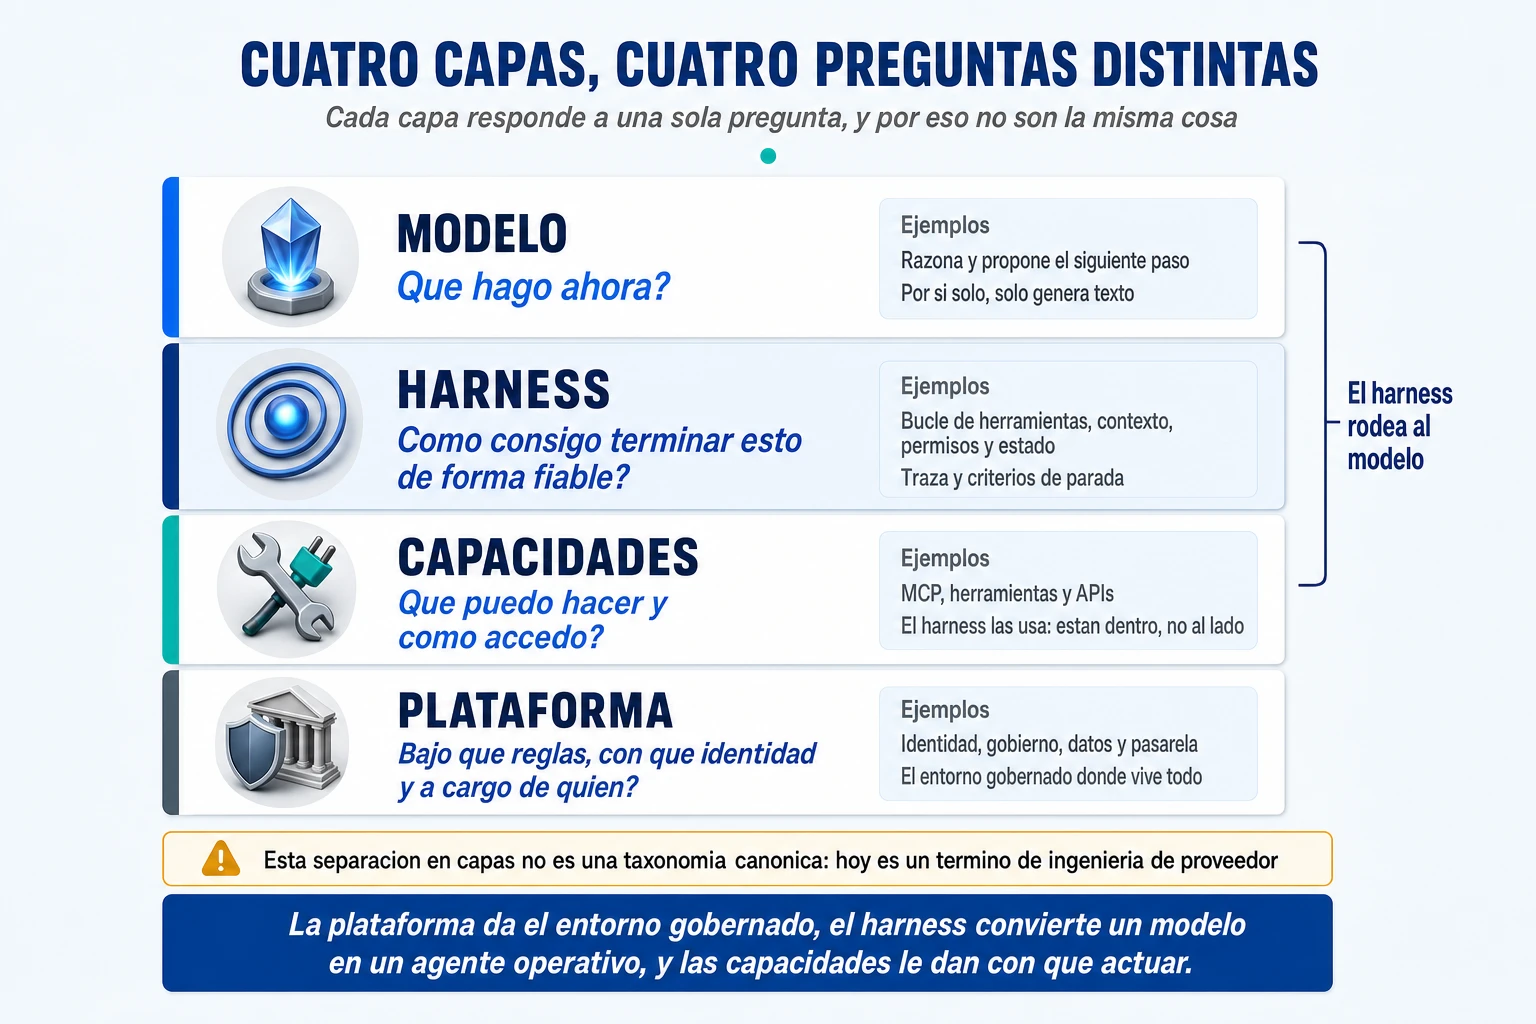
La forma más rápida de ordenar la conversación es asignar a cada capa la pregunta que responde. El modelo responde a «¿qué hago ahora?». El harness, a «¿cómo consigo terminar esto de forma fiable?». Las capacidades —herramientas, APIs, MCP, habilidades—, a «¿qué puedo hacer y cómo accedo?». Y la plataforma corporativa, a «¿bajo qué reglas, con qué identidad y a cargo de quién?». Puesto en una frase: la plataforma da el entorno gobernado, el harness convierte un modelo en un agente operativo, y MCP, las herramientas y las APIs le dan las capacidades con las que actuar. Eso resuelve el 80 % de las discusiones circulares en una reunión de arquitectura, porque casi siempre el desacuerdo es que dos personas están hablando de capas distintas convencidas de que hablan de la misma.
| Capa | La pregunta que responde | Ejemplos concretos | Dónde lo cubre este blog |
| Modelo | ¿Qué hago ahora? | El modelo de razonamiento que elige el siguiente paso y redacta la llamada a la herramienta | Fuera de alcance: cambia cada trimestre |
| Harness | ¿Cómo consigo terminar esto de forma fiable? | Bucle, construcción y compactación del contexto, permisos por acción, estado durable, criterios de parada, traza | Este artículo |
| Capacidades | ¿Qué puedo hacer y cómo accedo? | Herramientas, APIs de negocio, servidores MCP, habilidades empaquetadas, protocolo entre agentes | El artículo sobre la plataforma agéntica |
| Plataforma | ¿Bajo qué reglas, con qué identidad y a cargo de quién? | Identidad del agente, pasarelas, registro, gobierno del dato, observabilidad, control de gasto | El artículo sobre la plataforma agéntica |
Una advertencia antes de que nadie imprima este esquema y lo cuelgue en una pared: esta separación en capas no es una taxonomía canónica. Hay un fabricante que publica una pila con una capa llamada literalmente «Harness»; y hay una casa de analistas que en agosto de 2026 publicó una arquitectura de referencia para ejecución de agentes, con nueve componentes, en la que la palabra harness no aparece ni una sola vez —y que además mezcla nuestros tres planos, poniendo el gestor de contexto y el orquestador al mismo nivel que el gobierno y la observabilidad—.
Esa brecha es un dato en sí mismo. Harness es hoy un término de ingeniería de proveedor, no de industria: aparece en documentación de producto de las cuatro grandes y no aparece en el marco del analista que vende la arquitectura corporativa. Conviene saberlo antes de buscar el «cuadrante mágico de harnesses»: no existe.
Por qué se confunde con MCP, y el argumento que cierra la discusión
MCP —el protocolo que estandariza cómo un agente se conecta a fuentes de datos y herramientas externas— ocupó toda la conversación de 2025 por una razón legítima: resolvía un problema visible y doloroso, el de que cada integración fuera un trabajo a medida. Es un avance real y lo tratamos en su propio artículo, sobre la plataforma de agentes.
Pero MCP responde a qué puede hacer el agente y cómo accede. El harness responde a cómo consigue terminar la tarea usando eso. Y el argumento que cierra la discusión no lo damos nosotros: lo da Google sin proponérselo. En la misma página en la que define qué es un agent harness, MCP aparece dentro, como uno de los cuatro mecanismos con los que el harness resuelve el acceso a capacidades: «muchos agent harnesses modernos usan el Model Context Protocol», que «estandariza cómo los agentes se conectan a fuentes de datos y herramientas externas».
No son alternativas. Uno contiene al otro. Tener MCP y creer que con eso está el harness resuelto es como tener una red eléctrica normalizada y creer que con eso se tiene la fábrica.
Qué no es un harness
Un término nuevo atrae equipaje ajeno. En los últimos meses hemos oído llamar harness a un framework de orquestación, a una pasarela de IA, a un catálogo de herramientas y a un agente entero. Cuatro correcciones, empezando por la que más dinero cuesta.
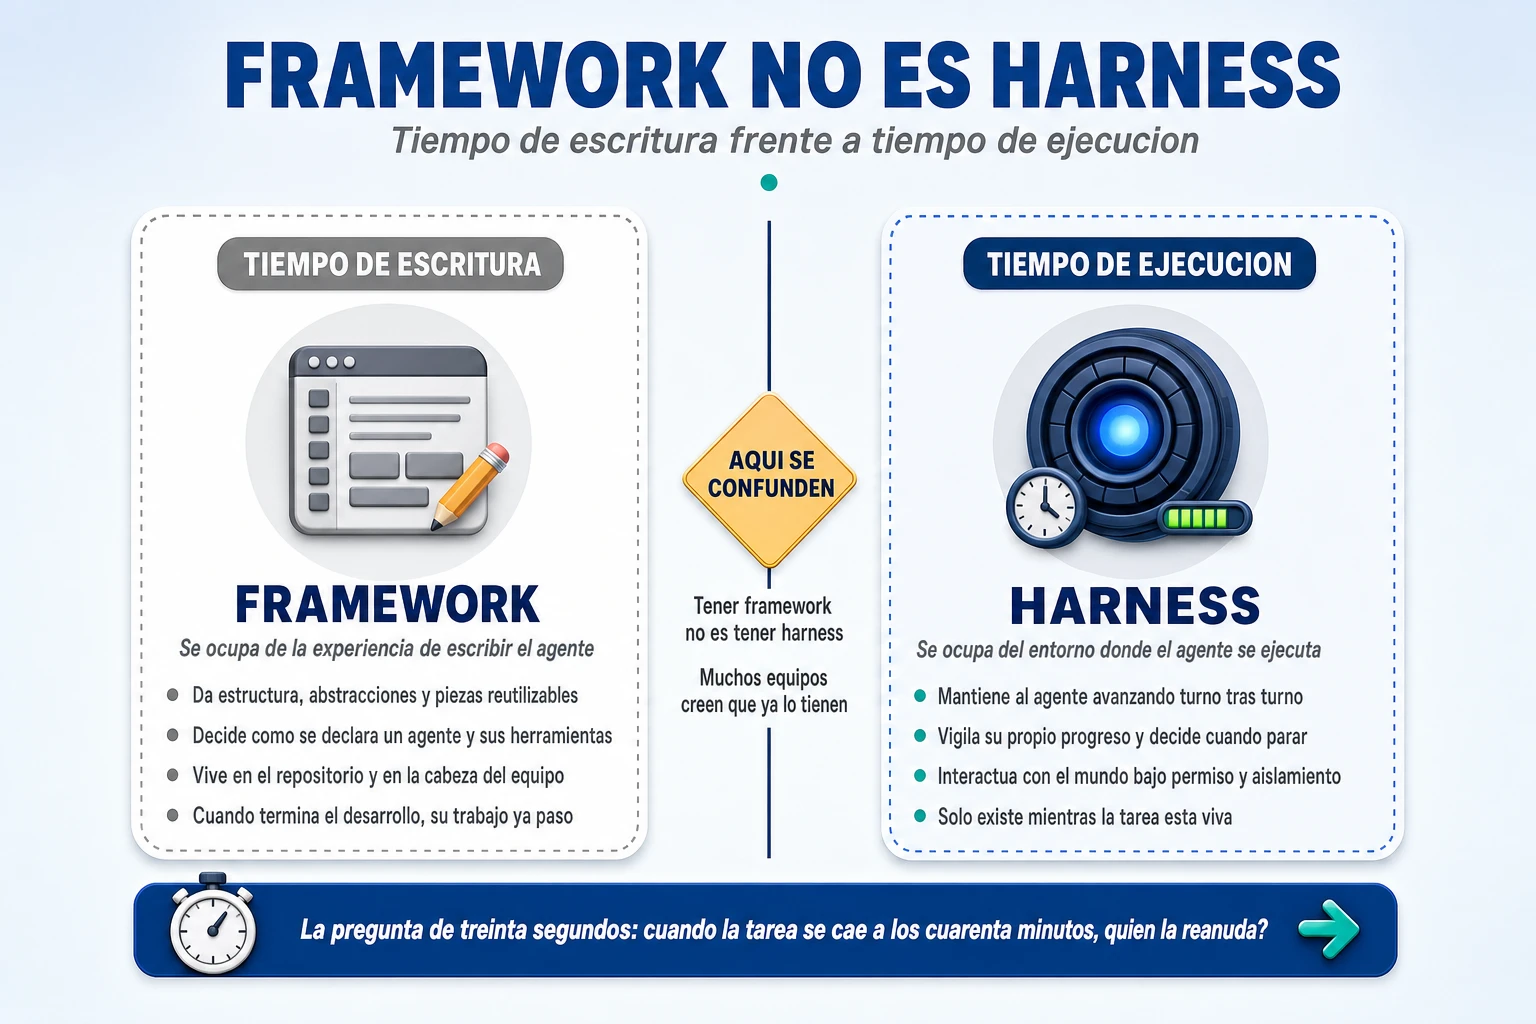
No es un framework: tiempo de escritura frente a tiempo de ejecución
La distinción más limpia está publicada, y es de Google, bajo un epígrafe que dice exactamente «agent harness frente a frameworks de orquestación»: «los frameworks de orquestación ayudan a los desarrolladores a construir aplicaciones con modelos de lenguaje encadenando prompts y fuentes de datos. Un agent harness es un tipo específico de entorno de despliegue construido explícitamente para agentes autónomos. Mientras el framework se centra en la experiencia de desarrollo de escribir el código, el harness se centra en el entorno de ejecución. Se asegura de que el agente pueda funcionar de forma continua, vigilar su propio progreso e interactuar con seguridad con sistemas externos».
Tiempo de escritura frente a tiempo de ejecución. Es la frontera entera, y explica el error más caro que vemos en empresas que ya han empezado: muchos equipos creen que tienen harness porque tienen framework. Han elegido una librería, han montado un grafo de nodos, han conectado herramientas y el agente funciona en la demo. Lo que no tienen es quién decide qué sale del contexto cuando se llena, qué pasa si el proceso muere a los cuarenta minutos, qué acción requiere permiso y cuándo hay que dejar de intentarlo. Eso no viene en el framework: son decisiones que el framework le deja tomar a usted.
Microsoft lo formula desde el otro lado con una precisión útil: su harness «compone piezas existentes del framework en lugar de definir un runtime aparte», y lo describe como «opinado y con las pilas incluidas». El framework son las piezas; el harness es un ensamblaje con las decisiones ya tomadas y valores por defecto que se pueden desactivar. La pregunta correcta no es «¿framework o harness?», es «¿quién ha tomado las decisiones del bucle, del contexto y de los permisos: yo o el paquete?». Si la respuesta es «nadie todavía», no hay harness: hay un prototipo con buena suerte.
No es un orquestador ni una pasarela
El orquestador reparte trabajo entre varios agentes y coordina sus traspasos; la pasarela aplica política en la frontera de red: autentica, enruta, mide cuotas, registra. La relación no es de alternativa sino de contención: el orquestador está dentro del harness, y la pasarela está en la capa de al lado. Un agente puede tener harness sin orquestación —un solo agente, un solo bucle—, pero no puede existir orquestación sin harness, porque alguien tiene que ejecutar cada agente coordinado. Si un producto se vende como «orquestador de agentes» y no dice nada del contexto, de los permisos y de la verificación, está vendiendo una parte y llamándola el todo.
No es el agente
El agente es el encargo: qué hace, con qué instrucciones, sobre qué datos, con qué herramientas, con qué nombre y con qué dueño. El harness es la maquinaria que lo ejecuta. Un mismo harness sostiene cientos de agentes distintos, igual que un mismo motor de base de datos sostiene cientos de aplicaciones. Y un mismo agente, definido con las mismas instrucciones, se comportará de forma distinta bajo dos harnesses distintos: eso es justamente el asunto de la sección siguiente.
Y no siempre hace falta
Conviene decirlo pronto, porque no lo dice nadie que venda esta capa. Y quien lo dice con más claridad es, curiosamente, un proveedor: «si su chatbot solo responde preguntas a partir de un prompt fijo o de sus datos de entrenamiento, no necesita un agent harness completo». Hace falta cuando hay varios pasos, herramientas reales y consecuencias: consultar una base de datos viva, navegar, ejecutar un flujo de varios pasos, reservar algo en nombre de alguien.
Esto encaja con la regla de la mínima autonomía que defendimos en el artículo de arquitectura agéntica: la primera pregunta no es qué harness, es si el caso necesita un agente. Un buscador con recuperación de documentos que responde bien no mejora porque le pongamos un bucle, permisos y estado durable. Empeora: se vuelve más lento, más caro y más difícil de auditar, y todo eso para resolver un problema que ya estaba resuelto.
| «Lo llamamos harness» | Qué es en realidad | Cómo distinguirlo en treinta segundos |
| Un framework de orquestación | Una librería para escribir el agente: grafos, nodos, roles, traspasos | Pregunte quién decide la compactación del contexto y el criterio de parada. Si la respuesta es «lo programamos nosotros», es framework |
| Una pasarela de IA | Política en la frontera de red: autenticación, cuotas, enrutado, registro | Pregunte si sabe en qué paso de la tarea va el agente. Si no lo sabe, es pasarela |
| Un catálogo de herramientas o servidores MCP | Capacidades: qué puede hacer el agente y cómo accede | Pregunte qué pasa cuando hay ciento veinte herramientas disponibles. Si no hay respuesta, falta el harness |
| El agente | El encargo: instrucciones, datos, herramientas, dueño | Pregunte cuántos agentes distintos corren sobre lo mismo. Si solo uno, está mirando el agente, no la capa |
| La plataforma corporativa | El entorno gobernado: identidad, registro, observabilidad, gasto | Pregunte si funciona con un solo agente en un portátil. La plataforma no; el harness sí |
La prueba: mismo modelo, distinto resultado
Hasta aquí, definiciones. Ahora los números, porque esta es la parte que no se puede decir sin ellos. Y conviene avisar desde el principio: la prueba es buena, pero no dice lo que la mayoría de la gente cree que dice.
El caso de ARC-AGI-3, con la tensión honesta incluida
Los números están ya dados: 13,3 % con el andamiaje oficial, 38,3 % con el de OpenAI, unas seis veces menos tokens de salida, mismo modelo y ningún reentrenamiento. Lo que merece detalle es el mecanismo, porque los dos defectos son errores que comete cualquiera sin darse cuenta.
Descartar el razonamiento privado tras cada acción parece incluso sensato: es largo, ocupa contexto y ya se ha «consumido» al producir la acción. Pero significaba que «con cada acción se le pedía al modelo que descifrase el juego de nuevo, sin poder recordar su pensamiento anterior». El efecto de arreglarlo fue doble y contraintuitivo: el modelo empezó a pensar menos antes de cada acción, porque ya no tenía que reinterpretar el juego desde cero, y a la vez aprendía mejor a lo largo de la partida. Truncar por el principio, el segundo defecto, es lo que hace por defecto casi todo el mundo la primera vez que se topa con el límite de la ventana: es la solución de una línea. Sus dos inconvenientes son que el modelo pierde observaciones previas sin saber que las ha perdido, y que pasa buena parte de la tarea operando con la ventana casi llena, lo que «puede deteriorar ligeramente el rendimiento».
Aquí viene la tensión que hace el caso mucho más interesante, y que casi nunca se cuenta: los dueños del benchmark no se equivocaron. Eligieron un andamiaje genérico a propósito, y su razonamiento, recogido por OpenAI, es que «un harness simple hace más visibles las carencias del modelo y hace más justas las comparaciones». Los desarrolladores comerciales hacen lo contrario: optimizan el andamiaje para las características y las rarezas de cada modelo. Los dos criterios son defendibles y dan resultados distintos. Comparar de forma justa exige el mismo andamiaje para todos, lo que penaliza a los modelos entrenados para otro; medir lo que usted va a obtener exige que cada modelo lleve su mejor andamiaje, lo que hace imposible la comparación. Son dos preguntas distintas que la industria venía contestando con la misma tabla.
Los experimentos controlados: qué se cambió exactamente
Anthropic ha publicado tres experimentos del mismo género y son, técnicamente, los más limpios que existen: un solo cambio en el andamiaje, un solo modelo, un benchmark público. Son cifras del fabricante sobre sus propios modelos, sin contraste independiente, y hay que leerlas así. En una evaluación de navegación y búsqueda, dar al modelo la capacidad de filtrar sus propias salidas de herramientas —dejarle decidir qué parte del resultado de una búsqueda se queda en el contexto— subió la exactitud del 45,3 % al 61,6 %. En una variante, darle una carpeta donde tomar notas que sobreviven entre pasos la subió del 60,4 % al 67,2 %. Y dejarle lanzar subagentes con ventana propia añadió 2,8 puntos sobre la mejor ejecución de un solo agente.
Lo notable no son los porcentajes: es qué se cambió. Ninguno de los tres es un modelo mejor, ni más razonamiento, ni un prompt más ingenioso. Uno es permiso para olvidar selectivamente; otro es un sitio donde escribir; el tercero es una ventana limpia para una subtarea.
Y aquí hay que dar la vuelta al argumento, porque el mismo equipo que publica esas cifras lleva dos años haciendo lo contrario de lo que se deduciría de ellas. Su filosofía declarada al construir agentes de programación es «dar el máximo control posible al propio modelo de lenguaje y mantener el andamiaje mínimo»: literalmente dos herramientas, ejecutar comandos y editar ficheros. Y en su documento de patrones lo convierten en regla: «adelgace su harness: pregúntese qué puede dejar de hacer». El harness importa mucho, y parte de lo que importa es saber qué quitar.
Lo que dice la literatura, y el matiz que lo cambia todo
En mayo de 2026 se publicó un artículo de posición académico dedicado exactamente a esto, con un título que ya es un argumento: «Dejen de comparar agentes de LLM sin declarar el harness». Su tesis central, la «tesis de la restricción dominante», dice que en tareas de largo horizonte y entre modelos de capacidad frontera comparable, la varianza de rendimiento la gobierna más la configuración del harness que la elección de modelo.
Los números que recopila y produce, todos con modelo fijo y cambiando solo el andamiaje: entre 5 y 15 puntos porcentuales de varianza de forma rutinaria en las evaluaciones de ingeniería de software más citadas, 34 puntos en un caso extremo, 7,3 puntos de mejora en una evaluación de terminal solo por la evolución del andamiaje, y entre 8,5 y 13 puntos en una rejilla controlada de tres modelos. El dato que remata el argumento es comparativo: ese rango es mayor que la mejora que muchos anuncios de modelo presentan como un salto generacional, que suele estar en dos a cuatro puntos. Reportan además algo peor que la varianza: inversiones de ranking. Cambiar el harness puede invertir qué modelo parece mejor.
Su propuesta es concreta: que cada envío a una clasificación pública venga con una «tarjeta del harness», una declaración estructurada de la configuración —ejecución, herramientas, contexto, planificación, observabilidad, verificación y permisos—. Y su frase de cierre es la que un directivo debería recortar: «mientras no se declaren las especificaciones del harness, las comparaciones de clasificaciones para agentes de largo horizonte deben tratarse como incompletas y potencialmente engañosas».
Y ahora el matiz que impide que esta sección se convierta en propaganda, porque es el dato más útil de toda la investigación. Otro preprint de 2026 compara harnesses sobre el mismo modelo y encuentra hasta 40 veces de diferencia en tokens por tarea resuelta, y sin embargo solo de 0 a 8 puntos porcentuales de diferencia en tasa de acierto. Mismo modelo, mismo resultado, cuarenta veces el gasto.
Cambiar de harness casi siempre cambia mucho lo que cuesta, y a veces cambia mucho lo que consigues. Nunca es neutro.
Las dos cosas son verdad y no se contradicen. Cuando el harness cambia mucho el resultado es porque el andamiaje de partida tenía un defecto grave: tiraba el razonamiento entre pasos, truncaba por el principio, no dejaba filtrar las salidas de herramientas. Entre dos harnesses razonables, la diferencia de acierto es modesta y la de factura es abismal. Eso da una recomendación distinta, y mejor: no busque el harness que le suba dos puntos en un benchmark; busque el que no le multiplique la factura por diez haciendo exactamente lo mismo.
La consecuencia incómoda para una empresa
Si el andamiaje mueve el resultado entre cinco y quince puntos, entonces el benchmark que usted lee no predice lo que va a obtener, porque su casa tiene otro harness. No es una objeción teórica: es la razón por la que tantos pilotos reproducen mal las cifras del anuncio y el equipo concluye que «el modelo no es tan bueno como decían». A veces es cierto. Casi siempre lo que ha cambiado es todo lo demás.
La buena noticia es que el sector ha empezado a corregirlo en público. El dueño de la evaluación que abre este artículo reporta hoy dos harnesses distintos como configuraciones separadas en su clasificación —uno estándar y otro que conserva el estado de razonamiento y compacta las conversaciones largas—, y una clasificación de tareas de terminal muy seguida tiene columnas independientes para el modelo y para el agente, además de coste y tokens. Los que aún no lo hacen son los que miden un solo artefacto de salida —un parche, una respuesta—, donde durante años se dio por supuesto que el andamiaje era ruido.
Y la consecuencia comercial que nadie está midiendo
Si el harness mueve el resultado, el fabricante que vende modelo y harness juntos tiene un incentivo evidente en que los dos encajen. Y uno de ellos lo dice abiertamente en su propia documentación: todas sus superficies «funcionan sobre un agent harness compartido y muy optimizado, co-entrenado con los modelos» de la casa (afirmación del fabricante sobre sí mismo, sin contraste independiente). Es la frase más fuerte de todo el corpus de proveedores, porque implica que el harness no es un envoltorio neutro.
Y hay evidencia académica de que el fenómeno inverso también ocurre. Un trabajo de agosto de 2026 encuentra que los modelos de pesos abiertos afinados con trayectorias recogidas casi exclusivamente bajo un andamiaje concreto «puntúan bien bajo ese andamiaje pero se degradan sustancialmente al desplegarse bajo cualquier andamiaje distinto al de entrenamiento», mientras que los modelos base sin afinar no muestran esa divergencia. La dependencia no es intrínseca: se induce al afinar.
| Experimento | Qué se cambió (y qué no) | Antes → después | Quién lo mide |
| Evaluación de razonamiento visual (ARC-AGI-3) | Conservar el razonamiento entre acciones y compactar en vez de truncar. Mismo modelo, mismos pesos, mismo presupuesto de razonamiento | 13,3 % → 38,3 %, con ~6 veces menos tokens de salida | OpenAI sobre su propio modelo, contrastable contra la clasificación pública |
| Evaluación de búsqueda en web | Dejar al modelo filtrar sus propias salidas de herramientas. Mismo modelo | 45,3 % → 61,6 % | Anthropic sobre sus propios modelos, sin contraste independiente |
| Variante de la misma evaluación | Darle una carpeta de memoria donde tomar notas. Mismo modelo | 60,4 % → 67,2 % | Anthropic sobre sus propios modelos |
| Evaluaciones de ingeniería de software | Solo el andamiaje, con modelo fijo | 5 a 15 puntos porcentuales de varianza; 34 puntos en un caso | Artículo académico de mayo de 2026, agregando clasificaciones públicas |
| Comparación de harnesses sobre el mismo modelo | Solo el harness | Hasta 40 veces en tokens por tarea resuelta; solo 0 a 8 puntos en acierto | Preprint de 2026, sin revisión por pares |
Anatomía: doce piezas y el síntoma cuando falta cada una
Esta es la sección de referencia del artículo, organizada de forma deliberada: no como una lista de doce componentes, sino como seis bloques con una función y un síntoma. Porque a un directivo no le sirve saber que existe la «detección de estancamiento»; le sirve reconocer que su agente lleva tres semanas dando vueltas y que eso tiene un nombre y una causa.
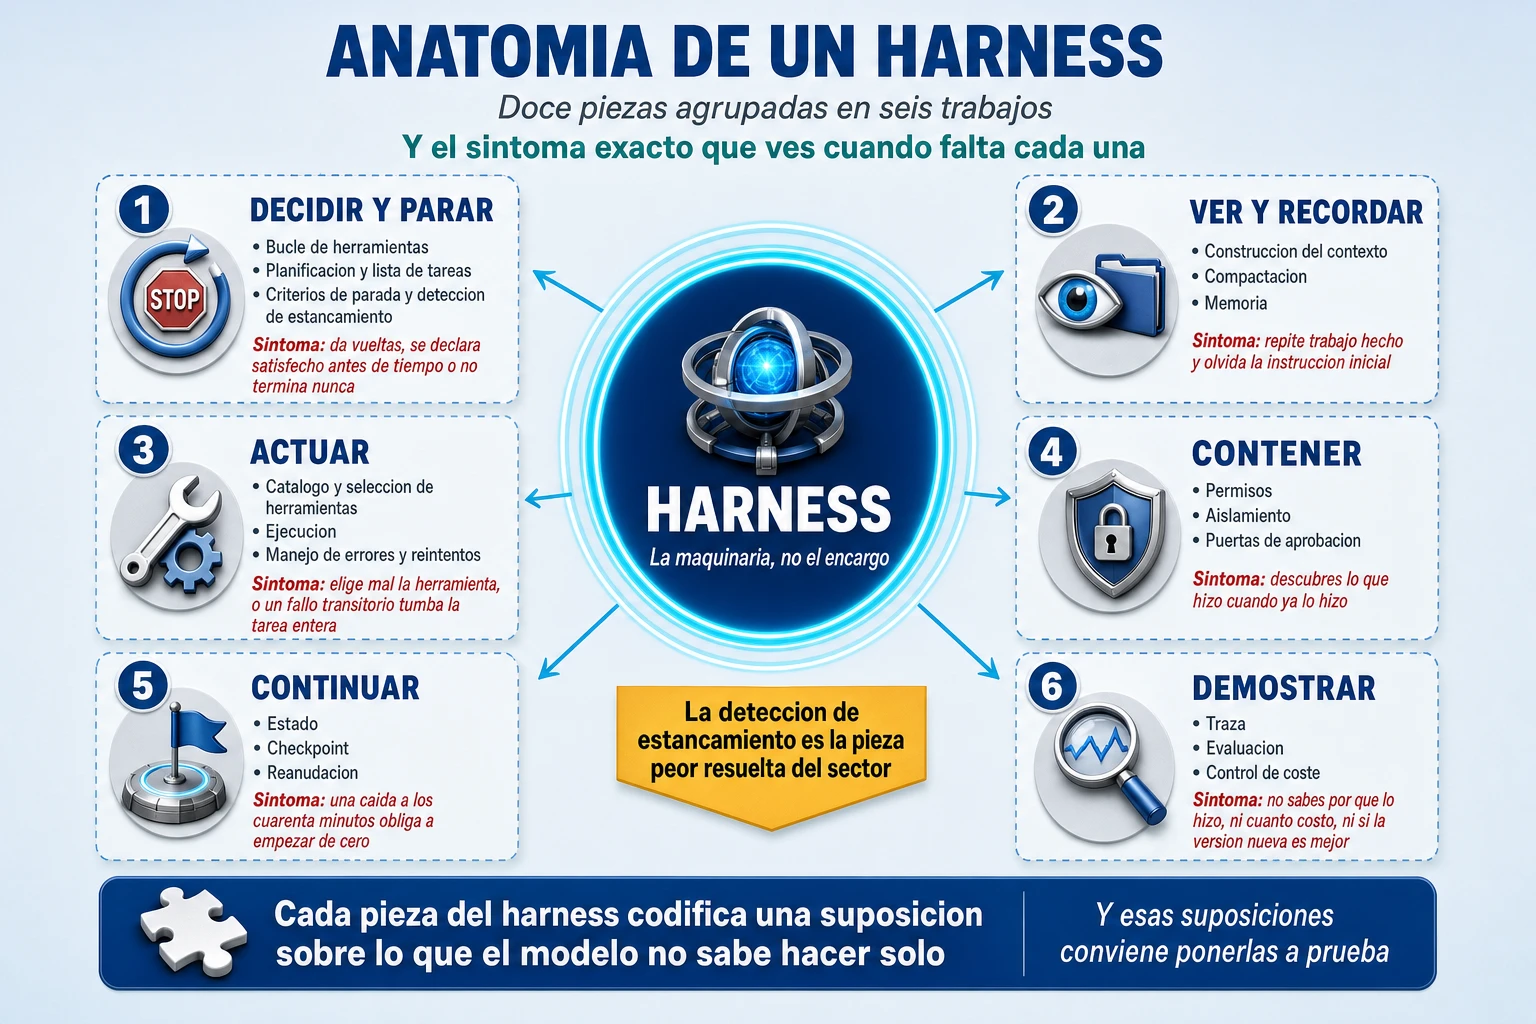
Decidir y parar
Tres piezas: el bucle de herramientas, la planificación con su lista de tareas, y los criterios de parada con detección de estancamiento. El bucle convierte una respuesta en una secuencia: el modelo pide una herramienta, alguien la ejecuta, el resultado vuelve, y otra vez. La planificación permite que la secuencia tenga forma en lugar de ser una deriva. Los criterios de parada deciden que se ha terminado. Síntoma cuando falta: el agente da vueltas sobre lo mismo, se declara satisfecho antes de tiempo, o no termina nunca. Los tres fallos son la misma pieza vista desde tres ángulos.
Un dato honesto que conviene saber antes de firmar nada: en varios de los harnesses mejor documentados del mercado, el criterio de parada por defecto es «cuando el modelo deje de pedir herramientas», sin ningún límite. Uno de ellos lo escribe con todas las letras: sin límites, el bucle corre hasta que el modelo termina por su cuenta, «lo cual está bien para tareas bien delimitadas pero puede alargarse mucho con encargos abiertos». Dos de los cuatro grandes publican un límite numérico por defecto —quinientas llamadas al modelo en un caso, diez iteraciones en otro—; los otros dos lo dejan en «sin límite». Y un detalle que revela madurez: un harness serio distingue cinco formas de terminar y solo una es éxito —terminó bien, se agotaron los turnos, se agotó el presupuesto, falló al ejecutar, falló al validar la salida—. Un sistema que no distingue «terminó» de «se le acabó el dinero a mitad» no puede medirse.
Y el dato más importante de este bloque: la detección de estancamiento es la pieza peor resuelta del sector. Nadie la ofrece madura de serie. Lo más avanzado que hemos encontrado son evaluadores de finalización en uno de los ecosistemas —incluido un modelo juez separado que decide si la petición original está realmente atendida—, y están marcados como experimentales. La mejor formulación del problema es de un ingeniero que trabaja en esto a diario: hay que asignar el juicio sobre si el trabajo está terminado a algo que no sea el propio trabajador que quiere haber acabado. Si no, el agente es a la vez el examinando y el tribunal.
Ver y recordar
Tres piezas: la construcción del contexto —qué información entra en cada llamada al modelo, en qué orden y en qué forma—, la compactación —qué se hace cuando ya no cabe— y la memoria —qué sobrevive a la sesión—. Es el bloque que decide más, y por eso tiene su propia sección más adelante. Síntoma cuando falta: el agente repite trabajo que ya había hecho, olvida la instrucción inicial a mitad de la tarea, o contradice lo que él mismo dijo hace veinte pasos. Y el peor de todos, porque no deja rastro: da una respuesta plausible construida sobre información que tenía delante y no usó.
Hay una frase que resume la filosofía de esta capa mejor que cualquier explicación, y no es de un artículo de opinión: es la instrucción que un proveedor inyecta automáticamente en el prompt de sistema cuando el agente tiene memoria activada. Termina así: «Asuma la interrupción: su ventana de contexto puede reiniciarse en cualquier momento, así que corre el riesgo de perder cualquier progreso que no esté registrado en su directorio de memoria». Un proveedor diciéndole al modelo, por defecto, que trabaje como si fuera a desaparecer.
Actuar
Dos piezas: el catálogo de herramientas con su mecanismo de selección, y la ejecución con su manejo de errores y reintentos. La primera parece trivial y no lo es: qué herramientas ve el modelo en cada momento, cómo se describen, cómo se eligen entre ciento veinte. Síntoma cuando falta: elige mal la herramienta de forma sistemática —no aleatoria, sistemática, y eso es una pista— o un fallo transitorio de red tumba una tarea de cuarenta minutos. Un proveedor lo documenta como propiedad estructural y no como defecto: «los fallos menores del sistema pueden ser catastróficos para los agentes», precisamente porque acumulan estado.
Contener
Dos piezas: los permisos con su política, y el aislamiento con sus puertas de aprobación. Los permisos deciden si una llamada concreta se ejecuta, se pregunta o se bloquea; el aislamiento decide hasta dónde llega el daño si se ejecuta. Son ortogonales, y confundirlos es el error de arquitectura más común de esta capa. Uno de los proveedores lo dice de forma inmejorable: los modos de permiso deciden si el agente pregunta antes de una acción, y las fronteras de aislamiento deciden qué puede alcanzar esa acción una vez que corre. Síntoma cuando falta: descubre lo que hizo el agente cuando ya lo ha hecho. No hay síntoma intermedio, y esa es toda la gravedad del asunto.
Continuar
Una pieza con tres caras: el estado, el punto de control y la reanudación. Dónde vive lo que el agente sabe, cada cuánto se confirma, y desde dónde se retoma si algo se cae. Es la diferencia entre un bucle que vive en la memoria de un proceso y uno que sobrevive al proceso. Síntoma cuando falta: una caída a los cuarenta minutos obliga a empezar de cero, y —esto es lo caro— algunas acciones se repiten. Perder trabajo es un coste; repetir un cobro es un incidente.
Demostrar
Una pieza con tres funciones: la traza —qué hizo, con qué permiso y con qué datos—, la evaluación —si la versión nueva es mejor que la anterior— y el control de coste —cuánto ha gastado cada agente, cada tarea y cada persona—. Síntoma cuando falta: no sabe por qué hizo lo que hizo, ni cuánto le costó, ni si la actualización del modelo ha empeorado el resultado. Los tres son el mismo síntoma con distinto destinatario: el auditor, el director financiero y el equipo. Y un principio de diseño que se olvida siempre: la observabilidad debe estar fuera del contexto, no dentro. Los puntos de intercepción del bucle corren en el proceso de la aplicación, no en la ventana del modelo, y por eso no consumen contexto.
Y ahora la frase que mejor explica por qué esta lista de doce piezas será distinta el año que viene. Es de un ingeniero de Anthropic, en marzo de 2026:
Cada componente de un harness codifica una suposición sobre lo que el modelo no sabe hacer solo, y esas suposiciones conviene ponerlas a prueba.
Léala otra vez pensando en su propio proyecto. Si tiene un módulo que trocea las tareas en subtareas, es porque asume que el modelo no sabe trocearlas. Si tiene un validador que comprueba el formato de la salida, es porque asume que el modelo no lo respeta. A medida que el modelo aprende a hacer algo solo, la pieza que lo suplía deja de aportar y empieza a estorbar. Parte de su harness es deuda técnica con fecha de caducidad, y la disciplina correcta —que uno de los proveedores publica como principio— es quitar un componente a la vez y medir si algo se rompe.
| Pieza | Qué hace | Qué ve cuando falta | Quién suele traerla de serie |
| Bucle de herramientas | Encadena inferencia, acción y observación hasta terminar | Un asistente que responde pero no hace | Todos. Es lo mínimo |
| Planificación y lista de tareas | Da forma explícita a la secuencia y registra lo hecho | Deriva: el agente se pierde en una rama y no vuelve | Los cuatro grandes, con distinto grado de automatismo |
| Criterios de parada y detección de estancamiento | Decide cuándo se ha terminado y cuándo se está perdiendo el tiempo | No termina nunca, o se declara satisfecho antes de tiempo | Parada, sí. Estancamiento, nadie de forma madura |
| Construcción del contexto | Elige qué ve el modelo en cada llamada | Respuestas plausibles sobre información que ignoró | Todos, con políticas muy distintas |
| Compactación | Comprime el historial cuando ya no cabe | Se pierde la instrucción inicial a mitad de la tarea | Los cuatro, uno de ellos en estado experimental |
| Memoria | Conserva lo que debe sobrevivir a la sesión | Cada sesión empieza de cero y repite trabajo | Todos, con formatos incompatibles entre sí |
| Catálogo y selección de herramientas | Decide qué herramientas ve el modelo y cuándo | Elige mal de forma sistemática; el contexto se llena antes de empezar | Todos; la carga bajo demanda solo algunos |
| Ejecución, errores y reintentos | Ejecuta, captura el fallo y decide si vuelve a intentarlo | Un fallo transitorio tumba la tarea entera | Todos, casi nunca con presupuesto global |
| Permisos y política | Decide si esta llamada concreta se ejecuta, se pregunta o se bloquea | Se enteró de lo que hizo cuando ya estaba hecho | Los cuatro grandes, con granularidad distinta |
| Aislamiento y puertas de aprobación | Limita el alcance del daño y pide firma en lo irreversible | Un comando desafortunado sale del perímetro | Todos; el nivel de aislamiento varía mucho |
| Estado, punto de control y reanudación | Permite retomar sin repetir | Una caída obliga a empezar de cero y repite acciones | Parcialmente; lo fuerte está en los motores de ejecución duradera |
| Traza, evaluación y control de coste | Permite explicar, comparar y facturar | No puede responder qué hizo, por qué ni cuánto costó | Todos ofrecen trazas; la evaluación comparativa, pocos |
Un turno por dentro
Los cuatro grandes describen el bucle de forma casi idéntica. Puestas en una secuencia, las fases de una sola iteración —lo que la documentación llama un turno— son nueve, y merece la pena recorrerlas despacio una vez, porque después todo lo demás se explica solo.
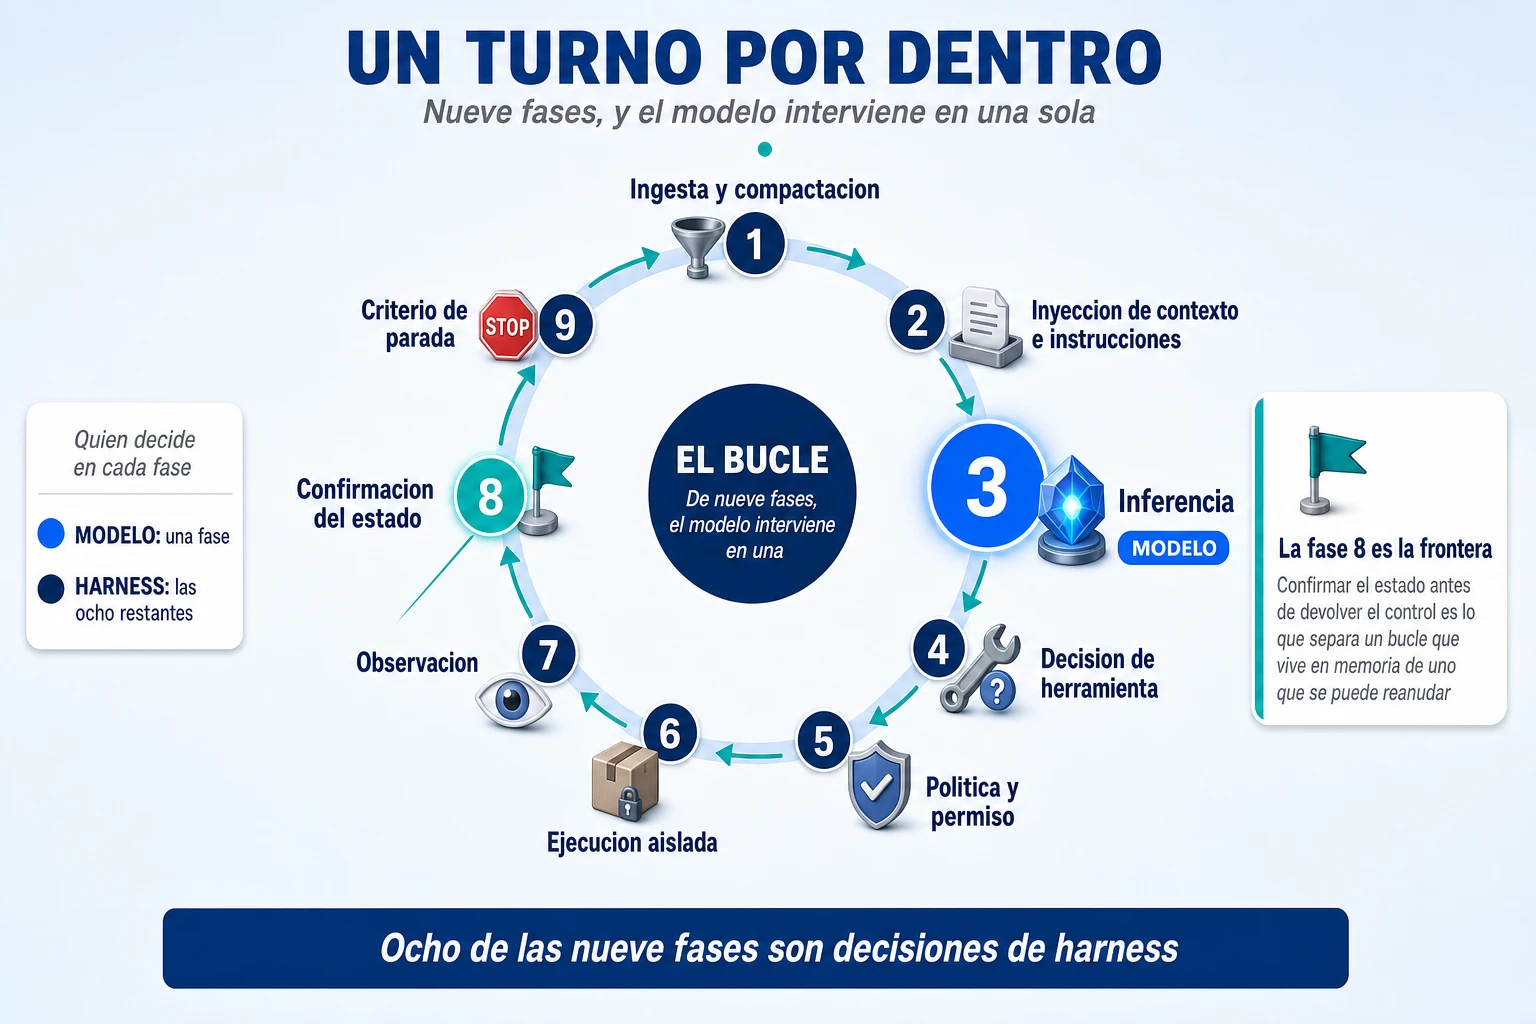
Uno, ingesta y compactación. Llega una instrucción nueva y el harness decide si el historial acumulado cabe; si no cabe, comprime o descarta antes de seguir. Dos, inyección de contexto e instrucciones. Se monta lo que el modelo va a ver: el prompt de sistema, el fichero de instrucciones del proyecto, las definiciones de las herramientas disponibles en este momento, el historial y lo que se recupere de memoria. Tres, inferencia. El modelo lee todo eso y produce texto: una respuesta, una o varias peticiones de herramienta, o ambas. Cuatro, decisión de herramienta. El harness interpreta la salida y reconoce una petición de acción con sus argumentos.
Cinco, política y permiso. Antes de ejecutar nada se consulta la regla: esta herramienta con estos argumentos, ¿se permite, se pregunta o se deniega? Seis, ejecución aislada, dentro de la frontera que se haya definido. Siete, observación: el resultado —o el error— vuelve al historial en un formato que el modelo pueda leer. Ocho, confirmación del estado: lo que ha cambiado se escribe en algún sitio antes de continuar. Nueve, criterio de parada: ¿hay otra petición pendiente? ¿Se ha alcanzado el límite de turnos o de presupuesto? ¿Ha declarado el modelo que ha terminado, y hay algo que lo verifique?
Dos observaciones sobre esta secuencia, y son las dos que justifican todo este artículo. La primera: de las nueve fases, el modelo solo interviene en una. Las otras ocho las ejecuta software convencional, determinista, escrito por alguien. Cuando un agente falla, la probabilidad de que el fallo esté en la fase tres es mucho menor de lo que sugiere la conversación pública.
La segunda: la fase ocho es la frontera entre un juguete y un sistema. Un bucle que guarda el estado en la memoria del proceso funciona perfectamente hasta que el proceso muere. Un bucle que confirma el cambio de estado en un almacén externo antes de devolver el control se puede reanudar. Solo dos de los cuatro grandes nombran esa fase como fase propia en su documentación, y uno de ellos la describe de forma explícita: el ejecutor confirma el cambio de estado en un servicio de sesión externo antes de que el agente vea la siguiente iteración. Si esa fase falta, el agente «sabe» cosas que nadie ha escrito en ningún sitio, y una caída las borra.
El contexto es donde se decide casi todo
Si hubiera que quedarse con una sola pieza del harness, sería esta. Y no por elegancia conceptual: porque es la única que decide a la vez la calidad y la factura, y porque es donde estaban los dos defectos que triplicaron una puntuación al arreglarlos.
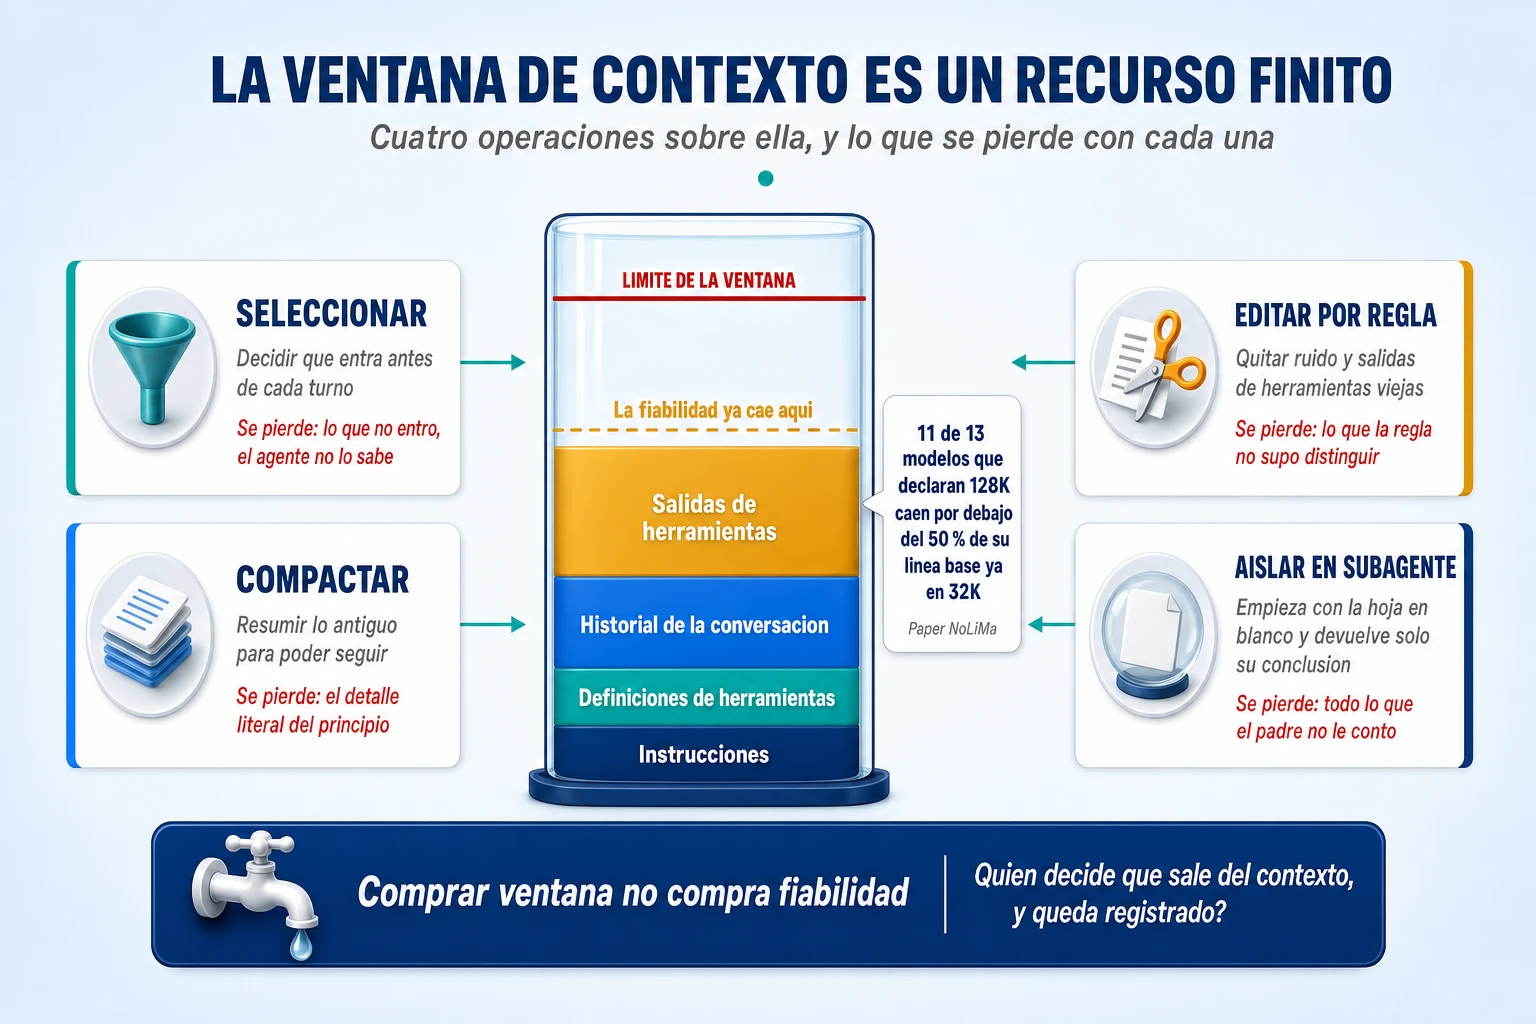
La ventana no es memoria, y se degrada mucho antes de llenarse
Una aclaración de vocabulario que el marketing ha destruido: la ventana de contexto es la cantidad total de información que el modelo tiene delante en una llamada. No es memoria, es la mesa de trabajo. Y no se reinicia entre turnos dentro de una sesión: todo se acumula, incluidas las salidas de las herramientas.
Y aquí está el dato que debería aparecer en toda conversación comercial sobre ventanas grandes. Un estudio publicado en 2025 evaluó trece modelos que declaran soportar 128.000 tokens o más, con una metodología que evita la trampa habitual: las preguntas no se pueden resolver encontrando literalmente la misma palabra en el texto, hay que hacer una inferencia. Resultado: once de los trece caen por debajo del 50 % de su propio rendimiento de contexto corto ya en 32.000 tokens. Uno de ellos pasa del 99,3 % al 69,7 %. La causa que los autores atribuyen es la dificultad creciente del mecanismo de atención en contextos largos cuando no hay coincidencia literal que lo guíe.
Hay dos resultados complementarios. Uno, de 2023, describe una curva en U: el rendimiento es más alto cuando la información relevante está al principio o al final, y se degrada de forma significativa cuando está en el medio, «incluso en modelos explícitamente de contexto largo». Otro, de 2025, sobre dieciocho modelos, encuentra que basta un solo distractor —información parecida pero incorrecta— para que el rendimiento caiga de forma apreciable. Una nota de honestidad: los tres estudios son de 2023 y 2025, y no hemos encontrado una evaluación publicada en 2026 con metodología comparable sobre los modelos actuales. Que el fenómeno siga vigente es una inferencia razonable, no un dato medido.
La consecuencia práctica cabe en una línea: comprar ventana no compra fiabilidad. Un millón de tokens de ventana no significa que el modelo use bien un millón de tokens. Significa que caben. Un proveedor lo ha incorporado a su propio vocabulario hablando de «presupuesto de atención» finito, que es una forma honesta de decirlo.
Compactar tiene precio, y alguien decide qué se tira
Hay tres mecanismos para el mismo problema y cada uno pierde algo diferente. El primero es borrado por regla: cuando el contexto pasa de cierto umbral, se eliminan las salidas de herramientas más antiguas y se sustituyen por un marcador. No hay resumen, hay poda; es lo que un proveedor llama «la forma más segura y ligera de compactación». Tiene un coste oculto que casi nadie anticipa: borrar contenido invalida el prefijo cacheado, así que cada poda obliga a pagar de nuevo la escritura de la caché. Por eso existe un parámetro que obliga a borrar un mínimo de tokens cada vez: sin él, podar el contexto puede salir más caro que dejarlo estar.
El segundo es compactación bajo demanda: la aplicación decide cuándo, envía la conversación y recibe un resumen firmado que sustituye a los mensajes resumidos. Aquí la documentación del proveedor es admirablemente franca: «las imágenes, los documentos, los ficheros subidos y las URL recuperadas dentro de los mensajes resumidos desaparecen cuando el bloque los reemplaza. Vuelva a enunciar o a subir cualquier cosa que un turno posterior siga necesitando». Y el detalle que debería quitar el sueño a alguien: los mensajes de sistema que caigan dentro del rango resumido «también se resumen, así que sus instrucciones de texto dejan de aplicarse». La compactación puede borrar sus propias reglas de operación.
El tercero es compactación automática del harness: el propio andamiaje decide cuándo comprimir y deja una marca en el historial. Lo interesante es qué preserva según su documentación —decisiones de arquitectura, errores sin resolver, detalles de implementación y los cinco ficheros accedidos más recientemente— y qué descarta —salidas de herramientas redundantes y mensajes superfluos—. Con una advertencia operativa que vale su peso en oro: «las instrucciones específicas dadas al principio de la conversación pueden no preservarse. Las reglas persistentes van en el fichero de instrucciones del proyecto, no en el prompt inicial, porque el contenido de ese fichero se reinyecta en cada petición».
De todo esto sale una pregunta que un directivo puede hacer en una reunión de arquitectura y que va a cambiar la conversación: ¿quién decide qué sale del contexto, y queda registrado en algún sitio? Si la respuesta es «el modelo, y no», no hay auditoría posible de por qué el agente ignoró un dato que tenía delante.
Subagentes: aislar contexto antes que repartir trabajo
Los subagentes se venden como paralelismo y se usan, sobre todo, como aislamiento. La mecánica está documentada con precisión en dos ecosistemas y es la misma: el subagente arranca con una conversación limpia, no hereda el historial del padre, carga sus propias instrucciones, y solo su respuesta final vuelve al padre como resultado de una herramienta. Un proveedor da la magnitud: un subagente puede gastar muchísimos tokens internamente y devolver entre mil y dos mil de resumen condensado.
Cuántas herramientas aguanta, y cómo se deforma una recomendación
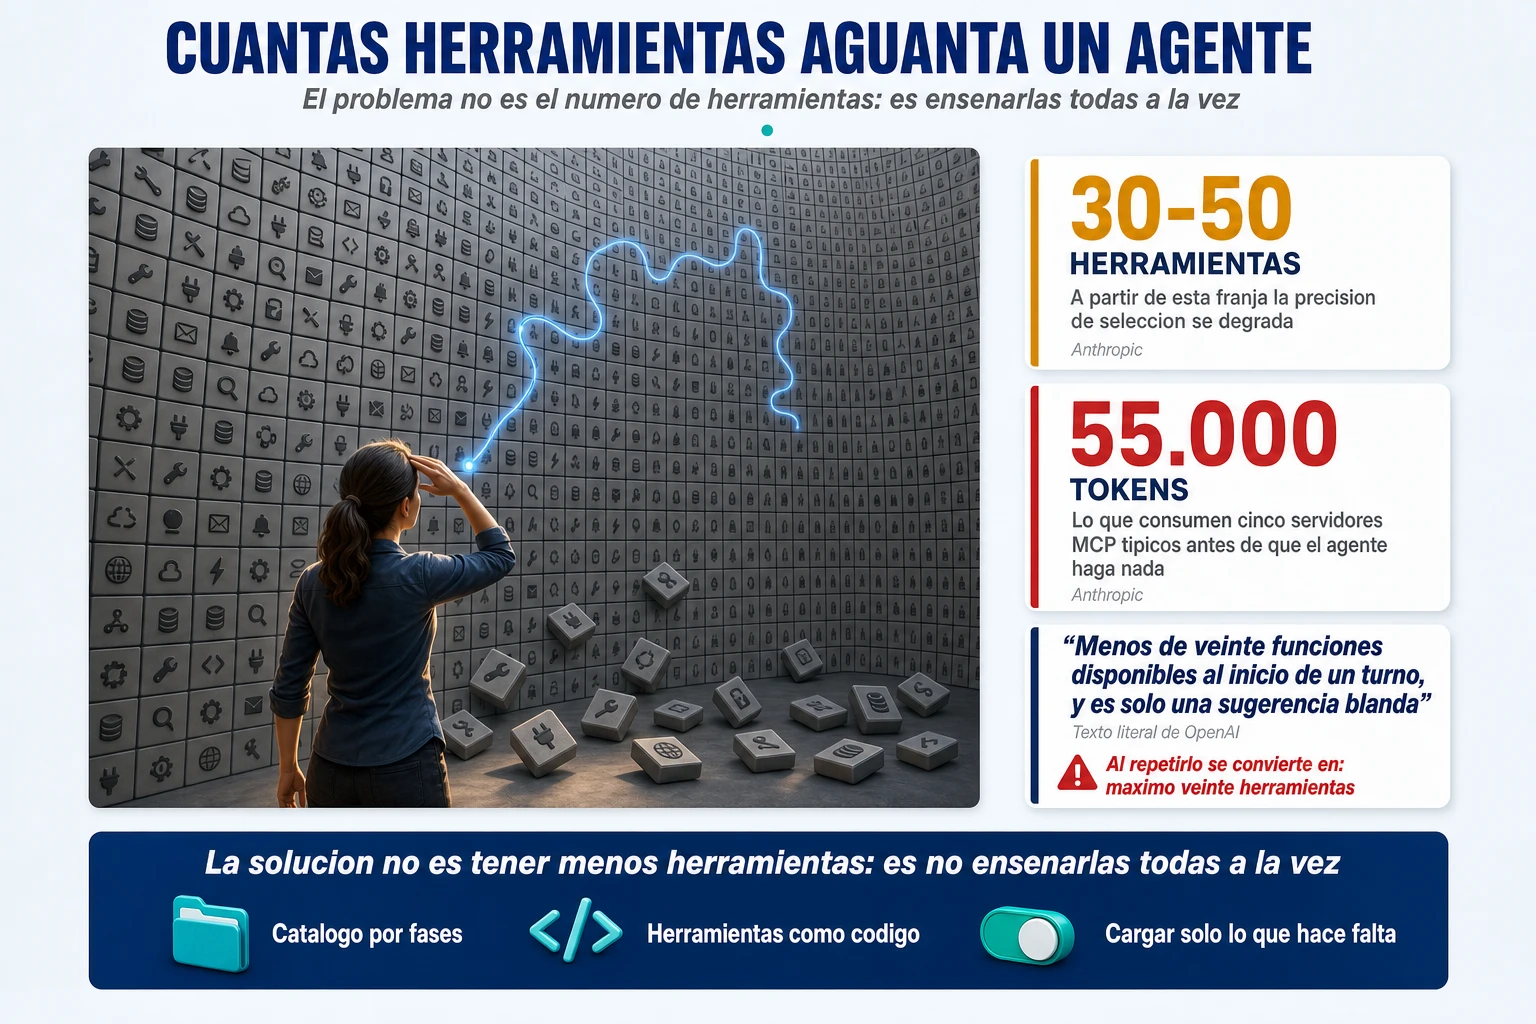
Dos cifras, las dos del mismo proveedor y sobre su propio producto. La primera: la capacidad del modelo de elegir la herramienta correcta «se degrada una vez que se pasa de 30 a 50 herramientas disponibles». La segunda: un montaje típico de cinco servidores de herramientas corporativas —control de versiones, mensajería interna, gestión de errores, paneles y registros— «puede consumir unos 55.000 tokens en definiciones antes de que el modelo haga ningún trabajo»; uno solo de esos servidores aporta 35 herramientas y unos 26.000 tokens. Y el mismo equipo admite haber visto internamente 134.000 tokens solo en definiciones antes de optimizar.
Aquí entra una lección lateral sobre cómo circula la información técnica. La recomendación de OpenAI dice, literalmente: «apunte a menos de veinte funciones disponibles al inicio de un turno en cualquier momento dado, aunque esto es solo una sugerencia blanda». En los resúmenes y las conversaciones de pasillo esa frase se ha convertido en «máximo veinte herramientas», que es un techo de arquitectura. Quitar «al inicio de un turno» transforma una recomendación sobre el contexto activo en un límite de diseño; quitar «sugerencia blanda» le da una firmeza que su autor no reclama. El número es correcto y la conclusión que se saca de él, falsa.
Porque la solución no es tener menos herramientas: es no enseñarlas todas a la vez. El mecanismo que ha aparecido para esto carga solo los nombres al arrancar y deja que el modelo busque las definiciones completas de las tres o cinco que necesita. El ahorro documentado por el proveedor supera el 85 % de los tokens de definiciones, con mejoras de acierto en sus propias pruebas —de 49 % a 74 % en un modelo, de 79,5 % a 88,1 % en otro (cifras del fabricante, sin contraste independiente)—, y tiene un detalle de ingeniería elegante: las herramientas diferidas se excluyen del prefijo del prompt de sistema, de modo que cargarlas bajo demanda no invalida la caché.
Lo que el agente no ve, no existe
Hay una frase de OpenAI, en su relato de cinco meses construyendo un producto casi enteramente con agentes, que es la mejor formulación que hemos leído de por qué el contexto es una decisión de arquitectura y no un detalle de implementación: «desde el punto de vista del agente, cualquier cosa a la que no pueda acceder en contexto mientras ejecuta, efectivamente no existe. El conocimiento que vive en documentos ofimáticos, en hilos de chat o en las cabezas de las personas no es accesible para el sistema».
Para una empresa la consecuencia es inmediata y poco agradable. El criterio de aprobación que solo conoce la persona que lleva doce años en el puesto, la excepción que se aplica «siempre» y no está escrita, el matiz que se decidió en un hilo de mensajería el verano pasado: nada de eso es conocimiento para un agente. Por eso los proyectos de agentes desentierran problemas de documentación que llevaban años enterrados.
El hallazgo más útil de ese relato es qué pasó cuando intentaron resolverlo por la vía obvia. Probaron un único fichero de instrucciones grande, con todo dentro, y falló. Sus cuatro razones, tal cual: el contexto es un recurso escaso y un fichero gigante desplaza a la tarea, al código y a la documentación relevante, así que el agente o se salta restricciones clave o empieza a optimizar las equivocadas; demasiada orientación se convierte en ninguna orientación, porque cuando todo es importante nada lo es; se podre al instante, y un manual monolítico acaba siendo un cementerio de reglas rancias; y es difícil de verificar, porque un bloque único no se presta a comprobaciones mecánicas.
Lo que hicieron en su lugar: tratar el fichero de instrucciones no como la enciclopedia sino como el índice. Unas cien líneas que se inyectan en cada petición y apuntan a dónde mirar, con la base de conocimiento real en un directorio versionado y tratado como sistema de registro. Lo llaman divulgación progresiva, y lo verifican con comprobaciones automáticas que validan que esa base está al día y bien estructurada; hay incluso un agente recurrente que busca documentación obsoleta. Cien líneas de índice y un archivo mantenido, en lugar de un manual de trescientas páginas que nadie lee, empezando por la máquina.
De la demo a producción: que no se pierda el trabajo
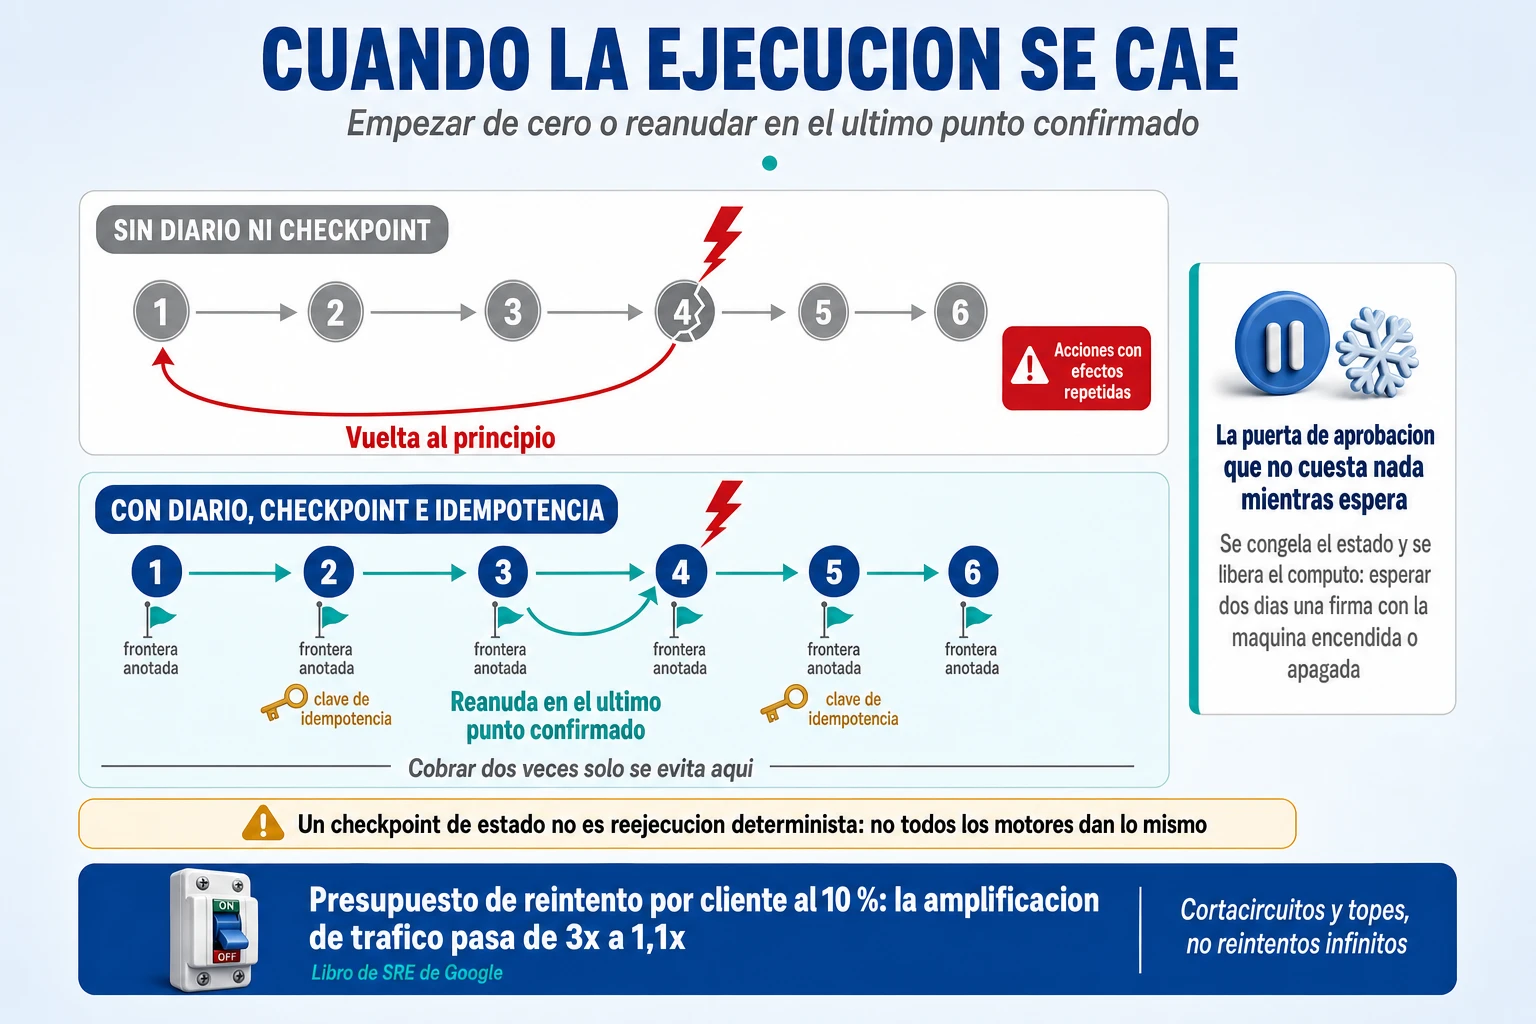
Por qué toda ejecución larga se cae
El argumento no es estadístico y conviene decirlo así, porque no existen datos públicos fiables de tasas de fallo en ejecuciones largas de agentes y sería más fácil inventarse una cifra. El argumento es mecánico: multiplique la probabilidad de que algo se interrumpa en un minuto por el número de minutos. Un proceso que corre seis horas cruza reinicios de proceso, límites de tasa del proveedor, expiraciones de credenciales, despliegues de su propia aplicación y caídas transitorias de red. Ninguno de esos eventos es improbable en seis horas; varios son casi seguros.
Y esas duraciones ya no son hipotéticas: el equipo de OpenAI que trabajó cinco meses con agentes escribe que «vemos con regularidad ejecuciones individuales trabajando en una sola tarea durante más de seis horas, a menudo mientras los humanos duermen». Un detalle que rara vez se cuenta: en un sistema de agentes largos, un despliegue es un modo de fallo. Uno de los proveedores lo resuelve desplazando el tráfico de forma gradual entre versiones, precisamente para no interrumpir a los agentes que están trabajando. Y sobre la fiabilidad de la capa de inferencia hay un dato público que sirve para calibrar expectativas: un informe postmortem documentó que un error de enrutado afectó inicialmente al 0,8 % de las peticiones y, en la peor hora, al 16 % de las peticiones de uno de sus modelos. Nada de esto funciona al cien por cien.
Diario, reanudación e idempotencia, sin una línea de código
Los tres conceptos que resuelven esto son antiguos, vienen del mundo de los sistemas transaccionales y se explican sin tecnicismos. Diario: anotar cada frontera de paso en un registro ordenado y duradero antes de cruzarla; no se anota lo que el agente piensa, se anota lo que ha ocurrido —qué paso empezó, con qué entrada, qué devolvió—. Reanudación: al retomar, leer ese registro y saltarse todo lo ya hecho en lugar de volver a hacerlo. Idempotencia: marcar cada acción con efectos en el mundo exterior de forma que ejecutarla dos veces tenga el mismo efecto que ejecutarla una.
El ejemplo que hace obvia la tercera es siempre el mismo: cobrar. Si el agente ya lanzó el cargo y el proceso se cayó justo después, sin idempotencia la reanudación lo cobra otra vez. No es una sofisticación: es el requisito mínimo para que un agente toque un sistema de pago, un inventario o un buzón de clientes.
La puerta de aprobación que no cuesta nada mientras espera
De todos los argumentos económicos de la ejecución duradera, este es el más fácil de defender ante un comité. Un agente que espera la firma de una persona tiene dos formas de esperar: con la máquina encendida o con el estado congelado y el cómputo liberado. Uno de los proveedores lo describe sin rodeos: la ejecución duradera permite a las orquestaciones «esperar días o incluso semanas» mientras aguardan una respuesta humana, y combinada con cómputo sin servidor «todos los recursos de cómputo se apagan durante el periodo de espera, eliminando los costes de cómputo» hasta que la persona responde. Y sin consumir tokens del modelo, porque no hay ninguna llamada en vuelo.
Qué existe de verdad para esto
Existe una categoría entera de producto, es anterior a los agentes y lleva años resolviendo el mismo problema para procesos de negocio: los motores de ejecución duradera. El más maduro basa todo en un historial completo y ordenado de eventos y en reejecución determinista: si el proceso cae, otro recupera el historial, vuelve a ejecutar el código contra él para reconstruir el estado y continúa desde el punto de fallo «como si el fallo no hubiera ocurrido». Su regla de oro resume el modelo entero: «cualquier cosa que hable con el mundo exterior pertenece a una actividad registrada». Otros ofrecen lo mismo con memoización de pasos —al reejecutar, el paso no se ejecuta, se le inyecta el resultado anterior— o sobre una base de datos convencional, para no introducir infraestructura nueva.
Y hay una corrección que merece hacerse porque circula mal. Uno de los mecanismos más citados de 2026 —el que registra cada invocación duradera en una base de datos local antes de empezar y permite guardar una instantánea en cualquier punto— no es reejecución determinista. Su propia documentación lo dice: el código original «ya no está» al recuperarse, no se puede serializar, y la lógica de recuperación tiene que estar en el punto de intercepción que el desarrollador escribe. Es un punto de control del estado de aplicación, con recuperación definida por el desarrollador. Es una filosofía deliberadamente distinta, y para agentes tiene sentido precisamente porque los agentes no son deterministas.
Aquí encaja una distinción que ordena toda esta conversación, porque tres cosas muy distintas se dicen con la misma expresión. Razonamiento de horizonte largo es que el agente tenga que planificar y ejecutar a lo largo de muchos pasos dependientes: eso es sobre todo un problema de calidad de modelo. Ejecución de larga duración es que el proceso corra durante horas o días, con el modelo invocado miles de veces: eso es sobre todo un problema de harness. Y agencia persistente es que el agente tenga una identidad que sobreviva a cualquier tarea, acumule memoria y esté siempre disponible: eso todavía no está resuelto por nadie. Mezclarlas es la causa de la mitad de las expectativas mal calibradas.
Reintentos, cortacircuitos y presupuestos
El reintento es la primera cosa que alguien añade cuando un agente falla, y la primera que tumba un sistema. El dato que cierra el argumento viene del libro de fiabilidad de Google y es de los más accionables de este artículo: un presupuesto de reintento por cliente, que solo permite reintentar mientras la proporción de reintentos sobre el total se mantenga por debajo del 10 %, reduce el crecimiento del tráfico a 1,1 veces frente a 3 veces sin él. El mismo texto propone un presupuesto por petición de tres intentos, con su razonamiento: si una petición ya ha caído tres veces en tareas sobrecargadas, es relativamente improbable que un cuarto intento ayude.
Por qué esto es más grave en un agente que en una aplicación normal: un agente reintenta en tres niveles a la vez. La librería de red reintenta la llamada al modelo; el bucle reintenta la herramienta que falló; y el agente, al ver el error en su contexto, reintenta la tarea entera. Tres niveles multiplicativos sin presupuesto global producen exactamente la explosión combinatoria que describe la literatura clásica. Y aquí hay que ser honesto: no hemos encontrado ningún framework de agentes que ofrezca un presupuesto de reintento compartido entre los tres niveles. Es una prescripción correcta, no una característica disponible.
El harness es la factura
El precio unitario baja y la factura sube
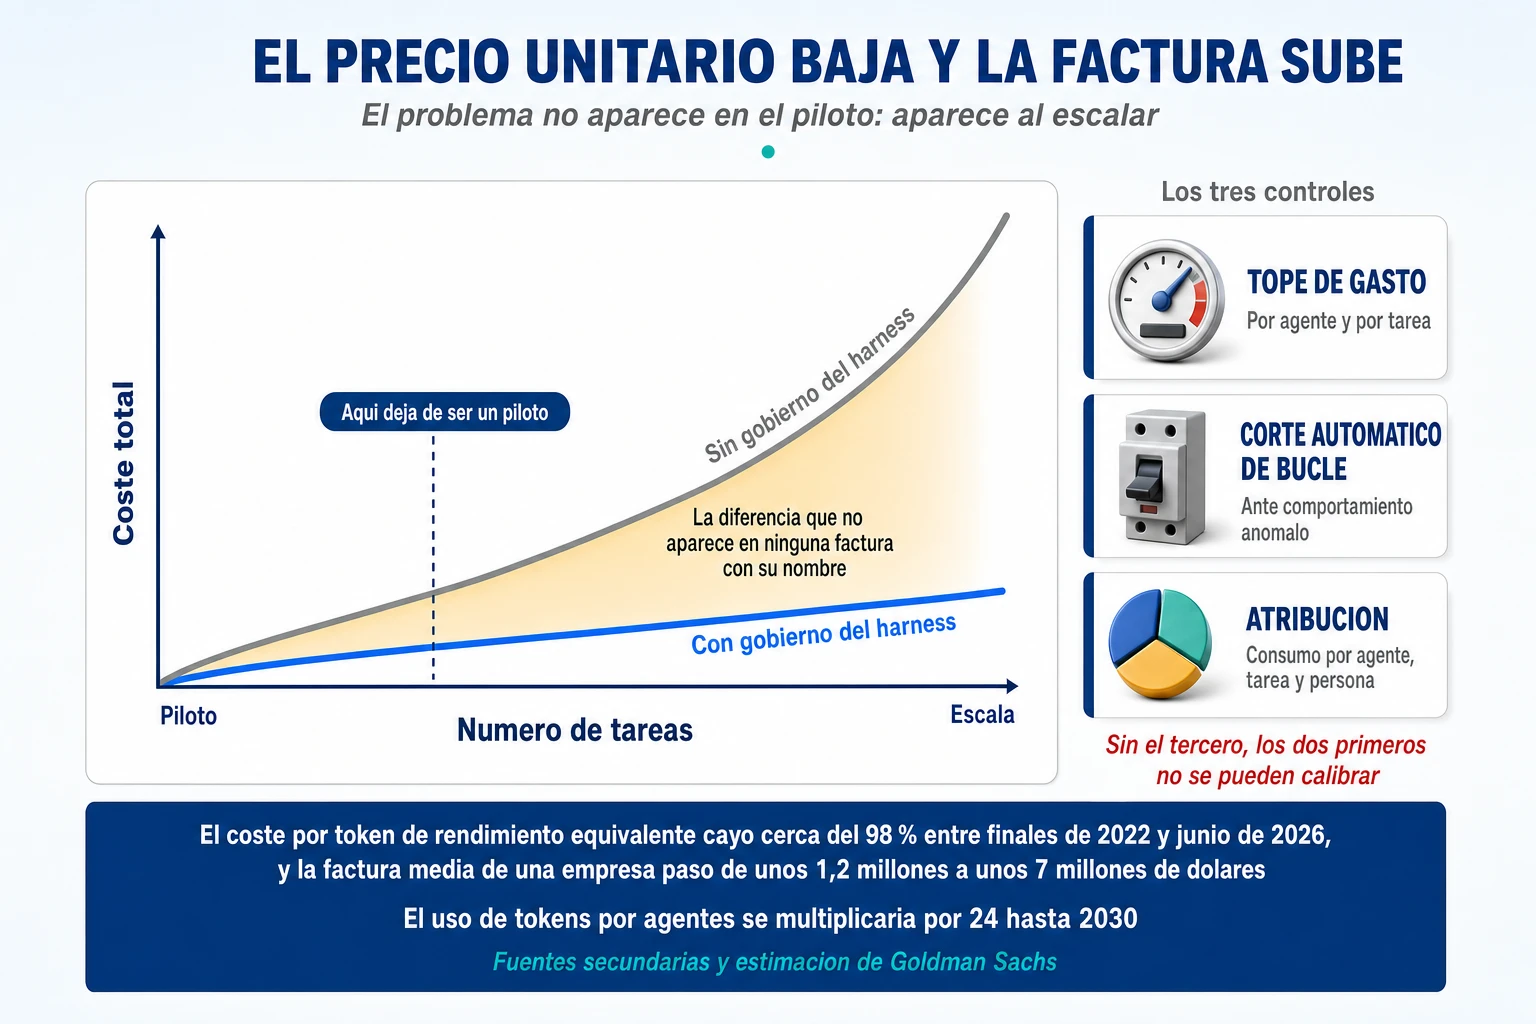
La tensión es el dato, no cada cifra por separado. El coste de alcanzar un nivel dado de capacidad —lo que hace un par de años requería el modelo más caro del mercado— ha caído aproximadamente un 98 % entre finales de 2022 y mediados de 2026 (cifra recogida por un medio especializado en junio de 2026, no por un laboratorio). Y en el mismo periodo, según el mismo análisis, la factura media de IA de una empresa pasó de en torno a 1,2 millones de dólares al año en 2024 a unos 7 millones en 2026.
El precio unitario cayó un 98 % y la factura se multiplicó por casi seis. No es una paradoja: es aritmética. Lo que ha cambiado no es el precio del token, es cuántos tokens hace falta para hacer algo. Y ahí entra el harness. El mecanismo no necesita interpretación: una conversación hace una llamada por turno; un agente hace decenas o cientos por tarea, y cada una arrastra el historial acumulado —el prompt de sistema, las instrucciones del proyecto, las definiciones de herramientas y todo lo ocurrido hasta ese momento, incluidas las salidas de las herramientas—. Un agente que da veinte pasos no paga veinte llamadas: paga la suma de veinte historiales crecientes.
Si alguien quiere una cifra de horizonte para dimensionar el problema, la más citada es una estimación de Goldman Sachs de mayo de 2026: el consumo de tokens se multiplicaría por 24 hasta 2030, y su mecanismo declarado es exactamente el que acabamos de describir —agentes que monitorizan su entorno de forma continua, releen contexto cuando cambian las condiciones, verifican sus propias salidas en varias rondas y funcionan sin que nadie les escriba un prompt—. Es una estimación de una casa de análisis, vía fuentes secundarias, y hay que leerla como tal.
Por qué el bucle gasta lo que gasta, y por qué eso es también la calidad
Hay dos cifras publicadas por un proveedor sobre sus propios sistemas que dan la magnitud: «los agentes usan típicamente unas 4 veces más tokens que las interacciones de chat, y los sistemas multiagente usan unas 15 veces más tokens que el chat». Guarde esos dos multiplicadores: son el mejor punto de partida para dimensionar un caso de negocio antes de haber construido nada.
Y ahora el dato que cambia la conversación entera. En una de las evaluaciones de búsqueda ya citadas, el mismo proveedor midió que el uso de tokens explica por sí solo el 80 % de la varianza de rendimiento; tres factores juntos explican el 95 %. Léalo despacio: no es que gastar más cueste más. Es que gastar más es rendir mejor, en esa evaluación y con ese modelo.
La consecuencia es que coste y calidad no son dos palancas: son la misma, y el harness es lo que decide dónde se pone. Eso explica por qué el caso que abre este artículo mejora y abarata a la vez: al conservar el razonamiento, el modelo dejó de gastar tokens en redescubrir el juego cada turno y pudo gastarlos en jugarlo. No gastó más ni menos por casualidad: gastó en otra cosa. Y el corolario incómodo para quien quiere recortar: casi cualquier recorte ciego de tokens es un recorte de calidad. Las palancas que funcionan no reducen el gasto útil; reducen el gasto redundante.
Las palancas que están en el harness
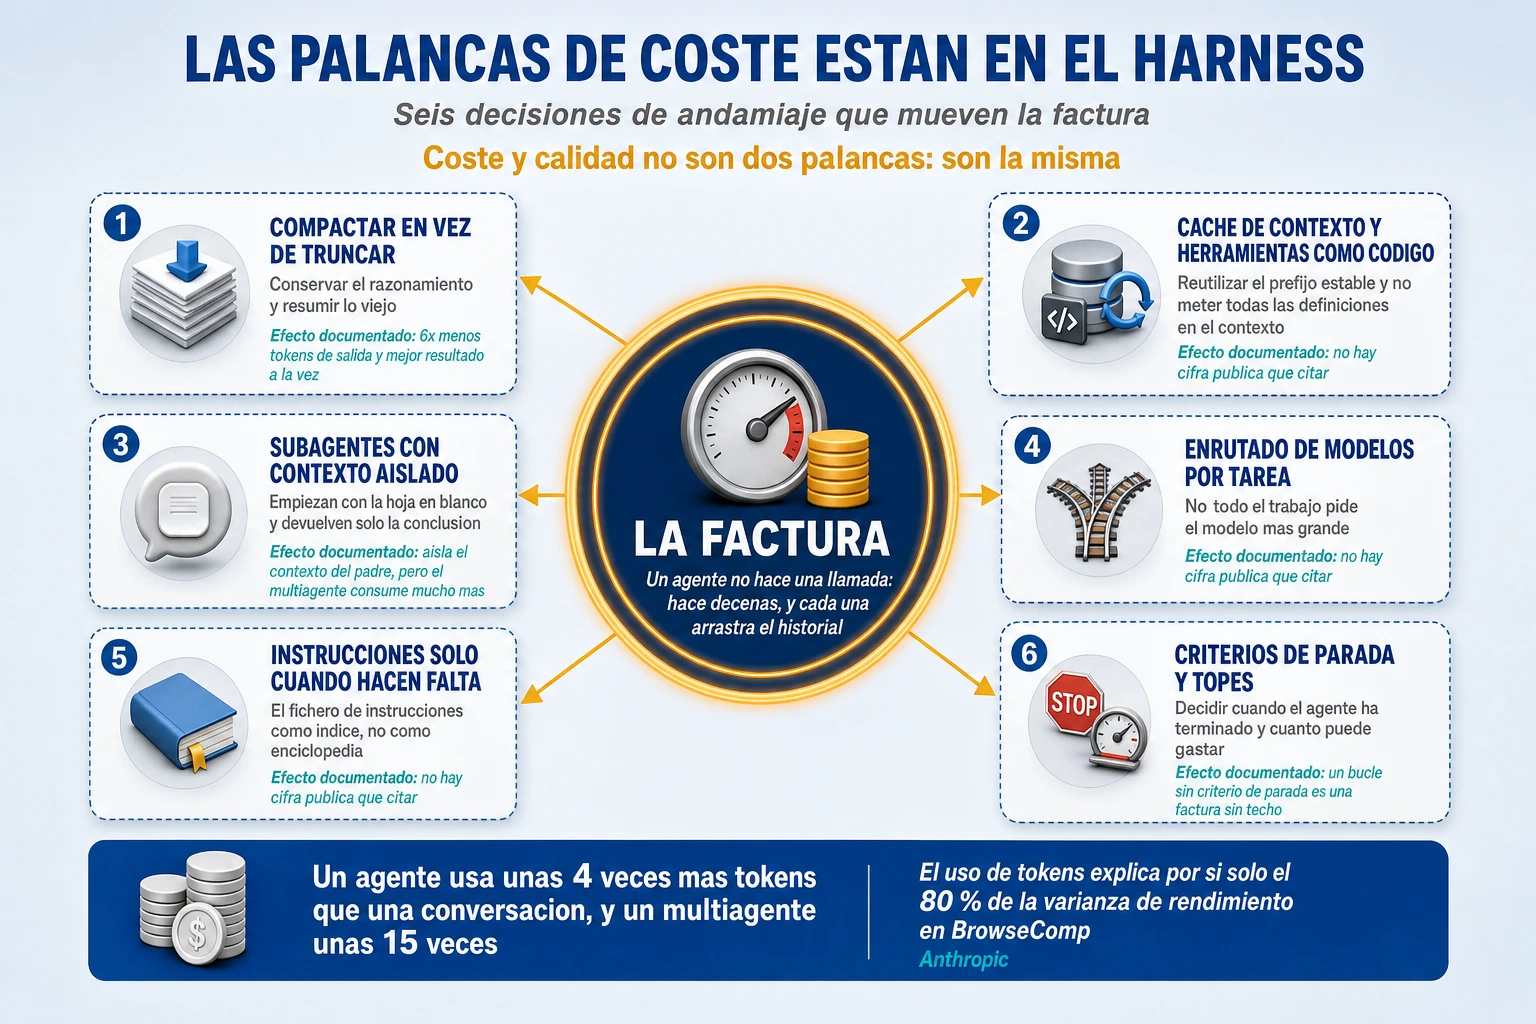
La caché del prefijo es la más rentable y la peor usada. Si el principio del prompt es idéntico entre peticiones, se puede cachear y las lecturas posteriores cuestan una fracción del precio —una décima parte en la mayoría de los modelos de uno de los proveedores, y hasta una vigésima en sus modelos de gama alta—, a cambio de que escribir la caché cueste entre 1,25 y 2 veces el precio base. El ahorro solo existe si el prefijo se reutiliza. Y aquí están las dos trampas, las dos documentadas: hay un tamaño mínimo por debajo del cual el contenido no se cachea y el sistema no devuelve ningún error, simplemente no cachea; y cambiar las definiciones de herramientas —un nombre, una descripción, un parámetro— invalida la caché entera. Un harness que no instrumenta cuántos tokens escribe y cuántos lee de caché puede estar pagando 1,25 veces el precio sin obtener un solo acierto y no enterarse nunca.
La compactación y el borrado de salidas de herramientas reducen lo que se arrastra, con las pérdidas ya detalladas y con un coste propio: la llamada de resumen se factura. La carga bajo demanda de herramientas ahorra más del 85 % de los tokens de definiciones en el caso documentado y preserva la caché. La ejecución de herramientas como código evitó, en un ejemplo publicado, que 148.000 tokens pasaran por el modelo sin que nadie los necesitase dentro. La llamada programática de herramientas bajó el uso medio de 43.588 a 27.297 tokens, un 37 %, en tareas complejas de investigación (todas estas cifras son del fabricante sobre sus propios productos). Los subagentes hacen crecer el contexto del padre por un resumen de uno o dos mil tokens en lugar de por la transcripción íntegra.
El enrutado a modelos distintos según la tarea es la palanca más obvia y la menos automatizada: un harness que llama al modelo más caro para decidir si un fichero existe está quemando dinero. No hay ahorro documentado publicable para esta palanca, y lo decimos: la evidencia es anecdótica. Y los criterios de parada son la palanca menos glamurosa y la que más dinero salva en un incidente, porque un bucle sin techo que se atasca toda una noche no produce un fallo: produce una factura. Merece la pena citar el marco propio que publicó Google en julio de 2026 sobre eficiencia de tokens, porque son once principios —no cinco, como circula por ahí—, firmados por su equipo de relaciones con desarrolladores del producto de agentes, y varios son literalmente decisiones de harness: usar habilidades desde el principio, delegar las tareas que generan mucha salida, dividir y conquistar, adelantar la verificación, evitar bucles descontrolados y empezar una sesión nueva para cada tema nuevo.
| Palanca | Qué hace | Efecto documentado | Quién lo mide |
| Caché del prefijo | Reutiliza la parte invariable del prompt entre peticiones | Lecturas a una décima parte del precio base; escritura a 1,25 o 2 veces | Tarifas publicadas por el proveedor |
| Carga de herramientas bajo demanda | Solo carga las tres o cinco herramientas que la petición necesita | Más del 85 % de reducción en tokens de definiciones, preservando la caché | El fabricante, sobre su propio producto |
| Herramientas como código | Permite filtrar y transformar resultados antes de que entren en el contexto | De 150.000 a 2.000 tokens en un ejemplo publicado | El fabricante, ejemplo concreto, no promedio |
| Llamada programática de herramientas | Sustituye llamadas encadenadas por una ejecución que devuelve solo lo relevante | De 43.588 a 27.297 tokens de media (−37 %) | El fabricante, pruebas internas |
| Compactación y borrado de salidas | Comprime o poda el historial arrastrado | Sin porcentaje publicado. La llamada de resumen se factura y el borrado invalida la caché | Nadie publica cifras de ahorro |
| Subagentes con ventana propia | Devuelven un resumen en lugar de la transcripción | El contexto del padre crece 1.000-2.000 tokens en lugar de la subtarea entera | El fabricante, documentación de producto |
| Enrutado por modelo | Usa el modelo barato para lo rutinario y el caro para lo difícil | Sin ahorro documentado publicable. La evidencia es anecdótica | Nadie |
| Criterios de parada y tope de gasto | Corta el bucle antes de que la factura crezca sola | Sin porcentaje. Es prevención de incidentes, no optimización | Disponible como parámetro en varios harnesses |
Los tres controles que su harness corporativo debe tener
Sea de quien sea el harness, y sin entrar en qué producto: hay tres controles sin los cuales no se puede gobernar esto, y los tres son verificables en una demo.
El primero es un tope de gasto por agente y por tarea. No un aviso: un tope duro que detiene la ejecución. En uno de los ecosistemas corporativos existe como límite mensual por agente con dos salvaguardas, aviso al acercarse y apagado automático al alcanzarlo; en otro, como presupuesto máximo por ejecución que además alcanza a los subagentes: al agotarse, lanzar otro subagente falla y los que corrían en segundo plano se detienen.
El segundo es el corte automático de bucle ante comportamiento anómalo. Un techo de iteraciones es lo mínimo; lo bueno es un corte por patrón —el mismo paso repetido, ninguna herramienta nueva en diez turnos, ningún avance en la lista de tareas—, y ahí es donde más flojea el mercado. El tercero es la atribución del consumo a agente, tarea y persona: sin él los dos primeros no se pueden calibrar, porque no hay forma de saber qué tope es razonable. Es el que más se olvida, porque no hace falta hasta el día en que el consumo se triplica y alguien pregunta por qué.
El harness es el control
«No debería» frente a «no puede»
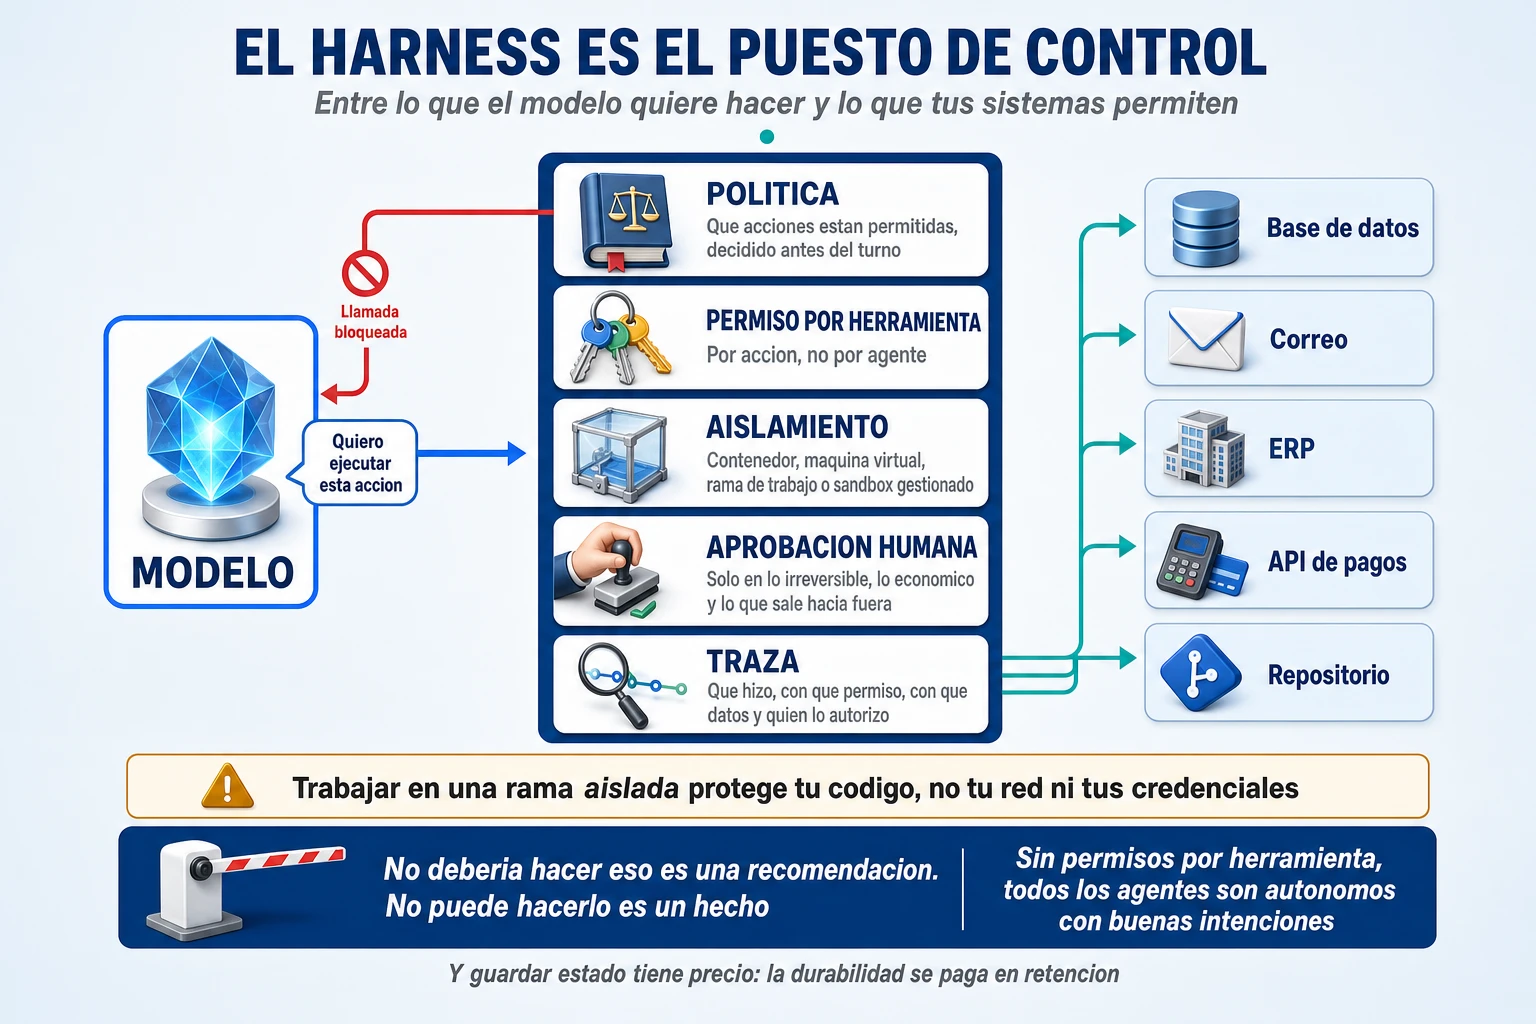
Un prompt que pide prudencia es una recomendación. Una política que bloquea la llamada es un hecho. Toda la conversación sobre seguridad de agentes se reduce, en la práctica, a cuál de las dos cosas tiene usted, y la diferencia entre ambas es una decisión de harness, no de redacción. Google lo dice con una expresión que vale la pena adoptar: el harness es «un puesto de control de seguridad entre el modelo de lenguaje y sus sistemas externos». Cuando un agente decide actuar, el harness comprueba si tiene los permisos correctos para ejecutar esa llamada concreta, «impidiendo que el modelo realice acciones no autorizadas o acceda a datos restringidos». No es el modelo el que se abstiene: es el sistema el que no le deja.
Aislamiento: qué aísla cada opción y qué no
Las opciones, de menos a más: un sandbox del intérprete de comandos, que aísla los comandos y sus procesos hijos; un sandbox de todo el proceso del agente, que incluye las herramientas de ficheros y los servidores de herramientas externas; un contenedor; una máquina virtual; y un entorno gestionado por el proveedor. El esfuerzo crece con el nivel y el aislamiento también.
Lo que sí es una sorpresa para mucha gente son los tres avisos que el propio proveedor publica. Primero: «el aislamiento del sandbox reduce el impacto de una brecha, pero no elimina el riesgo. Cualquier enfoque que permita salida de red puede seguir filtrando datos que el agente puede leer, y cualquier enfoque que monte su directorio de proyecto con permiso de escritura puede seguir modificando ese código». Segundo, el que más gente ignora: «el aislamiento tampoco cambia lo que se envía al modelo. Sus prompts y los ficheros que el agente lee se transmiten a la API con sandbox o sin él». Tercero: los servidores de herramientas externas y los puntos de intercepción «son procesos separados que corren sin restricciones en el anfitrión».
Y una advertencia explícita porque la confusión está muy extendida: uno de los mecanismos de moda es dar a cada subagente su propia rama de trabajo aislada y efímera del repositorio, que se limpia al terminar. Es un mecanismo excelente y real. Pero trabajar en una rama aislada protege su código, no su red ni sus credenciales. Un agente en una rama separada tiene exactamente el mismo acceso al sistema de ficheros, a la red y a las claves que tendría fuera. No es contención de seguridad; es contención de cambios, que es otra cosa muy valiosa y distinta.
Autonomía por acción, no por agente
En el artículo sobre arquitectura agéntica propusimos una escala de seis niveles: N0 informa, N1 recomienda, N2 prepara, N3 ejecuta y la persona audita, N4 ejecuta salvo excepciones, N5 autónomo. No la volvemos a desarrollar. Solo hace falta añadir lo que este artículo aporta a esa escala: el harness es lo que hace que un nivel sea verdad en lugar de una declaración de intenciones. Decir «este agente es de nivel 3» sin permisos por herramienta es decir que confiamos en que se portará como un nivel 3. Sin permisos por acción, todos los agentes son de nivel 5 con buenas intenciones. Y como los grados de autonomía se asignan por acción y no por agente —un mismo agente puede consultar sin permiso, preparar sin permiso y no poder ejecutar un pago jamás—, la única capa donde ese reparto se puede implementar es esta. Es el mismo criterio que usamos al describir el modelo operativo de una transformación con agentes.
La aprobación humana y su enfermedad
Dónde poner una puerta de aprobación: en las acciones irreversibles, en las que tienen efectos económicos y en las que salen hacia fuera de la organización. Tres criterios, y casi nada más. Qué pasa cuando se pone en todas partes: se aprueba sin mirar. La fatiga de aprobación no es una hipótesis nuestra; es el problema que dos de los tres grandes nombran explícitamente en su documentación de producto al justificar los modos que reducen preguntas. Uno asigna a su modo automático, literalmente, el caso de uso «tareas largas, reduciendo la fatiga de prompts»; el otro llama a su mecanismo «aprobación de herramientas de no volver a preguntar». Cuando el nombre de la característica reconoce el problema, el problema existe.
Lo que no existe todavía es una medición publicada de cuánto degrada la fatiga la calidad de la revisión. Hay literatura académica de 2026 abordándolo y análisis de campo que describen un mecanismo coherente —a volumen alto los revisores dejan de leer y empiezan a reconocer patrones—, pero nadie ha publicado una cifra reproducible. La regla operativa que sí se sostiene es simple: poca puerta y bien puesta. Pedir confirmación para acciones triviales y de solo lectura entrena el reflejo de aprobar, y ese reflejo es el que se va a aplicar el día que aparezca la acción que sí importaba.
Lo que tiene que poder responder seis meses después
Cinco preguntas, y la capacidad de contestarlas es la definición operativa de traza: qué hizo el agente, con qué permiso, con qué datos, quién lo autorizó, y si se puede repetir el razonamiento que le llevó a hacerlo. Ninguna de las cinco se responde con el resultado: se responden con la trayectoria completa. Hay un trabajo académico de mayo de 2026 que propone auditar precisamente eso —trayectorias enteras— en tres ejes: cumplimiento de límites, fidelidad de ejecución y estabilidad del sistema. Sus dos hallazgos justifican esta sección: el éxito de la tarea no correlaciona con la ejecución segura, y las violaciones crecen con la longitud de la trayectoria, concentrándose en el acceso a recursos y en el paso de información entre agentes. Es un preprint sin revisión por pares, y hay que citarlo con esa etiqueta; pero señala exactamente los dos puntos que conviene instrumentar al cien por cien.
Y aquí hay un dato de gobierno que es de los más útiles de toda la investigación, porque es un compromiso explícito que un directivo entiende en cinco segundos. Uno de los proveedores vende un harness gestionado que guarda el historial de conversación, el estado del sandbox y las salidas en su lado. Y en su documentación advierte que, precisamente por eso, ese producto no es elegible para acuerdos de retención cero de datos ni para acuerdos de cumplimiento sanitario. No lo esconde: lo explica, y ofrece mitigaciones —borrado de sesiones vía API y un sandbox alojado en infraestructura del cliente—.
La durabilidad se paga en retención. Un harness que recuerda es un harness que guarda.
Si su organización exige retención cero, no está eligiendo entre proveedores: está eligiendo entre durabilidad y cumplimiento, y esa decisión no se toma en la capa de compras. Es una incompatibilidad, no una preferencia, y conviene descubrirla antes de la prueba de concepto y no después.
Cómo se sabe si un harness es bueno
La métrica que desinfla los pilotos: la consistencia
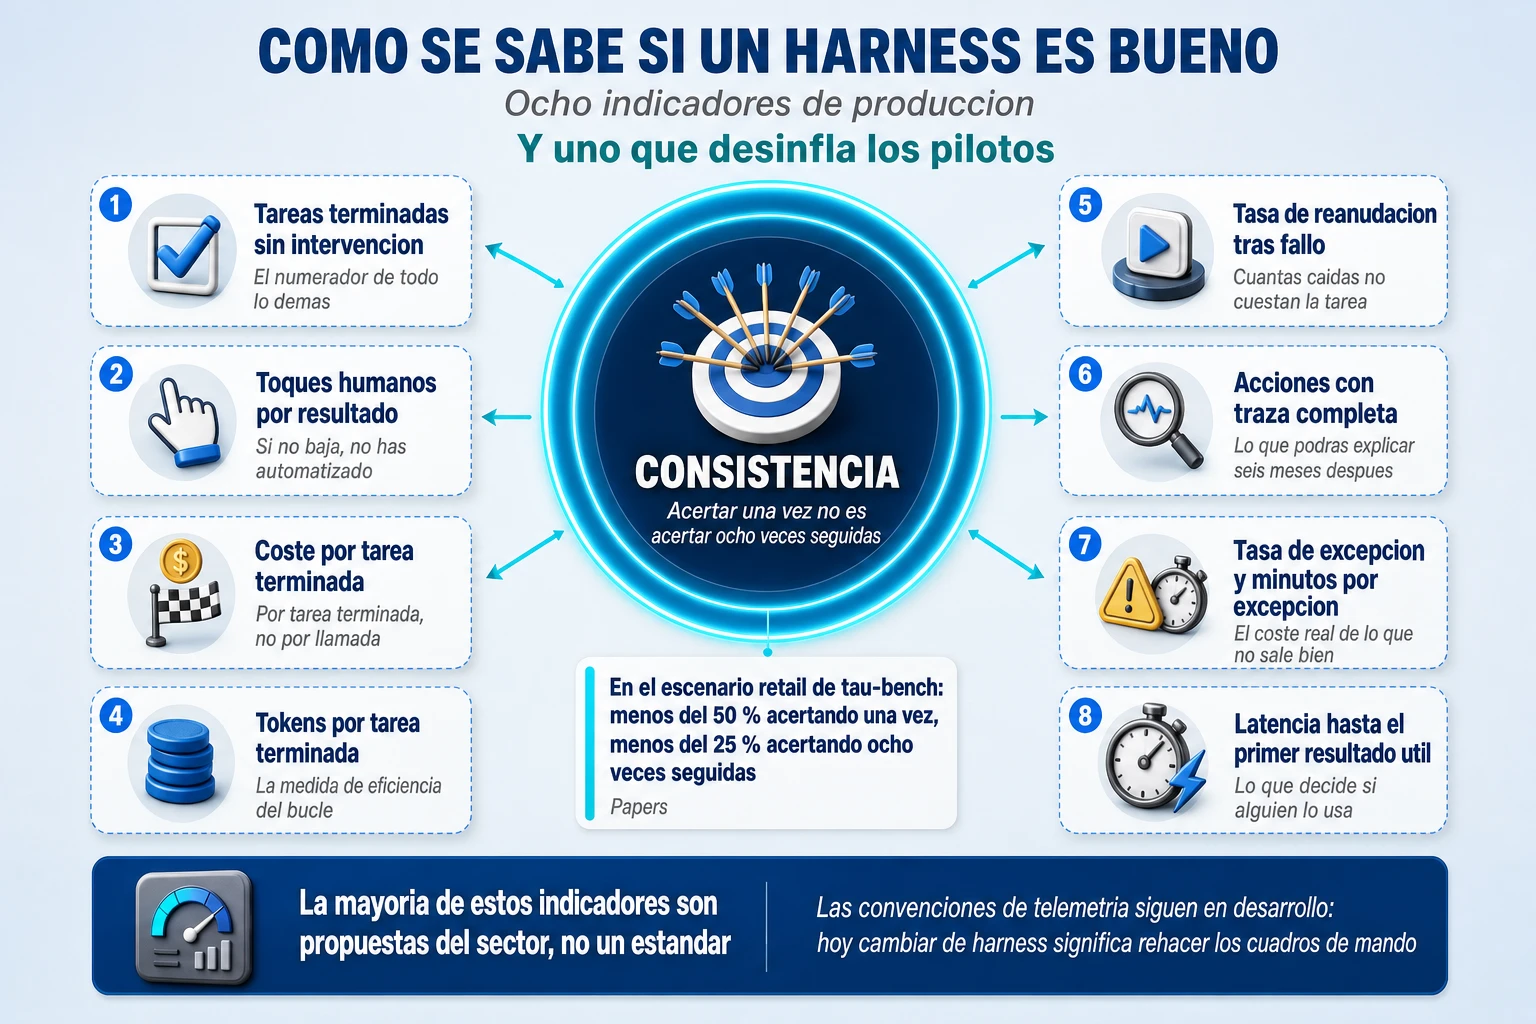
Hay dos métricas que se parecen en el nombre y miden cosas opuestas. Una mide si el agente acierta al menos una vez en varios intentos: es una métrica de capacidad, y es la que aparece en los anuncios. La otra mide si acierta todas las veces: es una métrica de fiabilidad, y es la que decide si algo puede ponerse en producción.
La cifra que hizo famosa la distinción viene de una evaluación de atención al cliente publicada en junio de 2024: los mejores agentes de la época «acertaban en menos del 50 % de las tareas, y eran bastante inconsistentes: menos del 25 % de acierto en ocho intentos seguidos en el dominio de comercio». Hay que datarla: es de 2024 y con los modelos de entonces, no es el estado del arte de 2026. Sirve como origen histórico de la métrica y como ilustración del fenómeno, que sigue siendo el mismo.
Un año después, la continuación de esa misma evaluación añadió un dominio en el que el agente y el usuario comparten el control del entorno —los dos pueden actuar sobre el mismo sistema, como en una llamada de soporte técnico en la que el cliente también toca su router—. El resultado es el más útil para quien diseña procesos reales: pasar de un escenario sin usuario activo a uno de control compartido le costó 18 puntos a un modelo y 25 a otro. Casi todos los procesos de negocio son de control compartido.
Lo que esto significa para un piloto: si su prueba de concepto funcionó tres veces de tres delante del comité, no sabe nada sobre su consistencia. El harness es precisamente la capa que convierte capacidad en fiabilidad, y por eso esta métrica es la correcta para evaluarlo.
Los ocho indicadores de producción
| Indicador | Qué contesta | Estado |
| Consistencia sobre k intentos | ¿Acierta las ocho veces, no solo una? | Definida en la literatura académica y por un proveedor. Es la única con respaldo formal |
| Tareas terminadas sin intervención | ¿Cuántas llegan al final sin que nadie toque nada? | Propuesta del sector. Nadie publica una definición canónica |
| Toques humanos por resultado | ¿Cuántas veces interviene una persona por cada resultado útil? | Propuesta del sector |
| Coste por tarea terminada | ¿Cuánto cuesta un resultado, no una llamada? | Un proveedor la menciona como dimensión, sin metodología. ¿Se cuentan los reintentos? ¿La revisión humana? |
| Tokens por tarea terminada | ¿Cuánto consume el bucle por unidad de trabajo? | Es la métrica mejor cuantificada para comparar harnesses: hasta 40 veces de diferencia |
| Tasa de reanudación tras fallo | ¿Cuántas ejecuciones interrumpidas se retoman sin repetir? | Respaldada por el diseño de los productos gestionados. Nadie la define como métrica |
| Proporción de acciones con traza completa | ¿De cuántas acciones puede demostrar qué hizo y por qué? | Justificada por la literatura de auditoría. Sin definición operativa publicada |
| Tasa de excepción y minutos por excepción | ¿Cuántas se salen del carril, y cuánto cuesta cada una? | Propuesta del sector |
| Latencia hasta el primer resultado útil | ¿Cuánto tarda en servir algo de valor? | Instrumentada por varios proveedores, sin objetivos publicados para trabajo agéntico |
La columna de la derecha es lo más honesto de esta tabla y la razón de que exista: la mayoría de estos indicadores son propuestas del sector, no un estándar. Quien le presente un cuadro de mando de agentes como si fuera una norma establecida está vendiendo su propio cuadro de mando. Lo que sí es cierto es que ninguno de los ocho aparece en una ficha de producto, y que los tres que más duelen —coste por tarea terminada, toques humanos por resultado y consistencia— son los que un piloto casi nunca mide.
Y el estado real de la telemetría
Conviene desactivar una idea que circula mucho: no hay un estándar cerrado de telemetría para agentes. Las convenciones de instrumentación para IA generativa del proyecto abierto que las mantiene siguen en estado de desarrollo, se han mudado a un repositorio propio y aparte, y la sección que debería declarar la versión del esquema figura como pendiente. Nada ha alcanzado el estado estable. Presentarlas como «el estándar» es incorrecto; presentarlas como la convención emergente hacia la que converge la industria, todavía en desarrollo, es correcto y más interesante.
La consecuencia práctica es la que hay que llevarse: hoy, cambiar de harness significa rehacer los cuadros de mando. No hay formato común de trayectoria, no hay esquema estable, y su evidencia histórica de auditoría queda atada a la herramienta con la que la generó. Y una pieza para quien necesite reproducibilidad de verdad —integración continua, control de cambios, evidencia regulatoria—: hay un harness que ofrece un modo desnudo por contrato, que arranca sin puntos de intercepción, sin habilidades, sin comandos propios, sin subagentes, sin servidores de herramientas externos, sin memoria automática y sin fichero de instrucciones, y que su documentación recomienda «cuando necesita el mismo resultado en todas las máquinas». Un harness sin modo desnudo es un harness difícil de auditar, y esa pregunta se puede hacer en una demo.
Quién llama harness a qué: los cuatro ecosistemas
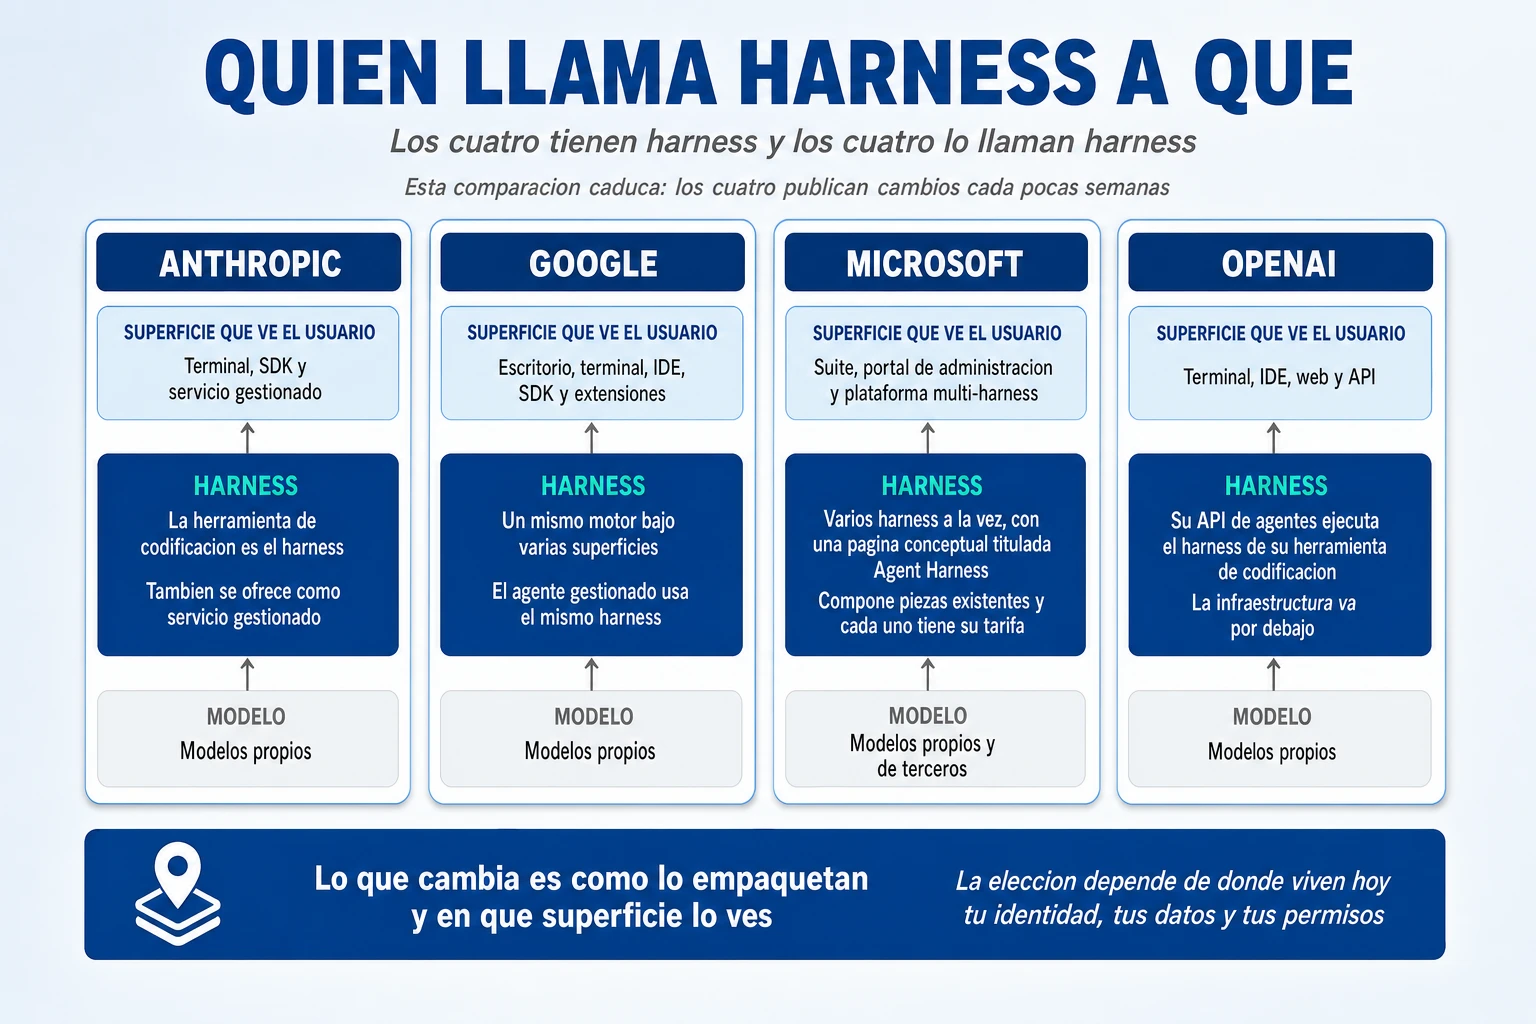
Los cuatro grandes tienen harness y los cuatro lo llaman harness. Ese es, en sí mismo, el hallazgo de esta sección: en menos de un año, un término que era jerga interna de un laboratorio ha pasado a ser superficie de producto en las cuatro casas, con páginas de documentación conceptual, desplegables en la interfaz y —en un caso— línea de factura. Lo que cambia no es la existencia de la capa: es cómo la empaquetan y en qué superficie usted la ve.
Cada bloque sigue la misma plantilla: cómo lo llaman, qué superficie ve el usuario, qué trae de serie, qué modelos admite, dónde encaja mejor y qué le falta o está en versión previa. Y todos llevan la misma advertencia por delante: esta comparación caduca. Los cuatro publican cambios cada pocas semanas, tres de ellos renombraron productos durante 2026 y varias de las capacidades que se citan aquí estaban en versión previa el día que se escribió este artículo.
Anthropic: el harness como agente completo
La filosofía de Anthropic es probablemente la más fácil de entender: el harness no es una colección de piezas para construir un agente; es el agente operativo que ya viene construido alrededor de Claude. Claude aporta el razonamiento, pero Claude Code y Claude Agent SDK aportan buena parte de aquello que permite que ese razonamiento se convierta en trabajo: herramientas, contexto, permisos, memoria de sesión, ejecución, subagentes, compactación y control de acciones.
Por eso Claude Code se entiende mejor no como una interfaz para hablar con Claude, sino como un entorno de ejecución agéntico ya terminado. Anthropic ofrece después distintas formas de acceder a ese mismo concepto, desde una aplicación interactiva hasta un SDK o un servicio gestionado, pero la unidad conceptual sigue siendo la misma: entregar al modelo un entorno suficientemente completo para que pueda trabajar durante muchos pasos sin que cada empresa tenga que diseñar desde cero el bucle del agente.
Esta filosofía aparece todavía más clara en Managed Agents. Anthropic separa explícitamente tres elementos: la sesión, que conserva lo ocurrido; el harness, que decide cuándo llamar al modelo y cómo ejecutar sus herramientas; y el sandbox, donde se realizan las acciones. Esa separación permite incluso que el harness desaparezca y vuelva a levantarse sin perder el trabajo, porque el estado duradero vive fuera de él. Es una arquitectura pensada para agentes de larga duración, no simplemente para encadenar prompts.
La consecuencia práctica es importante: Anthropic intenta que el usuario piense lo menos posible en la infraestructura del agente. El producto ya incorpora una opinión fuerte sobre cómo debe trabajar Claude. Eso reduce drásticamente el esfuerzo inicial y explica por qué Claude Code puede sentirse tan coherente: herramientas, contexto, permisos y ejecución pertenecen al mismo sistema. El reverso es que esa experiencia está fuertemente optimizada alrededor de Claude y de la forma de trabajar que Anthropic considera adecuada.
En una frase: Anthropic trata el harness como el agente terminado que envuelve al modelo.
Google: el harness como sistema operativo común para los agentes
Google parte de una filosofía distinta a la de Microsoft: intenta que el agente conserve el mismo núcleo de ejecución aunque cambie la superficie desde la que se utiliza. Ese núcleo es Antigravity, que no debe entenderse simplemente como un IDE. Antigravity es el harness, es decir, la capa que mantiene al agente trabajando: gestiona el contexto, decide cuándo llamar al modelo, ejecuta herramientas, aplica políticas, coordina subagentes y mantiene el bucle de razonamiento y acción. Lo que cambia es la interfaz desde la que se accede a ese mismo motor.
Por eso Google presenta varias superficies alrededor de Antigravity. Puede utilizarse desde la aplicación Antigravity, desde Antigravity IDE, desde la terminal, mediante SDK o como agente gestionado en Google Cloud. Para el usuario son productos o interfaces diferentes, pero la intención arquitectónica es que compartan el mismo comportamiento básico. El desarrollador puede empezar de forma interactiva en su ordenador, automatizar después ese mismo tipo de trabajo desde código y, finalmente, llevarlo a un entorno gestionado en la nube sin tener que rediseñar completamente el agente.
El harness de Antigravity incorpora buena parte de lo que necesita un agente moderno para trabajar de forma autónoma: razonamiento iterativo, herramientas, gestión de contexto, políticas de seguridad, skills, subagentes y ejecución en entornos aislados. En los servicios gestionados de Google Cloud, ese agente puede recibir un sandbox donde planificar, ejecutar código, consultar información o manipular archivos. Esto convierte a Antigravity en algo más amplio que una herramienta de desarrollo: Google intenta utilizarlo como una capa de ejecución reutilizable desde el puesto individual hasta la infraestructura empresarial.
La principal ventaja de este enfoque es la coherencia. Google intenta evitar que cada salto obligue a cambiar de modelo mental. El usuario no tiene que aprender una arquitectura completamente distinta para pasar del escritorio al terminal, del terminal al SDK o del SDK a la nube. Eso reduce mucho la sensación de estar ensamblando productos independientes y explica por qué Antigravity puede resultar tan fluido: distintas interfaces funcionan como puertas de entrada al mismo sistema agéntico.
La segunda ventaja es la velocidad de evolución del agente. Un caso puede comenzar como una prueba local, incorporar herramientas y subagentes, automatizarse y desplegarse posteriormente en Google Cloud manteniendo buena parte de la lógica original. Para equipos que trabajan de manera iterativa, esta continuidad reduce el coste de pasar de experimento a aplicación real. La arquitectura está pensada para que el harness acompañe al agente durante todo ese recorrido, en lugar de utilizar una herramienta para prototipar y otra completamente diferente para operar.
Cuando el agente llega al entorno corporativo, entra en juego la plataforma empresarial de Google. A través de Gemini Enterprise Agent Platform y los servicios gestionados de agentes, la empresa puede añadir identidad, seguridad, control de acceso, red, observabilidad y gobierno. El planteamiento es progresivo: primero se construye y prueba el agente utilizando Antigravity; después se le añaden las capacidades necesarias para que pueda trabajar bajo las reglas de la organización. Google intenta así mantener separadas dos preocupaciones: la experiencia agéntica y el gobierno empresarial, pero haciendo que una pueda extenderse hacia la otra.
Otra característica importante es que Google no plantea Antigravity únicamente como una interfaz para Gemini. Aunque el ecosistema está claramente optimizado alrededor de sus propios modelos, la arquitectura del harness contempla también otros modelos y mecanismos de ejecución. Esto permite separar, al menos conceptualmente, el modelo que razona del entorno que gestiona herramientas, contexto, permisos y ejecución. Para una empresa, esa separación es relevante porque evita identificar automáticamente “modelo” y “agente” como si fueran la misma cosa.
El precio de esta coherencia es que una parte importante de la arquitectura queda más decidida por Google. Cuanto más se aprovecha la experiencia integrada de Antigravity, más se adopta también su forma de organizar contexto, herramientas, políticas y ejecución. Esto simplifica mucho el trabajo inicial, pero puede reducir la libertad de diseñar cada capa independientemente. La ventaja es menos ensamblaje; la contrapartida es una mayor dependencia del runtime y de las decisiones arquitectónicas del proveedor.
También hay que distinguir entre la experiencia individual y la empresarial. Algunas capacidades aparecen primero en las herramientas de desarrollo o en planes de consumo y no necesariamente llegan al entorno corporativo con el mismo ritmo o con las mismas condiciones. Además, varias piezas del ecosistema agéntico de Google siguen evolucionando rápidamente. Esa velocidad es una fortaleza para innovar, pero también obliga a una gran empresa a vigilar madurez, soporte, cuotas, compatibilidad y estabilidad antes de convertir una capacidad reciente en parte crítica de su arquitectura.
En conjunto, Google está construyendo una arquitectura en la que Antigravity funciona como el núcleo común del agente y las distintas interfaces son formas diferentes de utilizarlo. La aplicación, el IDE, la terminal, el SDK y los servicios gestionados no representan necesariamente agentes distintos, sino distintas maneras de acceder al mismo tipo de runtime. Después, Google Cloud añade las capas necesarias para operar esos agentes con seguridad y gobierno empresarial.
La idea esencial puede resumirse así: Antigravity aporta el harness y la experiencia de ejecución; sus distintas superficies permiten utilizar ese mismo motor de diferentes maneras; y Google Cloud añade infraestructura, seguridad y gobierno cuando el agente pasa a producción. Su principal fortaleza es la continuidad entre desarrollo y ejecución; su principal riesgo es que esa comodidad aumenta la dependencia del enfoque arquitectónico de Google. Por eso Google trata el harness como un sistema operativo común para agentes, accesible desde diferentes interfaces y extensible hacia el entorno corporativo.
Microsoft: el harness como composición de capacidades empresariales
Microsoft organiza su ecosistema agéntico como un conjunto de capacidades especializadas que se combinan según el tipo de agente y el contexto empresarial. No existe una única pieza equivalente a “todo Microsoft para agentes”. GitHub Copilot cubre principalmente el trabajo técnico y de desarrollo, con agentes capaces de explorar repositorios, planificar cambios, modificar código y ejecutar tareas. Copilot Studio es la superficie orientada a crear agentes de negocio, conectarlos con conocimiento y aplicaciones corporativas, definir acciones y publicarlos para usuarios. Microsoft Agent Framework proporciona a los desarrolladores una capa programática para construir agentes, workflows y harnesses con mayor control. Y alrededor de ellos aparecen Azure para infraestructura y servicios de IA, Entra para identidad y permisos, Microsoft Graph para acceder al universo de Microsoft 365 y Power Platform para conectores, automatizaciones y procesos deterministas.
El concepto de harness aparece en Microsoft precisamente al unir esas piezas. El harness es el runtime que mantiene al agente trabajando: decide cuándo llamar al modelo, mantiene y compacta el contexto, utiliza herramientas, gestiona memoria y tareas pendientes, solicita aprobaciones, delega trabajo a otros agentes y controla cuándo termina una ejecución. Microsoft dispone además de varios harnesses, no de uno solo. En Copilot Studio puede utilizar distintos runtimes según se necesite razonamiento autónomo de varios pasos, un comportamiento más estructurado o una extensión de Microsoft 365 Copilot. Y en Agent Framework ofrece otro nivel de construcción para escenarios donde el desarrollador necesita controlar directamente esa lógica. Por eso Microsoft se describe mejor como una plataforma multi-harness.
GitHub Copilot tiene aquí más importancia de la que puede parecer. El trabajo realizado para convertir Copilot en un agente de ingeniería capaz de planificar, utilizar herramientas y ejecutar durante varios pasos ha proporcionado a Microsoft un harness avanzado que posteriormente puede reutilizar en otros contextos. El mundo técnico y el mundo empresarial no están completamente separados: comparten conceptos de planificación, herramientas, memoria, delegación y control de ejecución, aunque después se expongan mediante productos diferentes.
Una de las principales ventajas de esta arquitectura es la integración corporativa. Un agente puede disponer de identidad propia en Entra, acceder mediante permisos controlados a correo, calendario, documentos, Teams o SharePoint a través de Graph, utilizar Power Automate para ejecutar procesos deterministas y apoyarse en Azure para modelos, datos, red, almacenamiento y ejecución. En una organización que ya utiliza Microsoft, buena parte de esta infraestructura existe antes de crear el agente. No hay que inventar nuevamente el directorio de identidades, el modelo de permisos, los repositorios documentales, los mecanismos de cumplimiento o cientos de conectores empresariales.
La segunda ventaja es el gobierno a escala. Microsoft está tratando progresivamente a los agentes como nuevos actores de la organización: pueden tener identidad, propietario o responsable, permisos, políticas y trazabilidad. Esto cambia mucho cuando se pasa de construir tres agentes a administrar cientos. El problema deja de ser únicamente si el agente razona bien y pasa a ser quién es responsable de él, qué información puede utilizar, qué acciones tiene autorizadas, cómo se audita y cómo se retira cuando deja de ser necesario. Esa capa de gobierno es una de las fortalezas estructurales del enfoque Microsoft.
La tercera ventaja es su apertura a modelos y runtimes diferentes. Microsoft no necesita que toda la arquitectura dependa de un único modelo. Su plataforma puede trabajar con modelos propios y de terceros y está evolucionando hacia un entorno en el que el valor estratégico reside menos en imponer un modelo concreto que en ser la plataforma desde la que se consumen, conectan y gobiernan diferentes modelos y agentes. Es una diferencia importante: Microsoft puede beneficiarse incluso cuando el mejor modelo para determinado problema pertenece a otro proveedor.
Power Platform introduce además una separación especialmente útil entre razonamiento y automatización. No todo lo que hace un agente debería resolverse mediante inteligencia artificial. Un proceso como aprobar una factura, actualizar un registro o ejecutar una operación sobre un sistema puede seguir siendo un flujo determinista. El agente interpreta la intención y decide cuándo necesita esa capacidad; Power Automate ejecuta después el proceso predecible como una herramienta. De esta forma, Microsoft puede combinar agentes probabilísticos con procesos empresariales tradicionales sin sustituir innecesariamente aquello que ya funciona.
La contrapartida es la complejidad. Al existir varias superficies, runtimes y servicios, el cliente debe tomar más decisiones: GitHub Copilot o Copilot Studio, Agent Framework o una solución gestionada, qué harness utilizar, qué modelo, qué herramientas, qué conectores, dónde alojar los datos, cómo gestionar permisos y qué acciones delegar en Power Automate. Muchas capacidades que otros proveedores presentan dentro de una única experiencia aparecen en Microsoft como piezas diferenciadas. De ahí la sensación de “Lego”: no porque falten componentes, sino porque hay muchos y la empresa tiene que entender cuáles necesita y cómo encajan.
Esa modularidad introduce además decisiones que conviene tomar bien desde el principio. No todos los harnesses ofrecen las mismas capacidades ni tienen necesariamente el mismo modelo de consumo, y determinadas elecciones del runtime pueden condicionar posteriormente el agente. A esto se suma que algunas de las capacidades más nuevas siguen evolucionando rápidamente, con funcionalidades en preview, cambios de terminología y productos que Microsoft reorganiza con bastante frecuencia. La amplitud del ecosistema es una fortaleza, pero también genera un coste de aprendizaje y de arquitectura que no debería ocultarse.
Microsoft Agent Framework intenta precisamente reducir parte de esa fragmentación. Está reuniendo en una capa más coherente capacidades como planificación, gestión de contexto, memoria, tareas, herramientas, aprobaciones, observabilidad y delegación. Sin embargo, incluso ahí Microsoft mantiene su filosofía de fondo: no construir una caja cerrada, sino permitir que esos componentes puedan combinarse, sustituirse o integrarse con otros servicios.
El resultado es una propuesta especialmente potente para grandes corporaciones, pero con una lógica distinta a la de un producto agéntico completamente integrado. Microsoft optimiza menos la sensación de que todo ocurre dentro de una única aplicación y más la capacidad de insertar los agentes dentro de la arquitectura existente de la empresa. Su gran ventaja es aprovechar identidad, datos, aplicaciones, automatización, seguridad y gobierno ya desplegados; su principal inconveniente es que esa arquitectura queda mucho más visible y exige más decisiones.
La idea esencial puede resumirse así: GitHub Copilot aporta la experiencia agéntica para ingeniería; Copilot Studio permite construir y distribuir agentes de negocio; Agent Framework proporciona el harness programable; Azure aporta modelos e infraestructura; Entra gobierna identidad y acceso; Graph conecta con Microsoft 365; y Power Platform convierte procesos y aplicaciones empresariales en herramientas que los agentes pueden utilizar. La fortaleza de Microsoft no está tanto en una de esas piezas aislada como en poder hacer que todas formen parte de una misma arquitectura corporativa. Para una gran empresa, ésa es también la razón por la que Microsoft puede parecer más complejo al principio y, sin embargo, resultar especialmente potente cuando el problema deja de ser crear un agente y pasa a ser operar y gobernar cientos de ellos.
OpenAI: el harness como runtime reutilizable y gestionado
OpenAI se sitúa en un punto intermedio entre Anthropic y Google, pero con una orientación especialmente clara hacia los desarrolladores: el harness es una capa de ejecución reutilizable que puede consumirse de diferentes maneras.
Codex Web, CLI, IDE y otras experiencias utilizan el mismo núcleo de ejecución. OpenAI describe precisamente el Codex harness como el ciclo que mantiene contexto, utiliza herramientas, aplica políticas de sandbox y aprobación y continúa trabajando entre turnos. La interfaz puede cambiar; el motor permanece.
La diferencia está en que OpenAI ha convertido explícitamente ese motor en una plataforma consumible a distintos niveles de abstracción. La empresa plantea tres caminos claramente separados. Con Agents API, OpenAI ejecuta el harness completo y mantiene sesiones, contexto, recuperación y orquestación. Con Agents SDK, el bucle se ejecuta dentro de la aplicación del cliente y éste conserva mayor control. Y con Responses API puede construirse prácticamente todo desde cero.
Por tanto, su filosofía no es simplemente “te damos nuestro harness”, sino “elige cuánto del harness quieres que operemos nosotros”.
El Agents API lleva este enfoque bastante lejos. OpenAI administra sesiones duraderas, compactación de contexto, subagentes y recuperación; el desarrollador decide las herramientas y puede escoger dónde se ejecutan comandos y archivos: sandbox gestionado, infraestructura propia u otros entornos. De esta manera se separan deliberadamente la inteligencia de orquestación y el lugar físico donde se realiza el trabajo.
Existe además otra diferencia relevante: OpenAI ha publicado como código abierto buena parte del harness de Codex. Eso permite utilizarlo no solo como producto final sino como infraestructura embebible dentro de aplicaciones específicas, desde ingeniería o seguridad hasta operaciones o soporte.
Frente a Google, que enfatiza especialmente la continuidad entre superficies, OpenAI enfatiza más la portabilidad del runtime y la elección del nivel de control. Frente a Microsoft, intenta proporcionar una experiencia más integrada sin obligar al cliente a ensamblar tantas capas. Y frente a Anthropic, ofrece una separación algo más explícita entre harness gestionado, SDK y construcción directa.
En una frase: OpenAI trata el harness como un runtime reusable que puede consumirse gestionado, embebido o construido a medida.
Y los que no venden modelos
Fuera de Anthropic, Google, Microsoft y OpenAI existe otro ecosistema importante: empresas y proyectos que no venden un modelo propio, sino alguna de las capas necesarias para construir y operar agentes. Aquí es donde más confusión suele haber, porque bajo la etiqueta genérica de “plataforma de agentes” se mezclan productos que hacen cosas muy distintas. Conviene separar al menos cuatro capas. Los frameworks sirven para definir la lógica del agente: estados, ciclos, rutas, equipos de agentes, roles, herramientas y reglas de coordinación. Los motores de ejecución duradera se ocupan de que un proceso largo pueda sobrevivir a errores, esperas o reinicios, mediante checkpoints, reintentos y recuperación del estado. Los runtimes de agente, es decir, los harnesses propiamente dichos, ejecutan el bucle completo del agente: llaman al modelo, mantienen el contexto, enrutan herramientas, aplican permisos, gestionan memoria y coordinan subagentes. Y, atravesando todas estas capas, están las herramientas de observabilidad y evaluación, que permiten reconstruir qué hizo el agente, medir costes y latencias, detectar fallos y comparar versiones.
La distinción importa porque estas capas no son excluyentes ni suelen venir todas en el mismo producto. Un equipo puede diseñar la lógica del agente con un framework, ejecutarlo dentro de un harness y apoyarse por debajo en un motor durable para garantizar que una tarea de horas o días pueda reanudarse después de un fallo. De hecho, algunos frameworks permiten conectarse a varios motores de ejecución distintos, precisamente porque no pretenden resolver esa capa por sí mismos. La respuesta a “¿cuál es el mejor?” depende entonces menos de una superioridad técnica absoluta que de qué plataforma, base de datos, colas, observabilidad e infraestructura ya opera la empresa.
También está apareciendo otra señal de madurez: proveedores de infraestructura que no venden ni modelos ni harnesses propios están empezando a ofrecer una interfaz común para ejecutar harnesses de terceros. Eso solo tiene sentido si la categoría está suficientemente estabilizada como para reconocer una anatomía común: un harness completo mantiene sesiones, contexto, herramientas, políticas y ejecución, aunque por dentro use Claude, Codex, Gemini u otro modelo. El problema es que esa interoperabilidad todavía está lejos de ser perfecta. Los adaptadores existen, pero muchas implementaciones siguen siendo experimentales, cambian APIs y formatos entre versiones y obligan a mantener integraciones específicas para cada harness.
Por eso no debe sorprender que muchas arquitecturas reales terminen combinando varias piezas. El framework define cómo debe comportarse el agente; el harness lo mantiene vivo y operativo; el motor durable evita que pierda el trabajo cuando algo falla; y la observabilidad permite saber qué demonios ha hecho durante el proceso, detalle menor hasta que el agente empieza a tocar sistemas de producción. No es un mal diseño ni una duplicación absurda, sino el resultado de que cada capa resuelve un problema distinto. El mercado está convergiendo poco a poco hacia estas abstracciones comunes, pero todavía no existe una plataforma neutral que permita intercambiar frameworks, harnesses y motores de ejecución como si fueran piezas completamente compatibles. Esa es, probablemente, la siguiente frontera del ecosistema agéntico.
| Dimensión | Anthropic | Microsoft | OpenAI | |
|---|---|---|---|---|
| Filosofía | Harness como agente completo | Motor común en múltiples superficies | Composición de capacidades empresariales | Runtime gestionado o embebible |
| Unidad principal | Un harness coherente | Un motor, varias interfaces | Varios harnesses y runtimes | Un núcleo con varios niveles de consumo |
| Experiencia | Muy integrada | Muy integrada | Más modular | Intermedia |
| Modelos | Principalmente Claude | Gemini y algunos modelos de terceros | Muy multimodelo | Principalmente modelos OpenAI |
| Gobierno empresarial | Alto | Alto | Muy alto | Alto |
| Continuidad | Sesión durable separada del runtime | Persistencia y reanudación | Durabilidad componible | Sesiones y estado gestionados |
| Mejor encaje | Agentes técnicos y desarrollo de software | Experiencia agéntica unificada | Grandes empresas y procesos de negocio | Desarrollo y agentes como servicio |
| Principal limitación | Mayor dependencia del ecosistema Claude | Diferencias entre entorno individual y corporativo | Mayor complejidad y fragmentación | Más trabajo cuando se busca control total |
Ninguna fila de esa tabla tiene un ganador, y no es diplomacia: es que las filas no son comparables entre sí en importancia. Que un fabricante tenga más gobierno corporativo no compensa que su compactación sea experimental si su caso de uso es una tarea larga; que otro tenga la experiencia más integrada no compensa que le falten modelos de terceros en el plan de empresa si su política de riesgo exige poder cambiar de modelo. La tabla sirve para saber qué preguntar, no para elegir.
Conclusión: cuatro estrategias de harness, y en qué se nota cada una
Que ninguna fila de la tabla tenga ganador no significa que no se pueda concluir nada. Se puede, y conviene mojarse, porque los cuatro no están haciendo lo mismo con distinto acabado: están optimizando cosas distintas, y eso sí se puede decir con nombre y apellidos.
Para una gran corporación, la diferencia entre Google y Microsoft aparece menos en el inventario de capacidades que en la forma de llegar a ellas. Google intenta mantener una experiencia agéntica continua alrededor de Antigravity: el mismo enfoque de harness se extiende desde el entorno del desarrollador hasta distintas superficies y, después, hacia la plataforma cloud corporativa. La idea es partir de un agente que ya funciona en Antigravity y añadir progresivamente identidad, seguridad, red, datos y gobierno sin cambiar demasiado de paradigma.
Microsoft recorre el camino de forma distinta. No tiene un equivalente tan claro a Antigravity como centro único de la experiencia. Parte de una arquitectura empresarial ya existente y hace que el agente encaje dentro de ella. Identidad, datos, permisos, automatización, seguridad y cumplimiento están repartidos entre Entra, Microsoft 365, Azure, Copilot Studio y Power Platform. Eso obliga a tomar más decisiones de arquitectura al principio, pero también permite que el agente herede controles corporativos que la empresa ya utiliza para usuarios, aplicaciones y datos.
La consecuencia práctica es que Antigravity reduce mucho la sensación de ensamblaje. Google intenta que el desarrollador vea un agente coherente y que la complejidad de la plataforma aparezca después, cuando se necesita endurecerlo para producción. Microsoft hace más visible esa complejidad desde el principio: hay que decidir qué runtime, qué herramientas, qué conectores, qué políticas y qué servicios intervienen. Esa es la raíz de la sensación de “Google parece una sola cosa y Microsoft parece Lego”.
Sin embargo, esa aparente desventaja de Microsoft puede invertirse cuando la organización pasa de unos pocos agentes a una flota grande. Si la empresa ya utiliza Microsoft 365, Entra, Azure y Power Platform, identidad, permisos, datos, canales y gobierno ya están estandarizados. Google, con Antigravity, ofrece una experiencia más coherente alrededor del agente; Microsoft ofrece una integración más profunda con la maquinaria corporativa que ya existe.
La diferencia de fondo puede resumirse así: Google, con Antigravity, optimiza la continuidad de la experiencia del agente; Microsoft optimiza la integración del agente con la empresa. Por eso Google puede resultar más elegante y rápido para construir y evolucionar casos concretos, mientras que Microsoft puede ganar peso cuando la prioridad es gobernar muchos agentes dentro de una organización ya muy asentada sobre su ecosistema.
| Fabricante | Qué está optimizando | Lo que resuelve bien | Lo que cuesta |
| Anthropic | El harness como aplicación | Es el que más trae resuelto de fábrica: contexto y compactación, permisos, aislamiento, puntos de control, subagentes, habilidades y sesiones que sobreviven a una interrupción. La mejor experiencia de las cuatro para trabajo técnico sobre ficheros y código | Muy ligado a su propio modelo; su harness gestionado sigue en beta; y es el que peor encaja hoy con una exigencia de que el dato se quede en Europa. Menos orientado al proceso de negocio que al trabajo de ingeniería |
| Una experiencia única alrededor del agente | Un mismo motor debajo del escritorio, la terminal, el IDE y la API —lo dicen ellos por escrito—, artefactos revisables, aislamiento por rama de trabajo y continuidad real entre superficies. El salto al entorno corporativo es un cambio de configuración, no de arquitectura | Bastantes piezas todavía en estado previo y sin etiqueta pública de madurez en la capa de gobierno; cambios de producto bruscos, con una retirada documentada de dieciocho días entre el anuncio y el apagado; y la paradoja de que su apertura a modelos de terceros no llega al plan empresarial | |
| Microsoft | El gobierno de muchos agentes y muchos modelos | Identidad por agente, registro, seguridad, gobierno del dato, la mayor variedad de modelos —incluidos los de sus competidores— y la integración con la suite donde la empresa ya trabaja. Es el que mejor responde a la pregunta de quién hizo qué y con permiso de quién | Fragmentación real: varios harnesses simultáneos con contadores separados, decisiones de arquitectura por delante del primer agente y piezas importantes aún en versión previa, entre ellas la compactación y la durabilidad. Es, de largo, el que más cuesta encender |
| OpenAI | El harness como servicio gestionado | Arquitectura limpia y poca infraestructura propia si se usa su servicio: sandbox, permisos, subagentes, guardarraíles, memoria y trazado vienen dados. Y deja bajar un peldaño —a librería, o a construirlo uno mismo— sin cambiar de casa | Muy centrado en sus propios modelos y en el trabajo de código; menos gobierno corporativo nativo que Microsoft; y superficies que todavía se mueven, con retiradas de herramientas de agentes anunciadas este mismo año |
Puesto en una sola frase, que es la síntesis que este artículo llevaba debiendo desde el principio:
Anthropic diseña el harness como una aplicación completa alrededor de Claude. Google busca que el mismo motor agéntico funcione de forma coherente en distintas interfaces. Microsoft prioriza una plataforma modular para gobernar muchos agentes, modelos y procesos empresariales. OpenAI apuesta por un harness que puede consumirse como servicio gestionado o integrarse dentro de otras aplicaciones.
Y esta diferencia explica bastante bien por qué la experiencia cambia tanto entre unas plataformas y otras. En un entorno integrado, el usuario puede simplemente decir qué quiere conseguir y dejar que el agente resuelva cómo hacerlo. En una plataforma empresarial más modular, antes hay que decidir qué agente utilizar, qué harness lo ejecutará, qué herramientas puede invocar, qué flujos necesita y qué permisos tendrá. Eso no significa que haya menos capacidad técnica. Muchas veces ocurre justo lo contrario: hay más piezas y más posibilidades, pero también más decisiones que tomar y más arquitectura que gestionar. Anthropic y Google tienden a ocultar esa complejidad para ofrecer una experiencia más fluida; Microsoft la hace más visible porque prioriza integración, control y gobierno corporativo. OpenAI intenta situarse entre ambos enfoques ofreciendo distintos niveles de abstracción. La diferencia no está tanto en quién tiene más funcionalidades, sino en dónde decide cada proveedor colocar la complejidad.
Cuánto se tarda en montar lo que un agente necesita
Comparar únicamente qué harness tiene más funciones puede resultar engañoso. Para una empresa hay una pregunta bastante más práctica: ¿cuánto trabajo hace falta para pasar de una idea a un agente que pueda utilizarse de verdad?
Para responderla conviene distinguir tres estados. Un prototipo demuestra que el modelo puede resolver una tarea. Un primer agente funcional ya realiza una tarea real de principio a fin, utilizando herramientas o sistemas externos. Y un agente corporativo añade todo lo necesario para trabajar de forma segura dentro de una organización: identidad, permisos, acceso a sistemas internos, protección del dato, auditoría, observabilidad y gobierno.
La diferencia importante entre proveedores no suele estar en el prototipo. Con los cuatro se puede conseguir uno rápidamente. Tampoco basta con medir cuánto se tarda en hacer una primera llamada a una API. Lo interesante es cuánto camino existe entre demostrar que el agente funciona y poder confiarle trabajo real dentro de una empresa.
Dos etapas que conviene no mezclar
La primera etapa va del prototipo al primer agente funcional. Aquí el objetivo es conseguir que el agente complete una tarea real: que pueda consultar información, utilizar una herramienta, tomar una decisión y devolver o ejecutar un resultado. Todavía no exigimos toda la infraestructura corporativa que rodearía a ese agente en producción.
La segunda etapa va del primer agente funcional al agente corporativo. El agente ya sabe trabajar; ahora hay que conseguir que pueda hacerlo bajo las reglas de la empresa. Esto significa controlar quién es, a qué puede acceder, qué acciones puede ejecutar, dónde circulan sus datos, cómo entra en los sistemas internos y cómo podemos reconstruir posteriormente todo lo que hizo.
Esta separación es importante porque un producto puede ser extraordinariamente rápido en la primera etapa y bastante más exigente en la segunda. También puede suceder lo contrario: una plataforma puede parecer más compleja al principio precisamente porque incorpora desde el inicio elementos de seguridad, identidad y gobierno que después serán obligatorios.
Del prototipo al primer agente funcional
En esta primera etapa buscamos algo más serio que una demo. El agente debe ser capaz de completar una tarea real de extremo a extremo. Por ejemplo: recibir una incidencia, consultar dos sistemas, interpretar la información, utilizar una herramienta y generar una propuesta de actuación.
En este nivel, los cuatro proveedores permiten avanzar con bastante rapidez. Anthropic y Google destacan por ofrecer experiencias muy integradas alrededor del agente. OpenAI ofrece distintas formas de empezar, desde entornos preparados hasta SDK y API. Microsoft facilita mucho la entrada mediante herramientas visuales y su ecosistema de Copilot, aunque la experiencia depende más del producto concreto desde el que se construya.
Por eso la velocidad hasta el primer agente funcional no es, por sí sola, un gran criterio de selección. Todos los fabricantes han invertido mucho en conseguir que esta primera experiencia sea sencilla. Las diferencias realmente importantes empiezan cuando ese agente tiene que conectarse de forma permanente con procesos, datos y sistemas corporativos.
| Dimensión | Anthropic | Microsoft | OpenAI | |
|---|---|---|---|---|
| Llegar a un primer agente funcional | Rápido | Rápido | Rápido | Rápido |
| Experiencia inicial | Muy integrada alrededor de Claude | Experiencia unificada alrededor del agente | Más modular, con distintas herramientas de entrada | Varias rutas según el nivel de control deseado |
| Uso de herramientas | Muy integrado en el harness | Integrado en el entorno agéntico | Amplio ecosistema de conectores y acciones | Integrado mediante herramientas y APIs |
| Ruta con poco código | No es su orientación principal | Disponible | Especialmente desarrollada | Más limitada |
| Principal fortaleza | El agente llega muy equipado desde el principio | Fluidez entre distintas superficies | Integración con el ecosistema empresarial Microsoft | Flexibilidad entre producto, SDK y API |
| Dónde empieza la complejidad | Al añadir requisitos empresariales externos al harness | Al pasar al entorno corporativo gobernado | Al decidir qué piezas de la plataforma combinar | Al decidir qué parte gestiona OpenAI y qué parte construye el cliente |
Del primer agente funcional al primer agente corporativo
Aquí cambia la naturaleza del problema. El agente ya funciona. Lo que hay que conseguir ahora es que la empresa pueda confiar en él.
Un agente corporativo necesita una identidad reconocible, permisos limitados, acceso seguro a sistemas internos, protección de información sensible, trazabilidad, observabilidad, políticas de aprobación y mecanismos para administrarlo durante todo su ciclo de vida. Cuando hay cientos de agentes, además, hacen falta inventario, responsables, políticas comunes y una forma centralizada de gobernarlos.
Y aquí aparecen con claridad las diferentes filosofías de los cuatro proveedores.
Anthropic intenta mantener la mayor cantidad posible de capacidades dentro de un harness coherente. Esto simplifica la experiencia del agente, aunque la organización debe completar alrededor de él parte de la infraestructura corporativa necesaria.
Google parte también de una experiencia agéntica bastante integrada, pero la extiende hacia su plataforma cloud para incorporar progresivamente identidad, seguridad, redes, datos y gobierno. El salto es principalmente de configuración y plataforma.
Microsoft parte casi del planteamiento contrario. El agente se integra dentro de un ecosistema empresarial que ya dispone de identidad, seguridad, datos, aplicaciones, automatización y gobierno. Esto ofrece muchas capacidades corporativas, pero hace más visible la arquitectura: el cliente tiene que decidir qué componentes utiliza y cómo los combina.
OpenAI permite escoger cuánto de esa infraestructura se delega en el proveedor y cuánto permanece bajo control de la empresa. Esa flexibilidad reduce algunas barreras, pero también obliga a tomar decisiones arquitectónicas cuando se abandona el camino totalmente gestionado.
La consecuencia es importante: la plataforma más rápida para hacer una demostración no tiene por qué ser la más rápida para desplegar un agente corporativo, y la que requiere más componentes tampoco tiene necesariamente menos capacidades. Lo que cambia es cuánto resuelve el proveedor dentro de su harness y cuánto deja explícitamente en manos de la plataforma y de la empresa.
| Dimensión | Anthropic | Microsoft | OpenAI | |
|---|---|---|---|---|
| Naturaleza del salto | Completar alrededor del harness el entorno empresarial | Extender el agente hacia la plataforma cloud corporativa | Integrar el agente con varias capacidades empresariales | Elegir qué gestiona OpenAI y qué mantiene la empresa |
| Identidad y permisos | Integrados en el servicio y complementados por la empresa | Integrables con identidad y políticas cloud | Muy integrados con el ecosistema corporativo | Configurables según la arquitectura utilizada |
| Acceso a sistemas internos | Requiere integración empresarial | Mediante infraestructura cloud y herramientas | Muy integrado con Microsoft 365, Azure y Power Platform | Mediante herramientas, APIs y arquitectura del cliente |
| Gobierno de muchos agentes | En desarrollo alrededor del ecosistema Claude | Integrado progresivamente en la plataforma | Uno de los puntos fuertes del enfoque | Disponible, con distintos niveles de gestión |
| Cantidad de arquitectura visible para el cliente | Baja-media | Media | Alta | Media |
| Principal ventaja | Coherencia y simplicidad del entorno del agente | Continuidad entre agente y plataforma | Integración, seguridad y gobierno empresarial | Flexibilidad para elegir el grado de gestión |
| Principal coste | Completar capacidades corporativas externas | Configurar correctamente la capa empresarial | Mayor número de piezas y decisiones | Más arquitectura cuanto mayor control se desea |
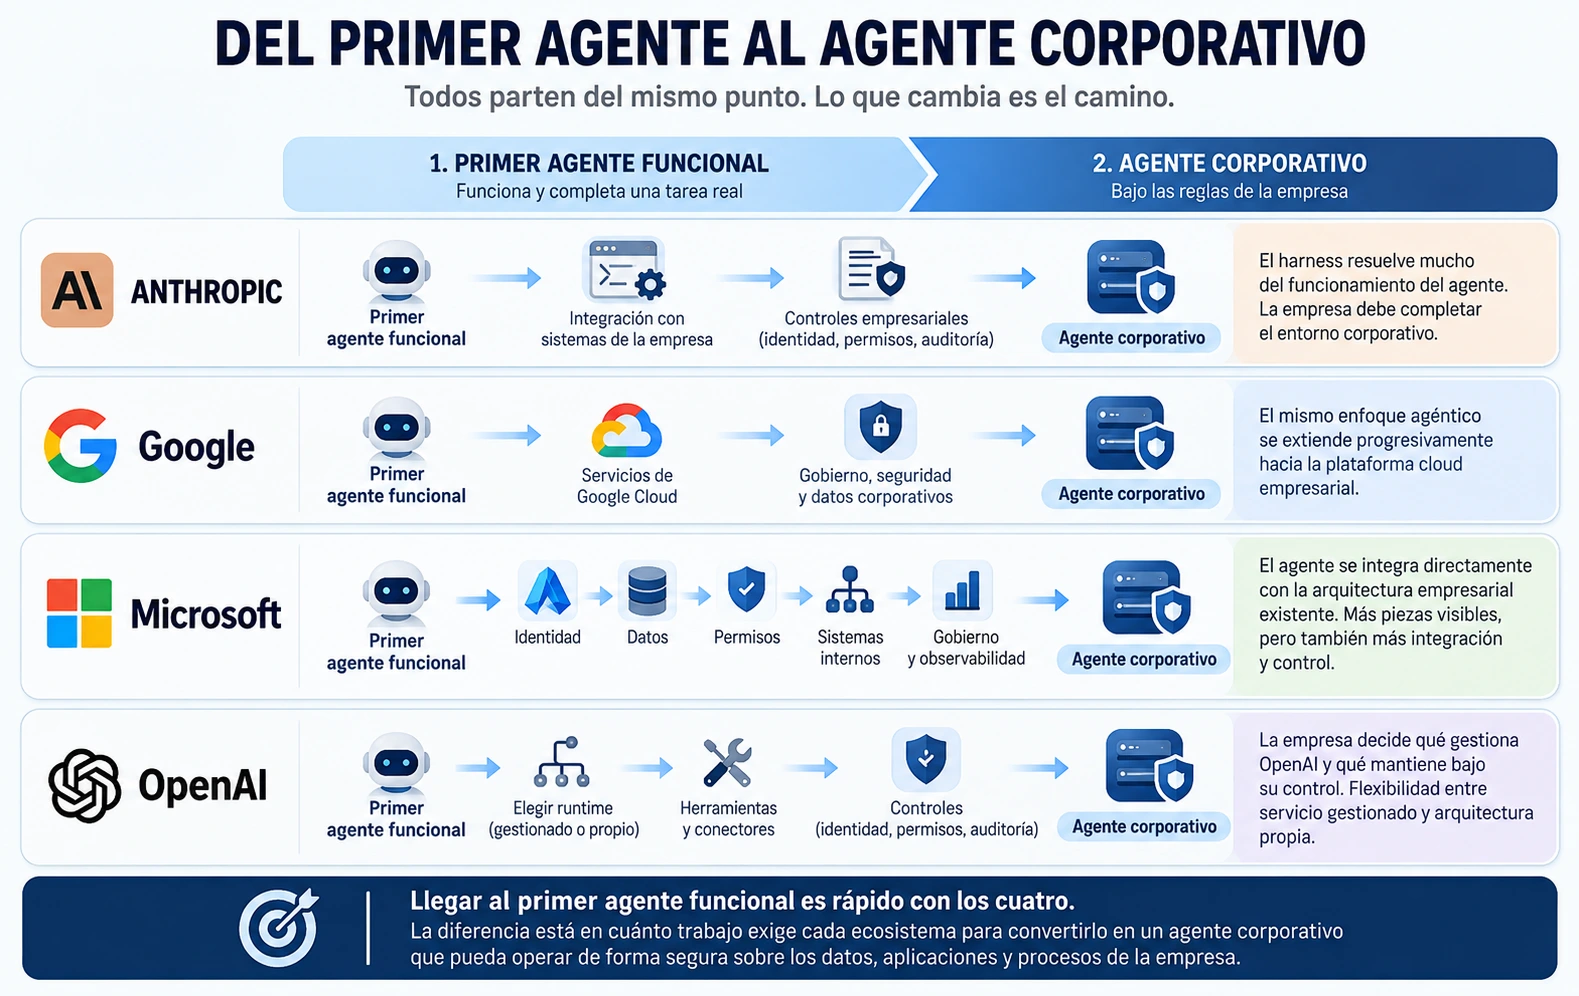
La distancia no es solo más larga en unos: es de otra naturaleza
Pasar de un agente funcional a un agente corporativo no consiste simplemente en añadir más configuraciones. El tipo de trabajo cambia según el ecosistema.
En Anthropic, buena parte del funcionamiento del agente ya está resuelto dentro del harness, pero la empresa tiene que completar alrededor de él aspectos como integración corporativa, residencia del dato o acceso seguro a sistemas internos.
Google intenta que el salto sea más continuo: el mismo enfoque agéntico se va ampliando con capacidades de Google Cloud para identidad, seguridad, red y gobierno.
Microsoft plantea un recorrido diferente. El agente se incorpora a una arquitectura empresarial formada por identidad, datos, permisos, conectividad, seguridad y gobierno. Por eso el paso a producción puede requerir más diseño previo, aunque esas mismas piezas facilitan después operar muchos agentes dentro de una organización.
OpenAI ofrece una posición intermedia: permite comenzar utilizando infraestructura gestionada y asumir progresivamente más componentes cuando se necesita mayor control.
La diferencia entre plataformas no es solo cuántos pasos hay hasta producción, sino qué tipo de trabajo exige cada una durante el camino.
Europa puede cambia la elección
En proyectos europeos aparece un condicionante que muchas demostraciones ignoran: dónde se procesan y almacenan los datos y qué componentes del servicio permiten seleccionar región o residencia.
Esto puede alterar bastante una arquitectura que parecía sencilla en una prueba. No todas las funciones de una plataforma tienen necesariamente las mismas opciones de residencia, y algunas capacidades gestionadas pueden tener restricciones distintas de las del modelo o de la infraestructura cloud sobre la que se apoyan.
Por eso, para sectores regulados o empresas con requisitos estrictos de soberanía del dato, no basta con preguntar si el proveedor tiene región europea. Hay que comprobar la residencia de cada pieza relevante: modelo, sesiones, memoria, herramientas, trazas, almacenamiento y servicios gestionados del agente.
Ese apartado aporta mucho más que enumerar qué proveedor tiene Madrid, Suiza o qué endpoint está en preview, porque la idea seguirá siendo válida aunque mañana cambien las regiones disponibles.
Algunas decisiones de arquitectura, como región, red, identidad o tipo de runtime, pueden ser difíciles de modificar posteriormente. Por eso conviene diseñar el primer piloto pensando ya en las condiciones que tendrá el agente si llega a producción.
Otro coste: la estabilidad de la plataforma
La velocidad de evolución también tiene un coste. Todos estos ecosistemas están cambiando muy deprisa: productos que se renombran, APIs que evolucionan, servicios que pasan de preview a disponibilidad general y capacidades que se sustituyen. Para una empresa, esto significa que la estabilidad del roadmap y la compatibilidad hacia atrás importan casi tanto como las funcionalidades actuales. Una plataforma muy potente pero que obliga a revisar continuamente arquitectura, documentación y formación puede introducir una forma de deuda tecnológica difícil de ver en una comparativa funcional.
La velocidad cambia cuando pasamos de un agente a cien
Hay dos tipos de agilidad que no siempre coinciden.
La primera es la agilidad de creación: cuánto cuesta pasar de una idea a un agente funcional. Aquí tienen ventaja los entornos que integran modelo, herramientas, permisos, memoria y ejecución dentro de una experiencia coherente.
La segunda es la agilidad de industrialización: cuánto cuesta repetir ese proceso cuando ya no hablamos de un agente, sino de decenas o cientos, todos con identidad, responsables, permisos, auditoría y políticas comunes.
Y ahí aparece una paradoja importante. Una plataforma muy integrada puede ser extraordinariamente rápida para construir el primer agente, mientras que una plataforma más modular y gobernada puede amortizar su complejidad inicial cuando el número de agentes crece.
Anthropic y Google ponen mucho énfasis en reducir el recorrido entre intención y ejecución. Microsoft acepta más arquitectura visible a cambio de disponer de un ecosistema empresarial preparado para administrar identidad, datos, permisos y gobierno a escala. OpenAI intenta ocupar una posición intermedia, permitiendo empezar con servicios gestionados y asumir progresivamente más control.
La pregunta correcta, por tanto, no es solo “¿cuánto tardaré en construir mi primer agente?”, sino también: “¿qué parte de ese trabajo tendré que repetir cuando construya el agente número cien?”
Por qué en casa parece magia y en la empresa parece un Lego
La sensación es muy común: en casa, o en un entorno de desarrollador, un agente parece una sola cosa. Se abre, se le da una tarea y trabaja. En una gran empresa, en cambio, aparecen identidad, permisos, datos, conectores, pasarelas, observabilidad, seguridad, cumplimiento y gobierno. Parece que se haya pasado de un producto terminado a una caja de piezas.
La explicación es que no estamos viendo el mismo nivel de la arquitectura.
En el entorno individual vemos sobre todo la experiencia del agente: el modelo, el harness y las herramientas están ya integrados y muchas decisiones vienen tomadas por el proveedor.
En el entorno corporativo vemos además todo lo que rodea al agente para que pueda operar bajo las reglas de la empresa: quién es, a qué puede acceder, qué acciones puede ejecutar, dónde están sus datos, cómo se audita, cómo se controla el coste y quién responde por él.
Por eso comparar directamente ambas experiencias puede llevar a conclusiones equivocadas. Es como comparar conducir un coche con ver el esquema completo de sus sistemas electrónicos. El primero parece simple porque alguien ya ha resuelto la complejidad por usted.
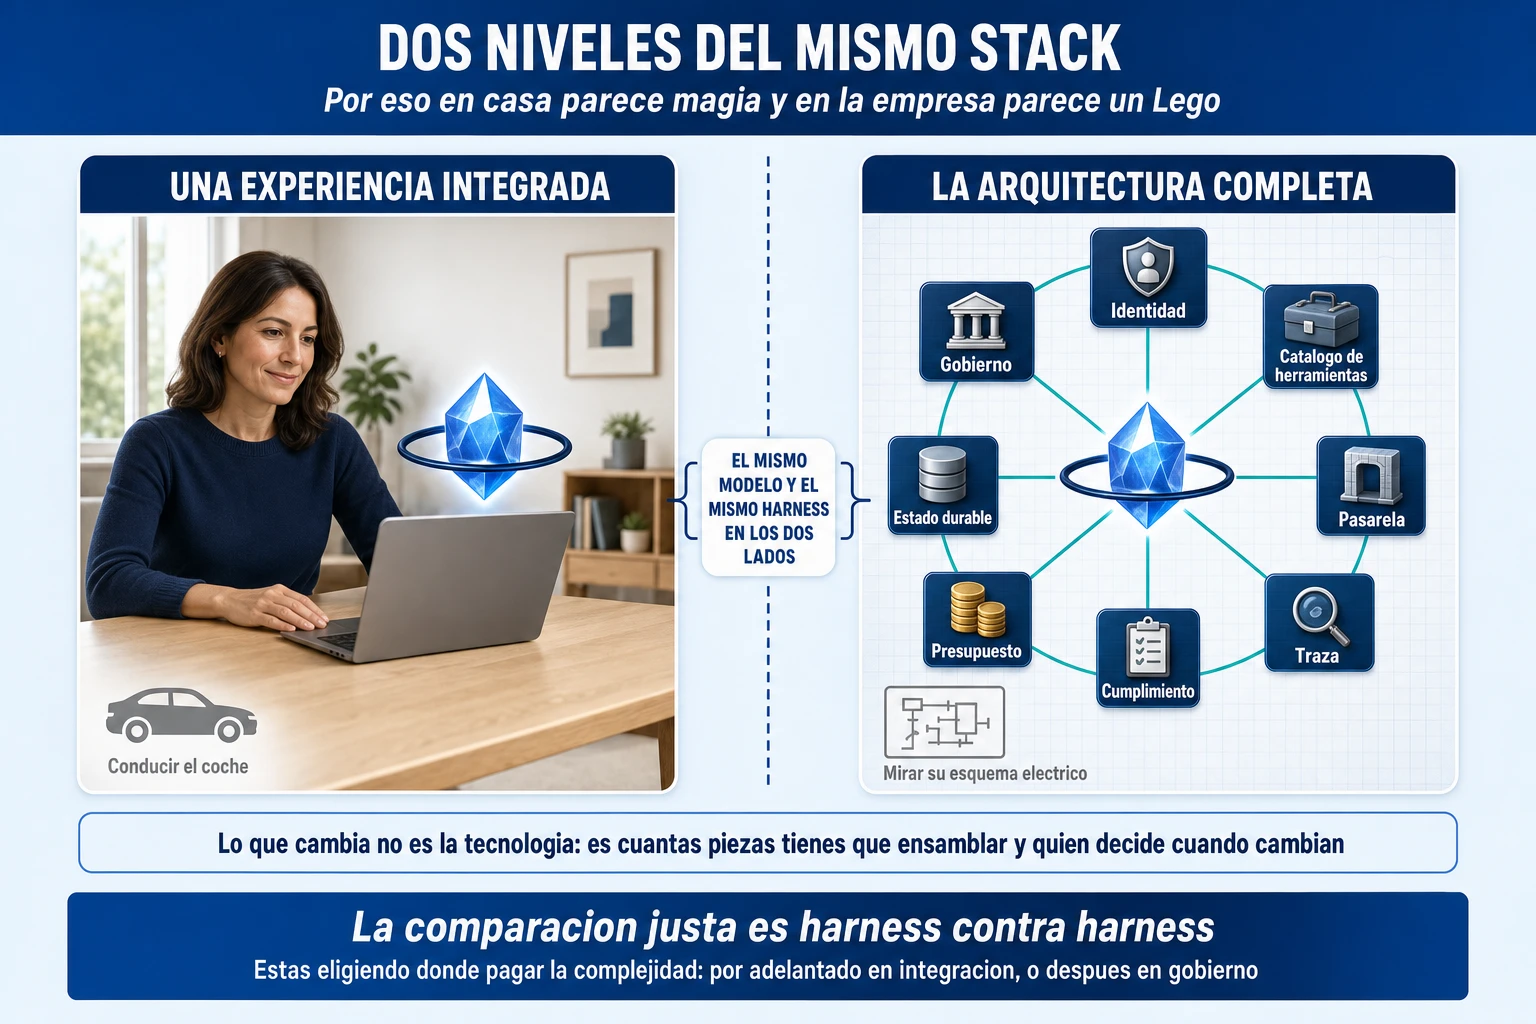
La comparación que hace todo el mundo, y por qué está mal planteada
Cuando una persona utiliza un entorno muy integrado, puede pensar que ese proveedor tiene una arquitectura mucho más sencilla. Pero muchas veces la diferencia no está en la cantidad de capacidades, sino en cuántas decisiones están ocultas y cuántas quedan expuestas al cliente.
Anthropic y Google tienden a ofrecer una experiencia más integrada: muchas decisiones sobre herramientas, contexto, permisos y ejecución están ya resueltas dentro del entorno.
Microsoft hace más visibles las piezas de la arquitectura empresarial porque el agente se integra con identidad, datos, seguridad, Power Platform, Microsoft 365, Azure y gobierno corporativo.
OpenAI permite elegir entre ambos extremos: utilizar una experiencia más gestionada o asumir progresivamente mayor control sobre la arquitectura.
Por eso la comparación justa no es “qué plataforma tiene menos piezas”, sino: “qué parte de la complejidad resuelve el proveedor y qué parte tiene que resolver la empresa”.
Lo que sí es diferente de verdad
Las diferencias importantes no están tanto en que un proveedor tenga o no memoria, herramientas, permisos o subagentes. Los cuatro grandes disponen ya de buena parte de esas capacidades.
Lo que cambia de verdad es cómo las empaquetan.
En unos ecosistemas, muchas capacidades vienen integradas dentro de una experiencia común. En otros, esas mismas capacidades están repartidas entre varios productos y servicios que la empresa debe combinar.
La primera opción suele reducir el esfuerzo inicial y ofrecer una experiencia más fluida. La segunda introduce más decisiones de arquitectura, pero puede ofrecer más flexibilidad, integración y gobierno cuando el número de agentes crece.
No es una diferencia entre una tecnología buena y otra mala. Es una diferencia entre integración y composición.
La respuesta honesta a la pregunta de partida
La intuición inicial es parcialmente correcta.
Sí: si una empresa ya utiliza Microsoft 365, Azure, Entra, Power Platform y sus herramientas de seguridad y cumplimiento, Microsoft parte con una ventaja importante. Buena parte de la identidad, los datos, los permisos y el gobierno necesarios para los agentes ya existen.
También es cierto que Google o Anthropic pueden ofrecer una experiencia individual más fluida porque concentran más decisiones dentro del propio entorno agéntico.
Pero sería incorrecto concluir que eso significa que Microsoft “no tiene harness” o que tecnológicamente está por detrás. El problema es distinto: Microsoft distribuye más capacidades entre varias capas de su plataforma, mientras que otros proveedores concentran más de ellas dentro de una experiencia integrada.
Y OpenAI adopta una posición intermedia: permite empezar con una experiencia bastante gestionada y aumentar progresivamente el control cuando el proyecto lo necesita.
La conclusión, por tanto, no es que un enfoque sea mejor que otro.
La decisión real es dónde quiere pagar la complejidad: antes, integrando piezas y diseñando la arquitectura; o después, aceptando más dependencia de una experiencia integrada del proveedor.
Eso enlaza muchísimo mejor con todo lo anterior y, sobre todo, se entiende sin necesidad de descifrar frases como “quién decide cuándo cambian” o “la costura está en otro sitio”, que suenan profundas pero obligan al lector a hacer arqueología semántica.
Qué se puede llevar de un harness a otro
Esta es la pregunta que hace un CIO en el minuto tres de la reunión, y la respuesta honesta es incómoda: se puede llevar poco, y lo que se lleva es lo menos valioso.
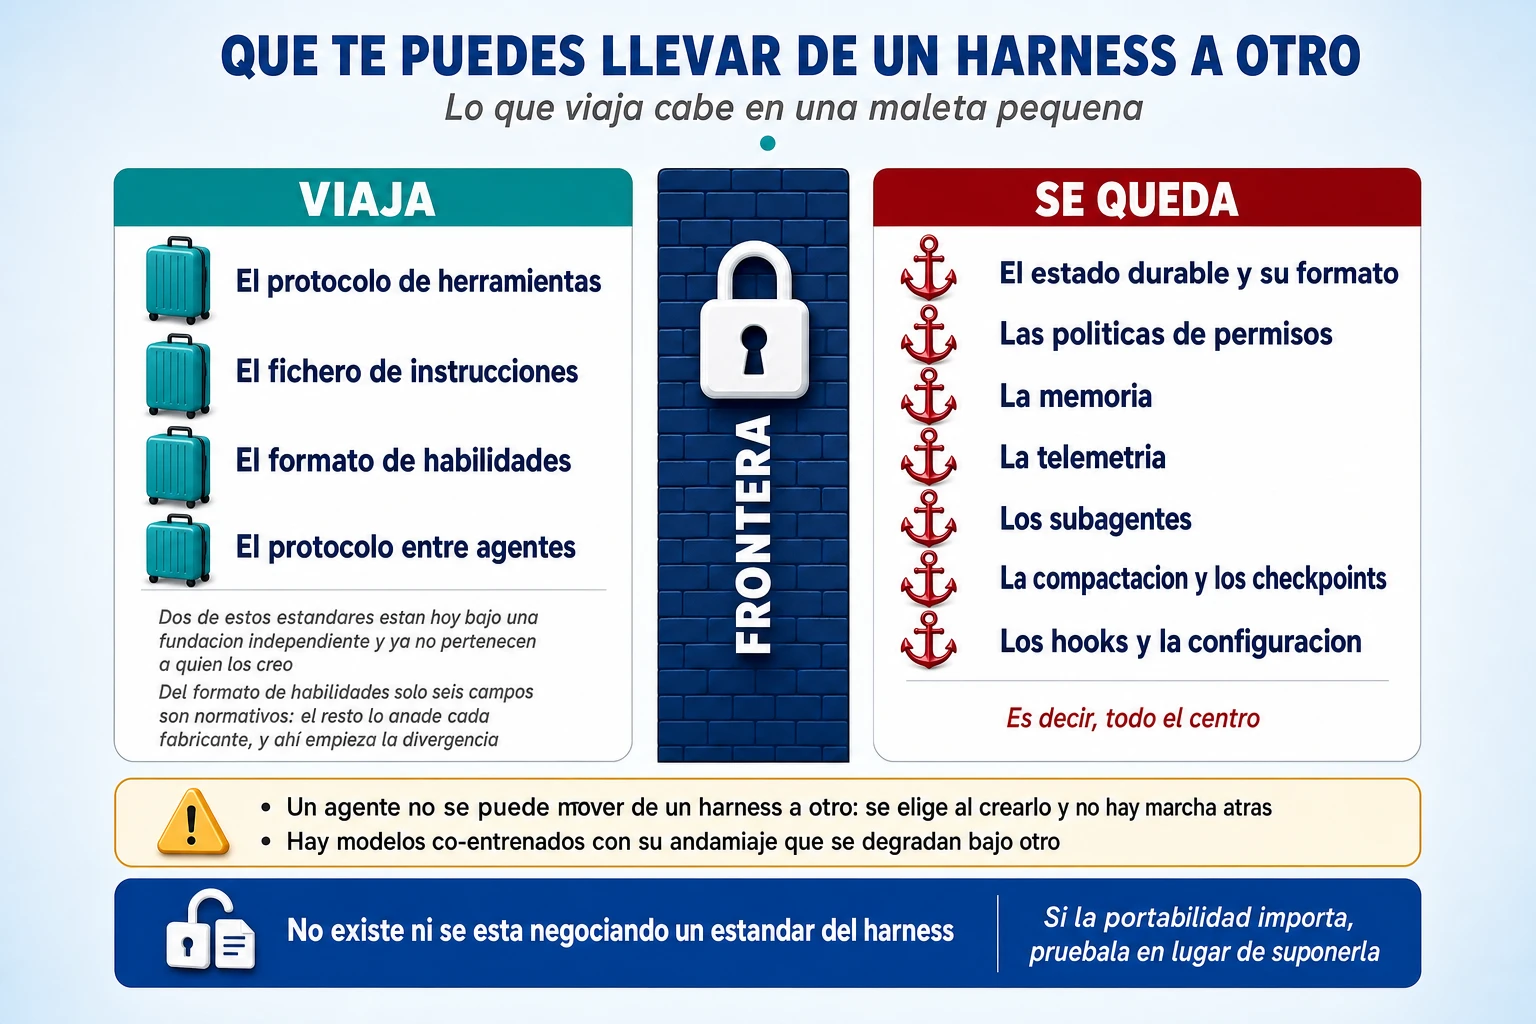
Lo portable, y el estado real de cada estándar
El protocolo de herramientas. Es el caso más sólido. Creado por Anthropic en noviembre de 2024, y desde el 9 de diciembre de 2025 es proyecto fundacional de una fundación de IA agéntica dentro de la Linux Foundation; su gobierno es formal, con mantenedores a título individual y sin asientos reservados por empresa, un proceso de propuestas de mejora y una política que mantiene doce meses una funcionalidad marcada como obsoleta antes de poder retirarla. La versión vigente de la especificación es de julio de 2026. Está soportado por los cuatro grandes y por cientos de integraciones. Con un matiz que hay que dar: portar el acceso a la herramienta no porta el comportamiento. El mismo servidor conectado a dos harnesses se cargará en contexto de forma distinta, consumirá tokens distintos y se someterá a políticas de permiso distintas.
El fichero de instrucciones. Es hoy el estándar de facto más ampliamente adoptado, y es portable justamente porque es el menos ambicioso: un fichero de texto, sin semántica ejecutable, que no define permisos, ni herramientas, ni estado. Surgió en agosto de 2025 de una colaboración entre varias herramientas del sector, está tutelado por la misma fundación, y según su propia web lo usan más de 60.000 proyectos abiertos (cifra de la web del formato, basada en búsqueda de código). Los cuatro grandes lo leen.
El formato de habilidades. Un directorio con un fichero descriptor, más recursos opcionales, con divulgación progresiva y presupuestos de tokens explícitos. Y aquí está el matiz que decide la portabilidad real: solo seis campos del descriptor son normativos —nombre, descripción, licencia, compatibilidad, metadatos y una lista de herramientas permitidas que además está marcada como experimental—. Cada fabricante ha añadido los suyos, y ahí empieza la divergencia: una habilidad que use campos no normativos para controlar la invocación o el aislamiento no es portable; una que se limite a los seis, sí. Segundo matiz: este formato no está en la fundación; vive en su propia organización abierta con su propio sitio. Es abierto, pero su gobierno no es fundacional.
El protocolo entre agentes. Donado por Google a la Linux Foundation en junio de 2025, con un comité técnico en el que están ocho grandes de la industria, incluidos dos hiperescalares competidores. Estandariza el descubrimiento de agentes, la delegación de tareas y el intercambio de información sin que los agentes compartan memoria, herramientas ni lógica interna. Y esa última frase es la clave: estandariza la conversación entre agentes, no el motor. Dos agentes con harnesses radicalmente distintos pueden hablarlo, y eso no hace portable ni uno solo de sus componentes internos.
Lo que no es portable, y es casi todo lo demás
Nada de lo que viene ahora tiene un estándar, y tampoco hay ningún proyecto que aspire a crearlo: el estado durable y su formato, las políticas de permisos, la memoria, la telemetría, los subagentes, la compactación, los puntos de control, los puntos de intercepción y la configuración. Es decir, todo el centro.
Los detalles concretos, contrastando las dos implementaciones mejor documentadas: las trayectorias se guardan en formatos propietarios distintos; los subagentes se declaran en dos lenguajes de configuración incompatibles; los modos de permiso son seis en un caso y una combinación de modos de sandbox más política de aprobación en el otro; los ficheros de ajustes tienen nombres, sintaxis y capas distintas; y los mecanismos de compactación y de punto de control no tienen equivalencia. La formulación que mejor lo resume: lo portable son los sustantivos —qué herramientas hay, qué dice el proyecto, qué sabe hacer una habilidad—; lo que no es portable son los verbos —cómo se decide, cómo se aprueba, cómo se recuerda, cómo se reanuda, cómo se audita—. Cambiar de harness es reescribir los verbos.
El ejemplo más concreto y menos teórico de dependencia a nivel de harness lo pone Microsoft sin querer: en su herramienta de construcción de agentes de negocio, un agente no se puede transferir de un harness a otro. Se elige al crearlo y no hay marcha atrás, y además uno de los dos no permite configurar el comportamiento de orquestación. Eso no es un lock-in de proveedor: es un lock-in dentro del mismo proveedor, entre dos de sus propios productos.
La dependencia nueva que nadie está contando
Ya hemos dado los dos hechos por separado: un fabricante afirma que su harness está co-entrenado con sus modelos, y hay evidencia académica de que los modelos afinados bajo un andamiaje concreto se degradan sustancialmente al desplegarse bajo otro. Juntos describen un mecanismo que no aparece en ningún contrato y que nadie está midiendo: la dependencia no está en el modelo ni en el harness, está en el par. Un preprint de 2026 lo formula en términos de compra con precisión inusual: «el nombre del modelo por sí solo es una unidad de comparación incompleta; los pares harness-modelo determinan el coste real, la latencia y la carga de supervisión».
El consejo práctico es tan aburrido como inevitable: si la portabilidad le importa, pruébela en lugar de suponerla. Tome tres tareas representativas, ejecútelas ocho veces en el harness de origen y ocho en el de destino, y mida la consistencia y los tokens por tarea terminada en los dos. No la tasa de acierto en un intento: la consistencia. Porque lo que va a cambiar al mover no es tanto si acierta, sino cuántas veces de ocho y a qué precio.
Y el dato que cierra la sección
No existe ni se está negociando un estándar del harness. La fundación que alberga los estándares de esta industria tiene seis proyectos: dos protocolos de interconexión, dos pasarelas, un formato de fichero de instrucciones y una implementación concreta de agente. Ninguno de los seis es una especificación del bucle, del formato de sesión, del modelo de permisos o del formato de trayectoria. Hay una segunda iniciativa, también bajo la misma fundación paraguas y distinta de la primera, con un componente de ejecución segura que es lo más cercano que hemos encontrado a «un estándar de cómo se ejecuta un agente de forma segura», pero es una implementación abierta, no una especificación que otros harnesses adopten.
Esa asimetría no es accidental. La industria ha estandarizado los bordes del agente —cómo llega a las herramientas, cómo habla con otros agentes, qué lee como instrucciones, qué sabe hacer— y ha dejado sin estandarizar el centro —el bucle, el estado, la política y la traza—. Los bordes son donde la interoperabilidad crea mercado para todos; el centro es donde cada proveedor compite. Es también, exactamente, donde vive la dependencia. Y no aparece en ningún contrato con su nombre.
| Elemento | ¿Portable? | Qué se rompe al mover | Qué hacer |
| Herramientas y su protocolo | Sí, con gobierno fundacional desde diciembre de 2025 | Nada del acceso; sí cambia cómo se cargan en contexto, cuánto consumen y qué política las filtra | Reservar tiempo para recalibrar el catálogo y la carga bajo demanda |
| Fichero de instrucciones | Sí. Es el más portable porque es el menos ambicioso | Las reglas de precedencia y los límites de tamaño varían entre harnesses | Mantenerlo como índice, no como enciclopedia; así viaja mejor |
| Habilidades | Parcialmente: solo seis campos del descriptor son normativos | Todo lo que use campos propios de un fabricante: invocación, aislamiento, rutas condicionales | Escribirlas contra los seis campos normativos si la portabilidad importa |
| Protocolo entre agentes | Sí, con comité técnico de ocho compañías | Nada de la conversación. No hace portable ningún componente interno | No confundir interoperabilidad entre agentes con portabilidad de harness |
| Estado durable y su formato | No | Todo. No hay forma de importar sesiones en curso | Planificar una migración con corte, no una convivencia |
| Políticas de permisos | No | La granularidad, los modos y la precedencia. Hay que reconstruir la matriz entera | Documentar la política en lenguaje de negocio, no en la sintaxis del fabricante |
| Memoria | No, salvo lo que esté en el fichero de instrucciones | Todo lo que el agente haya aprendido por su cuenta | Externalizar la memoria valiosa a un almacén propio desde el día uno |
| Telemetría y trayectorias | No. Las convenciones siguen en desarrollo | Los cuadros de mando y la comparabilidad histórica de sus auditorías | No prometer series históricas comparables antes y después del cambio |
| Subagentes, compactación, puntos de control e intercepciones | No | Cada uno tiene formato, nombres y semántica propios | Tratarlos como código específico del harness y presupuestar su reescritura |
Seis preguntas para elegir
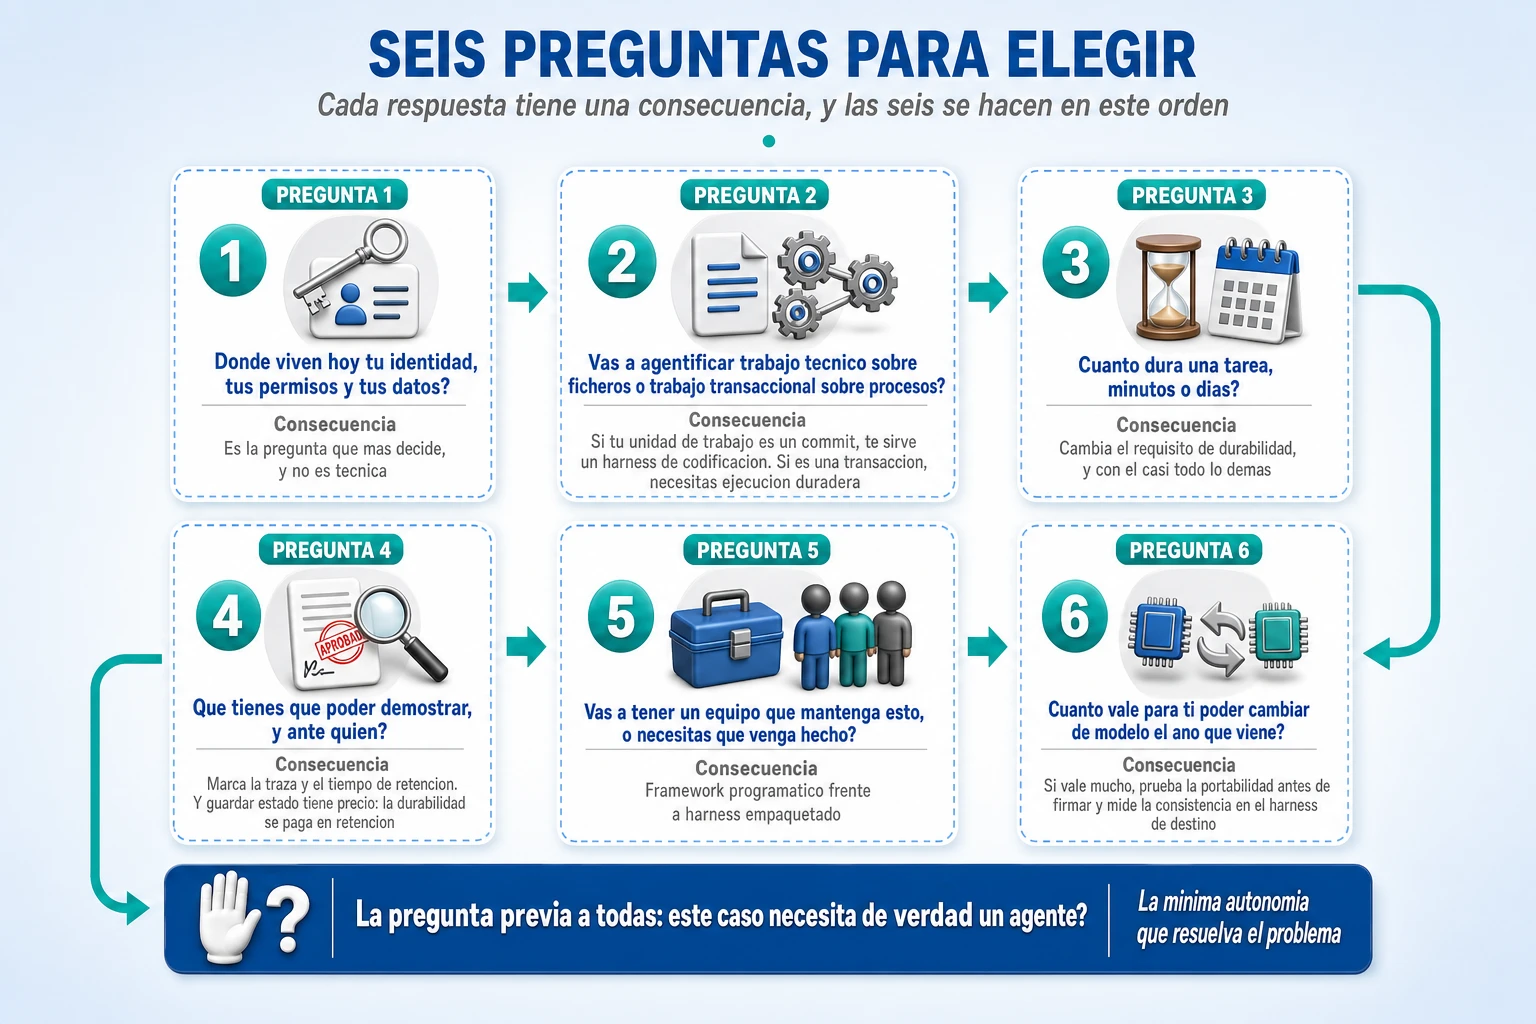
Uno. ¿Dónde viven hoy su identidad, sus permisos y sus datos? Es la pregunta que más decide y no es técnica. Si su directorio corporativo, su clasificación de datos y su herramienta de cumplimiento están en un ecosistema, el harness que se integre con ese ecosistema le ahorra la mitad del proyecto. La consecuencia práctica: la elección de harness suele estar tomada antes de que empiece la evaluación técnica, y fingir lo contrario alarga el proceso sin cambiar el resultado. Lo que sí puede cambiar es que lo sepa desde el principio y negocie en consecuencia.
Dos. ¿Qué tipo de trabajo va a agentificar? Hay una frontera muy limpia que sale de toda esta investigación y que conviene adoptar: si su unidad de trabajo es un commit, le sirve un harness de codificación; si su unidad de trabajo es una transacción, necesita ejecución duradera. El motivo es mecánico y cabe en una frase: las acciones que afectan a sistemas remotos —una base de datos, una API de terceros, un despliegue— no se pueden deshacer con un punto de control. Por eso el mundo del código puede vivir con «vuelve atrás y repite» y el mundo del proceso de negocio no. Consecuencia: si le están ofreciendo un harness de programación para automatizar altas de cliente, la pieza que falta no es una integración, es una capa entera.
Tres. ¿Cuánto dura una tarea? Minutos o días cambia el requisito de durabilidad, y con él casi todo lo demás. Cuatro señales, y con dos afirmativas la durabilidad es una capa aparte y no una opción de configuración: la tarea dura más que un proceso; espera a una persona durante horas o días; tiene que sobrevivir a un despliegue de su propia aplicación; y necesita garantía de que una acción con efectos se ejecuta exactamente una vez. Consecuencia: si responde sí a dos, el harness es solo la mitad de su arquitectura.
Cuatro. ¿Qué tiene que poder demostrar, y ante quién? No es la misma respuesta si el destinatario es un auditor interno, un regulador sectorial o un cliente que reclama. Reconstruir por qué el agente hizo algo exige la trayectoria completa, no el resultado; y como no hay estándar de trayectoria, esa evidencia queda atada al harness que la generó. Consecuencia: si su obligación de conservar evidencia es de cinco años, acaba de añadir un criterio de selección que no estaba en su lista, y es el que va a doler más si se equivoca.
Cinco. ¿Va a tener un equipo que mantenga esto, o necesita que venga hecho? Es la pregunta que separa «adoptar un harness empaquetado» de «ensamblar uno». Con un equipo pequeño y sin perfil de infraestructura, cada pieza que haya que elegir es una pieza que se va a quedar a medias, y el ensamblaje de once servicios del ejemplo anterior es la advertencia. Con un equipo capaz, ensamblar da control real y la posibilidad de apuntar el harness a su propia plataforma —algo que está documentado y se hace en una línea de configuración—. Consecuencia: la respuesta a esta pregunta determina más el éxito del proyecto que la elección de fabricante.
Seis. ¿Cuánto vale para usted poder cambiar de modelo el año que viene? Si la respuesta es «mucho», hay dos consecuencias inmediatas: elija un harness que admita modelos de varios proveedores —y compruebe que los admite en su plan, no solo en el plan de consumo—, y escriba sus habilidades y sus ficheros de instrucciones contra los campos normativos de los formatos abiertos, no contra las extensiones de nadie. Si la respuesta es «poco», reconózcalo y aproveche la integración vertical, que es real y aporta. Lo que no funciona es querer las dos cosas: se paga el precio de la portabilidad sin usarla.
| Perfil de organización | Qué priorizar | Qué comprobar antes de firmar |
| Suite corporativa consolidada, casos transaccionales, equipo de TI pero no de plataforma | Integración con la identidad y el gobierno que ya tiene; harness empaquetado; flujos deterministas como herramientas del agente | Qué está en versión previa de lo que le están vendiendo; si el harness elegido es reversible; cómo se factura el consumo y con qué tope duro por agente |
| Trabajo técnico sobre código, equipo de ingeniería fuerte | Un harness empaquetado con aislamiento, puntos de control y permisos por acción; verificación mecánica como bucle de cierre | Qué no cubre el punto de control; si hay modo desnudo reproducible para integración continua; límites de turnos y de gasto por defecto |
| Procesos de negocio largos con aprobaciones humanas | Ejecución duradera por debajo, con idempotencia y espera sin cómputo; el harness por encima | Que las acciones con efectos externos sean idempotentes; que la espera de días no consuma recursos; qué ocurre al agotarse la capacidad |
| Entorno regulado con retención restringida | Librería en su propio proceso o sandbox en su infraestructura; traza exportable; política en capas no sobreescribibles | Elegibilidad para su régimen de retención; si las claves propias cubren la telemetría; cuánto tiempo se guarda la trayectoria y en qué formato |
| Multi-nube o con exigencia de cambiar de modelo | Harness con catálogo amplio de modelos y formatos abiertos sin extensiones propietarias | Que los modelos de terceros estén en su plan; medir la consistencia en el harness de destino antes de decidir |
Y la advertencia que va antes que las seis: la pregunta previa a todas es si el caso necesita un agente. Es la regla de la mínima autonomía que defendimos en el artículo de arquitectura agéntica: el nivel de autonomía más bajo que resuelve el problema es el correcto. Si un formulario con validaciones resuelve el caso, un agente con harness, permisos y estado durable es una forma carísima de tener el mismo resultado con más riesgo.
Doce formas de romper un harness
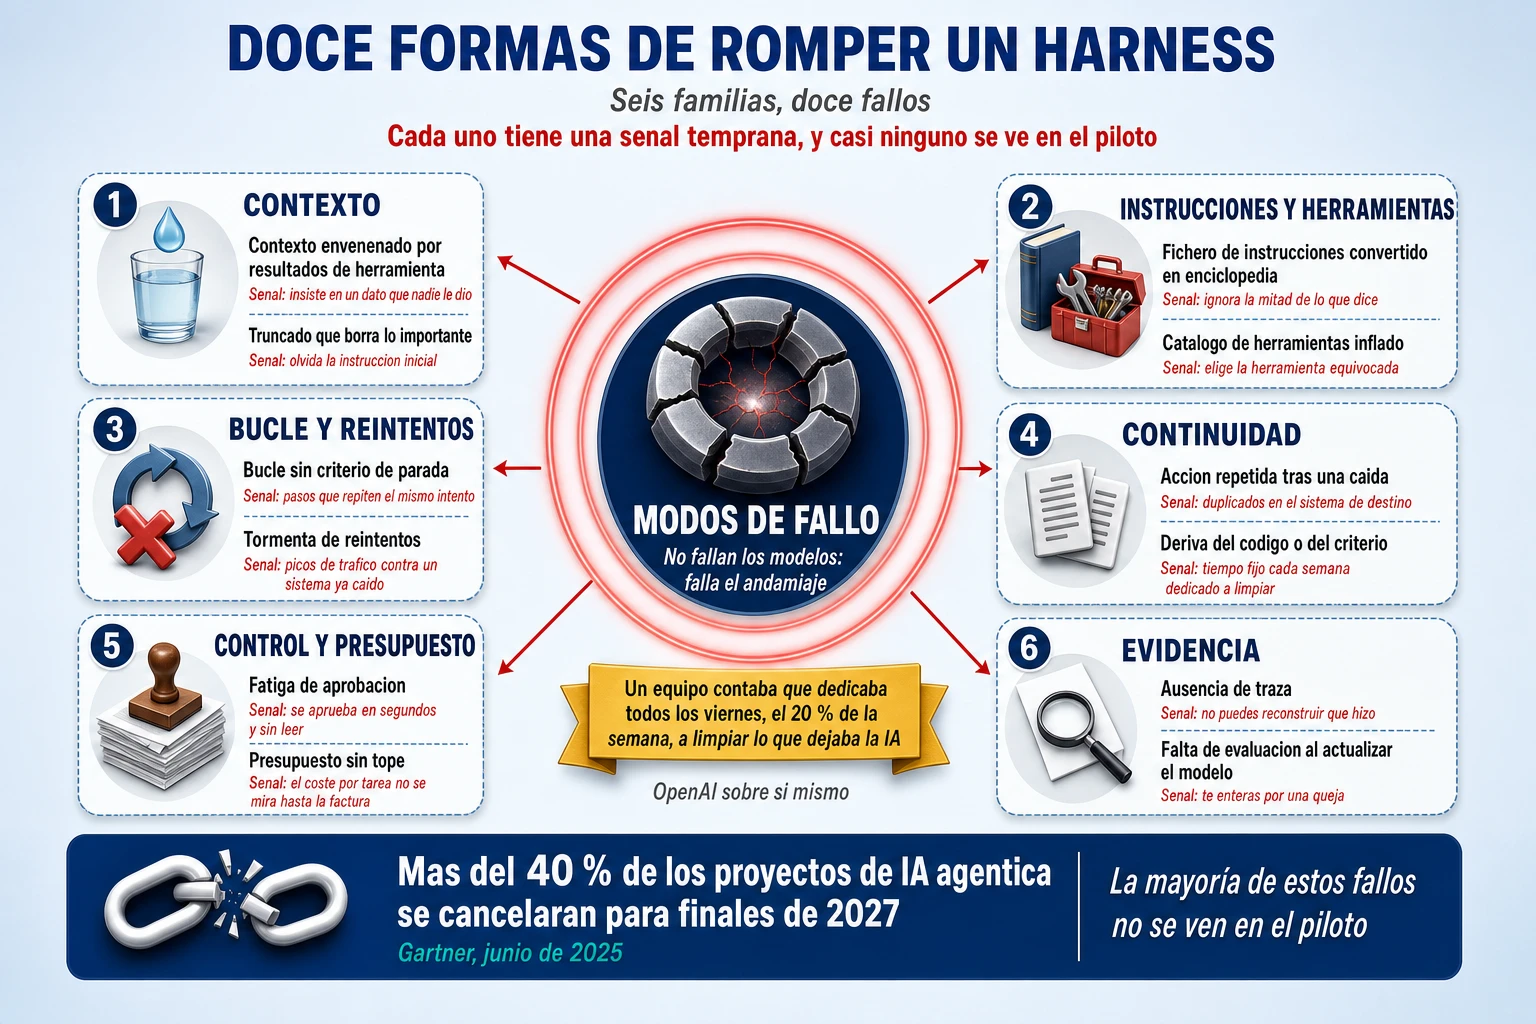
Gartner predijo en un comunicado del 25 de junio de 2025 que más del 40 % de los proyectos de IA agéntica se cancelarán para finales de 2027, por costes escalados, valor de negocio poco claro o controles de riesgo inadecuados. Es la cifra más limpia que existe sobre este asunto, con comunicado oficial y atribución inequívoca, y es mucho más útil que el «80 % de los pilotos que no llegan a producción» que circula sin fuente. Los tres motivos que da Gartner son, los tres, síntomas de la capa de la que habla este artículo. La mayoría de estos doce fallos no se ven en el piloto: el piloto es corto, está vigilado y se ejecuta sobre casos elegidos.
| Modo de fallo | Señal temprana | La pieza que falta |
| 1. Contexto envenenado por salidas de herramienta | Las respuestas empiezan a citar datos que nadie pidió, o siguen instrucciones que estaban dentro de un documento leído | Filtrado de salidas de herramienta y aislamiento del contenido no confiable |
| 2. Truncado que borra lo importante | A partir de cierta longitud, el agente olvida la restricción que se le dio al principio | Compactación en lugar de truncado, y reglas persistentes en el fichero de instrucciones, no en el prompt |
| 3. Deriva del código o del criterio | El trabajo nuevo replica los defectos del trabajo viejo, cada vez más | Invariantes verificados mecánicamente y tareas de limpieza recurrentes |
| 4. Fichero de instrucciones convertido en enciclopedia | Se añaden reglas y el comportamiento no mejora; nadie sabe qué regla está viva | Índice de cien líneas más base de conocimiento versionada y verificada |
| 5. Catálogo de herramientas inflado | Elige mal de forma sistemática, y el contexto está medio lleno antes del primer paso | Carga bajo demanda: nombres al arrancar, definiciones cuando se necesitan |
| 6. Bucle sin criterio de parada | Ejecuciones que duran horas sin producir nada nuevo | Techo de turnos, tope de gasto y un verificador externo que decida si terminó |
| 7. Tormenta de reintentos | Un fallo puntual se convierte en una avalancha de peticiones al mismo sistema | Presupuesto de reintento global compartido entre los tres niveles, y señales de «no reintentes» |
| 8. Acción repetida tras una caída | Un cobro duplicado, un correo enviado dos veces, un registro creado dos veces | Idempotencia en toda acción con efectos, y diario con reanudación |
| 9. Fatiga de aprobación | Los revisores aprueban en menos de dos segundos y en lotes | Menos puertas, mejor puestas: irreversible, económico o hacia fuera |
| 10. Ausencia de traza | Alguien pregunta por qué el agente hizo algo la semana pasada y nadie lo sabe | Traza de trayectoria completa, fuera del contexto, con retención definida |
| 11. Falta de evaluación al actualizar el modelo | El rendimiento cae tras una actualización y nadie puede probar que antes era mejor | Un banco de tareas propio y medición de consistencia antes y después |
| 12. Presupuesto sin tope | La factura del mes sorprende, y no se puede atribuir a nadie | Tope duro por agente y por tarea, más atribución a agente, tarea y persona |
De los doce, el tercero merece un párrafo propio porque tiene el mejor síntoma documentado que hemos encontrado y es de quien más lejos ha llevado esto. El equipo de OpenAI que construyó un producto entero con agentes describe el mecanismo así: el agente «replica patrones que ya existen en el repositorio, incluso los irregulares o suboptimos. Con el tiempo, esto lleva inevitablemente a deriva». Y el síntoma:
Nuestro equipo se pasaba todos los viernes —el 20 % de la semana— limpiando la basura generada por la IA. Como era previsible, eso no escalaba.
Su solución no fue vigilar más ni escribir mejores prompts: fue codificar unos principios mecánicos en el propio repositorio y lanzar tareas de limpieza recurrentes en segundo plano que abren propuestas de refactorización dirigidas, revisables en menos de un minuto y fusionables automáticamente. Lo comparan con la recolección de basura de un lenguaje de programación: pagar la deuda de forma continua en lugar de a tirones. Es la mejor prueba de que la deriva no es un fallo del modelo, es una propiedad del sistema, y se combate con andamiaje.
Los otros dos que más daño hacen en empresas grandes son el octavo y el undécimo. El octavo porque es el único de los doce que puede acabar en una reclamación de un cliente: repetir una acción con efectos no es un fallo de calidad, es un incidente. Y el undécimo porque es invisible por construcción: si no tenía una medición antes de la actualización del modelo, no puede demostrar que el rendimiento ha caído, y la conversación se convierte en opiniones.
Por dónde empezar
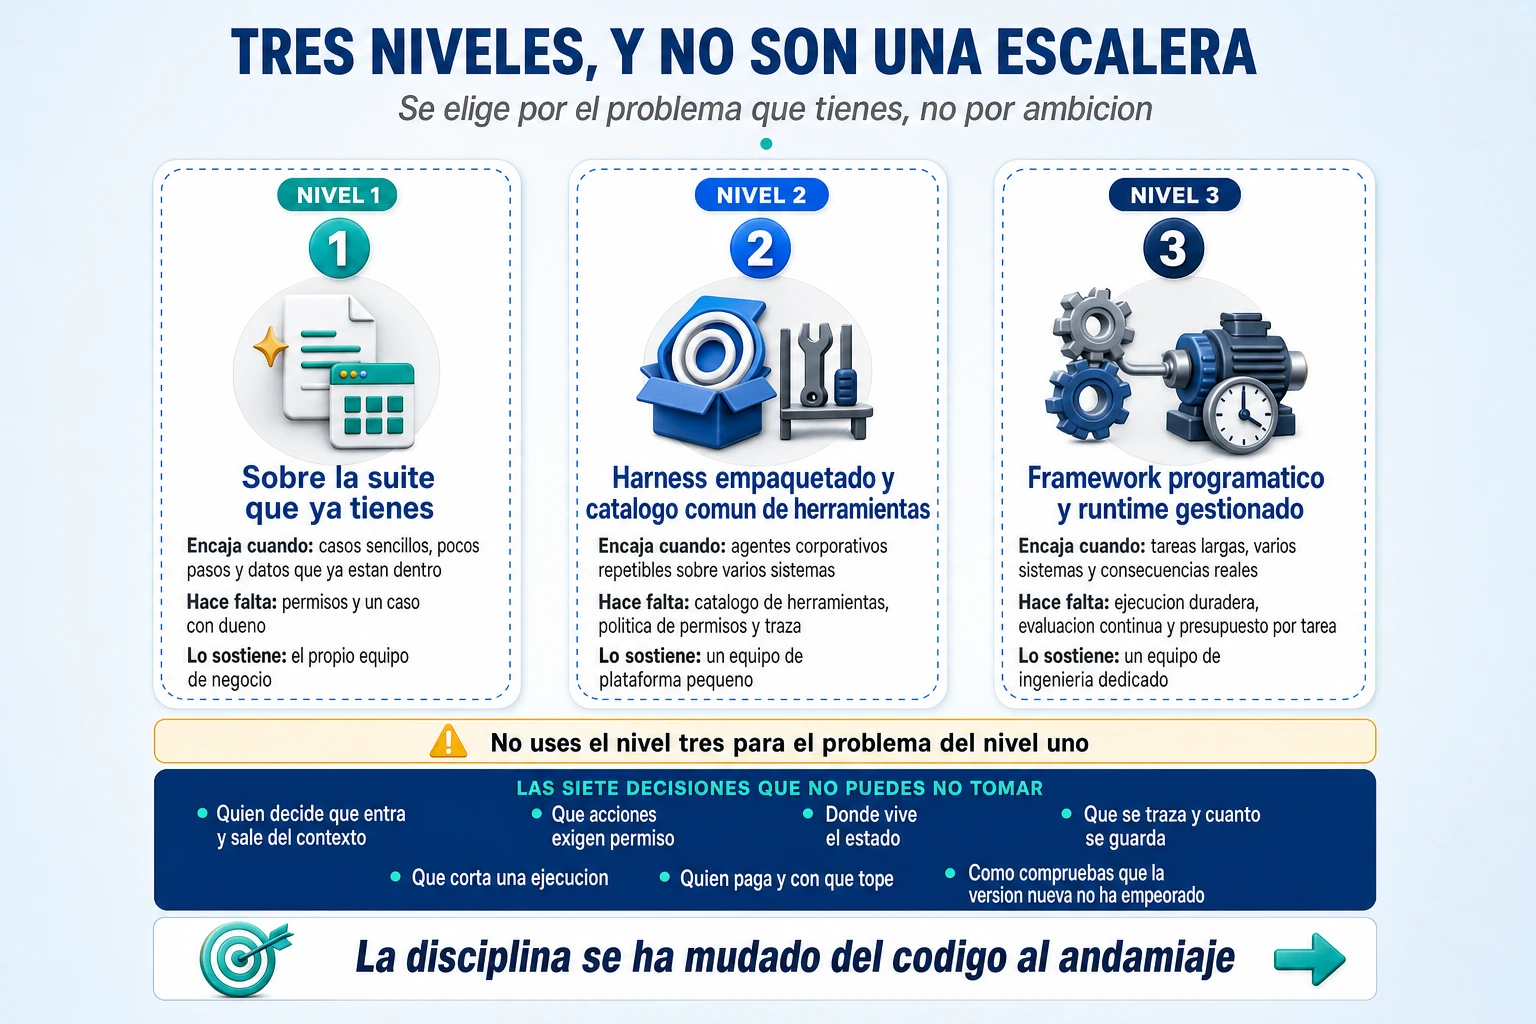
Tres niveles, y la regla de no confundirlos
Nivel uno: casos sencillos sobre la suite que ya tiene. Un asistente que responde con conocimiento corporativo, redacta un borrador o prepara un documento. Aquí el harness viene decidido, es el de su proveedor de suite, y eso es exactamente lo que quiere: no hay nada que ensamblar y el gobierno ya está puesto. Lo único que hay que vigilar es el consumo y quién puede publicar qué.
Nivel dos: agentes corporativos serios sobre un harness empaquetado y un catálogo común de herramientas. Aquí sí hay decisiones: cuál de los harness disponibles, qué herramientas se exponen y con qué permisos, dónde vive el estado, qué se traza. Es el nivel donde está la mayoría de los casos con retorno real, y es donde este artículo es más útil.
Nivel tres: agentes complejos con framework programático y runtime gestionado. Cuando el bucle tiene una estructura que ningún harness generalista cubre, cuando la traza y la política tienen que estar bajo control total por regulación, o cuando el caso es un proceso de negocio transaccional con compensaciones. Aquí se ensambla: framework, harness, motor de ejecución duradera y observabilidad.
Y la regla: no use el nivel tres para el problema del nivel uno. Es el error más caro que vemos, y no por el coste de la tecnología —que es lo de menos— sino por el coste de oportunidad: seis meses de arquitectura para un caso que se resolvía en dos semanas, y un equipo quemado que ya no tiene crédito interno para el caso de nivel dos que sí lo merecía. Si necesita un caso concreto para calibrar expectativas, hemos documentado cuatro despliegues de IA agéntica en grandes empresas y ninguno empezó por el nivel tres.
Las siete decisiones que no puede no tomar
Sea quien sea su proveedor y cualquiera de los tres niveles, hay siete decisiones que alguien va a tomar. La única elección real es si las toma usted a conciencia o las hereda del valor por defecto de un paquete.
- Quién decide qué entra y qué sale del contexto, y si queda registrado en algún sitio.
- Qué acciones exigen permiso humano y qué acciones se deniegan siempre, sin excepción y en todos los modos.
- Dónde vive el estado: en la memoria de un proceso, en disco, o en un almacén externo confirmado antes de cada paso.
- Qué se traza y cuánto tiempo se guarda, incluyendo si se registra el contenido de los mensajes o solo el hecho de que hubo una llamada.
- Qué corta una ejecución: techo de turnos, tope de gasto, patrón anómalo, o nada.
- Quién paga y con qué tope, atribuido a agente, tarea y persona.
- Cómo comprueba que la versión nueva no ha empeorado, cuando el modelo se actualice sin que usted lo pida.
Ninguna de las siete es una decisión de compra. Las siete son decisiones de diseño, y las siete se pueden tomar en una tarde con las personas adecuadas en la sala. Lo que no se puede es no tomarlas: el paquete las tiene tomadas por defecto, y esos valores por defecto están optimizados para que el producto funcione en una demo, no para que cumpla su política de riesgo.
El trabajo nuevo que aparece
El mejor relato en primera persona que existe sobre esto es de OpenAI, publicado en febrero de 2026. Un equipo se impuso una restricción: cero líneas de código escritas a mano —«cada línea de código, la lógica de la aplicación, los tests, la configuración de integración continua, la documentación, la observabilidad y las herramientas internas, la ha escrito el agente»—. Cinco meses después, del orden de un millón de líneas de código y unas 1.500 propuestas de cambio abiertas y fusionadas, con un equipo que empezó con tres ingenieros y creció a siete, y una productividad declarada de 3,5 propuestas por ingeniero y día. Estiman que lo construyeron en «una décima parte del tiempo» que habría llevado escribirlo a mano.
Todas esas cifras son del fabricante sobre su propio producto, sin contraste independiente, y la última es explícitamente una estimación: ellos escriben «estimamos». Lo que hace el relato valioso no son las cifras: es qué trabajo apareció. Porque al principio iban lentos, y su diagnóstico es preciso: «el progreso inicial fue más lento de lo que esperábamos, no porque el agente fuera incapaz, sino porque el entorno estaba subespecificado. Al agente le faltaban las herramientas, las abstracciones y la estructura interna necesarias para avanzar hacia objetivos de alto nivel. El trabajo principal de nuestro equipo de ingeniería pasó a ser habilitar a los agentes para que hicieran trabajo útil.»
Qué construyeron, y esta lista es la definición operativa de «harness» hecha por gente que lo estaba haciendo sin saber que estaba definiendo nada. Un entorno por tarea: hicieron la aplicación arrancable de forma independiente por cada rama de trabajo, para que el agente lanzara y manejara su propia instancia por cada cambio. Ojos: conectaron el protocolo de depuración del navegador al agente y le dieron habilidades para trabajar con capturas de pantalla y del árbol de la página, de modo que pudiera reproducir un error y validar su arreglo. Observabilidad legible por el agente: una pila local y efímera por rama, con registros, métricas y trazas que el propio agente consulta, lo que hace tratable una instrucción como «asegúrate de que el arranque del servicio tarda menos de 800 milisegundos».
Y su advertencia final, que es la más honesta de todo el material que hemos revisado: «este comportamiento depende mucho de la estructura concreta y de las herramientas de este repositorio, y no debe asumirse que se generalice sin una inversión parecida; al menos, no todavía». Añaden que tampoco saben cómo evoluciona la coherencia arquitectónica a lo largo de años en un sistema generado íntegramente por agentes.
Conclusión
El punto de partida era aparentemente sencillo: dos agentes con el mismo modelo pueden comportarse de forma muy distinta. Después de recorrer el problema completo, la explicación también resulta bastante clara: el modelo aporta capacidad, pero el harness determina cómo se convierte esa capacidad en trabajo real. Decide qué contexto recibe el modelo, qué herramientas puede utilizar, cuándo necesita aprobación, qué ocurre si una ejecución falla, cuánto tiempo puede seguir intentando una tarea y qué queda registrado después. Por eso cambiar el harness puede alterar el rendimiento, pero sobre todo puede cambiar de forma radical el coste, la fiabilidad y la capacidad de controlar lo que hace el agente.
Eso no significa que exista un harness “mejor” en términos absolutos. Anthropic, Google, Microsoft y OpenAI han acabado incorporando prácticamente la misma anatomía básica, pero la empaquetan de forma distinta. Anthropic concentra muchas decisiones dentro de una experiencia muy integrada alrededor de Claude; Google intenta mantener un motor agéntico coherente a través de distintas superficies; Microsoft distribuye las capacidades entre una plataforma empresarial más modular y gobernable; y OpenAI permite elegir cuánto del runtime se consume gestionado y cuánto queda bajo control del cliente. La diferencia importante no está solo en qué funcionalidades existen, sino en dónde coloca cada proveedor la complejidad.
Por eso tampoco hay que confundir harness con plataforma. El harness consigue que el agente trabaje; la plataforma corporativa consigue que pueda hacerlo bajo las reglas de una organización. Identidad, seguridad, redes, gobierno del dato, auditoría o control presupuestario no sustituyen al harness, pero condicionan completamente lo fácil que será llevarlo desde un prototipo hasta producción. Ésa es también la razón por la que una experiencia individual puede sentirse extraordinariamente fluida y la versión empresarial parecer mucho más fragmentada: en la segunda estamos viendo piezas que en la primera permanecían ocultas.
La consecuencia práctica es que elegir tecnología agéntica comparando únicamente modelos o listas de funcionalidades es cada vez menos útil. Hay preguntas bastante mejores: ¿quién controla el contexto?, ¿quién decide los permisos?, ¿cómo se recupera una ejecución?, ¿cómo se verifica que la tarea realmente terminó?, ¿qué parte del estado es portable?, ¿qué ocurre cuando tenemos cien agentes en lugar de uno? Esas preguntas dicen mucho más sobre el comportamiento futuro de la plataforma que unos puntos adicionales en un benchmark.
Un buen harness no convierte mágicamente un modelo mediocre en uno excelente. Lo que hace es evitar que un buen modelo trabaje con mala memoria, herramientas mal expuestas, permisos inadecuados, bucles sin control o costes que nadie sabe explicar.
Y esa es probablemente la conclusión más útil de todo el análisis: la ventaja ya no está únicamente en tener acceso al mejor modelo, porque los modelos cambian constantemente y las diferencias entre ellos se reducen o se invierten según el entorno de ejecución. La ventaja está en construir una capa estable alrededor de ellos que permita cambiar de modelo sin perder control, conocimiento operativo ni capacidad de gobierno.
Para una empresa, por tanto, la pregunta final no debería ser “¿qué proveedor tiene el mejor harness?”, sino algo bastante más incómodo y bastante más importante:
¿qué parte de la inteligencia operativa de nuestros agentes queremos que controle el proveedor y qué parte queremos conservar nosotros?
Ahí está la decisión estratégica. El modelo puede cambiar el trimestre que viene. El harness, las integraciones, las políticas y la forma de gobernar los agentes son lo que probablemente seguirá con usted bastante más tiempo.
En Transformalix ayudamos a abrir esa capa y ponerle nombre a lo que hay dentro: quién decide qué entra y qué sale del contexto de sus agentes, qué acciones tienen permiso y qué acciones se deniegan siempre, dónde vive el estado cuando una ejecución se cae a los cuarenta minutos, qué se traza y durante cuánto tiempo, qué corta un bucle desbocado antes de que llegue la factura, y cómo comprobar que la próxima actualización del modelo no ha empeorado nada. Si en su organización hay un piloto de agentes que funcionó en la demo y no acaba de pasar a producción, o una factura de tokens que nadie sabe atribuir, hablemos.