Una compañía decide lanzar un servicio nuevo: que una pequeña empresa pueda contratar desde el portal un servicio de ciberseguridad y que quede activo sin que intervenga nadie. La idea es sencilla de explicar, el valor está claro y nadie se opone.
Para que eso ocurra tienen que moverse: producto, que define qué se vende y a quién; comercial, que decide cómo se ofrece; arquitectura, que dice por dónde pasa; el equipo del portal, que construye la pantalla; el de CRM, que registra el pedido; el de facturación, que activa la tarifa; la plataforma de seguridad, que da de alta al cliente; operaciones, que tendrá que sostenerlo; atención al cliente, que recibirá las llamadas cuando falle; y seguridad y legal, que revisan condiciones y datos.
Diez áreas. Y aquí está el dato que ordena todo lo que viene después: el problema de este lanzamiento no es programar. Programar es una parte pequeña. El problema es que diez áreas trabajen sobre la misma idea sin que la información se pierda por el camino.
Pongámosle números. Desde que alguien escribe la petición por primera vez hasta que el primer cliente contrata pasan catorce semanas, que son setenta días laborables. Si después se reconstruye qué ocurrió cada uno de esos días, el reparto sorprende a todo el mundo menos a quien lo ha vivido: hubo nueve días de trabajo efectivo y sesenta y uno de espera.
Esperó doce días a entrar en un comité que prioriza cada quince. Nueve a que alguien de arquitectura lo mirase. Siete a que negocio aclarase qué pasa si el cliente ya tiene un servicio contratado, una pregunta que nadie se había hecho al escribir la petición. Diez a que facturación tuviera hueco. Ocho a un entorno de pruebas con datos representativos. Seis a la revisión de seguridad. Y nueve a la ventana de despliegue del mes siguiente.
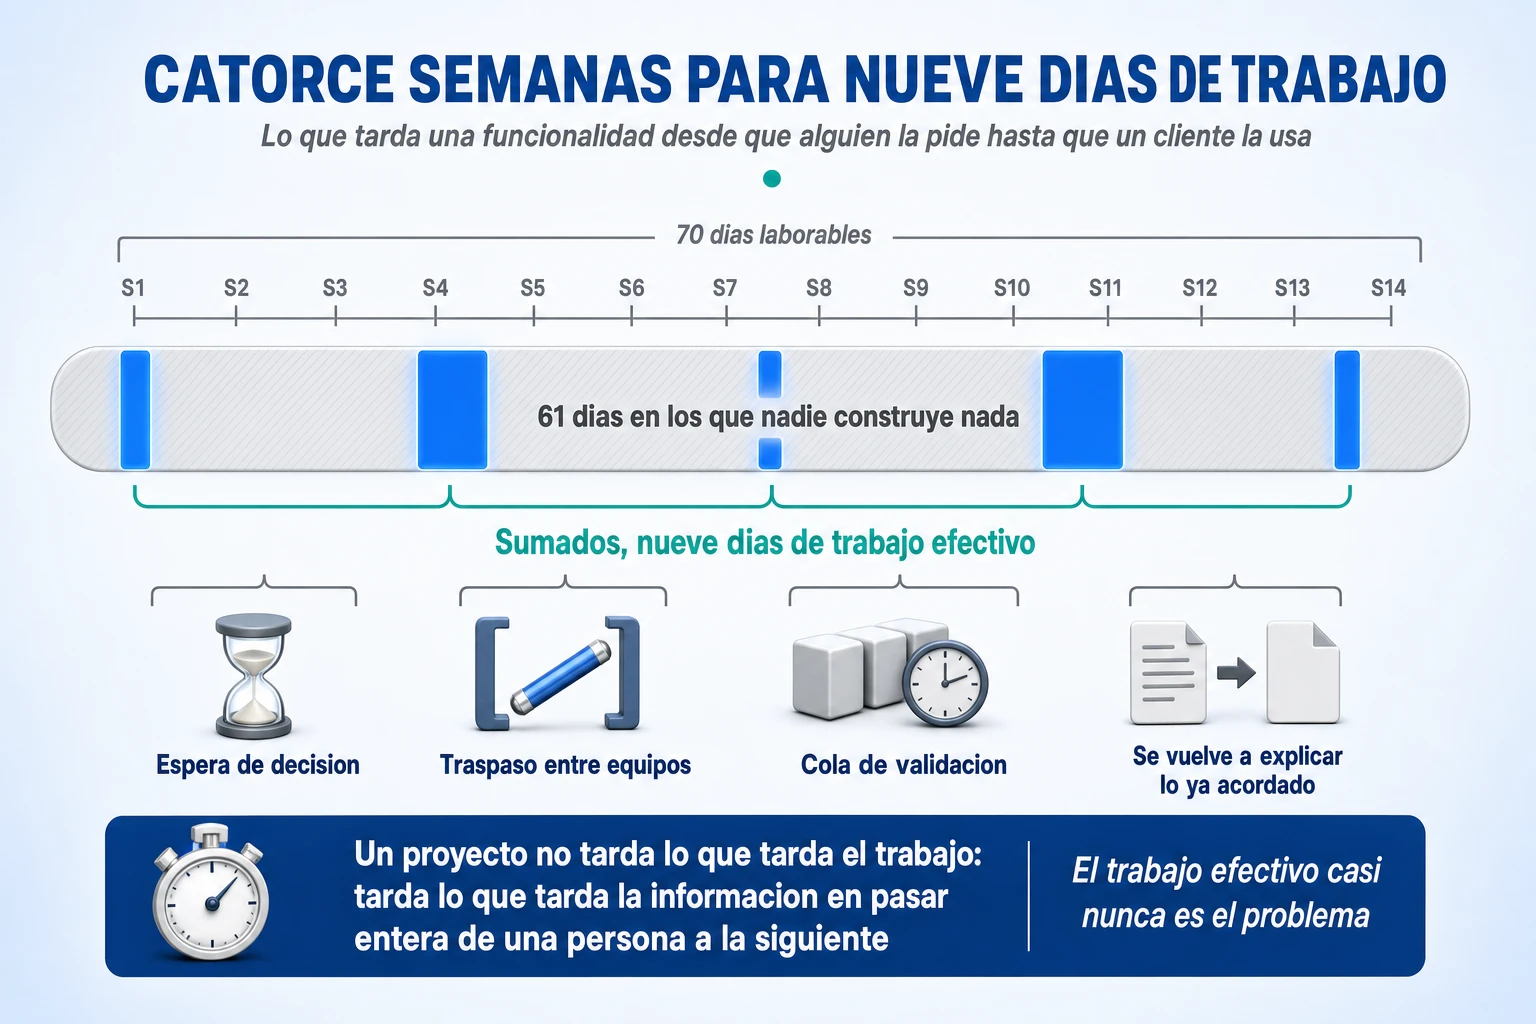
Esa aritmética conviene tenerla delante antes de decidir nada, porque desmonta la intuición más extendida. Si se introduce una herramienta de inteligencia artificial que permite escribir el código en la mitad de tiempo, los cuatro días de construcción se convierten en dos y el plazo total pasa de catorce semanas a trece y media. Es una mejora real, es medible y el cliente no la nota.
De ahí sale la tesis de este artículo: acelerar el desarrollo de un servicio no consiste en que cada equipo trabaje más deprisa, sino en que todas las áreas trabajen sobre el mismo contexto sin tener que reconstruirlo en cada traspaso. Cada una de esas siete esperas es un punto donde alguien tuvo que rehacer un contexto que otra persona ya tenía.
Este artículo explica cómo se monta ese sistema, y lo hace en tres niveles. Primero el conceptual: las seis funciones que cualquier organización tiene que cubrir, que son las mismas en una operadora de treinta mil personas y en una empresa de ochenta aunque las implementen con productos distintos. Después el operativo: qué hace exactamente el equipo en una semana normal, quién puede meter trabajo, cómo se gestionan las dependencias y cuándo algo está terminado de verdad. Y por último el concreto: qué objeto se crea en cada herramienta, con qué se enlaza y qué evento provoca el salto a la siguiente, con el entorno de Microsoft que ya tiene casi todo el mundo y con la inteligencia artificial en su sitio, que no es una capa indistinta sino tres ámbitos muy distintos.
Vamos a seguir el mismo ejemplo de principio a fin. Cuando lleguemos al final, el servicio de ciberseguridad estará en producción y usted debería poder explicar el montaje entero en cinco minutos. Ese es el objetivo, y hay un párrafo al final pensado literalmente para eso.
Las seis funciones que hay que cubrir, y por qué no dependen de las marcas
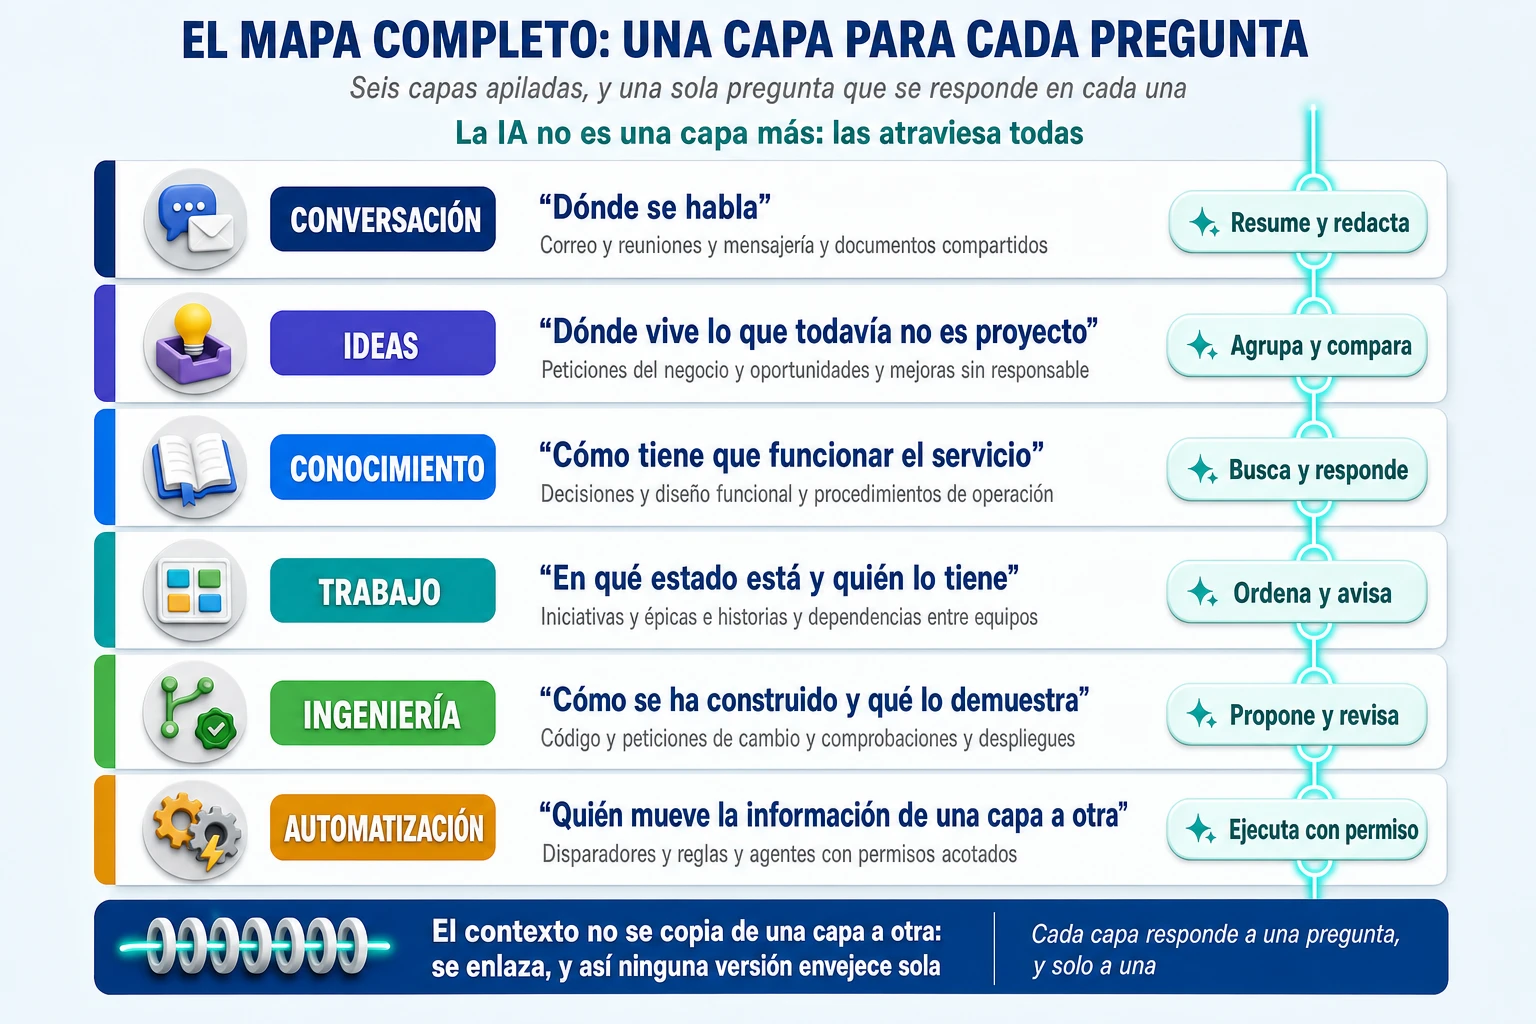
Antes de nombrar ninguna herramienta conviene fijar qué hace falta, porque de lo contrario esto se convierte en una discusión de catálogo. Para que una iniciativa atraviese diez áreas sin perder el contexto hay que cubrir seis funciones, y cada una responde una pregunta que las demás no responden. No son seis productos: son seis preguntas.
| Función | La pregunta que responde | Lo que NO es |
| Conversación | ¿Qué estamos hablando ahora? | No es la memoria de nada |
| Ideas | ¿Merece la pena hacer esto? | No es el trabajo comprometido |
| Conocimiento | ¿Cómo tiene que funcionar el servicio y por qué? | No es un archivo ni un gestor de tareas |
| Trabajo | ¿Qué hay que hacer, quién lo tiene y en qué estado está? | No es el repositorio del conocimiento |
| Ingeniería | ¿Cómo se ha construido y qué demuestra que funciona? | No interviene en el trabajo que no es software |
| Automatización | ¿Quién mueve la información de una función a otra? | No es una herramienta, es plomería |
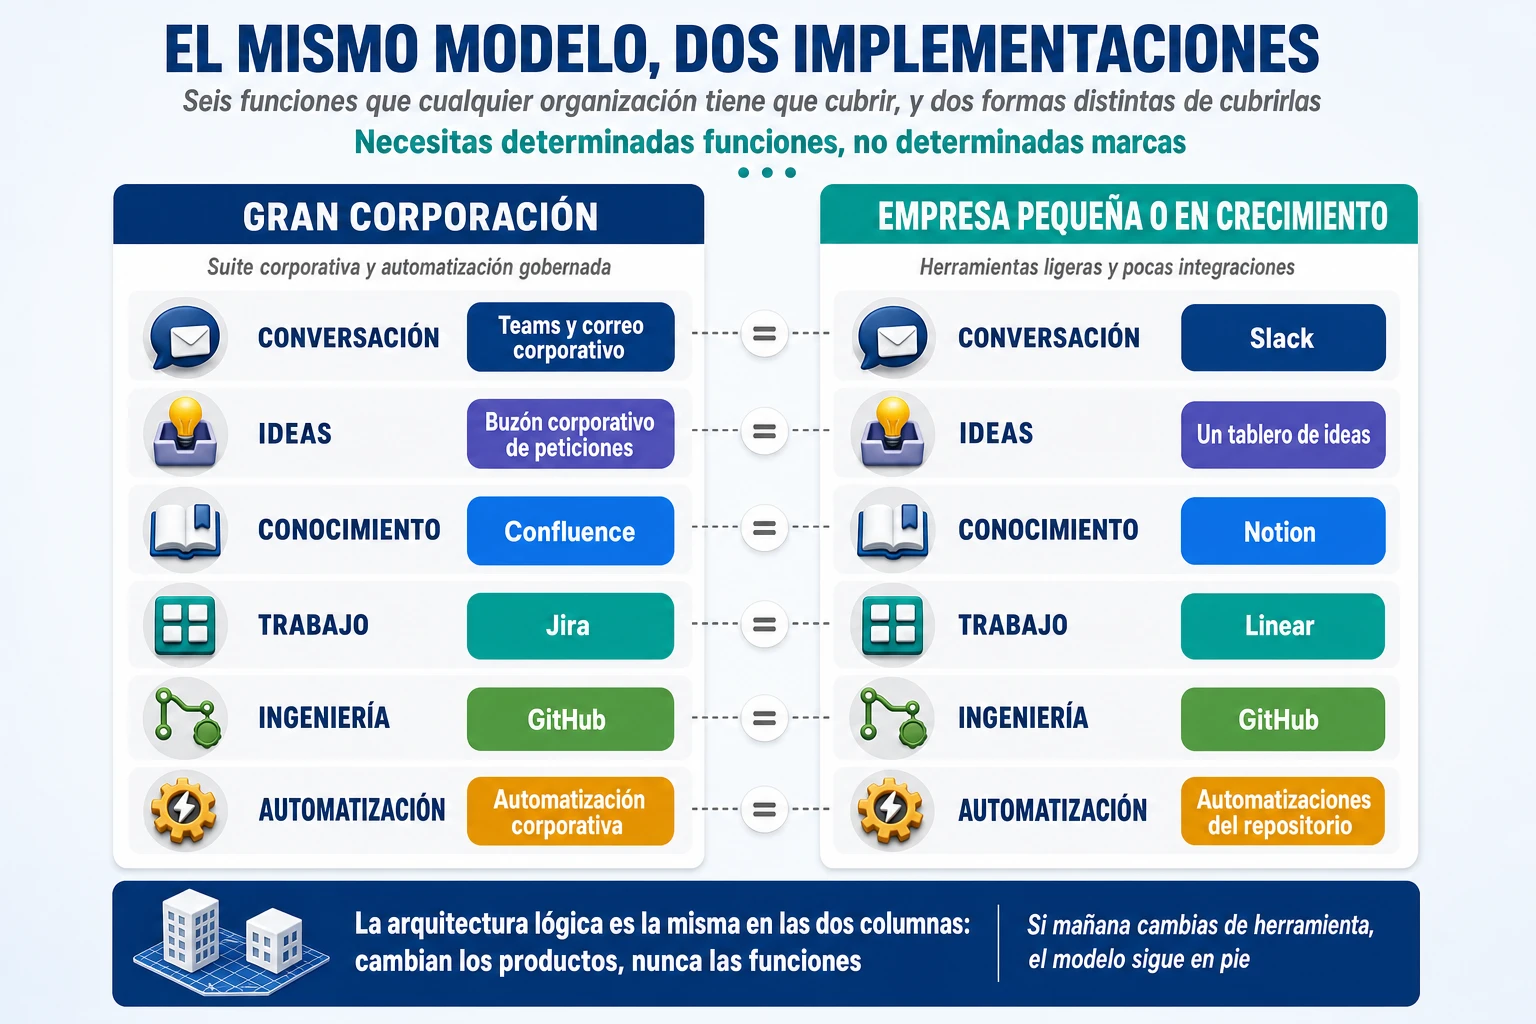
Y ahora la parte que conviene no saltarse, porque es la que impide que este artículo se lea como una recomendación de compra: necesita usted esas funciones, no esas marcas. La arquitectura lógica es idéntica en una operadora de treinta mil personas y en una empresa de ochenta; lo que cambia es con qué se implementa y cuánta ceremonia soporta.
| Función | Gran corporación, típicamente | Empresa pequeña o en crecimiento |
| Conversación | Teams y correo | Slack |
| Ideas | Un espacio de oportunidades separado del backlog | Un tablero ligero, o el propio gestor con otra vista |
| Conocimiento | Confluence | Notion |
| Trabajo | Jira | Linear, Asana o ClickUp |
| Ingeniería | GitHub o GitLab | GitHub |
| Automatización | Reglas del gestor, plataforma corporativa de flujos y acciones del repositorio | Flujos del propio chat e integraciones nativas |
Habrá notado que la inteligencia artificial no aparece en esas tablas, y es deliberado: no es una séptima función. No tiene un flujo propio ni un sitio en la cadena; se apoya en lo que guardan las otras seis. En una gran corporación eso se traduce en asistentes con gobierno de identidad, permisos y traza; en una empresa pequeña, en los asistentes que cada herramienta ya trae dentro. Pero en los dos casos la regla es la misma, y es la que evita el error más común de estos diagramas: dibujar un círculo enorme alrededor de todo y escribir dentro «inteligencia artificial» no es diseñar una arquitectura.
Merece la pena detenerse en por qué una empresa de ochenta personas puede apañarse con tres herramientas y una de treinta mil no. No es que la grande sea más torpe. Es que en la grande aparecen piezas que en la pequeña no existen: arquitectura empresarial, compras, cumplimiento normativo, seguridad corporativa, proveedores externos, infraestructura compartida, decenas de repositorios, gestión de cartera, un sistema de incidencias con sus propios acuerdos de servicio y segregación de funciones exigida por auditoría. Cada una de esas piezas es una frontera más que la información tiene que cruzar, y cruzar fronteras es exactamente lo que cuesta tiempo.
De las seis funciones, tres concentran casi toda la confusión en una organización grande, y para esas tres hay una regla que resuelve la mayoría de las discusiones de implantación. La capa de conocimiento responde cómo tiene que funcionar el servicio; la de trabajo, qué hay que hacer y en qué estado está; la de ingeniería, cómo se ha construido y qué lo demuestra. La regla práctica para cualquier contenido nuevo cabe en una frase: si cambia cada día es un estado y va a la capa de trabajo; si cambia con el código y se revisa con el código va a la de ingeniería; si es un acuerdo que sobrevive a la entrega va a la de conocimiento.
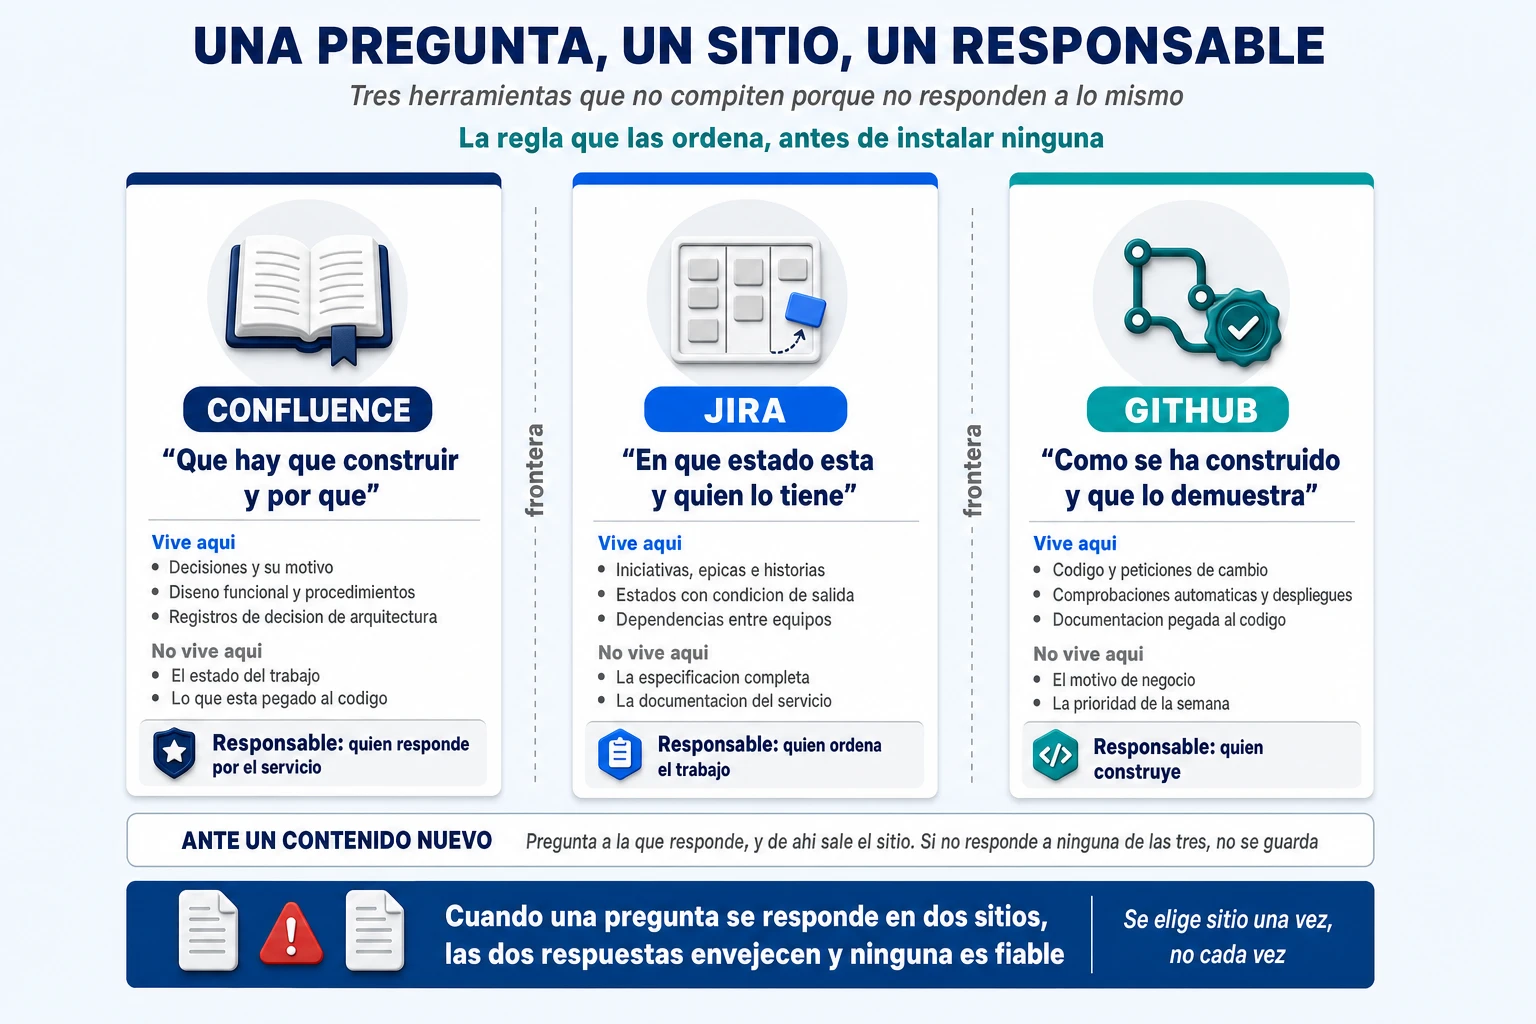
Falta la tercera parte de la regla, que es la que más se incumple: un responsable por pregunta, y que no sea quien administra el software. No se trata de nombrar a un dueño de la herramienta, que acaba siendo alguien de sistemas que gestiona permisos, sino de que haya una persona que responda de que la respuesta esté actualizada. Sin eso ocurre lo de siempre: tres herramientas bien instaladas, tres fuentes incompletas y una cuarta fuente real, que es preguntar a quien lleva años y se lo sabe de memoria.
Y antes de todo eso: dónde viven las ideas
Hay una función que casi nadie monta y que explica buena parte del ruido en los gestores de trabajo. Una ocurrencia aparece en una reunión a las diez y diecisiete y a las diez y veintidós ya tiene un identificador de ticket, como si haberle dado número la hubiera convertido en estrategia. A partir de ahí ocupa sitio en el backlog, aparece en los informes y nadie se atreve a borrarla.
Las ideas necesitan vivir en algún sitio antes de ser trabajo comprometido, con problema, clientes afectados, beneficio esperado, coste aproximado y prioridad. Nada de eso es todavía un proyecto. Hay herramientas específicas para ello, pero el principio importa más que el producto: lo importante es que exista un sitio donde las ideas puedan estar sin ser proyectos. Y la regla que lo hace útil es una sola: una idea puede existir durante meses; una iniciativa empieza el día en que la organización decide invertir capacidad en resolverla. Ese día, y no antes, arranca el reloj del plazo. Si no se separa, toda métrica de tiempo medida desde la creación del elemento acaba midiendo veinte años de backlog arqueológico.
Las siete etapas, y por qué esto no es una cadena de fases
Con las funciones claras, miremos el trabajo. Cualquier servicio, tenga o no software dentro, recorre siempre las mismas siete etapas, y cada una cierra una pregunta distinta.
| Etapa | La pregunta que cierra | En nuestro ejemplo |
| La idea | ¿Merece la pena hacerlo? | ¿Cuántas pymes contratarían esto y qué ingresos mueve? |
| La definición del servicio | ¿Cómo tiene que funcionar exactamente? | Qué ve el cliente, qué pasa si ya tiene contrato, qué pasa si el alta falla |
| El plan de trabajo | ¿Qué hay que hacer y quién lo hace? | Pantalla, tipo de pedido, tarifa, interfaz de alta, procedimiento, formación |
| La construcción | ¿Está hecho? | Cada equipo construye su parte, y solo algunas son software |
| La verificación | ¿Funciona y es seguro? | Pruebas de extremo a extremo, revisión de seguridad, prueba con clientes reales |
| El lanzamiento | ¿Lo activamos? | Despliegue, activación comercial, atención preparada |
| La operación | ¿Está funcionando como esperábamos? | Altas completadas, incidencias, llamadas, y qué se aprende |
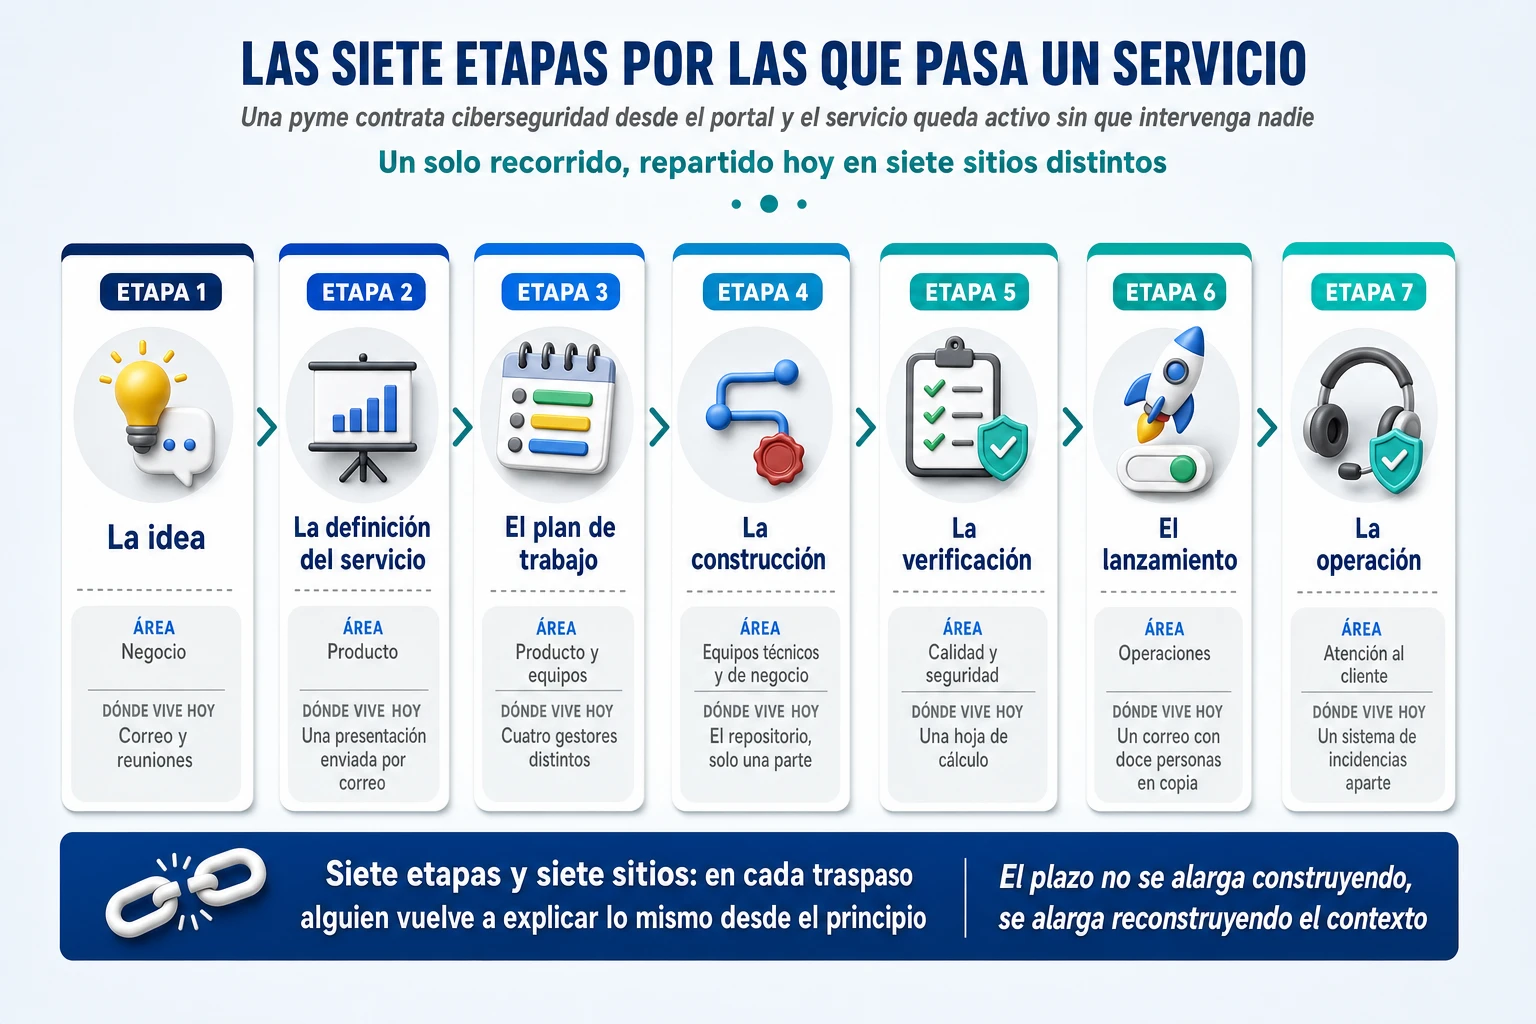
Hasta aquí no hay nada polémico. El problema de las organizaciones grandes aparece en la frase siguiente: cada una de esas siete etapas suele vivir en una herramienta distinta, un departamento distinto y una conversación distinta. La idea nació en una reunión y está en las notas de alguien. La definición acabó en una presentación que se envió por correo. El plan está troceado en cuatro gestores, uno por departamento. Las pruebas, en una hoja de cálculo. El lanzamiento, en un correo con doce personas en copia. Y la operación, en un sistema de incidencias que nadie relaciona con lo que se construyó.
Una advertencia imprescindible antes de seguir
Una tabla de siete etapas se puede leer de dos maneras, y una de las dos arruina todo lo demás. La lectura equivocada es: definimos todo, planificamos todo, construimos todo, probamos todo, y entre cada dos etapas ponemos una aprobación. Eso es una cascada con nombres nuevos, y el riesgo es real: en una organización grande siempre hay alguien dispuesto a concluir que basta con mantener el proceso de catorce puertas de siempre y comprar licencias de Jira.
La lectura correcta es otra. Hay un primer tramo que sí es secuencial y corto: de la idea al compromiso. Alguien decide que esto merece la pena y que se le asigna capacidad. Es una decisión de inversión, se toma una vez y conviene que tenga puerta.
A partir de ahí, lo que hay no es una cadena sino un bucle que se repite por incrementos: definir el siguiente trozo, construirlo, verificarlo, desplegarlo, observarlo y aprender; y con lo aprendido, definir el siguiente. En nuestro ejemplo, el primer incremento podría ser el alta para un único producto y un único perfil de cliente, sin cancelación y sin los casos raros. Eso se puede tener funcionando mientras se sigue definiendo el resto, y lo que se aprenda al verlo funcionar cambiará la definición de lo que viene después.
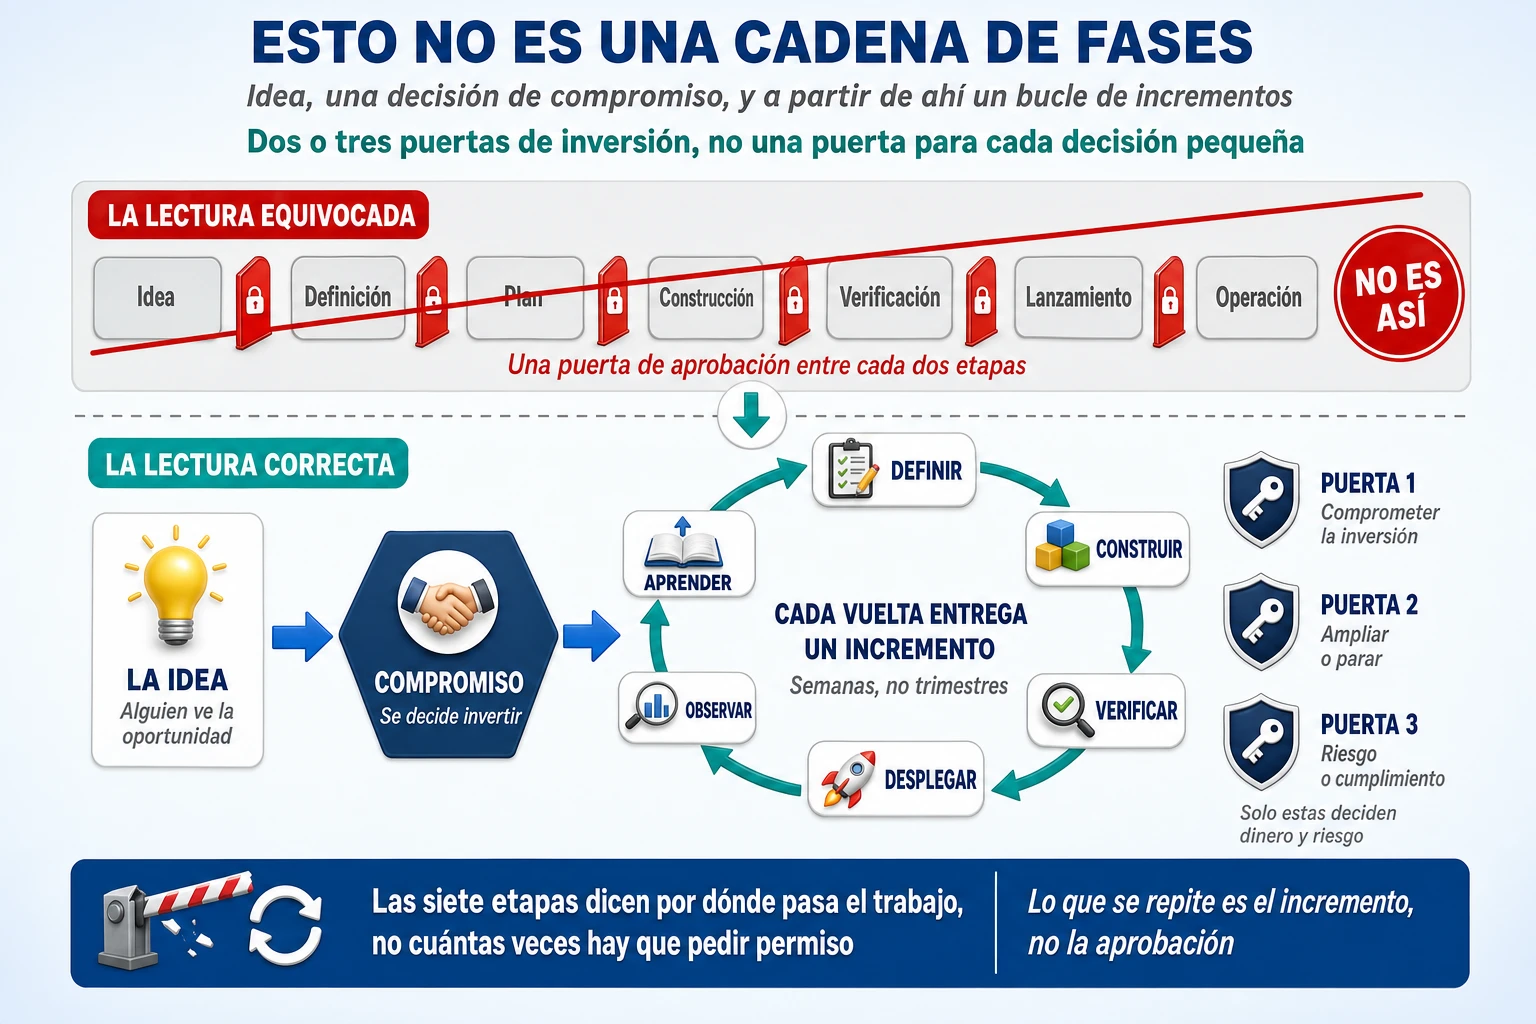
La diferencia entre las dos lecturas se nota en una sola pregunta: ¿cuántas veces hay que pedir permiso para seguir? Si la respuesta es dos o tres —comprometer la inversión, aceptar un riesgo material, autorizar la salida a producción—, el modelo funciona. Si es catorce, lo que se ha montado es el proceso de siempre con herramientas nuevas, y el plazo no se va a mover.
Dónde se va realmente el tiempo
La intuición más extendida en una dirección es que para ir más rápido hay que conseguir que la gente trabaje más rápido. La teoría de colas dice lo contrario desde hace décadas: en organizaciones grandes el trabajo activo es la parte pequeña del plazo, y acelerarla apenas mueve el total. Lo que mueve el total es reducir el tiempo que el trabajo pasa parado.
La medida que captura esto se llama eficiencia de flujo: tiempo de trabajo activo dividido entre tiempo total transcurrido. Y aquí conviene una advertencia que ahorra disgustos, porque circulan muchos porcentajes de referencia y ninguno resiste una comprobación. «El quince por ciento», «más del noventa y cinco por ciento es espera» son cifras que vienen de artículos de proveedores, de experiencia declarada de consultores sin muestra y, cada vez más, de contenido generado para posicionarse en buscadores. No existe una medición independiente publicada del valor típico. La eficiencia de flujo es una pregunta excelente sobre el proceso propio y una cifra pésima para citar sobre el de los demás.
Lo que sí hay son anclajes concretos. El más contundente lo documentó Maersk Line sobre una de sus funcionalidades: pasó treinta y ocho semanas esperando en colas, con un coste de retraso estimado por encima de doscientos mil dólares por semana. Es un caso, no una muestra, pero sirve para calibrar lo que cuesta el tiempo parado cuando nadie lo mide. Y hay un dato de sistema, poco citado y muy sólido, del regulador financiero británico: analizó veintitrés entidades, más de un millón de cambios en producción de un solo año y cerca de veinte mil incidencias derivadas, con una tasa de fallo del 1,6 % en el conjunto y del 3,8 % en los cambios mayores.
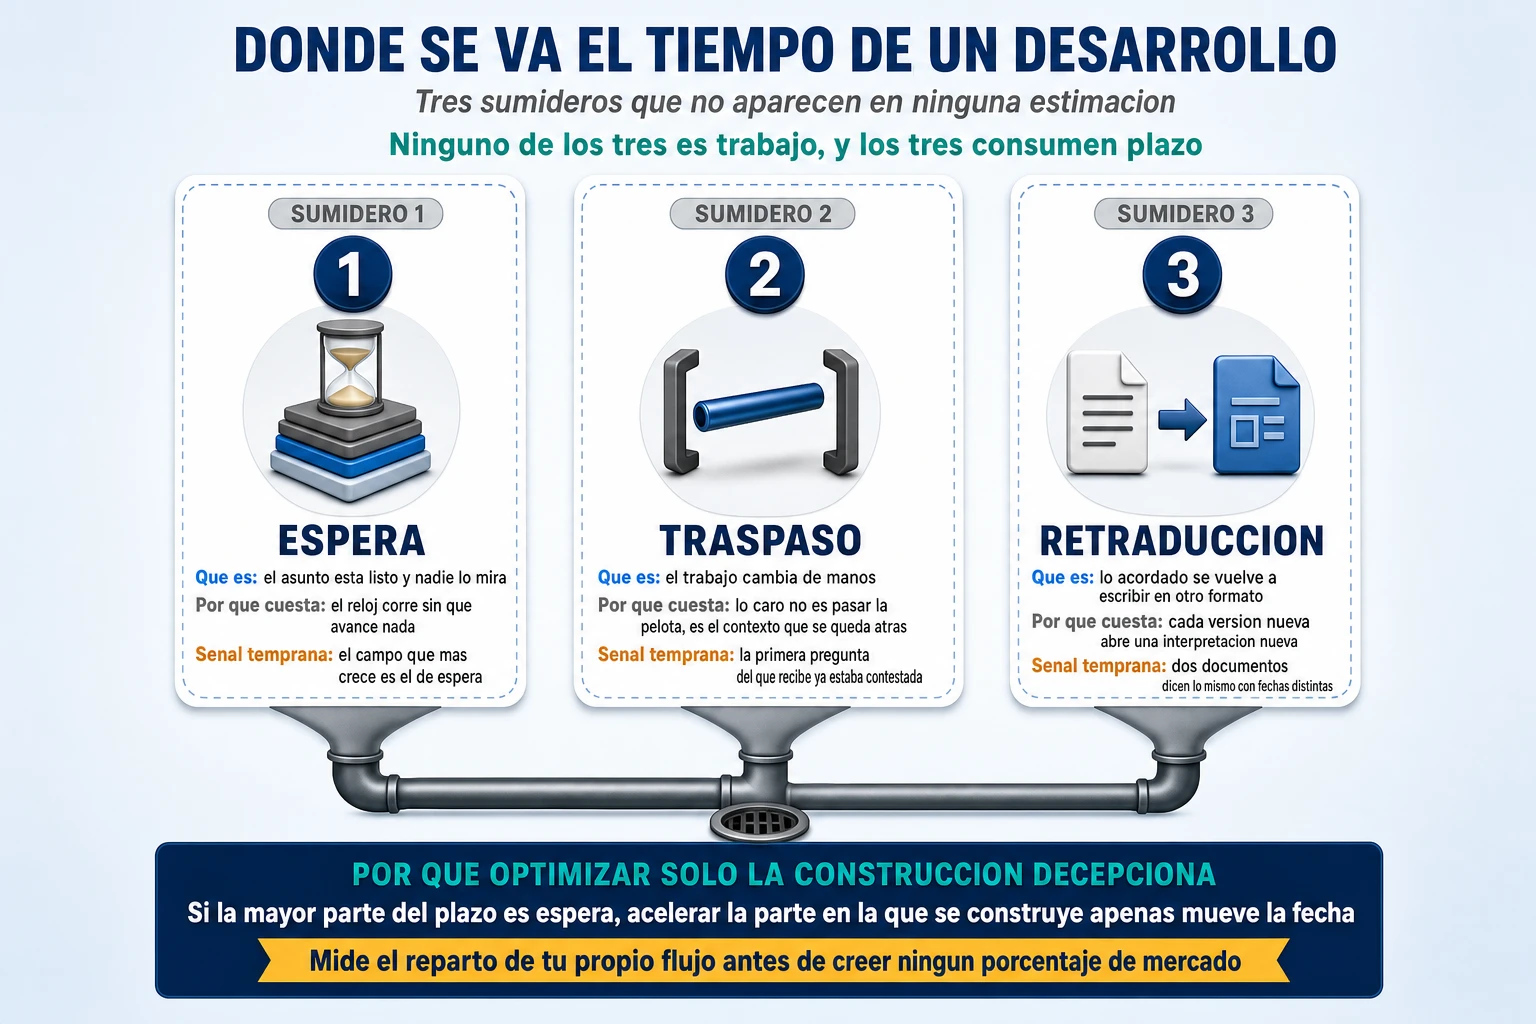
Los tres sumideros merecen distinguirse porque la gente los confunde y luego aplica el remedio equivocado. La cola es el tiempo que algo pasa delante de un equipo ocupado, y es consecuencia directa de cuántas cosas hay abiertas a la vez. El traspaso cuesta tres cosas y solo la primera es obvia: la cola del que recibe, lo que el que envía sabía y no escribió, y el bucle de aclaración posterior, que no es un correo sino varios días. La retraducción es que la misma información se escriba cuatro veces en cuatro formatos, y es la que mejor atacan las herramientas de las que trata este artículo.
Una honestidad necesaria: no existe ninguna medición publicada de cuántos días cuesta un traspaso, y cualquier número que se vea por ahí está inventado. El argumento no la necesita. Con cinco traspasos, la espera domina el plazo aunque cada paso individual sea eficiente, que es exactamente lo que pasó en nuestras catorce semanas sin que ningún equipo hiciera nada mal.
Las palancas que de verdad acortan el plazo
Antes de hablar de herramientas conviene fijar qué hace bajar un plazo, porque de lo contrario se acaba comprando software con la esperanza de que traiga el método dentro. Son seis palancas y ninguna requiere comprar nada.
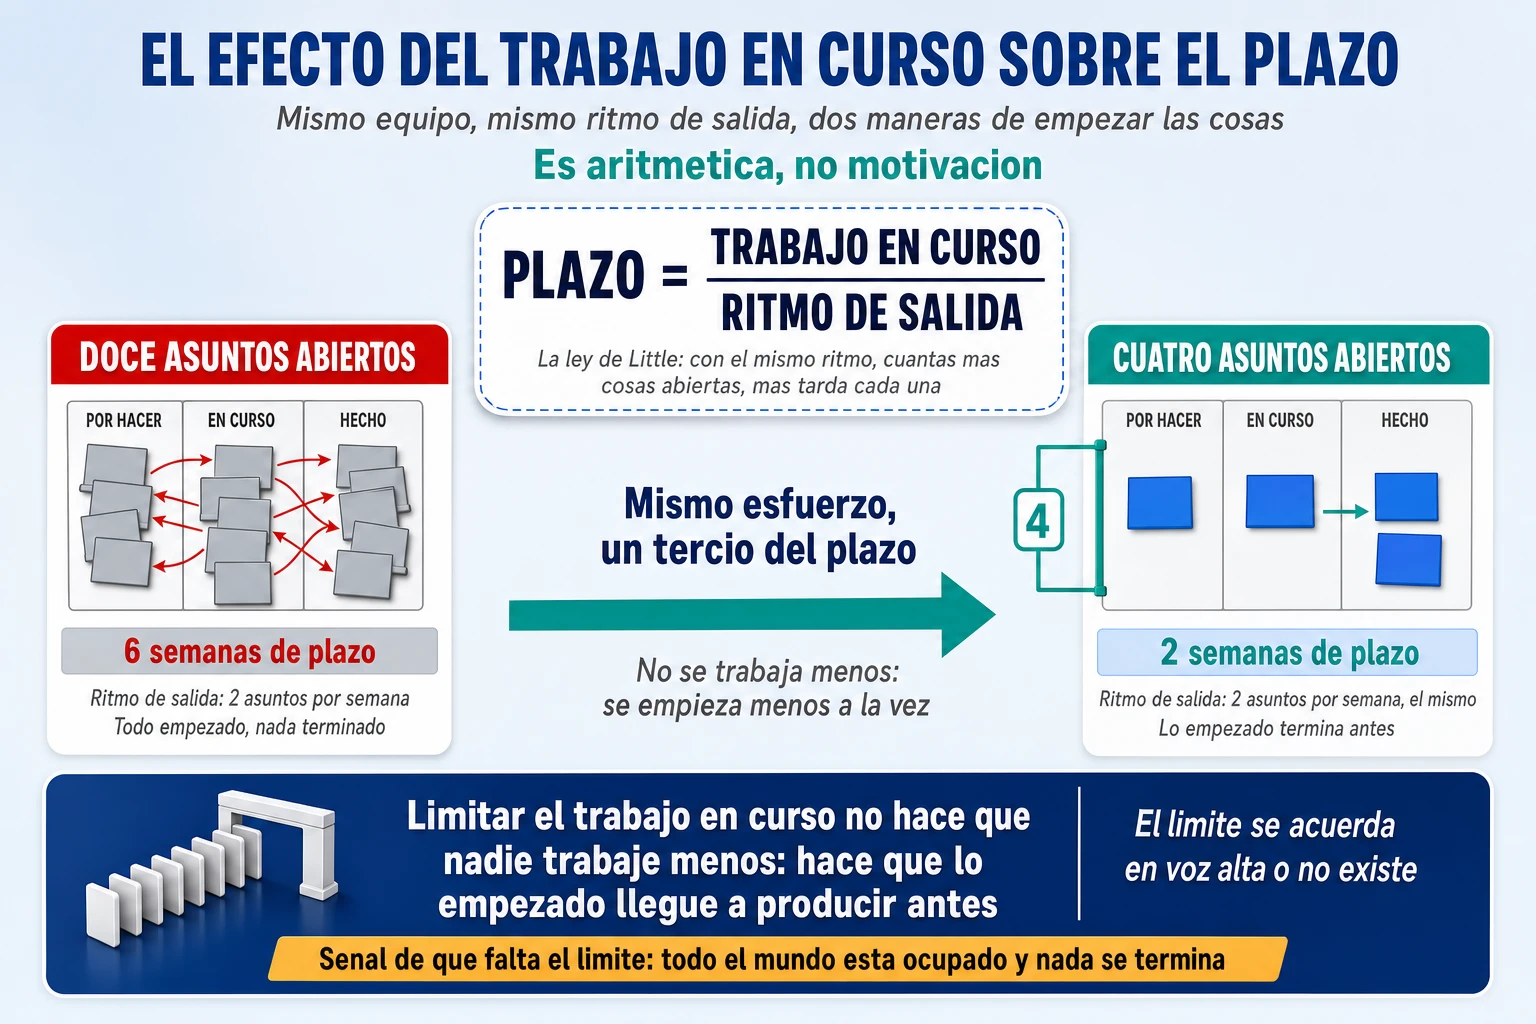
Reducir el trabajo abierto a la vez es la única gratis, y hay un resultado matemático que la garantiza. El tiempo que algo tarda en atravesar un sistema es igual al número de cosas en proceso dividido entre el ritmo al que se terminan. Un equipo que termina dos asuntos por semana y tiene doce abiertos tarda seis semanas de media en sacar cada uno; el mismo equipo, al mismo ritmo, con cuatro abiertos tarda dos. No ha mejorado nadie: ha dejado de repartir su atención entre doce frentes.
Hacer los lotes más pequeños actúa sobre lo mismo por otra vía. Un paquete de cuarenta requisitos que se analiza entero antes de construir nada, o una entrega trimestral, multiplican la cola, retrasan el momento en que se descubre el error y concentran el riesgo en una fecha. En nuestro ejemplo, el lote pequeño consistiría en sacar primero el alta para un único producto y un único perfil de cliente, y añadir el resto después. Partirlo no cuesta dinero y mejora las tres cosas a la vez.
Poner plazo y dueño a las decisiones ataca la mayor partida de nuestro desglose: veintiocho de los sesenta y un días de espera eran esperas a que alguien decidiera. Cada decisión abierta necesita cuatro datos: si es reversible, quién decide —una persona, no un comité—, para cuándo, y qué se hace por defecto si no hay respuesta en plazo. El cuarto es el que convierte la fecha en algo real.
Una sola fuente por cada pregunta es la palanca que ataca la retraducción, y el eje del resto del artículo. Si «¿qué tiene que hacer esto exactamente?» se responde en una página, en un ticket y en un correo, el equipo no tiene tres fuentes: tiene una incertidumbre permanente sobre cuál vale, que se resuelve preguntando, es decir, esperando.
Automatizar lo que siempre se hace igual elimina una clase entera de espera, la de «cuando alguien tenga un rato para lanzarlo». Y reutilizar caminos ya recorridos evita que crear el servicio número treinta y uno empiece con una reunión para decidir cómo se crea un servicio. El estándar deja de ser una recomendación escrita y pasa a ser algo que se ejecuta.
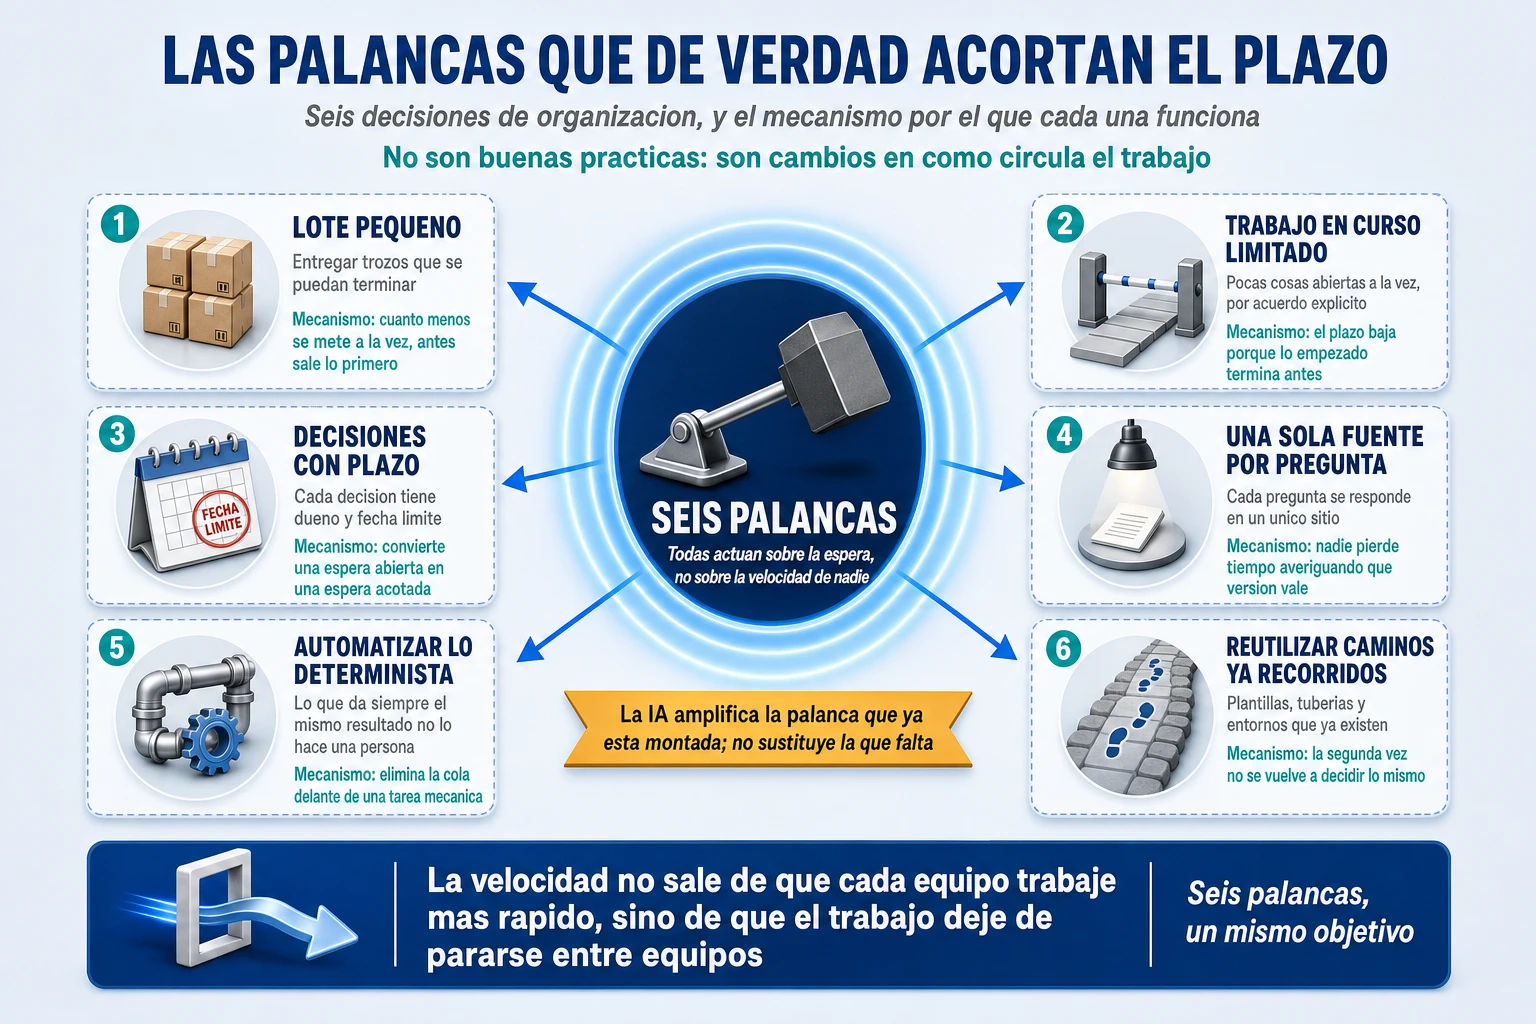
Falta una séptima, que es la inteligencia artificial, y funciona distinto de las otras seis: no es una palanca independiente, es un multiplicador de las anteriores. Donde el trabajo está troceado, escrito y verificado automáticamente, acelera. Donde no, produce más volumen de trabajo a medio hacer que alguien tendrá que revisar. No es prudencia: es lo que mide la investigación, y lo veremos con números más adelante.
El recorrido completo de una iniciativa, paso a paso
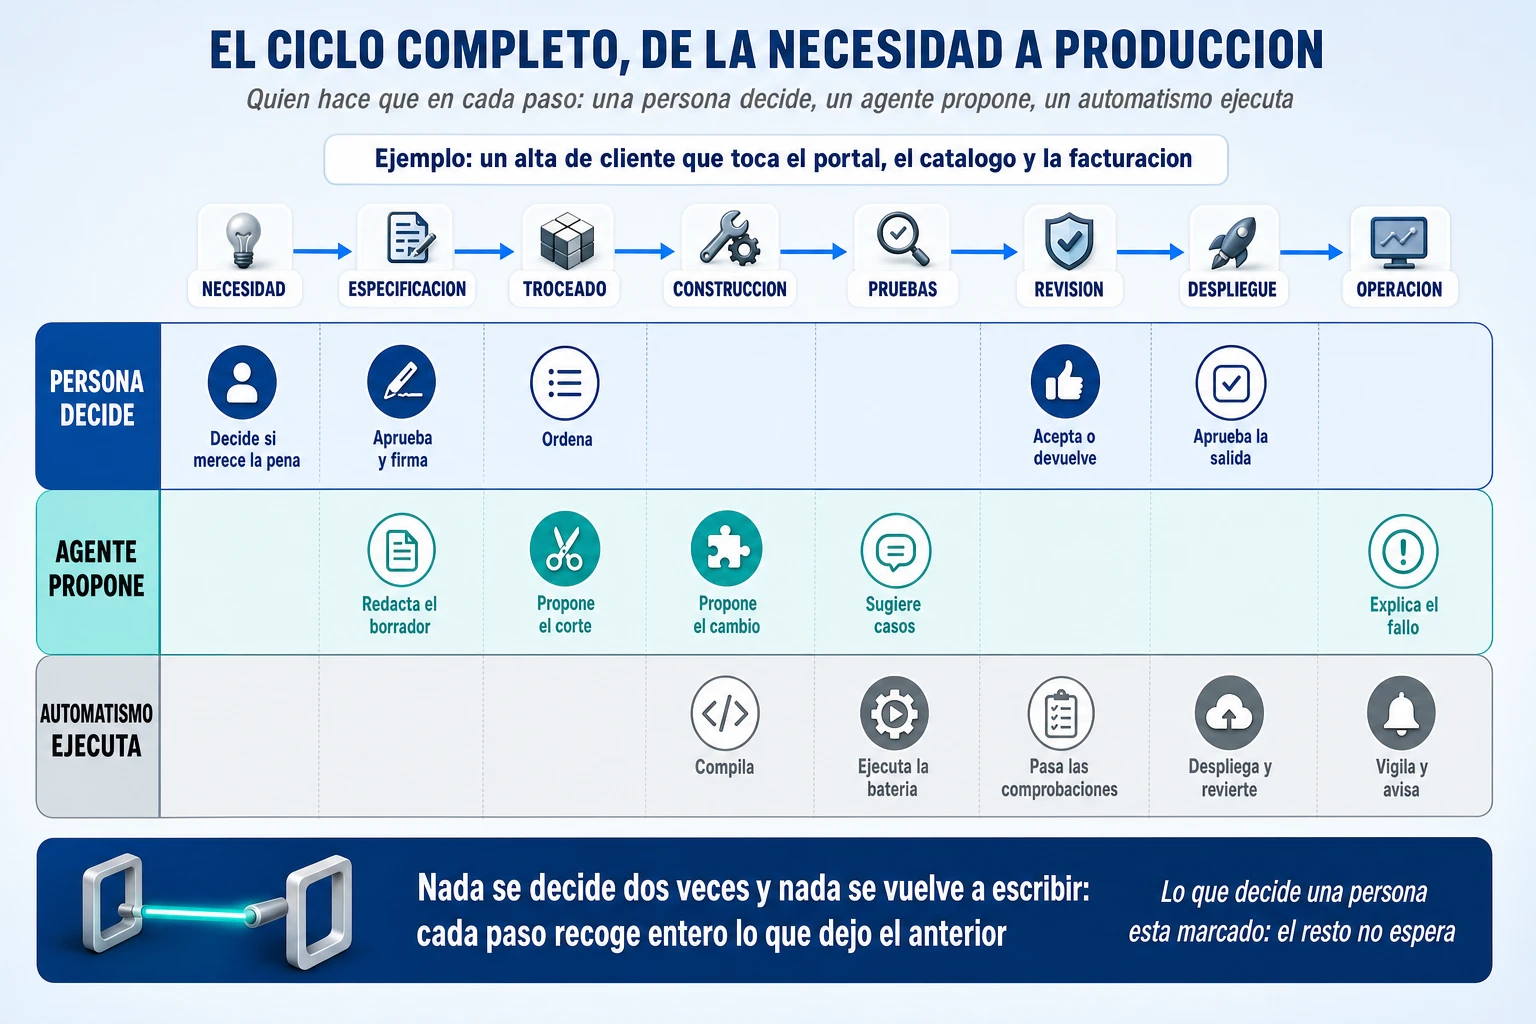
Esta es la sección que conviene leer despacio, porque es el artículo entero en concreto. Volvemos al servicio de ciberseguridad para pymes y lo seguimos desde la frase inicial hasta que un cliente lo contrata, viendo en cada paso quién hace qué, dónde queda registrado y qué se mueve solo.
Paso 1. Alguien propone la idea
En una reunión, producto dice que las pymes deberían poder contratar el servicio de ciberseguridad desde el portal en lugar de llamar. Eso ocurre en Teams y está bien que ocurra ahí: es una conversación.
Lo que no puede pasar es que se quede ahí. Al terminar la reunión alguien registra la oportunidad en la capa de ideas con cinco datos: qué problema resuelve, para qué clientes, qué beneficio se espera, cuánto costaría aproximadamente y qué prioridad tiene frente a lo demás. Cinco minutos de trabajo. Todavía no hay proyecto, no hay equipo asignado y no hay ni una tarea creada.
Qué espera se elimina: ninguna todavía. Pero se evita la peor de todas, que es que la idea viva seis semanas en la cabeza de una persona y en un hilo de mensajería hasta que alguien se acuerde de subirla a un comité.
Paso 2. Se decide que merece la pena
El comité que prioriza ya no recibe una petición en bruto que tendrá que devolver pidiendo información: recibe una oportunidad con problema, clientes, beneficio y coste estimado, comparable con las otras doce que hay encima de la mesa. Decide en su siguiente sesión en vez de en la siguiente a la siguiente.
Este paso es el que más se subestima. En el desglose original eran doce días de espera, y la mitad no era espera de agenda: era espera de información. Un comité que tiene que pedir datos convierte una sesión en dos.
Paso 3. Se define cómo tiene que funcionar el servicio
Aquí empieza Confluence, y aquí está la mayor diferencia con lo que hace la mayoría de las organizaciones. Se abre una página —una, no un expediente— y en ella producto, arquitectura, operaciones y seguridad escriben juntos cómo debe comportarse el servicio:
- El cliente entra en el portal, elige el servicio, acepta condiciones; el CRM registra el pedido; facturación activa la tarifa; la plataforma de seguridad da de alta al cliente; el cliente recibe la confirmación.
- Qué pasa si el cliente ya tiene un servicio equivalente contratado.
- Qué pasa si el alta en la plataforma de seguridad falla a mitad.
- Qué productos son compatibles y cuáles no.
- Qué compromiso de disponibilidad y de tiempo de activación se asume.
- Qué sistemas intervienen y qué interfaces se tocan.
- Cómo se sabrá que funciona: criterios de aceptación verificables.
Las dos preguntas del cliente con contrato previo y del alta que falla a mitad son, en nuestro desglose, dieciséis días de espera. Aparecieron en la semana nueve porque un desarrollador se las encontró de frente. Haberlas hecho aquí cuesta una conversación de cuarenta y cinco minutos.
Y hay una práctica que cambia más de lo que parece: marcar explícitamente lo que todavía no se sabe, en vez de taparlo con una frase que suene bien. Una página con tres huecos señalados es honesta y acciona tres conversaciones; la misma página con esos huecos cubiertos de lenguaje ambiguo parece completa y produce tres semanas de retrabajo.
Paso 4. De la definición salen los trabajos
Ahora cambia la pregunta. Ya no es cómo debe funcionar, sino qué hay que hacer para construirlo. Y ahí entra Jira. Desde la propia página de Confluence se crean los elementos de trabajo, de modo que el enlace entre el acuerdo y el trabajo exista por construcción y no por voluntad de alguien.
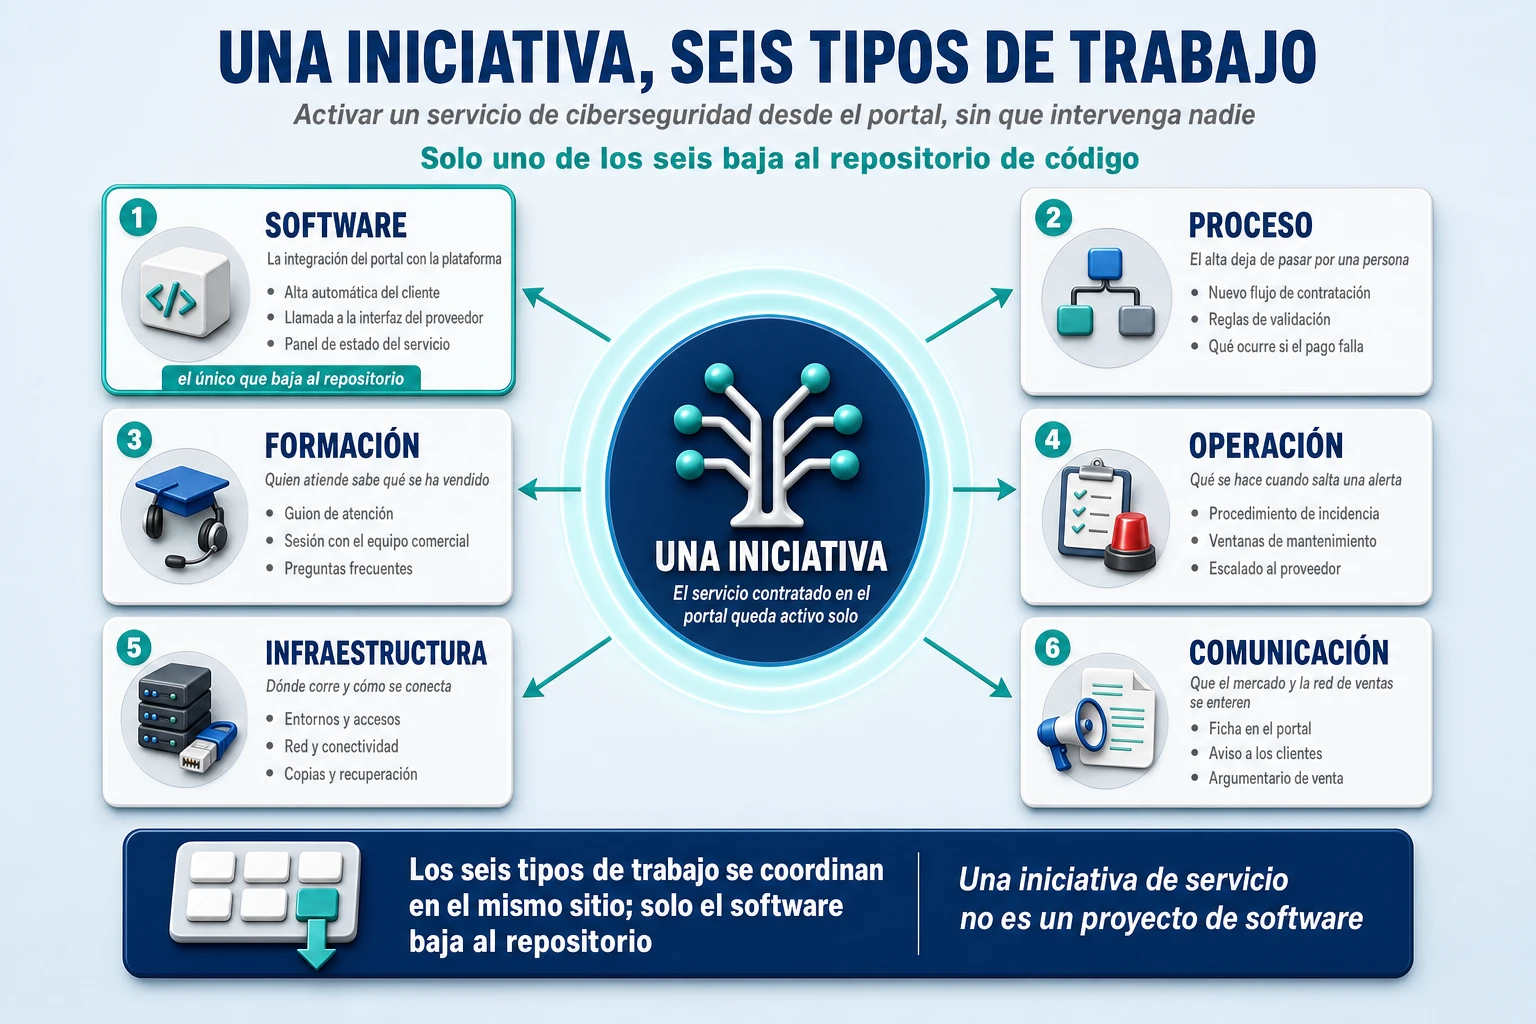
En nuestro ejemplo sale una iniciativa y, colgando de ella, seis bloques de trabajo bien distintos:
| Trabajo | Quién | ¿Es software? |
| Pantalla de contratación en el portal | Equipo de portal | Sí |
| Nuevo tipo de pedido en el CRM | Equipo de CRM | Sí, y en parte configuración |
| Alta de la tarifa en facturación | Equipo de facturación | Configuración, no desarrollo |
| Interfaz de alta en la plataforma de seguridad | Equipo de plataforma | Sí |
| Procedimiento de soporte y guía de incidencias | Operaciones | No |
| Formación del equipo de atención y argumentario comercial | Atención y comercial | No |
Conviene detenerse en esa última columna, porque es el punto que más se malinterpreta: de seis bloques de trabajo, tres no son software y uno es configuración. Todos se coordinan en el mismo sitio, todos cuelgan de la misma iniciativa y todos tienen que estar terminados para poder lanzar. Si el procedimiento de soporte no está escrito, el servicio no sale, por mucho que la interfaz funcione.
Paso 5. Los trabajos que son software bajan a GitHub
Tomemos uno concreto: «crear la interfaz de alta en la plataforma de seguridad». Un desarrollador lo toma, crea una rama cuyo nombre lleva el identificador del elemento de trabajo, escribe el cambio y abre una propuesta de cambio que también lo lleva en el título.
A partir de ahí ocurre una secuencia que siempre hace lo mismo: compila, pasa las pruebas, analiza el código buscando defectos y patrones inseguros, comprueba que no se han colado credenciales y revisa las dependencias. Cuando un revisor humano llega, no está comprobando si aquello compila: está mirando si la solución es la adecuada. Al incorporarse el cambio, el estado del elemento en Jira se actualiza y el despliegue al entorno que exige aprobación espera a que alguien la dé, con el expediente completo a la vista de quien tiene que darla.
Los otros tres bloques —procedimiento, formación, argumentario— no pasan por aquí en absoluto. Se completan en Jira, y lo que producen, si es conocimiento que sobrevive, se documenta en Confluence. GitHub solo interviene cuando el trabajo es software.
Paso 6. Aparece un cambio a mitad, como siempre
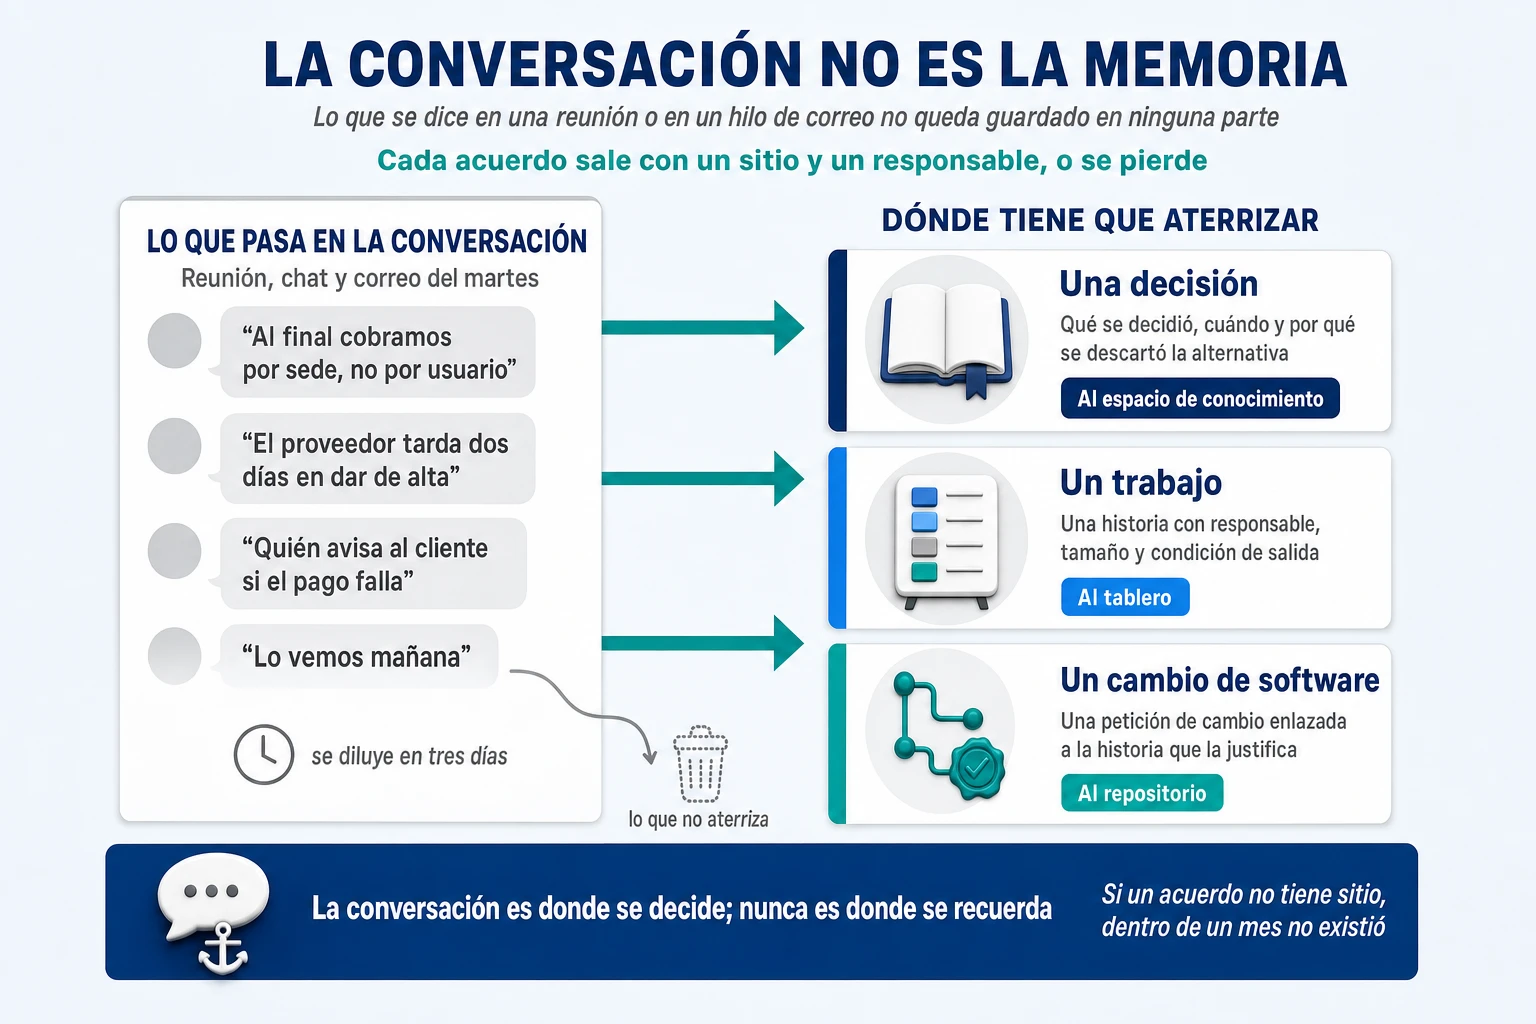
En una reunión de seguimiento alguien señala que el cliente debería poder cancelar el pedido durante las primeras veinticuatro horas. Es una conversación en Teams y es ahí donde tiene que ocurrir. Pero la decisión no puede quedarse en Teams, porque dentro de tres meses nadie recordará ni qué se decidió ni por qué.
El recorrido correcto de esa conversación es: la regla nueva se añade a la página del servicio en Confluence, donde vive el acuerdo; de ahí salen tres elementos de trabajo en Jira —modificar el portal, modificar el CRM, modificar la interfaz—; y los que sean software acaban en una propuesta de cambio. La conversación es el origen; la memoria está en otro sitio.
Paso 7. Se lanza, y entonces empieza lo interesante
Con todos los bloques terminados —incluidos los que no son software— el servicio se activa. Y aquí la cadena no se corta: cuando a las tres semanas aparezcan incidencias de clientes cuyo alta se queda a medias, se podrá ir desde la incidencia hasta el despliegue que la introdujo, desde ahí hasta el cambio concreto, desde ahí hasta el elemento de trabajo y desde ahí hasta la regla del servicio que lo originó. Que es exactamente la pregunta que nadie sabe contestar en la mayoría de las organizaciones.
Conviene cerrar este recorrido con la lista honesta de qué esperas desaparecen y cuáles no, porque es más útil que la versión optimista. Desaparecen las dos de aclaración, porque las preguntas se hicieron cuando costaban minutos; casi toda la de arquitectura, que ahora revisa una página en vez de reconstruir el problema; y buena parte de la del comité, que recibe algo decidible. No desaparecen la espera por el entorno de pruebas, la de la ventana de despliegue ni la de que el tercer equipo tenga capacidad. Esas tres son problemas distintos —de plataforma, de política de despliegue y de carga— y ninguna herramienta de documentación las va a resolver.
Esa es también la forma correcta de presentar esto en un comité: no como una promesa de reducir el plazo a la mitad, sino como el conjunto de esperas que ataca y el conjunto que deja intacto, con dueño y coste para cada una de las que quedan.
Cómo trabaja realmente el equipo
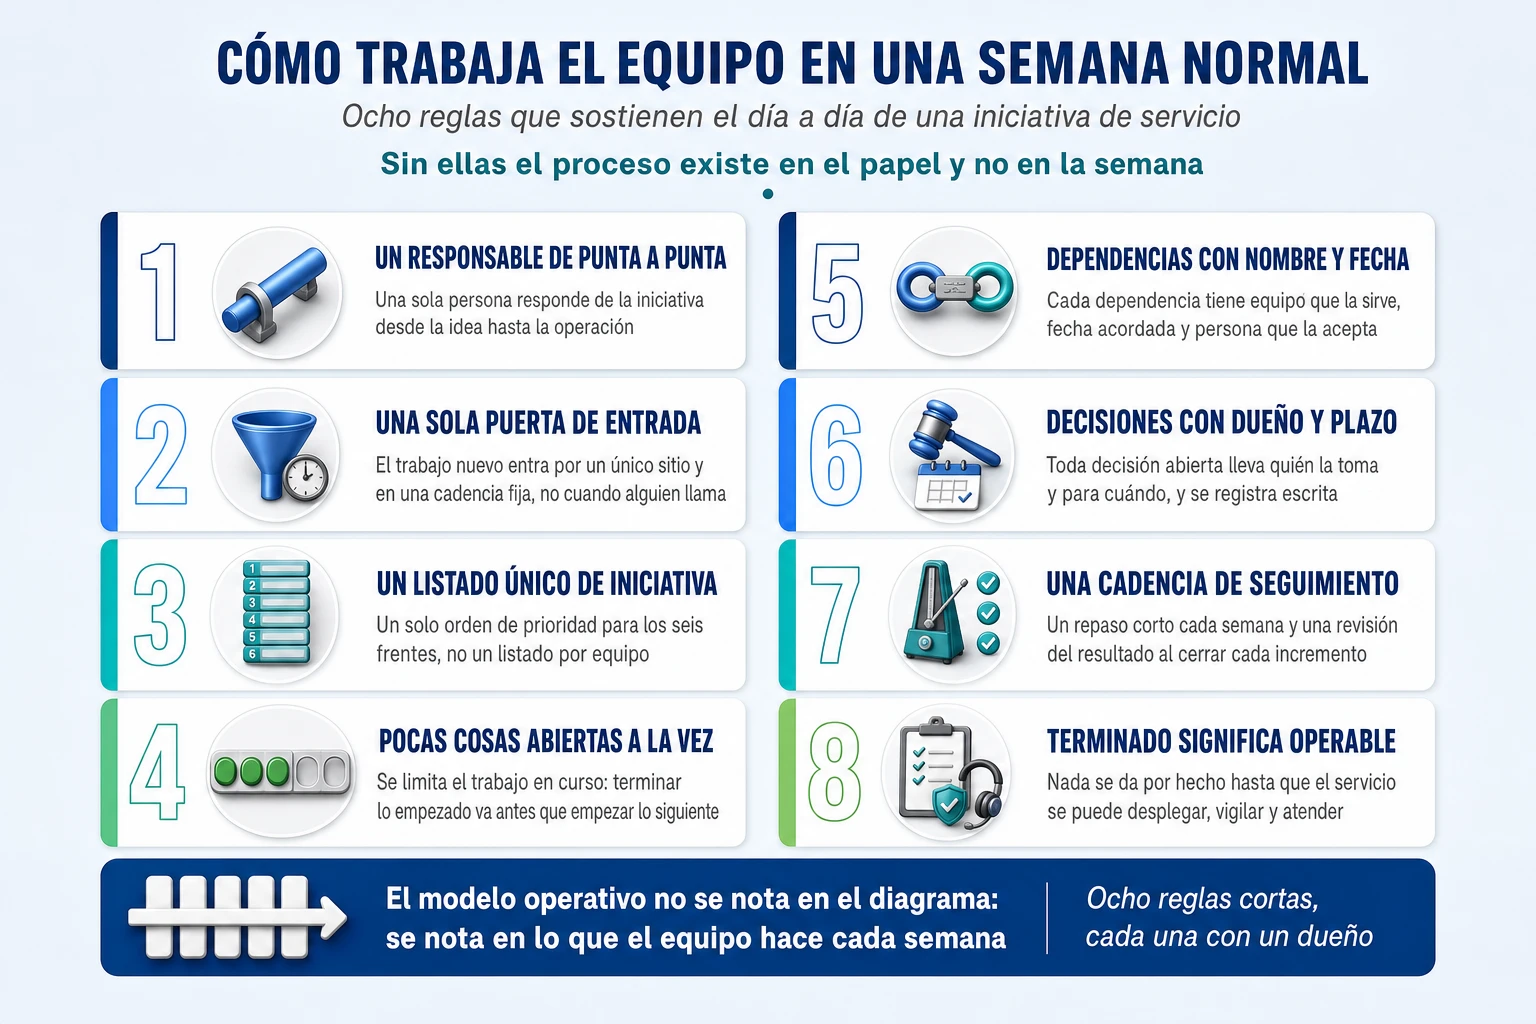
Hasta aquí sabemos por dónde pasa una iniciativa. Falta la pregunta que haría cualquiera a quien le pusieran mañana al frente del servicio de ciberseguridad: «muy bien, ¿y qué hacemos exactamente nosotros durante una semana normal?». Esa es la diferencia entre entender la arquitectura del proceso y poder operarlo, y se resuelve con ocho reglas. Ninguna requiere herramienta nueva y todas se pueden implantar el lunes.
| La regla | Qué evita |
| 1. La iniciativa tiene un responsable de punta a punta, que no lo es de ningún sistema concreto | Que seis ramas de trabajo avancen a velocidades distintas y la última marque la fecha sin que nadie lo decida |
| 2. Nada entra en ejecución sin una definición mínima, que no es una definición completa | Empezar a construir sobre supuestos, y también lo contrario: esperar a la perfección documental |
| 3. De esa definición sale un único backlog de iniciativa, con todo el trabajo | Que el procedimiento, la formación y el argumentario vivan fuera y aparezcan la semana del lanzamiento |
| 4. Los equipos tiran del trabajo; no reciben paquetes | Que un equipo acepte más de lo que puede terminar y lo descubra tarde |
| 5. Las dependencias están escritas en el gestor, no en la cabeza de nadie | Descubrir en una reunión, tres semanas después, que facturación esperaba a plataforma |
| 6. Cada decisión bloqueante tiene dueño, fecha y opción por defecto | Que el trabajo se quede parado esperando indefinidamente a que alguien se pronuncie |
| 7. El seguimiento se hace por excepciones, no por repaso de estados | La reunión semanal donde seis responsables leen en voz alta lo que ya está escrito |
| 8. La iniciativa termina cuando el servicio es operable, no cuando termina el código | Entregar software a un equipo de atención que no sabe qué hacer con él |
Qué tiene que existir antes de empezar a construir
Hace falta una frontera entre «esto es una idea» y «esto se está haciendo», pero conviene no convertirla en un formulario de cuarenta y siete campos, que es el deporte favorito de cualquier oficina de proyectos. La formulación que funciona es deliberadamente blanda: una iniciativa está lista para empezar cuando sabemos lo suficiente para construir el primer incremento.
En la práctica, eso significa que en la página de definición estén el objetivo, el alcance de ese primer incremento, el recorrido principal del cliente, las excepciones que ya se conocen, los sistemas afectados, las restricciones, los criterios de aceptación, las dependencias conocidas, las dudas abiertas y el nombre del responsable de punta a punta. Diez cosas, una página.
Y aquí está el matiz que separa esto de una cascada encubierta: las dudas abiertas no bloquean el inicio. Se convierten en decisiones pendientes con cuatro datos —responsable, fecha límite, impacto si no se resuelve y opción por defecto si nadie contesta—. La pregunta de si puede contratar el servicio un cliente que ya tiene otro producto no tiene por qué estar resuelta para empezar la pantalla del portal; tiene que estar registrada, con dueño y con fecha. La diferencia entre las dos cosas son, en nuestro ejemplo, siete días de espera.
Quién puede meter trabajo nuevo, y quién trocea
Dos preguntas que parecen de detalle y deciden si el modelo aguanta seis meses. Trabajo nuevo en la iniciativa solo lo mete el responsable de punta a punta, o se mete con su conocimiento. No es burocracia: es que si cualquiera puede añadir alcance, el alcance crecerá, y crecerá justo en las semanas en que ya no hay margen.
El troceado, en cambio, no lo hace esa persona sola. Cada equipo trocea su parte, porque es quien sabe en qué pedazos se puede entregar; el responsable de punta a punta se ocupa de que los trozos de los seis equipos encajen en un incremento que tenga sentido para un cliente. Dicho de otra forma: el responsable decide cuál es el siguiente incremento del servicio, y cada equipo decide cómo partir su contribución a ese incremento.
Las dependencias, que es donde muere la agilidad corporativa
Aquí está el verdadero agujero de la mayoría de las implantaciones. Tener elementos de trabajo para portal, CRM, facturación y plataforma está bien, pero el plazo no lo deciden ellos: lo decide la frase que todo el mundo ha oído alguna vez. CRM no puede empezar hasta que arquitectura apruebe una cosa, pero arquitectura esperaba a que plataforma definiera otra, que a su vez esperaba una decisión de producto. El glorioso círculo corporativo.
La regla es que cada dependencia crítica está escrita como tal en el gestor, enlazando los dos elementos con una relación explícita de bloqueo: el trabajo de crear el pedido en el CRM está bloqueado por el de crear la tarifa en facturación. Suena trivial. No lo es: convierte el gestor en un sitio donde se puede ver no solo qué va retrasado, sino qué está causando el retraso, que es una pregunta completamente distinta.
Y de ahí sale la regla que redefine el papel del responsable de punta a punta: no persigue tareas, persigue bloqueos. No pregunta «¿cómo vais?», que es una pregunta cuya respuesta ya está escrita y que además invita a contestar «bien». Pregunta «¿qué está impidiendo que esto avance?». Es la misma diferencia que hay entre un jefe de proyecto que actualiza un plan y alguien que quita piedras del camino.
Para que eso sea posible, el tablero tiene que distinguir visualmente dos cosas que la mayoría mezcla: los estados en los que alguien está trabajando —en construcción, en revisión, en pruebas— y los estados en los que el trabajo está esperando: esperando una decisión, esperando a otro equipo, esperando un entorno, esperando una aprobación. Con esa distinción, el gestor deja de ser una lista de tareas y se convierte en un mapa de dónde se está perdiendo el tiempo.
Qué se hace cuando un equipo está saturado
Limitar el trabajo abierto es fácil de decir y difícil de sostener la primera vez que alguien con galones pide meter algo más. Hace falta un mecanismo, no un principio. El que funciona tiene dos partes.
La primera: el límite no se salta, se negocia. Para que entre algo, sale algo, y la conversación sobre qué sale es exactamente la conversación de prioridad que de otro modo no ocurre nunca. La segunda: cuando la saturación es estructural y no coyuntural —el equipo de facturación es el cuello de botella de seis iniciativas a la vez—, eso deja de ser un problema del equipo y pasa a ser una decisión de cartera. O se reduce el número de iniciativas simultáneas, o se refuerza esa capacidad, o se acepta explícitamente que las fechas se desplazan. Lo que no vale es repartir la culpa entre seis responsables de servicio que no pueden hacer nada al respecto.
La semana normal
No hace falta imponer el mismo marco de trabajo a toda la organización. Puede haber equipos trabajando por iteraciones fijas y equipos trabajando por flujo continuo; da bastante igual. Lo común no es la ceremonia, es el flujo de la iniciativa.
Durante la semana, cada equipo trabaja desde el gestor, y cada elemento tiene cuatro cosas: responsable, estado, dependencias y criterio de salida. El responsable de punta a punta no mira el avance de las tareas: mira cinco cosas —lo que está bloqueado, cuánto trabajo hay abierto a la vez, las dependencias que se acercan, las decisiones pendientes con su fecha, y lo que amenaza el compromiso de fecha—.
Y una o dos veces por semana hay una conversación corta de coordinación que solo trata cuatro temas: bloqueos, decisiones, dependencias y cambios de alcance. No se repasa el estado, porque el estado está escrito y quien quiera leerlo lo lee. Esto suena a detalle menor y no lo es: es la diferencia entre media hora útil y el semáforo ejecutivo de toda la vida, donde todo permanece en verde hasta treinta segundos antes del desastre.
Esa conversación ocurre en la capa de conversación, naturalmente. Y termina como terminan todas en este modelo: lo que se ha decidido se escribe en la definición del servicio, lo que hay que hacer se crea como trabajo, y lo que toca software acaba en un cambio en el repositorio.
Confluence: cómo tiene que funcionar el servicio
De las tres herramientas, Confluence es la que más se usa y la que peor se usa, y las dos cosas tienen la misma causa. Mientras Jira obliga a elegir un tipo de elemento y GitHub obliga a que el código compile, Confluence acepta cualquier cosa que alguien quiera escribir. Esa ausencia de fricción es lo que la hace útil para lo que no cabe en ningún formulario, y es también lo que la convierte, en dos años y sin que nadie lo decida, en el sitio donde está todo y no se encuentra nada.
El malentendido habitual es tratarla como un archivo. No es un archivo: es donde vive el acuerdo vigente sobre cómo tiene que funcionar el servicio. Un archivo guarda lo que se escribió; esta capa tiene que decir lo que se ha acordado hoy. Esa diferencia es la que separa una capa de conocimiento de un almacén de documentos de 2018 con nombres terminados en «versión final definitiva».
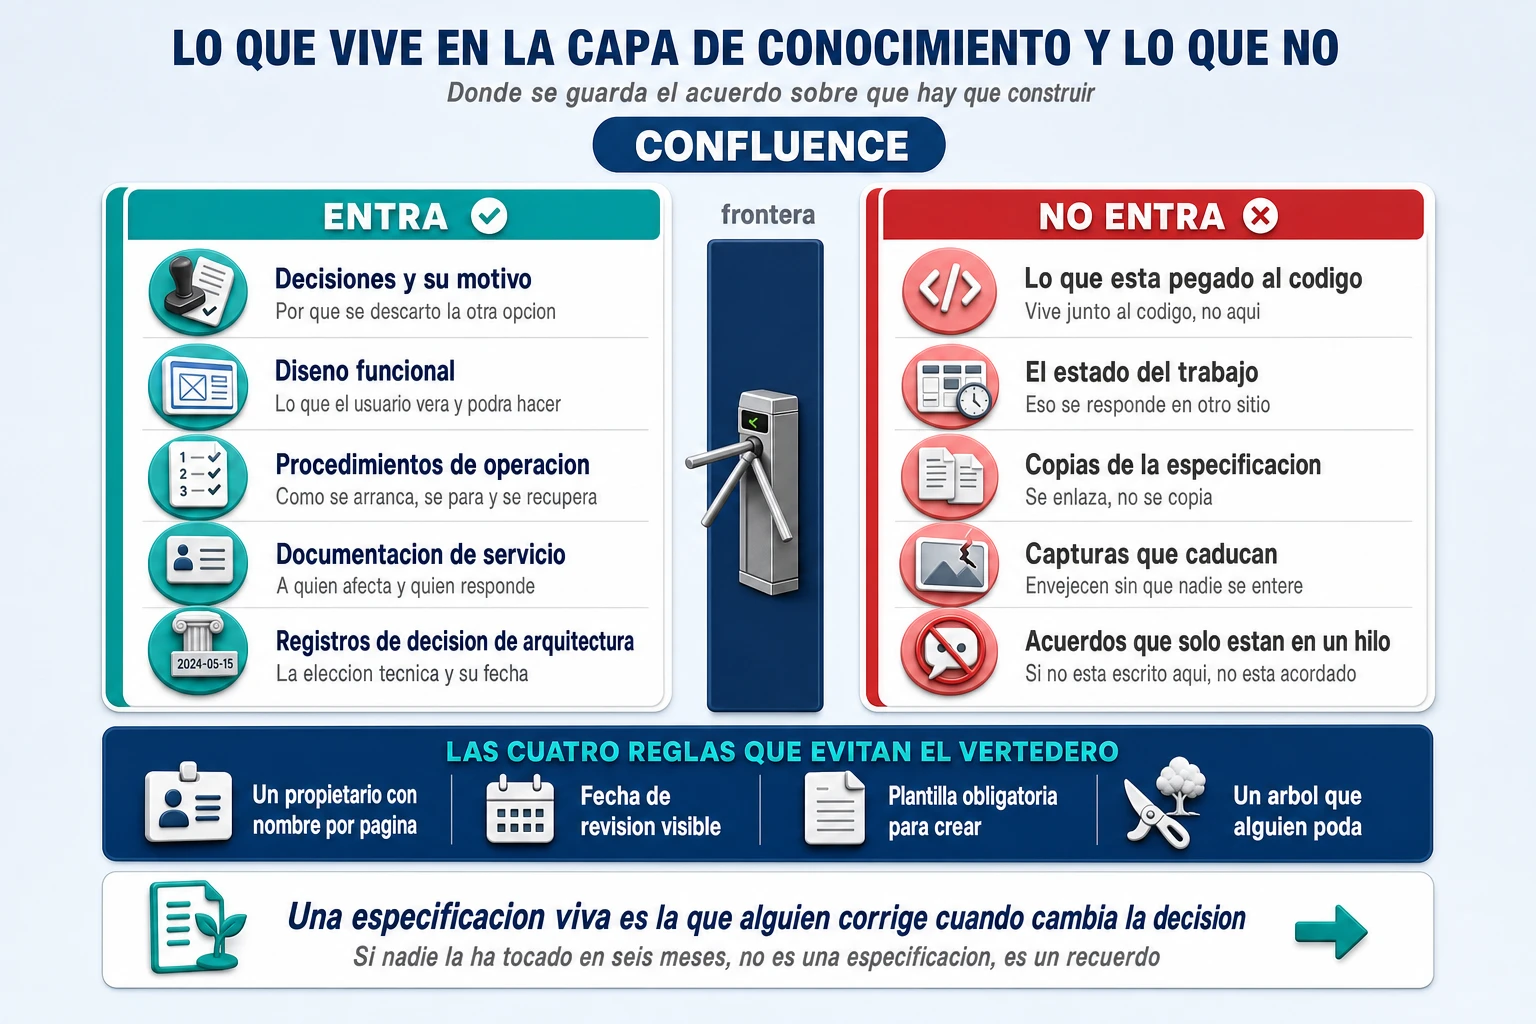
Qué vive dentro y qué no
Dentro van las decisiones y su motivo, la definición funcional del servicio, los procedimientos y políticas, la documentación tal como la necesita quien opera, y lo que se ha aprendido cuando algo ha salido mal. Todo eso comparte dos rasgos: sobrevive a la entrega concreta que lo originó y lo lee gente de varias áreas.
Fuera queda lo que está pegado al código: contratos de interfaz, esquemas de datos, parámetros de configuración y registros de decisión de arquitectura. Eso vive en el repositorio, versionado junto al software y revisado en la misma propuesta de cambio. Si está en los dos sitios divergirá, y lo grave no será que diverja: será que nadie sabrá cuál de los dos es el bueno.
Y fuera queda el registro del trabajo. Una tabla de tareas con responsables y fechas dentro de una página es un segundo gestor en la sombra, que nadie actualizará y que contradirá a Jira en diez días.
Cómo se configura para que no mienta
Hay que empezar por una limitación real, porque de lo contrario se promete algo que el producto no hace: Confluence no caduca páginas solo. No existe una función nativa que marque un documento como obsoleto pasado un tiempo ni que obligue a revisarlo. Hay un estado de página que alguien pone a mano, aprobaciones con fecha de vencimiento en los planes altos, archivado manual y un gestor de contenido que permite filtrar lo que lleva meses sin tocarse. Lo demás es disciplina, y conviene saberlo antes de prometer a un comité que la documentación se mantendrá al día sola.
La disciplina, eso sí, es barata si se monta una vez. Cada página tiene un propietario con nombre y apellidos, no un equipo. Cada tipo de documento tiene una plantilla que fuerza cuatro metadatos: propietario, fecha de última revisión, estado y trabajo relacionado. La navegación va por etiquetas y no por el árbol, porque el árbol lo diseña quien crea y las etiquetas las usa quien busca. Los espacios se organizan por servicio o por dominio, nunca por departamento. Y una vez al trimestre alguien filtra lo que lleva seis meses sin tocarse o tiene propietario dado de baja, y lo reasigna o lo archiva en bloque. Archivar, nunca borrar: lo archivado sale de las búsquedas pero conserva el enlace.
La página que de verdad acorta el plazo
De todo lo que puede vivir aquí, hay un documento que vale más que el resto junto: el que describe cómo tiene que funcionar lo que se va a construir. No es un documento de requisitos de cien páginas ni una presentación. Es una página por cosa que se decide, con una estructura fija y corta, y es la que usamos en el paso 3 del recorrido.
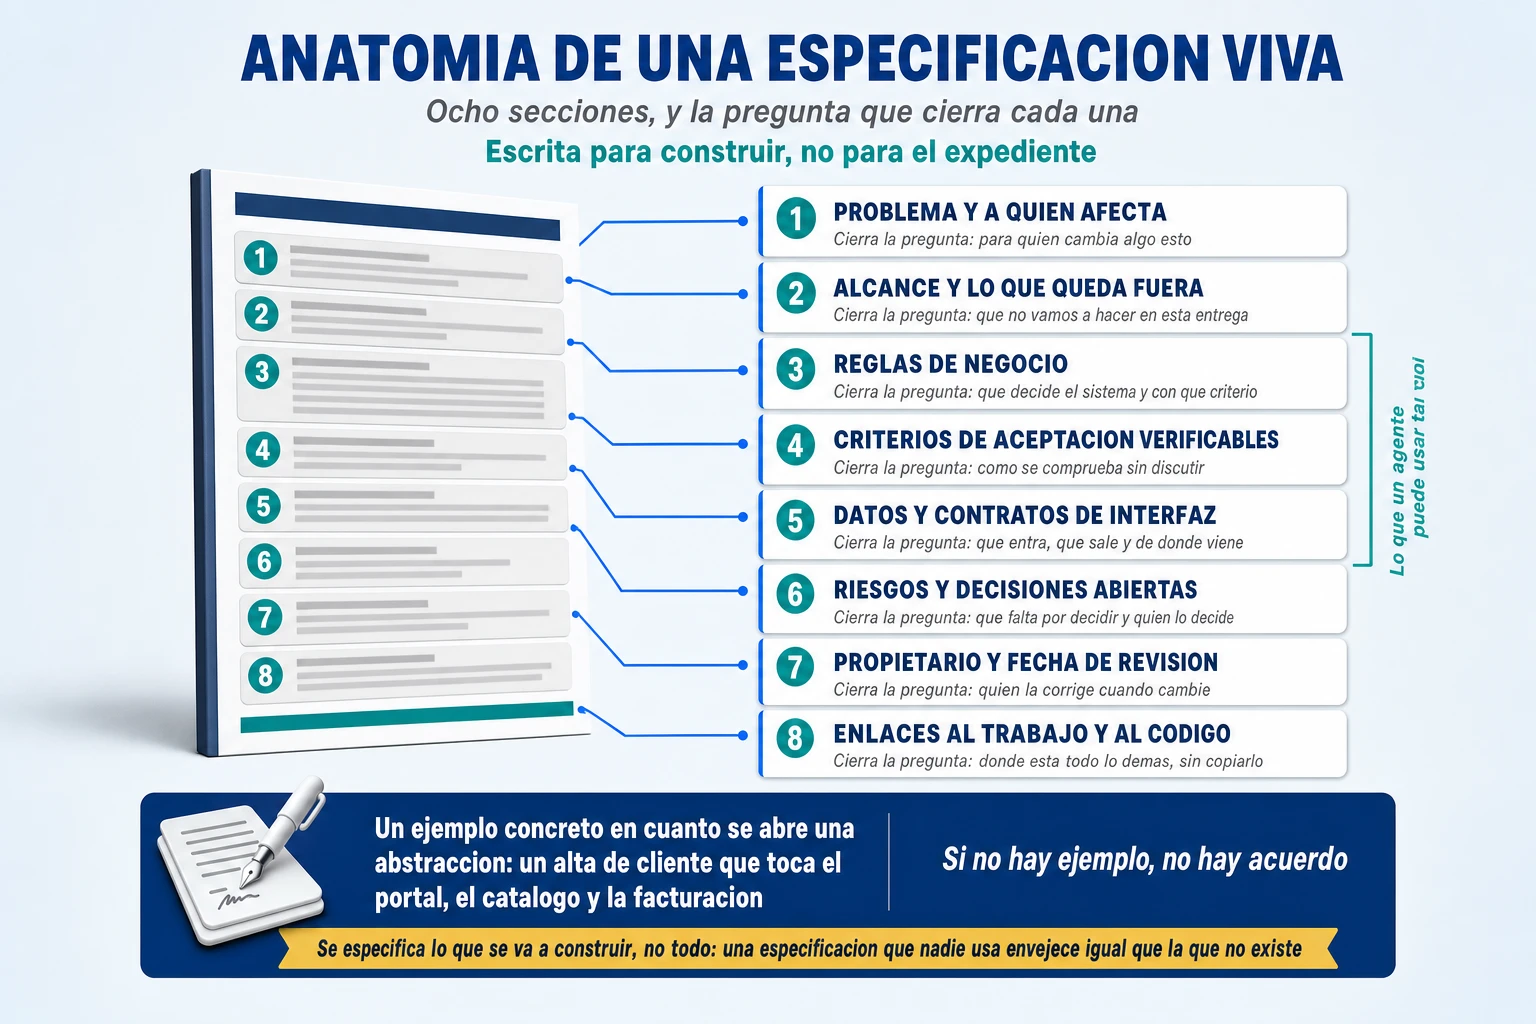
La contrapartida de todo esto es la misma decisión vista del otro lado: la libertad que hace útil a Confluence es la que la degrada. Un espacio sin propietarios, sin plantillas y sin poda trimestral no es neutro, es dañino, porque un buscador que devuelve cuatro versiones de la misma norma hace que la gente deje de buscar y vuelva a preguntar. El coste de mantenerlo es de una o dos horas al trimestre por responsable de servicio. Si esa inversión no se va a hacer, la recomendación honesta no es «usadlo igual»: es reducir drásticamente lo que se guarda y quedarse solo con las decisiones y las definiciones vivas.
Jira: todo el trabajo, no solo el software
Si Confluence es la herramienta que acepta demasiado, Jira es la que se configura demasiado. Responde a qué hay que hacer, quién lo tiene y en qué estado está, y el malentendido habitual es doble: tratarla como el repositorio de todo el ciclo de vida, y creer que es una herramienta de equipos de desarrollo.
Lo segundo es lo que más daño hace en el desarrollo de servicios, y conviene decirlo con todas las letras: la mitad del trabajo de lanzar un servicio no es software. En nuestro ejemplo, de seis bloques, tres no tocan una línea de código: el procedimiento de soporte, la formación del equipo de atención y el argumentario comercial. Y el servicio no sale sin ellos. Si esos tres bloques viven en una hoja de cálculo que lleva alguien de operaciones, en un correo y en la cabeza de un responsable de formación, la iniciativa no tiene un estado: tiene tres versiones del estado que nadie puede sumar.
Una nota de vocabulario, porque el fabricante lo ha cambiado dos veces en poco tiempo: lo que durante años fue una incidencia ahora se llama elemento de trabajo, y lo que era un proyecto ahora es un espacio. No cambia cómo funciona, pero sí data cualquier documento interno que use la nomenclatura antigua.
De la página de definición a las épicas: la articulación central del modelo
Este es probablemente el punto que más ilumina el conjunto, así que conviene verlo con nombres concretos. La página de definición del servicio contiene el objetivo, el recorrido del cliente, las reglas de negocio, las restricciones de arquitectura, los criterios de aceptación, las decisiones tomadas y las dependencias conocidas. De ahí, y desde la propia página, se crea una iniciativa única y, colgando de ella, una épica por cada frente de trabajo.
| Épica | Trabajos dentro | ¿Baja al repositorio? |
| Portal | Pantalla de contratación · validación del cliente · pantalla de confirmación | Sí |
| CRM | Nuevo tipo de pedido · lógica de cancelación en 24 horas | Sí, y en parte configuración |
| Facturación | Alta de la tarifa · activación y prorrateo | Configuración, no desarrollo |
| Plataforma de seguridad | Interfaz de alta · vuelta atrás si el alta falla a mitad | Sí |
| Operaciones | Procedimiento de soporte · monitorización y alertas | No |
| Atención | Formación del equipo · argumentario comercial · guía de incidencias | No |
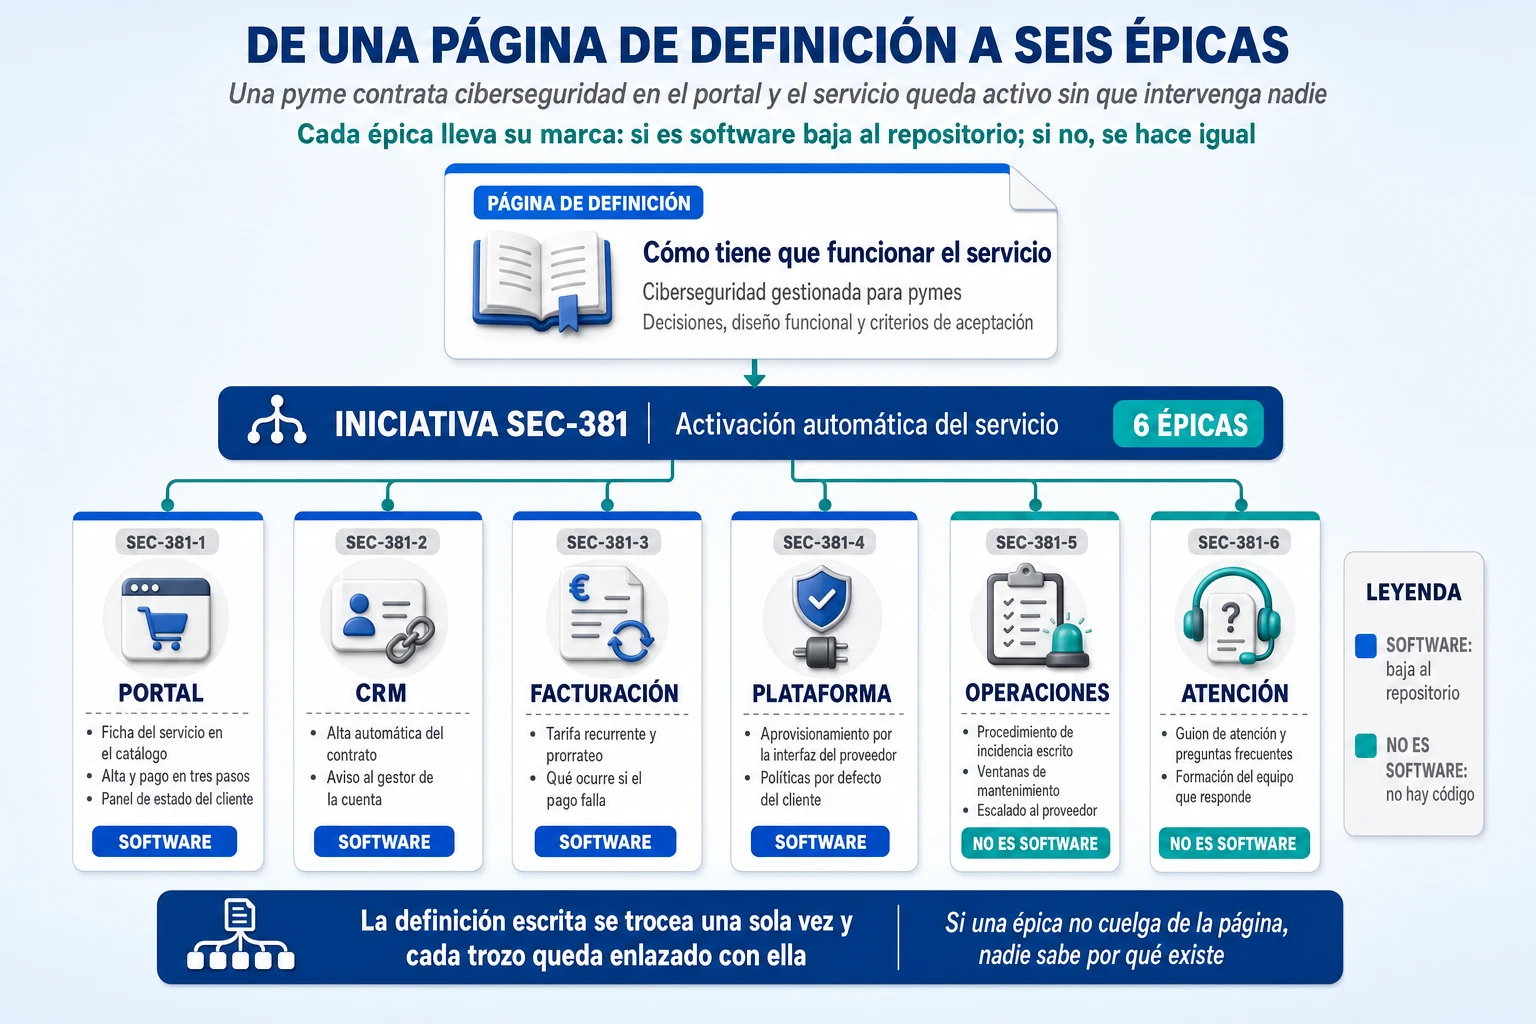
Lo que esta descomposición deja claro de un vistazo es que el gestor de trabajo no sustituye a la capa de conocimiento, la ejecuta. La página dice cómo tiene que funcionar el servicio; la iniciativa y sus épicas dicen qué hay que hacer para conseguirlo. Son dos preguntas distintas y por eso viven en sitios distintos, enlazados.
Y una precisión sobre el enlace, que es lo que decide si habrá trazabilidad: el trabajo se crea desde la página, no al revés. Si se crea en el gestor y alguien «luego pone el enlace», en una parte apreciable de los casos ese enlace no existirá nunca, y nadie lo echará de menos hasta el día que haya que responder qué decisión originó un cambio concreto.
Cómo se configura para que no mienta
Lo interesante de este apartado es que no hace falta citar a ningún consultor: la propia documentación de Atlassian recomienda mantener el flujo simple y limitar estados y transiciones, advierte de que cada estado añade complejidad para el equipo que trabaja dentro y sugiere construirlo con un representante de cada rol en vez de que lo diseñe un administrador en solitario. Es raro que un fabricante avise de que su función más vendida es la que más daño hace mal usada.
| Error de configuración | Qué rompe exactamente |
| Demasiados estados en el flujo | Nadie distingue «en revisión» de «pendiente de validación», y el tiempo de ciclo se fragmenta hasta volverse ilegible |
| Campos obligatorios al crear el elemento | Incentiva a no crearlo, o a rellenarlo con cualquier cosa para poder pasar |
| Un espacio por departamento | El plazo de punta a punta se parte en trozos que ya no suman, porque la iniciativa cruza espacios |
| Columnas del tablero que no son el flujo real | El diagrama acaba midiendo la configuración del tablero en vez del trabajo |
| No distinguir trabajar de esperar | Se ve qué va retrasado, pero no qué lo está causando, que es la única información accionable |
| Que solo los equipos de software usen la herramienta | La iniciativa parece terminada cuando el código está hecho, y faltan tres bloques |
La configuración que sí vale la pena es más sencilla de lo que parece. Pocos niveles de jerarquía —iniciativa, épica, historia y poco más—, pocos estados, y que cada uno tenga una condición de salida escrita: un estado que no dice cuándo se sale de él no es un estado, es una sala de espera con nombre bonito. Y la distinción que convierte el tablero en un instrumento de medida: separar los estados de trabajo activo de los de espera. Si el tablero tiene tres columnas, la eficiencia de flujo no se puede calcular, y eso ya es un diagnóstico.
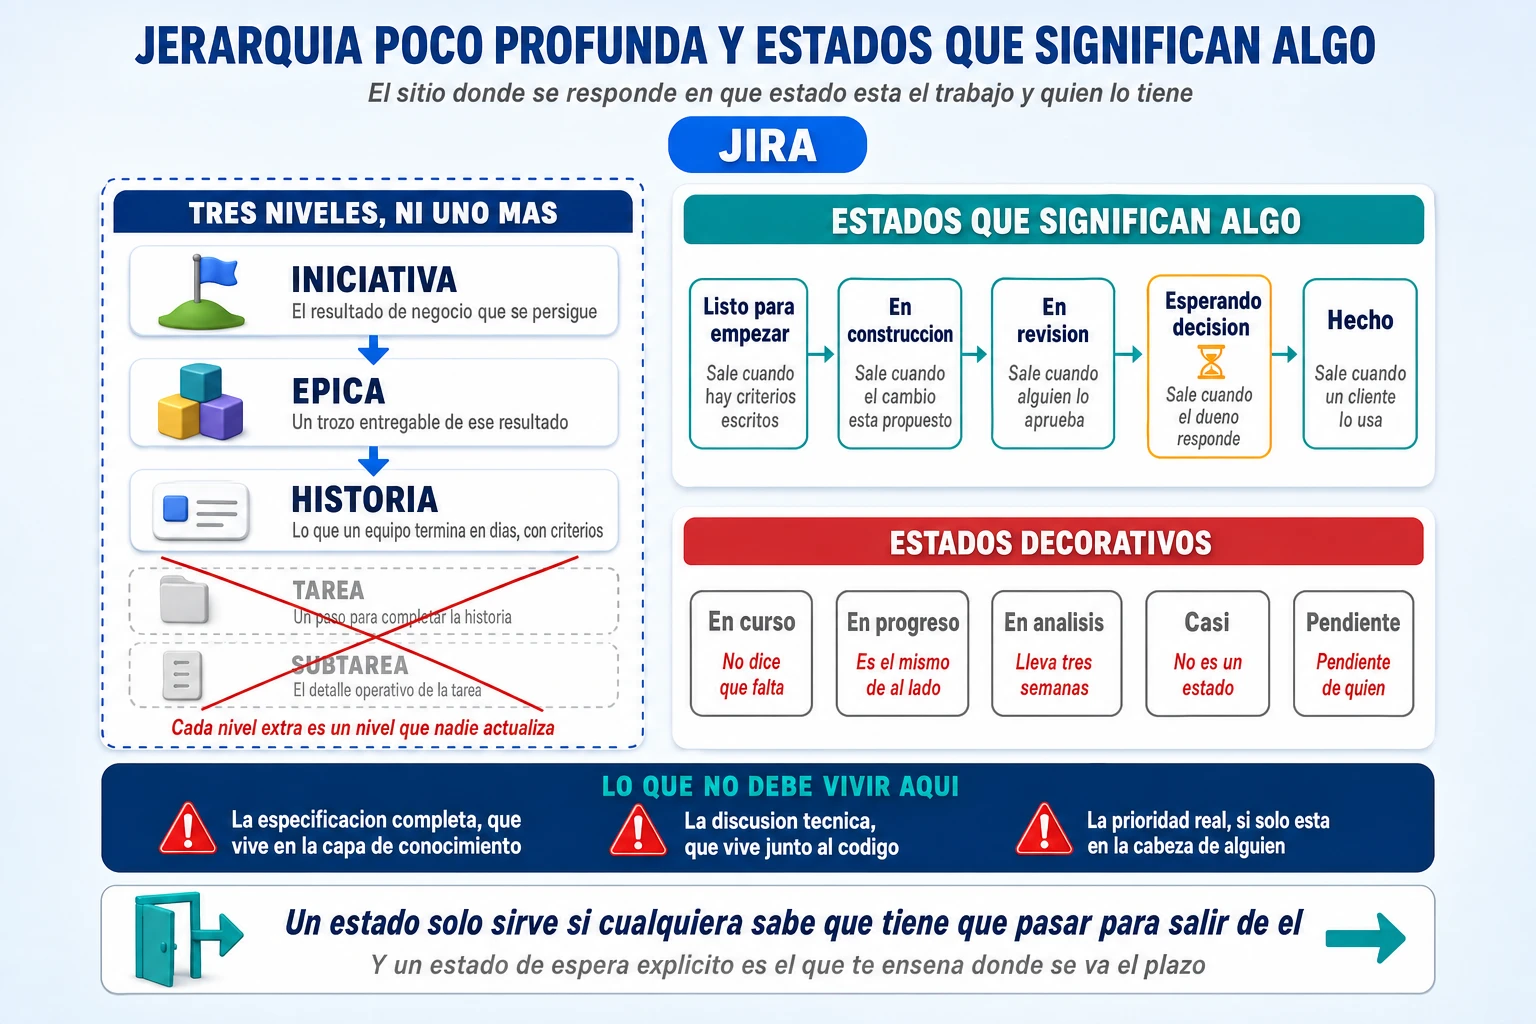
Una última advertencia sobre las métricas que la herramienta trae de serie, para evitar una decepción previsible: ofrece frecuencia de despliegue, plazo de entrega del cambio y tiempo de ciclo de las propuestas, pero no ofrece tasa de fallo de cambio ni tiempo de recuperación. Y las que sí ofrece dependen por completo de que alguien escriba el identificador del elemento en la rama y en el mensaje de cambio: miden la disciplina de nombrado antes que la capacidad de entrega.
GitHub: solo cuando el trabajo es software
Conviene empezar por donde termina la sección anterior, porque es la frontera que más confusión evita: GitHub no participa en la coordinación de la iniciativa. Participa en las épicas que son software, y en esas aporta algo que ninguna de las otras capas puede dar: la prueba de que lo construido funciona.
El malentendido habitual es tratarlo como el sitio donde se guarda el código, que es como describir un quirófano como el sitio donde se guardan los bisturís. Lo que lo hace relevante para una dirección y no solo para un equipo técnico es que cada cambio llega acompañado de su propio expediente: qué se modificó, por qué, a qué elemento de trabajo responde, qué comprobaciones pasó, quién lo revisó y con qué comentarios, y cuándo se desplegó. Eso sustituye al acta. La pregunta de auditoría «¿quién aprobó este cambio y con qué criterio?» deja de contestarse buscando un correo y pasa a contestarse abriendo un enlace.
El recorrido literal de un cambio
Tomemos un trabajo concreto de la épica de plataforma: crear la interfaz de alta del servicio. Supongamos que en el gestor tiene el identificador SEC-381. El recorrido completo, sin saltarse ningún paso, es este:
- Quien lo toma crea una rama cuyo nombre lleva el identificador:
feature/SEC-381-alta-ciberseguridad. No es estética: es el hilo. - Trabaja en un cambio pequeño y abre una propuesta de cambio cuyo título también lo lleva:
SEC-381 Interfaz de alta del servicio. - Abrir la propuesta dispara, sin que nadie haga nada, la secuencia de comprobaciones: compilación, pruebas unitarias, pruebas de integración, análisis estático del código, escaneo de dependencias, detección de credenciales y comprobaciones de calidad.
- Si algo falla, el cambio no avanza y quien lo propuso lo ve en minutos, no en la reunión del jueves.
- Si todo pasa, llega la revisión humana, que ya no comprueba si aquello compila: mira si la solución es la adecuada y si respeta las restricciones que venían de la definición.
- Al incorporarse el cambio, una automatización mueve
SEC-381al siguiente estado y el despliegue queda registrado contra ese elemento. - El entorno que exige aprobación espera a que alguien la dé, con el expediente completo a la vista de quien tiene que darla.
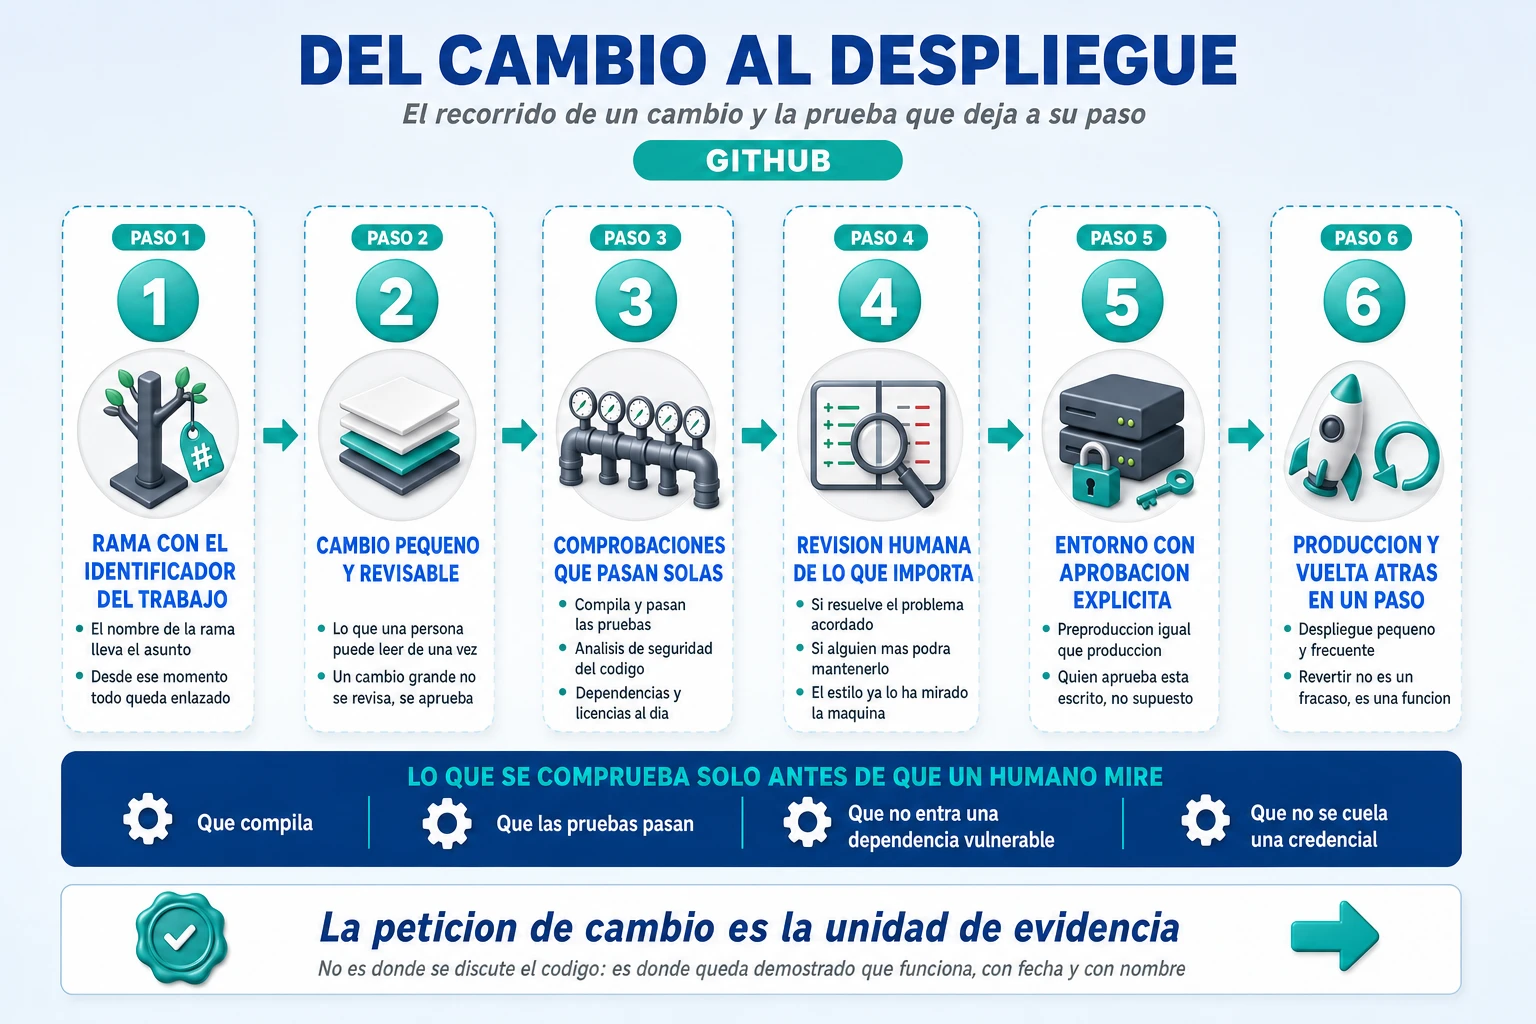
Fíjese en lo que no ha pasado en ningún punto de ese recorrido: nadie ha copiado información de una herramienta a otra. El identificador viajó en el nombre de la rama, la máquina hizo el resto, y el estado del trabajo se actualizó solo. Ahí está, en concreto, la promesa que recorre todo este artículo: que el contexto fluya sin que nadie lo reconstruya en cada traspaso.
De ahí se derivan las dos reglas de higiene que sostienen todo lo demás. Que las propuestas de cambio sean pequeñas, porque una revisión de ochocientas líneas no es una revisión, es una firma. Y que el identificador aparezca siempre; esto se puede forzar con una regla del repositorio en lugar de confiarlo a la buena voluntad, y conviene hacerlo, porque sin esa disciplina no hay panel, no hay métricas y no hay trazabilidad.
Encima de eso se configuran las condiciones de entrada a producción: qué comprobaciones son obligatorias, quién tiene que revisar según qué parte del sistema se toque y qué entornos exigen aprobación explícita. Aquí es donde el control deja de ser documental y pasa a ser ejecutable: la norma que dice «todo cambio en facturación lo revisa el equipo de facturación» puede estar escrita en una política que nadie lee, o puede estar configurada de forma que el sistema no deje incorporar el cambio sin esa revisión. La segunda opción no requiere recordárselo a nadie.
La contrapartida es que la cadena se ejecuta, y ejecutarse cuesta dinero. Las máquinas que corren esas comprobaciones se facturan por minuto, las más potentes no entran en ninguna bolsa incluida y las de determinados sistemas operativos cuestan un orden de magnitud más. A eso se han sumado dos consumidores nuevos que casi nadie presupuestó: la revisión automática de código y el entorno efímero donde trabaja un agente. Y hay un efecto menos obvio: cuando los cambios los empieza a proponer una máquina, la demanda de comprobaciones deja de crecer con el número de personas. Eso no es solo factura: es cola, y la cola de comprobaciones es una espera más.
Cuándo está terminado de verdad, y qué pasa después
En muchas organizaciones, «desarrollo terminado» significa que cuatro programadores han acabado algo. Mientras tanto, operaciones, formación, atención al cliente, observabilidad y documentación miran aquello como quien recibe un cachorro inesperado. Es el momento exacto en el que un proyecto que iba bien empieza a ir mal, y no se arregla con más seguimiento: se arregla cambiando la definición de terminado.
La regla es que la iniciativa termina cuando el servicio es operable, no cuando el código está escrito. Y eso se puede enumerar sin ambigüedad. Un incremento está listo para producción cuando se cumplen nueve condiciones:
- El software es desplegable y está desplegado en el entorno que corresponde.
- Las pruebas están superadas, incluidas las de extremo a extremo del recorrido del cliente.
- Seguridad está satisfecha, con las excepciones firmadas si las hay.
- Hay observabilidad: se puede ver si el servicio está funcionando y cuántas altas se completan.
- La vuelta atrás está definida y probada, no supuesta.
- El procedimiento operativo está escrito y el equipo que lo va a usar lo ha visto.
- El soporte está formado y sabe qué hacer cuando un cliente llame.
- La documentación del servicio está actualizada.
- Los criterios de aceptación de la definición se cumplen, comprobados y no supuestos.
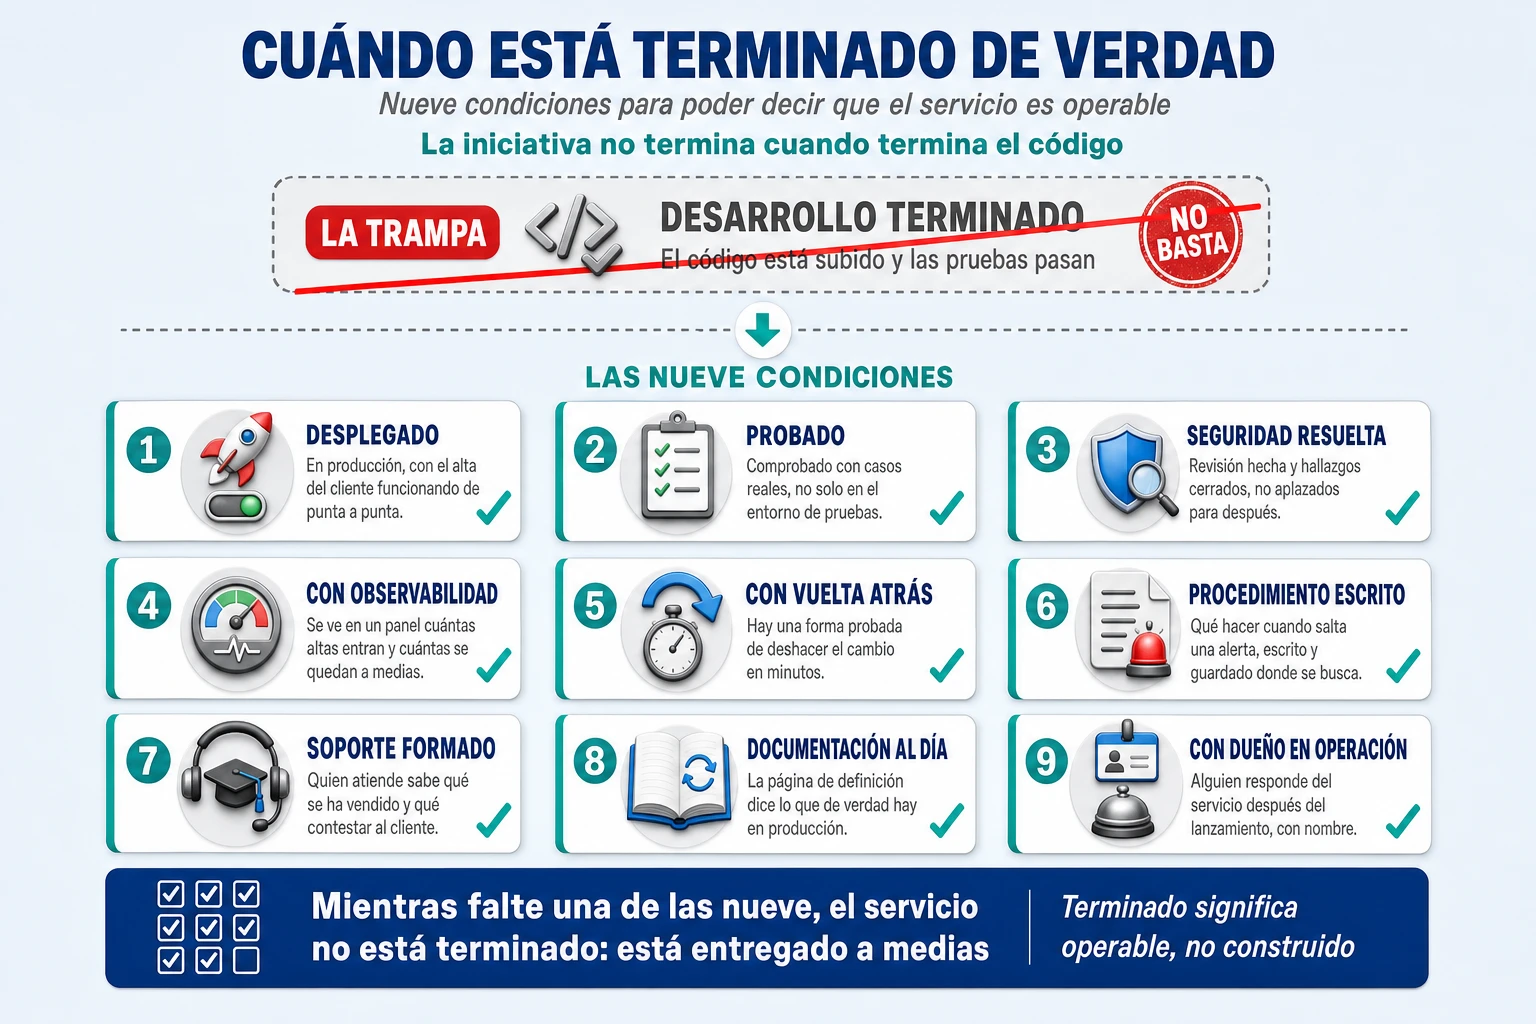
Lo práctico es que esto no tiene por qué ser una lista que alguien repasa a mano. Si todo el trabajo está en el mismo sitio y cuelga de la misma iniciativa, la condición de cierre es simplemente que las épicas necesarias estén cerradas. Si queda abierta la de preparar la guía de incidencias, la iniciativa no está lista, por impecable que esté el repositorio. El sistema lo dice solo, sin que nadie tenga que acordarse.
Y una consecuencia organizativa que conviene aceptar de antemano: con esta definición, la fecha de lanzamiento la marca el último bloque, que casi nunca es el software. Eso incomoda, y es precisamente la información que una dirección necesita tener seis semanas antes y no la víspera.
Y después del lanzamiento, el aprendizaje vuelve al origen
Aquí es donde el modelo deja de ser una línea y se convierte en un bucle, que es lo que lo distingue de un proceso en cascada bien pintado.
Tres semanas después del lanzamiento aparecen incidencias: a determinados clientes el alta se les queda a medias. Con el hilo montado, se puede recorrer la cadena hacia atrás sin preguntar a nadie: desde la incidencia hasta el despliegue que la introdujo, de ahí al cambio concreto, de ahí al elemento de trabajo, y de ahí a la regla de la definición que lo originó. Es la pregunta que nadie sabe contestar en la mayoría de las organizaciones.
Pero lo importante no es la arqueología, es lo que se hace con ella. Si se descubre que fallan los clientes que ya tenían un contrato previo, la reacción correcta no es arreglar el código. Es, en este orden: corregir en la definición del servicio cuál debe ser el comportamiento correcto en ese caso, porque la regla estaba mal o estaba incompleta; generar desde ahí el trabajo nuevo que haga falta; y, si toca software, que ese trabajo acabe en un cambio en el repositorio. Arreglar solo el código deja la definición mintiendo, y la próxima persona que la lea —o el próximo agente que la use como contexto— volverá a construir el error.
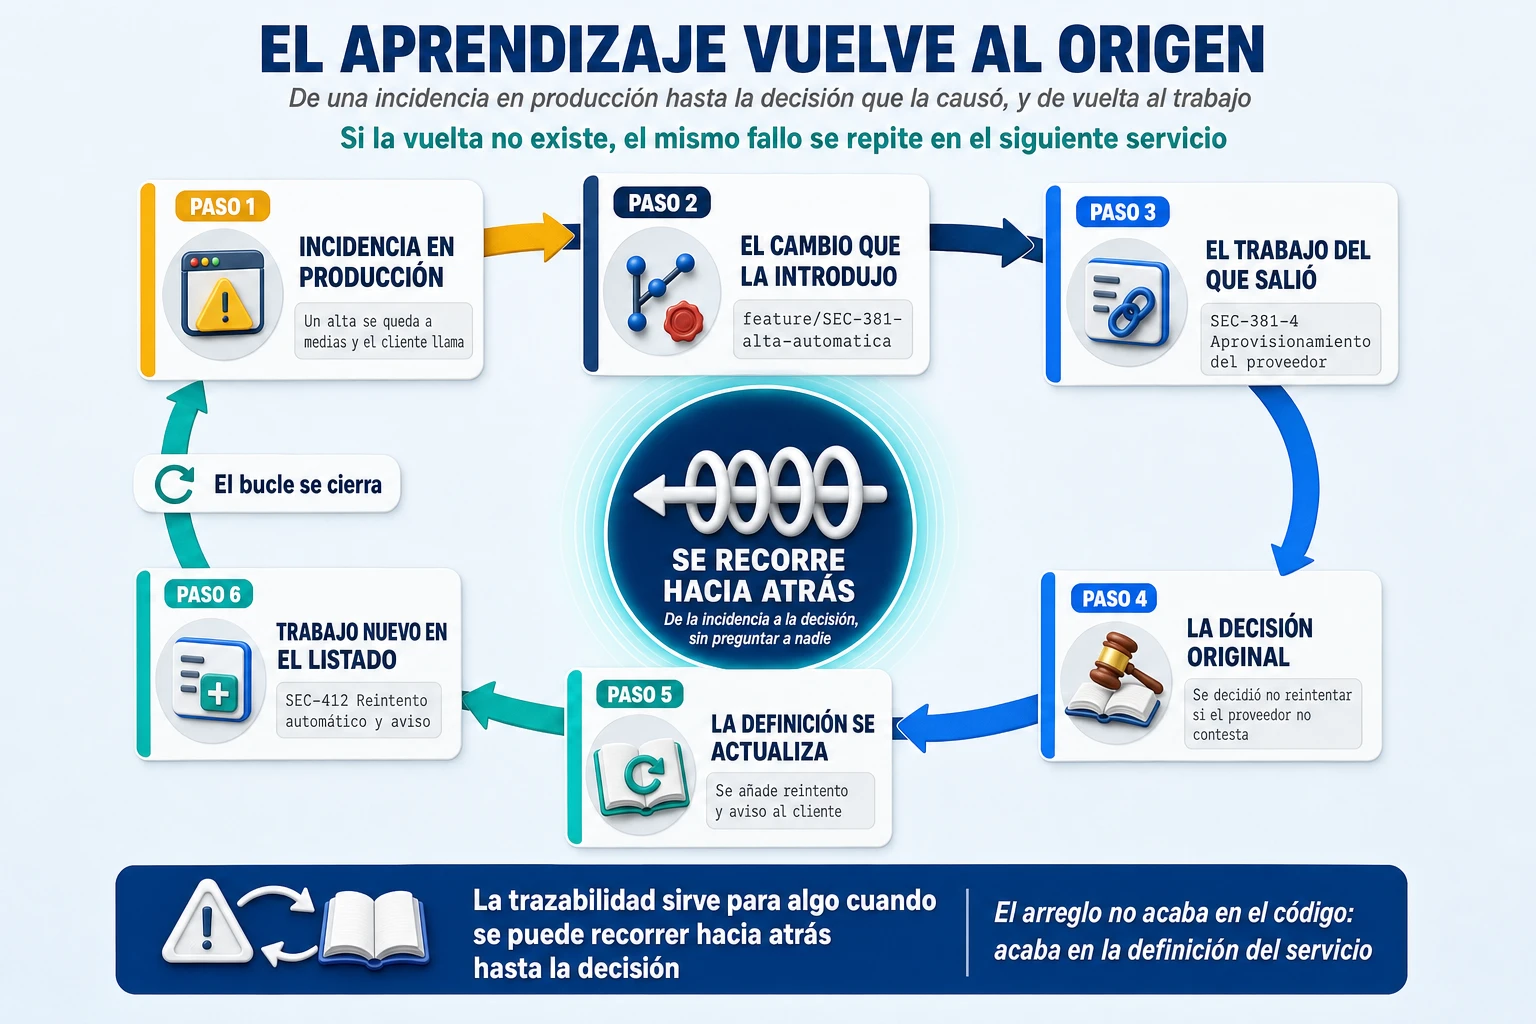
Ese bucle es también lo que convierte la operación en algo más que un coste. Cuando el comportamiento real del servicio está enlazado con lo que se decidió construir, se pueden responder preguntas que normalmente no tienen respuesta: qué reglas del servicio generan más incidencias, qué parte del recorrido del cliente concentra los abandonos, y si la funcionalidad que costó seis semanas la está usando alguien. Es el único mecanismo que impide que el siguiente incremento se decida igual que el anterior: por intuición.
Teams y Microsoft 365: la conversación no es la memoria
Hay un detalle que casi todos los modelos de este tipo omiten y que decide si el montaje funciona o se queda en una buena idea: nadie pasa el día dentro de Jira. En la mayoría de las empresas grandes, el trabajador vive en Teams, en el correo, en un documento compartido y en una presentación. Un modelo operativo que exija a producto, a operaciones y a atención al cliente vivir en un tablero de ingeniería no se incumple por mala fe: se incumple porque es irreal.
La solución no es elegir bando entre un ecosistema y otro, que es una dicotomía artificial. Es asignarle a cada uno el papel que le corresponde, y para Teams el papel es muy concreto: es donde se habla, no donde se recuerda. Sirve para conversar, reunirse, decidir en caliente, avisar y, cada vez más, para pedirle cosas a un asistente. Lo que no puede ser es el sitio donde queda la decisión.
Volvamos al paso 6 del recorrido, cuando alguien plantea que el cliente debería poder cancelar durante veinticuatro horas. Esa conversación ocurre en Teams y está bien que ocurra ahí. Lo que tiene que pasar después es un movimiento en tres tiempos que conviene convertir en costumbre explícita del equipo:
- La regla acordada se añade a la página del servicio, que es donde vive el acuerdo.
- El trabajo que genera se crea como elementos en el gestor, colgando de la misma iniciativa.
- El cambio de software, si lo hay, acaba en una propuesta de cambio en el repositorio.
Qué se puede conectar de verdad, y cuál es el peaje
Aquí conviene ser preciso, porque es terreno donde abunda el entusiasmo y escasea la letra pequeña. La buena noticia es que las piezas existen y son de primera parte: Microsoft publica conectores propios, en disponibilidad general, para indexar Confluence y Jira —y también incidencias, documentación y propuestas de cambio de GitHub— dentro de su propio índice. Es decir, el triángulo completo se puede buscar desde Teams, desde el correo y desde el buscador corporativo, con la cita a la fuente original. Eso sostiene buena parte de lo que promete este artículo.
La mala noticia es que cada integración tiene un peaje, y conviene conocerlos antes de prometer nada en un comité. Son cuatro y ninguno es menor.
| El peaje | Qué significa en la práctica |
| La licencia | Con un Microsoft 365 normal, el conector alimenta la búsqueda pero no alimenta al asistente. Para que responda citando Confluence hace falta el complemento de pago, por cada persona que vaya a preguntar |
| Lo que no se indexa | Páginas y entradas, sí. Comentarios, no. Tampoco el historial de versiones, ni los borradores, ni lo archivado. En Jira se indexa el cuerpo de la incidencia, no su hilo de comentarios |
| La latencia de permisos | El contenido se refresca cada pocos minutos, pero los cambios de permisos pueden tardar hasta veinticuatro horas en reflejarse. Quitar a alguien de un espacio no le quita el acceso inmediatamente desde el buscador |
| La identidad | El emparejamiento entre cuentas se hace por correo electrónico. Con fusiones, varios dominios o cuentas de proveedor, hay que configurar la correspondencia a mano o parte del contenido no aparecerá |
El segundo peaje merece una frase aparte porque tiene una consecuencia directa sobre cómo hay que trabajar: si su equipo cierra las decisiones en los comentarios de una página, el asistente no las verá nunca. No es un fallo del producto, es cómo está construido el índice. Y es un argumento inesperadamente bueno a favor de la disciplina que este artículo defiende: la decisión no se queda en el hilo de comentarios, se incorpora al cuerpo de la página. Antes eso era higiene documental; ahora decide si la máquina puede ayudar o no.
Hay un quinto detalle, más arquitectónico, que conviene conocer si en su organización manda el responsable de seguridad. Microsoft tiene dos familias de conectores: los que copian el contenido a su índice y los que consultan en vivo la fuente sin copiar nada. Para Atlassian hoy solo existe la primera. La opción que muchos responsables de seguridad preferirían —no sacar el dato de su sitio— no está disponible para Confluence ni para Jira, y conviene saberlo antes de la reunión y no durante.
En cuanto a lanzar trabajo desde la conversación —pedirle a un agente que implemente un cambio sin salir de Teams—, existe, funciona y está en vista previa, con requisitos que no son triviales: plan de pago del asistente de desarrollo, entornos en la nube habilitados por el propietario de la organización y permiso de escritura en el repositorio. Los invitados y los colaboradores externos no pueden, lo que en un modelo con proveedores no es un detalle menor. Es una capacidad real y prometedora; presentarla hoy en un comité como algo consolidado es exagerar.
Hay una variante más madura y bastante menos conocida que cierra el circuito del que habla todo este artículo: el agente de desarrollo se puede lanzar desde el propio elemento de trabajo, asignándoselo como a una persona, mencionándolo en un comentario o —esto es lo interesante— disparándolo desde una regla de automatización cuando el elemento cambia de estado. El agente lee el contexto del elemento, incluidos los criterios de aceptación, trabaja y abre la propuesta de cambio enlazada. El trabajo definido se convierte en una propuesta de código sin que nadie copie nada entre herramientas. Exige las dos aplicaciones instaladas y los permisos de administrador de los dos lados, y una advertencia que la documentación hace explícita y conviene no pasar por alto: si el repositorio es público, el contenido del elemento de trabajo acaba siendo visible en la propuesta de cambio.
La recomendación, entonces, es menos vistosa y más útil de lo que suele oírse: empiece por la búsqueda y la citación, que es lo maduro, y trate lo demás como un piloto con fecha de revisión. Que una persona de atención al cliente pueda preguntar en su entorno habitual cómo se comporta el servicio cuando el alta falla, y obtener la respuesta con el enlace a la página donde está escrita, ya elimina una ronda de correos. Eso es poco espectacular y se nota el primer día.
Quién mueve la información de una herramienta a otra
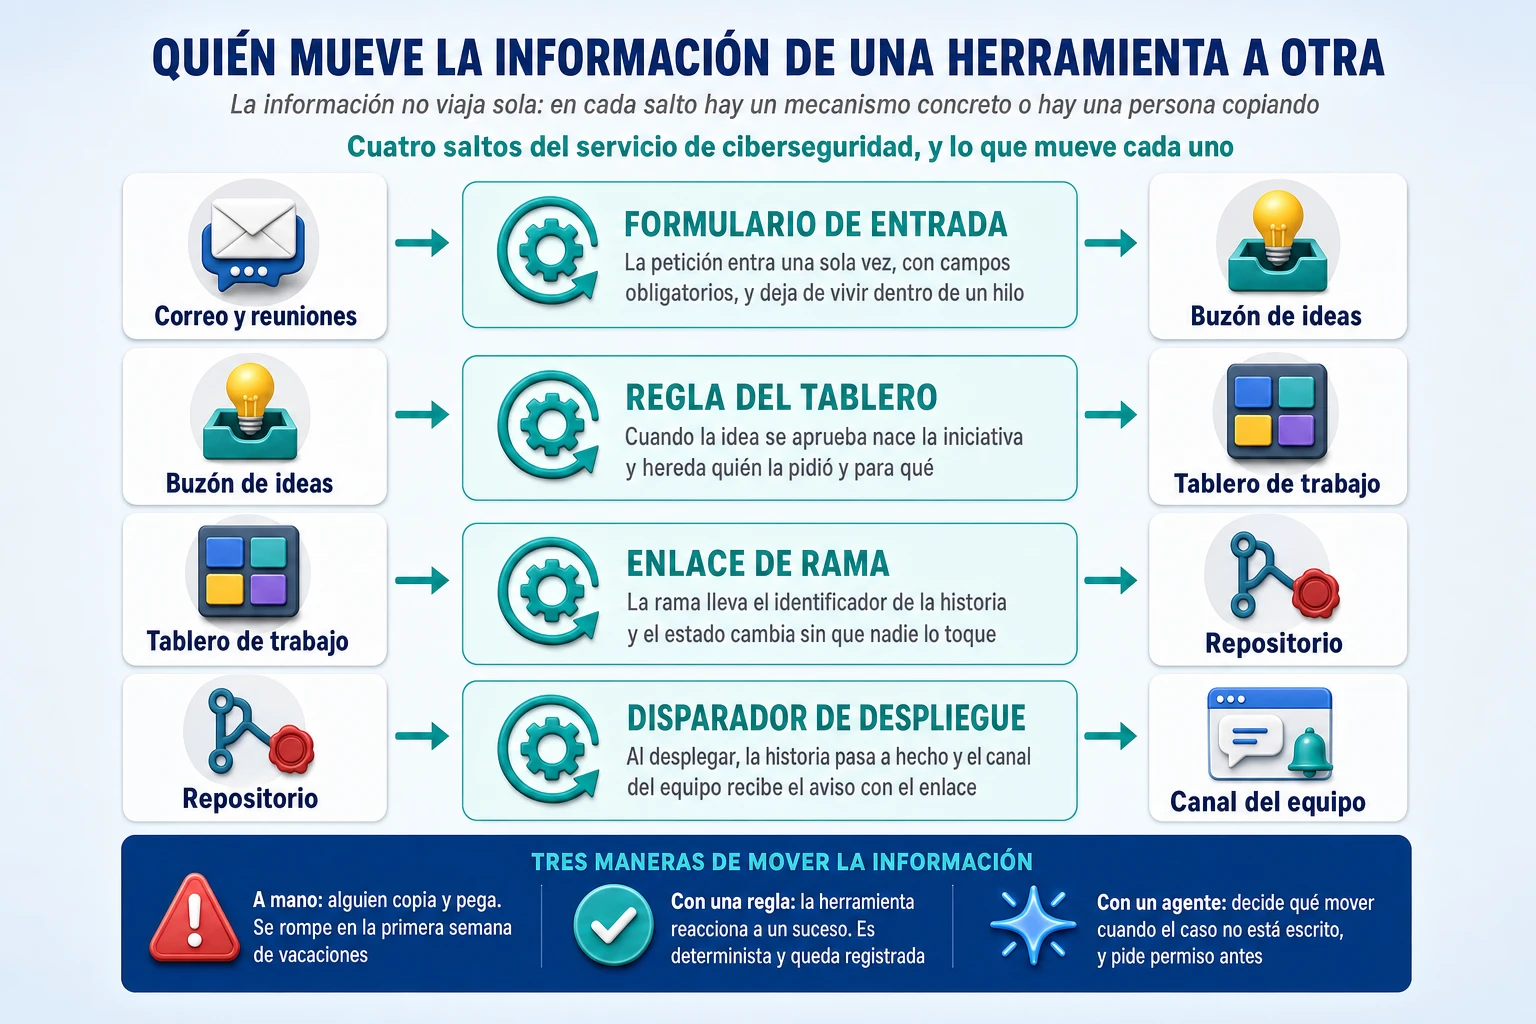
Llegados aquí hay un hueco en el razonamiento que conviene tapar, porque es donde fracasan la mayoría de estos montajes. Hemos dicho que la definición del servicio está en una capa, el trabajo en otra y el software en una tercera, y que todo queda enlazado. Pero alguien tiene que mover esa información, y si ese alguien es una persona, el modelo no se sostiene.
Es la capa que nadie presenta en un comité porque no tiene logotipo y no ilusiona a nadie. También es la que decide si el sistema funciona en marzo o si en marzo hay un analista dedicando media jornada semanal a copiar estados de un sitio a otro, que es el final más común de estas historias.
Lo primero es darse cuenta de que no hay un mecanismo, hay cuatro, y cada salto pide uno distinto.
| El salto | Con qué se mueve | Qué hay que saber |
| De la decisión al trabajo | Crear los elementos desde la propia página | No es automatización, es orden de creación. Si se hace al revés, el enlace no existirá en un tercio de los casos |
| Entre elementos de trabajo | Reglas nativas del gestor | Es lo más barato y lo más infrautilizado. Ojo al consumo: se cuenta por pasos ejecutados, no por reglas, con asignación mensual por usuario según el plan y exceso facturable. Si se desactiva el exceso, los flujos dejan de ejecutarse hasta el siguiente ciclo |
| Del repositorio al estado del trabajo | Eventos del repositorio más una automatización que escucha | Fiable. Lo que no es fiable es cambiar el estado con una palabra escrita en el mensaje de un cambio: falla en silencio si hay campos obligatorios |
| Del repositorio a la documentación publicada | Un flujo propio contra la interfaz de programación | No hay camino oficial. La dirección tiene que ser siempre del repositorio hacia la documentación, nunca al revés |
| Hacia el entorno de colaboración | Avisos y resúmenes generados, no escritos | Es el salto más fácil y el que más tiempo devuelve: sustituye la preparación manual del informe semanal |
Sobre la plataforma de automatización corporativa conviene una advertencia práctica que ahorra una sorpresa presupuestaria. Existe un conector oficial para conectar el gestor de trabajo con las herramientas de automatización de Microsoft, lo publica Microsoft y funciona; pero es un conector de categoría premium, lo que significa licencia adicional de la plataforma para cada usuario o para cada flujo. Es perfectamente asumible y es exactamente el tipo de detalle que no aparece en la diapositiva y sí en la factura.
Y dos reglas de diseño que valen más que la elección de producto. La primera: empiece por los dos o tres saltos que hoy hace una persona a mano, no por automatizarlo todo. En nuestro ejemplo son casi siempre los mismos tres: crear el trabajo desde la definición, actualizar el estado cuando el cambio llega a producción, y generar el informe de estado de la iniciativa. Esos tres eliminan la mayor parte del trabajo administrativo y no requieren ninguna plataforma nueva.
La segunda: cuando un automatismo falle —y va a fallar— tiene que notarse. Un flujo que deja de ejecutarse en silencio es peor que no tenerlo, porque el equipo sigue confiando en una información que ya no se actualiza. Cada automatismo necesita un responsable con nombre y un aviso cuando se rompe, igual que cualquier otra pieza de producción.
Y conviene saber que los avisos entre sistemas son menos fiables de lo que parece, porque esto sorprende a mucha gente la primera vez. Quien emite el evento espera una respuesta en segundos y, si no la recibe, reintenta un número limitado de veces y se rinde; no hay garantía de que los avisos lleguen en orden; puede haber duplicados; y algunas suscripciones caducan solas al cabo de unas semanas si nadie las renueva. Por eso toda integración que importe lleva encima una reconciliación periódica: un proceso que compara los dos lados y corrige lo que se haya perdido. Sin eso, el sistema no falla de golpe, se desincroniza despacio, que es peor.
Queda una conclusión incómoda que conviene decir en voz alta, porque es la que decide el calendario real. El cuello de botella de este montaje no es técnico, es de licencias y permisos. Todos los caminos descritos exigen roles que un equipo de producto no tiene: administrador de inteligencia artificial en el entorno de Microsoft, administrador del sitio en la capa de trabajo, propietario de la organización en el repositorio. Y la suma de licencias, para una persona que lo use todo, no es marginal: hay que contar el complemento del asistente del empleado, la licencia premium de automatización si se toca el gestor de trabajo, la del asistente de desarrollo, más el consumo variable de los componentes de inteligencia artificial. Es una decisión de presupuesto y de gobierno, no un proyecto de integración, y plantearla como lo segundo es la forma más fiable de que se atasque tres meses en un comité que no sabía que le tocaba decidir.
La cadena de trazabilidad, que es lo que de verdad se está montando
Todo lo anterior tiene un único propósito, y conviene enunciarlo porque es lo que justifica el esfuerzo: que exista una cadena que se pueda recorrer en los dos sentidos. Hacia abajo responde qué se construyó a partir de qué. Hacia arriba responde por qué el sistema se comporta como se comporta.
En nuestro ejemplo la cadena completa es esta: objetivo de negocio, oportunidad registrada, definición del servicio, decisión de arquitectura, iniciativa, trabajos, cambio de software, pruebas, despliegue, comportamiento en producción e incidencia. Once eslabones, y el hilo que los cose es sorprendentemente humilde: el identificador del elemento de trabajo escrito en la rama, en el mensaje de cambio y en el título de la propuesta.
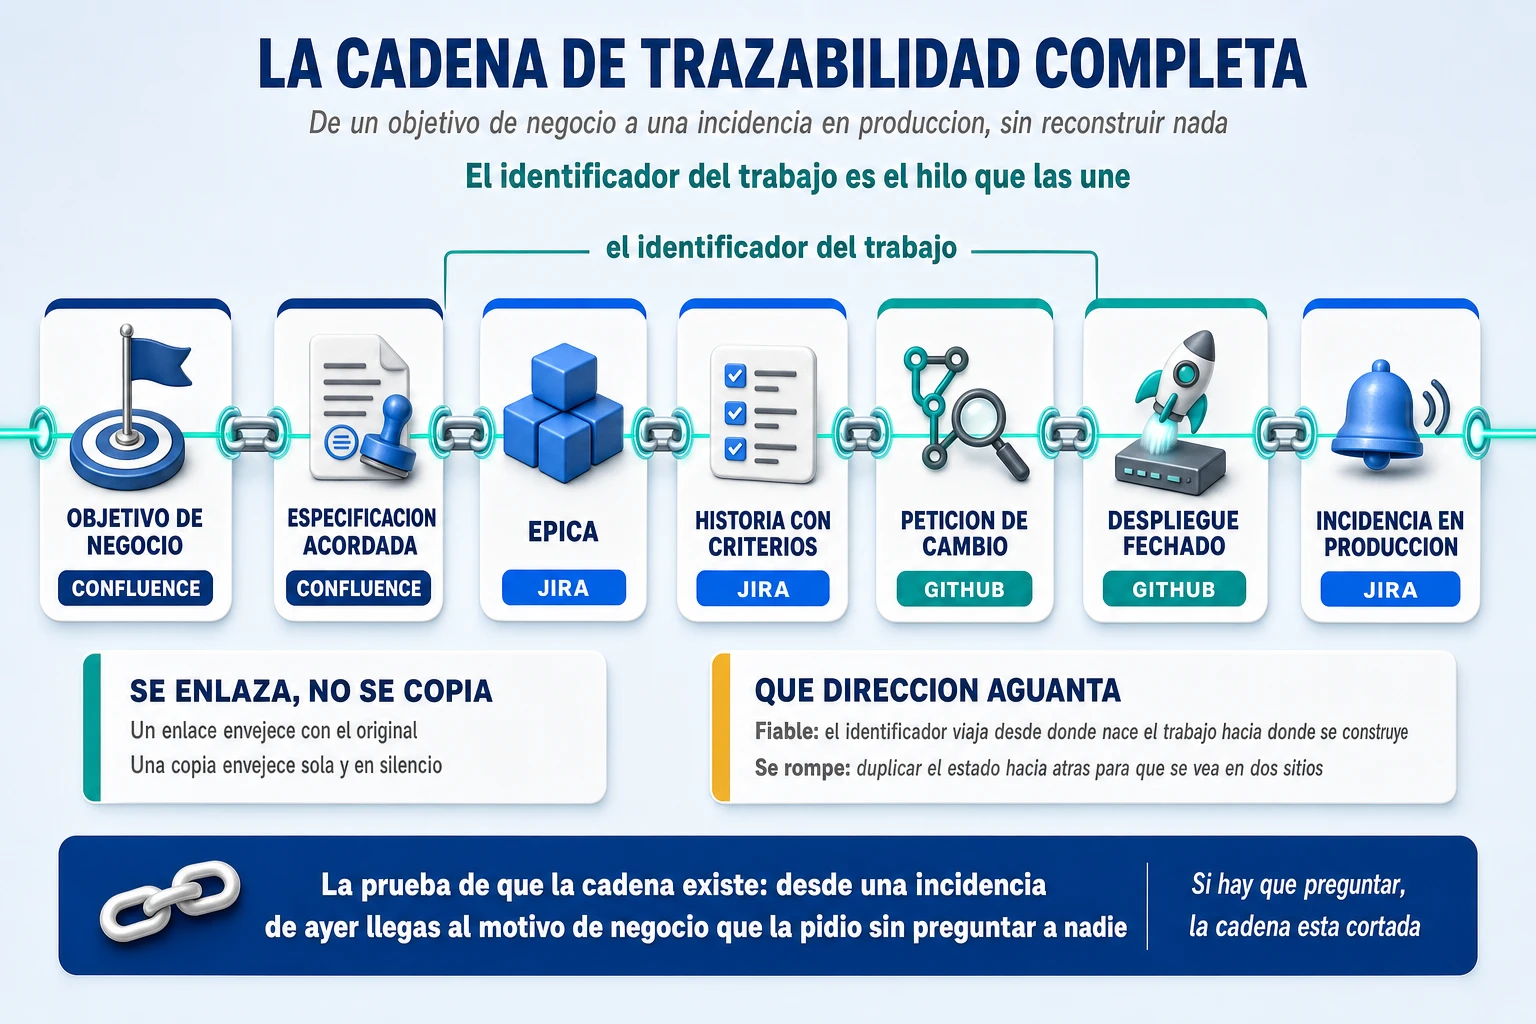
El principio que la mantiene viva cabe en tres palabras: se enlaza, no se copia. Cada vez que alguien copia el contenido de un sitio a otro crea una segunda versión que envejecerá por su cuenta. Y hay dos preguntas concretas que sirven para comprobar si la cadena existe de verdad, porque son las que se hacen en la vida real: ¿qué decisión originó este cambio? y ¿qué trabajo salió de esta decisión?. Si alguna de las dos exige preguntar a una persona, la cadena está rota en algún punto y conviene localizar cuál.
Conviene conocer tres límites que sorprenden a quien construye encima sin leer la letra pequeña: el panel que muestra la actividad de desarrollo dentro de un elemento de trabajo enseña los primeros cien cambios y no más; determinadas vistas agregadas dejan de funcionar por encima de cien elementos; y desinstalar la aplicación de integración borra el histórico de despliegues acumulado. Ninguno es grave si se sabe de antemano; los tres lo son si se descubren el día que alguien pide un informe anual.
No hay un copiloto, hay tres
Esta es probablemente la confusión más cara de todas las que rodean a este asunto, y es fácil de deshacer. Cuando en un comité alguien dice «ya tenemos copiloto», hay tres cosas distintas que puede querer decir, con tres licencias distintas, tres ámbitos distintos y tres dueños distintos dentro de la organización. Comprar uno y esperar los beneficios de otro es un error que se comete con una frecuencia notable.
| Ámbito | Dónde trabaja | Para qué sirve | Lo que no hace |
| El del empleado | Correo, reuniones, documentos, chat y, con el complemento de pago, el contenido indexado de las demás herramientas | Entender, buscar, resumir y preparar: encontrar la decisión de hace ocho meses, resumir una reunión, redactar un primer borrador | No ejecuta trabajo dentro del proceso ni toca el código |
| El del proceso | Sobre el trabajo y el conocimiento: elementos del gestor, páginas, flujos | Actuar sobre el proceso: enriquecer un elemento, detectar duplicados y dependencias, generar el informe de estado, disparar algo cuando el trabajo cambia de estado | No escribe el software ni sustituye la decisión de negocio |
| El del software | Repositorio, incidencias técnicas, propuestas de cambio, pruebas y tuberías | Convertir trabajo ya definido en software, y revisarlo | No coordina la iniciativa ni ve el trabajo que no es software |
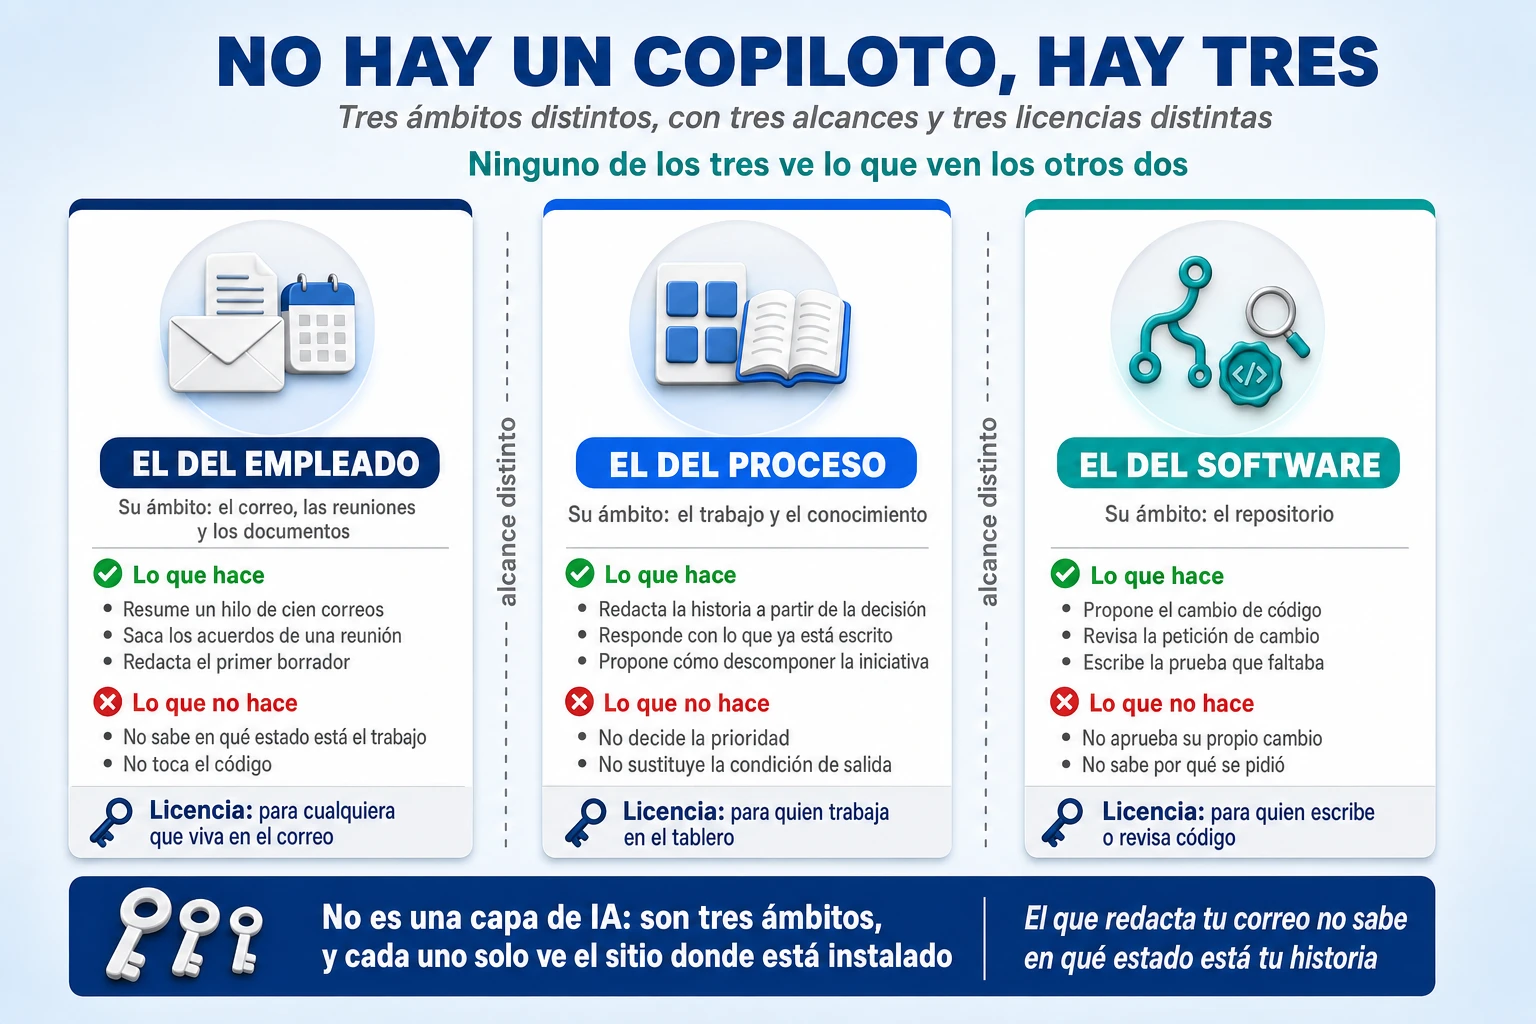
La utilidad práctica de esta distinción es que permite asignar responsable y presupuesto por separado, y sobre todo permite diagnosticar. Si la queja del equipo es «perdemos horas buscando dónde está escrito esto», el que falta es el primero. Si la queja es «nos pasamos el viernes preparando el informe de estado y actualizando tickets a mano», el que falta es el segundo. Y si la queja es «tardamos en convertir una historia en código», el tercero. Son problemas distintos y se resuelven con compras distintas.
En nuestro ejemplo los tres aparecen y en momentos distintos. El del empleado, cuando alguien de atención pregunta en su entorno habitual qué pasa si el alta falla a mitad y recibe la respuesta con el enlace a la página donde está escrita. El del proceso, cuando al crearse los seis bloques de trabajo alguien los enriquece con las dependencias que ya existen entre portal, CRM y facturación, y cuando el informe de estado del lanzamiento se genera leyendo el estado real en vez de preguntando a seis personas. Y el del software, cuando un desarrollador le pasa la interfaz de alta ya definida y recibe un borrador de implementación con sus pruebas.
Dónde aporta de verdad, fase por fase
La conversación sobre inteligencia artificial en desarrollo empieza casi siempre por la codificación, que es donde las herramientas están más maduras. Es un punto de entrada razonable y un modelo objetivo pobre, por la aritmética del principio: si la construcción son cuatro días de setenta, hacerla el doble de rápida devuelve dos días.
Hay un patrón que ordena todo esto y conviene tenerlo presente: la inteligencia artificial funciona bien generando material que después juzga una persona, y funciona mal cuando la que juzga es ella. Casi todas las decepciones documentadas caen del lado de pedirle el juicio en vez del borrador.
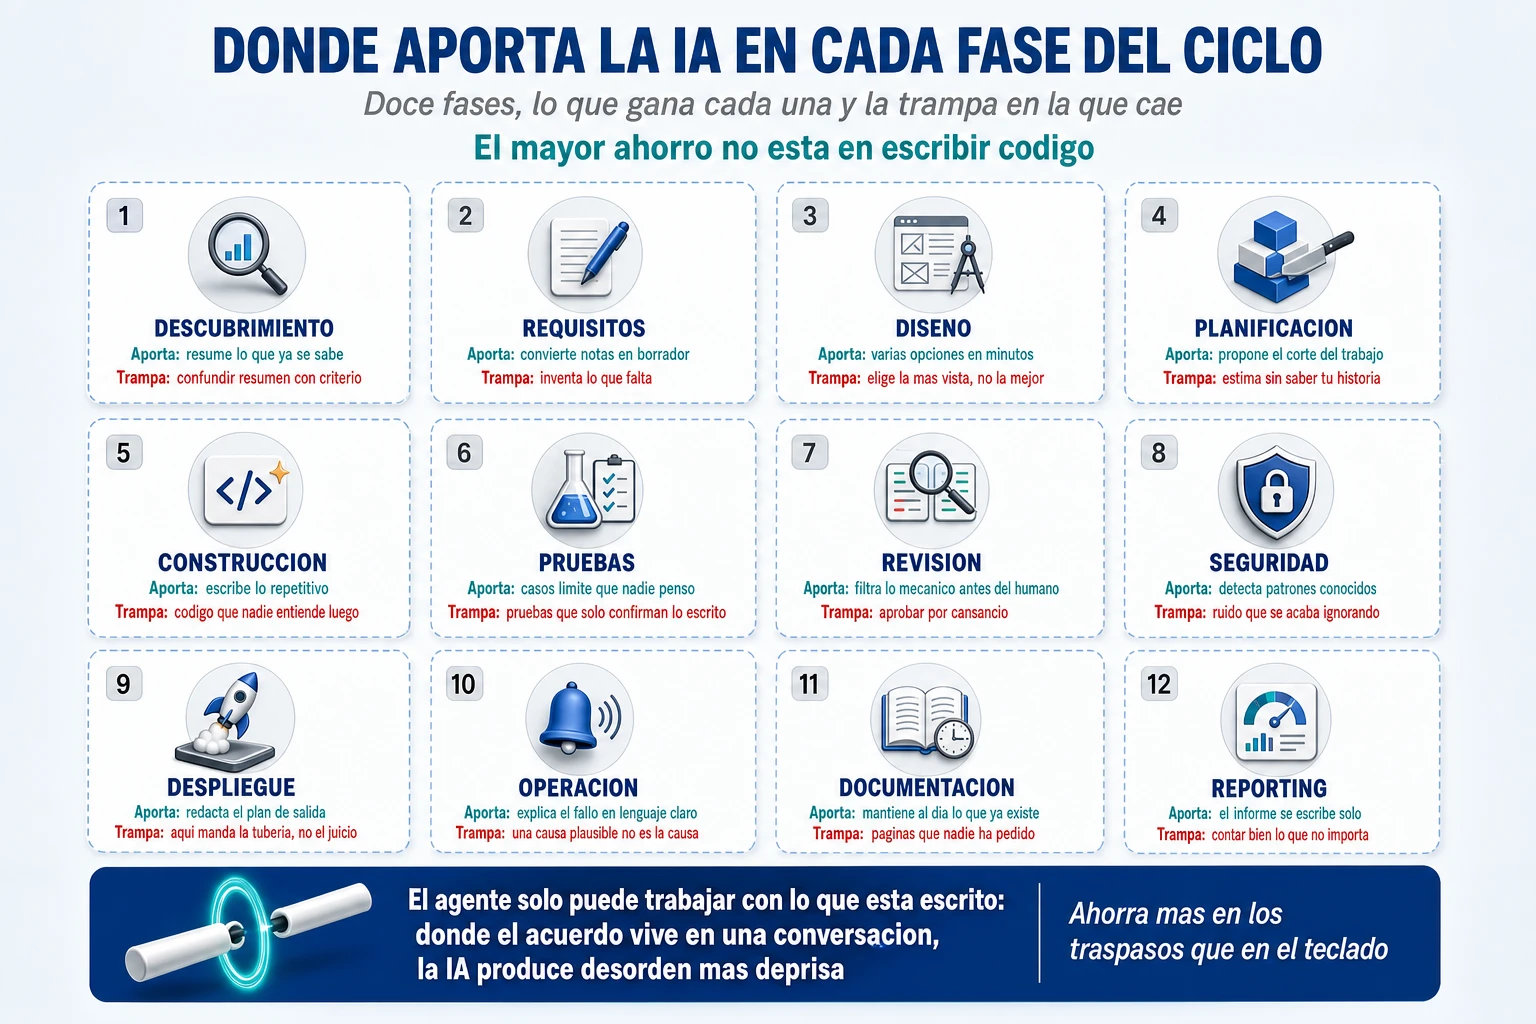
En la parte de arriba del recorrido —descubrimiento, definición, diseño— está el ahorro menos visible y probablemente el mayor, porque es donde se generaban las esperas de aclaración. Un asistente con acceso al conocimiento de la organización puede responder si ya existe algo parecido, qué sistemas toca históricamente un cambio de este tipo y qué salió mal la última vez. En nuestro ejemplo, eso es saber en minutos que el alta de otro servicio ya resolvió el caso del cliente con contrato previo, y cómo. Lo que antes era una ronda de correos a cuatro personas.
Hay un resultado experimental que conviene conocer antes de entusiasmarse con la revisión automática de requisitos: en una evaluación de detección de defectos, el sistema encontró en torno a la mitad de los problemas reales con una tasa apreciable de falsas alarmas, y —esto es lo incómodo— la inspección humana empeoró cuando se hizo con su apoyo. La explicación más plausible es el anclaje: quien revisa con una lista delante comprueba esa lista en vez de leer con ojos nuevos. La conclusión no es renunciar, es no sustituir la revisión humana por la asistida sin medir qué pasa.
En la codificación, la horquilla defendible con estudios de campo serios va de una ralentización modesta a una ganancia de en torno al veintiséis o cuarenta por ciento en tareas completadas. El mejor dato disponible, con casi cinco mil desarrolladores y tres experimentos de campo, da alrededor de un veintiséis por ciento más de tareas. Un fabricante midiéndose a sí mismo sobre miles de repositorios declara un diecinueve por ciento más de propuestas incorporadas. Nadie llega, ni de lejos, a los multiplicadores que circulan en las presentaciones. Y hay un segundo factor que explica por qué las expectativas se incumplen tan sistemáticamente: el rendimiento depende muchísimo de si hay contexto previo que respetar. Las mejoras grandes aparecen en tareas sencillas sobre proyectos nuevos; en tareas complejas sobre código heredado, que es el de cualquier empresa grande, se quedan en márgenes pequeños.
En la verificación el balance es positivo con un matiz que vale más que el resultado. En generación de pruebas, en el caso mejor documentado, en torno a tres de cada cuatro propuestas acabaron aceptándose; pero el valor no estaba en el generador, estaba en el filtro automático que descartaba lo que no compilaba, lo intermitente y lo que no aumentaba la cobertura. Lo que hace útil a un generador es el verificador que tiene delante. En revisión de código, en cambio, más de la mitad de las sugerencias automáticas se rechazan y el revisor puede ser inducido a cambiar su veredicto manipulando metadatos, de modo que la conclusión operativa no admite suavizado: un agente revisa; no aprueba.
Y al final del recorrido hay tres usos poco glamurosos y muy rentables: correlacionar un cambio con el comportamiento posterior del servicio para proponer hipótesis de causa; generar las notas de versión a partir de lo que realmente cambió en vez de lo que alguien recuerda; y construir el informe de estado leyendo el estado real del trabajo. Ese último es trabajo de recolección puro y es, en una iniciativa con seis equipos implicados, de lo que más tiempo devuelve.
Conviene cerrar con la advertencia que ordena todo el apartado. Las capacidades concretas y los nombres de producto cambian cada pocas semanas, así que cualquier lista detallada caduca pronto. Lo que no caduca es el patrón: la inteligencia artificial propone y una persona dispone, y la calidad del sistema depende de lo bueno que sea el mecanismo que hay entre las dos cosas. Ese mecanismo tiene nombre propio y decide más que el modelo que se elija: lo tratamos en el artículo sobre qué es un agent harness.
Por qué la inteligencia artificial obliga a escribir mejor lo que se pide
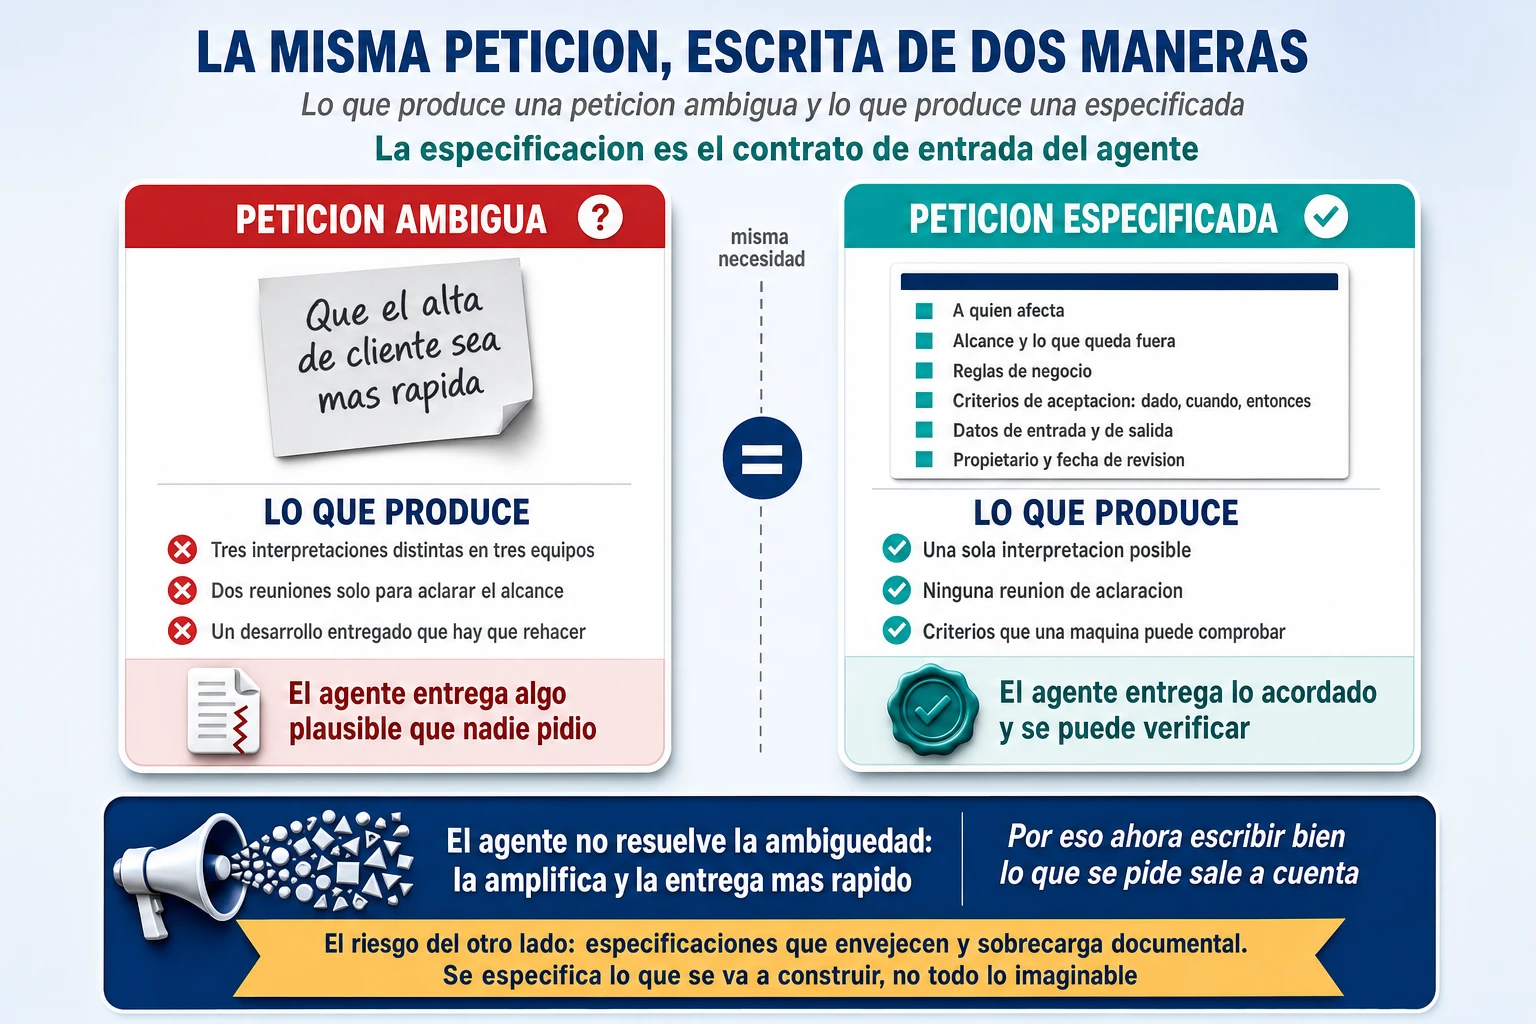
Durante años, escribir bien un requisito fue una virtud profesional con premio diferido: el equipo que lo hacía sufría menos retrabajo seis semanas después. Ahora tiene premio inmediato, y la razón es mecánica. Una persona que recibe una petición ambigua pregunta; un agente, no. Rellena el hueco con lo que le parece más probable, lo hace con una seguridad notable y produce algo coherente, bien escrito y equivocado. La ambigüedad deja de frenar el trabajo y pasa a multiplicarse por la velocidad de la máquina.
En nuestro ejemplo, la regla del cliente que ya tiene un servicio contratado es exactamente ese tipo de hueco. Una persona lo detecta y pregunta, con el coste de siete días de espera. Un agente no pregunta: elige una interpretación razonable —por ejemplo, impedir la contratación— y construye sobre ella. Si resulta que negocio quería permitirla con un descuento, el error no aparece en la revisión de código, porque el código estará perfecto. Aparece en producción.
Qué hace verificable un criterio de aceptación
Un criterio es verificable cuando dos personas que lo leen por separado coinciden en si se cumple. «El alta debe ser rápida» no lo es. «Desde que el cliente confirma hasta que el servicio aparece activo no deben pasar más de treinta segundos en el noventa y cinco por ciento de los casos» sí lo es, y además se puede convertir en una comprobación automática que corra en cada cambio.
Hay varios formatos para escribirlos y no conviene convertirlo en una guerra de religión. Describir el comportamiento con un caso concreto —dada esta situación, cuando ocurre esto, entonces pasa aquello— funciona bien para reglas de negocio con casos límite, como la del contrato previo, y mal cuando se convierte en una burocracia de frases que nadie ejecuta. Una frase imperativa simple funciona mejor para requisitos de sistema. Y para las interfaces, lo que de verdad elimina ambigüedad no es prosa: es el contrato de la interfaz, que sirve a la vez de documentación, de validación y de base de pruebas. La regla sensata es elegir formato según el tipo de requisito y no imponer uno para todo.
Las reglas que no se reescriben en cada iniciativa
Por encima de cada definición concreta hay un conjunto de principios que no deberían volver a discutirse cada vez: cómo se exponen las interfaces, qué se registra y en qué formato, qué nivel mínimo de pruebas se exige, cómo se tratan los datos personales, qué se puede desplegar sin aprobación. Escribir eso una vez, en un sitio que consultan tanto las personas como los agentes, es probablemente la inversión documental más rentable que puede hacer una organización grande.
Lo interesante es que convierte el estándar corporativo en otra cosa. Un estándar que vive en una página que nadie lee es una aspiración; el mismo estándar incorporado al contexto que recibe quien construye —persona o agente— y comprobado por una regla automática es una restricción real. Ese salto, de aspiración a restricción, es el que cambia los resultados.
Dónde está la trampa, y es seria
Conviene decir con claridad que el entusiasmo actual por tratar la especificación como artefacto central tiene catorce meses de vida, no una década de práctica, y que va por delante de la evidencia. La crítica más afilada es también la más obvia: una organización que se tome en serio escribir especificaciones completas antes de construir puede acabar reinventando el documento de requisitos de los años noventa, con el agravante de que ahora lo escribe más rápido.
Hay un dato de adopción que lo ilustra mejor que cualquier argumento. Un análisis de repositorios públicos encontró cientos de miles de ficheros de especificación repartidos por decenas de miles de proyectos, pero solo unos pocos miles de cambios en los que la especificación y la implementación se modificasen juntas. Muchísima gente escribe la especificación y casi nadie la mantiene viva, que era justo lo que la hacía valiosa. Una especificación que se escribe una vez y se abandona es peor que no tenerla, porque alguien la leerá creyendo que describe el sistema.
Y hay una señal de mercado que conviene conocer antes de montar un programa alrededor de esto: el radar tecnológico de referencia del sector situó el desarrollo guiado por especificación en la categoría de «evaluar» a finales de 2025 y no lo renovó en la edición siguiente. Lo que sí movió a «adoptar» fueron dos cosas más humildes: las instrucciones compartidas y curadas —escribir una vez cómo trabaja esta organización, para que todo el mundo, persona o agente, parta de ahí— y el cuidado del contexto que se le entrega a la máquina.
La recomendación que se deduce es deliberadamente modesta, y es la que yo defendería en un comité: adoptar el principio —escribir bien lo que se pide, versionarlo y revisarlo con el mismo rigor que el código— y no adoptar ningún método con nombre propio. Los productos que lo implementan cambian de comandos cada pocas semanas; el principio lleva funcionando desde que existe la ingeniería.
Lo que conviene automatizar y lo que conviene agentizar
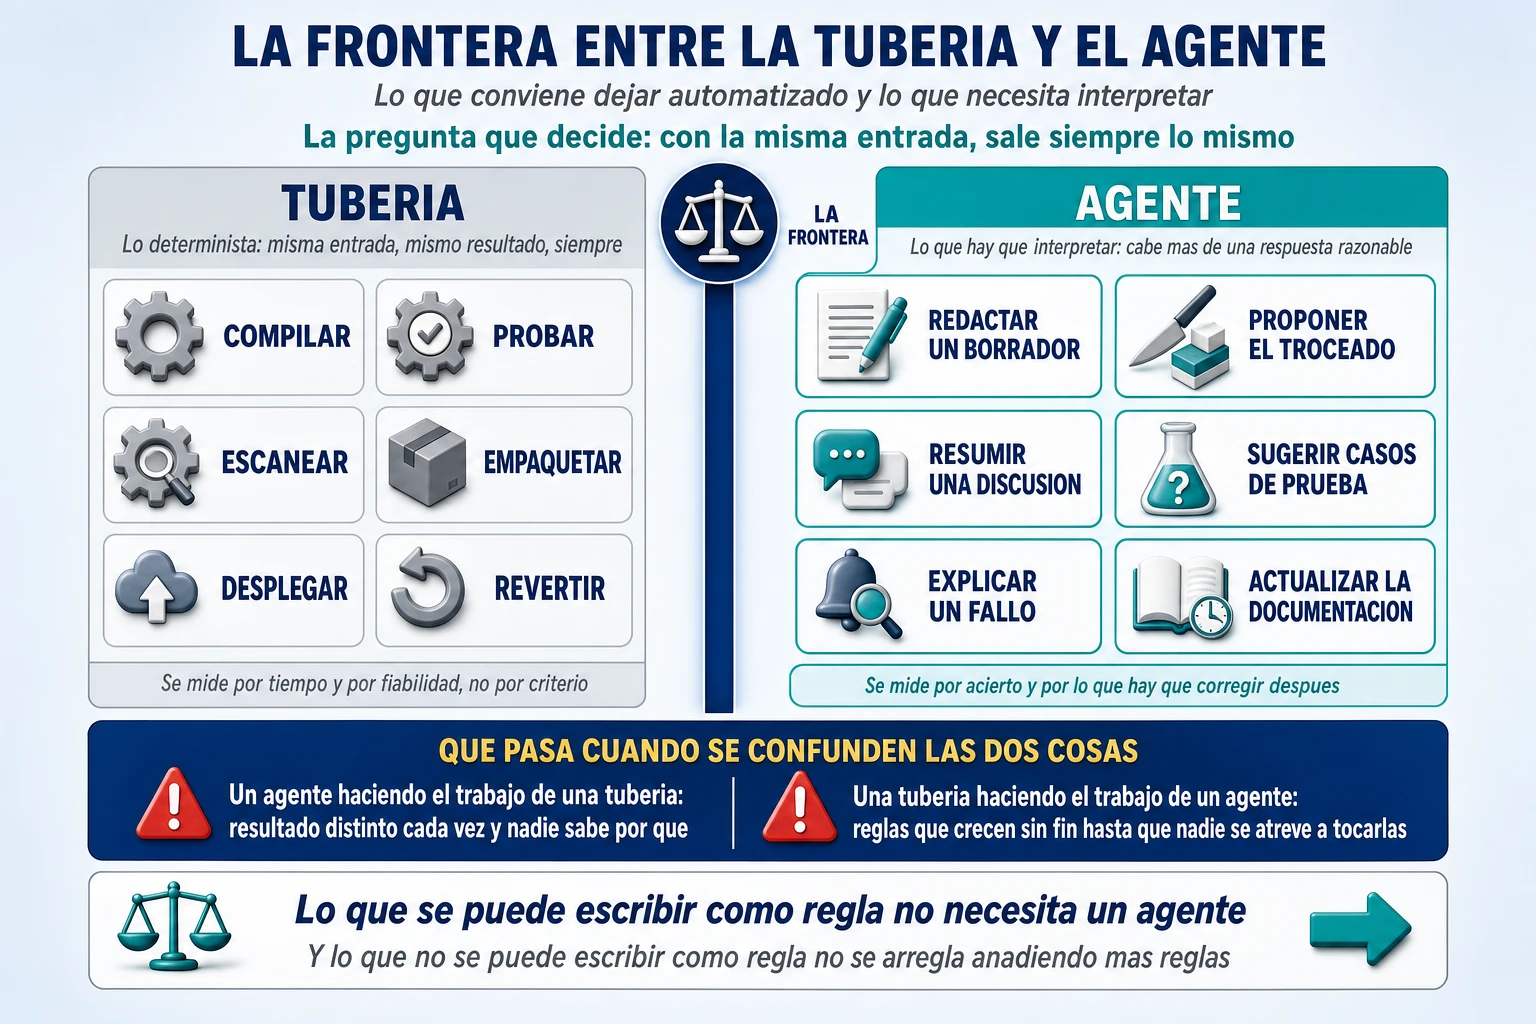
En medio del entusiasmo por los agentes se ha perdido una distinción que vale dinero: no todo lo que se puede automatizar debe convertirse en un agente. Una tarea determinista es aquella en la que, dada la misma entrada, debe salir siempre exactamente lo mismo, y para eso un agente es peor herramienta que un guion: es más caro, más lento y, sobre todo, no garantiza el mismo resultado dos veces.
Compilar, ejecutar la batería de pruebas, escanear en busca de vulnerabilidades y credenciales, empaquetar, desplegar en un entorno y revertir a la versión anterior pertenecen a esa categoría. Son el suelo sobre el que se apoya todo lo demás y tienen que ser aburridos y predecibles. Interpretar una incidencia confusa, proponer tres opciones de diseño, redactar el primer borrador de una definición de servicio o explicar por qué falló algo pertenecen a la otra categoría, la que requiere juicio, y ahí un agente aporta.
Hay una zona intermedia de moda que merece una advertencia. Se habla mucho de tuberías que se reparan solas: cuando una comprobación falla, el error se devuelve automáticamente al agente, que propone la corrección y la somete a revisión. El mecanismo es real y útil, y la etiqueta con la que se vende todavía no significa lo mismo para dos personas distintas, así que conviene describir la capacidad en lugar de comprar el nombre.
Y conviene añadir el riesgo, que nadie pone en las presentaciones: una tubería que se repara sola sin que nadie entienda qué falló convierte los incidentes en invisibles. El equipo deja de acumular el conocimiento que le permitía diagnosticar, y el día que el fallo sea de los que no se arreglan solos, nadie sabrá por dónde empezar. La forma sana de usarlo es que la corrección automática sea visible, quede registrada y pase por la misma revisión que cualquier otro cambio.
Cuánta autonomía dar a cada actividad
«Agéntico» se ha convertido en una palabra que no distingue entre un asistente que sugiere una línea y un sistema que despliega en producción sin preguntar. Para decidir algo hace falta una escala, y en este blog ya publicamos una de seis niveles al tratar cómo organizar una transformación con agentes de inteligencia artificial: 0 informa · 1 recomienda · 2 prepara · 3 ejecuta y deja traza · 4 ejecuta salvo excepción · 5 opera de forma autónoma. Lo que añade este artículo es aplicarla al recorrido que hemos seguido.
Antes de la tabla, el criterio que la ordena, que importa más que la tabla: la autonomía no se concede por confianza en el modelo, se concede por la calidad del verificador que hay detrás. Se puede dejar que un agente genere pruebas con bastante libertad porque existe un filtro objetivo que comprueba si compilan, si son estables y si aumentan la cobertura. No se puede dejar que apruebe un cambio, porque el verificador de esa decisión es un criterio humano que todavía no sabemos automatizar. Cada vez que alguien proponga subir un escalón, la pregunta correcta no es si el modelo ha mejorado: es qué comprueba que no se ha equivocado. El razonamiento completo de por qué la autonomía es un coste y no una prestación está en el artículo sobre cuánta autonomía necesita cada problema.
| Actividad | Nivel inicial razonable | Qué verifica que no se ha equivocado |
| Buscar antecedentes, servicios parecidos y dependencias | 1 · Recomienda | Quien lo pide, al contrastarlo con lo que ya sabe |
| Redactar el borrador de la definición del servicio | 2 · Prepara | La conversación de cierre de huecos con arquitectura, operaciones y seguridad |
| Proponer opciones de arquitectura | 1 · Recomienda | Decisión humana registrada, con las alternativas descartadas |
| Trocear la iniciativa en trabajos y detectar dependencias | 2 · Prepara | Confirmación del responsable antes de aplicar los cambios |
| Escribir código a partir de una definición cerrada | 2 · Prepara | Comprobaciones automáticas más revisión humana obligatoria |
| Generar pruebas | 3 · Ejecuta y deja traza | Filtro objetivo: compila, no es intermitente, sube cobertura |
| Revisar código | 1 · Recomienda | Nada automático; por eso comenta y no aprueba |
| Escaneo de seguridad y dependencias | 3 · Ejecuta y deja traza | Reglas deterministas; las excepciones las firma una persona |
| Despliegue a producción | 1 · Recomienda | La tubería despliega; el agente, como mucho, propone cuándo |
| Documentación y notas de versión | 3 · Ejecuta y deja traza | Se genera de lo que cambió realmente, y es revisable |
| Informe de estado de la iniciativa | 3 · Ejecuta y deja traza | Sale del estado real del trabajo, no de lo que recuerda nadie |
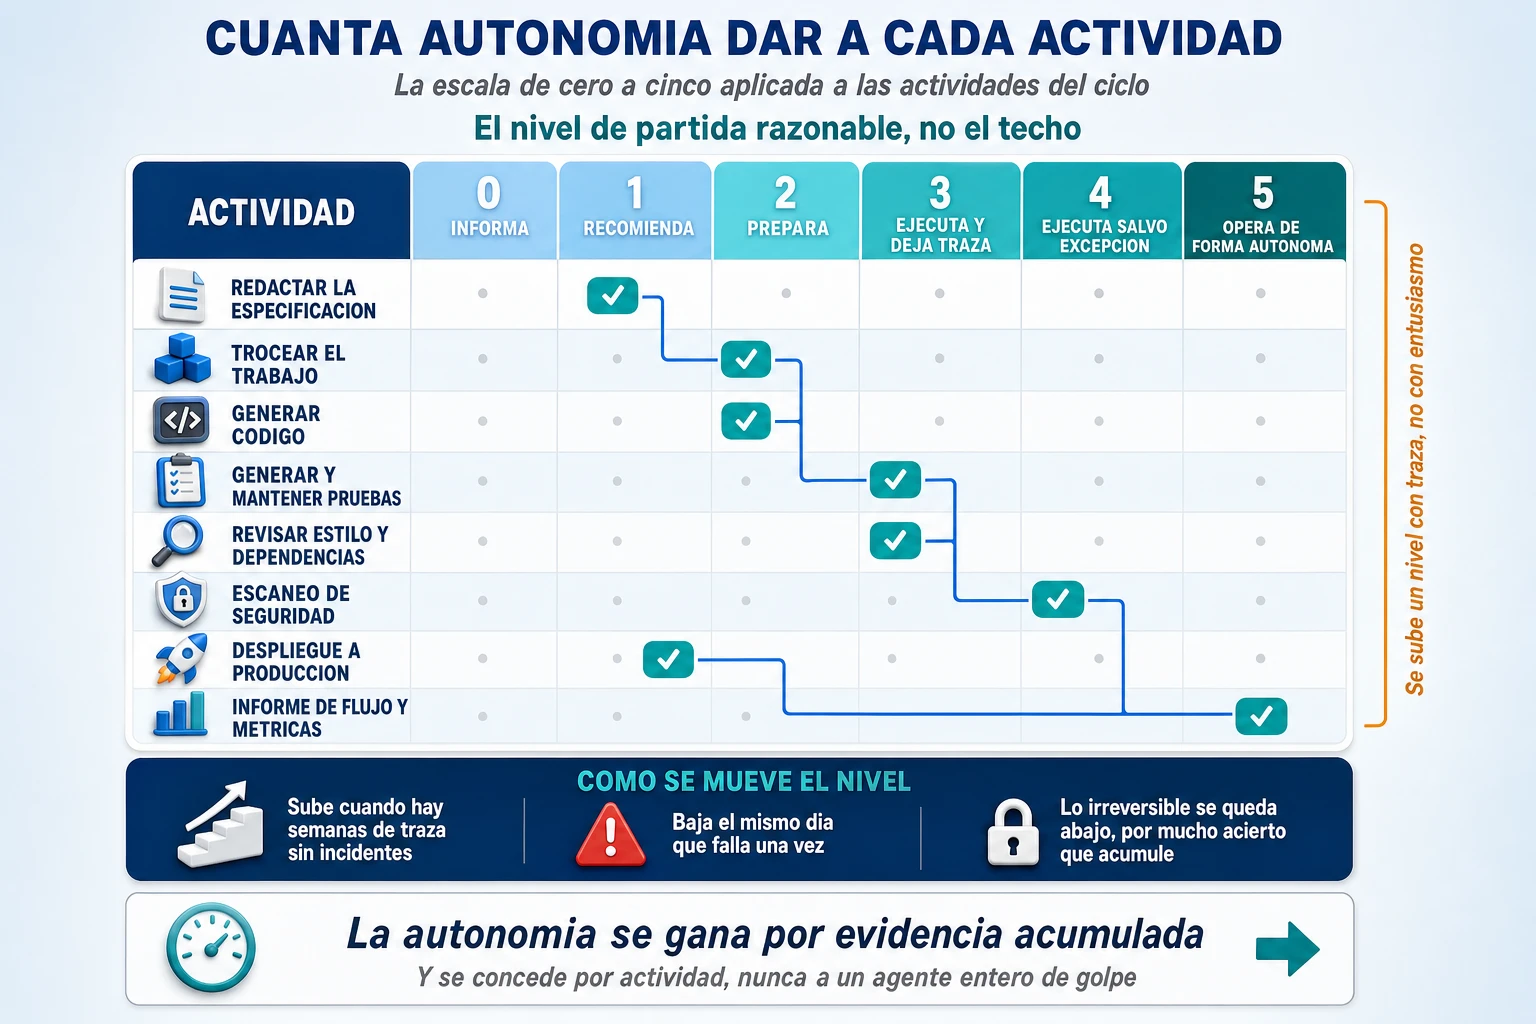
Merece la pena situar dónde está hoy el agente de codificación más integrado del mercado medido con esta escala, porque desinfla bastante retórica: abre una propuesta de cambio en estado de borrador, no puede marcarla como lista, no puede aprobarla, no puede incorporarla, no puede saltarse las protecciones de la rama y trabaja sobre un único repositorio, una única rama y una sola propuesta por tarea, con un límite de tiempo por sesión inferior a una hora. Eso es un nivel 2 verificable. Es útil, es real y no es «el agente que hará la migración», que sigue siendo el caso que más ilusiona en los comités y el que el producto declara explícitamente que no hace.
Hay un principio de permisos que se aplica aquí casi literalmente: lectura amplia, escritura estrecha. Un agente puede leer todo el repositorio, las definiciones de servicio y el histórico de decisiones; escribe solo en una rama, dentro de una propuesta, sometido a las mismas comprobaciones que cualquiera.
El problema de gobierno que esto abre, explicado por el propio fabricante
Hay una regla que GitHub activa por defecto y cuyo razonamiento es la mejor explicación de este problema que he encontrado en documentación de producto: exigir una aprobación normalmente significa que dos personas han intervenido en un cambio, la que lo escribió y la que lo aprobó; esa suposición deja de cumplirse cuando es el agente quien abre la propuesta con su propia identidad. Por eso exige una aprobación adicional para los cambios que vienen de un agente sin atribución humana.
Es un detalle técnico con consecuencias de gobierno. Todo el edificio de control del desarrollo moderno —segregación de funciones, cuatro ojos, trazabilidad de quién aprobó qué— se construyó asumiendo que detrás de cada acción hay una persona. Cuando deja de ser cierto, la pregunta no es si el agente puede hacer el trabajo: es quién responde de lo que hizo. Y hay una tensión concreta que aparece pronto: si una regla del repositorio restringe quién puede firmar cambios, el agente queda bloqueado, y la solución documentada es añadirlo como excepción de esa regla. Esa decisión no se toma en un repositorio, se toma en un comité, porque es relajar un control para que funcione una herramienta.
El gobierno del trabajo: puertas que deciden y equipos que iteran
La discusión entre tener fases con puertas de aprobación o trabajar de forma iterativa está mal planteada, y resolverla bien es lo que más plazo ahorra de todo lo que contiene este artículo. Un comité necesita puntos de decisión porque administra capital. Un equipo necesita flujo continuo porque el aprendizaje no llega en las fechas del comité. Son compatibles en cuanto se separan dos preguntas que las organizaciones mezclan.
La primera es si se sigue invirtiendo en este servicio. Es decisión de cartera, por hitos, la toman pocas personas con autoridad y tiene cadencia trimestral. La segunda es cómo se resuelve. Es decisión de equipo, continua y reversible, y no debería aprobarla nadie de fuera. El fallo típico no es tener puertas: es usar la puerta para aprobar el cómo.
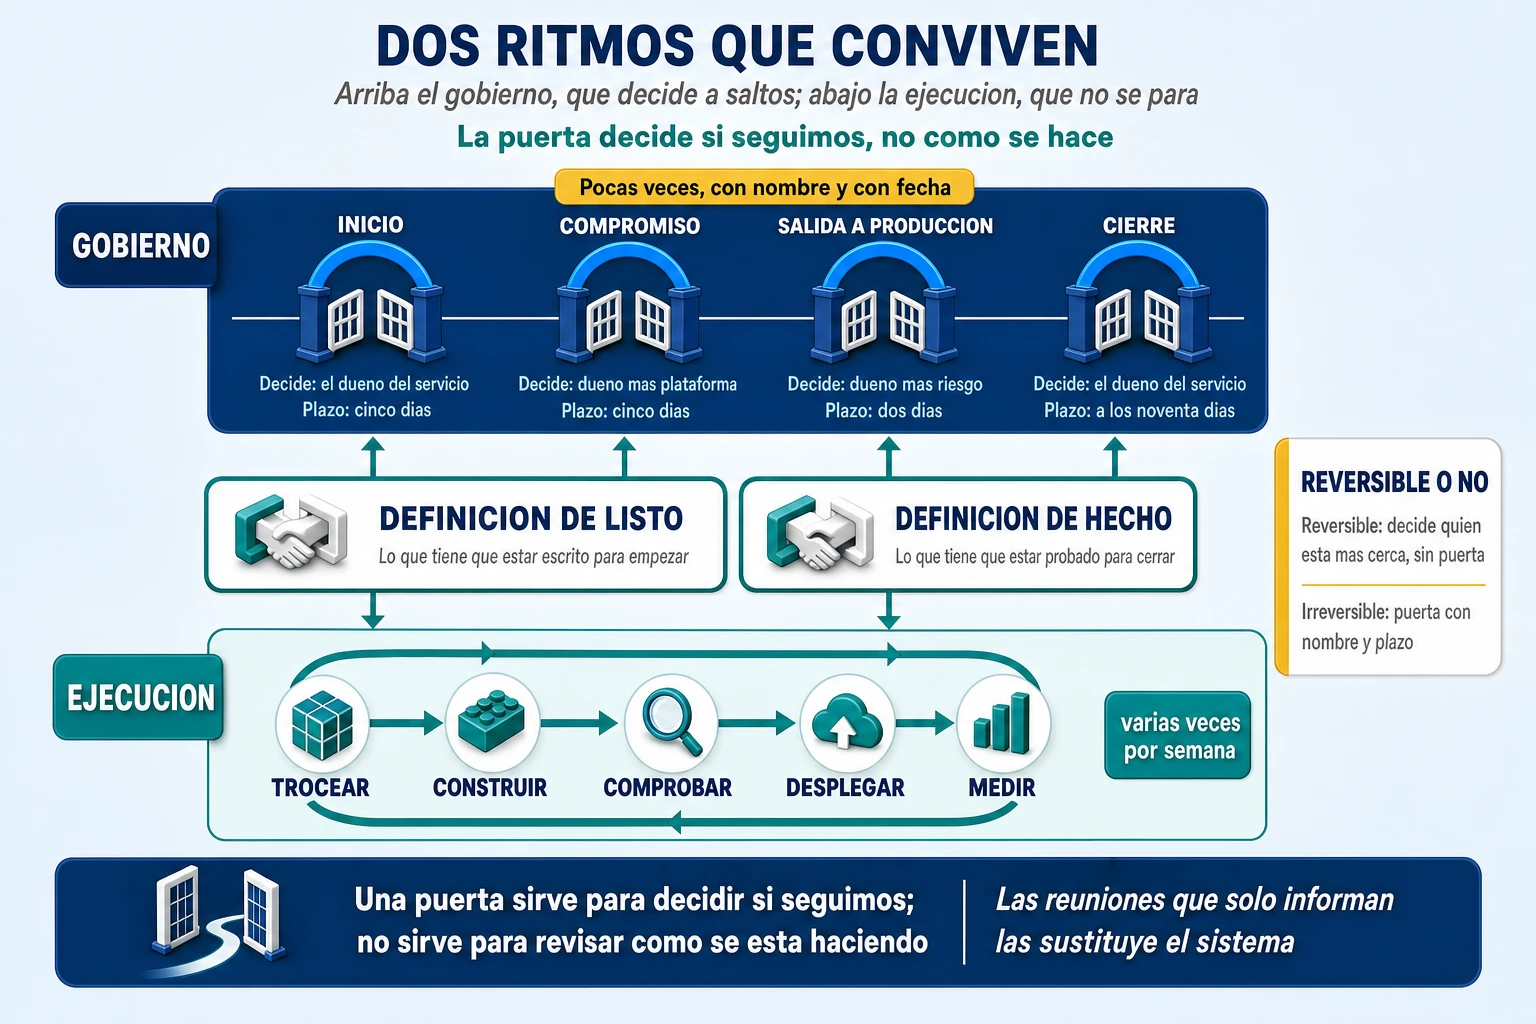
Lo que cuesta aprobar los cambios de uno en uno
Aquí la evidencia es contundente y no hace falta citar a ningún consultor. La investigación de DORA encontró que exigir la aprobación de un órgano externo —un comité de cambios o un directivo— para los cambios significativos multiplica por 2,6 la probabilidad de estar entre los equipos de peor rendimiento. Y, lo que es más incómodo para quien defiende el comité: no encontró evidencia de que esa aprobación reduzca la tasa de fallo. El coste es real y el beneficio no aparece.
El dato que lo confirma desde fuera del mundo de la consultoría viene del regulador financiero británico, que analizó más de un millón de cambios en veintitrés entidades: los comités aprobaron más del noventa por ciento de los cambios mayores que revisaron, y en algunas entidades no rechazaron ni uno en todo el año. El propio regulador sugiere que cumplen un papel más parecido al control de tráfico aéreo que al aseguramiento. Un filtro que deja pasar más de nueve de cada diez cosas no es un filtro: es una cola con acta.
Ahora el matiz, que es lo que hace esta sección útil en lugar de incendiaria. La misma investigación encontró que comunicar bien el proceso que ya existe y ayudar a los equipos a navegarlo mejora el rendimiento de entrega. Lo que mata la velocidad no es que exista un proceso: es que sea opaco, externo e impredecible. Y el regulador, en la misma dirección, halló correlación positiva entre llevar seis meses o más con el mismo marco de gobierno y tener mejores tasas de éxito. La estabilidad del gobierno ayuda; el gobierno convertido en ventanilla, no.
La alternativa que propone la propia investigación tampoco es suprimir el control: es mover la aprobación a la revisión por pares dentro del desarrollo, donde queda registrada con su comentario y su fecha, y reconvertir el comité en algo más valioso que una ventanilla, como decidir el equilibrio entre tiempo de salida y riesgo de negocio. La segregación de funciones que exige auditoría se satisface mejor con el expediente de una propuesta de cambio que con un acta, porque el expediente no se puede escribir después.
Cómo se decide quién decide
El instrumento más útil y más barato lo escribió Jeff Bezos en la carta a los accionistas de 2015, y sigue siendo mejor que casi todo lo publicado después. Hay decisiones que son puertas de ida y vuelta: si salen mal, se deshacen, y esas se toman rápido y las toma poca gente. Y hay decisiones de ida sin vuelta, que se toman despacio. El diagnóstico que acompaña a la distinción explica por qué las organizaciones se vuelven lentas al crecer: acaban aplicando el proceso pesado a casi todo, y el resultado es lentitud, aversión al riesgo mal entendida y falta de experimentación. Conviene recordar también la nota al pie, que impide que esto suene frívolo: las empresas que usan habitualmente el proceso ligero para decisiones irreversibles desaparecen antes de hacerse grandes.
En la práctica, cada decisión abierta necesita cuatro datos: si es reversible, quién decide —una persona, no un comité—, para cuándo, y qué pasa por defecto si no hay respuesta. Ese registro es conocimiento, no estado, así que vive en la capa de conocimiento, enlazado al trabajo que depende de él.
Las reuniones que sobreviven
Con información estructurada y accesible, buena parte de las reuniones pierde su razón de ser, pero no todas, y el criterio para distinguirlas es sencillo: una reunión aporta cuando produce una decisión, un compromiso o un aprendizaje compartido que no se puede obtener leyendo. Todo lo que sea informar del estado se sustituye por algo que se genera solo; todo lo que sea decidir, no.
Hay un dato que ayuda a dimensionar el problema, con la salvedad de que lo publica quien vende las herramientas que lo miden: en una muestra de más de treinta mil trabajadores del conocimiento, la interrupción media llegaba cada dos minutos y la mitad de las reuniones caía en las dos franjas de máxima concentración. No hace falta aceptar las cifras al pie de la letra para reconocer el patrón. Y una observación que vale más que una lista de ceremonias: una reunión de coordinación recurrente es un síntoma de acoplamiento, no una buena práctica.
Quién hace qué: roles, equipos y proveedores
Nada de lo anterior funciona si la organización está repartida de forma que el trabajo tenga que cruzar cinco fronteras. Hay tres tipos de equipo que cubren casi todas las necesidades, y lo útil no son los nombres sino la pregunta que resuelve cada uno.
Están los equipos que responden de un producto o de un servicio de punta a punta, que son los que entregan valor y deberían ser la mayoría. Están los equipos de plataforma, que construyen lo que los demás usan —entornos, tuberías, catálogo, observabilidad, la capa de inteligencia artificial— y cuyo éxito se mide por cuánto se usan sus cosas sin que haya que pedírselo. Y están los especialistas que ayudan temporalmente —arquitectura, seguridad, fiabilidad, datos—, cuyo objetivo es que el equipo al que ayudan adquiera la capacidad, no convertirse en una parada obligatoria del circuito.
En nuestro ejemplo hay una figura que decide más que ninguna otra y que a menudo no existe: alguien que responde del servicio completo, no del portal ni del CRM ni de la plataforma de seguridad. Si nadie tiene ese papel, las seis ramas de trabajo avanzan a velocidades distintas y la que va última marca la fecha sin que nadie lo haya decidido.
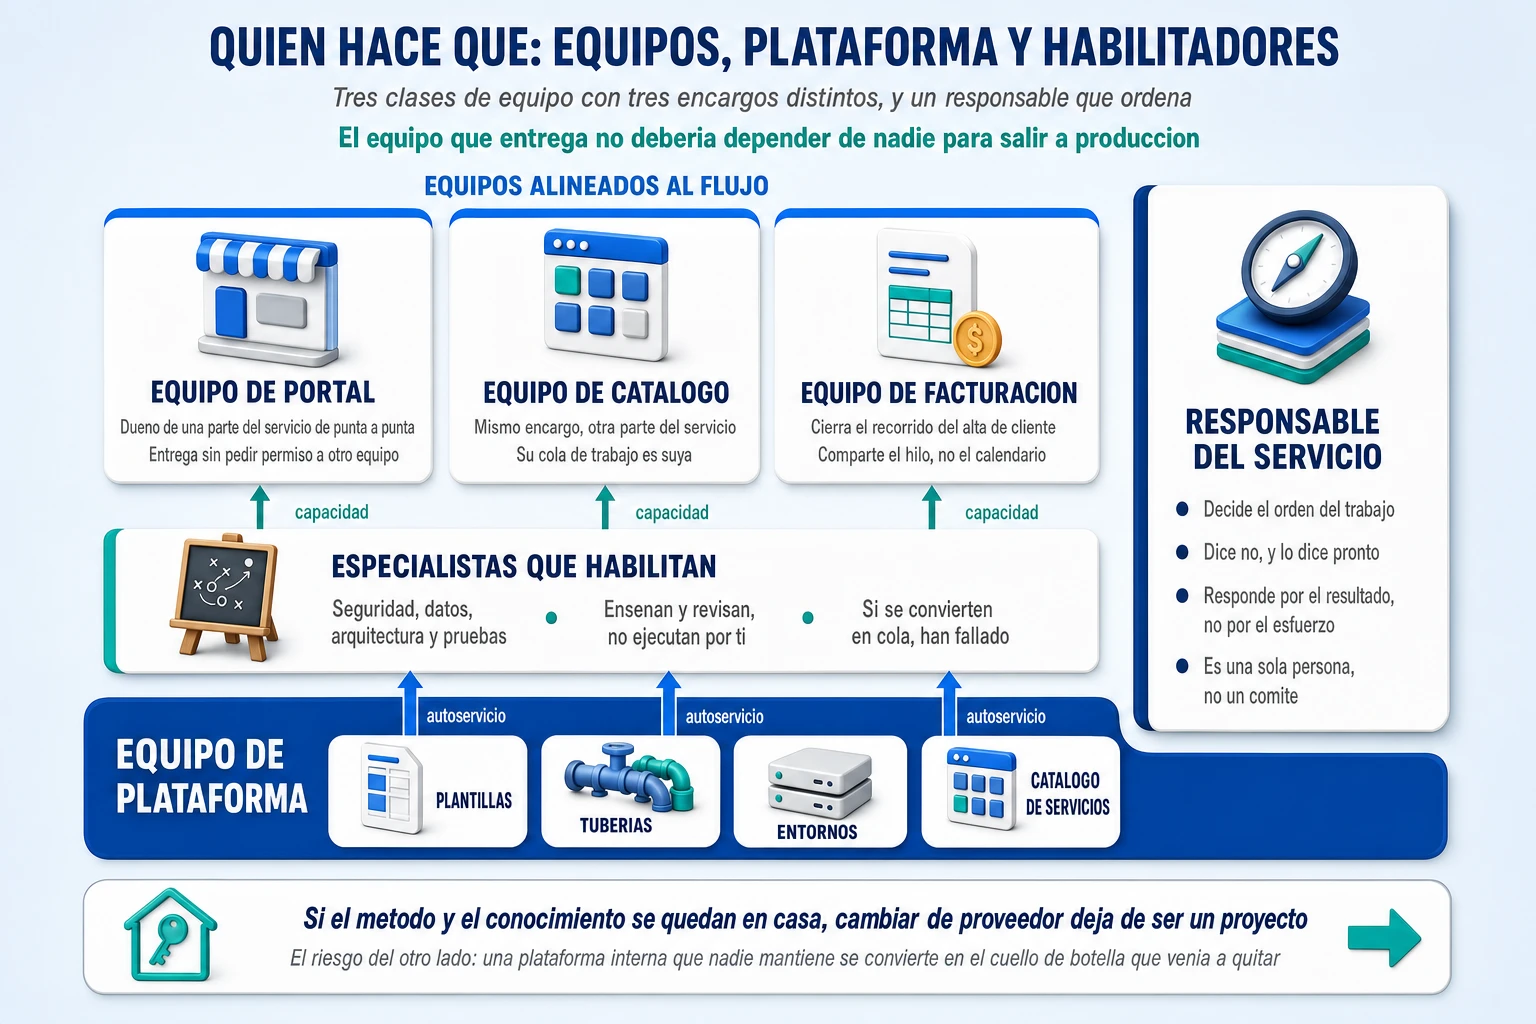
Conviene tener a mano un hallazgo para la próxima vez que un comité dedique tres sesiones a elegir marco de trabajo. Un estudio con más de quince mil personas en cuatro mil equipos comparó los enfoques de escalado más extendidos y encontró que las diferencias entre ellos eran demasiado pequeñas para tener significado práctico. Lo que sí tenía efecto grande y consistente era otra cosa: cuánto tiempo llevaba el equipo trabajando así. El tamaño de la organización no explicaba nada. La conclusión es poco épica y muy rentable: elegir un marco razonable, dejar de discutirlo y darle tiempo vale más que elegir el mejor y volver a cambiarlo en dieciocho meses.
Con los proveedores, el cambio relevante es que cuando el método, los estándares, las plantillas y el registro de decisiones viven en las herramientas de la empresa, el conocimiento operativo deja de irse al terminar el contrato. Eso acorta la incorporación de un equipo externo y permite que la conversación comercial deje de ser sobre horas. Sin venderlo como panacea: pagar por horas no incentiva reducirlas pero es el único modelo que permite cambiar de dirección sin renegociar; el precio cerrado da previsibilidad y castiga el aprendizaje; pagar por entregables incentiva producir unidades en vez de resultados. El error no suele ser el modelo: es usar el mismo para todo.
Cómo se mide que esto funciona
Casi todos los cuadros de mando de desarrollo miden cuánto se produce. Eso funcionaba cuando producir era lo caro. Ahora que generar código se ha abaratado, medir producción es medir lo abundante e ignorar lo escaso, que ha pasado a ser la verificación, la decisión y el despliegue seguro.
De ahí sale la única regla de construcción que importa: cada métrica de velocidad va emparejada con la que omite. Nunca sola. Un cuadro de doce números en seis parejas es más honesto que uno de seis sueltos, y se discute mejor en un comité porque cada pregunta incómoda ya tiene su respuesta al lado.
| Métrica de velocidad | Su contrapeso obligatorio | De dónde sale el dato |
| Tiempo desde la intención hasta producción | Defectos escapados por cada cien despliegues | Jira y registro de despliegues |
| Plazo de entrega del cambio | Tasa de fallo de cambio y de retrabajo | GitHub y gestión de incidencias |
| Tiempo de ciclo de desarrollo | Tiempo hasta la primera revisión y tiempo de revisión | GitHub |
| Trabajos terminados | Tamaño mediano del cambio y cobertura de revisión humana | GitHub |
| Aceptación de lo que produce la inteligencia artificial | Retrabajo sobre eso mismo a dos y a cuatro semanas | GitHub, con los cambios de agente etiquetados |
| Coste por tarea | Tamaño medio del cambio y defectos escapados | Facturación, Jira y observabilidad |
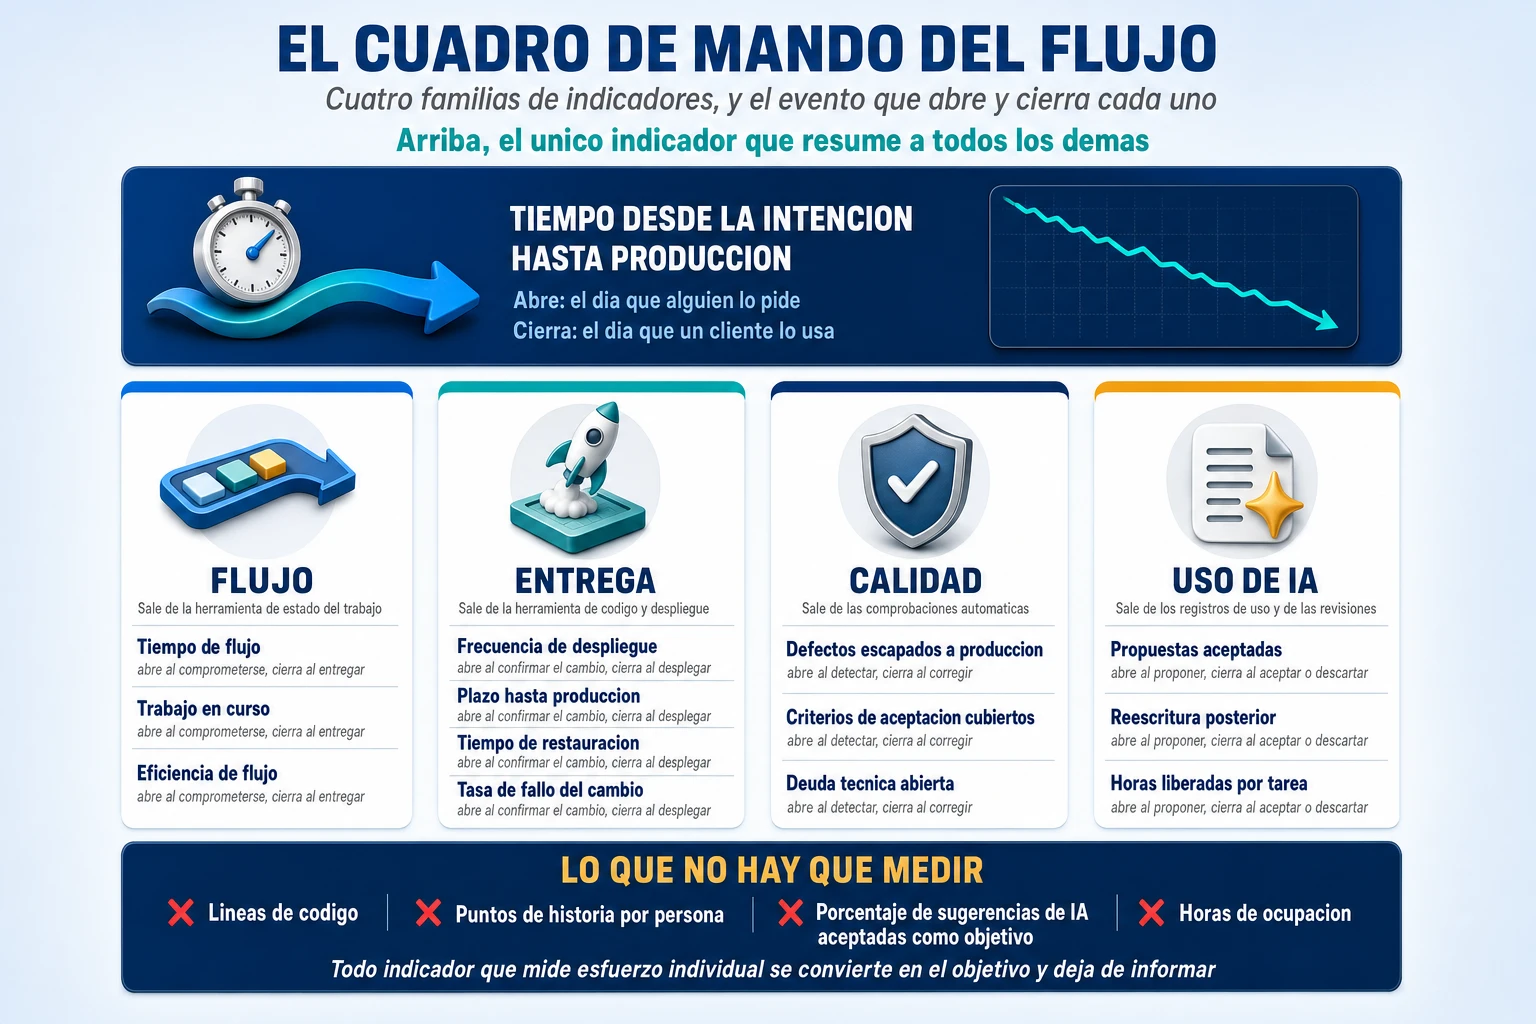
Tres precisiones valen más que la tabla. La primera es cuándo arranca el reloj del tiempo hasta producción: empieza cuando la organización se compromete —cuando el trabajo pasa a estar en curso—, no cuando se registra la idea, porque eso mide la cola de las ideas. La segunda es que comparar ese tiempo con el plazo medido desde el primer cambio en el código es el diagnóstico más barato que puede hacer una dirección: si lo primero son treinta días y lo segundo es uno, el problema no está en la máquina de entrega y ninguna herramienta de codificación lo va a arreglar.
La tercera es la métrica que no aparece en ningún marco estándar y hay que añadir a mano: la cobertura y la profundidad de la revisión humana. No basta con saber qué porcentaje de cambios tiene revisión; hay que saber cuántos tienen al menos un comentario, porque una aprobación sin texto y una revisión son cosas distintas. Ahí se ve si la velocidad se está pagando con verificación. Hay un caso documentado que lo ilustra: una organización que se fijó duplicar el ritmo de cambios lo consiguió durante más de dos años, y la factura apareció justo en este indicador, con la cobertura de revisión humana cayendo más de veinte puntos. La recomendación de quienes lo midieron cabe en una línea: no gobiernes solo por el recuento de cambios incorporados.
Y conviene cerrar con lo que no hay que medir, porque es donde más daño se hace con buena intención. Nada de líneas de código, puntos de historia, tickets cerrados ni cambios por persona. Nada de «porcentaje de código escrito por inteligencia artificial» ni «porcentaje de adopción» como indicador de resultado: miden uso, no valor, y en cuanto se premian suben solos. Y nada de un índice único que lo resuma todo, porque su función real es destruir la tensión entre velocidad y estabilidad, que es justo lo que un directivo necesita ver. Todo en mediana y percentil, nunca en media, leído como serie temporal propia y jamás como ranking entre equipos.
Los errores que más veces lo estropean
Casi todos los fracasos de este tipo de montaje se parecen entre sí, y casi todos dan una señal temprana que permite corregirlos barato.
| El error | La señal temprana que lo delata |
| Empezar por la herramienta en vez de por el recorrido del servicio | Hay un plan de migración con fechas y nadie sabe decir qué contenido va a cada sitio |
| Tratarlo como un asunto de los equipos de software | La iniciativa figura terminada y faltan el procedimiento, la formación y el argumentario |
| Responder la misma pregunta en dos sitios | Alguien pregunta en un chat cuál de los dos documentos es el bueno |
| Convertir toda idea en trabajo comprometido el mismo día | El backlog tiene doscientos elementos y ciento sesenta no se harán nunca |
| Organizar espacios y repositorios por departamento | El plazo de punta a punta no se puede calcular porque cruza cuatro espacios |
| Dejar que la decisión se quede en la conversación | Tres meses después nadie recuerda por qué el servicio se comporta así |
| Flujos con quince estados «para tener visibilidad» | Nadie distingue dos estados contiguos sin preguntar qué significan |
| Esperar que la información viaje sola entre herramientas | Alguien dedica media jornada semanal a copiar estados de un sitio a otro |
| Medir adopción de inteligencia artificial como si fuera un resultado | El indicador sube todos los meses y ningún plazo baja |
| Dejar que crezca el tamaño de los cambios | La mediana de líneas por propuesta sube y el tiempo hasta la primera revisión se dispara |
| Revisión humana convertida en trámite | Crecen las aprobaciones sin un solo comentario |
| Pilotar con un equipo excepcional | Funciona muy bien, no se sabe explicar por qué, y no se puede repetir |
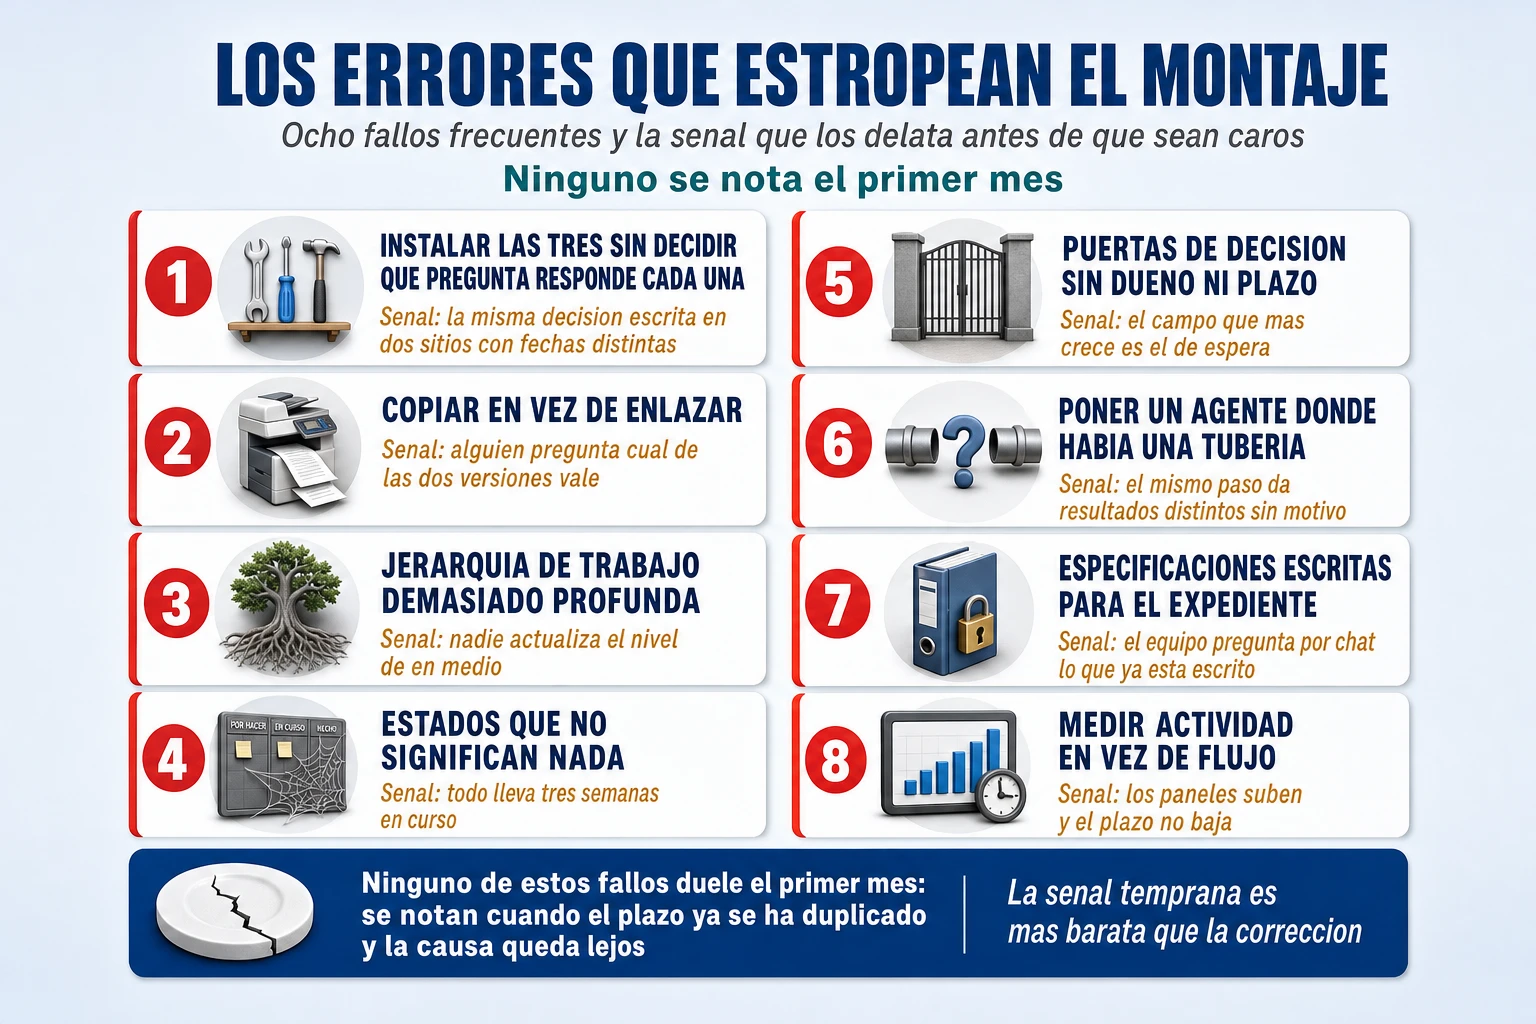
Hay uno que merece párrafo aparte porque es el más silencioso y el que la inteligencia artificial está provocando ahora mismo sin que nadie lo vea venir. Cuando crece el volumen de código generado, crecen los cambios, y los cambios grandes rompen la verificación. No es especulación: la investigación de DORA documentó que al aumentar la adopción de inteligencia artificial empeoraba la estabilidad de la entrega, y su propia hipótesis era que el sector había olvidado uno de sus principios básicos, los lotes pequeños, porque ahora se puede producir mucho más en el mismo tiempo. Los datos de revisión que han ido apareciendo apuntan igual: las propuestas que abre una máquina son varias veces más grandes, esperan mucho más a que alguien las mire y acaban incorporándose bastante menos. Por eso el tamaño mediano del cambio es la métrica adelantada más barata que existe: si sube, ya se sabe por qué va a empeorar la estabilidad antes de que empeore.
Por dónde empezar, y cómo contarlo en cinco minutos
Nada de esto requiere un programa de transformación, y presentarlo como tal es la forma más segura de que no ocurra. Lo que sigue es un plan de noventa días con un criterio: cada bloque termina con algo que se puede demostrar, no con un informe de avance.
Primer mes: ver dónde se va el tiempo
Se elige un servicio real que esté entregando ahora, no un piloto de laboratorio. Se reconstruyen tres entregas recientes día a día, separando trabajo activo de espera y anotando quién esperaba a quién. En paralelo se ajusta el tablero para que distinga estados de trabajo de estados de cola, porque sin eso no se podrá medir nada el mes siguiente. Y se hace un inventario rápido de en cuántos sitios vive hoy la información de ese servicio.
La prueba de que está hecho: se puede enseñar en una diapositiva el reparto real entre trabajo y espera, y las tres esperas más caras tienen nombre y dueño.
Segundo mes: montar el hilo
Se escribe la plantilla de definición de servicio y se usa en todo lo nuevo, con la regla de crear el trabajo desde la página. Se mete en el gestor todo el trabajo de la iniciativa, incluido el que no es software, que es el cambio que más cuesta y el que más se nota. Se fuerza el identificador en ramas, cambios y propuestas con una regla automática. Y se automatizan los dos o tres saltos de información que hoy hace una persona a mano.
La prueba de que está hecho: se toma una incidencia de producción al azar y se llega, en menos de dos minutos y sin preguntar a nadie, hasta la decisión que la originó.
Tercer mes: meter la inteligencia artificial donde ya hay sitio
Con el hilo montado se añade asistencia en tres puntos y no en diez: borrador de la definición de servicio, generación de pruebas, e informe de estado de la iniciativa. Son los tres que tienen verificador objetivo detrás. Se etiquetan los cambios de origen automático para poder medirlos aparte y se empieza a seguir el par que importa: tamaño mediano del cambio y cobertura de revisión humana.
La prueba de que está hecho: se puede responder con datos propios —no de un informe de mercado— si lo que produce la máquina se acepta, cuánto se retoca dos semanas después y si el tamaño de los cambios está creciendo.
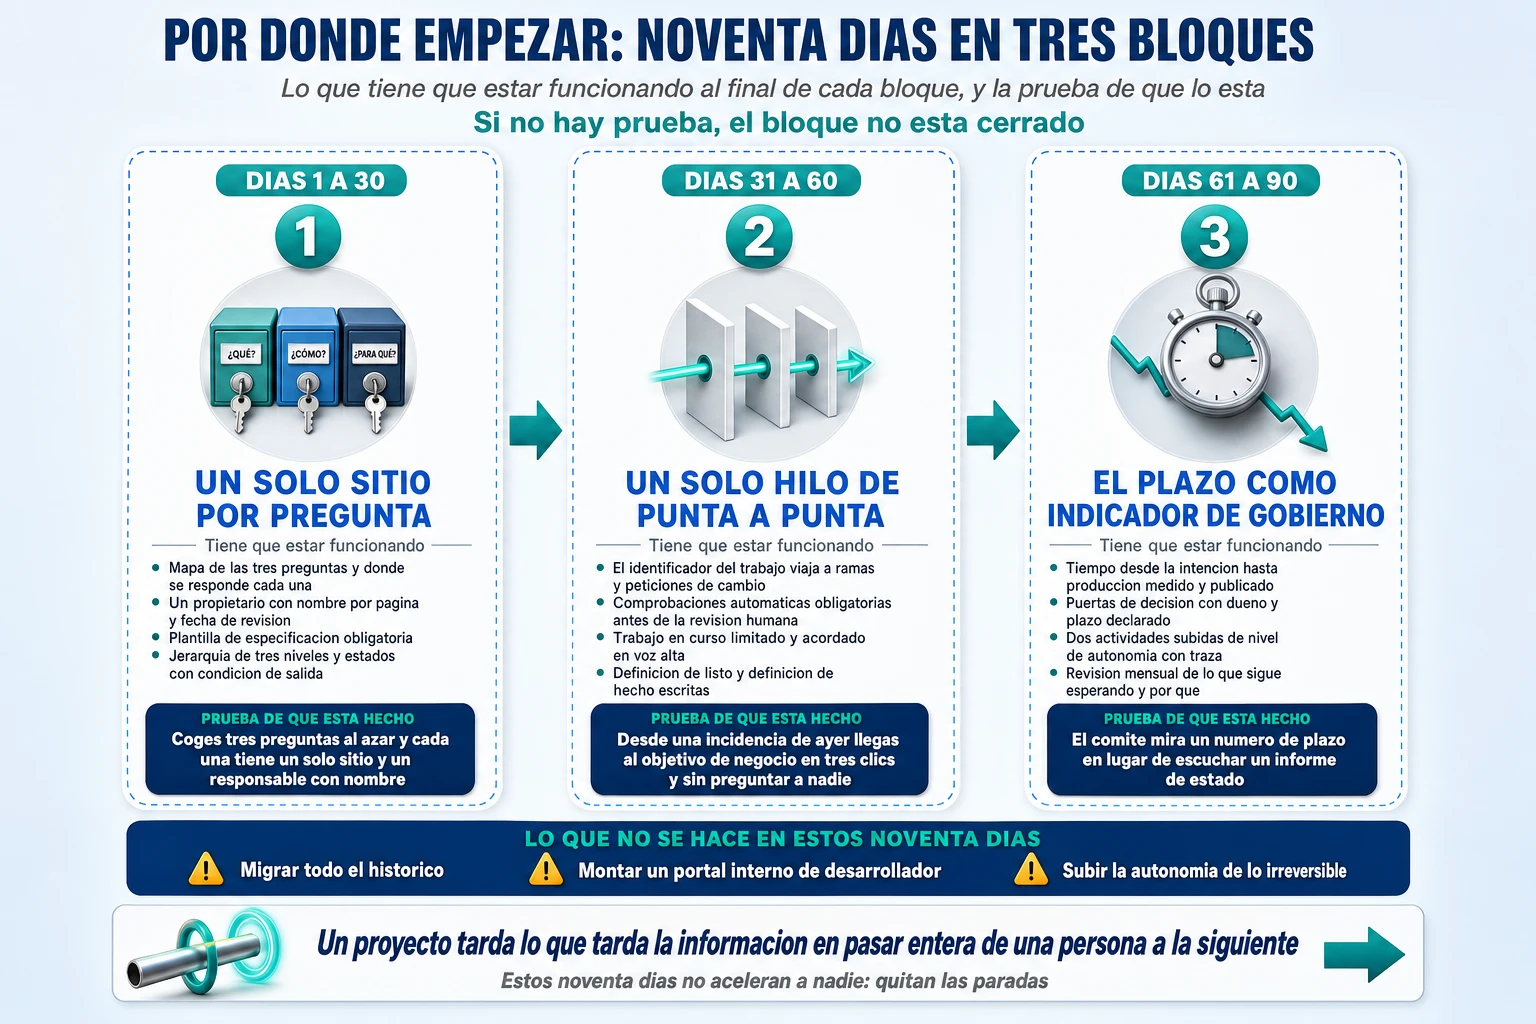
El orden no es caprichoso: la inteligencia artificial va en el tercer mes y no en el primero, no por prudencia sino porque en el primero no habría dónde apoyarla. Un agente que trabaja sobre definiciones que no existen, en un repositorio cuyo contexto no está escrito y con una revisión que ya era un trámite, produce más volumen de lo mismo.
Lo que vendrá después: cuando nadie sabe qué servicios hay
Pasado cierto tamaño aparece una pregunta que este montaje no responde: ¿qué servicios tenemos, quién responde de cada uno y de qué dependen? Jira sabe de trabajo, Confluence de documentos y GitHub de código; ninguno sabe de servicios. Lo que falta entonces es un catálogo, y lo mínimo que tiene que contener son tres datos por servicio: qué es, en qué estado de vida está y quién responde de él.
Dos honestidades sobre esto. La documentación oficial del proyecto de referencia del sector avisa de que hace falta un equipo central que sea dueño del catálogo y lo trate como un producto: no es una herramienta que se instala. Y la propia investigación de DORA midió que tener una plataforma interna sube la productividad percibida del equipo pero baja el rendimiento de entrega y la estabilidad, por el aumento de traspasos entre sistemas que introduce, mientras que en su trabajo posterior aparece como una de las capacidades que amplifican el beneficio de la inteligencia artificial. No es contradicción: la plataforma no acelera por sí misma; reduce la varianza y le da a la inteligencia artificial un sitio seguro donde aterrizar. El umbral honesto, sin inventar una cifra: compensa cuando el número de servicios supera el número de personas capaces de nombrarlos todos.
El párrafo para la reunión
Si alguien pregunta para qué sirve todo esto, la respuesta cabe en un párrafo que se puede repetir tal cual:
Estamos montando una cadena continua desde la idea hasta producción. Las ideas tienen un sitio donde vivir antes de ser proyectos. Confluence guarda cómo tiene que funcionar el servicio y por qué se decidió así. Jira coordina todo el trabajo que hace falta, que es software pero también procedimientos, formación y operación. GitHub se ocupa solo de la parte que es software y aporta la prueba de que funciona. Teams sigue siendo donde hablamos, pero no donde recordamos. Entre esas capas hay automatismos que mueven la información sin que nadie la copie. Y la inteligencia artificial se apoya en todo ese contexto para buscar, redactar, revisar y ejecutar una parte creciente del trabajo.
Y si hay que justificar por qué merece la pena, la aritmética del principio es mejor argumento que cualquier promesa: si el trabajo efectivo son nueve días de setenta, el premio grande no está en escribir el código más rápido, está en los sesenta y uno restantes.
El primer paso no cuesta una licencia: cuesta reconstruir tres entregas recientes día a día y mirar el reparto entre trabajo y espera. En cómo arrancar un proyecto de transformación está el detalle de cómo se prepara ese arranque para que no se quede en un diagnóstico bonito.