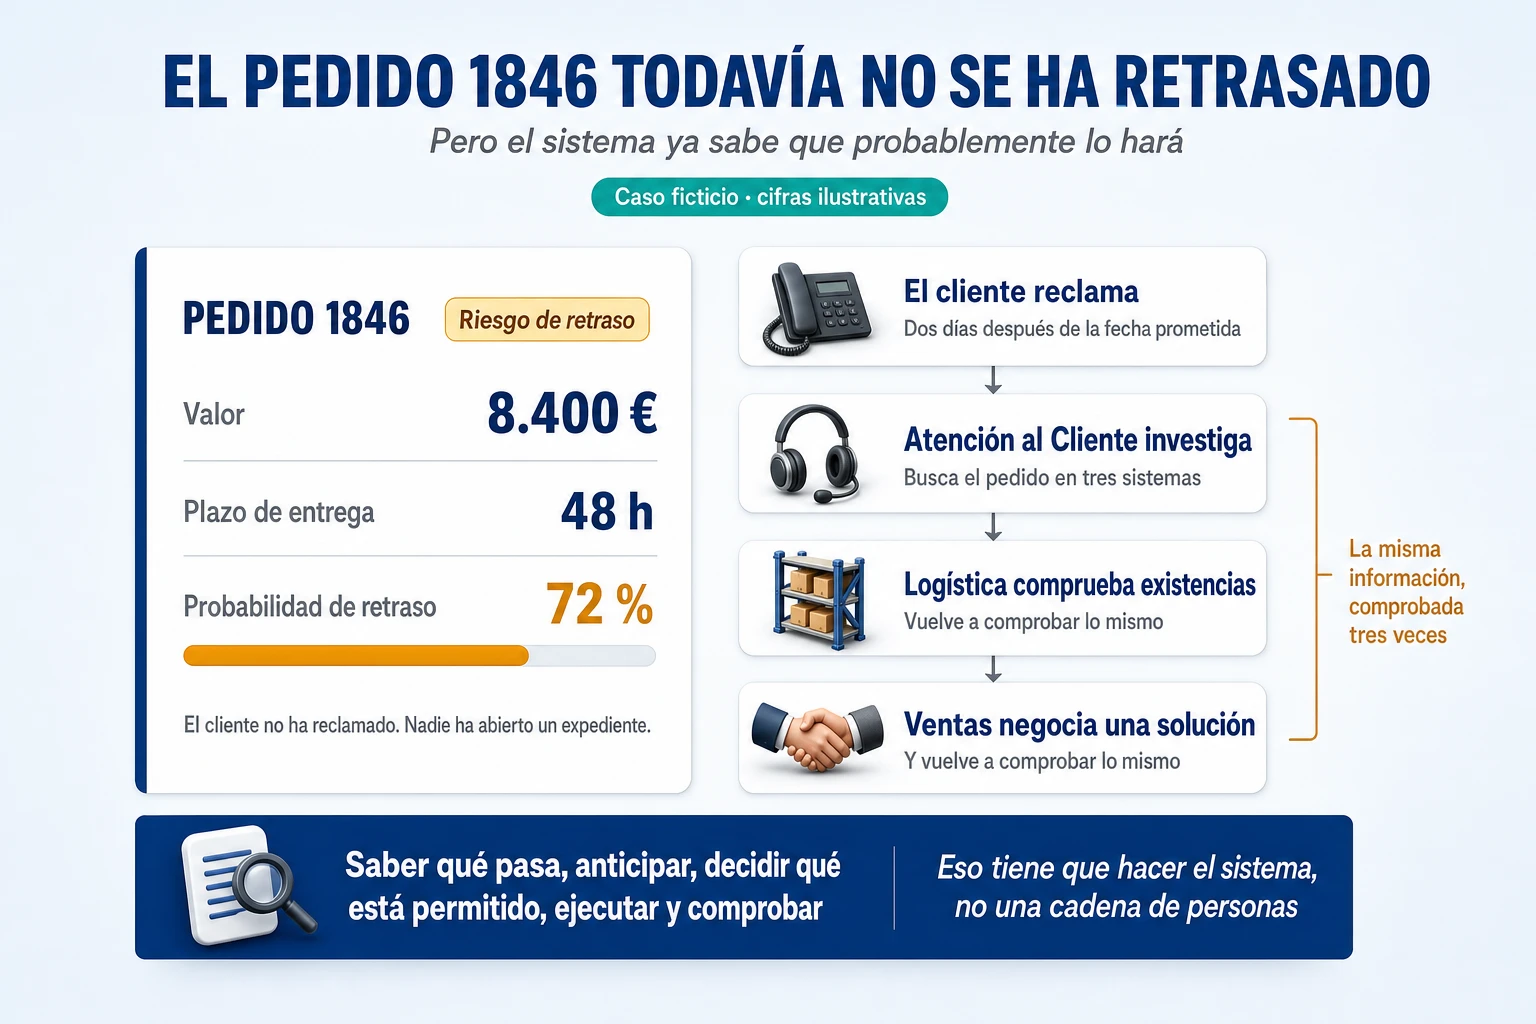
Martes, 9:40. En una distribuidora con tres almacenes, varios operadores logísticos y veinticinco mil pedidos a la semana, el sistema marca el pedido 1846. Vale 8.400 euros, el compromiso de entrega vence en 48 horas y la probabilidad estimada de que llegue tarde es del 72 %. El cliente no ha reclamado, nadie ha abierto un expediente y, sin embargo, el sistema ya sabe que ese pedido va a fallar. El caso es ficticio y las cifras son ilustrativas, pero la situación la reconoce cualquiera que haya trabajado en operaciones.
Conviene detenerse en lo que pasa hoy en una empresa así cuando ese pedido se retrasa, porque es el punto de partida de todo lo que viene después. El cliente llama dos días después de la fecha prometida. Atención al Cliente busca el pedido en tres sistemas y abre una incidencia. Logística comprueba las existencias y descubre que una de las referencias no estaba disponible en el almacén que debía servirla. Ventas interviene para negociar una solución con el cliente. Cada una de esas personas vuelve a comprobar lo que la anterior ya sabía, y la solución que al final se acuerda, un envío urgente desde otro almacén, es la misma que se habría tomado el martes a las 9:40 si alguien hubiera estado mirando.
Lo que tendría que hacer un sistema en su lugar se puede decir en cuatro verbos. Primero, saber qué está pasando y por qué: qué referencia falta, en qué almacén, desde cuándo. Después, anticipar las consecuencias y encontrar alternativas: qué pasa si esperamos a la reposición, qué pasa si dividimos el envío, qué pasa si trasladamos stock. En tercer lugar, decidir qué actuación está permitida, porque no todas las soluciones cuestan lo mismo ni todas puede autorizarlas una máquina. Y por último, ejecutar la actuación y comprobar que ha funcionado. Saber, anticipar, decidir y actuar son cuatro capacidades distintas, y ninguna tecnología las cubre las cuatro.
Aquí aparece la intuición que este artículo quiere corregir. Cuando una empresa decide resolver este problema con inteligencia artificial, lo primero que suele construir es un agente que consulta el ERP, lee el pedido y propone algo. Es un paso razonable y, a la vez, es muy poco. Construir un agente que consulte el ERP no es construir un sistema inteligente de gestión de pedidos: es construir una de sus siete piezas. Las otras seis, que son las que saben cómo funciona de verdad el proceso, cómo se relacionan los pedidos con las existencias, qué va a pasar, qué alternativas hay, qué está permitido y cómo se ejecuta sin romper nada, no las aporta el modelo de lenguaje. Las aportan los datos, los modelos predictivos, los simuladores, los motores de reglas, los motores de proceso y los sistemas que la empresa ya tiene.
Por eso este artículo utiliza un concepto más amplio que el de agente o el de plataforma de agentes: el de sistema empresarial inteligente. La ventaja de ese nombre es que no presupone cómo se resuelve cada parte. Un sistema empresarial inteligente integra IA predictiva, agentes, simulación, reglas, aplicaciones y personas, y en cada caso la proporción cambia. Conecta lo que la empresa sabe de su operación con la capacidad de anticipar, decidir y actuar; los agentes aportan razonamiento y flexibilidad, y todo lo demás lo aportan componentes que se pueden validar. Hay procesos en los que casi todo el valor está en las reglas y el flujo, y el agente es una pieza pequeña; hay otros en los que hacen falta varios agentes especializados. El método para construirlos es el mismo.
Vamos a construir ese sistema para el pedido 1846, etapa por etapa, tomando en cada una las decisiones que habría que tomar de verdad: descubrir cómo funciona realmente el proceso de pedidos, construir el contexto que relaciona pedidos, existencias y almacenes, anticipar y simular lo que puede pasar, diseñar el agente que investiga y propone, ejecutar la decisión de punta a punta con garantías, elegir con qué tecnologías se construye todo esto, escalarlo cuando otros departamentos empiecen a construir lo suyo e industrializarlo para que funcione en producción. En cada etapa veremos qué problema aparece en el pedido, qué capacidad hace falta, qué decisión de diseño se toma y qué queda construido al final. Después, dos casos más con arquitecturas distintas, un siniestro de hogar de 460 euros y una oferta para una licitación de cinco millones, para ver que el método no cambia aunque cambien las piezas. Y al final, un párrafo para explicarlo en una reunión.
Qué es un sistema empresarial inteligente, y por qué es más que una plataforma de agentes
Antes de construir nada conviene fijar qué hace falta, porque de lo contrario la conversación se convierte en una comparación de productos. Un sistema empresarial inteligente es el conjunto de componentes que permite a una empresa saber qué está pasando en su operación, entender cómo se relacionan las cosas, anticipar lo que va a ocurrir, evaluar alternativas, aplicar su propia política, razonar sobre cada caso y ejecutar con garantías. Son siete capacidades, y cada una responde a una pregunta que las demás no responden. La tabla las resume, con quién aporta cada una y, sobre todo, con lo que no es, porque las confusiones son más frecuentes que los aciertos.
| Capacidad | La pregunta que responde | Quién la aporta | Lo que NO es |
| Saber qué está pasando | ¿Cómo funciona de verdad el proceso y qué está ocurriendo ahora? | Process mining, eventos de los sistemas, datos operativos | No es el procedimiento oficial |
| Entender cómo se relacionan las cosas | ¿Qué depende de qué? | Modelo semántico, grafo de conocimiento, gemelo digital | No es una API que devuelve un número |
| Anticipar | ¿Qué es probable que pase? | Modelos predictivos | No es una alerta por umbral |
| Evaluar alternativas | ¿Qué pasaría si…? ¿Cuál cumple mejor? | Simulación y optimización | No es la opinión del modelo de lenguaje |
| Aplicar la política de la empresa | ¿Qué está permitido y qué exige aprobación? | Motor de reglas y tablas de decisión | No es una frase en el prompt |
| Razonar sobre la situación | ¿Qué hacemos con este caso concreto? | Agente de IA | No es quien ejecuta la transacción |
| Ejecutar con garantías | ¿Cómo se hace realidad, se verifica y se recupera si falla? | Motor de proceso, APIs, sistemas corporativos, personas | No es una secuencia de llamadas desde el agente |
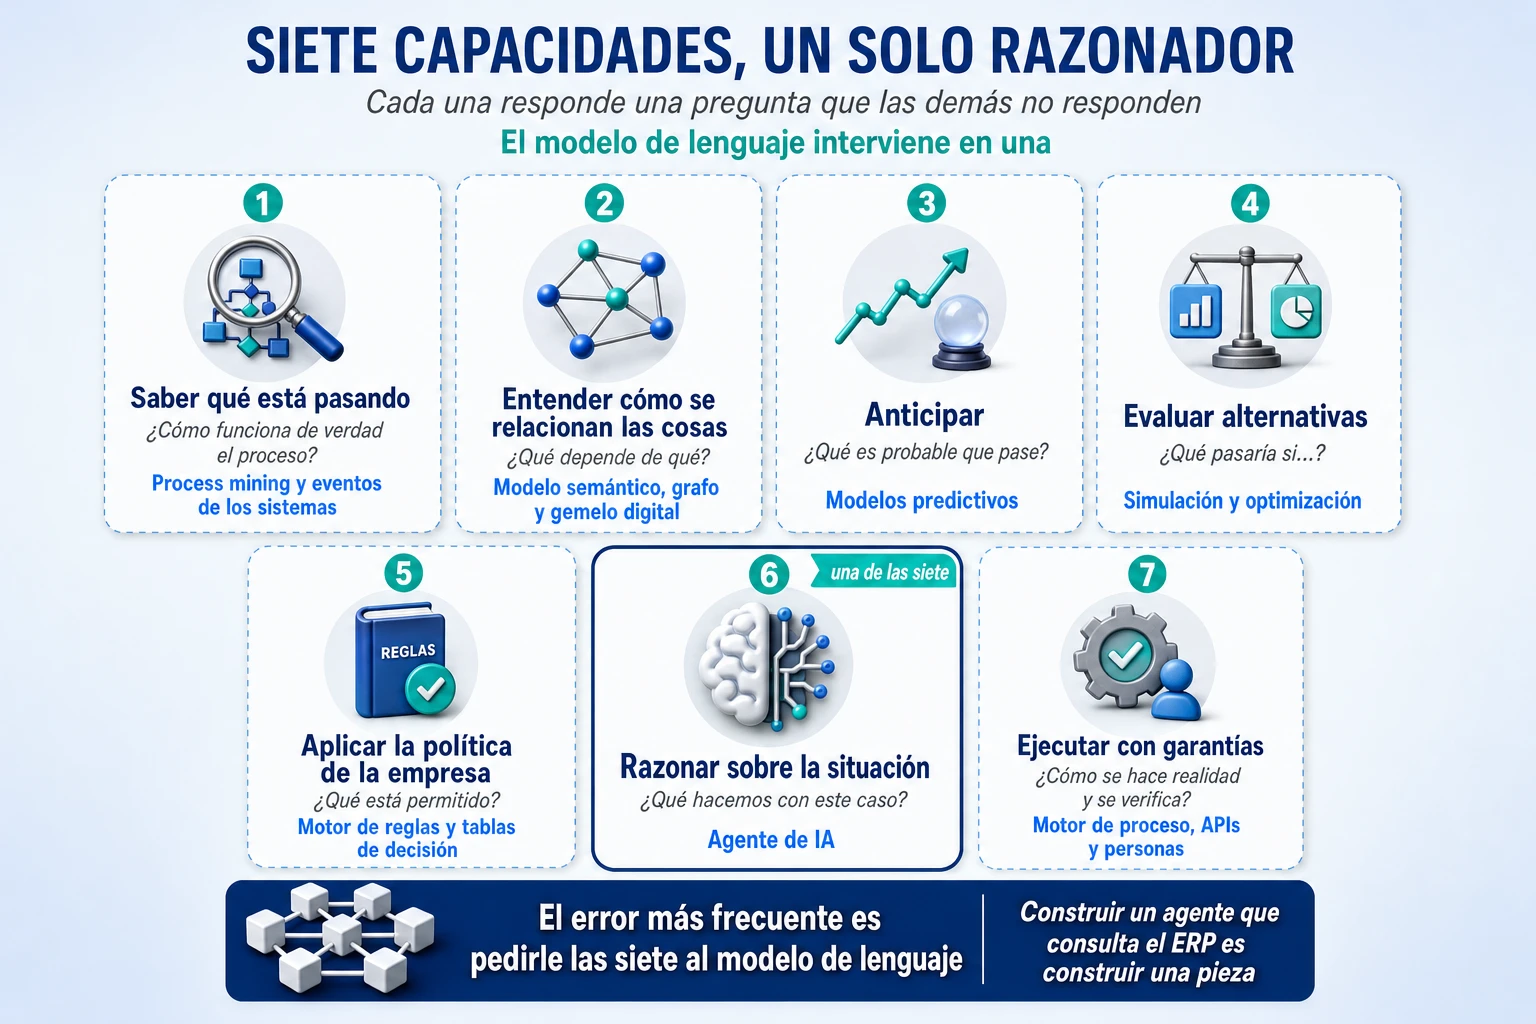
Lo que más llama la atención de esa tabla es que el modelo de lenguaje interviene en una sola fila. El error más frecuente en los proyectos de IA agéntica es pedirle las siete capacidades al modelo: que adivine cómo funciona el proceso leyendo el procedimiento, que deduzca las relaciones entre pedidos y existencias consultando una API tras otra, que estime cuánto va a tardar un transporte, que compare alternativas de memoria, que recuerde la política de gasto porque alguien la escribió en el prompt, y que además ejecute las reservas llamando a los sistemas una detrás de otra. Cada una de esas peticiones tiene una respuesta mejor en otro componente, y casi todas las empresas ya tienen ese componente o pueden tenerlo sin inventar nada.
Se entiende mejor con el pedido 1846. Saber qué está pasando es que el proceso real de pedidos esté reconstruido a partir de los eventos del ERP, del almacén y del transporte, y no a partir del manual. Entender cómo se relacionan las cosas es que el sistema sepa que las veinte unidades que figuran en Madrid están comprometidas en parte para otros dos pedidos. Anticipar es el 72 %. Evaluar alternativas es que un simulador diga qué pasa con el plazo si se divide el envío entre dos almacenes. Aplicar la política es que una tabla de decisión diga que un sobrecoste de hasta cien euros se autoriza solo y por encima lo aprueba una persona. Razonar es que el agente lea todo lo anterior, investigue lo que no cuadra y proponga. Y ejecutar con garantías es que un proceso reserve, expida, avise y compruebe, y que si una reserva falla a mitad de camino no se quede nada a medias.
Si se ordenan esas capacidades como capas, aparece el mapa funcional del sistema. Arriba están los procesos y los objetivos del negocio, de donde sale qué se quiere conseguir y cómo se trabaja de verdad. Debajo, la capa de experiencia y activación: las aplicaciones, los copilotos, los eventos y las APIs por donde entra una petición o un aviso. A continuación, la orquestación del proceso, que coordina pasos, decisiones y personas a lo largo de horas o días. En el centro conviven dos bloques que trabajan en paralelo y que conviene no confundir: el razonamiento y los agentes, por un lado, y la inteligencia especializada, por otro, es decir, la predicción, la optimización, la simulación y las reglas de decisión. Debajo de los dos, el contexto y la representación del negocio: el modelo semántico, el grafo de conocimiento y, cuando se justifica, el gemelo digital. Más abajo, los datos, las herramientas y los sistemas: APIs, MCP, el ERP, el CRM, el sistema de almacén y los eventos que emiten. Y atravesándolo todo, las capacidades transversales sin las que nada de lo anterior es operable: identidad, seguridad, observabilidad, evaluación, control de costes y gobierno.
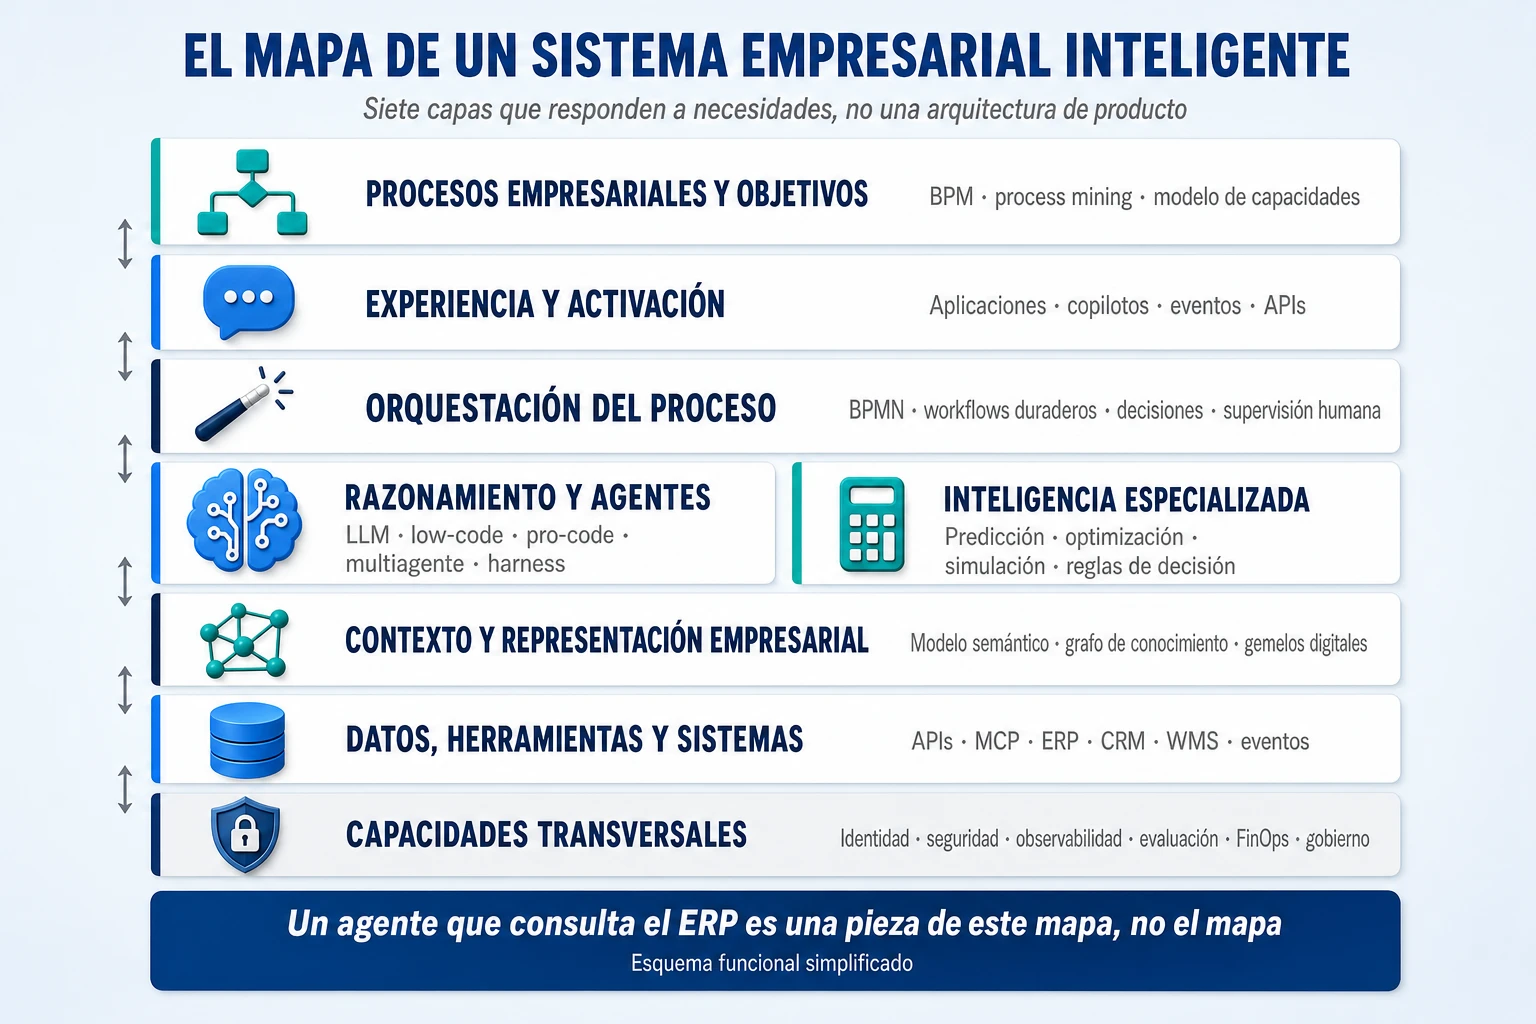
Ese mapa explica por qué un sistema así es algo más amplio que una plataforma de agentes. La plataforma, la que se describe en cómo acelerar la implantación de una plataforma de agentes en una empresa, es la capa que da a los agentes identidad, acceso gobernado a herramientas y datos, observabilidad y control de costes; se monta una vez y la usan todos los casos. Pero la plataforma no sabe cómo funciona el proceso de pedidos, no predice retrasos, no simula envíos y no decide cuánto gasto autoriza la empresa. Un sistema empresarial inteligente combina tecnologías que las empresas llevan décadas usando, como la gestión de procesos, los datos, la analítica y la automatización, con una capacidad nueva, el razonamiento agéntico, y el valor está en la combinación, no en la pieza nueva. Es un esquema funcional simplificado: muchas interacciones son bidireccionales y las capacidades pueden distribuirse entre plataformas distintas.
Conviene también situar este artículo respecto a lo que ya está publicado en este blog, porque cada pieza responde a una pregunta distinta y aquí no se repiten. Soluciones de IA: de RAG a agentes autónomos y sistemas multiagente explica qué tipos de solución existen y cuánta autonomía necesita cada problema; es el artículo al que hay que ir cuando la duda es si una tarea necesita un agente, un workflow o un modelo. El de la plataforma explica la infraestructura común. Y reingeniería de procesos con IA agéntica: casos de antes y después explica cómo cambia el trabajo y qué pasos desaparecen cuando se rediseña un proceso con estas capacidades. Este artículo enseña lo que ninguno de los tres cuenta: cómo se combinan todas esas tecnologías para implantar una solución completa, de problema empresarial a sistema en producción.
Y una advertencia antes de empezar, porque el ejemplo que vamos a seguir es deliberadamente completo. El pedido 1846 va a necesitar predicción, simulación, un gemelo de la operación, un agente y un motor de proceso, y los va a necesitar porque la distribuidora tiene tres almacenes con recursos compartidos y veinticinco mil pedidos semanales entre los que cada decisión afecta a otras. En la mayoría de los procesos de una empresa bastan reglas y cálculos sobre los datos existentes, y el gemelo digital o el simulador solo se justifican cuando hay muchas dependencias y recursos compartidos. Si al terminar de leer alguien concluye que necesita un gemelo digital para gestionar pedidos, este artículo habrá fallado. El objetivo es enseñar todas las piezas sobre un caso en el que todas hacen falta, para que después cada lector sepa cuáles sobran en el suyo.
Etapa 1. Descubrir cómo funciona realmente la gestión de pedidos
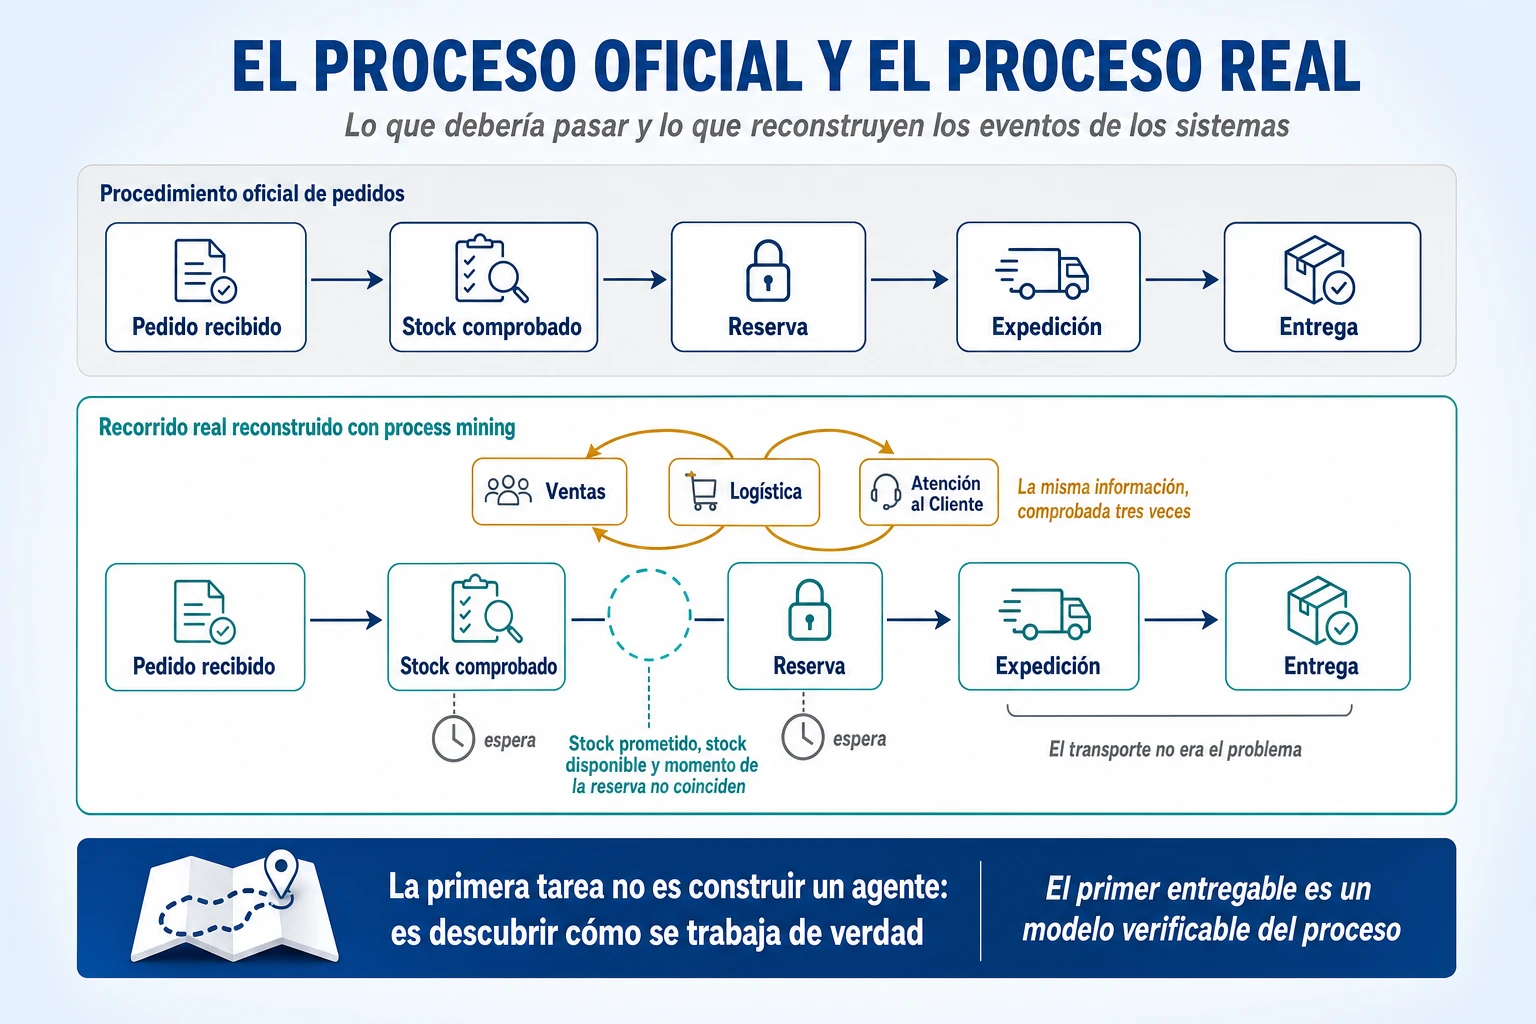
La primera tarea no es desarrollar agentes: es descubrir cómo se trabaja de verdad. La distribuidora tiene un procedimiento oficial de gestión de pedidos, con sus pasos, sus responsables y sus plazos, y tiene también una realidad hecha de excepciones, aprobaciones que nadie recuerda por qué existen, traspasos entre departamentos y recorridos que el procedimiento no contempla. Cualquier sistema que se construya sobre el procedimiento oficial automatizará un proceso que no existe. Por eso la etapa 1 consiste en medir la distancia entre los dos y en decidir, con esa medida delante, qué parte del proceso merece la pena cambiar.
BPM y process mining: el plano y la realidad
Hay dos disciplinas para hacerlo, y son complementarias porque miran el proceso desde lados opuestos. La gestión de procesos de negocio, el BPM, lo mira desde el diseño: con una notación como BPMN, que es un estándar con quince años de vida y que el propio organismo que lo mantiene describe como lo bastante preciso para traducir el diagrama en componentes software, se representan las actividades, los responsables, los eventos, las decisiones y las excepciones. Modelar antes de automatizar obliga a explicitar lo que hasta entonces era conocimiento tácito repartido entre personas, y convierte el proceso en un objeto que se puede discutir, versionar, medir y ejecutar. La investigación sobre seguridad en organizaciones complejas tiene un nombre para la distancia que ese plano no ve: Hollnagel y sus colegas la llamaron en 2015 la diferencia entre el trabajo imaginado, que describe lo que debería ocurrir en condiciones normales, y el trabajo realizado, que describe lo que ocurre de verdad.
El process mining mira el proceso desde la realidad. El manifiesto que fundó la disciplina, publicado por un grupo de trabajo del IEEE en 2011, lo define como descubrir, monitorizar y mejorar «procesos reales, es decir, no los procesos supuestos» a partir de los registros de eventos que los sistemas ya guardan. Lo que necesita es poco y a la vez es lo más caro de conseguir: un registro en el que cada evento se refiera a una actividad y a un caso concreto, ordenado en el tiempo. En la distribuidora el caso es el pedido, las actividades son «pedido creado», «disponibilidad comprobada», «stock reservado», «preparado», «expedido», «entregado» y «reclamado», y las marcas de tiempo están repartidas entre el ERP, el sistema de almacén, el de transporte y el CRM. El propio manifiesto señala como primer reto de la disciplina encontrar, fusionar y limpiar esos datos, y quince años después sigue siendo donde se va la mayor parte del esfuerzo de esta etapa: localizar las tablas en tres sistemas, unificar identificadores y limpiar.
Lo que devuelve a cambio es lo que ninguna entrevista devuelve. Devuelve el mapa real con la frecuencia de cada camino; la lista de variantes ordenada por volumen, que suele ser larguísima; los tiempos entre actividades, que es donde aparecen las esperas, porque las tareas en sí suelen ser cortas y lo que tarda es la cola entre un departamento y el siguiente; las desviaciones respecto al procedimiento, con pasos saltados, repetidos o fuera de orden; el retrabajo, que se ve como bucles; y los traspasos entre roles y sistemas. Un pedido real complica además el análisis clásico, porque tiene varias líneas, cada línea puede ir en una entrega distinta y una entrega puede agrupar líneas de varios pedidos; para eso existe desde 2024 un estándar abierto, OCEL 2.0, que permite registrar eventos que afectan a varios objetos a la vez sin forzar un único identificador de caso. Es la novedad técnica real que hay detrás de lo que Celonis, SAP Signavio o UiPath venden como «process intelligence»: la etiqueta es comercial, Gartner sigue evaluando la categoría como plataformas de process mining, con dieciséis fabricantes en su cuadrante de 2025, pero el avance, ver el proceso desde el pedido, la línea, la entrega y la factura a la vez, es de verdad. El task mining, que graba clics y pantallas para rellenar lo que ocurre entre dos eventos, es un complemento útil que en Europa exige garantías de protección de datos, no un sustituto.
Lo que descubre la distribuidora
El análisis de la distribuidora revela dos cosas que nadie había visto así. La primera es que los retrasos no se producen principalmente en el transporte, como todo el mundo suponía, sino antes: en la discrepancia entre el stock que se promete al cliente al tomar el pedido, el que realmente está disponible y el momento en que se reserva. Entre que un comercial confirma una fecha y el almacén bloquea las unidades pasan horas, a veces un día, y en ese hueco otros pedidos consumen las mismas existencias. La segunda es el bucle: cuando surge un problema, el expediente pasa de Ventas a Logística y después a Atención al Cliente, y cada departamento vuelve a recopilar información que el anterior ya tenía. Ese bucle no está en el procedimiento oficial, no lo gestiona nadie y es, con diferencia, la variante más cara del proceso.
El caso es ficticio, pero el patrón no lo es. Una tesis de la Universidad de Chalmers publicada en enero de 2026, hecha con la empresa de alimentación Paulig sobre su proceso de pedido a cobro en un ERP de Infor, analizó 6.740 pedidos con 192.090 eventos y encontró que solo el 5,4 % seguía el modelo de referencia del sector; los cuellos de botella estaban en los datos maestros, en los bloqueos de crédito y en la asignación de stock, no en el transporte, y el responsable del proceso ignoraba que Atención al Cliente llamaba a Ventas cada día para confirmar pedidos, un hallazgo que él mismo calificó de ligeramente alarmante. Lo que tiene de valioso ese estudio es que es independiente, porque lo que no existe es una medición independiente del beneficio económico del process mining: las cifras de ahorro que circulan son de fabricantes o de consultoras, y lo que la literatura académica sí ha medido es que aumenta la transparencia del proceso. Siemens, que lleva más de una década aplicándolo a su proceso de pedidos, sirve para entender la escala a la que esto se complica, con más de treinta millones de líneas de pedido al año y cerca de un millón de variantes distintas según sus propias cifras, no para prometer un retorno.
Con el mapa real delante aparece la decisión que de verdad importa en esta etapa, y que no es tecnológica. El bucle entre tres departamentos se puede automatizar tal cual, con un agente que lo recorra más deprisa, o se puede eliminar, haciendo que el pedido en riesgo se detecte y se resuelva antes de que exista una reclamación. La diferencia entre las dos opciones es la diferencia entre acelerar el camino de vacas y trazar uno nuevo, y es el argumento central de reingeniería de procesos con IA agéntica: casos de antes y después: antes de automatizar un paso hay que preguntarse qué pantalla sobra. En la distribuidora sobra la reclamación del cliente como disparador, sobra la investigación por triplicado y sobra la negociación a posteriori. Eso es lo que el nuevo proceso tiene que dejar de hacer.
Las decisiones que se toman aquí y condicionan todo lo demás
Del mapa real salen cuatro decisiones que las etapas siguientes van a dar por hechas. La primera es qué evento dispara el sistema: en el proceso nuevo no es la reclamación del cliente, sino el momento en que un pedido entra en riesgo, lo que obliga a que exista un evento de ese tipo y a que alguien lo emita. La segunda es qué actividades se automatizan, cuáles exigen juicio y cuáles exigen aprobación; comprobar disponibilidad es automatizable, elegir entre tres maneras de entregar exige juicio y autorizar un sobrecoste por encima de cierto importe exige una persona. La tercera es qué resultado se mide. El sistema no se mide por cuántos agentes despliega ni por cuántas propuestas genera, sino por cuántos pedidos se entregan dentro del plazo prometido y a qué coste, que es la métrica que ya existe en la empresa y la única que el cliente nota.
La cuarta decisión es menos evidente y tiene consecuencias años después: de quién son los eventos. El registro de eventos sobre el que se construye todo lo demás vive hoy en las tablas del ERP y del sistema de almacén, y acceder a él depende de los extractores de cada fabricante. En 2025 esa dependencia llegó a los tribunales: Celonis demandó a SAP en California por el acceso a los datos de su ERP, SAP se comprometió en junio a no interferir con el extractor ni cobrar por él mientras dure el caso, y el juicio está previsto para 2027, sin que nada esté sentenciado. La lección práctica no espera a la sentencia: el registro de eventos de la operación conviene materializarlo en una capa de datos propia, con los identificadores unificados, y no dejarlo dentro del extractor de nadie. Ese registro es, además, la materia prima de las etapas que vienen: sobre él se construye el contexto, se entrena la predicción y se calibra el simulador.
Al terminar la etapa 1 la distribuidora tiene un modelo verificable de cómo funciona hoy la gestión de pedidos, con sus variantes, sus esperas y su bucle cuantificados; un diseño funcional del proceso nuevo, en el que el pedido en riesgo se detecta y se resuelve antes de la reclamación; y la lista de eventos, reglas y excepciones que ese proceso tiene que manejar. El primer entregable no es un agente, y eso no es un retraso: es lo que impide construir el agente equivocado.
Etapa 2. Construir el contexto: del dato suelto al conocimiento de la operación
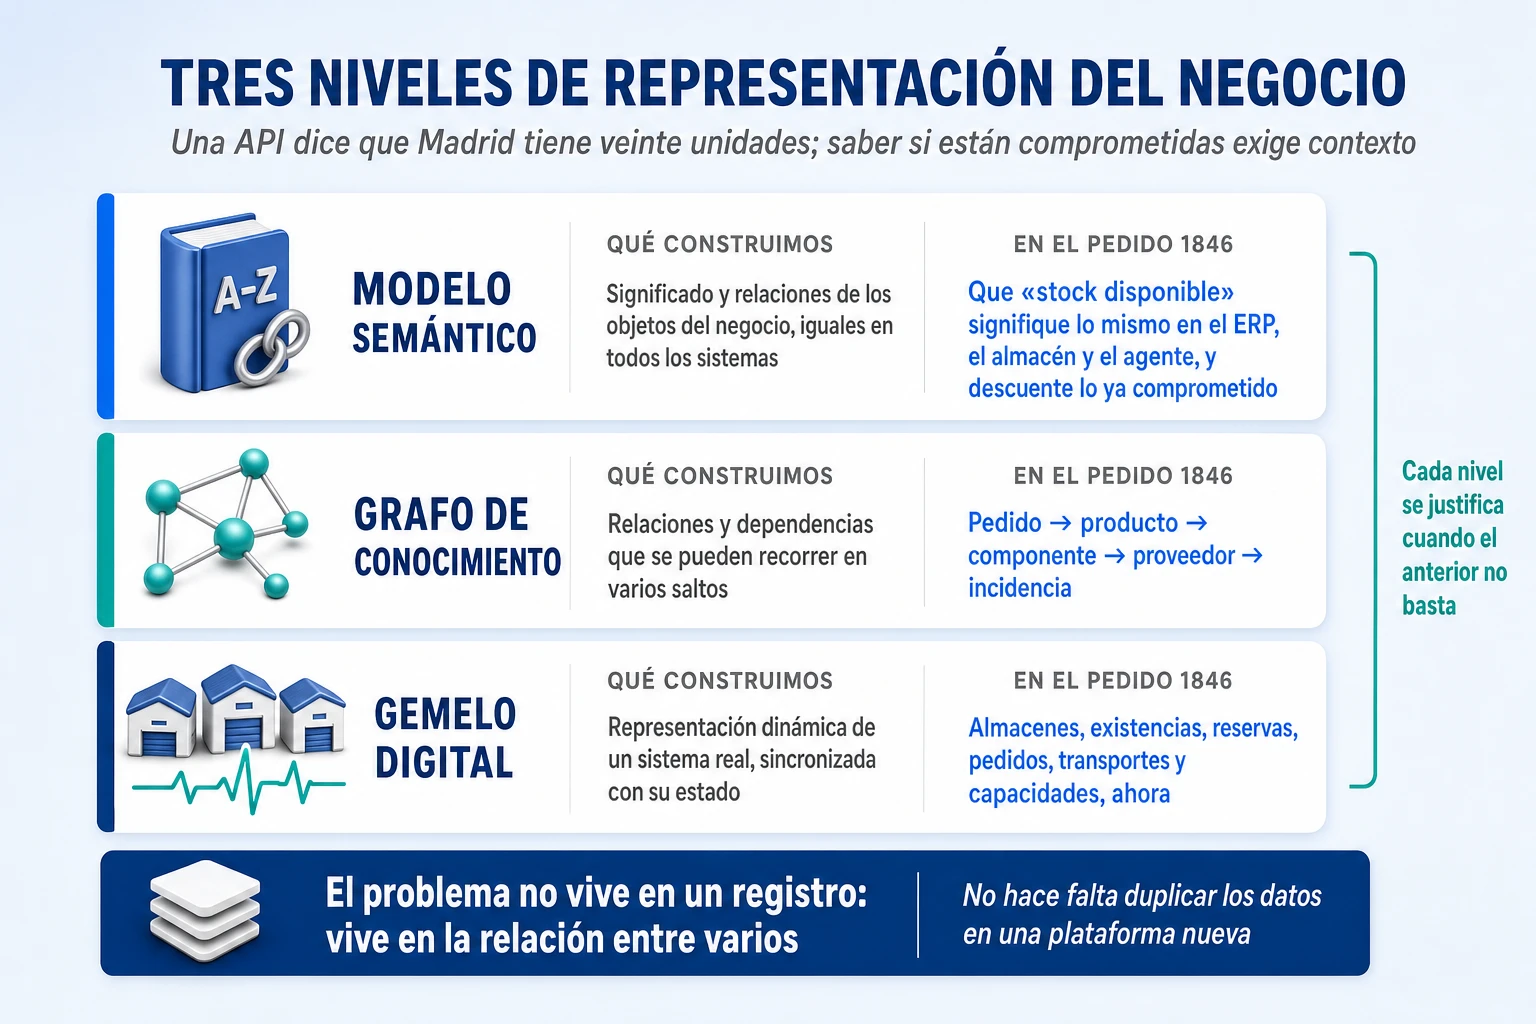
Una API puede decir que el almacén de Madrid tiene veinte unidades; saber si están comprometidas para otros pedidos, si pueden trasladarse y qué pasaría con el resto de la operación si se trasladan exige contexto. Los sistemas de una empresa organizan la información por aplicaciones: el ERP conoce los pedidos, el CRM conoce a los clientes, el sistema de almacén conoce las existencias, el de transporte conoce los envíos y el financiero conoce los costes. Resolver el pedido 1846 exige combinar todo eso, y el problema casi nunca está en un registro aislado sino en la relación entre varios. Esta etapa consiste en construir la representación del negocio sobre la que el resto del sistema va a razonar, predecir y simular.
Tres niveles de representación, y cuándo basta cada uno
El primer nivel es el modelo semántico, y responde a una pregunta humilde que arruina más proyectos de los que parece: qué significa cada cosa. Que «stock disponible» signifique lo mismo en el ERP, en el almacén y en la respuesta del agente, y que descuente lo ya comprometido; que «pedido entregado a tiempo» se calcule igual en Logística y en Finanzas. Las capas semánticas que las plataformas de datos llevan años construyendo para las herramientas de informes, como las de dbt, Databricks, Snowflake, Microsoft Fabric o Cube, se han reposicionado desde 2025 como la pieza que da a un modelo de lenguaje las definiciones de negocio y las uniones correctas antes de que genere una consulta, y casi todas exponen ya sus métricas a agentes. Lo que hay que saber de ellas es que son de solo lectura y que no modelan el estado operativo: dicen cuánto vale una métrica, no qué reservas hay abiertas ahora sobre esas veinte unidades. Para el pedido 1846 son necesarias y no son suficientes.
El segundo nivel es el grafo de conocimiento, y responde a qué depende de qué. Un pedido depende de un producto que usa un componente que suministra un proveedor que tiene abierta una incidencia; recorrer esa cadena de cuatro saltos es posible con una base de datos relacional si alguien escribió de antemano las uniones, pero en un grafo las relaciones están explícitas y se pueden recorrer sin conocer el camino, que es exactamente lo que un agente aprovecha mejor que una consulta prefijada. Conviene separar el grafo de dependencias de la operación, que sí vale, de lo que se ha llamado GraphRAG, que es opcional. El método que Microsoft Research publicó en 2024 para resumir corpus documentales construyendo un grafo de entidades midió «exhaustividad» y «diversidad» con otro modelo como juez, no exactitud, y su repositorio de referencia está desde 2026 en modo de mantenimiento; dos evaluaciones independientes publicadas en 2025 y 2026 encontraron entre tres y diez puntos de mejora en preguntas que exigen encadenar varios saltos, hasta once puntos de pérdida en preguntas factuales simples, y un coste de indexación entre cuarenta y cincuenta y siete veces mayor. Para explicar por qué el pedido 1846 está en riesgo hace falta el grafo de dependencias; para buscar en la documentación, en la primera versión basta la recuperación convencional.
El tercer nivel es el gemelo digital, y responde a cómo está ahora el sistema real y cómo se comportan sus partes. Es una representación dinámica de los almacenes, las existencias, las reservas, los pedidos en curso, los transportes y las capacidades, mantenida con los datos del sistema real a una frecuencia determinada. Cada nivel se justifica cuando el anterior no basta, y el tercero solo lo hace cuando hay recursos compartidos cuyo estado cambia deprisa y decisiones que se afectan entre sí, que es el caso de tres almacenes y veinticinco mil pedidos semanales, y no es el caso de la mayoría de los procesos administrativos de una empresa.
| Nivel | Qué construimos | En el pedido 1846 | Cuándo se justifica |
| Modelo semántico | Significado y relaciones de los objetos del negocio, iguales en todos los sistemas | «Stock disponible» descuenta lo comprometido en el ERP, en el almacén y para el agente | Siempre; es la base de todo lo demás |
| Grafo de conocimiento | Relaciones y dependencias que se pueden recorrer en varios saltos | Pedido → producto → componente → proveedor → incidencia abierta | Cuando las preguntas encadenan relaciones que nadie unió de antemano |
| Gemelo digital | Representación dinámica del sistema real, sincronizada con su estado | Almacenes, existencias, reservas, pedidos, transportes y capacidades, ahora | Cuando hay recursos compartidos y decisiones que se afectan entre sí |
Hay un patrón que conviene conocer porque se ha convertido en la referencia de «capa sobre la que actúan agentes», y es el que Palantir llama ontología en su plataforma Foundry: objetos con propiedades, enlaces entre objetos y, lo que lo distingue de una capa semántica de informes, acciones con validaciones y permisos que un agente hereda igual que una persona. Lo importante no es el producto sino el patrón, objetos más enlaces más acciones con permisos, que se puede construir con un grafo de propiedades, un vocabulario alineado con los estándares del sector y un catálogo de acciones expuesto como servicios; en logística ese vocabulario ya existe, porque GS1 define identificadores de producto, ubicación y unidad logística y un estándar de eventos de visibilidad que es, de hecho, el modelo de eventos de la cadena de suministro. Sus detractores, que suelen ser competidores, le reprochan a Palantir el formato propietario, la dependencia y que su fortaleza visible sea orquestar decisiones y no la maquinaria de predicción y optimización que hay debajo; las dos críticas son justas y las dos coinciden con la tesis de este artículo, porque representar no es predecir ni simular. Microsoft está replicando el mismo patrón con un constructor de gemelos dentro de Fabric que, a fecha de este artículo, sigue en vista previa.
Gemelos digitales con rigor: de activo, de proceso y de organización
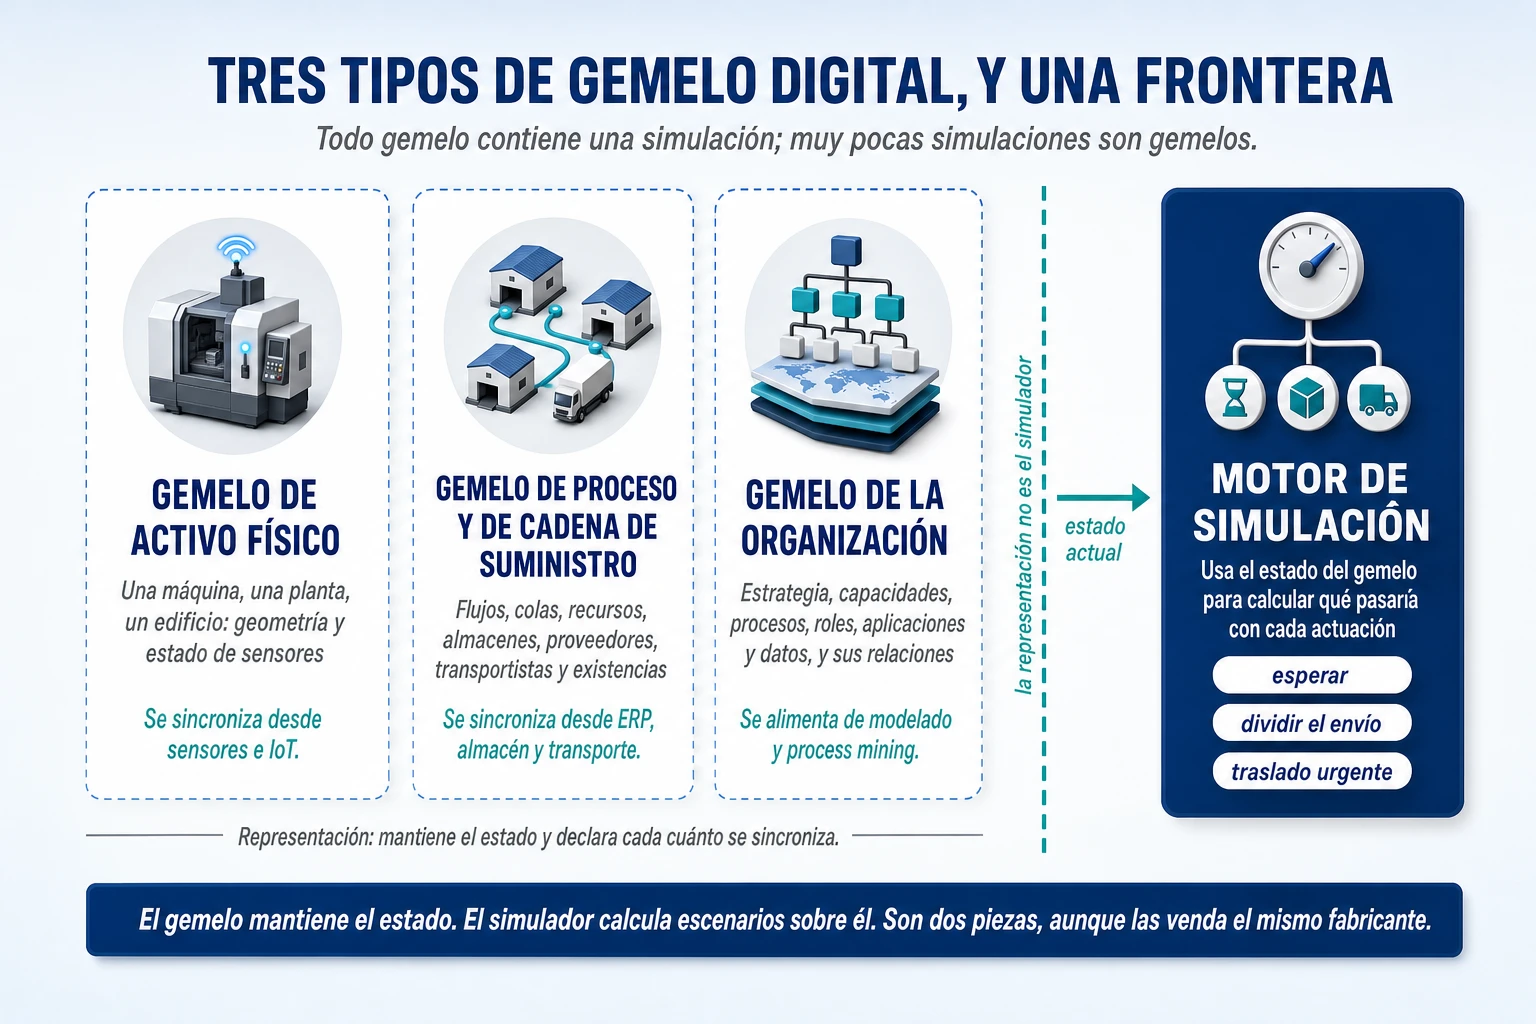
La palabra «gemelo digital» se usa para cosas tan distintas que conviene empezar por una definición con autor. El Digital Twin Consortium lo define como una representación virtual, integrada y basada en datos, de entidades y procesos del mundo real, «con interacción sincronizada a una frecuencia y fidelidad especificadas»; existe además una norma internacional de conceptos y terminología, ISO/IEC 30173, publicada en 2023. Las dos palabras que importan de esa definición son frecuencia y fidelidad: un gemelo no es «en tiempo real» por definición, es una representación que declara cada cuánto se sincroniza y con qué detalle. Una taxonomía académica muy citada, la de Kritzinger y sus colegas en 2018, añade la distinción que más ayuda a no engañarse: un modelo digital no intercambia datos automáticamente con la realidad, una sombra digital se actualiza desde la realidad pero no actúa sobre ella, y solo un gemelo tiene el flujo en los dos sentidos.
Con esa vara de medir se pueden distinguir tres tipos. El gemelo de activo físico representa una máquina, una planta o un edificio, con su geometría y el estado de sus sensores; es el territorio de Siemens, de NVIDIA Omniverse, de AWS IoT TwinMaker o de Azure Digital Twins, y no modela pedidos ni inventario. El gemelo de proceso y de cadena de suministro representa flujos, colas, recursos y tiempos, o una red de plantas, almacenes, proveedores y transportistas con sus existencias y restricciones; ahí están, con nombres distintos, Celonis, SAP Signavio, o9, Kinaxis, Blue Yonder o anyLogistix. Y el gemelo digital de la organización, el DTO, representa cómo opera la empresa entera: estrategia, capacidades, procesos, roles, aplicaciones, datos y sus relaciones. Gartner trata las plataformas DTO como un mercado propio desde 2019 y en julio de 2026 les dedicó su primer Magic Quadrant, con dieciocho fabricantes evaluados, y su definición de 2026 nombra expresamente a los agentes de IA entre lo que el DTO ayuda a orquestar. Conviene añadir el matiz honesto: la mayoría de los DTO comerciales son hoy herramientas de modelado y análisis que se alimentan de process mining, es decir, sombras digitales según la taxonomía anterior, y el propio Gartner pide como capacidad emergente la integración en tiempo real con los datos operativos y la simulación continua, lo que indica que la mayoría todavía no la tiene.
Y la distinción que ordena esta sección y evita el malentendido más caro: la representación digital no es el motor de simulación. El gemelo mantiene el estado; el simulador lo usa para calcular qué pasaría bajo distintas actuaciones. Son dos piezas, aunque a veces las venda el mismo fabricante dentro del mismo producto, como hace anyLogistix al separar explícitamente el modelo de la red, el optimizador y el simulador de eventos discretos. Un fabricante de simuladores lo resumió en 2026 con una frase que vale para todo el mercado: todo gemelo contiene una simulación, y muy pocas simulaciones son gemelos. Para la distribuidora, lo que se construye en esta etapa es la representación: el estado actualizado de los tres almacenes, sus capacidades, las reservas abiertas y las dependencias entre pedidos. Lo que se hace con ella es la etapa siguiente.
El contexto del pedido 1846
Cuando el sistema analice el pedido 1846, lo que tiene que poder reconstruir en una sola consulta es esto: el cliente y el compromiso de entrega que se le dio; los productos y cantidades; las existencias disponibles y las reservas ya abiertas en cada uno de los tres almacenes; las alternativas logísticas, con los transportistas y sus tiempos habituales; las restricciones contractuales, por ejemplo si el cliente admite entregas parciales; los costes y márgenes del pedido; y el estado actual del expediente. Nada de eso es una métrica agregada y nada de eso vive en un solo sistema, y por eso el contexto es un servicio que se construye una vez y consumen después el modelo predictivo, el simulador, el agente y las personas.
Construirlo no implica duplicar todos los datos en una plataforma nueva, y conviene decirlo porque es el miedo razonable de cualquier director de sistemas. El modelo semántico puede apoyarse en los sistemas existentes y el grafo de dependencias puede materializar solo las relaciones, no los registros completos; las tres formas de dar acceso al dato a un agente, por una API de negocio, por una consulta parametrizada o por una consulta generativa sobre un modelo semántico, están explicadas en el artículo sobre la plataforma de agentes enlazado más arriba, y aquí se dan por hechas. Al terminar la etapa 2 la distribuidora tiene una base de contexto que relaciona datos de varias aplicaciones, accesible como servicio con permisos, y un modelo dinámico de la operación que se sincroniza con la realidad a una frecuencia declarada. Todavía no predice nada ni decide nada: solo sabe cómo están las cosas y cómo se relacionan. Que ya es más de lo que sabía nadie en la empresa el martes a las 9:40.
Etapa 3. Anticipar y simular: predecir, comparar alternativas y aplicar la política
Esta etapa introduce capacidades que el modelo de lenguaje no tiene, y por eso es la que más proyectos se saltan. Predecir, simular, optimizar y aplicar reglas son cuatro cosas distintas, y las cuatro son estadísticas o deterministas, no generativas: cada una produce un número que se puede comprobar contra la realidad, y esa es exactamente la propiedad que el agente no tiene. Al terminar la etapa 2 el sistema sabe cómo están las cosas; al terminar esta sabe qué puede pasar, qué opciones existen y cuáles están permitidas. Todo eso antes de que el agente diga una palabra.
Predecir: de dónde sale el 72 %
El 72 % del pedido 1846 lo produce un modelo predictivo, y conviene saber qué hay detrás para no pedirle lo que no puede dar. En la práctica consolidada del sector el modelo hace dos cosas encadenadas: primero clasifica si el pedido llegará tarde respecto al compromiso, con una probabilidad, y después estima cuánto se retrasaría. Se alimenta de lo que el process mining ya señaló como causa, la disponibilidad real al prometer la fecha, las reservas comprometidas y la fecha de reposición de cada referencia, más el historial del transportista en ese trayecto, la carga del almacén, la hora de corte y la etapa del proceso en la que está el pedido. Lo que lo hace útil no es la precisión en un día concreto, sino que la predicción se recalcula en cada evento nuevo: cuando se confirma el pedido, cuando se intenta reservar, cuando sale del almacén. El 72 % de las 9:40 puede ser un 40 % a las 11:00 si llega una reposición, y el sistema tiene que saberlo.
Hay dos exigencias que separan un modelo útil de un adorno. La primera es la calibración: un 72 % solo sirve si, de todos los pedidos a los que el modelo asigna un 72 %, alrededor de siete de cada diez se retrasan de verdad, porque de lo contrario el umbral con el que el proceso decide abrir un expediente no significa nada. Existen técnicas conocidas para comprobarlo y corregirlo, y existe desde 2025 una familia de métodos, la predicción conformal, que en lugar de un punto devuelve un intervalo con cobertura garantizada; un trabajo del Georgia Tech aplicado a un gran minorista en línea encontró con ella un 75 % más de envíos tardíos detectados que con el sistema de reglas que la empresa usaba, y otro del mismo grupo en 2026, sobre más de diez millones de envíos reales, estimó la duración del retraso con un error medio de entre 0,67 y 0,91 días. La segunda exigencia es vigilar el deterioro: cambia la mezcla de pedidos, cambia un transportista, cambia el proceso, y el modelo que estaba calibrado deja de estarlo sin avisar. Eso se resuelve en la etapa 8, pero se decide aquí: la predicción emitida se guarda siempre, para poder compararla después con lo que pasó.
Los casos públicos enseñan algo más que cifras, y las cifras hay que leerlas con cuidado porque todas las publica quien las consigue. Project44 declara haber mejorado 28 puntos la precisión de su hora estimada de llegada a diez horas de horizonte, con más de ciento cincuenta variables y modelos distintos para corta y larga distancia; Flexport publica un 75 % de puntualidad en su tráfico transpacífico combinando históricos, horarios de las navieras y la supervisión de expertos humanos; FedEx describe cómo su sistema anticipa riesgos por paquete y reencamina, sin dar una cifra de precisión. Lo que tienen en común es más importante que lo que las separa: todas predicen tiempo o riesgo, ninguna decide; todas recalculan con cada evento; todas combinan el modelo con reglas o con personas; y ninguna usa un modelo de lenguaje para predecir. Esa es la arquitectura que la distribuidora copia.
Simular: tres maneras de entregar el pedido
Con el riesgo detectado, la pregunta ya no es si el pedido va a fallar sino qué se puede hacer, y eso lo responde un simulador que usa el estado del gemelo. Las tres alternativas son esperar a la reposición prevista, dividir el envío sirviendo parte desde Madrid y parte desde Valencia, o hacer un traslado urgente de stock entre almacenes. Para cada una, el simulador recorre el proceso muchas veces con tiempos muestreados del historial, los de preparación, los del transportista en ese trayecto, los de la reposición del proveedor, y cuenta en qué fracción de las repeticiones se cumple el plazo. Esa es la técnica, simulación de eventos discretos con muestreo de incertidumbre, y es lo que convierte un «probablemente llegue» en un porcentaje defendible. Un modelo de lenguaje no puede producir ese número, y si lo produce es una opinión con dos decimales.
| Alternativa | Coste extra | Probabilidad de cumplir el plazo |
| Esperar a la reposición | 0 € | 30 % |
| Dividir el envío entre dos almacenes | 85 € | 95 % |
| Traslado interno urgente | 170 € | 87 % |
| Estimaciones hipotéticas del caso ficticio, no datos reales. | ||
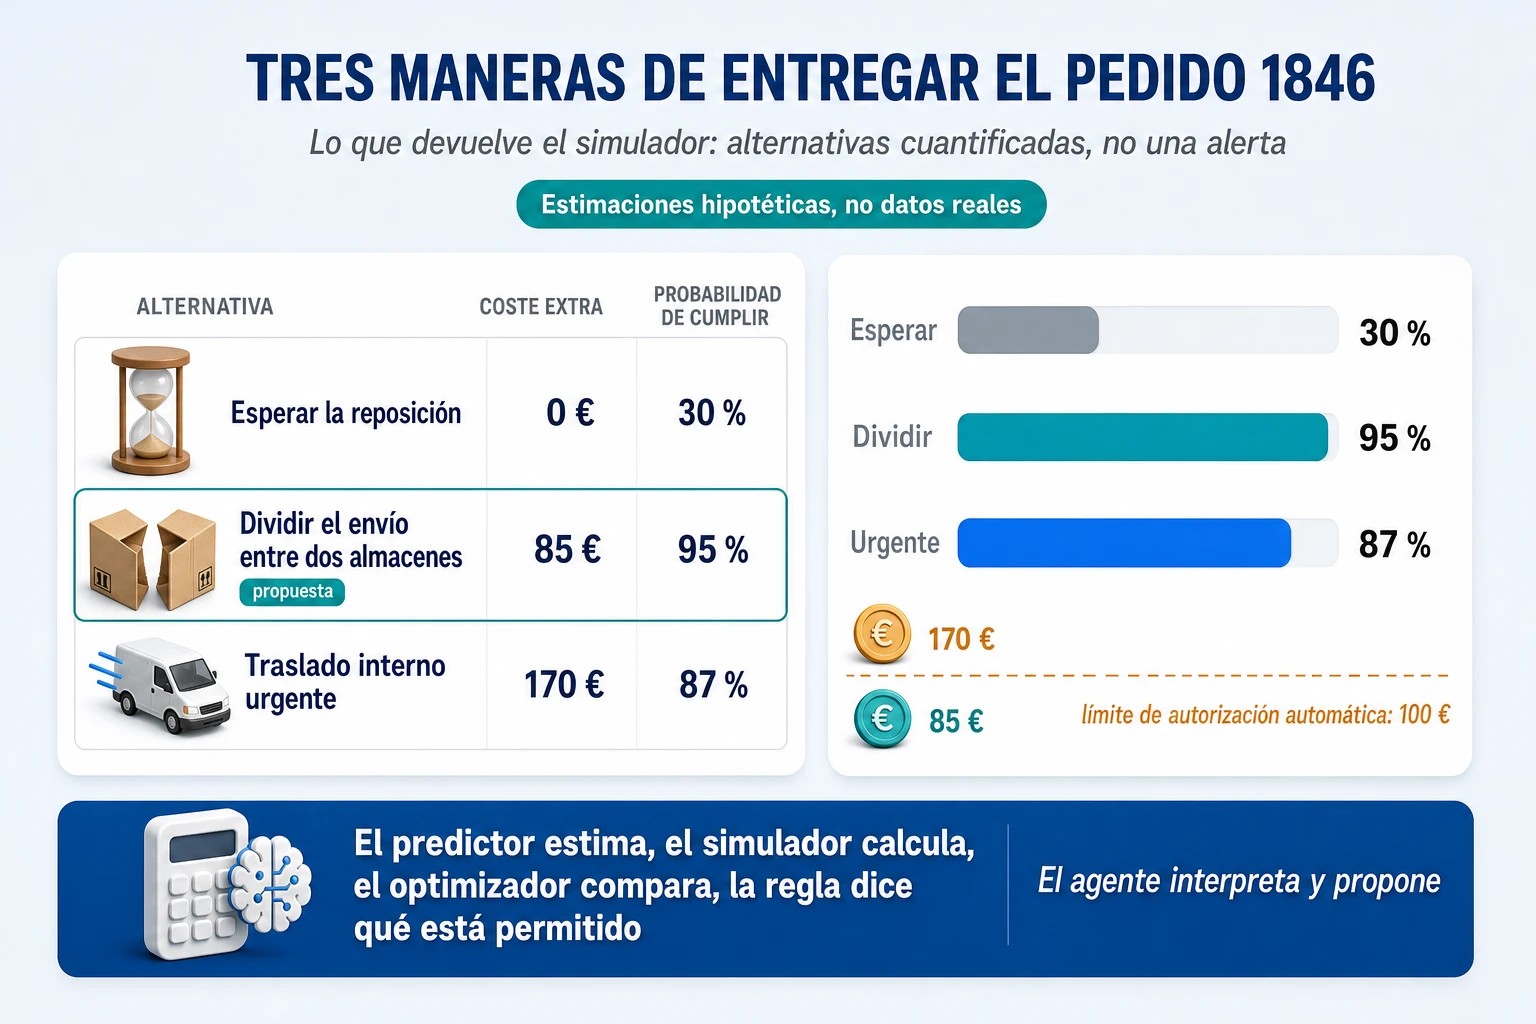
Al lado del simulador trabaja el optimizador, y conviene distinguirlos porque responden a preguntas distintas. La simulación responde a «qué pasaría si»; la optimización responde a «cuál es la mejor opción dentro de unas restricciones», y para eso usa programación lineal y entera, programación con restricciones o algoritmos de rutas, con solucionadores como Gurobi, CPLEX, los OR-Tools de Google o HiGHS, que es de código abierto y está debajo de medio ecosistema científico. En el pedido 1846 el optimizador compara las tres alternativas contra el coste, el plazo y las capacidades de los almacenes, y es quien dice que dividir el envío cumple mejor el objetivo; con diez pedidos en riesgo a la vez, es quien evita que la solución de uno consuma el stock que otro necesita. En la práctica las dos técnicas se combinan: el optimizador propone y el simulador evalúa.
Lo que hace posible todo esto es que el simulador no trabaja sobre un modelo genérico sino sobre el estado real de la operación, inicializado desde el gemelo de la etapa anterior. La literatura lo llama simulación en línea o simbiótica, y señala como reto técnico más difícil justamente ese: sincronizar el estado del modelo con el estado real antes de lanzar los escenarios. El patrón práctico es sencillo de enunciar y laborioso de mantener: el estado operativo inicializa el modelo, se lanzan escenarios de horizonte corto, el resultado vuelve al proceso como recomendación y el modelo se recalibra periódicamente contra lo observado. El pariente real más cercano del pedido 1846 es el inventario que se corrige solo de Walmart, que usa un gemelo digital y simulación para redirigir mercancía antes del amanecer; está contado en cuatro procesos que ya nadie ejecuta a mano y aquí basta con saber que existe y que funciona con las mismas piezas.
Decidir qué está permitido: el motor de reglas
El simulador dice que dividir el envío cuesta 85 euros y cumple en el 95 % de los casos; no dice si la empresa está dispuesta a gastarlos. Esa es la política, y la política vive en un sitio concreto que no es el prompt del agente: una tabla de decisión. La regla «un sobrecoste de hasta cien euros se autoriza automáticamente si el cliente es de clase A y el margen del pedido supera el 12 %; por encima, aprobación humana» es una fila de una tabla, con sus entradas, su salida y su versión, y la puede cambiar negocio un viernes por la tarde sin tocar el agente ni el proceso. El estándar para escribir esas tablas existe desde 2015 y se llama DMN; define un diagrama de dependencias entre decisiones, las propias tablas y un lenguaje de expresiones legible por negocio, y obliga a decidir por adelantado qué pasa cuando varias reglas se cumplen a la vez, que es justo lo que un modelo de lenguaje resuelve improvisando.
Las razones para no meter la política en el prompt son cuatro y ninguna es de principios. La misma entrada no garantiza la misma salida en un modelo de lenguaje y sí en una tabla. La política se cambia en una fila versionada, no en una frase cuyo efecto sobre el resto del prompt nadie conoce. La auditoría dice qué regla se disparó con qué entradas, no un texto. Y la aritmética con umbrales, dos actuaciones de sesenta euros sobre un límite de cien, es exactamente donde los modelos fallan en silencio. Camunda, que es el fabricante que más ha escrito sobre cómo combinar las dos cosas, lo resume con una fórmula que vale como regla de diseño: usar la lógica de reglas para validar las respuestas del agente o disparar las rutas de escalado, y usar al agente para simplificar las reglas preclasificando y resumiendo entradas desordenadas antes de aplicarlas. La notación del proceso dibuja el flujo, las tablas de decisión ponen las barandillas.
Queda la pregunta de quién llama a quién, y hay dos patrones que conviene combinar. En el primero la regla es una herramienta del agente: mientras investiga, el agente consulta la política de gasto para no proponer tonterías. En el segundo la regla es una barrera del proceso: el agente solo propone, y fuera de él una tarea de decisión evalúa la propuesta y bifurca, dentro de límites a ejecución automática y fuera de límites a aprobación humana. El segundo patrón es el que garantiza que la política se aplica siempre, con independencia de lo que el agente haya decidido consultar; el primero evita propuestas absurdas. Los motores para hacerlo son conocidos: Camunda lo integra con su proceso, Apache KIE y Drools son la base abierta sobre la que IBM construye su producto de decisiones, y hay fabricantes especializados como Trisotech o FICO. Conviene saber que en el ecosistema de Microsoft no hay un motor de decisiones de este tipo de serie: las reglas de negocio de Dataverse y el lenguaje de fórmulas de Power Platform sirven para validar formularios, no para gobernar una política de gasto con trazabilidad, así que en ese ecosistema la decisión se externaliza a un motor o se codifica, con la pérdida de trazabilidad que eso supone.
La división del trabajo que lo ordena todo
Con las cuatro piezas en su sitio se ve el reparto que da sentido a la etapa. El predictor estima; el simulador calcula escenarios; el optimizador compara; el motor de reglas dice qué está permitido; y el agente interpreta los resultados, investiga lo que no cuadra y prepara una recomendación. El modelo de lenguaje no tiene que inventar cuánto tarda un transporte ni cómo afecta una reserva al resto de pedidos, porque esos cálculos pertenecen a servicios especializados que se pueden validar, versionar y auditar, y una opinión no. Esto no es una preferencia estética. Es lo que dice la evidencia disponible sobre lo que los modelos hacen bien y mal.
La evidencia es abundante y coincide. En un banco de pruebas de planificación publicado en 2024 por el grupo de Kambhampati en Arizona State, un planificador clásico resolvía el 100 % de los problemas en un cuarto de segundo mientras el mejor modelo razonador del momento llegaba al 23,6 % en los problemas grandes y costaba cuarenta y dos dólares por cada cien instancias; los mismos autores proponen que el modelo de lenguaje actúe como fuente de conocimiento acoplada a verificadores y solucionadores externos, que es exactamente la arquitectura de esta etapa. Un estudio de Apple del mismo año mostró que añadir una cláusula irrelevante a un problema de aritmética escolar hunde el acierto de todos los modelos punteros hasta un 65 %, y un pedido real está lleno de cláusulas irrelevantes. Y un trabajo presentado en NeurIPS 2024 encontró que quitar el modelo de lenguaje de tres predictores de series temporales que lo usaban no empeoraba el resultado, y a menudo lo mejoraba. Los laboratorios no publican confesiones de este tipo, pero publican la respuesta: herramientas de ejecución de código para que el modelo calcule llamando a algo que calcula bien.
Hay una tentación intermedia que conviene conocer porque va a aparecer en cualquier proyecto: que el modelo de lenguaje formule el problema de optimización y un solucionador lo resuelva. Microsoft publicó el patrón en 2023 para su cadena de suministro y Gurobi, el fabricante del solucionador más usado, expone desde septiembre de 2026 su motor y un agente que traduce descripciones en lenguaje natural a modelos, a través de MCP. El patrón es correcto; su fiabilidad hoy no lo es: el sistema académico de referencia acierta en el 28,6 % de los casos reales, y un estudio de 2026 documenta que un modelo generado puede dar el número correcto y estar mal formulado. La conclusión práctica para la distribuidora es que los modelos de simulación y optimización están predefinidos, validados y versionados, y que el agente elige escenarios y parámetros dentro de un contrato, pero no formula el modelo.
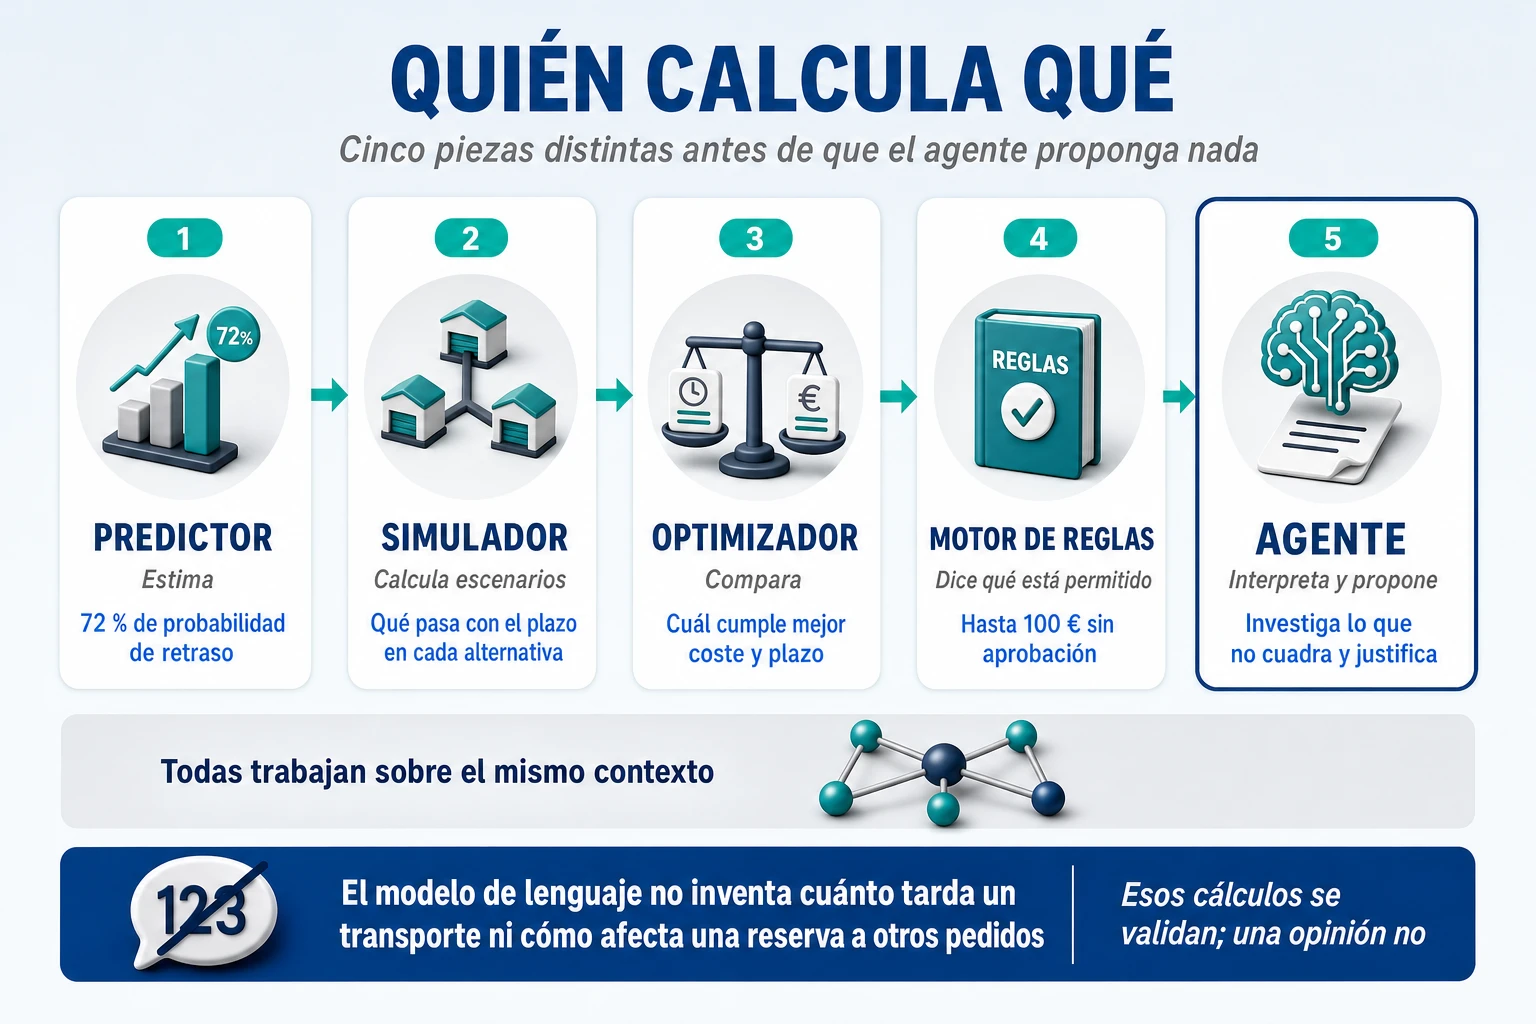
A esta capa que junta predicción, simulación, optimización y reglas el mercado la ha empezado a llamar inteligencia de decisión, y Gartner le dedicó en enero de 2026 su primer Magic Quadrant, con quince fabricantes que van desde motores de reglas de los años noventa hasta plataformas de planificación de cadena de suministro y bases de datos de grafos; el propio sector admite que una parte es cambio de etiqueta sobre lo que ya vendían. Como nombre de la disciplina es útil, porque describe bien el recorrido de modelar la decisión, predecir, simular, optimizar, ejecutar y realimentar; como categoría de producto es inmadura, y comprarla con ese nombre no exime de montar las piezas.
Y la advertencia de altura que ya se anunció: en la mayoría de los procesos de una empresa bastan reglas y cálculos sobre los datos existentes. Una tabla de decisión y una consulta bien hecha resuelven la gran mayoría de las excepciones administrativas sin simulador ni gemelo; estos compensan cuando hay muchas dependencias y recursos compartidos cuyo estado cambia deprisa, como en la distribuidora. Al terminar la etapa 3 el sistema sabe qué puede pasar con el pedido 1846, qué opciones existen, cuánto cuesta cada una, cuál cumple mejor y cuál está dentro de la política. Tiene alternativas cuantificadas, no una alerta. Y todavía no ha hecho falta un agente.
Etapa 4. Diseñar y programar el agente de resolución
Ahora sí hay un trabajo para un agente, porque el recorrido no está completamente definido. Investigar por qué el pedido 1846 está en riesgo, pedir alternativas a los servicios especializados, comprobar si la que mejor cumple está dentro de la política, detectar que el cliente admite entregas parciales y que la referencia que falta tiene una incidencia abierta con el proveedor, y preparar una propuesta justificada que una persona pueda leer en treinta segundos: eso exige interpretar, encadenar pasos variables y decidir qué consultar a continuación. Es el tipo de tarea para el que la regla de la mínima autonomía del artículo sobre soluciones de IA, de RAG a agentes autónomos acaba recomendando un agente, después de haber descartado el prompt, la recuperación y el workflow fijo.
La ficha de diseño
Antes de elegir framework ni modelo, el agente se diseña en una ficha de seis filas que cabe en media página y que es, en la práctica, el contrato del agente con el resto del sistema.
| Agente de resolución de pedidos | Pro-code |
| Objetivo | Resolver el riesgo de incumplimiento del pedido respetando los compromisos comerciales, los límites económicos y las políticas de la empresa |
| Entradas | Pedido, contexto reconstruido, riesgo estimado y restricciones aplicables |
| Herramientas | Consulta de pedidos, consulta de existencias y reservas, simulador de alternativas, consulta de políticas |
| Razonamiento | Investigar opciones, comparar resultados, detectar lo que no cuadra y justificar la propuesta |
| Salida | Plan estructurado con la alternativa elegida, las evidencias, el coste, la probabilidad del simulador y si requiere aprobación |
| Restricción | No ejecuta cambios transaccionales: propone, no reserva ni expide |
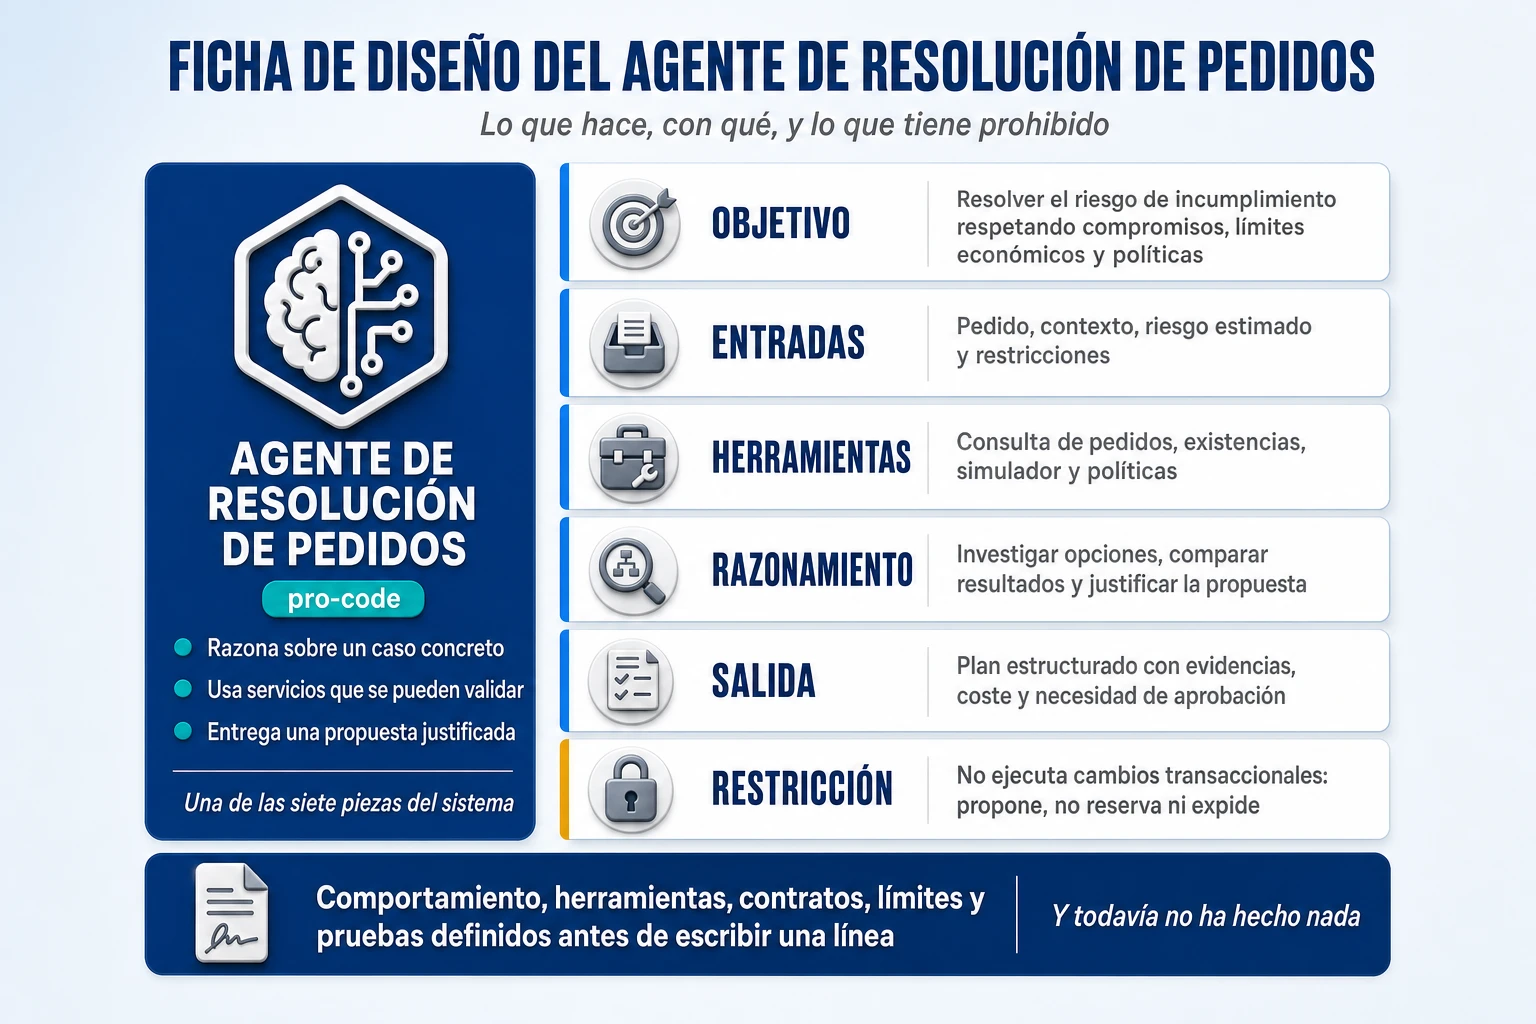
Cada fila tiene un porqué, y el de la última es el que más vale explicar. Que el agente no ejecute transacciones no es desconfianza en el modelo; es que reservar stock en dos almacenes, crear expediciones y actualizar un pedido son operaciones que tienen que sobrevivir a un fallo a mitad de camino, y eso lo garantiza un motor de proceso, no un bucle de llamadas. La restricción se implementa en tres capas que se refuerzan: el agente no recibe herramientas de escritura, las herramientas que podrían tener efectos se detienen a pedir permiso antes de ejecutarse, y una política externa al agente intercepta cada llamada antes de que llegue al sistema de destino. Las tres existen hoy en los frameworks y los runtimes, y las tres juntas son lo que convierte un «no debería hacerlo» en un «no puede hacerlo». La fila de la salida importa casi tanto: el plan es un documento estructurado que se valida contra un esquema, con la alternativa, el coste, la probabilidad que dio el simulador, los identificadores consultados y la política aplicada, y no un párrafo de texto que alguien tenga que interpretar.
Declarativo, low-code o pro-code: qué se elige para este agente y por qué
Los términos con los que el mercado describe cómo se construye un agente no son cuatro peldaños de una misma escalera, y conviene separarlos en dos ejes. El primero es qué se define: un agente declarativo se describe por configuración, con su propósito, sus instrucciones, su conocimiento y sus acciones, y el orquestador, el modelo y el alojamiento los pone el proveedor; es lo que Microsoft llama agentes declarativos en Microsoft 365 o lo que Google ofrece con su diseñador de agentes sin código en Gemini Enterprise, donde las acciones que afectan a otras personas se detienen por defecto a pedir aprobación. El segundo eje es cuánto código se escribe: sin código, poco código o código completo. Copilot Studio es el ejemplo de referencia del poco código: un estudio gráfico donde el agente se compone con instrucciones, conocimiento, herramientas y flujos, y donde, desde 2026, se elige entre tres harnesses que determinan cuánto razona, qué puede hacer de serie y cómo se factura. Dify y n8n ocupan el mismo lugar en el mundo abierto; Salesforce y ServiceNow lo ocupan dentro de sus propias plataformas, y Salesforce es el mejor ejemplo de que la frontera es un continuo, porque permite pasar del diseñador visual a un lenguaje intermedio y de ahí a código completo sin cambiar de agente.
El criterio para saber cuándo hay que pasar a código lo escribe, significativamente, el proveedor que más vende lo contrario. Microsoft documenta que un agente declarativo no es la opción cuando la solución exige control completo de la orquestación, del modelo, del alojamiento o de la interfaz, y recomienda un agente con motor propio cuando hay reglas de negocio precisas, varios sistemas que integrar o mensajería proactiva, con el ejemplo de un agente de aprobación de préstamos con sus reglas, sus requisitos de datos y sus varios sistemas de verificación. El agente de resolución de pedidos cumple tres de esos cuatro criterios, y por eso se construye con código: tiene una política de gasto precisa que no puede quedar al albur de un prompt, consulta cuatro sistemas distintos y tiene que arrancar solo cuando llega un evento, no cuando alguien le escribe. Si solo tuviera que consultar un pedido y explicar su estado, una configuración sencilla bastaría. La regla general es la misma de todo el artículo: la decisión no es qué framework está de moda, sino qué hay que programar o configurar.
Cómo se construye de verdad, sin código
Elegido el camino, hay que elegir un framework, y aquí la lista es más corta de lo que parece y cambia de nombre más deprisa de lo que conviene. Microsoft Agent Framework, en disponibilidad general desde abril de 2026, es el sucesor declarado de Semantic Kernel y AutoGen, que siguen existiendo con una capa de compatibilidad; LangGraph propone modelar el agente como un grafo de estados con puntos de control para reanudar; Google ADK, OpenAI Agents SDK, CrewAI y Pydantic AI proponen cada uno su manera de componer agentes, traspasar el control entre ellos y detenerse a pedir permiso. Lo que hay que mirar en cada uno no es la lista de funciones sino tres cosas: qué modelo de orquestación propone, cómo gestiona el estado entre pasos y cómo inserta a una persona cuando hace falta, porque esas tres decisiones son las que después cuesta cambiar. Y una frase de la documentación de Microsoft que debería estar en todas: si puedes escribir una función que haga la tarea, escribe la función en lugar de usar un agente.
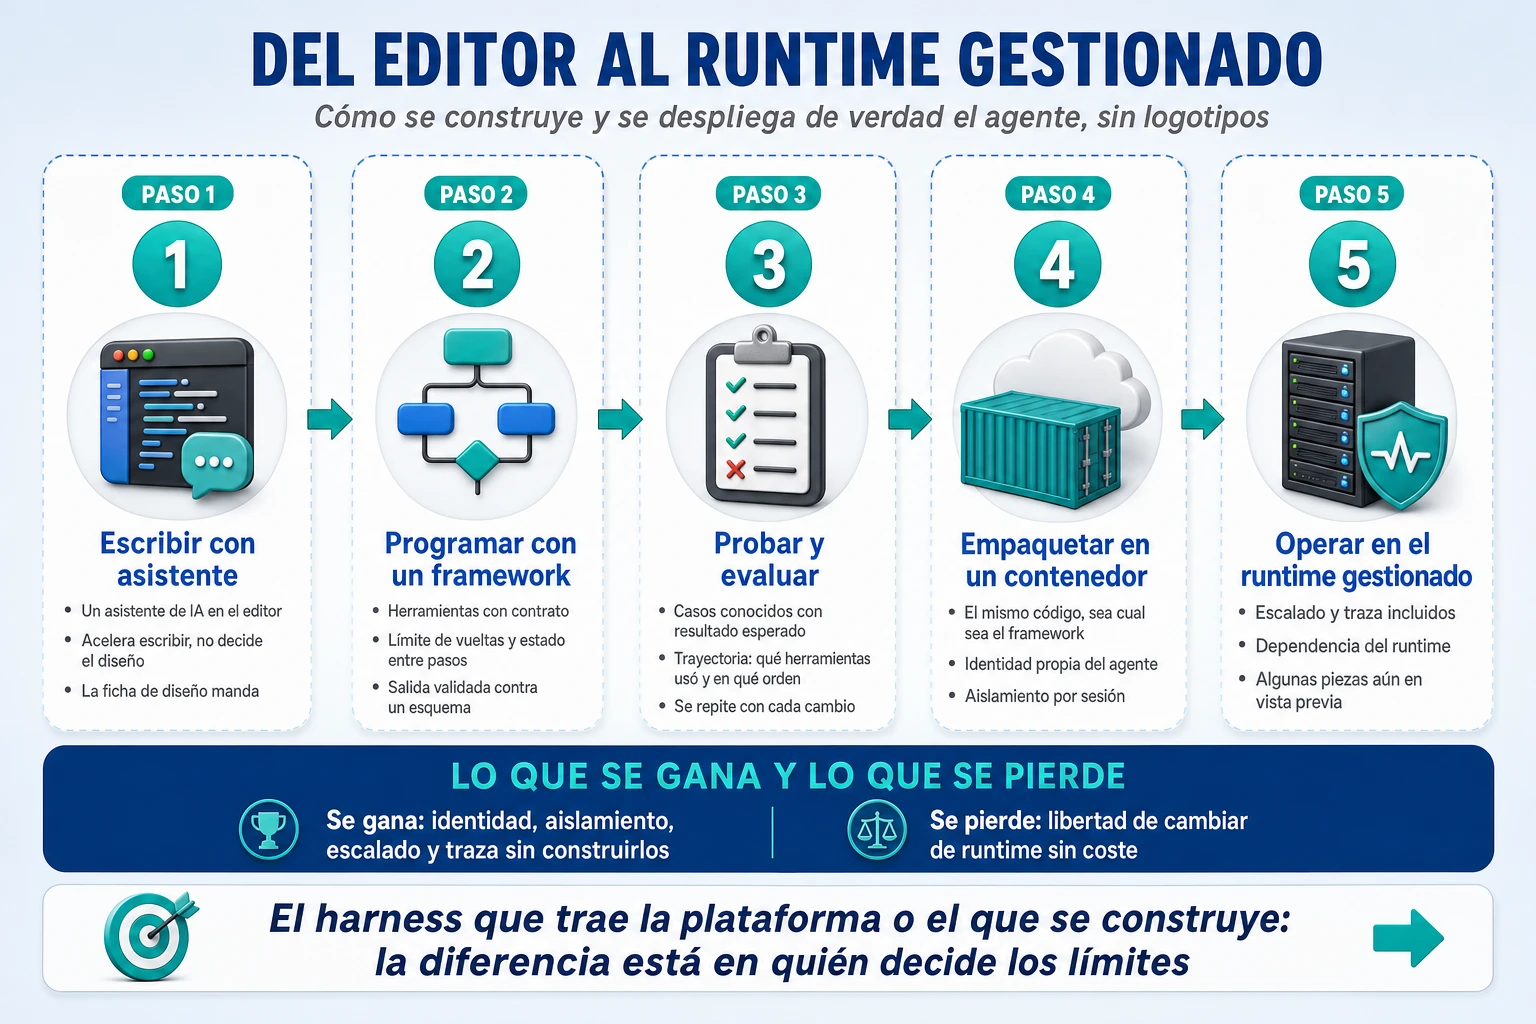
Con el framework elegido, construir el agente consiste en tomar seis decisiones que no son de código aunque se materialicen en él. Las herramientas se definen con contratos y se consolidan en alto nivel: una herramienta que evalúa las alternativas de entrega de un pedido y devuelve la tabla completa, en lugar de tres herramientas de bajo nivel que el agente tendría que encadenar; y lo que devuelven se expresa con significado, «almacén de Madrid, veinte unidades libres, doce comprometidas», en lugar de identificadores crudos, porque está documentado que eso mejora de forma apreciable la precisión del modelo. Se fija un límite de vueltas bajo, entre ocho y doce pasos, y superarlo es un fallo que escala a una persona, no un reintento. La salida se valida contra un esquema antes de aceptarse, el estado del turno vive en el framework y el estado del proceso de negocio vive fuera, en el motor de la etapa siguiente, y esa frontera es la que evita que el agente se convierta en el sistema. El harness que rodea al modelo, el bucle, el contexto, los permisos y la traza, puede ser el que trae la plataforma o uno construido a medida; la diferencia, que es sobre todo de quién decide los límites y cuánto cuesta cambiarlos, está explicada en el artículo sobre el agent harness.
Las pruebas se diseñan a la vez que el agente, no después, y aquí los tres grandes proveedores han convergido en un vocabulario que ya se puede tratar como estándar de hecho. Se construye un conjunto de treinta o cincuenta pedidos reales anonimizados con la secuencia de herramientas esperada, consultar el pedido, consultar existencias, lanzar el simulador, comprobar la política, y se evalúa la trayectoria del agente con tres grados de exigencia, coincidencia exacta, en orden o en cualquier orden, que es como lo llaman tanto Google como Microsoft como el kit de desarrollo de Google. Se valida la salida contra el esquema, se juzga la respuesta final con una rúbrica que comprueba que la alternativa elegida es la de mayor probabilidad entre las permitidas y que cita evidencias, y se prueban los fallos: una herramienta caída, un stock que cambió entre la consulta y la propuesta, una política ambigua, y en los tres casos la respuesta correcta es escalar, no inventar. Todo eso se repite con cada cambio de prompt, de herramienta o de modelo, dentro de la integración continua, y después en producción sobre una muestra de casos reales con el veredicto del aprobador humano como referencia. Conviene saber que la evaluación de agentes de Google sigue en vista previa y que varios evaluadores de Microsoft también; el vocabulario es estable, la herramienta no siempre.
Un párrafo sobre las herramientas de desarrollo asistido por IA, porque en 2026 nadie escribe un agente sin ellas y conviene ponerlas en su sitio. GitHub Copilot en su modo agente y como agente de programación, Claude Code, Cursor o Antigravity de Google aceleran escribir el agente, las herramientas, las pruebas y la documentación, y lo hacen mucho. Lo que no hacen es decidir el diseño: la ficha, los límites, la frontera entre el estado del agente y el del proceso y las pruebas que lo demuestran son decisiones que alguien toma antes de abrir el editor, y un asistente que las toma por su cuenta produce un agente que funciona en la demostración y nadie sabe por qué.
Dónde se ejecuta: el runtime gestionado
Un agente escrito con código hay que alojarlo en algún sitio, y la novedad de 2025 y 2026 es que los tres grandes proveedores de nube ofrecen un lugar pensado para eso. Microsoft Foundry admite desde julio de 2026, tras una vista previa iniciada en abril, los llamados agentes alojados: el código del agente empaquetado en un contenedor, en Python o C#, con cualquier framework, que se ejecuta en un entorno aislado por sesión, recibe una identidad propia en el directorio corporativo y dispone de un almacén de estado para los puntos de control del framework. No hay una lista de frameworks compatibles, y conviene decirlo así: es cualquier framework, incluidos Agent Framework, LangGraph o el SDK de agentes de Anthropic, siempre que el contenedor hable el protocolo que la plataforma espera. Amazon Bedrock AgentCore lleva en disponibilidad general desde octubre de 2025, ejecuta cada sesión en una micromáquina virtual de hasta ocho horas, admite igualmente cualquier framework y los tres protocolos de los que hablaremos en la etapa 6, y en 2026 ha añadido en disponibilidad general política, evaluaciones, registro y un harness gestionado. Y Google renombró en abril de 2026 su motor de agentes como Agent Runtime dentro de la plataforma de agentes de Gemini Enterprise, con soporte para su propio kit, para LangGraph, LlamaIndex y agentes propios.
Lo que se gana con un runtime gestionado es todo lo que en Kubernetes propio hay que construir: identidad por agente, aislamiento por sesión, estado persistido, telemetría preinstalada, escalado a cero y los protocolos de entrada ya expuestos. Lo que se pierde es control del despliegue, portabilidad del contrato entre la plataforma y el agente, y en algunos casos soberanía del estado; el harness gestionado de Anthropic, que sigue en beta, no es elegible para retención cero de datos precisamente porque guarda estado. Para una distribuidora con tres almacenes, el runtime gestionado le quita trabajo de plataforma que no le da ninguna ventaja diferencial, con una condición: que el proceso de negocio viva fuera del runtime del agente, en el motor de proceso de la etapa 5, de modo que cambiar de runtime no obligue a reescribir el proceso. Es la misma razón por la que el agente no ejecuta transacciones.
Lo que hace el agente con el pedido 1846
Con todo lo anterior construido, el agente recibe el evento y trabaja así. Lee el contexto del pedido y ve que la referencia que falta tiene una incidencia abierta con el proveedor, lo que hace poco probable la reposición prevista. Pide la predicción, que confirma el 72 %. Lanza las tres simulaciones y recibe la tabla. Comprueba la política y descubre que un sobrecoste de hasta cien euros puede autorizarse automáticamente para un cliente de clase A con el margen que tiene este pedido. Propone dividir el envío, con un coste de 85 euros y un 95 % de probabilidad de cumplir, porque es la alternativa con mayor probabilidad entre las que la política permite sin aprobación; descarta el traslado urgente no por caro, sino porque cumple peor y además exigiría que alguien lo aprobara. Y entrega la propuesta con los datos de origen, la comparación de escenarios, las restricciones comprobadas, el nivel de confianza de las estimaciones y un campo que dice que no requiere aprobación.
Al terminar la etapa 4 la distribuidora tiene un componente de software agéntico con comportamiento, herramientas, contratos, límites y pruebas definidos, alojado en un sitio con identidad y traza. Y que todavía no ha hecho nada, porque proponer no es ejecutar. Convertir esa propuesta en una reserva, una expedición y un pedido actualizado, y hacerlo de forma que sobreviva a que algo falle a mitad de camino, es la etapa siguiente.
Etapa 5. Ejecutar de punta a punta: convertir la recomendación en hechos
Hasta aquí el sistema ha identificado el problema y ha propuesto una respuesta, pero no ha hecho nada. Para que el pedido 1846 llegue a tiempo hay que comprobar que el stock sigue disponible, reservar unidades en dos almacenes, crear dos expediciones, actualizar el compromiso de entrega en el ERP y en el CRM, avisar al cliente de que recibirá dos bultos y comprobar al final que todo quedó registrado y que el pedido se entregó. Son seis actuaciones sobre cuatro sistemas, pueden durar horas o días si en medio hace falta una aprobación, y cualquiera de ellas puede fallar. Esta etapa construye el proceso que las coordina, y es la que separa un sistema que recomienda de un sistema que resuelve.
El expediente, paso a paso
El proceso nuevo empieza con un evento, no con una reclamación. Cuando la predicción supera el umbral que fija la política, el sistema emite un evento de pedido en riesgo, y ese evento abre un expediente que lleva desde el primer momento el identificador del pedido como hilo conductor de todo lo que viene. El expediente invoca al agente de resolución, que investiga y devuelve su propuesta estructurada: dividir el envío, 85 euros, 95 %, sin necesidad de aprobación. La propuesta pasa por la tarea de decisión, que consulta la tabla de la política y bifurca el proceso: dentro de límites, ejecución automática; por encima, se crea una tarea de aprobación para una persona y el expediente se queda esperando. Autorizada la actuación, el proceso lanza las operaciones en orden: reserva de stock en los dos almacenes, creación de las expediciones, actualización del pedido, aviso al cliente. Y cierra con la verificación: comprobar que las expediciones salieron, que la entrega se produjo en plazo, registrar las evidencias de cada paso y anotar el resultado para la etapa 8.
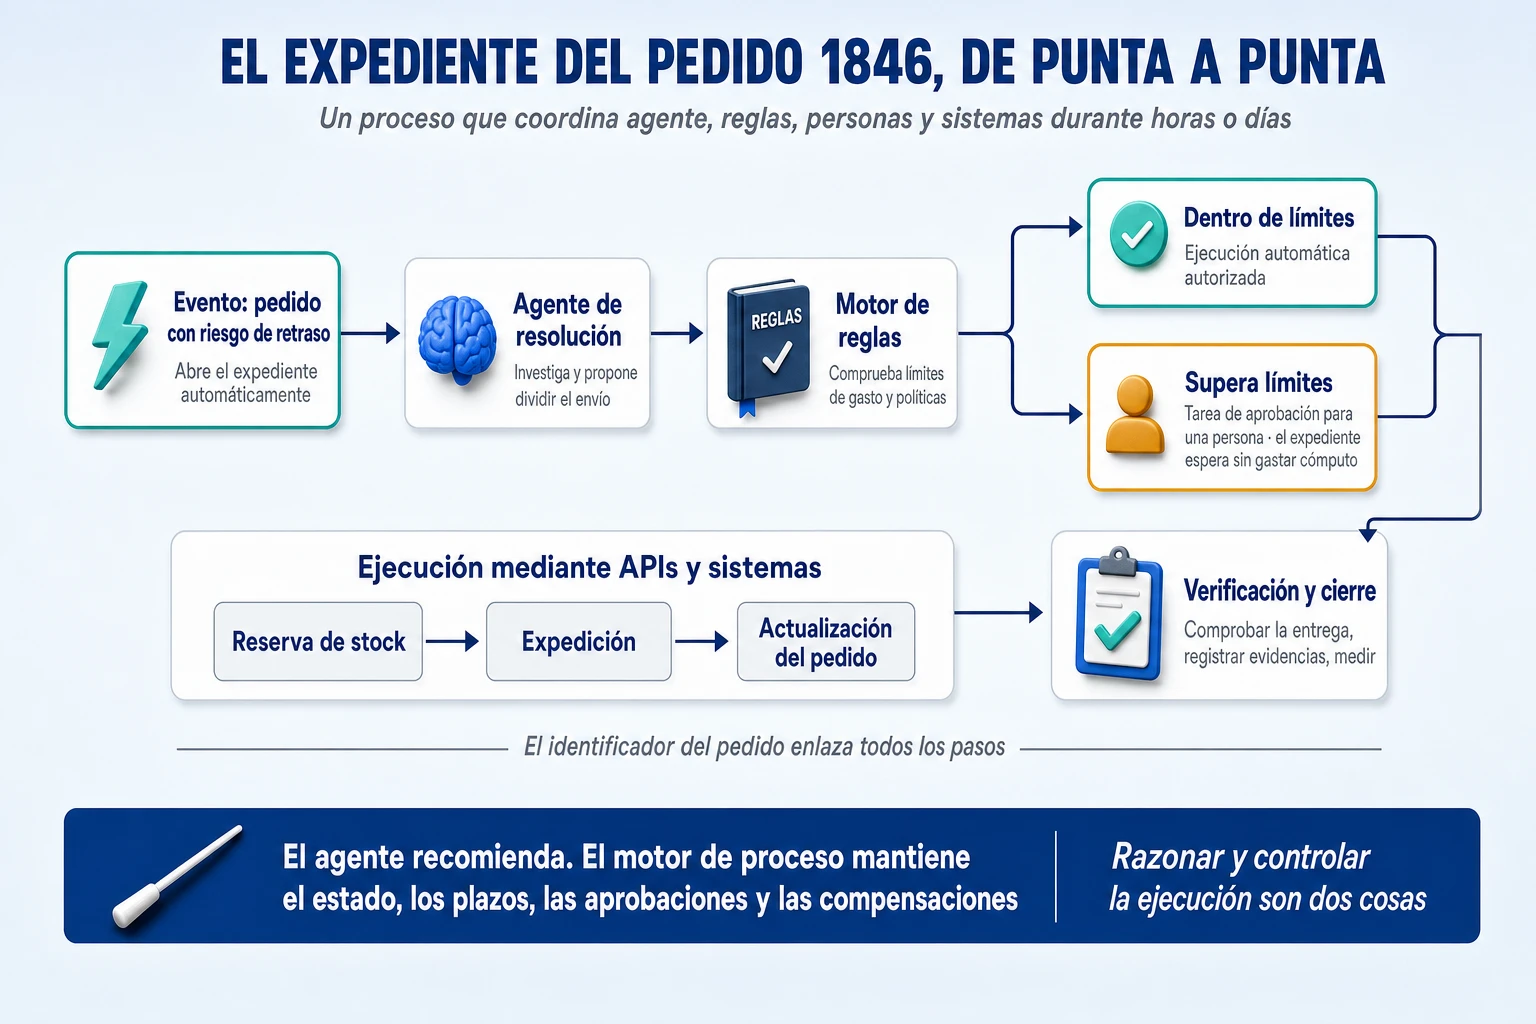
Conviene fijarse en qué objeto se crea en cada salto y qué evento provoca el siguiente, porque ahí es donde los diagramas bonitos se rompen en producción. El evento de riesgo crea un expediente con el identificador del pedido. El expediente crea una invocación al agente, que devuelve un plan como documento estructurado. El plan crea una evaluación de la política, que devuelve una decisión con la regla que se disparó. La decisión crea, según el caso, una orden de ejecución o una tarea de aprobación con responsable, plazo y lo que ocurre si el plazo vence. Cada operación de ejecución crea una orden hacia un sistema con una clave que la identifica de forma única, de modo que si la orden llega dos veces la segunda no reserva el doble; y cada respuesta de un sistema es el evento que dispara el paso siguiente. Nada de esto lo hace el agente: lo hace el motor que coordina el proceso.
Razonar sobre un proceso y controlar su ejecución son dos cosas distintas
Un motor de proceso hace lo que un agente no debe hacer: mantiene el estado del expediente durante horas o días, controla plazos, gestiona aprobaciones, reintenta lo que falla por motivos técnicos, reacciona a eventos, registra cada paso y, cuando algo se tuerce, deshace lo que haya que deshacer. Hay dos familias de productos para esto y conviene entenderlas por lo que aportan al control, no por el tamaño de su catálogo. La primera son los motores de procesos de negocio basados en BPMN, en los que el proceso es un diagrama que negocio puede leer y la máquina puede ejecutar. Camunda es el ejemplo más documentado de cómo meter un agente dentro: desde su versión 8.8, de octubre de 2025, un agente de IA es un elemento más del diagrama, un subproceso cuyas actividades internas son las herramientas que el modelo puede elegir, mientras a su alrededor siguen las tablas de decisión, las tareas de aprobación de personas y los eventos de compensación de siempre; el número máximo de veces que el agente puede llamar al modelo lo fija el proceso, con diez por defecto, no el prompt. UiPath lanzó en 2025 un orquestador con la misma idea, agentes, robots y personas como nodos del mismo modelo BPMN.
La segunda familia es la ejecución duradera en código. Temporal es su referencia: el proceso se escribe como código ordinario, cada llamada al modelo y cada llamada a una herramienta es una actividad con sus reintentos y sus plazos, el motor guarda el historial completo de lo que ha pasado y, si el servidor que ejecutaba el proceso se cae, otro lo retoma exactamente donde estaba, aunque hayan pasado semanas esperando una aprobación. Microsoft ofrece lo mismo con sus funciones duraderas y un planificador de tareas duraderas en disponibilidad general desde finales de 2025, y hay media docena de proyectos más jóvenes en la misma línea. Las dos familias garantizan lo mismo, que un proceso de varios pasos y varios sistemas llegue al final aunque fallen máquinas, APIs o personas; difieren en dónde vive la definición del proceso y quién puede leerla. Los dos fabricantes de referencia defienden su opción con el mismo argumento visto desde lados opuestos: Camunda sostiene que no se puede operar lo que no se puede ver, y el cofundador de Temporal que la complejidad de un proceso no está en la secuencia de pasos sino en los datos y las condiciones, que el diagrama esconde.
| Lo que hay que mirar | Motor de procesos BPMN | Ejecución duradera en código |
| Dónde vive el proceso | En un diagrama que negocio lee y la máquina ejecuta | En código ordinario |
| Quién puede cambiarlo | Analista de procesos y desarrollador comparten el artefacto | Solo desarrolladores |
| La espera de una persona | Tarea de usuario nativa, con responsable, plazo y escalado | Señal externa más temporizador; la bandeja la construye uno |
| Las reglas de negocio | Tablas de decisión integradas | Lo que se programe o se llame |
| Deshacer lo hecho | Eventos de compensación declarados en el diagrama | Lista de compensaciones escrita en el código |
| El agente | Un elemento del diagrama con sus herramientas dentro | Un proceso cuyas llamadas al modelo son actividades |
| Cuándo conviene | Muchas tareas humanas, reglas que cambian, auditoría, propietarios de proceso que no programan | Flujo mayoritariamente entre máquinas, mantenido por ingenieros, con la fiabilidad a escala como problema principal |
El criterio para elegir es, entonces, quién tiene que leer y cambiar el flujo. Si negocio, auditoría y el responsable del proceso tienen que entenderlo y modificarlo, el diagrama gana; si el flujo es sobre todo entre máquinas y lo mantiene un equipo de ingeniería, el código gana. Para el pedido 1846, con una aprobación que la toma una persona de negocio, una política que negocio cambia y una auditoría que querrá ver qué pasó, la recomendación es un motor BPMN con el agente dentro, y es un razonamiento, no una medición. Nada impide un híbrido: el agente puede ser un proceso duradero por dentro y una tarea del diagrama por fuera. Las plataformas de automatización sin código tienen su sitio en esta etapa, pero no en el centro. Power Automate conecta con cientos de sistemas y gestiona aprobaciones, pero una ejecución no puede durar más de treinta días contando el tiempo de espera de la aprobación, no hay compensación declarativa y la idempotencia es responsabilidad de quien diseña el flujo; sirve como actividad del proceso, no como el proceso. Camunda 7, que es lo que tienen instalado muchas entidades financieras y administraciones, no tiene nada de lo agéntico y su última versión salió en octubre de 2025.
Cuando el plan choca con la realidad
El agente propuso dividir el envío: seis unidades desde Madrid y cuatro desde Valencia. El proceso reserva en Madrid y lo consigue. Reserva en Valencia y el sistema de almacén responde que quedan dos unidades, porque otro pedido consumió las demás hace veinte minutos. Quien detecta el conflicto es el motor de proceso, porque la tarea de reserva devuelve un error de negocio, no un error técnico, y los errores de negocio no se reintentan: se deciden. Ni el agente ni ninguna persona se han enterado todavía, y eso es lo correcto, porque el motor es el único que sabe en qué punto exacto está el expediente.
Lo que hace el motor a continuación está escrito en la literatura de patrones distribuidos desde mucho antes de que existieran los agentes, y conviene copiarlo en vez de inventarlo. Entre un ERP y un sistema de almacén no hay transacciones distribuidas que lo bloqueen todo hasta que todo esté confirmado; lo que hay es una secuencia de transacciones locales, cada una atómica en su sistema, con una compensación preparada para deshacer cada una si hace falta, y eso tiene nombre, saga, y dos reglas que la guía de arquitectura de Microsoft formula con claridad. La primera es que la compensación es el último recurso: antes de deshacer la reserva de Madrid, que es el activo más valioso que tiene el expediente, se intenta una vía alternativa. La segunda es que un paso fallido no exige deshacer todo, y que cuando la decisión es de alto impacto o difícil de automatizar con fiabilidad, la toma una persona, no el sistema. Por eso la reserva de Madrid se hizo con caducidad, lo que la literatura llama un bloqueo a corto plazo con tiempo límite: si el expediente no avanza, se libera sola; si avanza por otra vía, se confirma.
Con la reserva de Madrid viva y la de Valencia fallida, el motor pide una decisión nueva al agente, y lo hace con el estado real, no con el de hace veinte minutos: Madrid reservada, Valencia con dos unidades, el plan anterior invalidado y la misma política de hasta cien euros. El agente no se da cuenta de nada por sí mismo; se le vuelve a llamar con un contexto distinto, y propone, por ejemplo, servir las seis de Madrid y las cuatro restantes con un traslado urgente desde el tercer almacén. Si el plan nuevo supera el límite o no hay alternativa, el proceso crea la tarea de aprobación. Si el agente choca otra vez con la realidad, el contador de intentos del proceso escala a una persona en lugar de dejarle probar indefinidamente. Y solo cuando el plan nuevo no necesita la reserva de Madrid, el motor lanza la compensación y la libera; si la necesita, la confirma y sigue. Después viene el punto de no retorno, confirmar las expediciones al transportista y avisar al cliente, y a partir de ahí solo quedan pasos que se pueden repetir sin daño: actualizar el ERP, registrar evidencias. Camunda lo resumió en octubre de 2025 tras medio centenar de prototipos con clientes en una frase que vale como regla: que los agentes no alteren los datos de origen directamente, que solo recomienden.
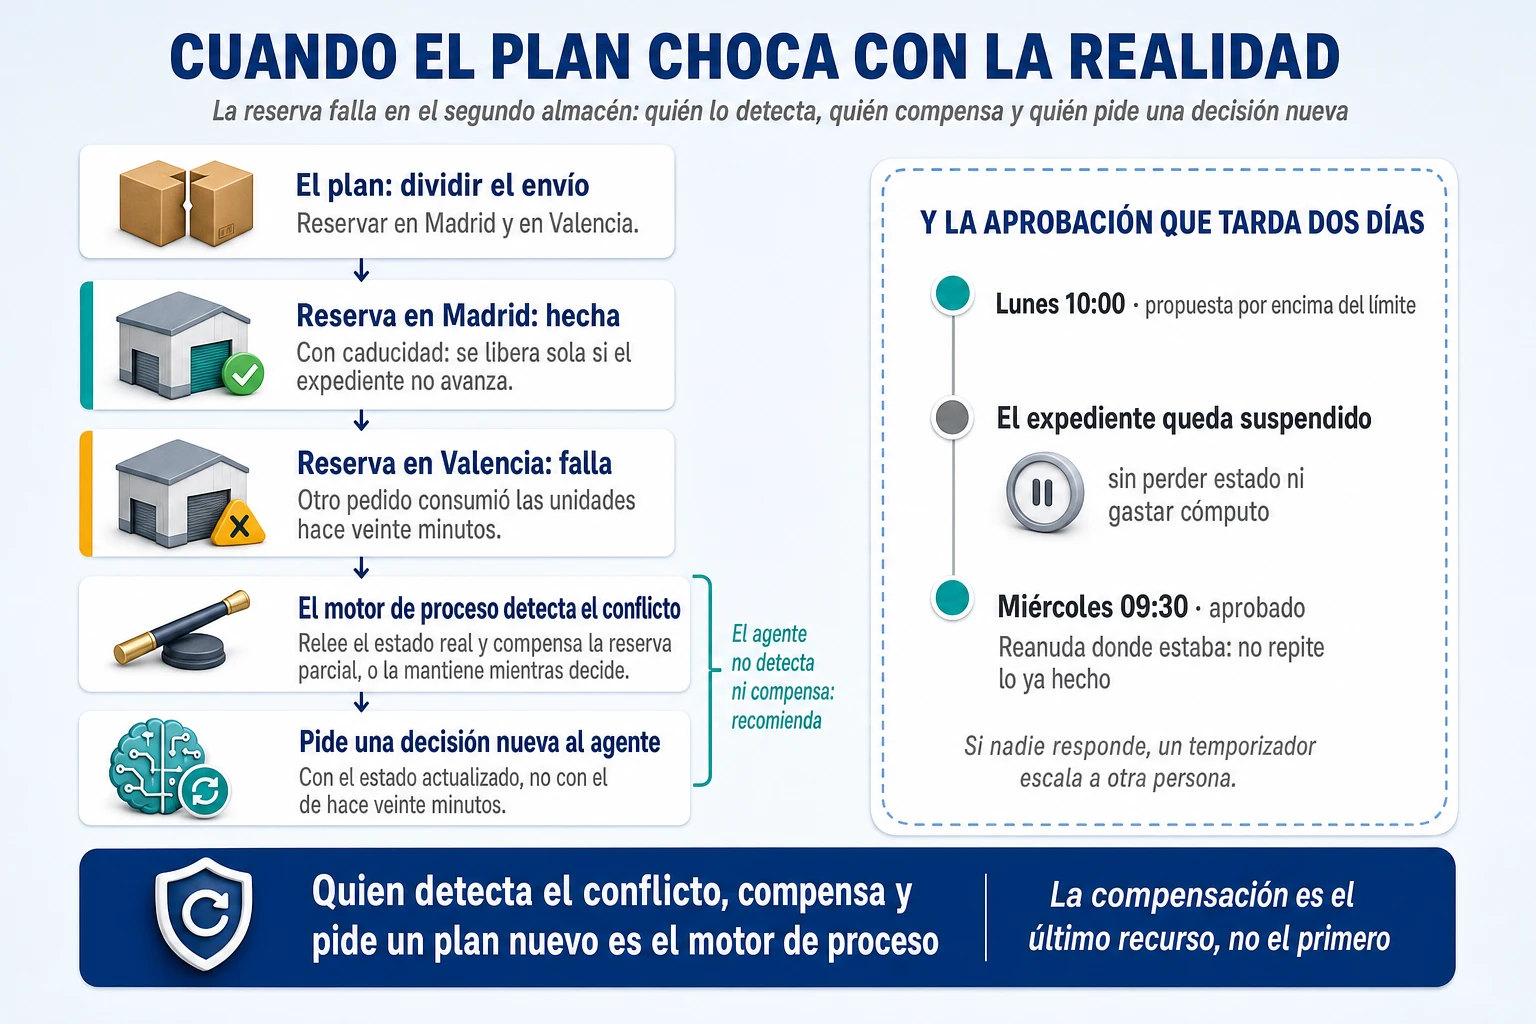
Dos detalles técnicos que no se ven en el diagrama y deciden si esto funciona. El primero es la idempotencia: en un sistema distribuido es impracticable garantizar que una orden llegue exactamente una vez, así que la solución es que el receptor sepa tratar el duplicado; cada orden hacia el almacén o el ERP lleva una clave estable, pedido, paso e intento, y si el almacén la recibe dos veces devuelve el mismo resultado sin reservar el doble. El segundo es la aprobación que tarda dos días. En un motor de proceso, la tarea de aprobación detiene el expediente sin consumir cómputo, con un responsable, un plazo y un temporizador que escala a otra persona si nadie responde; cuando llega la respuesta, el proceso reanuda exactamente donde estaba y no repite nada de lo ya hecho. La única sutileza es que la caducidad de la reserva tiene que ser compatible con el plazo de la aprobación, o renovarse, o aceptar que al volver el plan puede haber dejado de valer. Son decisiones de diseño del proceso, y se toman en esta etapa.
Las personas dentro del proceso
Dónde poner a las personas es una decisión de diseño con evidencia detrás, y la evidencia dice algo incómodo. El regulador financiero británico revisó en 2021 más de un millón de cambios tecnológicos en veintitrés entidades y encontró que los comités de aprobación habían autorizado más del 90 % de los cambios importantes que revisaron, que algunas entidades no rechazaron ni uno en todo el año, y que esos comités funcionaban más como control de tráfico que como aseguramiento. Una revisión de setenta y cuatro estudios clínicos publicada en 2012 midió el sesgo de automatización, la tendencia a aceptar la salida de un sistema en lugar de comprobarla, y encontró un riesgo relativo de 1,26 de seguir un consejo erróneo cuando lo da una máquina. Y un metaanálisis de más de cien experimentos publicado en 2024 en Nature Human Behaviour concluyó que, en tareas de decisión, la combinación de persona y sistema rinde de media peor que el mejor de los dos por separado. Ante una recomendación automática para aprobar en serie, la persona aprueba; la implicación no es quitar a la persona, es poner la puerta solo donde la decisión cambia el coste, el compromiso o el riesgo, y darle a quien aprueba el estado real y la alternativa.
En el pedido 1846 eso significa tres puertas y ninguna más: cuando el sobrecoste supera el límite de la política, cuando el agente detecta una contradicción que no sabe resolver y cuando el cliente está marcado como sensible. En las tres, la persona recibe el expediente con el contexto, las alternativas simuladas y la propuesta, y su decisión queda registrada como un paso más del proceso. Hay dos casos públicos de este patrón, los dos contados por el fabricante del motor pero coherentes con todo lo anterior: un banco turco que usa un modelo para extraer datos de documentos, una persona para revisarlos y el proceso para ejecutar, con un tiempo por operación que según Camunda pasó de 54 a 9 segundos; y una aseguradora estadounidense que ejecuta agentes dentro de procesos duraderos de horas o días con Temporal, donde el tramitador revisa solo las discrepancias. Y una línea sobre la automatización de pantallas: cuando un sistema no tiene API, los agentes que manejan la interfaz como una persona existen y están en disponibilidad general en varias plataformas, pero su acierto en el banco de pruebas de referencia pasó del 12 % en 2024 al 61 % a mediados de 2025 y las cifras superiores de 2026 las declaran los propios fabricantes; sirven para leer una pantalla sin API, no para reservar stock. La reserva va por API o no va.
Al terminar la etapa 5 la distribuidora tiene un proceso de punta a punta que combina decisiones dinámicas con ejecución controlada, que sobrevive a una reserva fallida, a una aprobación de dos días y a una caída del servidor, y que deja un registro de cada paso con quién lo decidió. Es un proceso que puede usar inteligencia artificial sin renunciar a las garantías que exige una operación transaccional, y esa frase es la que hay que poder decirle a un auditor.
Etapa 6. Elegir cómo construir y desplegar: cinco decisiones y tres composiciones
Llegados aquí, las tecnologías dejan de ser una lista y aparecen como respuesta a necesidades concretas, y la decisión de con qué construir se puede ordenar en cinco preguntas que conviene separar porque suelen venir mezcladas. Dónde interactúa el usuario con el sistema. Quién controla el proceso. Cómo se desarrolla la inteligencia agéntica. Dónde se ejecuta. Y cómo accede todo ello a las capacidades de la empresa, al ERP, al almacén, a los datos. Una misma empresa puede responder a cada pregunta con un proveedor distinto, y la mayoría lo hace aunque no lo sepa.
Tres maneras de construir el mismo sistema
Hay tres composiciones típicas para el sistema del pedido 1846, y la tabla las pone una al lado de otra para que se vea qué cambia y qué no. La primera aprovecha el ecosistema de Microsoft que la mayoría de las empresas ya paga. La segunda es un stack modular construido con piezas de código abierto o especializadas, elegidas una a una. La tercera construye sobre la plataforma empresarial que ya gobierna el proceso, sea el ERP, el CRM o la herramienta de gestión de servicios. Son tres composiciones, no tres productos, y una empresa puede mezclarlas; de hecho, la recomendación para la distribuidora va a ser una mezcla. Los nombres de la tabla son ejemplos vigentes a fecha de este artículo, y se dan porque sin nombres la tabla no sirve, no porque sean los únicos.
| Componente | Con el ecosistema de Microsoft | Con un stack modular pro-code | Sobre la plataforma empresarial que ya se tiene |
| Experiencia | Teams y Microsoft 365 Copilot | Aplicación web propia | El portal del CRM, el ERP o el ITSM |
| Desarrollo de agentes | Copilot Studio para lo sencillo, Microsoft Agent Framework para lo programado | LangGraph, Google ADK, OpenAI Agents SDK, CrewAI o Pydantic AI | El diseñador del fabricante (Agentforce, Joule Studio, AI Agent Studio) |
| Ejecución de agentes | Agentes alojados en Microsoft Foundry | Kubernetes propio, o un runtime gestionado como Amazon Bedrock AgentCore o Agent Runtime de Gemini Enterprise | El runtime de la plataforma |
| Control del proceso | Power Automate, el planificador de tareas duraderas de Azure o un motor BPMN externo; no hay motor de decisiones DMN de serie | Camunda con el agente dentro y las reglas en DMN, o Temporal en código | El workflow de la plataforma |
| Predicción | Azure Machine Learning y Fabric | Servicios de aprendizaje automático propios o gestionados | Los modelos integrados del fabricante |
| Simulación y gemelo | Azure Digital Twins o el constructor de gemelos de Fabric, aún en vista previa, más un simulador especializado | Un simulador y un optimizador como servicio: anyLogistix, Gurobi, OR-Tools | Un servicio especializado integrado |
| Herramientas y datos | APIs, MCP en Foundry y el agente de datos de Fabric, de solo lectura | APIs, MCP y eventos | Los conectores de la plataforma |
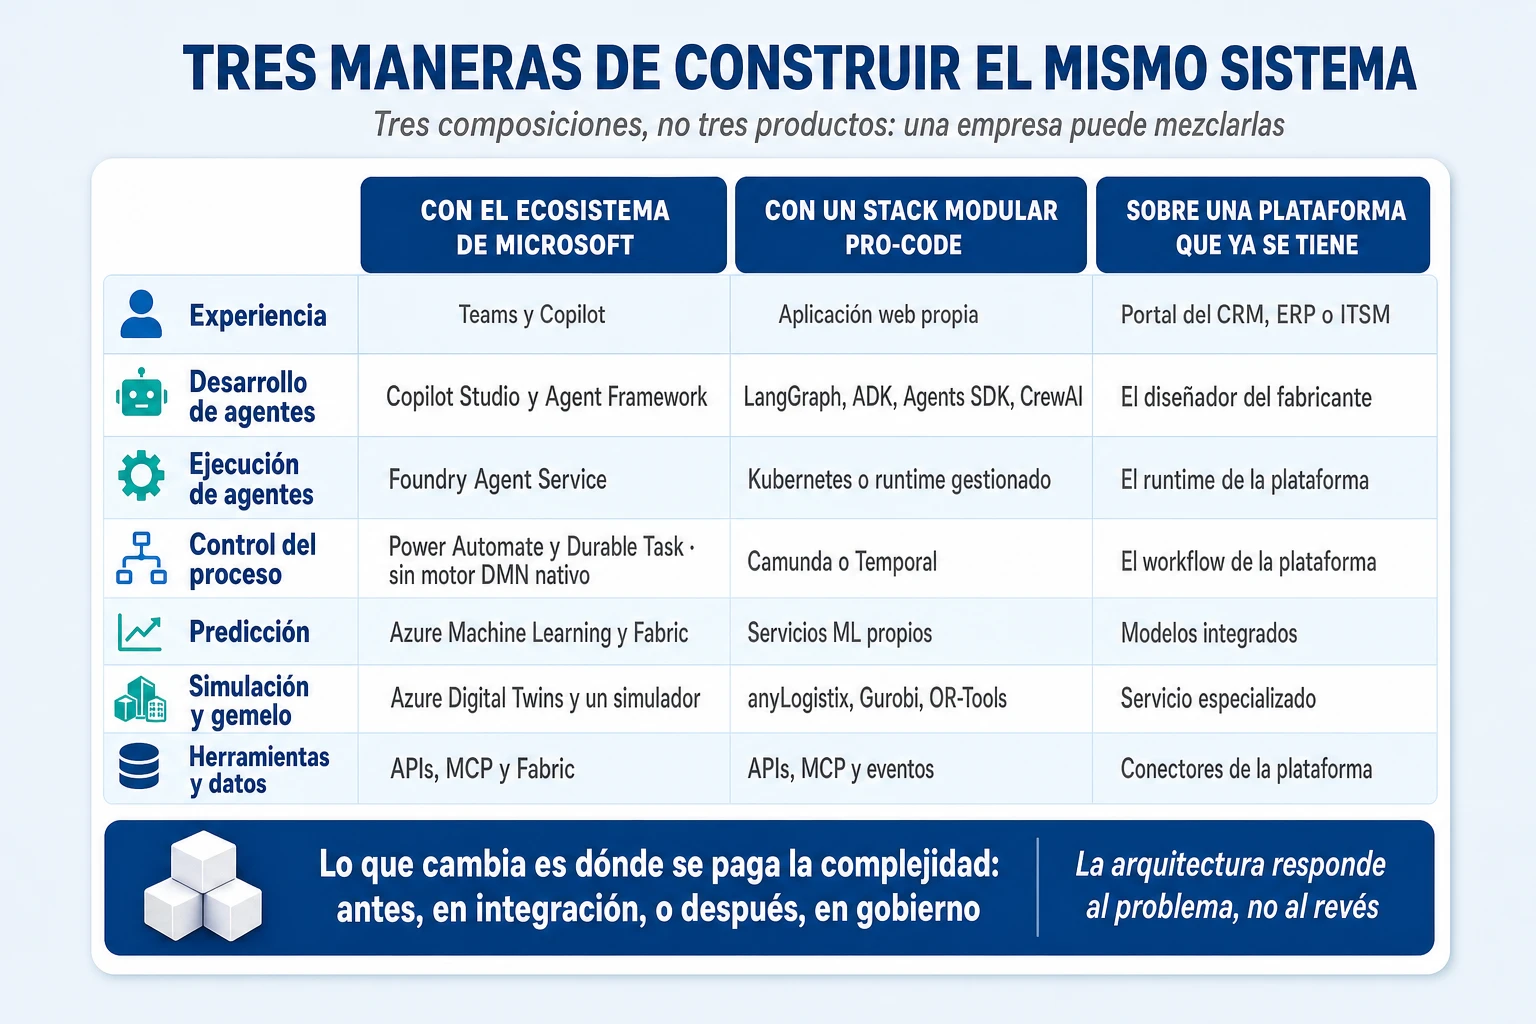
Lo que la tabla enseña es dónde se paga la complejidad en cada caso. En el ecosistema de Microsoft se paga poco al principio, porque la identidad, los datos y la experiencia ya están, y se paga después en dos huecos concretos: no hay un motor de decisiones de negocio de serie, así que la política de gasto se externaliza a un motor o se codifica, y los flujos sin código tienen el techo de treinta días. En el stack modular se paga al principio, en integración y en el equipo que hace falta para mantenerlo, y se cobra después en independencia y en control de cada pieza. Sobre la plataforma existente se paga en dependencia del fabricante, y se cobra en que el proceso, los datos y los agentes viven donde ya vive el trabajo. Ninguna es mejor en abstracto; lo que las separa es cuánta ingeniería propia puede asumir la empresa y cuánta independencia quiere comprar con ella.
Qué familia resuelve cada necesidad
El panorama de frameworks y plataformas se vuelve manejable cuando se ordena por la necesidad que resuelve cada familia y no por el nombre. Hay ocho necesidades, y la tabla da para cada una la familia y dos o tres ejemplos vigentes.
| Necesidad | Familia tecnológica | Ejemplos |
| Configurar un agente sin programar mucho | Plataformas low-code y declarativas | Copilot Studio, Dify, el diseñador de agentes de Gemini Enterprise |
| Programar agentes con lógica propia | Frameworks y SDK pro-code | LangGraph, Microsoft Agent Framework, Google ADK, OpenAI Agents SDK, Pydantic AI |
| Crear agentes que trabajan con conocimiento documental | Frameworks de recuperación y datos | LlamaIndex, LangChain |
| Componer equipos de agentes | Frameworks multiagente | CrewAI, Microsoft Agent Framework, LangGraph |
| Reutilizar un harness completo en vez de construirlo | SDK de ejecución agéntica | Claude Agent SDK |
| Alojar y operar agentes | Runtimes gestionados | Microsoft Foundry, Amazon Bedrock AgentCore, Agent Runtime de Gemini Enterprise |
| Coordinar el proceso de negocio | Motores de proceso y de ejecución duradera | Camunda, Temporal, UiPath |
| Desarrollar asistido por IA | Asistentes de programación | GitHub Copilot, Claude Code, Cursor, Antigravity |
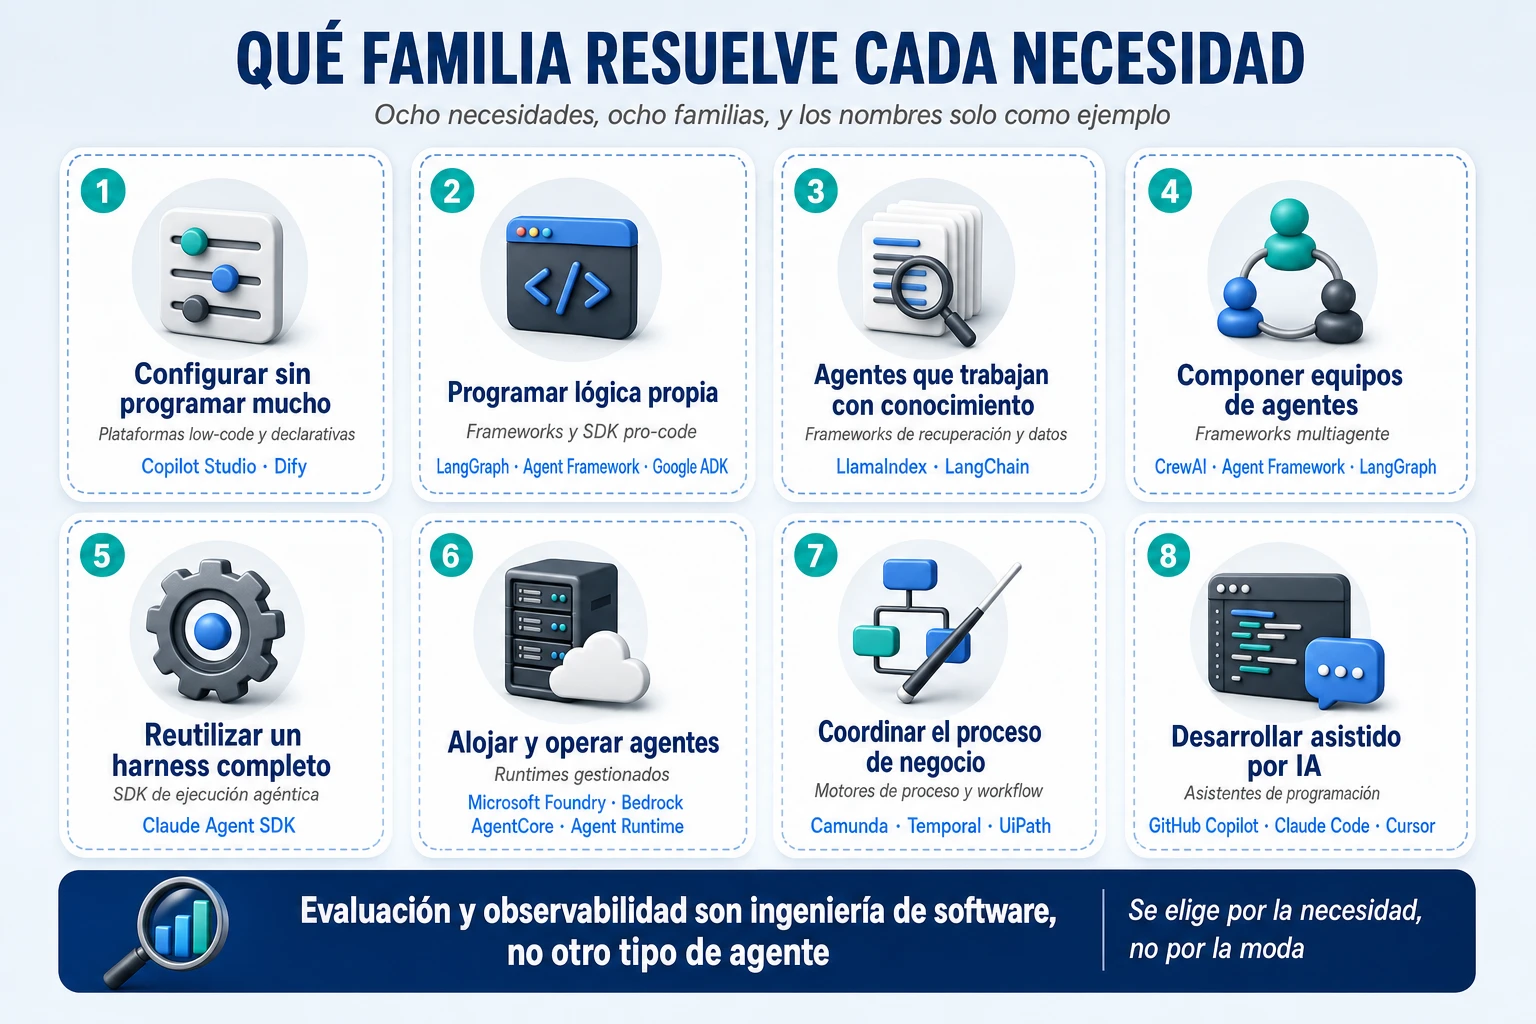
Tres advertencias sobre esa tabla, porque la lista cambia más deprisa que el artículo. La primera es que la evaluación y la observabilidad no son otro tipo de agente sino ingeniería de software: herramientas como LangSmith, Langfuse, que es de código abierto salvo su módulo empresarial y pertenece a ClickHouse desde enero de 2026, o Phoenix, cuya licencia no es abierta en sentido estricto, sirven para trazar, evaluar y versionar lo que hacen los agentes, y se eligen sobre todo por dónde van a vivir las trazas, que contienen prompts y datos de negocio; las convenciones de telemetría para IA generativa de OpenTelemetry, que son la capa común sobre la que todas trabajan, siguen a fecha de este artículo en estado de desarrollo y no estables. La segunda es que las herramientas sin código de OpenAI para construir y evaluar agentes se retiran el 30 de noviembre de 2026, así que lo que OpenAI mantiene es su SDK y su API, no un diseñador visual. Y la tercera es que las estrellas de GitHub miden atención de desarrolladores, no adopción empresarial, por mucho que se citen en las presentaciones.
Tres protocolos, un dibujo
Para que las piezas de la tabla hablen entre sí hay tres protocolos, y su papel cabe en un solo dibujo con el agente en el centro. MCP conecta al agente con sus herramientas y sistemas: el simulador, las existencias, la política. A2A conecta al agente con otros agentes, el de análisis de contratos de Compras o el de riesgo de Finanzas de la etapa 7. Y AG-UI conecta al agente con la aplicación donde una persona lo sigue, transmitiendo no solo texto sino el estado compartido entre los dos. El dibujo es honesto si se añaden dos frases: MCP y A2A son estándares con una fundación detrás, y AG-UI es una convención de un fabricante con adopción creciente. MCP lo donó Anthropic a la Agentic AI Foundation de la Linux Foundation en diciembre de 2025, con AWS, Google, Microsoft y OpenAI entre los miembros fundadores, y su especificación vigente es de julio de 2026; A2A lo creó Google y está en la Linux Foundation desde junio de 2025, con su versión 1.0 publicada y el protocolo rival de IBM fusionado dentro; AG-UI lo publicó CopilotKit en mayo de 2025 con licencia abierta, no está en ninguna fundación, y aun así Amazon lo soporta de forma nativa en su runtime y lo integran los principales frameworks. La triada tal cual procede del propio marketing de AG-UI; dibujar los tres iguales sería engañar.
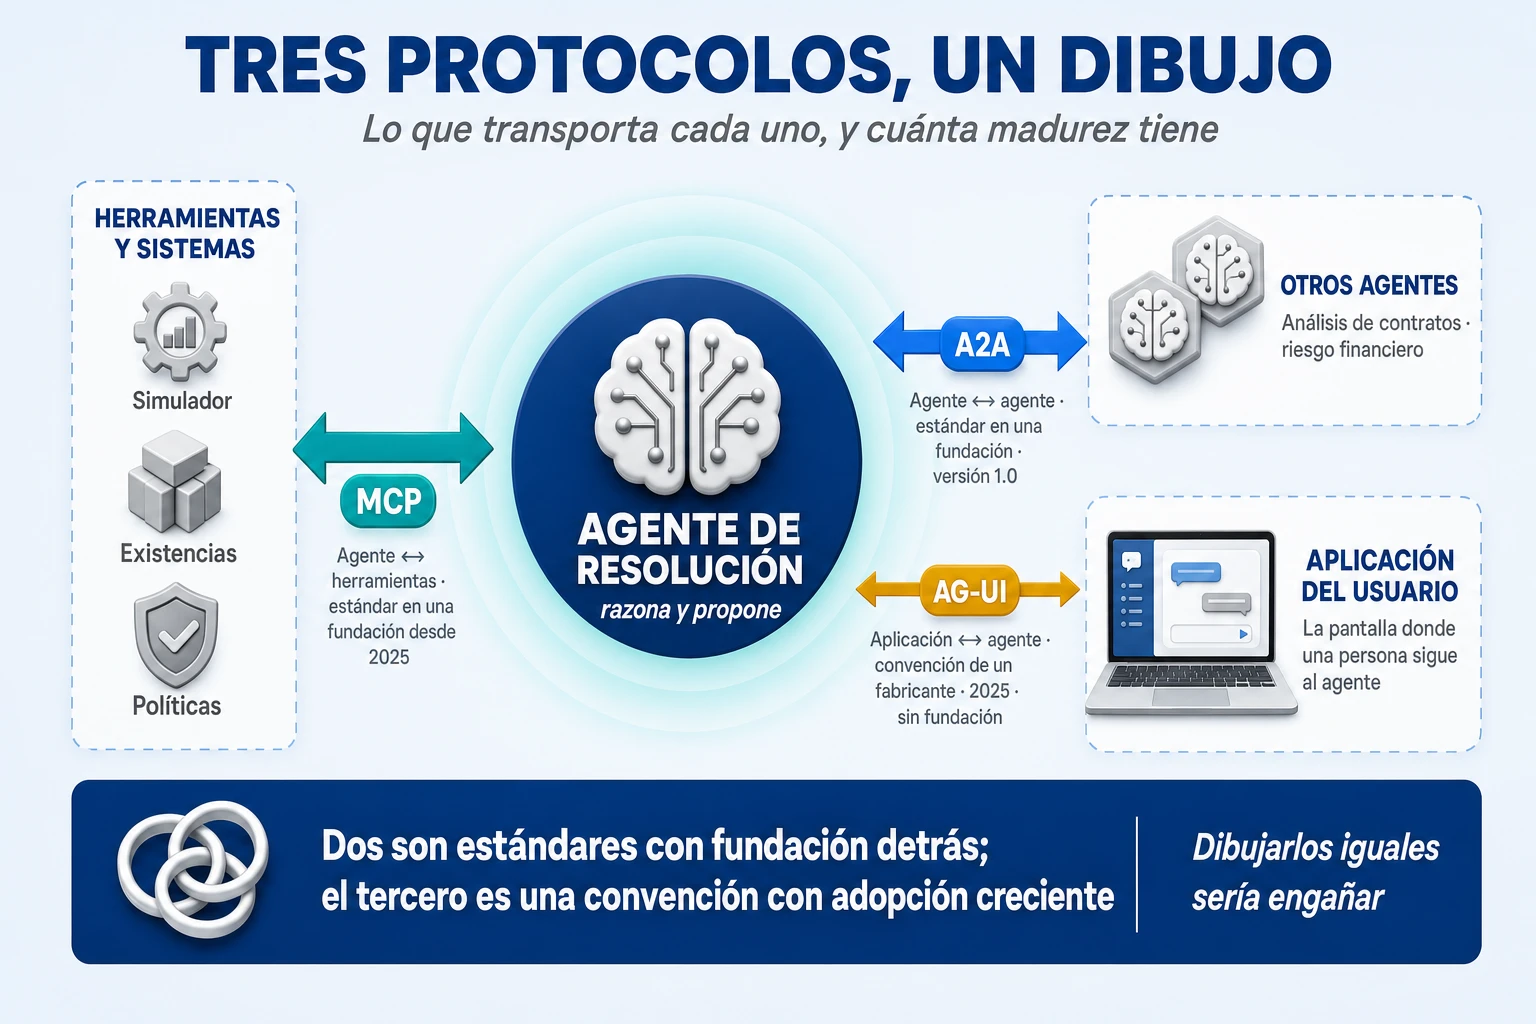
Qué es MCP por dentro, cómo se gobierna el acceso a herramientas a través de una pasarela y por qué A2A no sustituye a una función tipada cuando la petición cabe en una, está explicado en el artículo sobre la plataforma de agentes, y aquí no se repite. Lo que esta etapa añade es el criterio de uso: MCP siempre que el agente necesite una capacidad de la empresa; A2A solo cuando lo que hay al otro lado es de verdad otro agente con su propio razonamiento; y AG-UI cuando una persona tiene que seguir al agente en tiempo real desde una aplicación, que en el pedido 1846 es la pantalla del aprobador.
Un encaje concreto para el pedido 1846
Con todo lo anterior, el encaje completo para la distribuidora se puede recorrer de principio a fin. El agente se desarrolla en el editor con un asistente de programación, se programa con un framework pro-code, se aloja en un runtime gestionado con identidad propia, y queda dentro de un motor de proceso BPMN que coordina la política, las aprobaciones y las compensaciones; los sistemas de la empresa se exponen por APIs y MCP a través de la plataforma de agentes, y la predicción y la simulación son servicios especializados que el agente consulta como una herramienta más. Es una combinación técnicamente plausible, y hay que decir en la misma frase que antes de adoptarla habría que validar requisitos, compatibilidad y coste, porque cada una de esas piezas tiene versiones, estados y precios que cambian cada trimestre.
Si hay que mojarse, y en este artículo hay que hacerlo, la recomendación para una distribuidora como la del ejemplo, que ya vive en Microsoft 365, tiene un equipo de datos competente y no una fábrica de software, es una mezcla de la primera y la segunda columna: la experiencia, la identidad, los datos y el alojamiento del agente en el ecosistema de Microsoft, porque ya están pagados y gobernados; y el control del proceso en un motor BPMN externo con las reglas en DMN, porque es justo lo que a ese ecosistema le falta de serie y lo que una auditoría va a querer leer. La simulación, como servicio especializado, se compra, no se construye. Es un razonamiento, no una medición, y las cinco preguntas con las que cualquier empresa puede llegar a su propia respuesta son las mismas: qué capacidades tenemos ya y podemos reutilizar; cuánta flexibilidad necesitamos en el razonamiento y la coordinación; qué procesos exigen ejecución duradera, transacciones, aprobaciones y recuperación; qué predicción, simulación y conocimiento hacen falta; y qué independencia tecnológica, operación propia y mantenimiento podemos asumir. La arquitectura resultante debe responder al problema, y no obligar al problema a adaptarse a una plataforma.
Un segundo caso: la aseguradora que tramita un siniestro de 460 € sin un gran sistema multiagente
El pedido 1846 ha necesitado predicción, simulación y un gemelo de la operación porque tres almacenes y veinticinco mil pedidos semanales se afectan unos a otros. La mayoría de los procesos de una empresa no son así, y el segundo caso sirve para ver qué queda del método cuando se quitan las piezas caras. Un cliente comunica desde la aplicación de su aseguradora, a las 19:12, una avería en casa; adjunta tres fotografías, la factura de la reparación, que asciende a 460 euros, y una descripción de lo ocurrido. El caso es ficticio. Lo que sigue es el mismo recorrido de ocho etapas, comprimido, y lo interesante es cuántas etapas se resuelven con casi nada.
Descubrir el proceso real enseña que la mayor parte del tiempo de un siniestro pequeño se va en esperar a que alguien lo abra, lo lea y lo compare con la póliza, no en decidir. Construir el contexto consiste en tener a mano la póliza, sus coberturas, sus franquicias, el historial del cliente y las reclamaciones anteriores sobre la misma dirección, que ya están en el sistema asegurador. Anticipar y simular no hacen falta: no hay recursos compartidos ni alternativas que comparar, y la única pregunta es si el siniestro está cubierto y por cuánto. Lo que sí hace falta es leer documentos y fotografías, aplicar las reglas de la póliza, detectar si algo no cuadra, calcular la indemnización, autorizarla y registrarla.
| Función | Componente |
| Leer la documentación y las fotografías | IA multimodal, con una puntuación de certeza por cada lectura |
| Comprobar la cobertura | Motor de reglas sobre las condiciones de la póliza |
| Investigar contradicciones | Un agente sencillo, configurado sin apenas código |
| Calcular la indemnización | Servicio determinista: franquicia, límites, depreciación |
| Tramitar la autorización | Workflow, con aprobación por importe |
| Registrar la liquidación | API del sistema asegurador |
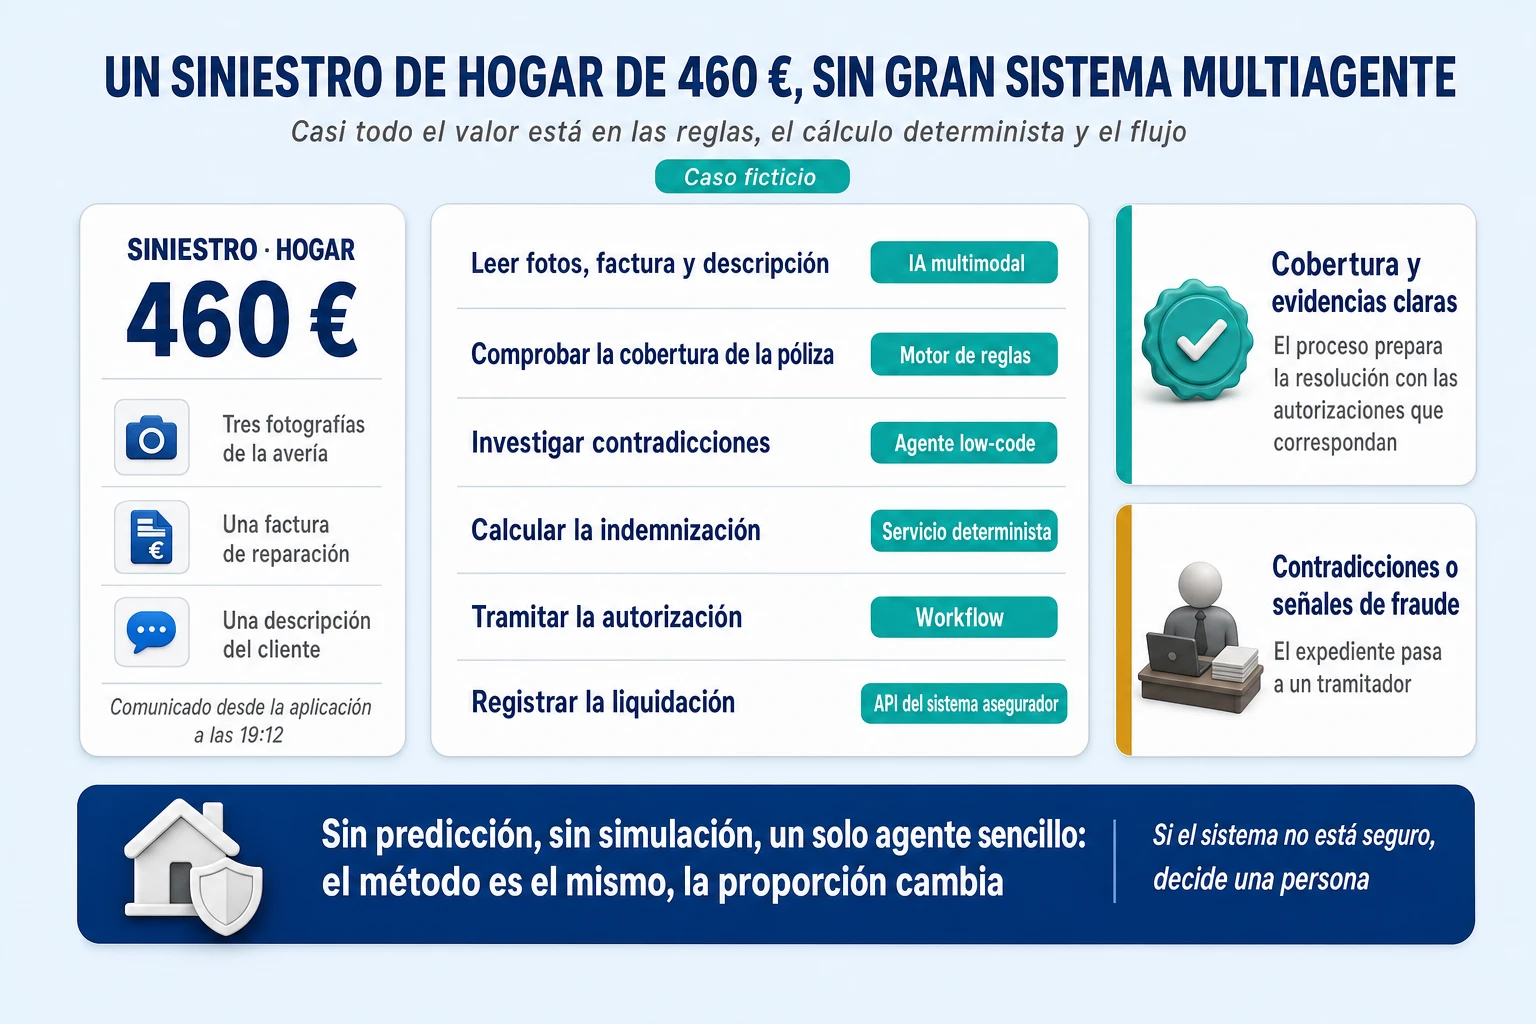
El flujo es corto. El modelo multimodal lee la factura, extrae la fecha, el importe y el concepto, describe lo que ve en las fotografías y devuelve, con cada lectura, una puntuación de certeza. El motor de reglas comprueba contra la póliza si el daño está cubierto, si hay franquicia y cuál es el límite. El agente, que aquí es un agente sencillo construido con una herramienta de poco código, hace una sola cosa que exige interpretación: buscar contradicciones, por ejemplo una factura fechada antes del siniestro, una fotografía que no se corresponde con la descripción o una reparación que no encaja con el daño declarado. Si la cobertura y las evidencias son claras, un servicio determinista calcula la indemnización, el workflow pide la autorización que corresponda al importe y la liquidación se registra en el sistema asegurador; si hay contradicciones o señales de fraude, el expediente pasa a un tramitador con todo lo recopilado. La implementación ilustrativa es una plataforma declarativa o de poco código, la propia del sistema asegurador o una como Copilot Studio, conectada a un workflow y a los servicios de la compañía.
Lo que las aseguradoras hacen de verdad confirma la arquitectura y la templa. Lemonade, la aseguradora nacida digital que más presume de automatizar, declara en su informe anual de 2025 que su sistema recoge sin intervención humana el 96 % de las primeras notificaciones de siniestro y que aproximadamente el 55 % de los siniestros se tramita de forma automatizada de principio a fin; el resto lo deriva a personas por dos motivos que el propio informe separa, que el sistema no está autorizado a liquidar ese importe o que ha detectado algo que le preocupa. Allianz publicó en 2026 que en su ramo de mascotas en Alemania el 49,7 % de los siniestros de 2025 se tramitó de forma totalmente automática, con la regla de que si el sistema no está seguro el caso va a expertos humanos, y con paneles que comparan la salida de la IA con el resultado real para detectar desviaciones. Incluso las aseguradoras que más automatizan derivan alrededor de la mitad de los casos a una persona, y lo hacen por las mismas dos razones que el pedido 1846: el límite de autorización y las señales de riesgo. El supervisor europeo de seguros, en su opinión de agosto de 2025, no prohíbe nada de esto: pide controles proporcionales al impacto y, para las piezas que no se pueden explicar del todo, como la lectura de imágenes, gobierno de datos y supervisión humana que compensen esa falta de explicabilidad, recordando que la entidad responde aunque el proveedor sea un tercero.
La lección del caso es que una arquitectura principalmente declarativa resuelve un problema completo sin simulación ni sistema multiagente, siempre que el trabajo pesado lo hagan las reglas, el cálculo y el flujo. Quien quiera mejorar este sistema no debe añadir agentes: debe mejorar la puntuación de certeza del lector de documentos, afinar las reglas y medir cuántos casos derivados a tramitador se resolvieron igual que habría propuesto el sistema.
Un tercer caso: la oferta de cinco millones que preparan varios agentes
El tercer caso va en la dirección contraria. Una empresa de servicios recibe un pliego de doscientas cincuenta páginas para una licitación de cinco millones de euros, con requisitos técnicos, legales, financieros y comerciales, y tres semanas para presentar la oferta. El caso es ficticio. Aquí sí tiene sentido estudiar varios agentes especializados, y conviene decir por qué, porque el multiagente es la arquitectura que más se sobreutiliza: los requisitos técnicos, los jurídicos y los económicos se evalúan con información distinta y con criterios distintos, los tres tienen que consolidarse en una oferta coherente, y la coherencia la tiene que comprobar alguien que no haya redactado ninguna de las partes.
La arquitectura tiene cinco agentes y una persona. Un agente coordinador lee el pliego, extrae cada requisito a una matriz de cumplimiento compartida, divide el trabajo y consolida los resultados. Tres especialistas trabajan en paralelo sobre esa matriz: el técnico, conectado al repositorio de soluciones y arquitecturas de la empresa; el jurídico, a las cláusulas, los riesgos y los antecedentes de cumplimiento; el financiero, al servicio de costes, a los márgenes y a las condiciones de pago. Un agente evaluador comprueba la coherencia entre las tres partes y, para cada requisito del pliego, que la oferta lo cubre y señala la evidencia que lo sostiene; el evaluador no redacta, y esa separación es la decisión de diseño más importante del caso. La información se comparte entre agentes como estado común, la matriz de requisitos y los borradores por sección, no como conversación, y el resultado pasa a revisión y aprobación humana antes de presentarse. La implementación ilustrativa es un framework multiagente programado, como LangGraph, CrewAI o Microsoft Agent Framework, conectado a los repositorios documentales, al CRM, al servicio de costes y a las herramientas de redacción.
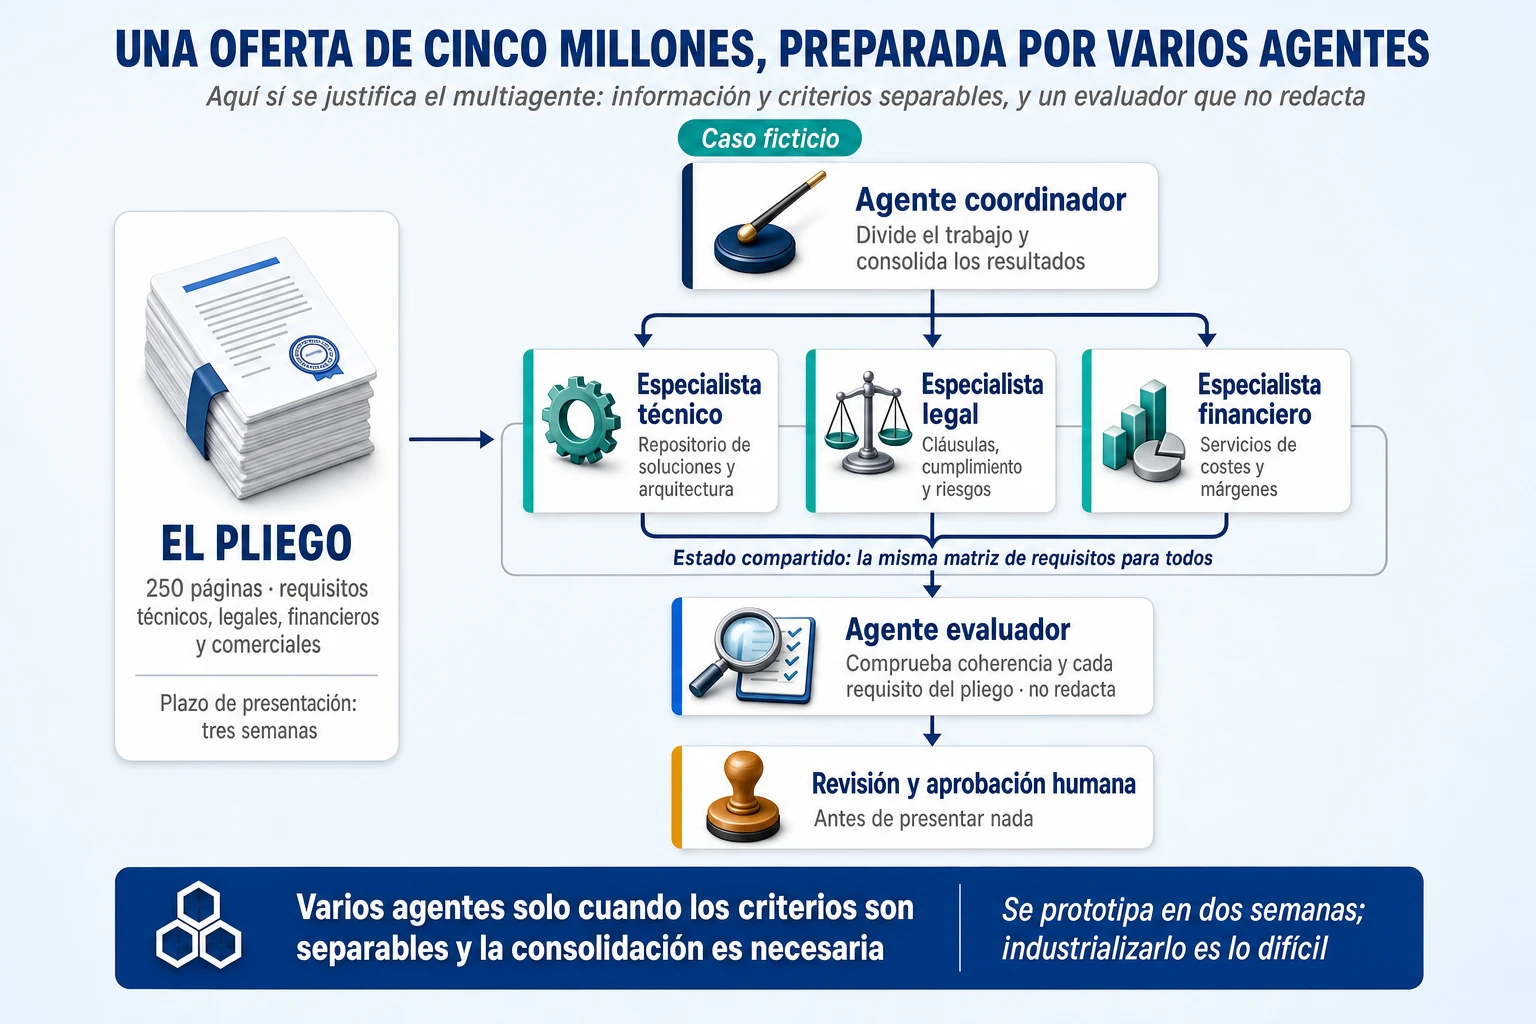
Lo que existe en el mercado confirma la arquitectura sin usar sus nombres. Los productos de respuesta a licitaciones y cuestionarios, Responsive, Loopio, AutogenAI o DeepRFP, implementan de hecho la misma secuencia, extracción de requisitos a una matriz de cumplimiento, redacción por secciones desde la biblioteca de contenidos de la empresa y una puntuación final que valida que cada respuesta cubre lo que se pregunta, y lo venden como flujo, no como equipo de agentes; SAP tiene en disponibilidad general un agente de análisis de pliegos, en este caso del lado del comprador. Un estudio publicado en enero de 2026 sobre sistemas multiagente en empresas encontró el patrón del coordinador que traspasa el trabajo a especialistas, y también la lección incómoda: los prototipos se entregaron en dos semanas y las soluciones listas para piloto en un mes, pero pasar a producción fue difícil por la variabilidad del comportamiento del modelo. Se prototipa deprisa y se industrializa despacio, y lo caro no es la arquitectura sino la etapa 8.
Los riesgos de este caso son distintos de los del pedido y hay que diseñarlos desde el principio. El primero es afirmar un cumplimiento que no existe, una certificación que la empresa no tiene o una experiencia que no es tal, y en una licitación eso no es un error de redacción sino causa de exclusión; de ahí que el evaluador exija evidencia para cada requisito. El segundo es la confidencialidad: el pliego, los datos del cliente y los precios no pueden acabar en un modelo externo sin las garantías contractuales adecuadas. El tercero es la homogeneización, porque si todos los licitadores usan las mismas herramientas sobre bibliotecas parecidas, la diferencia vuelve a estar en el juicio humano. Y el cuarto es la transparencia con el comprador: la administración británica pide desde 2024 a los licitadores que declaren si han usado IA en la oferta, a título informativo y sin penalizar, y prohíbe usar la información confidencial del pliego para entrenar modelos; en España no hay una regla general, pero mentir sobre el uso es peor que usarla. En la escala de autonomía, redactar es preparar; presentar lo decide una persona.
Tres problemas, tres arquitecturas: lo que cambia y lo que no
Puestos uno al lado de otro, los tres casos enseñan que el método es el mismo y que lo que cambia es la proporción de cada pieza. Los tres empiezan por descubrir el proceso real y construir el contexto; los tres tienen un motor de proceso que controla la ejecución y una persona en el sitio donde la decisión cambia el coste, el compromiso o el riesgo; y en los tres el agente propone y no ejecuta. La tabla responde para cada caso a las siete preguntas que dimensionan la arquitectura.
| Pregunta | Pedido en riesgo | Siniestro de hogar | Oferta de licitación |
| ¿Necesita predicción? | Sí: probabilidad de retraso, recalculada en cada evento | No | No |
| ¿Necesita simulación? | Sí: tres alternativas con coste y probabilidad | No | No |
| ¿Cuántos agentes? | Uno, que investiga y propone | Uno sencillo, que busca contradicciones | Cinco: coordinador, tres especialistas y evaluador |
| ¿Low-code o pro-code? | Pro-code | Declarativo o low-code | Pro-code multiagente |
| ¿Motor de proceso? | Sí: reservas, expediciones, compensaciones, aprobación | Sí: workflow de autorización por importe | Sí: consolidación, revisión y aprobación |
| ¿Dónde entra la persona? | Por encima del límite de gasto, ante contradicciones, con clientes sensibles | Ante contradicciones o señales de fraude | En la revisión final, antes de presentar |
| ¿Dónde está el valor? | En anticipar y comparar antes de que el cliente reclame | En las reglas, el cálculo y el flujo | En separar criterios y consolidar con evidencia |
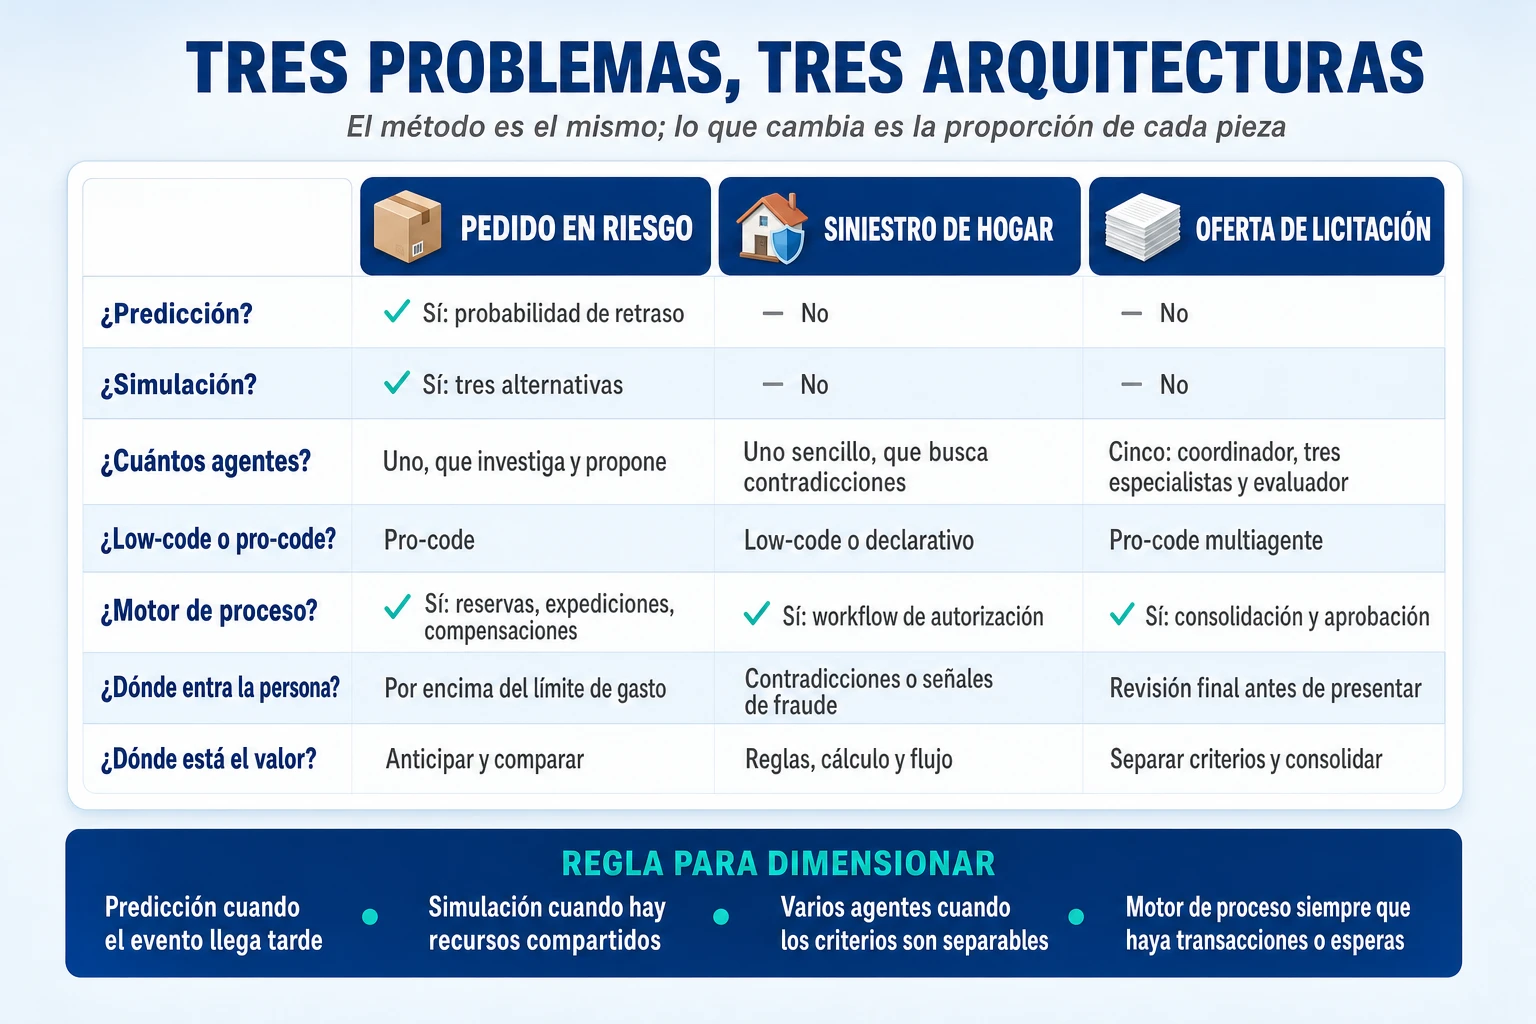
De la tabla sale una regla práctica para dimensionar cualquier caso nuevo antes de elegir una sola tecnología. Se añade predicción cuando el evento que hoy dispara el proceso llega tarde, como la reclamación del cliente; se añade simulación cuando hay recursos compartidos cuyo uso en un caso afecta a los demás; se añaden varios agentes cuando los criterios de evaluación son separables y hace falta consolidarlos; y se pone un motor de proceso siempre que haya transacciones o esperas, que es casi siempre. El agente se construye configurándolo cuando solo interpreta y las reglas hacen el trabajo, y se programa cuando hay una política precisa, varios sistemas y un evento que lo arranca sin que nadie le escriba. Todo lo demás, el gemelo, la optimización, el multiagente, se justifica caso a caso o no se justifica.
Etapa 7. Escalar de un agente a un ecosistema: cuando cinco departamentos construyen a la vez
El primer proceso funciona, y entonces Compras, Ventas, Atención al Cliente y Finanzas empiezan a construir sus propios agentes, y la pregunta deja de ser cómo se construye uno para pasar a ser cómo no se construyen cinco veces las mismas cosas. Cada departamento necesita leer contratos, evaluar riesgos, consultar al cliente y entender el impacto de una decisión sobre los costes, y cada uno lo resuelve a su manera, con su proveedor, su identidad y su registro. Al cabo de un año la empresa tiene tres agentes de análisis de contratos que no se conocen entre sí, y nadie sabe cuántos agentes hay ni qué datos tocan. Esta etapa decide el modelo organizativo que evita eso, y es mucho menos tecnológica de lo que parece.
Centralizado, federado o híbrido
Hay tres modelos, y los nombres vienen del gobierno de datos de la década pasada más que de ningún analista de agentes, así que conviene tomarlos como criterio y no como doctrina. El modelo centralizado, un equipo que construye y gobierna todos los agentes, funciona con menos de una decena y un solo dominio, y se atasca cuando tres departamentos piden a la vez, porque los agentes de bajo riesgo esperan en la misma cola que los de alto riesgo. El federado puro, cada departamento construye lo suyo, produce la proliferación descrita arriba. El híbrido, una plataforma común operada por un equipo central, dominios que son dueños de sus agentes y los publican en un catálogo compartido, y un comité ligero que fija cuánta autonomía puede tener cada tipo de agente, es el único que hoy tiene soporte de producto y el que recomiendan, con otras palabras, los analistas y las consultoras. Gartner publicó en mayo de 2026 que aplicar un gobierno uniforme a todos los agentes conduce al fracaso, propuso un gobierno proporcional por cuatro niveles de autonomía, observar, aconsejar, actuar con aprobación y actuar solo, y previó que en 2027 el 40 % de las empresas degradará o retirará agentes autónomos por huecos de gobierno descubiertos después de un incidente en producción; es una predicción, no una medición, y los cuatro niveles de Gartner son de gobierno y no sustituyen a la escala de autonomía por acción de este blog, pero apuntan en la misma dirección.
La parte del inventario y la identidad la han resuelto los grandes proveedores, cada uno para los suyos. Microsoft tiene en disponibilidad general desde mayo de 2026 un registro centralizado de agentes con identidad propia en su directorio, en la que cada agente tiene un patrocinador humano y una identidad pensada para existir minutos y crearse miles de veces al día. ServiceNow ofrece desde mayo de 2025 una torre de control que inventaría agentes propios y, por integraciones, de terceros; Salesforce, SAP y Google tienen sus equivalentes. Lo que ninguno hace es gobernar de forma nativa los agentes de los otros, así que una distribuidora con el ERP de un proveedor, el CRM de otro y la suite ofimática de un tercero tendrá tres inventarios de agentes salvo que decida cuál es el maestro. Y lo que el producto no resuelve en ningún caso es quién es el dueño funcional de una capacidad, qué procesos la consumen, quién paga cuando la usan otros y quién responde cuando falla dentro de un proceso ajeno. Eso es el catálogo, y es trabajo de la empresa.
Cuatro tipos de agentes, y cuáles se comparten
Para decidir qué se comparte hace falta una clasificación, y la que se propone aquí es propia, no de ningún analista. Hay agentes específicos de un proceso, como el de resolución de incidencias de pedidos, que viven dentro de ese proceso y rara vez sirven fuera. Hay agentes transversales a procesos, como el análisis de contratos o la evaluación documental, que hacen lo mismo para Compras, para Legal y para Pedidos. Hay agentes transversales a dominios, como el que evalúa el impacto de una decisión sobre el cliente, los costes y las operaciones a la vez, que por definición no pertenecen a un departamento. Y hay agentes especializados por dominio, como el de inventario, el de riesgo financiero o el de planificación logística, que son de un departamento pero los consultan los demás. Los dos primeros tipos del medio y el último se comparten; el primero, no, y la distinción ahorra la discusión de si todo debe ser común, que suele acabar en que nada lo es.
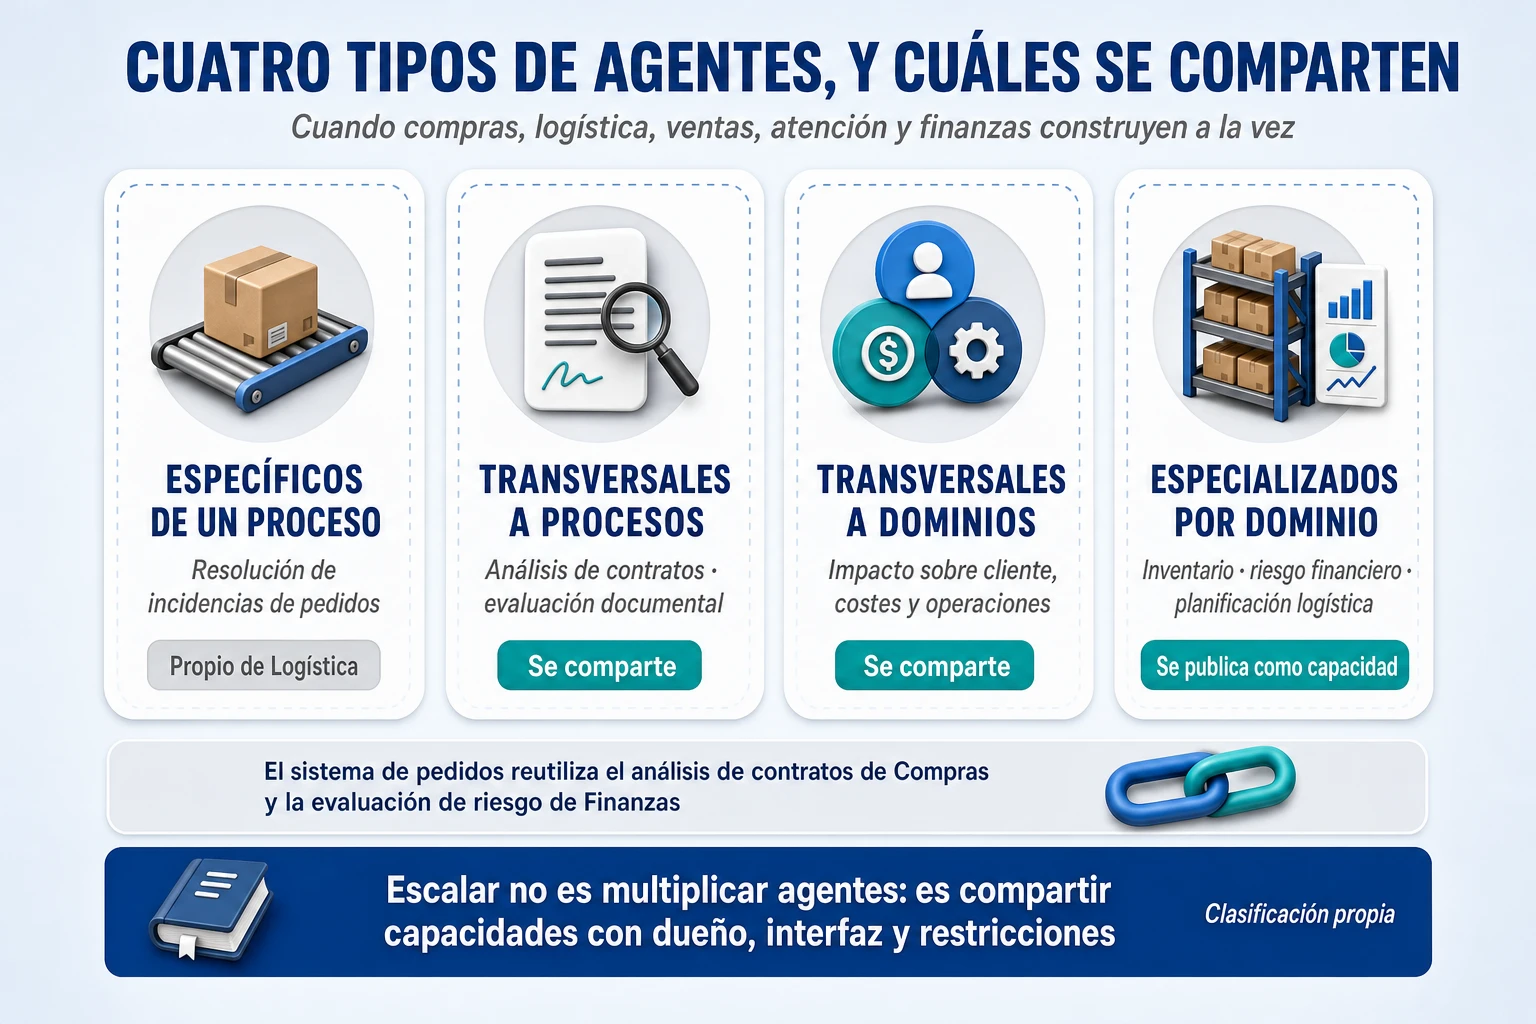
En la distribuidora esto se traduce en reutilización concreta. El sistema de pedidos no construye su propio análisis de contratos para saber si un cliente admite entregas parciales o qué penalización lleva un retraso: consume el agente de análisis de contratos que Compras publicó para sus proveedores, que ya existe como producto en algunos ERP. Tampoco construye su evaluación de riesgo de cliente: consume la capacidad que Finanzas mantiene para el crédito. Cada capacidad reutilizada es un agente menos que construir, pero sobre todo es una definición menos que discutir, porque la empresa entera pasa a tener una sola respuesta a qué significa que un contrato permite una entrega parcial.
Cómo se publica y se consume una capacidad
Una capacidad se publica de una de tres formas según lo que haya detrás: como una API de negocio si es una función determinista, como una herramienta accesible por MCP si la va a consumir un agente, o como un agente accesible por A2A si lo que hay al otro lado razona por su cuenta. Los registros públicos para anunciarlas existen pero están verdes: la especificación 1.0 de A2A define una tarjeta de agente en una ruta conocida y recomienda a las empresas registros curados propios, y el registro oficial de MCP sigue en vista previa desde septiembre de 2025 sin soporte para registros privados, aunque los runtimes gestionados han empezado a ofrecer los suyos. Lo que de verdad importa no es el mecanismo de publicación sino lo que declara cada entrada del catálogo: quién es el propietario, con nombre y suplente; qué interfaz expone y en qué protocolo; de qué depende; qué restricciones tiene, de solo lectura, de datos, de uso; qué procesos la consumen; y en qué versión y estado está. Sin dueño, el catálogo es una lista; sin consumidores declarados, nadie sabe a quién avisar cuando cambia.
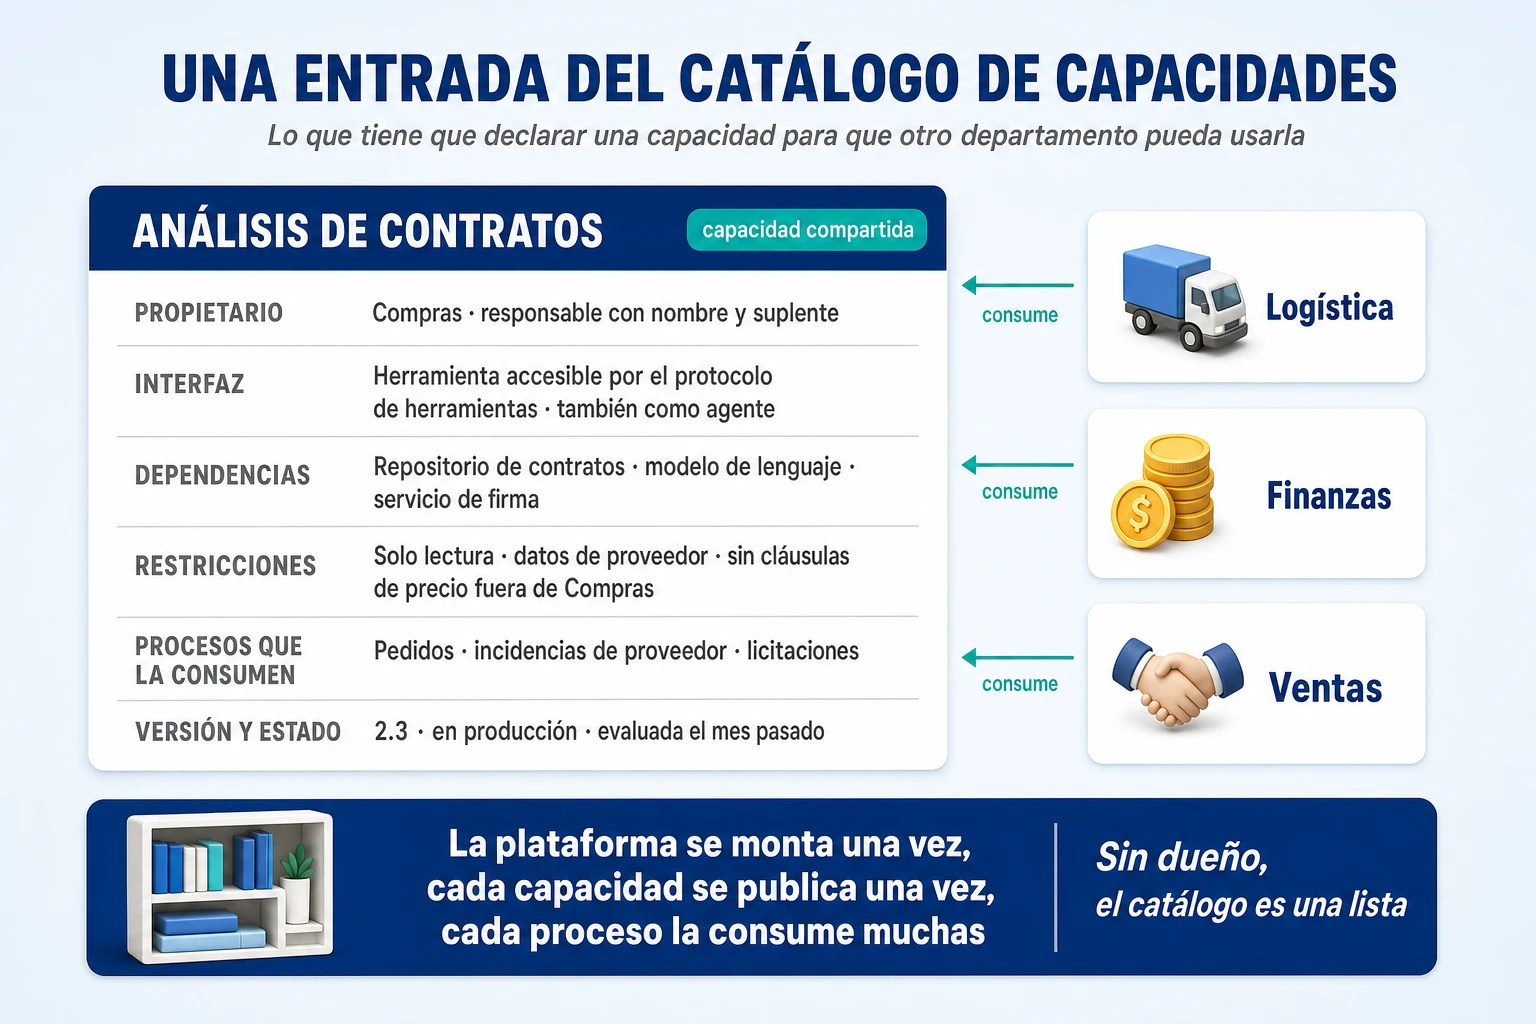
Tres problemas del catálogo no los resuelve ningún producto y hay que resolverlos en el comité ligero. Quién paga la capacidad compartida, porque el agente de contratos de Compras lo usan ahora Pedidos y Legal y consume modelo cada vez. Quién responde cuando falla dentro de un proceso ajeno, porque el responsable del proceso de pedidos no controla el agente que le dio una lectura equivocada. Y cómo se versiona sin romper a los consumidores, con el agravante, nuevo respecto a los servicios compartidos de siempre, de que una capacidad agéntica cambia de comportamiento cuando cambia el modelo que tiene debajo aunque nadie haya tocado nada. Son los problemas de los servicios compartidos de toda la vida, y la respuesta también lo es: la plataforma se monta una vez, cada capacidad se publica una vez y cada proceso la consume muchas veces, que es la lógica de los dos relojes explicada en el artículo sobre la plataforma de agentes. Al terminar la etapa 7 la distribuidora tiene un catálogo con propietarios, interfaces, dependencias, restricciones y consumidores, y un modelo operativo para mantenerlo que no depende de que un departamento le haga favores a otro.
Etapa 8. Industrializar: comprobar que funciona todo el sistema, no solo el agente
En producción hay que comprobar cinco cosas, y el razonamiento del agente es solo una de ellas. Que la predicción está calibrada, es decir, que de los pedidos a los que el modelo da un 72 % se retrasan de verdad siete de cada diez. Que la simulación es fiel, en el sentido de que su error en la métrica que decide es menor que la diferencia entre las alternativas que compara; si las alternativas difieren en ocho puntos y el simulador yerra en quince, no decide nada. Que las decisiones respetan los límites, con ninguna ejecución automática por encima de la política. Que el proceso se recupera de una reserva fallida, de una caída del servidor y de una aprobación tardía. Y que el agente razona bien, sigue la trayectoria esperada, produce una salida válida y escala cuando duda. La mayoría de los proyectos evalúa la quinta y da por supuestas las otras cuatro.
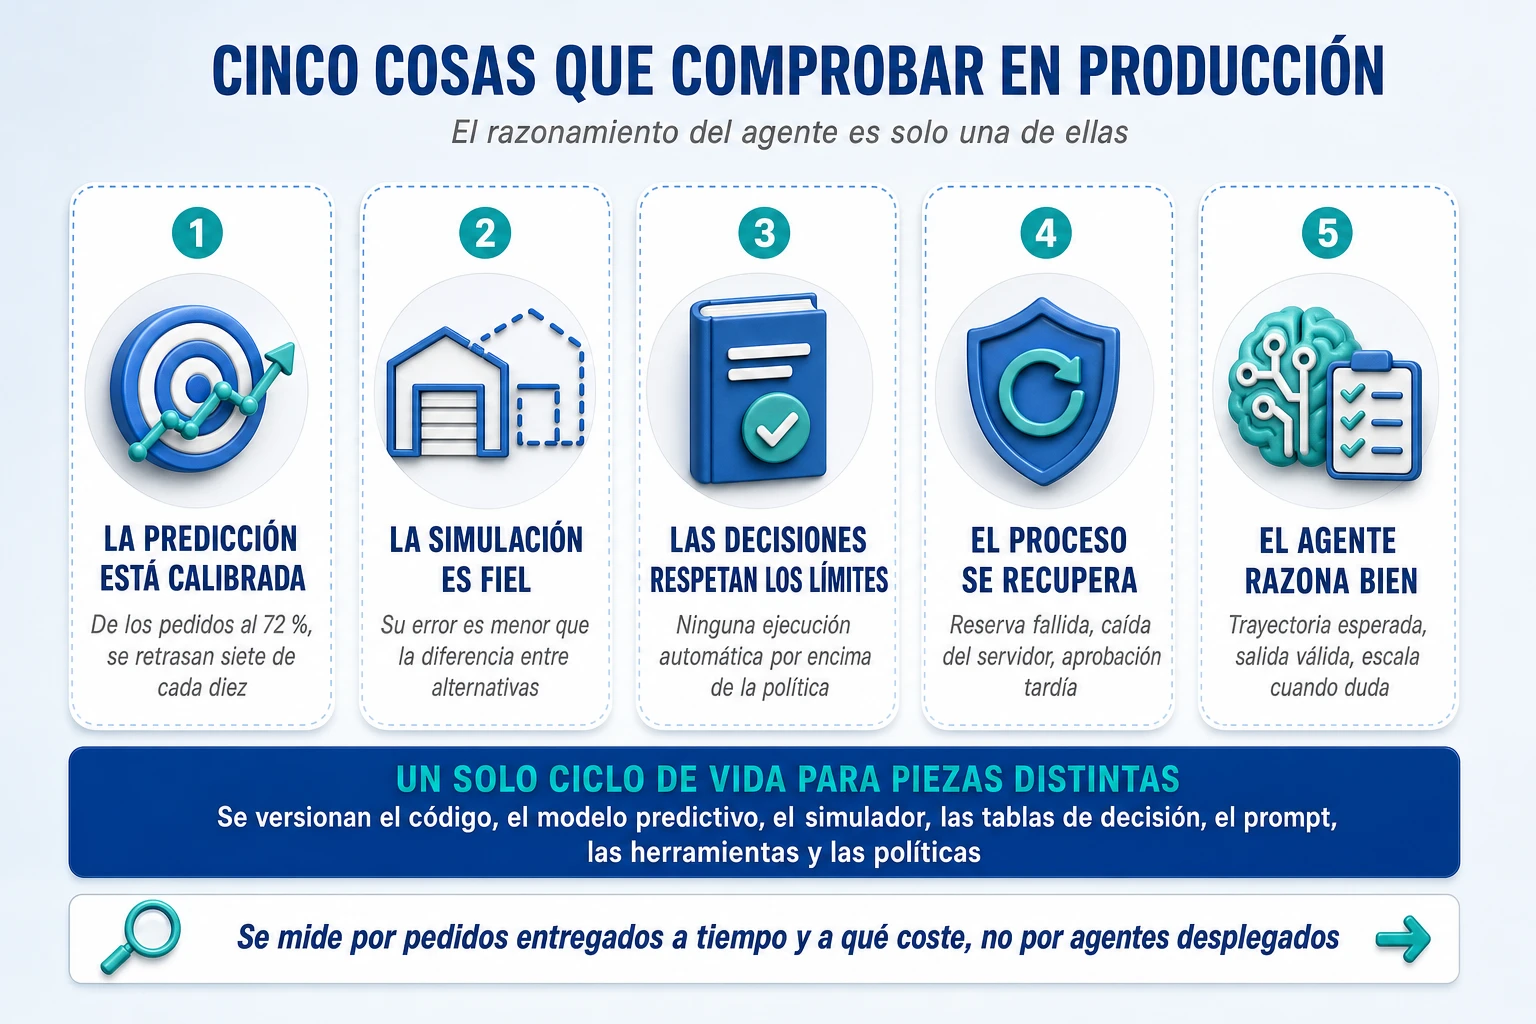
Un solo ciclo de vida para piezas distintas
Las siglas se han multiplicado, DevOps para el código, MLOps para los modelos, LLMOps para los modelos de lenguaje y AgentOps para los agentes, y conviene tratarlas como un solo ciclo de vida con objetos distintos que versionar. En el sistema del pedido 1846 se versionan el código del proceso y de las herramientas, el modelo predictivo con sus datos de entrenamiento, el simulador con sus parámetros, las tablas de decisión, el prompt del agente, el esquema de su salida, las políticas de permisos y la memoria que conserve. La novedad respecto a un microservicio es que el agente es una tupla, y la tupla cambia cuando cambia cualquiera de sus partes, incluido el modelo que el proveedor actualiza sin avisar: un agente cuyo prompt no ha cambiado pero cuyo modelo sí es una versión nueva y hay que reevaluarlo como tal. Un estudio del organismo público de investigación australiano publicado a finales de 2024 enumera lo que hay que poder trazar de un agente, el agente mismo, su plan, sus herramientas, su memoria, sus barandillas y su evaluación, y es una buena lista de lo que hay que versionar.
El embudo de promoción a producción tiene cuatro pasos y el orden importa. Primero la evaluación fuera de línea, contra el conjunto de casos de la etapa 4 y contra los fallos reales acumulados, con el criterio de no empeorar frente a lo que está en producción; es lo que la guía de madurez de MLOps de Google describe como validar el modelo antes de desplegarlo. Segundo el modo sombra, en el que la versión nueva recibe una copia de los casos reales y recomienda, pero solo la respuesta de la versión en producción llega al proceso, de modo que se compara sin que nadie actúe sobre ella. Tercero el despliegue gradual con autonomía reducida, un porcentaje de pedidos en los que la versión nueva propone y una persona aprueba, con un grupo de control simultáneo y no una comparación antes y después, que es como lo define el manual de fiabilidad de Google. Y cuarto la ampliación, seguida de una reevaluación periódica aunque nadie haya tocado nada, porque para un agente la deriva más frecuente no está en los datos sino en el modelo del proveedor y en las herramientas. Un modelo predictivo no necesita el tercer paso porque no ejecuta nada; un agente que reserva stock, sí.
Observar y pagar son la otra mitad de operar. Las trazas de un agente contienen prompts, resultados de herramientas y datos de negocio, así que dónde viven es una decisión de gobierno antes que de herramienta; las convenciones de telemetría para IA generativa de OpenTelemetry, que ya definen cómo trazar un agente y una llamada por MCP, siguen a fecha de este artículo en estado de desarrollo, lo que en la práctica significa que cambiar de plataforma todavía obliga a rehacer los cuadros de mando. En cuanto al coste, la encuesta anual de la FinOps Foundation de 2026, con casi mil doscientos practicantes, encontró que el 98 % ya gestiona costes de IA, frente al 31 % dos años antes; la Foundation propone medir por inferencia, por token y por llamada. Este artículo propone una unidad distinta y la declara como criterio propio: el coste por pedido resuelto, con un tope por expediente, porque es la única unidad que el responsable del proceso puede comparar con el valor del pedido, y porque un agente consume del orden de cuatro veces los tokens de una conversación y un sistema multiagente del orden de quince, según las mediciones del propio laboratorio que los vende.
Decisiones de despliegue que no son técnicas
Dónde se ejecuta todo esto, en la nube, en local o en una combinación, lo decide sobre todo la residencia del dato y la regulación, y aquí conviene estar al día porque el calendario europeo cambió en 2026. El reglamento conocido como Digital Omnibus, en vigor desde el 27 de julio de 2026, retrasó las obligaciones de la Ley de IA para los sistemas de alto riesgo del anexo III al 2 de diciembre de 2027 y las del anexo I al 2 de agosto de 2028. Ni la gestión de pedidos ni la tramitación de un siniestro de hogar son sistemas de alto riesgo según esa ley, lo que no exime del resto del derecho aplicable, como recuerda el supervisor de seguros, pero sí quita de la mesa un argumento que se usa mucho para no empezar. La residencia del dato se resuelve con las regiones europeas de los proveedores y, cuando hace falta, con despliegues híbridos en los que el proceso y los datos viven en casa y los modelos se consumen como servicio.
Qué modelo usar para cada tarea es la segunda decisión, y la respuesta es varios. Un documento de posición de NVIDIA, en su versión de septiembre de 2026, sostiene que los modelos pequeños, de menos de diez mil millones de parámetros, son entre diez y treinta veces más baratos y bastan para una parte grande de las llamadas que hacen los agentes, y estima, sobre tres sistemas abiertos, que entre el 40 % y el 70 % de esas llamadas serían sustituibles; es la opinión de un fabricante interesado, pero el patrón que describe es razonable. En el pedido 1846, clasificar un correo, extraer campos de una factura o resumir un historial son tareas para un modelo pequeño y barato; investigar por qué el pedido está en riesgo y justificar la alternativa es tarea para uno grande, y el enrutado entre los dos es una decisión del harness, no del prompt. La multimodalidad entra cuando hay fotos y documentos, como en el siniestro, y la automatización de pantallas solo cuando un sistema no tiene API, con los límites que ya se han dicho.
El bucle de aprendizaje empresarial
Lo que convierte todo lo anterior en un sistema que mejora es un bucle, y conviene describirlo con sus piezas porque la versión ingenua, «el sistema aprende de sus resultados», es la que estropea el sistema. Cada expediente cerrado deja un registro: qué predijo el modelo, qué calculó el simulador, qué decidió la regla, qué propuso el agente, qué se ejecutó, si intervino una persona, qué pasó al final y cuánto costó. Ese registro alimenta tres validaciones con tres criterios: la calibración del predictor por tramos de probabilidad, el error del simulador en la métrica que decide y la tasa de éxito y el coste del agente. Los cambios que salen de ahí, recalibrar, reentrenar, ajustar una regla, cambiar un prompt, no se promueven a producción porque los resultados lo sugieran, sino después de pasar por la puerta de validación de antes, fuera de línea, en sombra y de forma gradual, y solo si no empeoran en ninguna de las tres y mejoran en la que motivó el cambio. Allianz describe exactamente eso cuando cuenta que sus paneles comparan la salida de la IA con el resultado real del siniestro para detectar desviaciones pronto.
El bucle tiene dos trampas con nombre propio y las dos aparecen en el pedido 1846. La primera la describieron Perdomo y sus colegas en 2020 y se llama predicción performativa: cuando se actúa sobre una predicción, se cambia el resultado que se intentaba predecir. Si el sistema divide todos los pedidos al 72 % y llegan a tiempo, los datos siguientes dicen que ese perfil de pedido no se retrasa; un reentrenamiento a ciegas bajará la probabilidad, el sistema dejará de intervenir y los retrasos volverán, con lo que habrá apagado el sistema que funcionaba. La solución es registrar la intervención como una variable más y evaluar contra lo que habría pasado sin ella, con un grupo de control si hace falta. La segunda es la ley de Goodhart: si se optimiza al agente por el porcentaje de pedidos a tiempo, aprenderá a dividir todos los envíos, que cuesta dinero, o a mover las fechas de compromiso, que es hacer trampas a la métrica; la métrica tiene que ser compuesta, puntualidad, coste y reclamaciones a la vez, y revisarse. A las dos se suma el riesgo de la memoria: si el agente guarda lecciones de sus propias ejecuciones, un error se refuerza, así que la memoria lleva origen y fecha, se revisa y se puede borrar por versión.
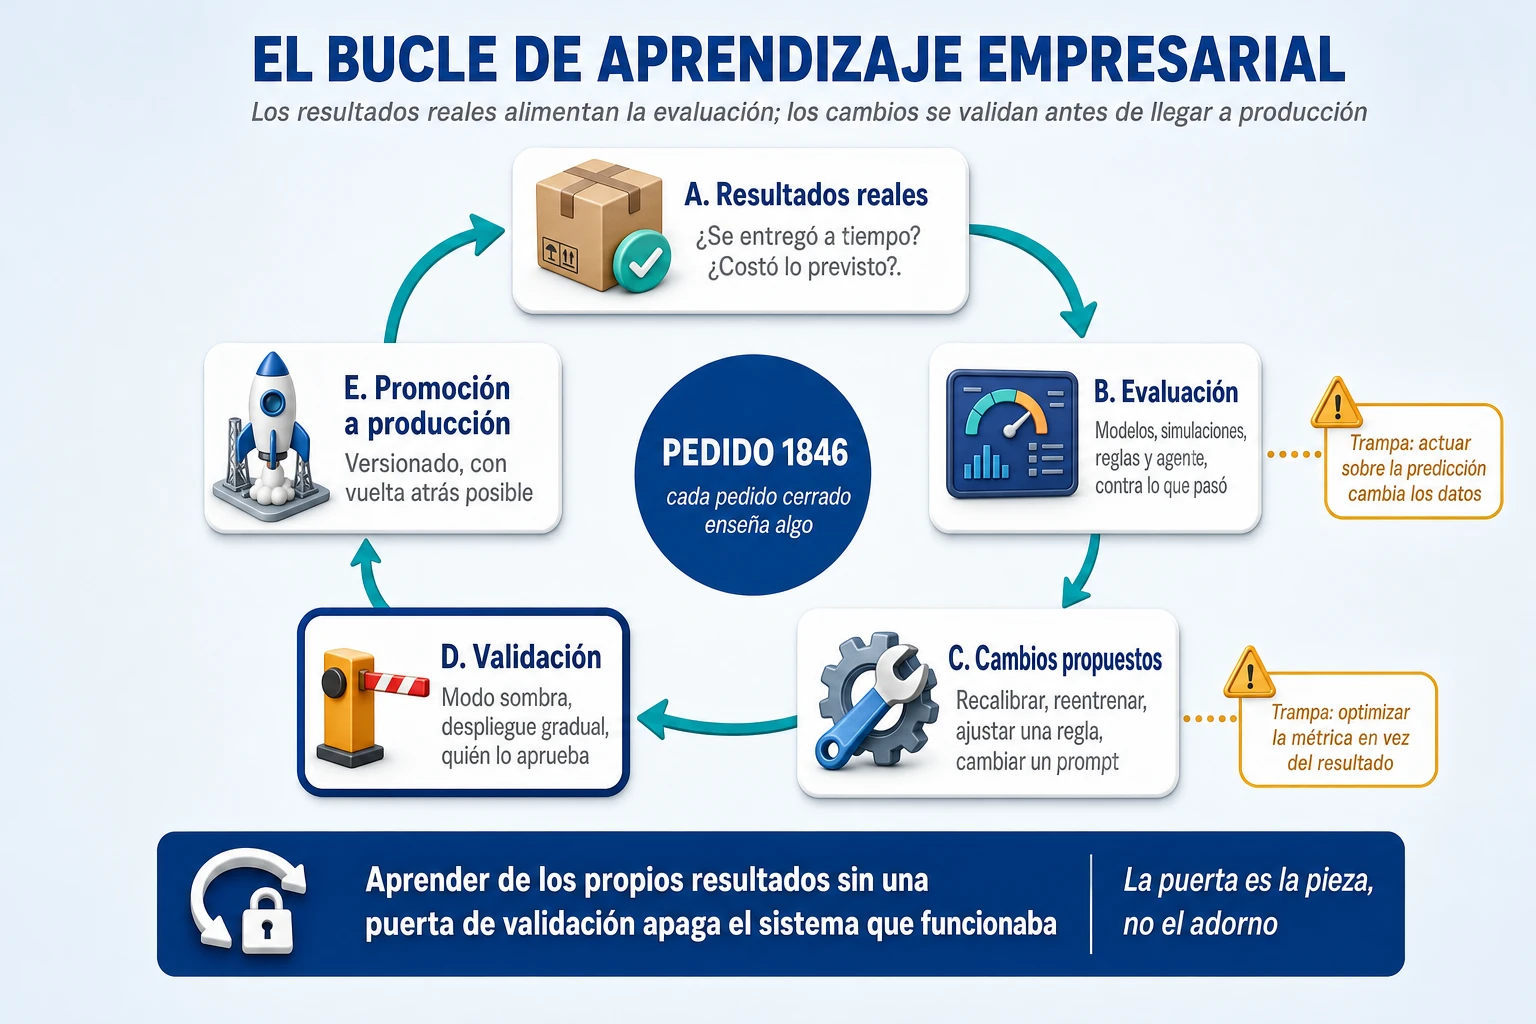
Al terminar la etapa 8 la distribuidora tiene un sistema que se puede versionar, probar, observar, pagar y mejorar, y que aprende de sus resultados sin apagarse a sí mismo. Es la etapa que separa el piloto que funcionó en la demostración del sistema que sigue funcionando el tercer mes, y es la que casi nadie presupuesta.
Implantarlo por etapas: visibilidad, decisión asistida y optimización dinámica
Nada de lo anterior se implanta el primer día, y el orden en que se implanta es una decisión tan importante como la arquitectura. No hace falta un gemelo digital completo, varios agentes, simulación avanzada y una plataforma nueva para empezar a evitar retrasos; hace falta elegir qué capacidad se añade en cada paso y medir que aporta algo antes de dar el siguiente. La implantación de la distribuidora tiene tres etapas, y cada una tiene que poder justificarse sola.
La primera etapa es visibilidad y asistencia. Se mide el proceso real con process mining, se conectan los datos imprescindibles, pedidos, existencias, reservas y transporte, y se construye un asistente que investiga los pedidos en riesgo y prepara una propuesta para una persona, que es quien decide y ejecuta. No hay predicción todavía, el riesgo lo marca una regla sencilla, y no hay ejecución automática. Lo que se mide es la calidad del diagnóstico, cuánto tiempo ahorra la investigación y cuántas propuestas aceptan quienes deciden sin cambiarlas, y esa última cifra es la que justifica o no la etapa siguiente.
La segunda etapa es decisión asistida y automatización. Se incorpora el modelo predictivo calibrado, la política pasa del documento a una tabla de decisión, se comparan alternativas con un cálculo sencillo antes de que exista un simulador, y se ejecutan automáticamente las actuaciones de bajo riesgo dentro de los límites de la política, con el motor de proceso de la etapa 5 por debajo. Los casos con incertidumbre o consecuencias relevantes van a supervisión humana. Lo que se mide son los expedientes completados, los errores, los tiempos, el coste por pedido resuelto y, sobre todo, el cumplimiento del plazo prometido frente a la etapa anterior.
La tercera etapa es optimización dinámica, y solo llega cuando la complejidad lo justifica: el gemelo de la operación, el simulador validado y el optimizador que resuelve entre pedidos que compiten por el mismo stock. Aquí el sistema compara actuaciones, anticipa situaciones nuevas y ajusta sus recomendaciones a partir de los resultados medidos y de las evaluaciones controladas de la etapa 8. La evolución no consiste en conceder cada vez más autonomía de manera indiscriminada; consiste en aumentar progresivamente las capacidades del sistema allí donde aportan un valor verificable, y en dejar de añadirlas donde no.
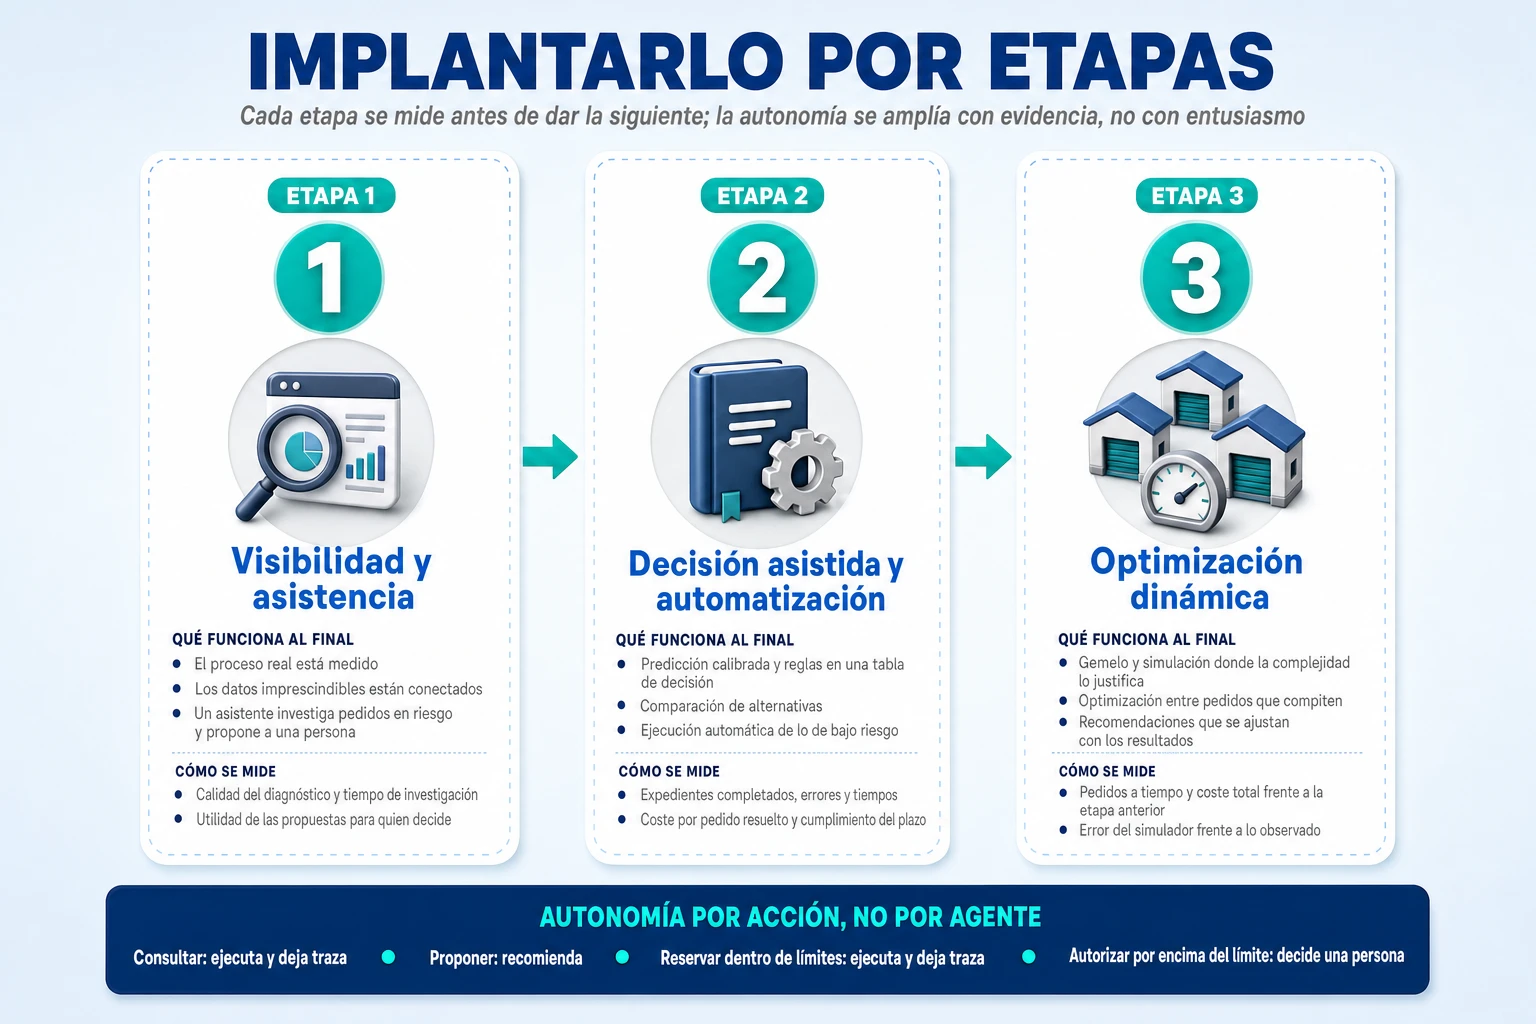
La autonomía, además, no se asigna al agente sino a cada acción del proceso, con la escala de seis niveles que este blog utiliza desde cómo organizar una transformación con agentes de inteligencia artificial: informa, recomienda, prepara, ejecuta y deja traza, ejecuta salvo excepción, opera de forma autónoma. Aplicada al pedido 1846, la tabla queda así, y cada fila sube un nivel solo cuando una medida de la etapa anterior demuestra que el nivel actual no basta.
| Acción del proceso | Nivel de partida | Qué lo sube |
| Consultar pedido, existencias y contexto | 3 · Ejecuta y deja traza | Nada: es lectura |
| Estimar el riesgo y abrir el expediente | 3 · Ejecuta y deja traza | Calibración comprobada durante varios meses, hacia «ejecuta salvo excepción» |
| Proponer la alternativa | 1 · Recomienda | Tasa de propuestas aceptadas sin cambios, hacia «prepara» |
| Reservar y expedir dentro de los límites de la política | 2 · Prepara, y en la segunda etapa 3 · Ejecuta y deja traza | Expedientes completados sin error y sin compensaciones |
| Autorizar un sobrecoste por encima del límite | Lo decide una persona | No sube: es la puerta que da sentido a las demás |
| Avisar al cliente de una entrega dividida | 3 · Ejecuta y deja traza | Reclamaciones asociadas al aviso |
Los errores que más veces lo estropean
Casi ninguno de los errores que estropean estos sistemas se ve en el piloto; todos se ven en el tercer mes de producción, y cada uno tiene una señal temprana más barata que el fallo. Empezar por el agente y no por el proceso: la señal es que nadie en el equipo sabe cuántas variantes tiene el proceso de pedidos ni dónde se va el tiempo. Pedirle al modelo de lenguaje que calcule plazos y costes: la señal son probabilidades con decimales que nadie puede comprobar contra nada. Meter la política de gasto en el prompt: la señal es que cuando la regla cambia hay que reescribir el agente y volver a probarlo todo.
Dejar que el agente ejecute transacciones directamente: la señal es una reserva a medias que nadie sabe deshacer y un almacén que pregunta por qué tiene unidades bloqueadas. Construir un gemelo sin validar la simulación: la señal es que el simulador dice 95 % y la realidad dice 60 %, y nadie lo mira porque la pantalla es bonita. Duplicar todos los datos en una plataforma nueva: la señal es que hay dos cifras de stock disponible para el mismo almacén y cada departamento cree la suya. Poner una aprobación en cada paso: la señal es que todo se aprueba en menos de un minuto, que es lo que el regulador financiero británico encontró en los comités de cambio y lo que la literatura sobre el sesgo de automatización predice.
No atribuir el coste a cada pedido resuelto: la señal es que la factura de modelos sube y nadie sabe qué proceso la causa. Un catálogo de capacidades sin dueño: la señal son tres departamentos con tres agentes de análisis de contratos que dan tres respuestas. Y medir la precisión del agente en vez de los pedidos entregados a tiempo: la señal es un cuadro de mando en el que el agente acierta cada vez más y un cliente que sigue reclamando igual. Los diez comparten una raíz, que es confundir la pieza con el sistema, y los diez se detectan con la pregunta de la etapa 1: qué resultado del negocio estamos midiendo.
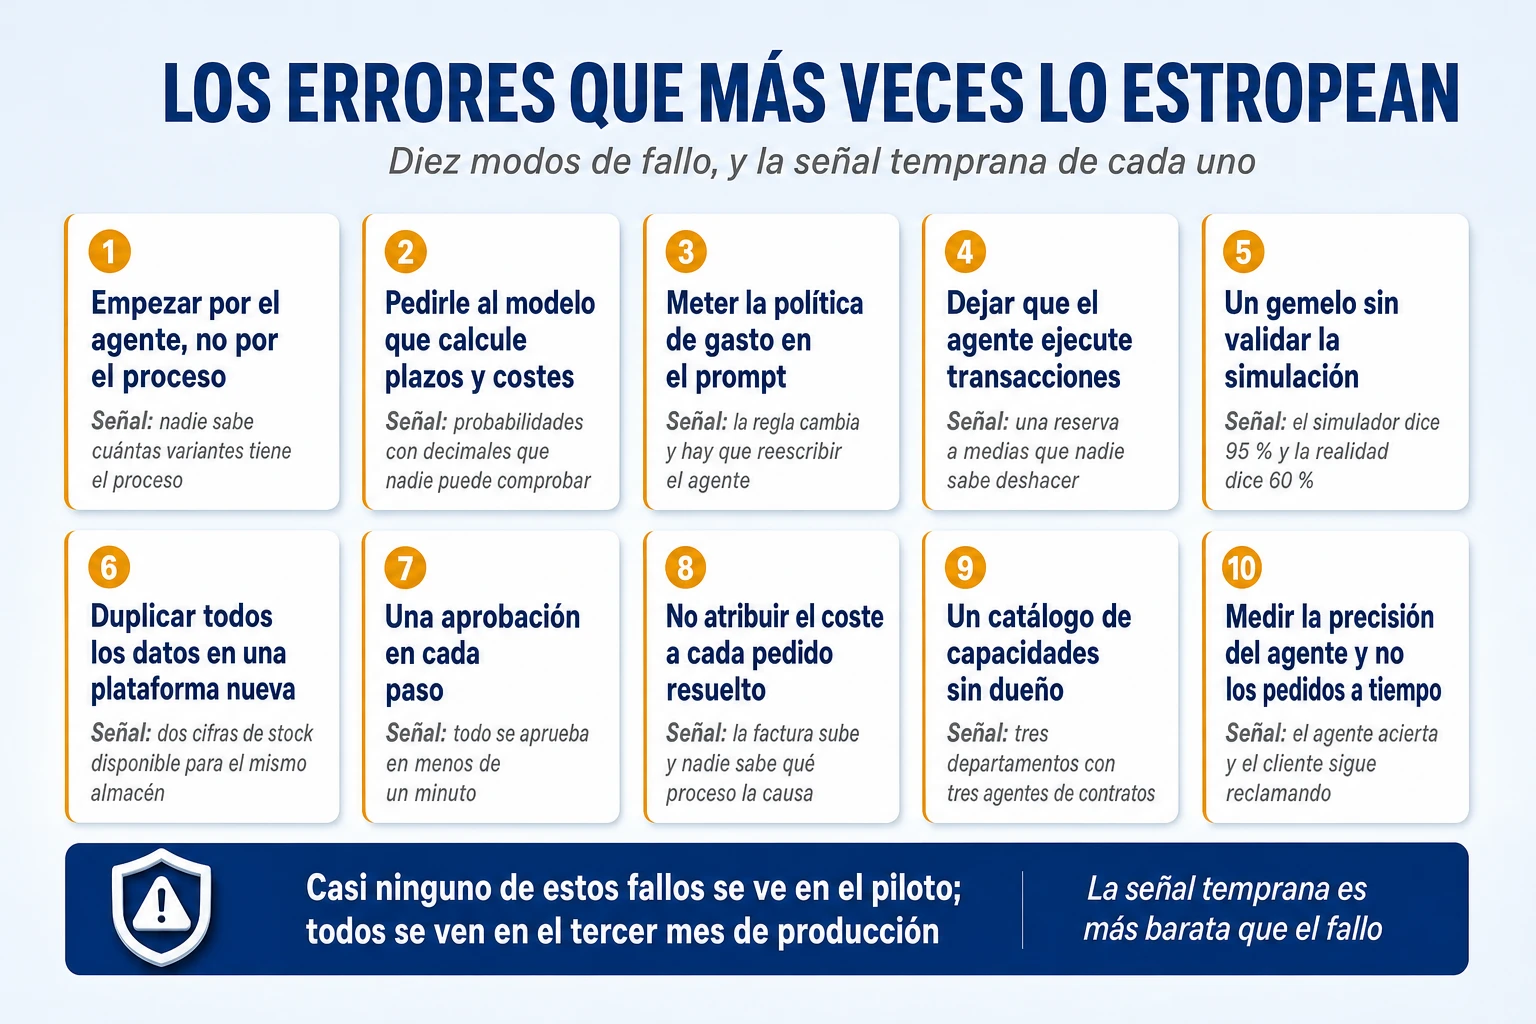
El pedido 1846, antes y después, y el párrafo para la reunión
Volvamos al pedido 1846, que es donde empezó todo. Antes, el cliente reclamaba dos días tarde, Atención al Cliente investigaba en tres sistemas, Logística comprobaba las existencias, Ventas intervenía y varias personas negociaban una solución comprobando por el camino, tres veces, la misma información. Después, un evento abre el expediente a las 9:40 del martes, el sistema reconstruye el contexto, estima el riesgo, compara tres alternativas, comprueba la política, coordina una actuación autorizada, verifica que el pedido se entregó dentro del plazo y registra lo que hace falta para que la próxima vez la predicción esté mejor calibrada y la simulación sea más fiel. Cuando una reserva falla por el camino, el proceso lo detecta, protege lo que ya tenía y pide una decisión nueva con el estado real; cuando el coste supera la política, una persona decide con todo delante.
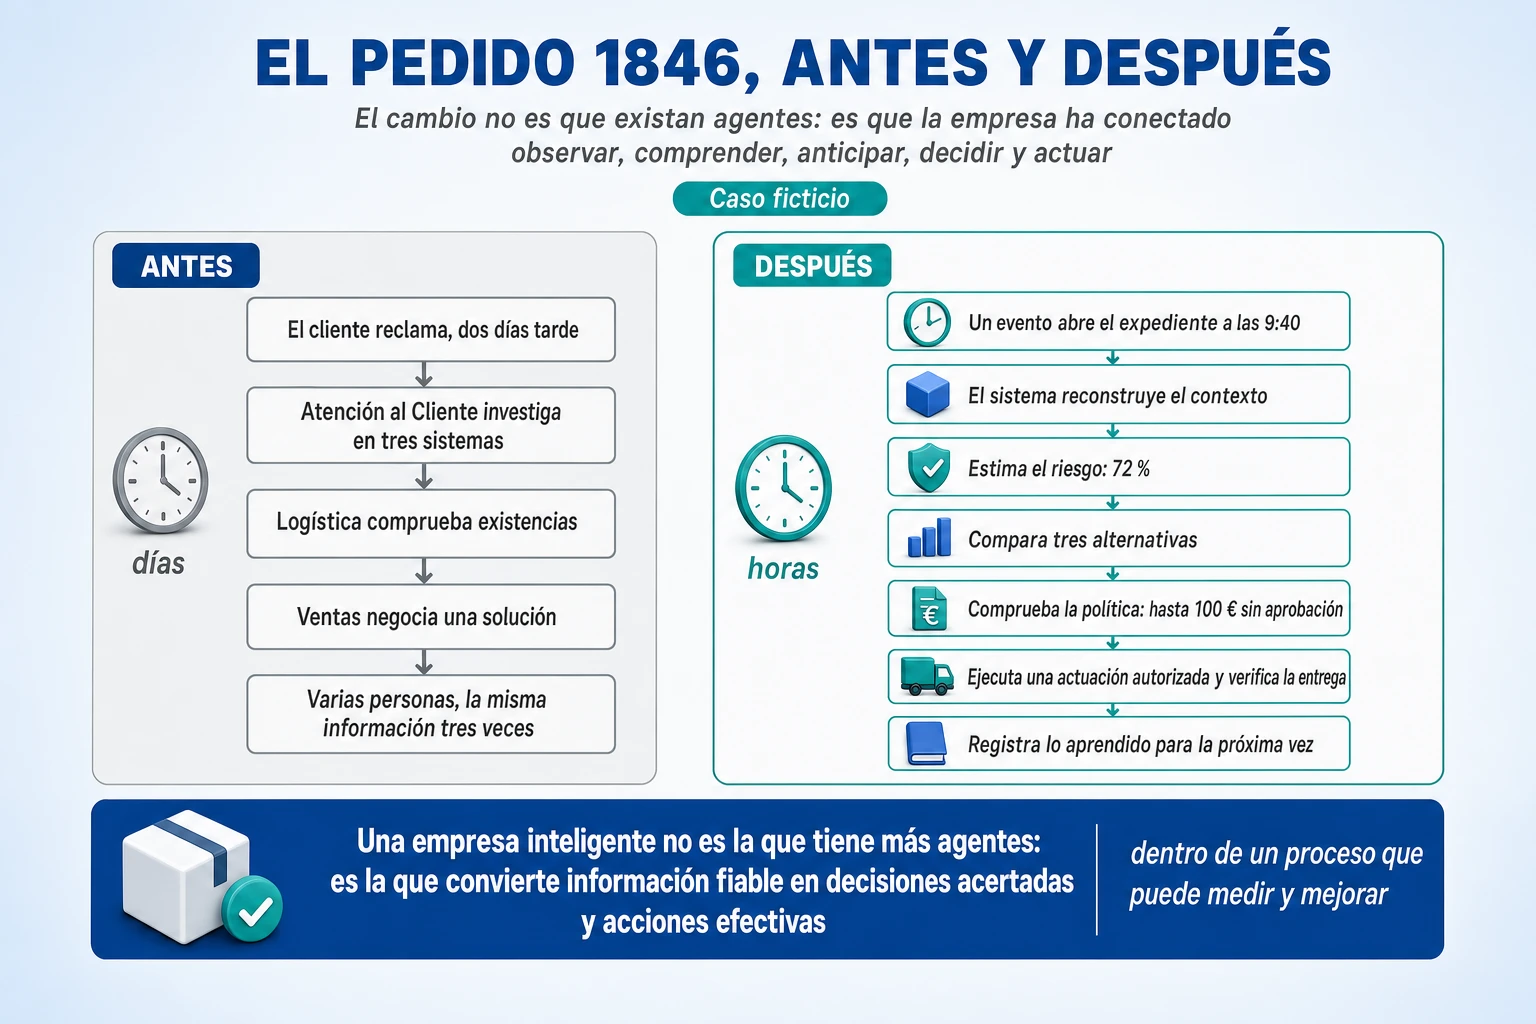
El cambio fundamental no es que ahora existan agentes de IA. Es que la empresa ha conectado su capacidad para observar lo que ocurre, comprenderlo, anticipar problemas, decidir y actuar, y lo ha hecho con piezas que en su mayoría ya tenía o podía tener sin inventar nada: el process mining sobre sus propios eventos, el modelo semántico sobre sus propios datos, un predictor y un simulador que se validan contra la realidad, una tabla de decisión que negocio puede leer, un motor de proceso que no deja nada a medias, y un agente que razona sobre cada caso y propone. El mismo método vale para la resolución de incidencias, la contratación, las reclamaciones, las compras, la planificación de recursos o la gestión de riesgos; la arquitectura concreta variará, y la lógica de diseño será la misma: partir del resultado empresarial, identificar qué capacidades hacen falta, y combinar de manera proporcionada datos, modelos, simulación, agentes, automatización y personas.
Si alguien pregunta en una reunión qué se está construyendo, la respuesta cabe en un párrafo que se puede repetir tal cual:
Estamos construyendo un sistema que detecta un pedido en riesgo antes de que el cliente reclame y lo resuelve con garantías. Primero hemos medido cómo funciona de verdad el proceso de pedidos, no cómo dice el manual. Después hemos conectado los datos de pedidos, existencias, reservas y transporte para que el sistema entienda qué depende de qué. Un modelo predice qué pedidos van a retrasarse, un simulador compara las alternativas con su coste y su probabilidad de cumplir, y una tabla de decisión dice qué está permitido hacer sin preguntar. Un agente de IA investiga cada caso y propone la mejor opción permitida, pero no ejecuta nada. Un motor de proceso reserva, expide, avisa y verifica, y si algo falla a medias lo deshace o pide una decisión nueva. Las personas aprueban solo lo que supera los límites. Y cada pedido cerrado sirve para comprobar que la predicción, la simulación y las decisiones siguen siendo buenas antes de cambiar nada.
Y si hay que justificar por qué merece la pena, la respuesta no está en la tecnología sino en la frase con la que empezó este artículo y con la que conviene terminarlo. Una empresa inteligente no es la que tiene más agentes. Es la que consigue convertir información fiable en decisiones acertadas y acciones efectivas, dentro de un proceso que puede medir y mejorar.
El primer paso no cuesta una licencia: cuesta reconstruir el recorrido real de cien pedidos recientes y mirar dónde estaba el retraso y cuántas veces se comprobó la misma información. Si quiere saber qué piezas de este sistema ya tiene su empresa y cuáles le faltan, hablemos.