
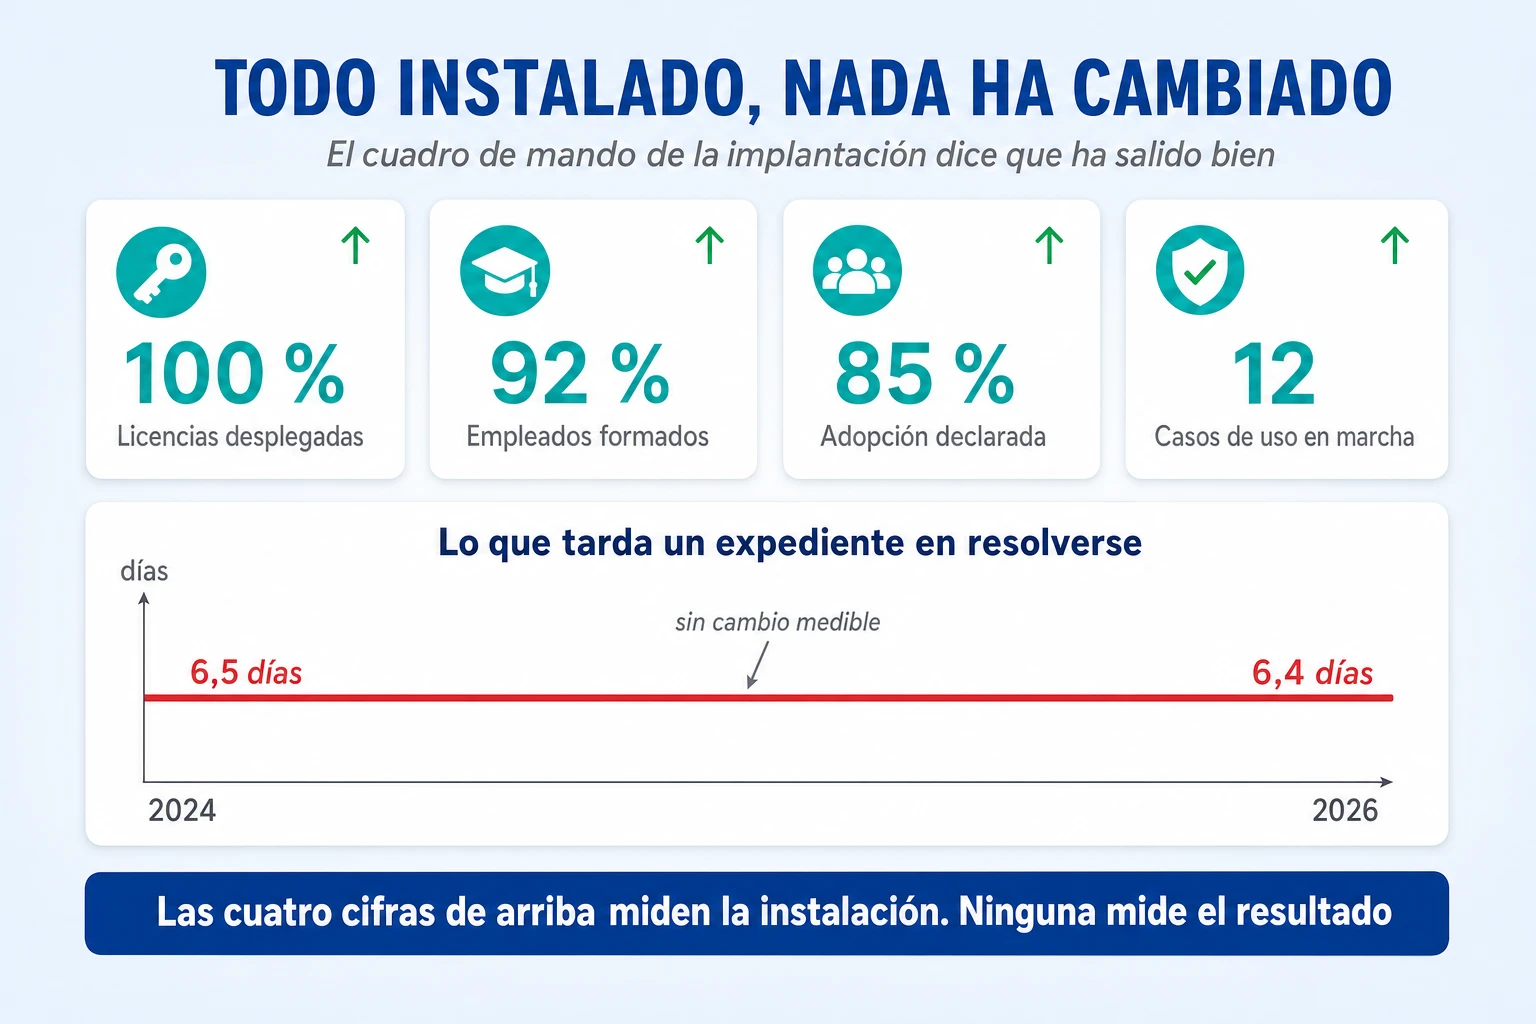
Imagine una empresa de servicios con mil doscientos empleados que ha hecho, una por una, todas las cosas que recomienda cualquier guía de implantación de inteligencia artificial. Compró licencias para toda la plantilla hace dos años. Formó al noventa y dos por ciento de los empleados. Seleccionó doce casos de uso con un comité mixto de negocio y tecnología. Hizo un piloto en atención al cliente que funcionó: los usuarios quedaron contentos, el tiempo de redacción de las respuestas bajó de forma medible y la encuesta interna salió bien. La adopción está hoy en el ochenta y cinco por ciento y la dirección aprobó la segunda fase sin una sola objeción. Y una reclamación de cliente sigue tardando seis días y medio en resolverse, que es exactamente lo que tardaba antes de empezar.
Cuando esto ocurre, la pregunta que se hace el comité de dirección es qué han hecho mal. Y la respuesta incómoda es que no han hecho mal casi nada de lo que se suele vigilar. Las licencias están bien compradas, la formación se dio, el piloto se eligió con criterio, la gente usa la herramienta y nadie ha tenido un incidente de seguridad. Lo que falta no es un paso de la implantación que alguien se saltó: es que la implantación terminó justo donde tenía que empezar el trabajo.
Hay un material que circula mucho entre directivos y que describe bien este fenómeno. Enumera doce señales que, según su autor, matan las transformaciones con inteligencia artificial: la dirección que financia antes de acordar qué es el éxito, los equipos que se quedan en el autocompletado y lo llaman transformación, el piloto que se confunde con una prueba, la adopción que se confunde con el resultado, la seguridad que actúa como puerta en lugar de como socio, el consejo que retira la financiación justo antes de que llegue el retorno. Acierta en lo esencial, que es señalar que el problema no está en el modelo sino en cómo funciona la organización a su alrededor. Pero deja las doce señales como una lista de cosas que vigilar sin decir nunca qué tienen en común.
Tienen algo en común, y es lo único que hace falta entender para que las doce dejen de ser doce consejos y pasen a ser un solo problema de gestión. Cada una de esas señales es el momento en el que una organización aplica el aparato de gestión de una compra a un problema de rediseño.
Conviene detenerse en qué significa eso, porque los dos aparatos son reconocibles y cualquiera que haya pasado por un comité de inversiones sabe distinguirlos. Una compra tiene precio, fecha de entrega, instalación, formación, usuarios activos y un proyecto que se cierra con un acta. Un rediseño tiene línea base, un dueño del proceso que responde del resultado, un reparto nuevo de tareas y de decisiones entre personas y máquinas, controles dentro del flujo en lugar de revisiones al final, un mecanismo explícito para convertir la mejora en dinero y una operación que no se cierra nunca. No son dos estilos de gestionar lo mismo. Son dos formas distintas de aprobar, de medir, de probar, de escalar y de financiar, y cada una produce un tipo de pregunta distinto en el comité.
Lo que ocurre con la inteligencia artificial es que se tramita casi siempre con el primero de los dos. Y el primero funciona: la herramienta se compra bien, se instala bien, se usa y se adopta. El resultado no llega porque el resultado nunca estuvo dentro de la herramienta. De ahí la frase que resume todo lo que viene después: la inteligencia artificial no se implanta en una empresa, se implanta en un proceso. Quien compra al nivel de la herramienta y espera el resultado al nivel de la cuenta de resultados se ha dejado sin hacer la pieza intermedia, que es la única que produce valor.
Este artículo trata de los errores que hacen que eso ocurra, y lo hace en tres movimientos. El primero es el diagnóstico: qué dicen de verdad los datos sobre lo que está pasando en las empresas, por qué la discusión sobre si fracasa el noventa y cinco por ciento o acierta el cinco es una discusión sobre denominadores, y en qué se diferencian exactamente los dos aparatos de gestión. El segundo recorre los errores agrupados por su mecanismo, no por el orden en que suelen aparecer en las listas, desde el que decide dónde se pone la tecnología hasta el que decide si el ahorro llega a alguna parte. Y el tercero es el que más va a servir en un comité: qué hacer el lunes, quién responde de cada cosa y cómo leer la próxima cifra que le pongan delante.
Los errores al implantar IA: causas comunes y diferentes responsabilidades
Las listas de errores tienen un problema que no se ve hasta que se intenta usarlas: ponen en fila cosas que no son del mismo tipo. En la de las doce señales conviven una decisión de dirección que se toma una vez al año en un comité de inversiones, una decisión de diseño que se toma cada vez que se aborda un proceso, una práctica de ingeniería que depende del equipo que lo construye y una política de seguridad que depende de un área que no participa en ninguna de las tres anteriores. Puestas en fila parecen doce tareas de la misma clase; en realidad tienen dueños distintos, calendarios distintos y consecuencias de magnitud muy distinta.
Agruparlas por su naturaleza cambia bastante la lectura. Las que afectan a la dirección y al resultado —qué se considera éxito, qué se mide y cómo se lee la curva de inversión— determinan si se está resolviendo el problema correcto, y si están mal no hay ejecución que lo arregle. Las que afectan al rediseño del trabajo —dónde se pone la tecnología, cuánta autonomía se le da, qué pasa con quien hacía antes esa tarea— determinan si existe valor que capturar. Las de industrialización —cómo se prueba, con quién, durante cuánto tiempo y cómo se lleva a la segunda área— determinan si lo que funcionó una vez se vuelve una capacidad de la empresa. Y las de control y gobierno determinan si todo lo anterior se puede sostener sin un incidente que lo pare.

Hay además tres afirmaciones de ese material que no conviene aceptar tal cual, y vale la pena dejarlas dichas desde el principio porque las tres aparecen una y otra vez en presentaciones de comité. La primera es que hay que pasar de copilotos a agentes que ejecuten, como si la autonomía fuera una etapa de madurez. No lo es: es una decisión de diseño que depende del riesgo, de la variabilidad del caso y de lo que cuesta un error, y más adelante se verá que los sistemas que de verdad funcionan en producción están deliberadamente lejos del extremo autónomo. La segunda es que hay que esperar cuatro sprints antes de fiarse de un resultado. El número es arbitrario: en un proceso que trata diez mil operaciones por semana habrá evidencia de sobra en quince días, y en un cierre contable trimestral cuatro sprints no llegan a cubrir un solo ciclo real. La tercera es la lectura del porcentaje de empresas que tienen éxito, que no significa lo que parece y que merece el apartado siguiente.
Por eso este artículo no recorre las doce señales una por una. Las agrupa por el mecanismo que las produce, les añade cinco que faltan en la lista original y que en la práctica cuestan tanto o más que las doce, y deja para el final una sola tabla que las mapea todas con su dueño y con la pregunta que las detecta. Quien quiera la lista cerrada la tiene allí. Lo que viene antes es la explicación de por qué ocurren, que es lo que permite anticiparlas en una empresa concreta en lugar de reconocerlas cuando ya han pasado.
La brecha entre la adopción de IA y los resultados empresariales
Antes de entrar en los errores hay que saber qué tamaño tiene el problema, y eso exige atravesar un campo minado de cifras que no significan lo que parecen. La buena noticia es que hay una sola idea que ordena todas: la discusión sobre si fracasa el noventa y cinco por ciento o acierta el cinco es, casi siempre, una discusión sobre denominadores. Y cuando se obliga a cada cifra a declarar el suyo, todas las mediciones serias terminan diciendo lo mismo, que es bastante más útil que cualquiera de los dos titulares: la adopción corre muy por delante del resultado.
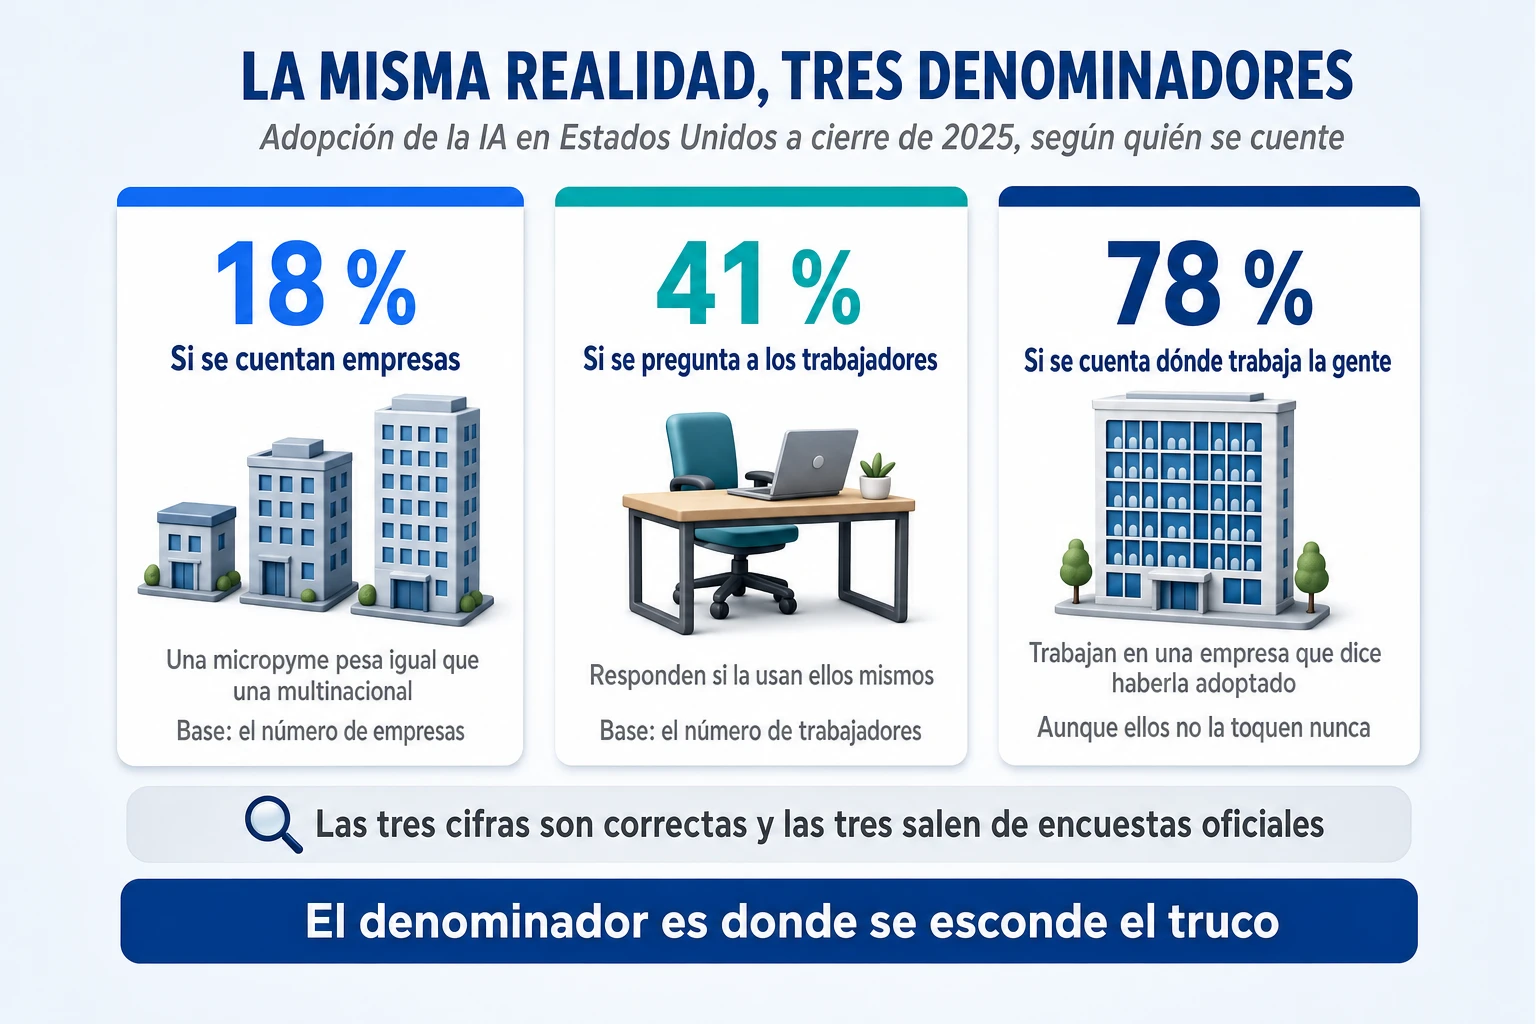
La demostración más limpia de hasta qué punto el denominador decide el titular la publicó la Reserva Federal estadounidense en abril de 2026, y debería estar impresa en la primera página de cualquier presentación de comité. A cierre de 2025, la adopción de inteligencia artificial en Estados Unidos era del dieciocho por ciento si se contaban empresas, del cuarenta y uno por ciento si se preguntaba a los trabajadores si la usaban ellos, y del setenta y ocho por ciento si se contaba cuánta gente trabaja en una empresa que dice haberla adoptado. Los tres números son correctos y proceden de encuestas oficiales. Miden cosas distintas: en el primero una micropyme pesa lo mismo que una multinacional, y el tercero no dice que el setenta y ocho por ciento de los trabajadores use inteligencia artificial, sino que trabajan en una empresa que declara haberla adoptado, aunque ellos no la toquen nunca.
Esa diferencia entre lo que la empresa declara y lo que la gente hace tiene nombre y tamaño. Gallup la llama el desfase entre integración y adopción, y en mayo de 2026 la medía así: el cuarenta y siete por ciento de los empleados estadounidenses decía que su organización había integrado inteligencia artificial, el treinta por ciento la usaba con regularidad semanal y solo el quince por ciento a diario. El dato más revelador, sin embargo, es otro, porque se refiere únicamente a quienes ya trabajan en una empresa que la ha integrado: solo el catorce por ciento está muy de acuerdo con que haya transformado cómo se hace el trabajo. Es decir, que incluso dentro de las empresas que la han metido de verdad, siete de cada ocho empleados no reconocen un cambio en su forma de trabajar. Conviene añadir que todo esto es autodeclarado y que el tamaño de la empresa cambia mucho el resultado, pero la dirección del hallazgo es difícil de discutir.
La pregunta siguiente es cuánta productividad hay detrás de esa adopción, y aquí es donde hay que bajar las expectativas que traen las presentaciones comerciales. La estimación más sólida que existe para Europa no habla de dos dígitos: el Banco de Pagos Internacionales, cruzando la encuesta de inversión del Banco Europeo de Inversiones con los estados financieros de más de doce mil empresas no financieras entre 2019 y 2024, cifra en un cuatro por ciento el aumento de la facturación por empleado asociado a adoptar inteligencia artificial, y lo concentra en las medianas y grandes. Hay que leer esa cifra con tres cautelas que los propios autores subrayan. Es un efecto de una sola vez y no una tasa anual que se repita cada ejercicio. Mide facturación por empleado, que no es lo mismo que valor añadido. Y la pregunta de la encuesta, vigente desde 2019, no se refiere a la inteligencia artificial generativa sino a un conjunto más amplio que incluye analítica de datos y automatización. Como orden de magnitud para construir un caso de negocio, sin embargo, es lo mejor que hay.
Donde esto se vuelve incómodo es al comparar el tiempo que la gente dice ahorrar con lo que ocurre después en la cuenta de resultados. La Reserva Federal de San Luis sitúa en el 2,2 por ciento de las horas trabajadas el ahorro que los propios empleados estadounidenses se atribuyen en el segundo trimestre de 2026, frente al 1,6 por ciento de finales de 2024: es autodeclarado y está calculado sobre todas las horas trabajadas, no solo sobre las de quienes usan la herramienta. Y hay un estudio que permite ir más allá de la declaración, porque enlaza encuestas con registros administrativos. Humlum y Vestergaard cruzaron respuestas de veinticinco mil trabajadores de siete mil centros de trabajo daneses, en once ocupaciones muy expuestas, con los datos oficiales de nóminas y horas. Los adoptantes declaran ahorrar en torno al tres por ciento de su jornada. El efecto medido sobre salarios y horas es un cero preciso: el estudio descarta efectos superiores al dos por ciento dos años después de la aparición de ChatGPT. Los propios autores resumen lo que sí se mueve de una forma que vale para todo este artículo: lo que cambia es la estructura del trabajo, no las horas ni los salarios.

Queda por desmontar la cifra que más circula, que es la del porcentaje de empresas que lo consiguen, y el desmontaje tiene un remate difícil de mejorar. El «solo el cinco por ciento genera valor con inteligencia artificial» procede de un estudio de BCG con mil doscientos cincuenta directivos de sesenta y ocho países, y su apéndice aclara lo que el titular esconde: ese cinco por ciento no es una medición de valor cobrado, sino el tramo superior de una puntuación de madurez que los propios encuestados se asignan sobre cuarenta y una capacidades, referida además al área que cada uno conoce mejor y no siempre a la empresa entera. El remate es que la misma consultora publicó a finales de septiembre de 2026 su edición siguiente, y ahí ese grupo ha pasado del cinco al siete y medio por ciento y el de los que están escalando con retorno, del treinta y cinco al cuarenta y uno. Quien hoy pone «solo el cinco por ciento» en una diapositiva está citando un dato que el propio emisor revisó hace dos semanas, y que se ha movido casi un cincuenta por ciento en un año sin que haya cambiado nada comparable en la economía real. Eso no es una medición del éxito: es un termómetro de optimismo directivo.
Su imagen especular, el célebre noventa y cinco por ciento de pilotos que fracasan, resiste todavía menos. El informe del que sale se presenta a sí mismo como hallazgos preliminares, se construyó sobre medio centenar de entrevistas y unos ciento cincuenta cuestionarios recogidos en congresos, y define el éxito como que alguien de la empresa haya comentado que hubo impacto. Lo que sí mide, y está en el documento, es un embudo de sistemas hechos a medida: se evalúan muchos, se pilotan bastantes menos y llegan a producción pocos. Y el mismo informe reconoce que cerca del cuarenta por ciento de las organizaciones tiene desplegadas herramientas genéricas que sí usa. Las dos cifras que más se citan en los dos bandos de este debate son autodeclaraciones blandas, y las dos se mueven cuando cambia el humor del sector. Lo que no se mueve es lo que está medido contra registros: un efecto de un solo dígito en productividad, un cero en salarios y horas, y una gran mayoría de empleados que no reconoce un cambio en su trabajo.
De todo esto sale una regla de higiene que merece la pena aplicar a cualquier cifra sobre inteligencia artificial empresarial, incluidas las de este artículo: desconfíe de toda cifra cuyo denominador no esté explícito. Y sale también la conclusión que de verdad importa, que no es un porcentaje. La distancia relevante no está entre las empresas que tienen éxito y las que fracasan, porque casi todas están en el mismo sitio. Está entre instalar y rediseñar. Y como esas dos cosas se aprueban, se prueban, se miden y se financian de forma distinta, conviene ver en qué se diferencian exactamente.
Comprar una herramienta y rediseñar un trabajo son dos proyectos distintos
La diferencia entre los dos aparatos de gestión se nota en seis momentos concretos, y merece recorrerlos uno a uno porque cada uno produce, cuando se equivoca, una de las señales de la lista. No es una metáfora: es que la pregunta que se hace en cada momento determina qué información se pide, quién la trae y qué se decide con ella.
El primer momento es la aprobación. En una compra se aprueba un presupuesto contra un plazo, y el debate del comité es si el precio es razonable y si el proveedor es fiable. En un rediseño se aprueba un resultado con un dueño, y el debate es otro mucho más incómodo: a quién le va a empeorar un indicador para que mejore el conjunto. Ese es el verdadero contenido del alineamiento de la dirección, y por eso tantas iniciativas lo dan por hecho cuando no existe. Imagine una compañía que quiere reducir un treinta por ciento el tiempo de resolución de reclamaciones. Operaciones quiere bajar el coste por caso, comercial quiere subir la satisfacción, finanzas exige retorno dentro del ejercicio, tecnología quiere aprovechar para unificar plataformas y riesgos quiere conservar las validaciones que ya tiene. Las cinco prioridades son legítimas y las cinco llevan a diseños distintos e incompatibles entre sí. La señal de que la dirección está alineada no es que todos hayan asentido en una presentación, sino que son capaces de decidir qué validación desaparece, qué responsabilidad cambia de sitio y qué indicador departamental se va a dar por bueno aunque empeore. Si esa conversación no se ha tenido, el proyecto está financiado pero no está dirigido, y vale la pena recordar que esa discusión pertenece al trabajo previo al arranque, no a la primera revisión de avance.
El segundo momento es el entregable. Una compra entrega una herramienta instalada y la prueba de que está instalada es que la gente entra en ella. Un rediseño entrega el trabajo repartido de otra manera, y eso incluye cosas que no se instalan: tareas que desaparecen, decisiones que cambian de nivel, excepciones que ahora tienen un camino definido y traspasos entre equipos que se escriben de nuevo. La consecuencia práctica de confundirlos es la señal del techo del copiloto. Cuando el entregable es una herramienta, el proyecto termina de forma natural en el momento en que la herramienta funciona, y nadie tiene el encargo de preguntarse qué pasos del proceso sobran ahora. El resultado es una organización que hace exactamente lo mismo que antes, un poco más deprisa en algunos sitios.
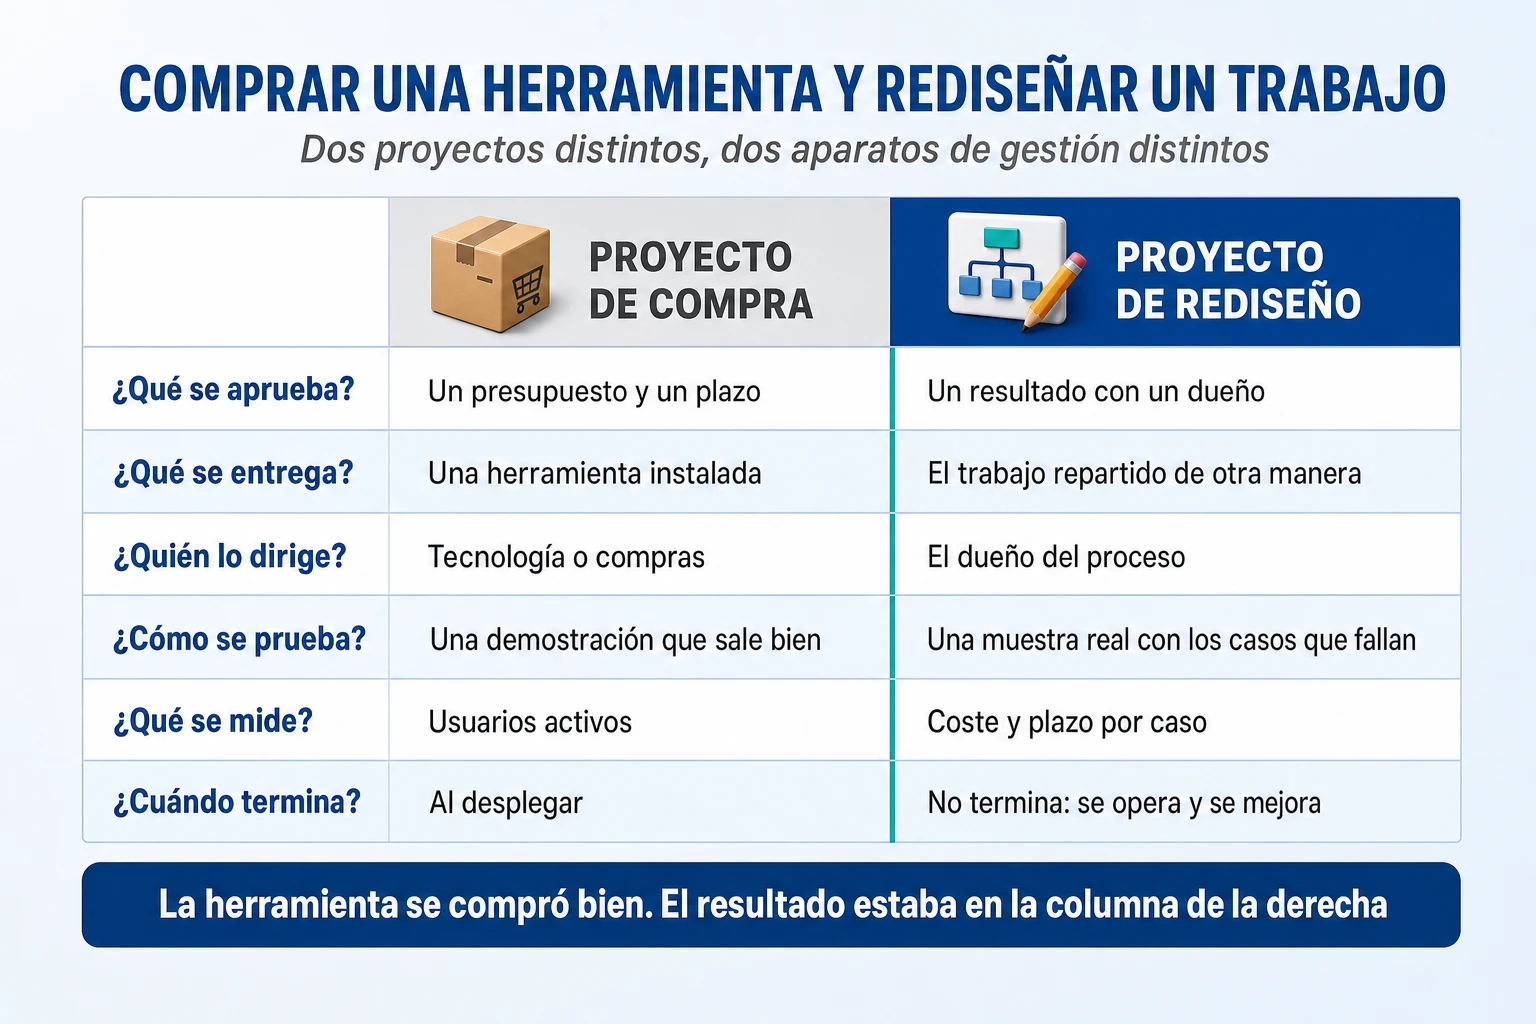
El tercer momento es quién dirige. Una compra la puede dirigir tecnología o el área de compras, porque lo que hay que gestionar es un contrato y un despliegue. Un rediseño lo tiene que dirigir quien responde del resultado del proceso de punta a punta, porque las decisiones que hay que tomar son suyas: qué se deja de hacer, qué pasa a una máquina, qué se queda con una persona y quién responde cuando el sistema se equivoca. Aquí está el matiz que corrige otra de las señales de la lista, la que pide poner a los dos o tres mejores profesionales en la primera prueba. El consejo es bueno y está incompleto, porque el equipo que necesita un rediseño no es el de los tres mejores programadores: es el que reúne conocimiento profundo del proceso y de sus excepciones, capacidad para rediseñar operaciones, arquitectura y datos, gestión del cambio y evaluación económica. Y hay un riesgo que el consejo original no menciona: si la solución funciona solo porque la sostienen tres personas excepcionales, no es una capacidad de la empresa, es una dependencia. La prueba definitiva de un rediseño es que pueda operarse, mantenerse y evolucionar sin sus creadores.
El cuarto momento es cómo se prueba. Una compra se prueba con una demostración que sale bien, y sale bien por construcción, porque el proveedor elige el caso. Un rediseño se prueba con una muestra representativa que incluye a propósito los casos difíciles, los datos incompletos y las excepciones que en la demostración nunca aparecen. Es una diferencia de propósito, no de rigor: la demostración quiere enseñar que puede funcionar y la prueba quiere descubrir cuándo deja de funcionar. Esto tiene consecuencias suficientes como para merecer su propio apartado más adelante, pero la idea mínima es que confundir las dos cosas no es un error de método, es haber hecho una prueba que no contesta la pregunta que importa.
El quinto momento es qué se mide, y probablemente sea donde más dinero se pierde. Una compra se mide en usuarios activos porque eso es exactamente lo que se compró: acceso. Un rediseño se mide en coste y plazo por caso, porque eso es lo que se quiso cambiar. Cuando el cuadro de mando de una iniciativa de inteligencia artificial está lleno de porcentajes de adopción, lo que la empresa está vigilando es el despliegue de un producto, no el rendimiento de un proceso, y los dos pueden ir en direcciones opuestas durante mucho tiempo sin que nadie lo note.
El sexto y último momento es cuándo termina. Una compra termina al desplegar y se cierra con un acta. Un rediseño no termina: se opera, se mide, se corrige y se vuelve a diseñar cuando cambian las condiciones. De ahí salen dos de las señales a la vez. La de escalar antes de codificar, porque un proyecto que se cierra no deja detrás componentes reutilizables y obliga al segundo equipo a reaprender lo que el primero ya resolvió. Y la de leer mal la curva de inversión, porque un proyecto que se cierra tiene precio y un rediseño tiene además un coste de aprendizaje que se paga antes de que aparezca el beneficio. Quien aprueba con el calendario de una compra retira la financiación justo cuando el gasto es máximo y el retorno todavía no se ve, que es lo que le ocurre a casi cualquier rediseño en su primer año.
Puestas así, las doce señales dejan de ser doce. Son seis decisiones de gestión mal planteadas que se manifiestan en doce sitios distintos. Y eso cambia la pregunta que hay que hacerse: no es qué errores vigilar, sino con qué aparato se está tramitando esto. Lo que viene a continuación recorre esas decisiones por orden de impacto, empezando por la única que tiene detrás un experimento capaz de aislar la variable.
El mapping problem: cómo descubrir nuevas oportunidades de IA aprendiendo de otras empresas
Casi todo lo que se publica sobre inteligencia artificial en empresas compara organizaciones que se parecen poco, con tecnologías distintas, en momentos distintos y midiendo cosas distintas, de modo que cuando una gana nunca se sabe por qué. Hay una excepción que merece conocerse, porque hace lo contrario: da a todos exactamente lo mismo y cambia una sola cosa. Y la única cosa que cambia no es tecnológica.
El estudio lo firman Kim, Kim y Koning con quinientas quince empresas jóvenes de alto crecimiento del laboratorio de inteligencia artificial de INSEAD, todas dentro del mismo programa y con el mismo acceso a la tecnología, y asignadas al azar a dos grupos. Lo único que se sorteó fue la información: al grupo de tratamiento le dieron casos de cómo otras empresas habían reorganizado su forma de producir alrededor de la inteligencia artificial, y al de control, formación de emprendimiento general. Diez semanas después, las que habían visto esos casos habían descubierto un cuarenta y cuatro por ciento más de usos para la tecnología, completado un doce por ciento más de tareas, tenían un dieciocho por ciento más de probabilidad de haber conseguido su primer cliente de pago y facturaban casi el doble que el grupo de control. Y hay un resultado adicional que llama la atención en sentido contrario al esperado: su demanda de capital externo bajó casi un cuarenta por ciento, con la plantilla sin cambios.

Antes de extraer conclusiones hay que poner los límites, porque es un hallazgo tan cómodo para la tesis de este artículo que da pudor usarlo sin cautelas. No son empresas establecidas: la mediana se había fundado el año anterior y tenía equipos de cuatro personas, en un programa de aceleración, de modo que extrapolar el multiplicador de facturación a una compañía de dos mil empleados no está respaldado por el estudio. Ese multiplicador, además, es un cociente entre dos cifras pequeñas —el único caso que los autores describen con detalle pasó de cero a cuarenta mil dólares en las diez semanas—, y los propios investigadores advierten de que la ganancia se concentra en el decil superior: la inteligencia artificial sube el techo de lo que consiguen las mejores más que el suelo de las demás. Lo que sí viaja bien a una empresa grande no es la magnitud, es el diseño del experimento: cuando la tecnología y el acceso son los mismos y aun así unos obtienen resultados y otros no, la diferencia no puede estar en la tecnología.
Lo que estaba en juego en ese experimento tiene un nombre poco glamuroso: el mapa del proceso. Saber qué hace la empresa, en qué orden, quién espera a quién y dónde se pierde el tiempo es la capacidad escasa, y es escasa precisamente porque nadie la vende. Los proveedores venden modelos, licencias y formación en herramientas, que son las tres cosas que el grupo de control ya tenía. Nadie vende el conocimiento de dónde encaja la tecnología en el flujo concreto de una empresa concreta, entre otras cosas porque solo existe dentro de ella, repartido entre la gente que hace el trabajo.
La consecuencia práctica es incómoda para la forma en que está montado el presupuesto de casi cualquier programa. Cuando se reparte el dinero entre licencias, infraestructura y formación, la partida de formación se gasta casi siempre en enseñar a usar la herramienta: cómo escribir una instrucción, qué hace cada botón, qué no conviene pegar en un chat. Eso es necesario y es exactamente lo que el grupo de control ya había recibido. Lo que marcó la diferencia fue mucho más barato y nadie lo presupuesta: ejemplos concretos de cómo otros reorganizaron el trabajo, y horas protegidas para que la gente dibuje su propio proceso y decida dónde encaja. En una empresa de cincuenta personas eso cabe en dos talleres; en una de cinco mil es un programa, pero sigue costando una fracción de lo que cuestan las licencias que ya están pagadas.
Queda una lectura de segundo orden que no hay que perder, porque explica por qué este error es tan persistente. Dar acceso a la tecnología es una decisión que se toma una vez, se ejecuta en semanas y se puede demostrar con una captura del panel de administración. Rediseñar el trabajo es una decisión que hay que tomar proceso a proceso, con la gente que lo hace, y cuyo resultado no se puede enseñar en un comité hasta mucho después. Entre dos caminos que llevan al mismo sitio, las organizaciones eligen sistemáticamente el que se puede demostrar antes. Por eso casi todas las empresas tienen la herramienta y casi ninguna tiene el mapa.
Dónde se va el tiempo de un proceso: Cuellos de botella, esperas y retrabajos: dónde está el verdadero potencial de mejora
De todos los errores de la lista, el que más dinero cuesta es el que parece más técnico: automatizar lo que se puede en lugar de lo que limita. Y no es una cuestión de criterio sino de aritmética. Si una actividad ocupa una fracción pequeña del plazo total de un proceso, mejorarla mucho mejora el plazo total muy poco, por espectacular que sea la mejora de esa actividad. Automatizar bien el paso equivocado produce una mejora real, medible, demostrable en comité, y ningún efecto en el resultado que la empresa quería cambiar.
Eso tiene nombre desde hace casi sesenta años y conviene usarlo, porque convierte una intuición de gestión en un límite que no se puede discutir. Gene Amdahl lo enunció en 1967 pensando en ordenadores: la mejora total que se puede obtener acelerando una parte está limitada por la fracción del tiempo que ocupa esa parte. Si un tramo es el ocho por ciento del plazo, hacerlo instantáneo —no más rápido: instantáneo— mejora el plazo un ocho por ciento como máximo. Y hay un segundo resultado, la ley de Little, que añade la pieza que casi nadie tiene en cuenta: el plazo de un proceso es el trabajo en curso dividido por el ritmo al que sale. De ahí sale la consecuencia más contraintuitiva de todo este artículo: una herramienta que permite generar más solicitudes, más borradores o más casos sin aumentar el ritmo al que el proceso los termina no acorta el plazo, lo alarga. Es exactamente lo que ocurre cuando se da capacidad de producción a la entrada de un proceso cuyo cuello de botella está en la aprobación.
Aquí circula una cifra muy cómoda que conviene no usar: la de que el trabajo está esperando entre el ochenta y cinco y el noventa y cinco por ciento del tiempo. La idea que hay detrás es buena y la métrica es sólida —eficiencia de flujo, es decir, tiempo efectivamente trabajado dividido entre el plazo total—, pero ese número concreto se cita de artículo en artículo sin un estudio detrás, y no conviene llevarlo a un comité. La buena noticia es que el argumento no necesita el número: necesita que usted lo mida en su propio proceso, que hoy es barato, y a continuación hay suficiente evidencia medida para saber qué va a encontrar.
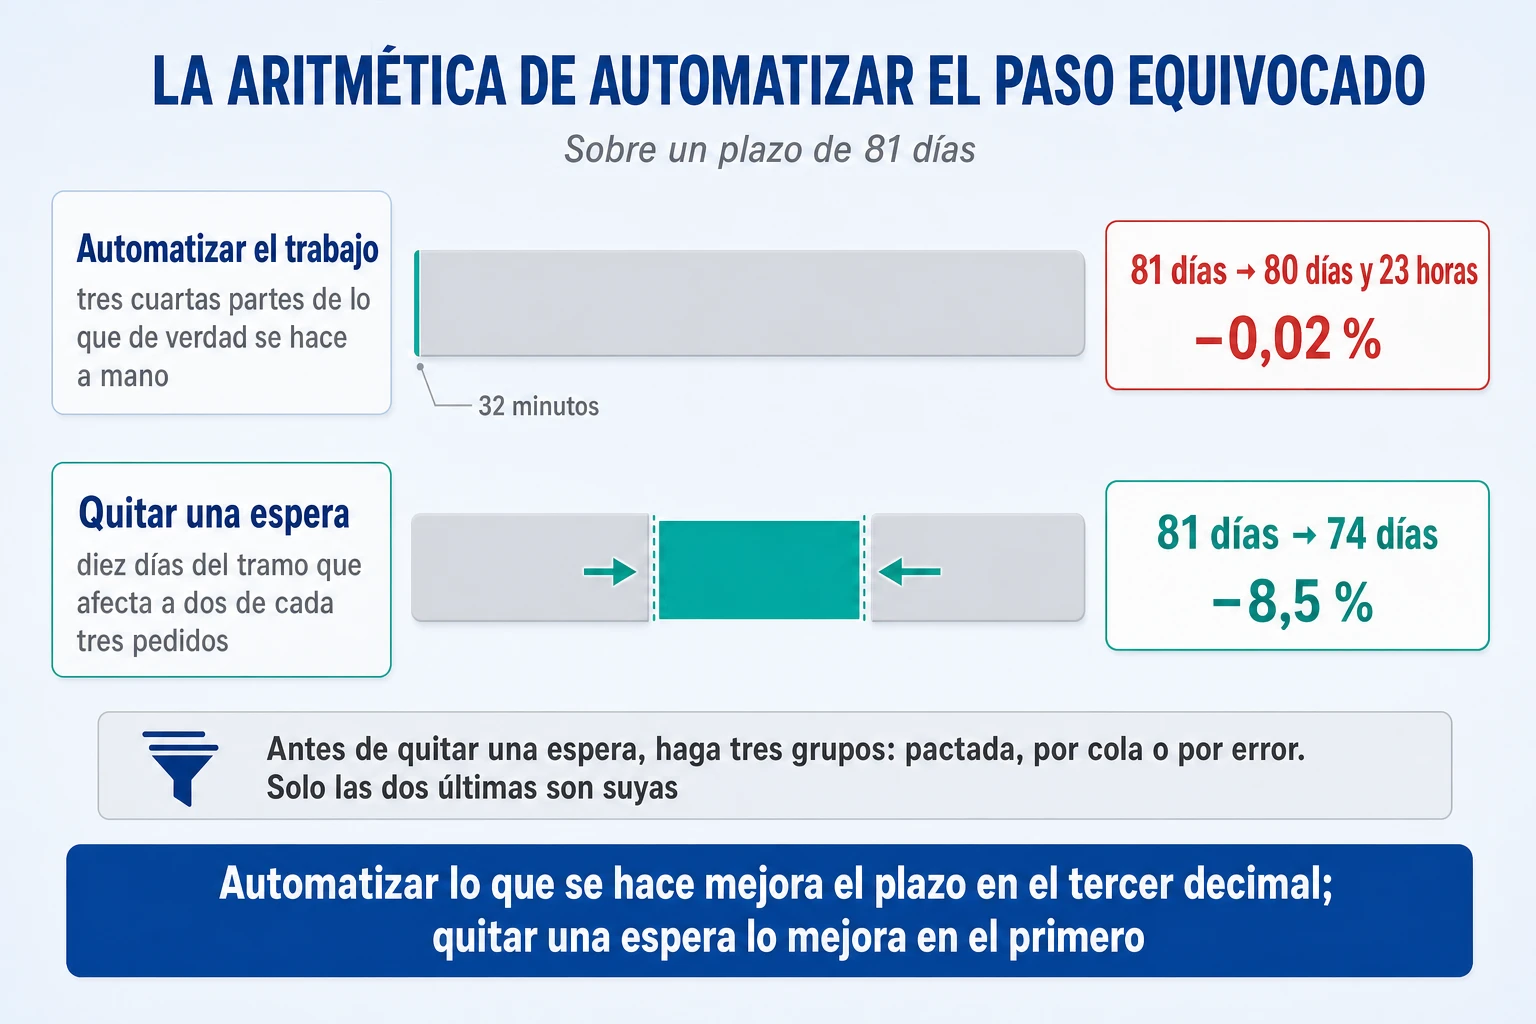
Existe un proceso de compra a pago medido de verdad y público, que es el que mejor enseña el mecanismo. Son doscientas cincuenta y una mil líneas de pedido de una multinacional, con un millón y medio de eventos registrados en su sistema de gestión, cedidas para un reto académico abierto de minería de procesos. El plazo medio de un pedido completo es de ochenta y un días. Cada línea deja algo más de seis eventos registrados, de modo que lo que alguien hace de verdad son unos pocos minutos de registro repartidos a lo largo de esos ochenta y un días. En el grupo mayoritario de pedidos, entre registrar la factura y liquidarla pasan cuarenta y cinco días en el sesenta y nueve por ciento de los casos. Y la proporción de actividades ejecutadas automáticamente es del ocho y medio por ciento.

Antes de sacar la conclusión fácil hay que decir lo que ese dato no demuestra, porque lo honesto es también lo más útil. Los propios autores advierten de que un plazo largo hasta el pago no se puede juzgar sin compararlo con las condiciones de pago pactadas: esos cuarenta y cinco días pueden ser exactamente el plazo acordado con el proveedor, es decir, una espera deliberada y no un desperdicio. El registro tampoco separa tiempo de trabajo efectivo de tiempo de calendario, así que de aquí no sale ningún reparto limpio entre ejecución y espera. Lo que sí sale, y es lo que importa, es que en un proceso administrativo real el plazo vive en los huecos entre los eventos, no en la duración de los eventos.
Con un solo supuesto declarado se ve el tamaño del malentendido. Pongamos que cada uno de esos seis eventos cuesta cinco minutos de persona, que es generoso para un registro administrativo. Son treinta y dos minutos de trabajo humano repartidos a lo largo de ochenta y un días: tres centésimas de uno por ciento del plazo. Automatizar el setenta y cinco por ciento de ese trabajo ahorra veinticuatro minutos y deja el plazo en ochenta días y veintitrés horas. Quitar diez días del tramo de espera de cuarenta y cinco, el que afecta a dos de cada tres pedidos, lo baja un ocho y medio por ciento. Automatizar tres cuartas partes de lo que de verdad se hace mejora el plazo en el tercer decimal; quitar una espera lo mejora en el primero. El supuesto de los cinco minutos es mío y se puede discutir; lo que no cambia al discutirlo es el orden de magnitud, porque haría falta multiplicarlo por cien para que la conclusión se moviera.
La conclusión correcta de esto no es «elimine las esperas», que sería otra consigna sin criterio y además puede salir cara. Parte de esos cuarenta y cinco días es el plazo de pago pactado con el proveedor, y pagar antes empeora la caja sin mejorar nada. Lo que hay que hacer es clasificar cada hueco en tres clases —espera pactada, espera por cola y espera por error— e ir solo a las dos últimas. La pactada se negocia o se deja en paz; la de cola es un problema de capacidad o de reglas de asignación; y la de error es la que de verdad interesa, porque es trabajo que ya se hizo y hay que volver a hacer.
Esa observación no es nueva y vale la pena saber de dónde viene, porque explica por qué llevamos décadas tropezando con lo mismo. En 1990, en el artículo de Harvard Business Review que fundó la reingeniería de procesos, Michael Hammer contaba que una aseguradora había estimado que una solicitud pasaba veintidós días en su proceso y se trabajaba sobre ella diecisiete minutos. Hay que tomarlo por lo que es, una anécdota de una compañía sin nombre citada de oído, y no como una medición. Su valor es otro: es el origen rastreable de todo lo que se repite después, y treinta y seis años más tarde seguimos comprando tecnología para acelerar los diecisiete minutos.
Hammer sacaba de ahí una conclusión que debería estar pegada en la pared de cualquier proyecto de inteligencia artificial. Observaba que las grandes inversiones en tecnología habían dado resultados decepcionantes «en gran medida porque las empresas tienden a usar la tecnología para mecanizar las viejas formas de hacer negocios: dejan los procesos existentes intactos y usan los ordenadores simplemente para acelerarlos». Y remataba: «Es hora de dejar de asfaltar las sendas de vaca. En lugar de incrustar procesos obsoletos en silicio y software, deberíamos destruirlos y empezar de nuevo.»
El ejemplo que él eligió sigue siendo el mejor para entender la diferencia entre acelerar y rediseñar. Las cuentas a pagar de Ford en Norteamérica tenían más de quinientas personas, y la dirección calculó que racionalizando el proceso e instalando sistemas nuevos podría recortar en torno a un veinte por ciento. Entonces miraron a Mazda, donde el mismo departamento lo llevaban cinco personas. Lo que cambiaron no fue el software: cambiaron la regla de fondo, de «pagamos cuando recibimos la factura» a «pagamos cuando recibimos la mercancía», con lo que el cotejo pasó de catorce datos a tres y la reducción fue del setenta y cinco por ciento allí donde implantaron el proceso nuevo. La diferencia entre el veinte y el setenta y cinco no la puso un ordenador mejor: la puso dejar de hacer el trabajo de cotejar. Conviene añadir dos matices que casi siempre se omiten: es un caso relatado por el consultor y nunca auditado de forma independiente, y la tecnología no sobraba, era condición necesaria. Lo que cambia el resultado es el orden: primero la regla, después el sistema.
Hammer añadía además una advertencia de alcance que sigue siendo la más ignorada: Ford descubrió que rediseñar solo el departamento de cuentas a pagar era inútil, porque el proceso relevante empezaba en compras y en recepción. Traducido a hoy, significa que el cuello de botella casi nunca está en el departamento que pide la herramienta. Cuando atención al cliente solicita presupuesto para redactar respuestas más deprisa, el plazo que el cliente percibe suele estar decidido en un paso de validación que pertenece a otra área y que nadie ha puesto sobre la mesa.
Queda una pregunta práctica: dónde suele estar el cuello de botella si no está en la velocidad de nadie. La respuesta que da la evidencia reciente es poco glamurosa y bastante consistente. En un estudio de 2026 de la Universidad Tecnológica de Chalmers sobre el proceso de pedido a cobro de la alimentaria Paulig, con seis mil setecientos cuarenta pedidos reales y ciento noventa y dos mil eventos registrados, solo un cinco y medio por ciento de los casos seguía el flujo estándar, cada pedido acumulaba cerca de treinta actividades, y los cuellos de botella que encontraron no eran la lentitud de ningún equipo: eran datos maestros mal puestos que obligaban a intervenir a mano una y otra vez. El tiempo se va en los traspasos, en las esperas de aprobación y en volver atrás a arreglar información que debería haber entrado bien. Es poco atractivo y es donde está el dinero, y por eso la reingeniería del proceso completo rinde tanto más que la automatización de una actividad.
De todo esto sale la pregunta que debería hacerse antes de aprobar cualquier caso de uso, y que no cuesta nada hacer: qué parte del plazo total ocupa aquello que vamos a automatizar. Si nadie en la sala lo sabe, lo que se está aprobando no es una mejora de proceso, es una compra con una justificación de proceso escrita después. Y si la respuesta es que nadie lo ha medido nunca, hay tres números que cualquier empresa saca de su propio sistema de gestión en una tarde y que bastan para tener la conversación: el plazo medio y el mediano de un caso, cuál es el mayor hueco entre dos eventos consecutivos y a qué porcentaje de casos afecta, y qué porcentaje de casos tiene al menos un paso hacia atrás. Con esos tres números se decide mejor que con cualquier estudio sectorial, porque son los suyos.
Cuándo basta con retocar y cuándo hay que rediseñar
Lo anterior se puede leer como una recomendación de rediseñarlo todo siempre, y eso sería un mal consejo. «Rediseña primero» tiene una factura que casi nunca se enseña, y conviene ponerla sobre la mesa antes de que alguien comprometa dieciocho meses de trabajo. Un rediseño exige dedicar muchos recursos durante mucho tiempo, y ese plazo largo crea un riesgo que no existía hace cinco años: que la tecnología avance lo suficiente durante el proyecto como para dejar desfasado el proceso nuevo el día que arranca. El informe de noviembre de 2025 de MIT Sloan Management Review con BCG lo formula bien y llega a sugerir que a veces lo estratégico es mejorar en pequeño ahora y saltarse deliberadamente una generación tecnológica. Hay que decir que es un informe patrocinado por una consultora que vende proyectos de transformación y que ese pasaje es razonamiento de los autores y no un resultado de su encuesta; el mérito está en haber nombrado la tensión, no en haberla medido.
La tensión es real y se resuelve con criterios, no con doctrina. Hay cuatro que permiten decidir en una reunión y que conviene aplicar en este orden. El primero es qué parte del plazo total ocupa lo que se va a tocar, que es la pregunta del apartado anterior: si es una porción pequeña, retocar no va a mover el resultado y el debate está cerrado antes de empezar. El segundo es de quién es la regla que habría que cambiar: si la espera de cuarenta y cinco días es una condición de pago pactada con el proveedor o un requisito del regulador, el rediseño del proceso interno no la toca y hay que ir a otra conversación. El tercero es la estabilidad: un proceso con mucha variabilidad y muchas excepciones se beneficia más del rediseño, porque las excepciones son precisamente lo que la automatización superficial no absorbe. Y el cuarto es el coste del error, que determina cuánto control hay que diseñar dentro del flujo y, por tanto, cuánto trabajo de verdad tiene el proyecto.
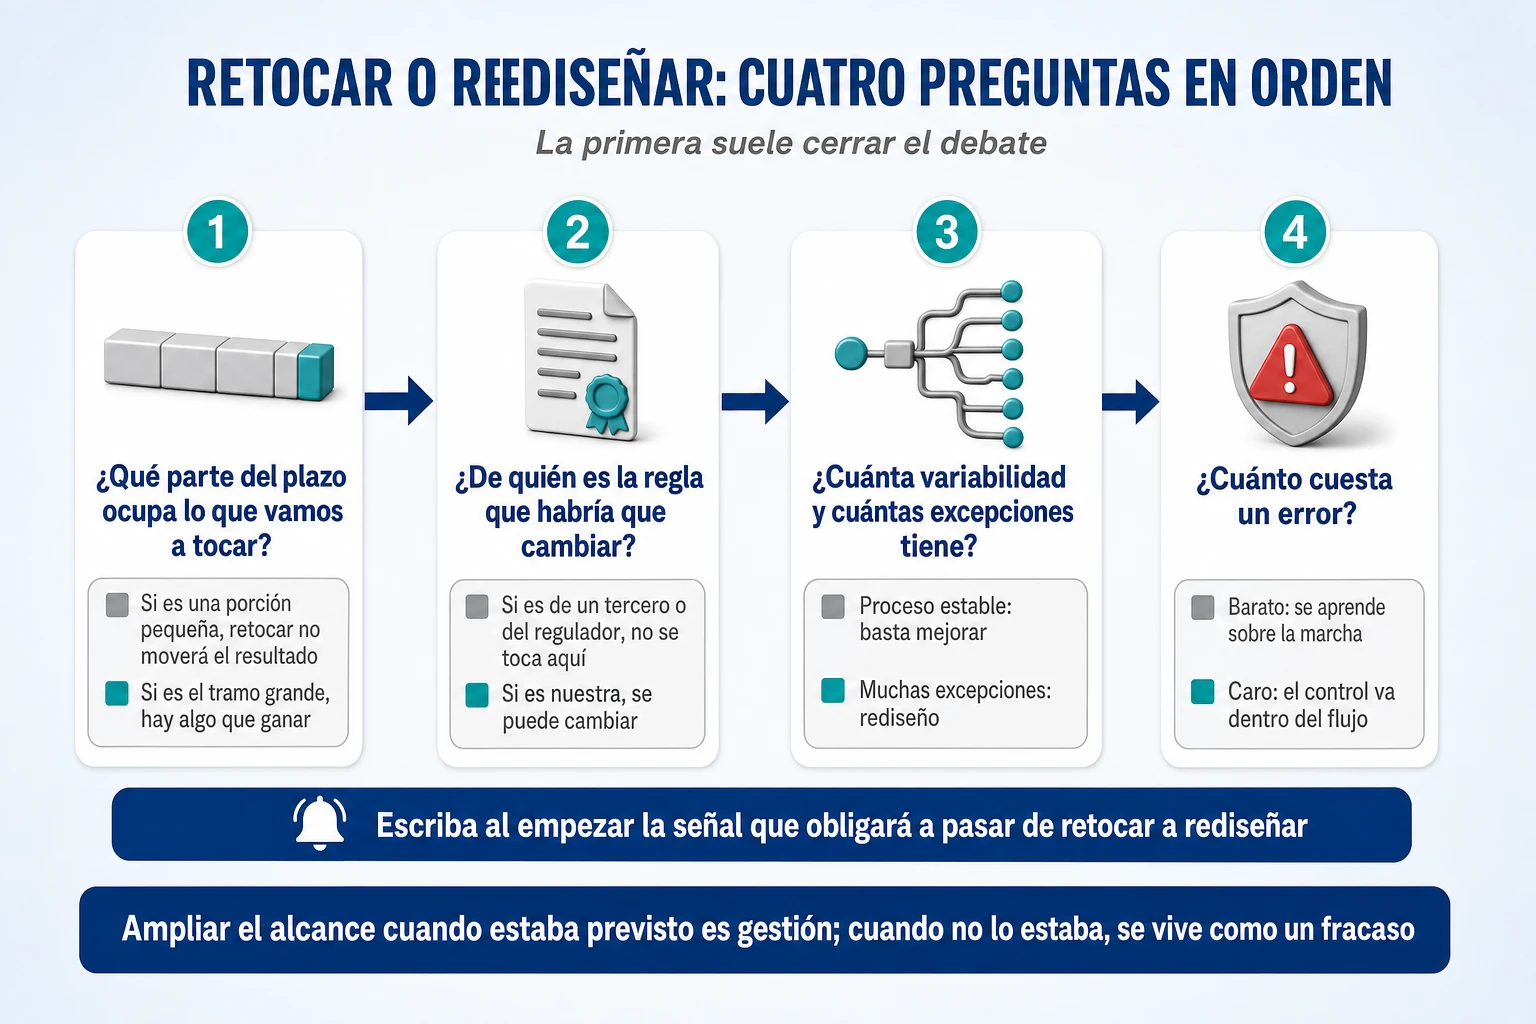
Un ejemplo hace esto concreto. Una empresa quiere acortar el alta de un cliente nuevo, que hoy tarda once días. Si al medirlo descubre que nueve de esos días son la espera de una verificación externa que no controla, rediseñar su parte interna es una obra cara para ganar medio día, y lo sensato es retocar lo propio mientras se negocia o se sustituye la verificación. Si en cambio descubre que siete de los once días son idas y venidas entre tres equipos internos porque la información entra incompleta, está exactamente en el caso contrario: cualquier retoque va a ser absorbido por los traspasos y el rediseño es la única opción que mueve el plazo.
Falta una decisión de gobierno que merece escribirse al empezar y que casi nadie escribe: cuál es la señal concreta que obligará a dejar de retocar y pasar al rediseño completo. Puede ser que la tasa de excepciones supere un umbral, que el volumen se duplique, que aparezca una capacidad que hace innecesaria media solución o que el coste por caso deje de bajar dos trimestres seguidos. Tenerlo escrito evita el problema más común de estos programas, que no es equivocarse de camino sino no tener ningún momento previsto para cambiarlo. Cuando ampliar el alcance está previsto y tiene su señal, es una decisión de gestión; cuando no lo está, se vive como un fracaso del proyecto y se defiende lo indefendible durante meses.
Cuánta autonomía necesita cada caso
Una de las señales de la lista original dice que los equipos se quedan en el autocompletado y que el salto de verdad son agentes que ejecutan en lugar de asistir. La observación de partida es correcta —quedarse en la ayuda individual no cambia ningún proceso— y la conclusión es equivocada, porque convierte la autonomía en una etapa de madurez a la que hay que llegar. La autonomía no es un objetivo de negocio: es una decisión de diseño que se paga en coste y en previsibilidad, y el criterio correcto es elegir el grado mínimo que produce el resultado buscado.
Lo interesante es que esto no es una preferencia conservadora: es lo que están haciendo los equipos que ya tienen sistemas funcionando. Un estudio presentado en 2026 en la conferencia ICML analizó despliegues reales y encontró que dieciséis de los veinte casos examinados usaban flujos estructurados en lugar de dejar que el sistema decidiera libremente su camino, y que en torno a dos tercios de los agentes desplegados daban como mucho diez pasos antes de que interviniera una persona. Conviene manejar ese dato con cuidado, porque la muestra es pequeña y los propios autores advierten de que sus porcentajes no son estimaciones de prevalencia, pero el patrón que describen es inequívoco y ellos mismos lo interpretan así: la intervención humana no es una muleta provisional mientras la tecnología madura, puede ser perfectamente un principio de diseño permanente. Los agentes que funcionan en producción se parecen mucho más a un diagrama de flujo bien pensado que a un empleado autónomo.
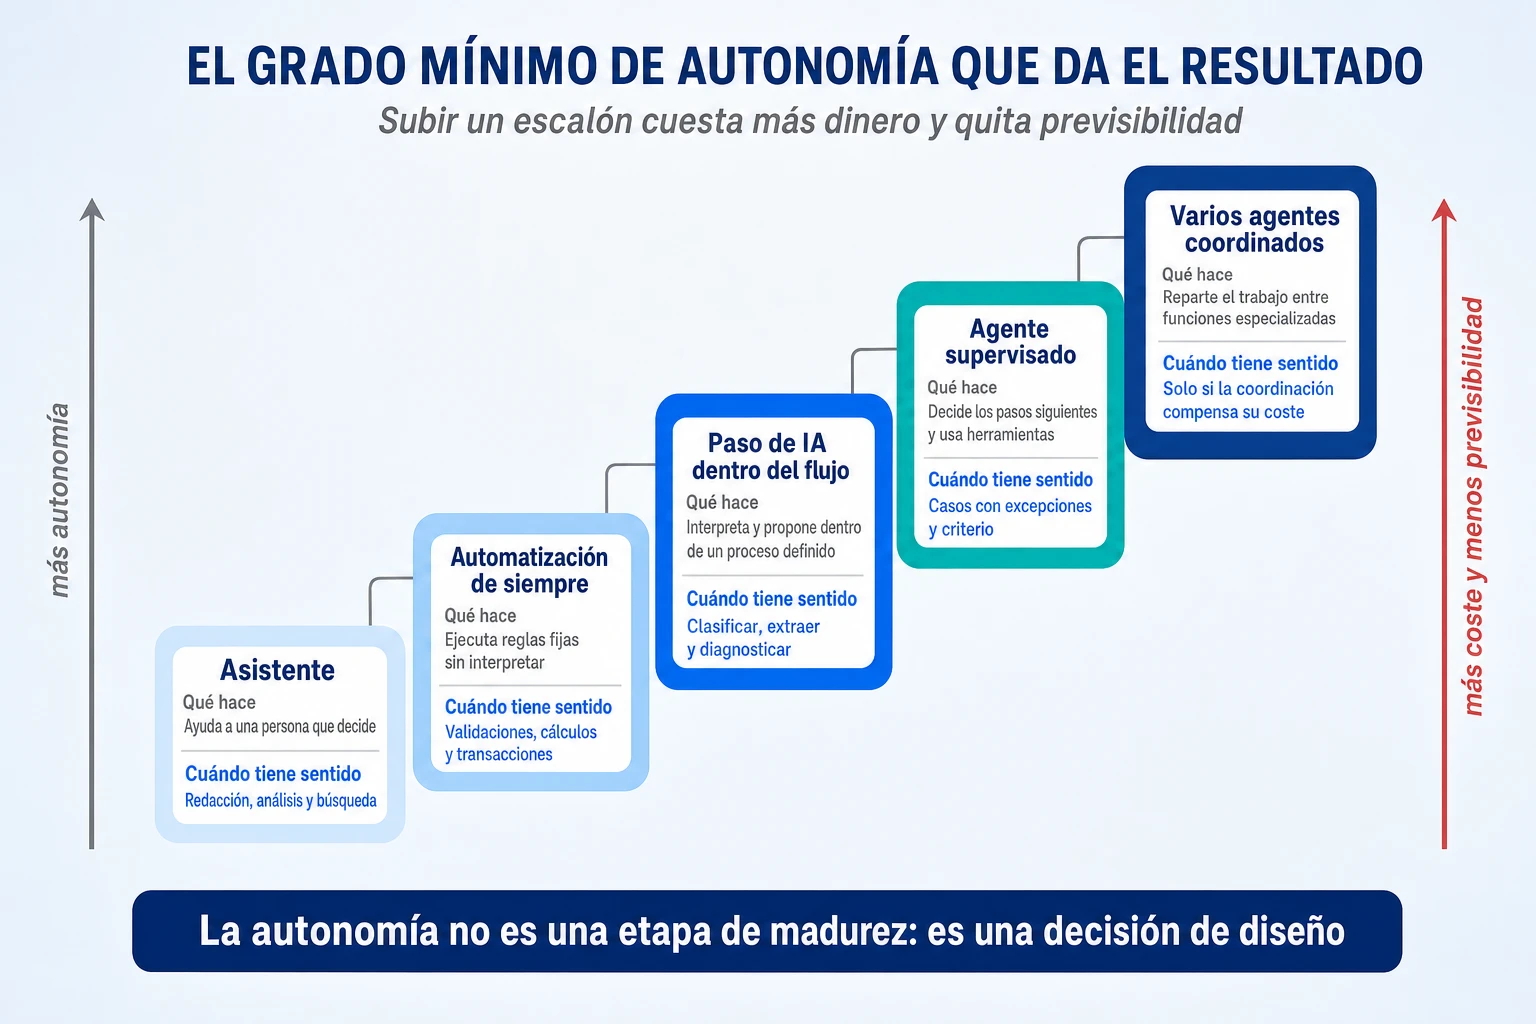
Una distinción técnica reciente ayuda a tener esta conversación sin discutir de palabras, y es separar lo que el sistema es capaz de hacer por su cuenta de lo que se le permite hacer. Son dos cosas independientes: un sistema muy capaz puede quedar deliberadamente limitado a proponer, y esa limitación no es un defecto de implantación sino una decisión tomada por alguien con nombre. Planteado así desaparece el falso dilema entre copiloto y agente. La pregunta no es cuánta autonomía puede tener la tecnología, sino cuánta le concede la empresa para cada tipo de acción, y eso es exactamente lo que hay que escribir antes de construir nada. En este blog hay una escala de autonomía de cero a cinco pensada para tener esa discusión en un comité, y un artículo entero sobre qué arquitectura pide cada problema; aquí basta con el criterio.
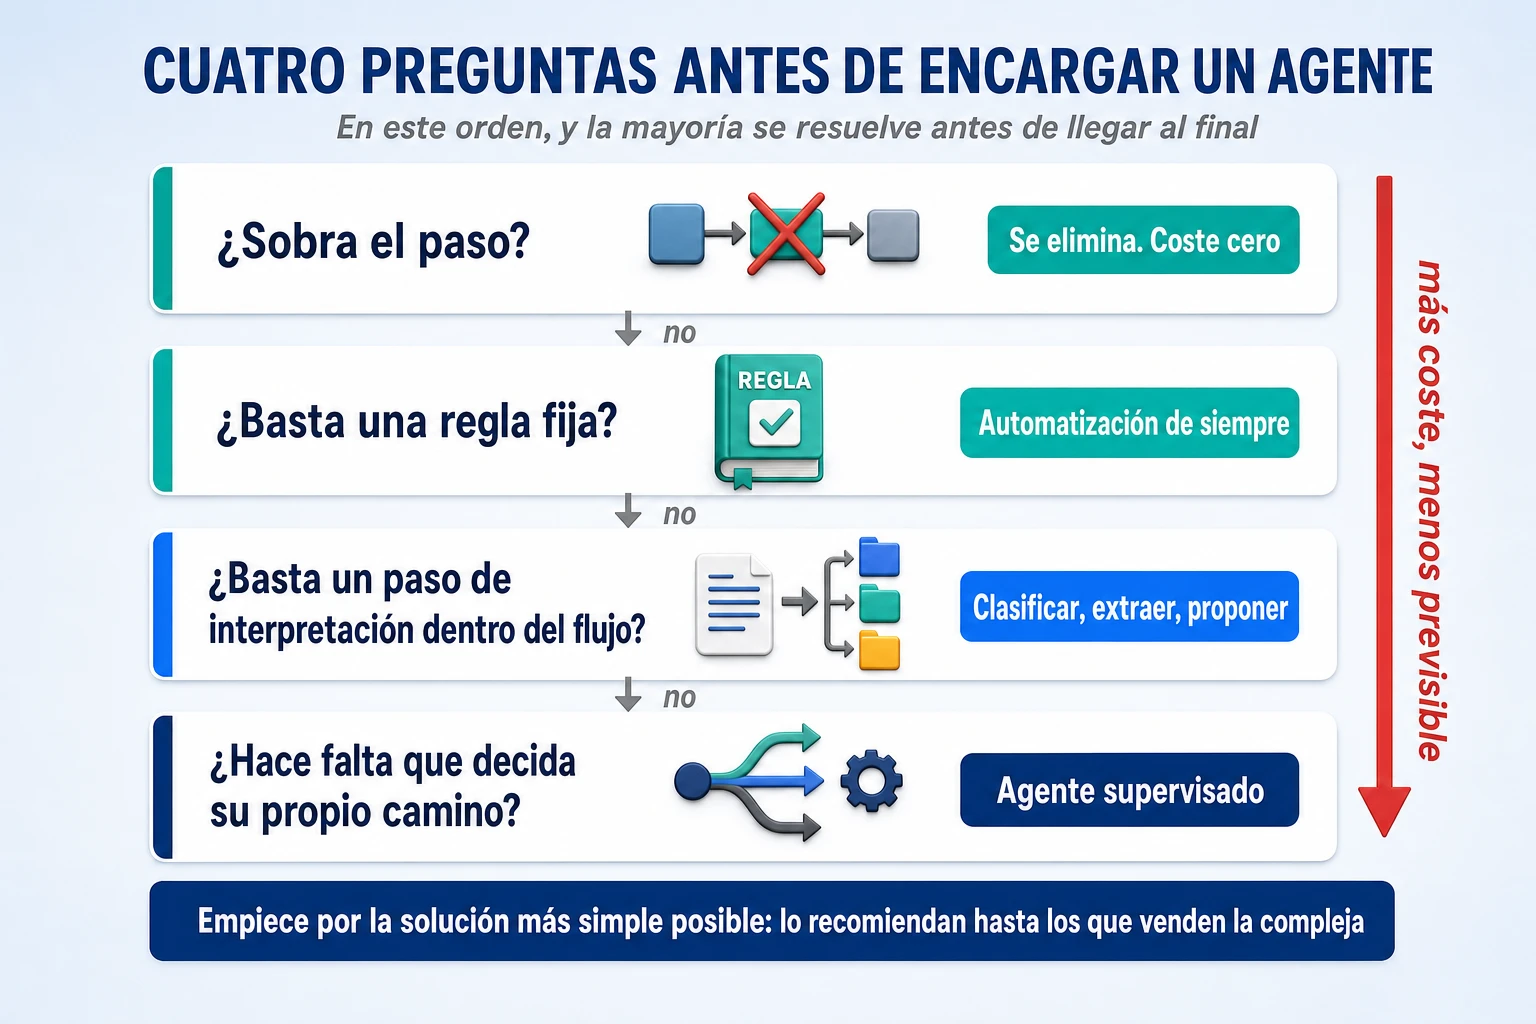
El criterio se puede convertir en cuatro preguntas en orden, y sirven para revisar cualquier propuesta que llegue a un comité. La primera es si el paso sobra: muchas veces el mejor uso de la tecnología es demostrar que una actividad no debería existir, y eso no cuesta licencias. La segunda es si basta una regla determinista, porque si una tarea se resuelve con una condición escrita, meter un modelo a decidir es más caro y menos fiable. La tercera es si basta un paso de interpretación dentro de un flujo que sigue estando definido, que es donde cae la mayoría de los casos útiles: clasificar, extraer, resumir, proponer. Y solo si las tres anteriores se han contestado que no, la cuarta pregunta es si hace falta un sistema que decida su propio camino. Hasta quienes venden esta tecnología recomiendan empezar por la solución más simple posible y reservar la autonomía para donde de verdad aporte, lo cual es una recomendación poco sospechosa.
Sobre esto circula también una predicción muy citada según la cual más del cuarenta por ciento de los proyectos de inteligencia artificial agéntica se cancelará antes de que acabe 2027. Conviene no apoyarse en ella: es una predicción de una casa de análisis, no una medición, y no publica ni el denominador ni qué cuenta como cancelado. Lo que sí vale de esa misma casa es su recomendación, que apunta justo adonde apunta este artículo: reimaginar los flujos de trabajo desde la base y centrarse en la productividad del conjunto de la empresa en lugar de en automatizar tareas aisladas.
Un ejemplo reciente enseña mejor que ninguna teoría que la variable de diseño no es cuánta autonomía sino dónde está la frontera. Una gran cadena de comida rápida desplegó atención por voz en sus autoservicios, tuvo problemas lo bastante visibles como para acabar en vídeos virales y frenó el despliegue. Lo interesante es lo que hizo después: no canceló el sistema ni lo dejó como estaba. Cambió la regla de enrutamiento —una persona entra cuando la cola crece, con supervisión activa— y con esa regla nueva volvió a escalarlo a cerca de novecientos establecimientos. La misma tecnología, el mismo grado de autonomía nominal y un resultado distinto, porque lo que se rediseñó fue el momento del traspaso.
De la prueba de concepto a producción: qué debe demostrar cada fase
Hay una distancia enorme entre demostrar que la tecnología puede resolver una tarea y demostrar que una empresa puede confiarle un proceso, y casi todos los programas tratan esas dos preguntas como si fueran la misma. Un piloto suele disfrutar de condiciones artificialmente buenas: datos limpios, casos elegidos, usuarios voluntarios y motivados, poca presión de plazo y, sobre todo, gente que corrige los errores sin decírselo a nadie porque quiere que el proyecto salga bien. En producción desaparecen las cinco cosas a la vez.
Por eso hay que separar tres pruebas distintas que responden a tres preguntas distintas, y no dar por contestada la tercera cuando solo se ha hecho la primera. La prueba de concepto contesta si puede funcionar técnicamente, y le basta con una muestra y un caso bien elegido. El piloto operativo contesta si funciona en condiciones representativas, y para eso necesita casos difíciles, excepciones y una línea base contra la que compararse. La validación de producción contesta si es fiable, sostenible y rentable a escala, y necesita coste por caso medido, resultados estables en varios ciclos y un plan de reversión. La inmensa mayoría de las iniciativas que se presentan como un éxito se han parado en la primera.

El cambio de mentalidad que hace falta se resume en una frase: el objetivo de una prueba no es que salga bien, es descubrir lo antes posible en qué condiciones deja de funcionar. Eso cambia cómo se diseña. Los casos se eligen por difíciles y no por representativos de la demostración; se mide contra una línea base tomada antes, no contra la impresión de los participantes; se cuentan los costes reales incluidos los de supervisión; y se decide de antemano cómo se revierte si hay que revertir. Para sistemas con riesgo apreciable, la forma más barata de hacer esto es dejar correr el sistema en paralelo sobre el trabajo real sin que su respuesta se aplique, y comparar lo que habría hecho con lo que hizo la persona. Cuesta poco, no expone a nadie y produce exactamente la evidencia que falta.
Esto permite corregir otra de las recomendaciones de la lista original, la de esperar al menos cuatro sprints antes de fiarse de un resultado. El número es arbitrario porque mide tiempo de calendario en lugar de evidencia. En un proceso que trata diez mil operaciones por semana habrá material de sobra en quince días; en un cierre contable trimestral, cuatro sprints no llegan a cubrir un solo ciclo real. Lo que hay que exigir no son ciclos sino condiciones: rendimiento estable con distintos volúmenes y tipos de caso, resultados comparables con una línea base, calidad sostenida incluidos los errores y las excepciones, costes de operación previsibles, capacidad de recuperación ante fallos y, muy importante, que siga funcionando sin que los desarrolladores tengan que intervenir cada semana.
El otro extremo también falla, y es el del piloto que no termina nunca. Tiene un ejemplo muy conocido. Una gran cadena de restauración mantuvo durante unos tres años una prueba de pedidos por voz en más de cien establecimientos y terminó cancelándola, sin que llegara a estar claro públicamente con qué métricas la estaba evaluando. Esa es la verdadera anomalía del caso, más que los vídeos de pedidos equivocados: un piloto de tres años sin criterio de salida publicado no es una prueba, es una situación. Una prueba sin condición de terminación escrita no puede fracasar, y por eso tampoco puede enseñar nada.
Y queda una lección sobre lo que pasa después de la prueba, que viene de un caso pequeño y muy instructivo. Una empresa de paquetería vio cómo su asistente de atención al cliente se comportaba de forma disparatada ante un usuario que lo provocó, y su explicación fue que el sistema llevaba años funcionando y que el fallo apareció tras una actualización. Dicho de otro modo: los límites de comportamiento existían, y dejaron de estar cubiertos cuando algo cambió por debajo. Los guardarraíles son código y, como cualquier otro código, hay que probarlos cada vez que se toca el sistema. Un control que no está en la batería de pruebas no es un control: es una creencia sobre el pasado.
Cómo evaluar un piloto de IA: eficiencia, calidad e impacto en el servicio completo
La forma más habitual de que un piloto engañe a quien lo encarga no es que falle: es que mejore de verdad aquello que se está mirando mientras empeora algo que no se está mirando. Un sistema puede ser más rápido y peor a la vez, y si el cuadro de mando solo tiene eficiencia, el deterioro de la calidad no aparece hasta que lo trae el cliente. Hay un experimento aleatorizado de campo que lo enseña con una limpieza poco frecuente, y que además sirve para algo más importante que la advertencia.
Un gran operador de comercio electrónico asignó al azar a seiscientos cuarenta y siete agentes de atención al cliente, repartidos entre un grupo de control y uno de tratamiento, y observó más de seiscientas ochenta mil conversaciones durante quince días. En las conversaciones donde el sistema podía intervenir, que eran menos del diez por ciento del volumen total, la duración bajó un dieciséis coma ocho por ciento y la valoración del cliente cayó cuatro décimas largas sobre cinco. Ese es el dato que se cita siempre, y es verdad. Pero el mismo estudio trae otro que casi nunca se cita: medido sobre el conjunto del servicio, la duración bajó algo más de un tres por ciento y el efecto sobre la calidad no fue estadísticamente significativo, entre otras cosas porque en las conversaciones donde el sistema no entraba la valoración mejoró ligeramente, probablemente porque los agentes tenían más tiempo.
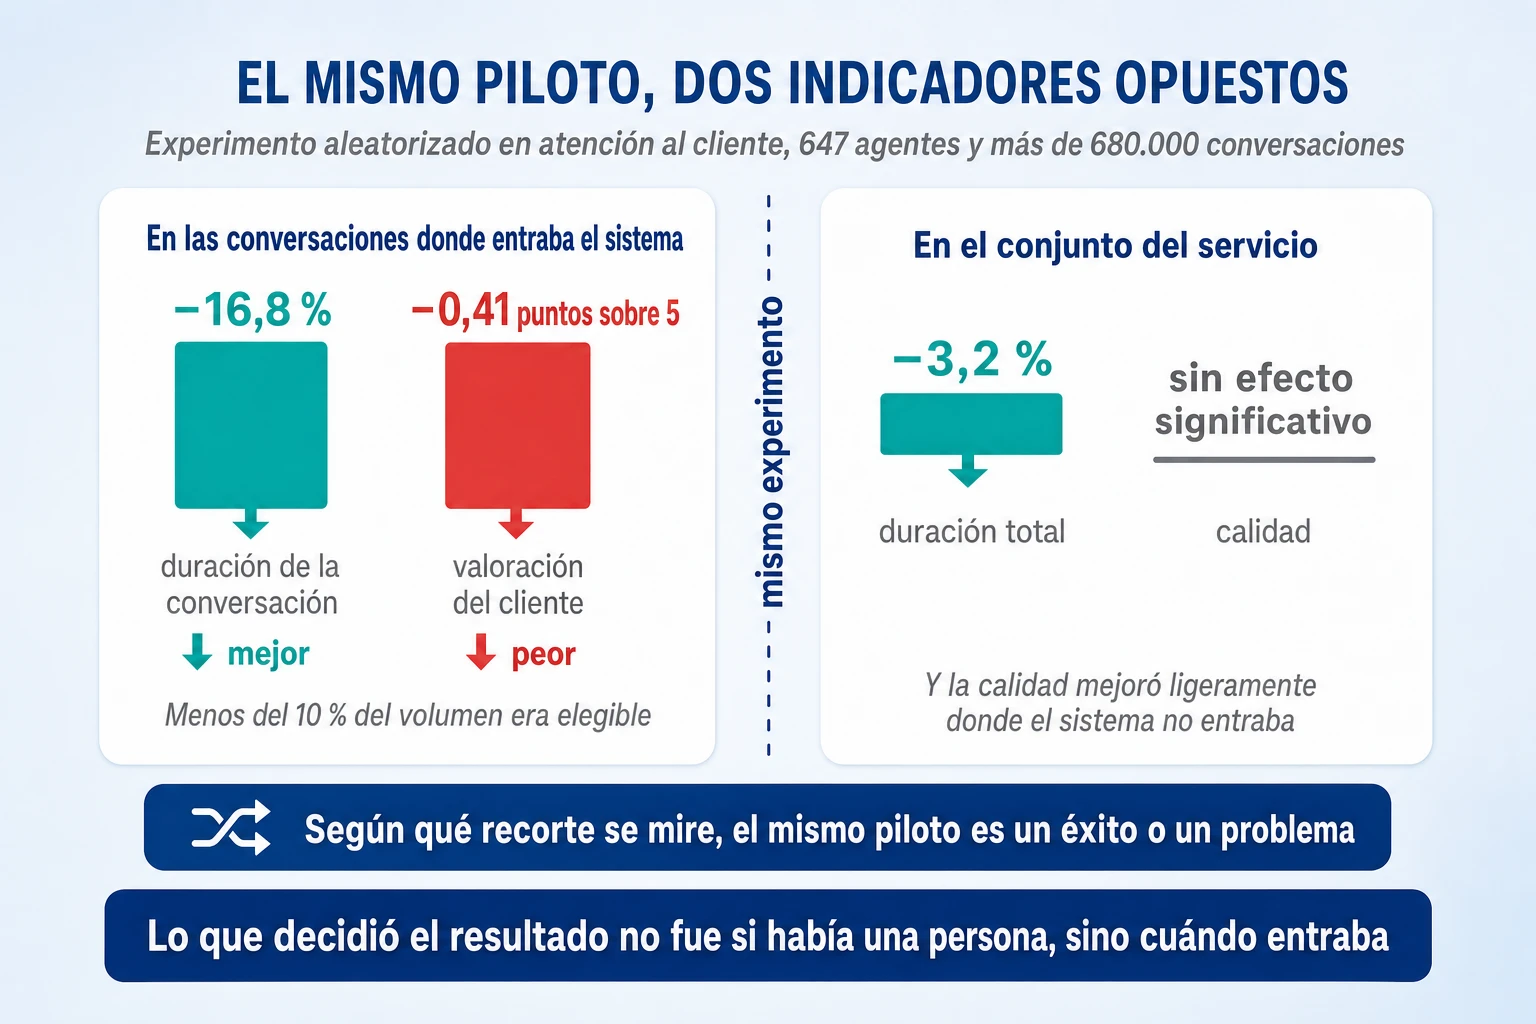
Merece la pena detenerse en lo que acaba de pasar, porque es más instructivo que el titular. Los dos resultados son correctos y proceden del mismo experimento bien diseñado. Si usted mide solo donde actuó el sistema, tiene un problema de calidad evidente; si mide el servicio entero, tiene una mejora modesta sin daño detectable. El denominador no solo decide el titular de un estudio: decide también si su piloto se aprueba o se cancela. De ahí sale una regla que cuesta cero: todo piloto se mide en los dos recortes, el de las operaciones afectadas y el del proceso completo, y las dos cifras se llevan juntas al comité. La primera dice si el sistema funciona; la segunda, si cambia algo.
El hallazgo más útil del estudio, sin embargo, está en un tercer nivel de detalle y es una decisión de diseño pura. Cuando el caso se traspasaba a una persona por un problema técnico, la conversación se alargaba en torno a un veinte por ciento y la calidad se mantenía: el rescate funcionaba. Cuando el traspaso se producía porque el cliente estaba frustrado, la conversación se alargaba más del cuarenta por ciento, subía la proporción de clientes que volvían a intentarlo y la valoración se hundía casi un punto entero. Dicho de otro modo: lo que determina el resultado no es si hay una persona en el bucle, sino en qué momento entra. Entrar tarde, cuando el cliente ya ha perdido la paciencia, es peor que no haber automatizado nada, porque la persona recibe un problema que ya no es técnico.
Eso convierte una discusión abstracta sobre supervisión humana en una especificación concreta que se puede escribir antes de construir: qué señales disparan el traspaso, con cuánta antelación, qué contexto recibe la persona cuando lo recibe y qué se le permite hacer entonces. Es exactamente el mismo aprendizaje que sacó la cadena de restauración de la que se hablaba más arriba cuando cambió su regla de enrutamiento. Y es la pregunta que casi nunca aparece en una propuesta de proveedor, porque la propuesta describe lo que el sistema hace solo y el valor está en lo que hace cuando no puede.
De la adopción al valor de negocio: cuatro niveles para medir los resultados de la IA
Que un noventa por ciento de la plantilla use una herramienta todas las semanas es un dato excelente sobre el despliegue y no dice absolutamente nada sobre el negocio. La adopción es la métrica natural de una compra, porque lo que se compró fue acceso, y por eso aparece sola en todos los cuadros de mando sin que nadie tenga que decidir ponerla. El problema no es elegir una métrica mala: es pararse en el segundo escalón de cuatro.
Los cuatro escalones son fáciles de distinguir y vale la pena nombrarlos porque cada uno responde a una pregunta distinta. El primero es el uso, y su indicador típico son los usuarios activos: dice que la herramienta está instalada y que la gente entra. El segundo es la productividad individual, y su indicador son los minutos ahorrados por tarea: dice lo que la gente cree que ha ganado. El tercero es el rendimiento del proceso, y sus indicadores son el coste y el plazo por caso y la tasa de casos que vuelven: dice si el trabajo de la empresa ha mejorado. Y el cuarto es el valor, con margen, ingresos y caja: dice si eso se ha convertido en dinero.
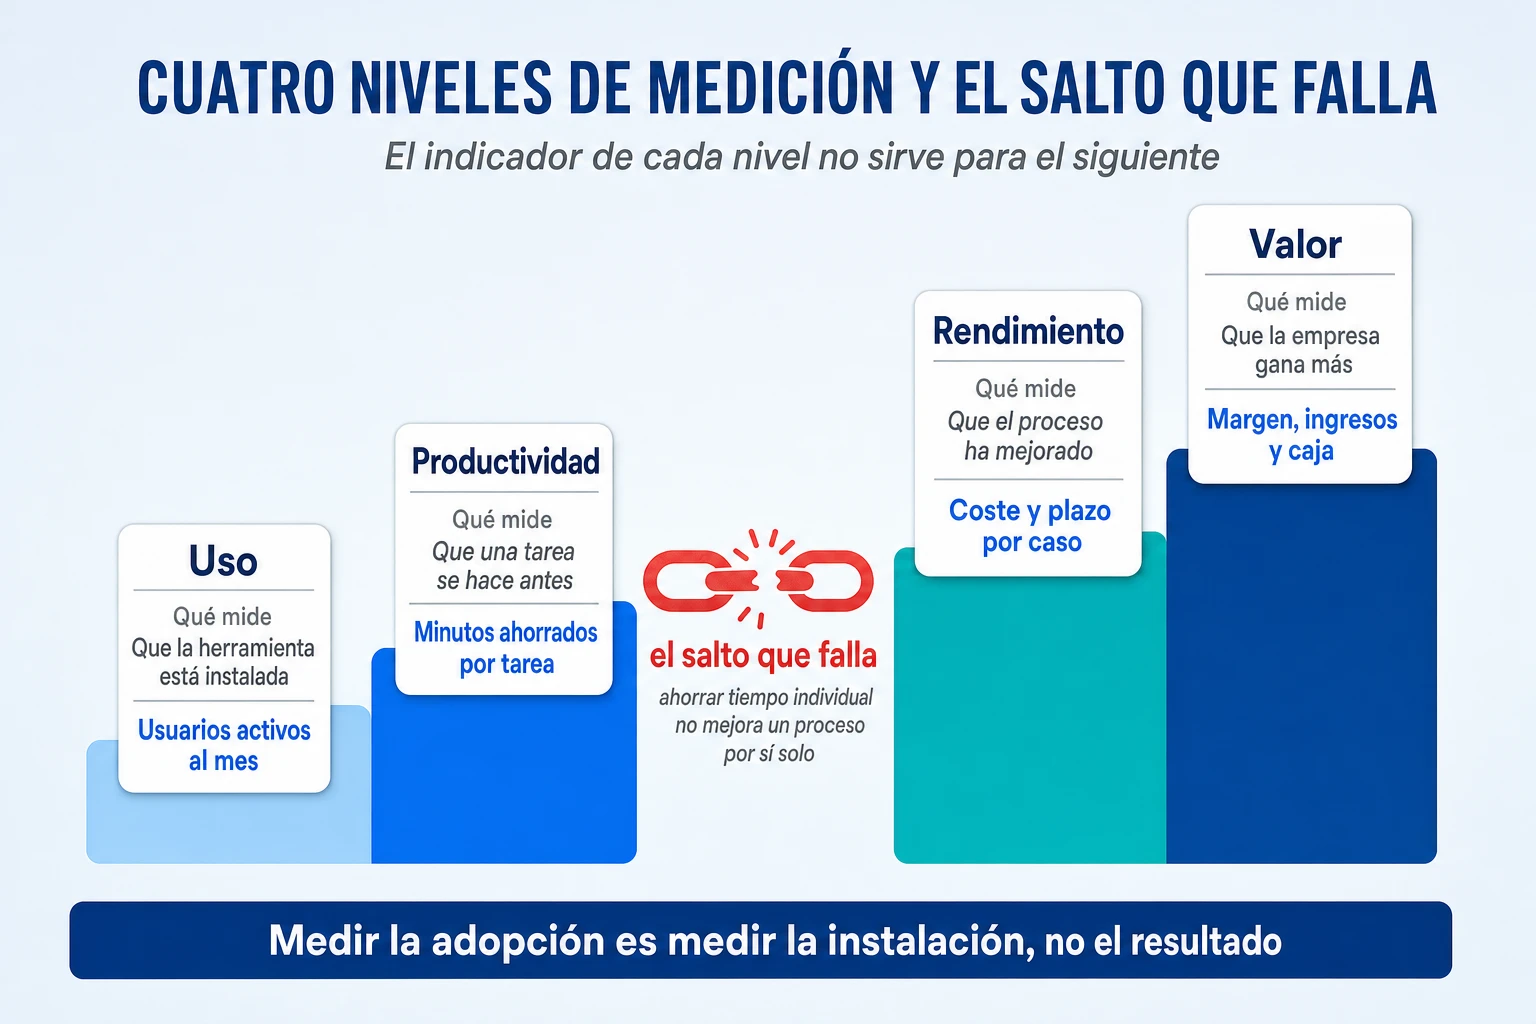
El salto que falla casi siempre es el segundo, el que va de la productividad individual al rendimiento del proceso, y falla por una razón que no tiene que ver con la tecnología. Ahorrar tiempo en una tarea solo mejora el proceso si esa tarea estaba limitando el proceso, que es precisamente lo que el apartado del cuello de botella decía que casi nunca ocurre. Por eso una empresa puede tener a la vez un segundo escalón espectacular y un tercero completamente plano, y las dos cosas ser verdad. Cuando alguien presenta minutos ahorrados como si fueran una mejora del negocio, está saltándose el escalón donde vive el argumento.
Hay además una métrica que casi ningún cuadro de mando incluye y que es la única que detecta el daño cuando lo hay: el retrabajo aguas abajo. Es decir, cuánto tiempo gasta quien recibe un entregable que parecía terminado y no lo estaba, cuántos casos vuelven atrás y cuántas veces hay que rehacer algo que ya se había dado por bueno. Tiene una propiedad que la hace especialmente valiosa: es la única que empeora cuando la empresa produce más deprisa cosas peores, que es exactamente el modo de fallo nuevo que introduce esta tecnología. Y es barata de obtener, porque en la mayoría de los sistemas de gestión ya está registrada aunque nadie la mire.
Una advertencia final sobre estos cuatro escalones, para no convertirlos en otra plantilla que rellenar. No hay que medir los cuatro desde el primer día ni con la misma frecuencia. El primero sirve durante las primeras semanas y después deja de informar. El segundo es útil para decidir dónde seguir y peligroso como argumento de inversión. El tercero es el que tiene que estar en la revisión mensual del programa. Y el cuarto solo se puede mirar con un horizonte largo y con cuidado, porque en el margen de una empresa influyen muchas más cosas que un rediseño de proceso, y atribuirle a la inteligencia artificial cualquier variación que coincida en el tiempo es el error simétrico del que este artículo viene advirtiendo desde el principio.
Cómo convertir el tiempo liberado por la IA en valor económico real
Supongamos que el salto anterior sí se ha dado y que el proceso ha mejorado de verdad. Queda todavía un tramo que casi ningún programa recorre, y es el que convierte una mejora operativa en un resultado financiero. La capacidad que se libera no se convierte en dinero por sí sola: se evapora salvo que alguien decida explícitamente a qué se dedica. Y esa decisión no es una consecuencia de la herramienta, es una decisión de dirección que hay que tomar y escribir.
La aritmética es sencilla y por eso engaña. Cien personas que ahorran media hora al día liberan cincuenta horas diarias, que sobre el papel son más de seis jornadas completas. En la práctica, esas cincuenta horas están repartidas en fragmentos de quince o veinte minutos entre cien agendas distintas, nadie las reasigna, los cuellos de botella del proceso siguen donde estaban y el efecto en la cuenta de resultados es indistinguible de cero. Esto no es una hipótesis: es exactamente lo que encontró el estudio danés que cruzaba encuestas con registros oficiales de nóminas y horas, donde los adoptantes declaraban ahorrar en torno a un tres por ciento de su jornada y el ochenta y cinco por ciento de ellos reconocía que ese tiempo se iba a otras tareas, mientras el efecto medido sobre salarios y horas era un cero preciso.

Los destinos posibles de esa capacidad son solo cuatro, y conviene elegir uno antes de empezar en lugar de descubrir después que no se eligió ninguno. Se puede absorber más volumen sin contratar, y entonces el beneficio aparece como crecimiento sin coste adicional. Se puede acortar el plazo, y entonces aparece como servicio y a veces como ingreso. Se puede reducir el coste unitario, y entonces hay que decir con qué se corresponde eso en la plantilla o en la subcontratación, que es la conversación que todo el mundo evita. O se puede dedicar a trabajo que antes no se hacía, que es un destino perfectamente legítimo y el que más se usa en la práctica, pero que hay que contabilizar como capacidad nueva y no como ahorro, porque no reduce ninguna partida. Confundir esas dos cosas es la forma más común de prometer un retorno que después no aparece en ningún sitio.
Que esto no se decida casi nunca tiene además respaldo empírico, aunque sea de una fuente interesada: en encuestas de consultoras que venden transformación, dos de cada tres usuarios declaran recibir poca o ninguna orientación sobre qué hacer con el tiempo que ganan. Es un dato autodeclarado y conviene no apoyarse mucho en él, pero coincide con lo que se ve en cualquier empresa. La herramienta llega con instrucciones de uso y sin instrucciones sobre el destino del ahorro, y en ausencia de instrucción la gente hace lo razonable, que es trabajar con menos agobio en lo mismo de siempre.
La consecuencia práctica cabe en una línea del acta de aprobación. Antes de empezar, el patrocinador debería tener que contestar por escrito a qué se va a dedicar la capacidad liberada y quién lo ejecuta, con la misma seriedad con la que se contesta cuánto cuesta el proyecto. Si la respuesta es que todavía no se sabe, el caso de negocio no está terminado; y si la respuesta es que se verá sobre la marcha, lo que hay es una compra de herramientas con una expectativa de ahorro que nadie ha asignado a nadie.
Cómo se sabe de verdad si un proceso ha mejorado
Todo lo anterior da por supuesto algo que no es trivial: que la empresa puede saber si el proceso ha mejorado. En la práctica es mucho más difícil de lo que parece, y la mejor prueba de hasta qué punto lo es viene de un instituto que se dedica exclusivamente a medir esto y que ha tenido que rendirse.
Empecemos por su primer resultado, que es el más citado y sigue siendo el más instructivo. En el único ensayo aleatorizado que ha cronometrado a desarrolladores con experiencia trabajando sobre su propio código, los que usaban asistentes de inteligencia artificial tardaron un diecinueve por ciento más. Los mismos participantes, al terminar, calculaban que habían ido un veinte por ciento más rápido. Hay que decir que son dieciséis personas en un contexto muy particular —repositorios grandes y maduros que conocían a fondo— y que los propios autores enumeran con cuidado lo que su estudio no demuestra, empezando por que la inteligencia artificial no acelere a la mayoría de los desarrolladores. Lo que sí demuestra, y es suficiente, es que la sensación de ahorro y el ahorro son dos variables distintas que pueden apuntar en direcciones opuestas.
Lo que vino después es todavía más revelador y casi nadie lo cuenta. En febrero de 2026, ese mismo equipo anunció que cambiaba el diseño de su experimento porque entre un treinta y un cincuenta por ciento de los participantes les decían que estaban dejando de aceptar tareas por no tener que hacerlas sin la herramienta, y eso pagando por su tiempo. Sus estimaciones nuevas, mucho más amplias y centradas también en el lado negativo, las califican ellos mismos de evidencia muy débil. Dicho sin rodeos: el grupo de control se ha vuelto inaccesible. Y esto no significa que la tecnología no funcione —la dirección del sesgo que ellos declaran va hacia infravalorar la aceleración—, sino algo más incómodo para cualquier comité: si un instituto dedicado a esto no consigue mantener una comparación limpia, conviene preguntar de dónde sale el cuarenta por ciento de mejora de una presentación interna.
La brecha entre lo percibido y lo medido tampoco es un vicio de los equipos de base. Un trabajo reciente de economistas de la Reserva Federal sobre varios cientos de directivos la nombra con todas las letras como una paradoja de productividad en la que las ganancias percibidas superan sistemáticamente a las medidas. Es una encuesta, de modo que mide lo que los directivos creen y no lo que registran los sistemas, pero precisamente por eso sirve: la percepción optimista está presente en todos los niveles de la organización, y es la única fuente de la que bebe la mayoría de los casos de negocio que se aprueban.
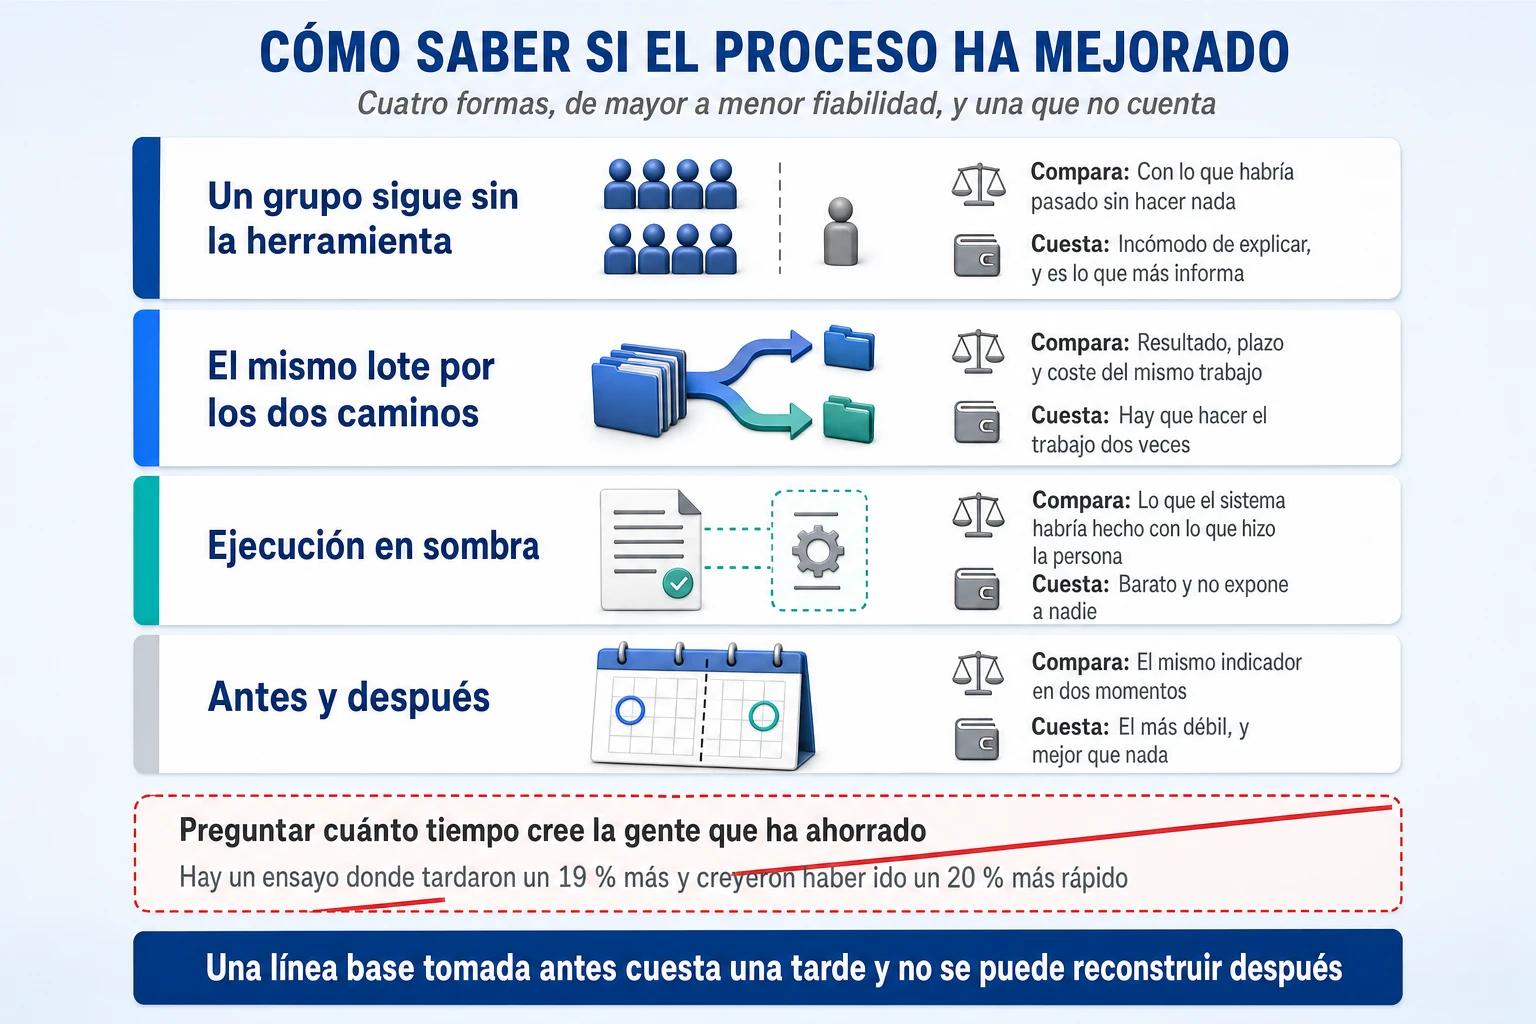
Lo que queda cuando el ensayo aleatorizado perfecto no es posible son cuatro diseños, de mayor a menor fiabilidad, y todos están al alcance de una empresa mediana. El primero es dejar deliberadamente a una parte del equipo sin la herramienta durante un tiempo acotado, que es incómodo y es lo que más información da. El segundo es resolver el mismo lote de expedientes por los dos caminos y comparar resultado, plazo y coste. El tercero es hacer correr el sistema en sombra sobre el trabajo real, sin que su respuesta se aplique, y comparar lo que habría hecho con lo que hizo la persona: no expone a nadie y es sorprendentemente barato. Y el cuarto, el más débil pero mejor que nada, es comparar el antes y el después con el mismo indicador. Preguntar cuánto tiempo cree la gente que ha ahorrado no aparece en esta lista, y no por capricho: es la única medida cuyo error está cuantificado.
Queda una razón adicional, y bastante desagradable, para medir uno mismo en lugar de confiar en lo publicado. Si uno busca casos de empresas que hayan rediseñado un proceso de punta a punta con inteligencia artificial y hayan publicado cifras, se encuentra con un patrón muy claro: el fracaso en inteligencia artificial se documenta en comunicados, demandas y folletos de bolsa; el éxito se documenta en folletos comerciales. Los casos que salen mal dejan rastro verificable porque alguien tiene que explicarlos ante un regulador, un tribunal o un sindicato. Los que salen bien se cuentan en materiales de proveedor, sin nombre de cliente, sin denominador y sin línea base. Esa asimetría explica buena parte del desconcierto de los comités, que comparan fracasos auditados con éxitos publicitados. En este blog hay un artículo dedicado a los casos que sí han cambiado algo de verdad, y escribirlo exigió exactamente ese trabajo de separar lo documentado de lo anunciado.
Las excepciones son pocas y merece la pena conocerlas porque enseñan el patrón de medición correcto. Una aseguradora nativa digital ha publicado en sus informes al regulador bursátil cómo su gasto de gestión de siniestros pasó del trece al siete por ciento de las primas mientras el volumen se multiplicaba por dos y medio y el equipo de siniestros se reducía en términos absolutos, con una formulación que vale la pena retener: convertir el coste de gestionar siniestros, históricamente variable, en un coste casi fijo. Un gran banco asiático publica desde hace años el valor económico que atribuye a sus iniciativas de datos e inteligencia artificial, lo descompone en tres partidas y —esto es lo importante— lo mide contra grupos de control y pruebas comparadas, además de reconocer públicamente que aislar el efecto será cada vez más difícil. Y hay un caso más antiguo que sirve de antídoto contra la impaciencia: la optimización de rutas de una gran empresa de paquetería tardó trece años desde su inicio hasta el despliegue completo sobre cincuenta y cinco mil conductores, con un ahorro anual de cientos de millones validado por un premio externo de investigación operativa. No es inteligencia artificial generativa, y por eso mismo recuerda que los rediseños grandes siempre han tardado.
De todo esto no se sigue que haga falta montar un departamento de investigación. Se sigue algo mucho más barato y mucho más urgente: una línea base tomada antes cuesta una tarde y no se puede reconstruir después. Quien empieza a desplegar sin ella ha renunciado, sin saberlo, a poder demostrar nunca que sirvió para algo.
El caso del banco australiano: los riesgos de medir solo la actividad automatizada
Todo lo anterior tiene un caso que lo demuestra mejor que cualquier razonamiento, y tiene la virtud poco común de estar documentado por las dos partes y de terminar con la empresa reconociendo por escrito el error. En 2025, el mayor banco de Australia implantó un sistema de voz en su servicio de atención telefónica y poco después anunció la supresión de cuarenta y cinco puestos en ese equipo. La justificación que dio fue una cifra concreta y perfectamente cierta: el sistema estaba desviando unas dos mil llamadas menos por semana hacia los agentes humanos.
El sindicato contestó con los datos del otro lado del mismo proceso. El volumen total de llamadas no estaba bajando, sino creciendo; el trabajo que el sistema no resolvía lo estaban absorbiendo horas extra y jefes de equipo puestos al teléfono; y el banco, cuando se le pidió, no documentó la medición en la que había basado la decisión. Ese segundo detalle vale tanto como el primero: la cifra que sostuvo una decisión sobre cuarenta y cinco personas no estaba en ningún sitio donde pudiera revisarse. Semanas después el banco dio marcha atrás y lo explicó con una frase que merece leerse entera, porque es la mejor definición de este error que ha publicado nunca una empresa: su evaluación inicial de que esos cuarenta y cinco puestos sobraban «no consideró adecuadamente todas las circunstancias relevantes del negocio, y ese error significó que los puestos no eran redundantes».
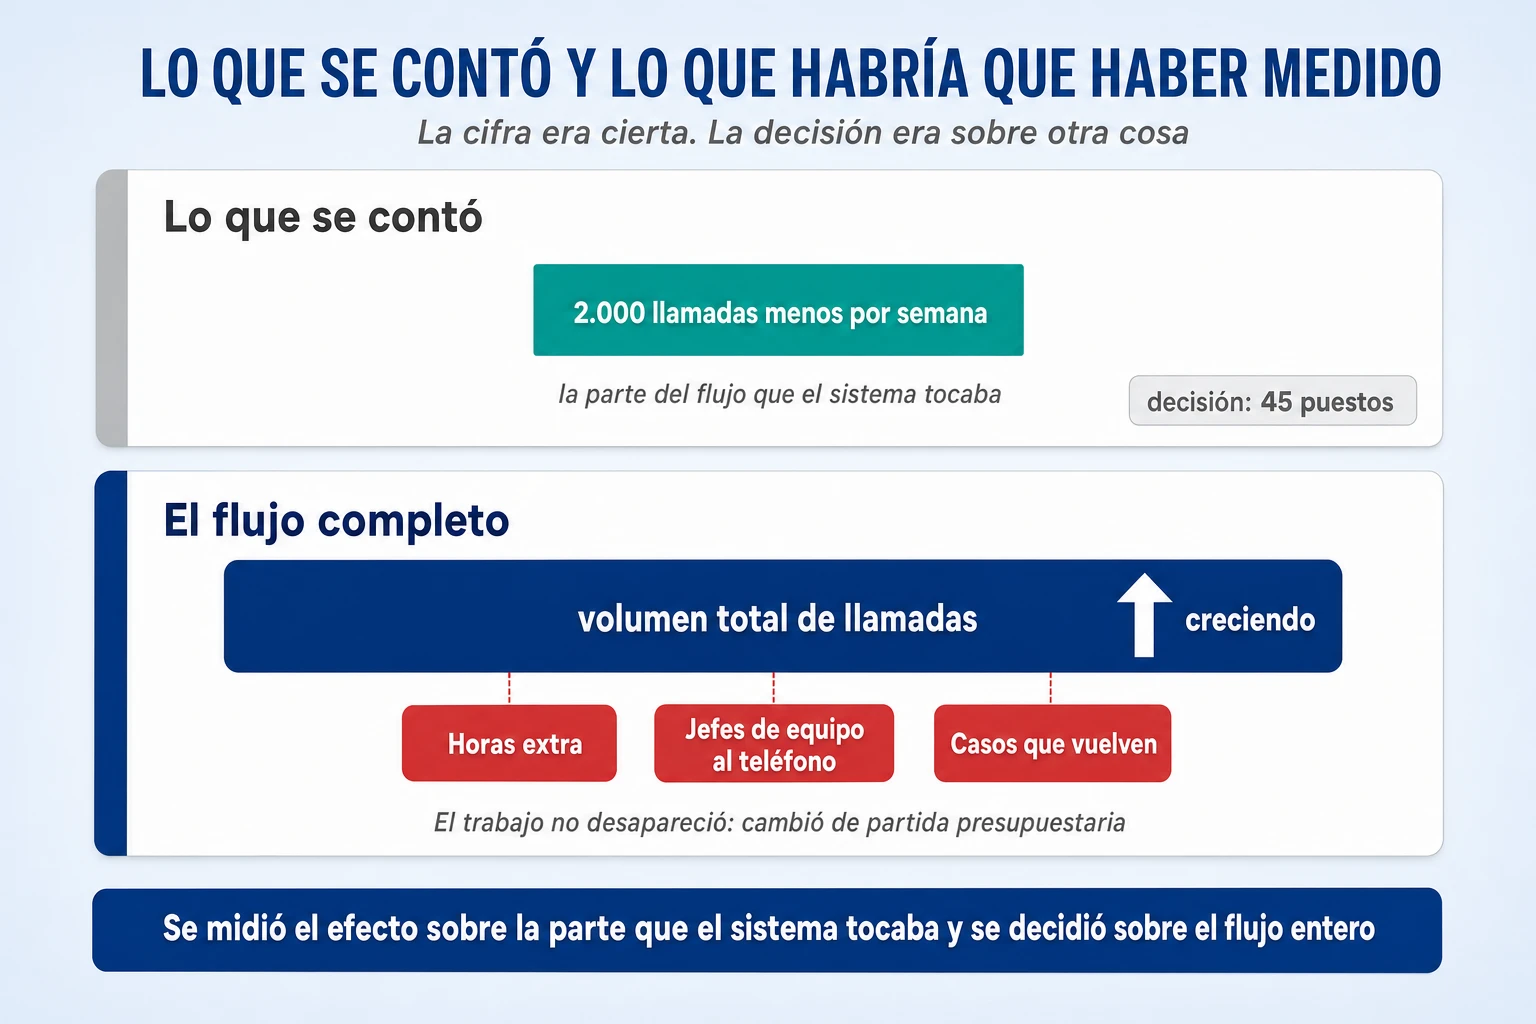
El mecanismo del fallo se puede enunciar en una frase que sirve para cualquier empresa: se midió el efecto del sistema sobre la parte del flujo que el sistema tocaba, y se decidió sobre el flujo entero. Las dos mil llamadas desviadas no eran una mentira ni una exageración. Eran una medición correcta de un trozo, usada para tomar una decisión sobre el todo. Y hay una segunda capa que es la que más se repite en otros sitios: el trabajo no desapareció, se desplazó hacia arriba. Lo que antes resolvía un agente pasó a resolverlo un jefe de equipo o a pagarse como hora extra, de modo que el coste siguió existiendo, cambió de partida presupuestaria y dejó de verse en el indicador que se estaba vigilando.
De ahí sale una regla práctica antes de eliminar un puesto por una automatización, y no es una regla moral sino de medición. Hay que mirar el flujo completo y no la parte automatizada: cuántas veces vuelve el mismo caso, cuántos se escalan y a quién, cuántas horas extra aparecen, quién absorbe lo que el sistema no resuelve y qué pasa con los casos que antes ni siquiera llegaban porque alguien los resolvía en el pasillo. Si esas preguntas no tienen respuesta medida, lo que hay no es un caso de negocio: es una extrapolación.
Conviene además desmontar aquí la historia que más se cita en estas conversaciones, porque circula deformada en los dos extremos y quien la usa en un comité queda retratado si alguien la ha comprobado. Se cuenta que una conocida empresa de pagos sustituyó a setecientos agentes por un asistente, y que después tuvo que dar marcha atrás y recontratarlos. Ninguna de las dos mitades es exacta. Los setecientos nunca fueron despidos: era una equivalencia de volumen, el trabajo que la empresa calculaba que habría hecho ese número de agentes. Y la empresa tampoco deshizo su reducción de plantilla, que siguió bajando de forma sostenida según sus propios documentos ante el regulador bursátil; lo que hizo fue reabrir un canal de atención humana para los clientes que lo quisieran. La lección verdadera del caso no es que la inteligencia artificial fallara, sino que una métrica de equivalencia se convirtió en un titular sobre personas y después en otro titular sobre un fracaso que tampoco ocurrió.
Workslop: el coste oculto del retrabajo generado por la IA
Esta tecnología introduce un modo de fallo que los procesos no habían tenido antes y para el que no están preparados. Un sistema informático que falla, falla de forma visible: da error, se cae, devuelve un campo vacío. Un texto generado que no sirve tiene exactamente el aspecto de uno que sí sirve. Está bien escrito, tiene la estructura correcta, usa el vocabulario adecuado y no hace avanzar el trabajo ni un paso. Y como parece terminado, cruza el traspaso al siguiente equipo sin que nadie lo pare.
De esto existe una medición que se ha hecho popular con razón. En una encuesta a alrededor de mil empleados de oficina, cuatro de cada diez decían haber recibido en el último mes trabajo generado con inteligencia artificial que parecía bueno y no hacía avanzar la tarea, y quienes lo recibían calculaban haber dedicado unas dos horas a arreglar cada caso. Conviene quedarse con esas dos cifras y no con las que suelen acompañarlas: las extrapolaciones a euros por empleado y mes que circulan multiplican tiempo autodeclarado por salario autodeclarado y las publica quien vende la solución al problema, de modo que no tienen el denominador que haría falta para llevarlas a un comité.
Lo que importa de ese dato no es su magnitud sino dónde cae el coste. No lo paga quien produce el entregable, que ha ido más rápido y así lo declarará si alguien le pregunta cuánto tiempo ha ahorrado. Lo paga quien lo recibe, que normalmente es el eslabón siguiente del proceso o el mando que tiene que revisarlo. Visto desde los cuatro niveles de medición de los que hablaba un apartado anterior, esto es lo que ocurre cuando el segundo escalón mejora y el tercero empeora: la productividad individual sube de forma real y el rendimiento del proceso baja, porque se ha movido trabajo de un sitio a otro sin que nadie lo registre.
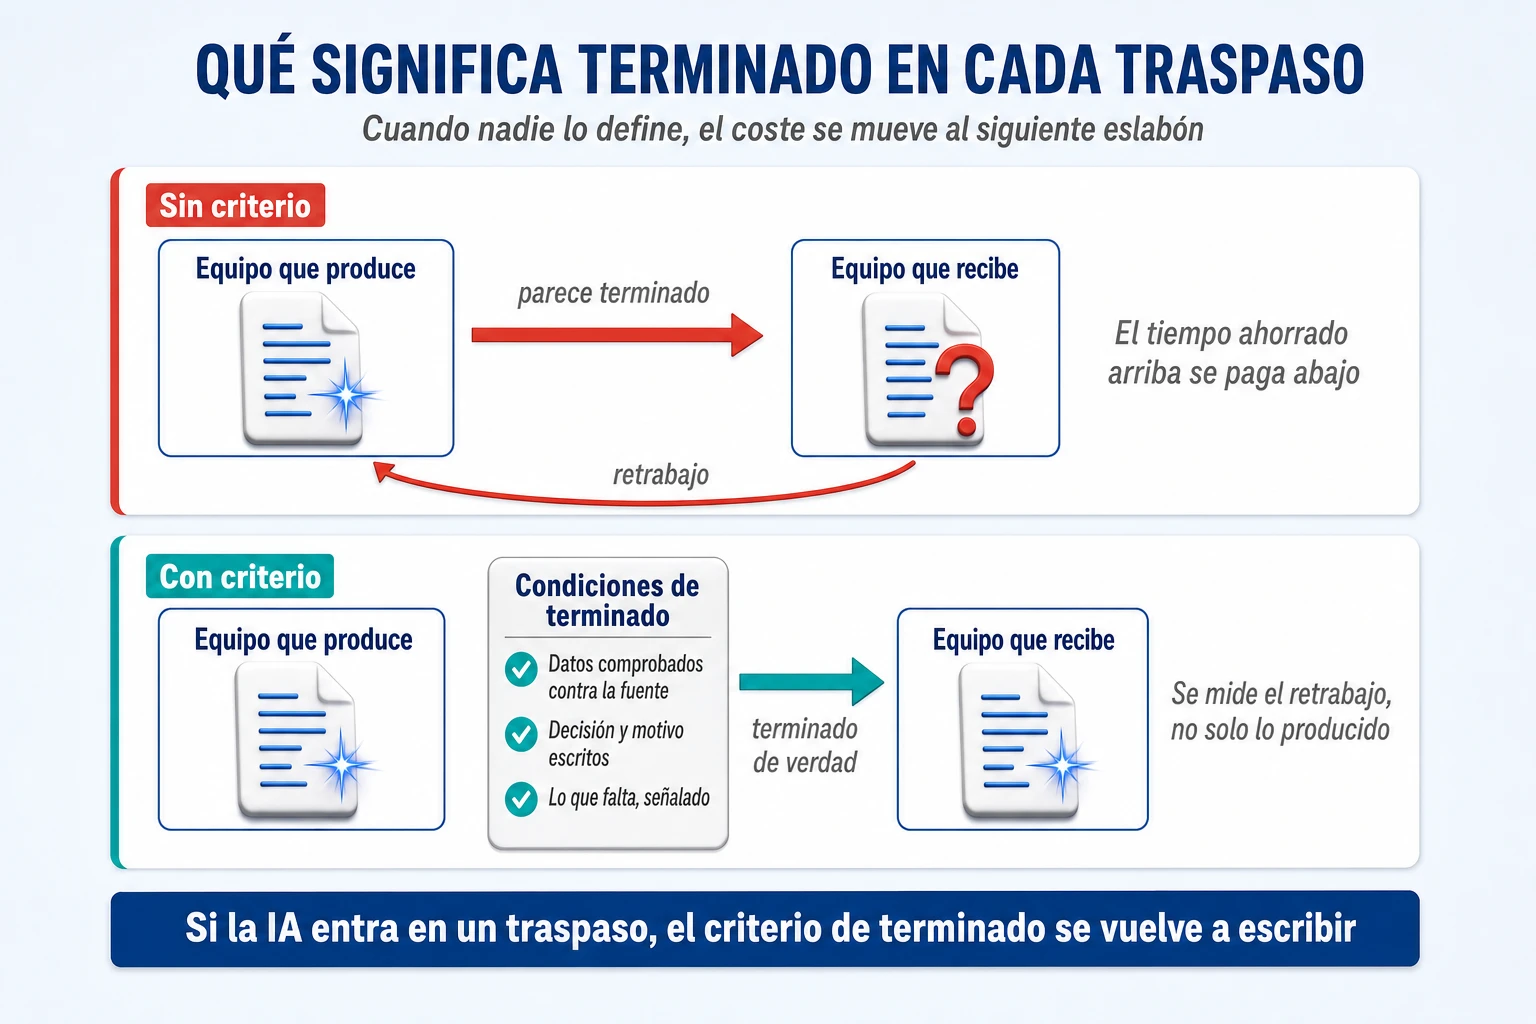
La respuesta que primero se le ocurre a todo el mundo es prohibir o restringir, y es la peor de las disponibles, porque el trabajo seguirá haciéndose igual y solo dejará de verse. La respuesta que funciona es aburrida y específica: cuando la inteligencia artificial entra en un traspaso, hay que volver a escribir qué significa «terminado» en ese traspaso. No en abstracto para toda la empresa, sino en ese punto concreto, y en tres o cuatro condiciones comprobables. Por ejemplo, para un análisis que pasa de un equipo a otro: que los datos estén comprobados contra la fuente y no solo citados; que la decisión propuesta venga con el motivo y con lo que se descartó; y que lo que falta esté señalado explícitamente en lugar de quedar rellenado con lenguaje plausible. Tres líneas en una plantilla, no un procedimiento de calidad.
Y junto a eso, la métrica que lo cierra: medir el retrabajo aguas abajo además del volumen producido. Si un equipo entrega el doble y el equipo siguiente dedica el triple de tiempo a corregir, el proceso ha empeorado aunque los dos indicadores de producción hayan mejorado. Es la única forma de que el coste aparezca donde se genera y no donde se paga, que es la condición mínima para que alguien tenga incentivo a corregirlo.
La resistencia de los expertos suele tener parte de razón
La lista original acierta al decir que el cambio va de hacer el trabajo a especificarlo, y acierta también al observar que quienes más resisten suelen ser los profesionales con más experiencia. Donde se queda corta es en el diagnóstico, porque trata la resistencia como un obstáculo que hay que vencer con comunicación. En la mayoría de los casos no es un obstáculo: es información sobre el diseño, y llega del único sitio de la organización que conoce el proceso de verdad.
Conviene separar cuatro cosas distintas que suelen contarse como una sola, porque cada una se gestiona de una manera. La primera es la competencia: el experto deja de ser quien ejecuta la tarea y pasa a especificarla, revisarla y resolver lo que la máquina no resuelve, y eso es un oficio distinto que nadie le ha enseñado. La segunda es la identidad profesional: las habilidades que le daban reconocimiento pierden peso relativo, y ese reconocimiento no se recupera con un curso. La tercera es el poder: quien controlaba una validación, una información o un recurso pierde capacidad de decidir, y eso es un cambio real que no desaparece porque se le llame resistencia. Y la cuarta es la responsabilidad, que es la más explosiva y la que casi nunca se nombra.
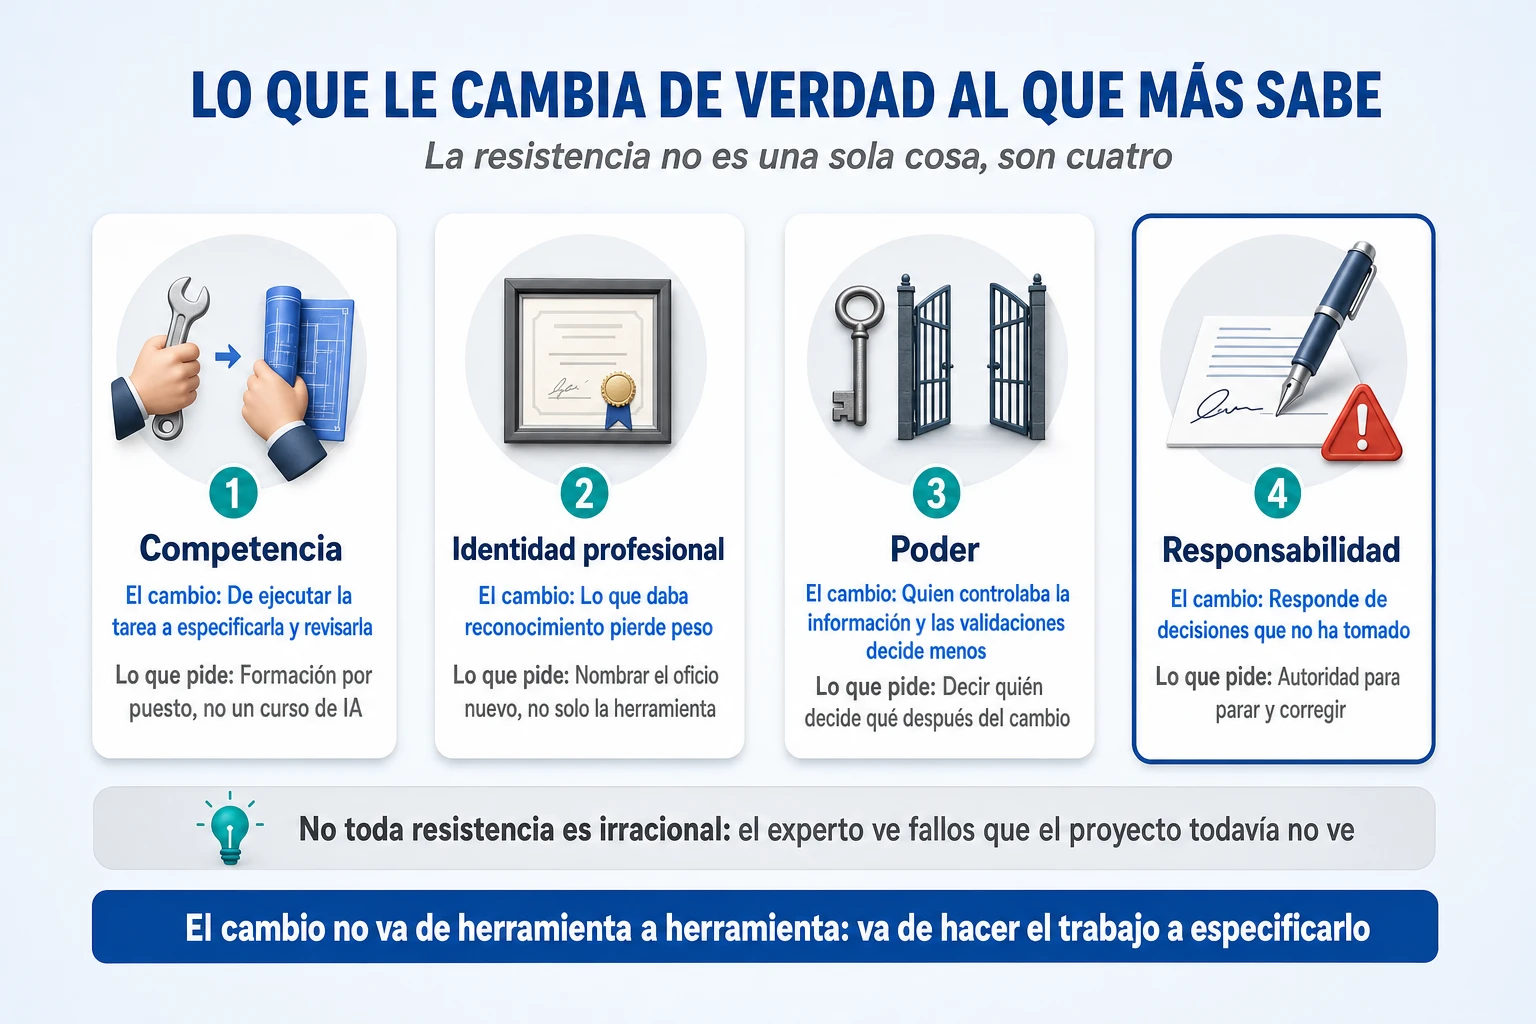
Un estudio de entrevistas presentado en 2026 en una conferencia de interacción entre personas y sistemas inteligentes le pone nombre a esa cuarta dimensión: la asimetría entre responsabilidad y autoridad. La decisión se desplaza al sistema y la responsabilidad se queda en la persona que tiene que explicársela al cliente, defenderla ante un inspector o firmarla. Es un estudio cualitativo con dieciséis profesionales, así que sirve para nombrar el mecanismo y no para medirlo, pero el mecanismo se reconoce al instante en cualquier empresa. Quien se resiste en ese escenario no está siendo refractario al cambio: está señalando que el diseño le ha dejado la firma y le ha quitado el criterio. Y mientras ese desajuste siga ahí, la resistencia es la respuesta correcta.
Hay que decir también lo contrario, porque las dos cosas son ciertas a la vez y quedarse con una sola lleva a un error simétrico. Que el experto detecte problemas que el proyecto no ve no significa que el experto sea un filtro fiable de los errores del sistema: como se verá en el apartado siguiente, cuando la máquina se equivoca, los profesionales más veteranos también caen, solo que menos. De modo que la conclusión correcta no es «haz caso al experto» ni «el experto exagera»: es que el experto hay que meterlo en el diseño, donde su conocimiento vale, y no dejarlo solo al final del proceso haciendo de red de seguridad, que es justo donde su juicio se degrada.
Llegados aquí aparece la pregunta incómoda sobre la gestión del cambio, que es si funciona. La revisión de referencia sobre el tema, publicada en Academy of Management Annals en 2018 por Stouten, Rousseau y De Cremer, arranca precisamente de ahí: los modelos de cambio más usados en empresa se apoyan en la opinión de su autor más que en evidencia científica, y los propios revisores tuvieron que reconstruir desde la literatura qué está demostrado y qué no. Conviene no sobreinterpretarlo: que no haya evidencia independiente de la secuencia completa de un marco no significa que el marco no sirva, y varios de sus componentes —crear conciencia del problema, apoyo del mando directo, participación de la gente en el diseño— sí tienen respaldo. Lo que no está demostrado es la secuencia patentada que vende cada proveedor. Y cuando alguien cite la cifra de que los proyectos con gestión del cambio excelente tienen siete veces más probabilidades de cumplir objetivos, conviene saber que sale del estudio de la empresa que vende esa metodología y que los encuestados califican el cambio como excelente sabiendo ya si el proyecto salió bien. Para el marco teórico de esto hay un artículo específico en este blog; aquí interesa lo que cambia en el trabajo real.
De lo que sí hay medición consistente es del papel del mando directo. Gallup lleva desde 2023 preguntando lo mismo a empleados estadounidenses, y el factor que más se asocia al uso no es la herramienta ni el curso: es el jefe inmediato. Quien percibe que su mando apoya el uso tiene 1,7 veces más probabilidad de usar la tecnología cada semana. Es una asociación y probablemente va en las dos direcciones —en los equipos donde la herramienta sirve para algo, el jefe la apoya—, así que no conviene convertirla en una promesa de multiplicador. Lo que sí deja claro es dónde está la palanca organizativa, y que casi ningún presupuesto la financia: el mando intermedio es quien tiene que rediseñar el trabajo de su equipo, y se le suele pedir que lo haga sin tiempo, sin criterio escrito y sin que su propio objetivo haya cambiado.
La traducción práctica son cinco cosas que se pueden hacer este trimestre. Meter a los expertos en el diseño del proceso futuro, no en la validación del diseño ya hecho. Escribir quién decide qué después del cambio, con nombre y con umbral, y dar a quien firma autoridad para parar y corregir. Formar por puesto y sobre el proceso concreto de esa persona, no con un curso general de inteligencia artificial. Cambiar los incentivos y los criterios de evaluación, porque pedirle a alguien que trabaje de otra manera mientras se le mide como antes es pedirle que elija. Y poner un canal donde el que detecta un fallo del sistema lo registre y vea que se corrige, que es la diferencia entre tener gente que señala problemas y tener gente que deja de señalarlos.
El supervisor que pierde la práctica supervisa peor
Casi todos los diseños que llegan a un comité de riesgos se sostienen sobre la misma pieza: habrá una persona que revise. Es la respuesta estándar a cualquier objeción sobre errores del sistema, y es una respuesta razonable. El problema es que esa pieza no es estática. Si la revisión humana es la salvaguarda del proceso, entonces la competencia de quien revisa es parte del diseño, y la evidencia dice que se degrada precisamente por usar el sistema que tiene que vigilar.
El caso mejor documentado no viene de una oficina, viene de un quirófano. En cuatro centros de endoscopia polacos, la tasa de detección de adenomas en las colonoscopias hechas sin ayuda de la máquina cayó del 28,4 al 22,4 por ciento después de que esos mismos centros empezaran a usar detección asistida, sobre algo más de mil cuatrocientos procedimientos. Hay que decir inmediatamente que es un estudio observacional de antes y después, que los propios autores escriben que «podría reducir» y no que reduzca, y que hay explicaciones alternativas razonables, desde el cambio de casuística hasta la rotación de profesionales. Pero plantea una pregunta que ningún plan de implantación se hace: si el supervisor pierde destreza, quién supervisa al supervisor.
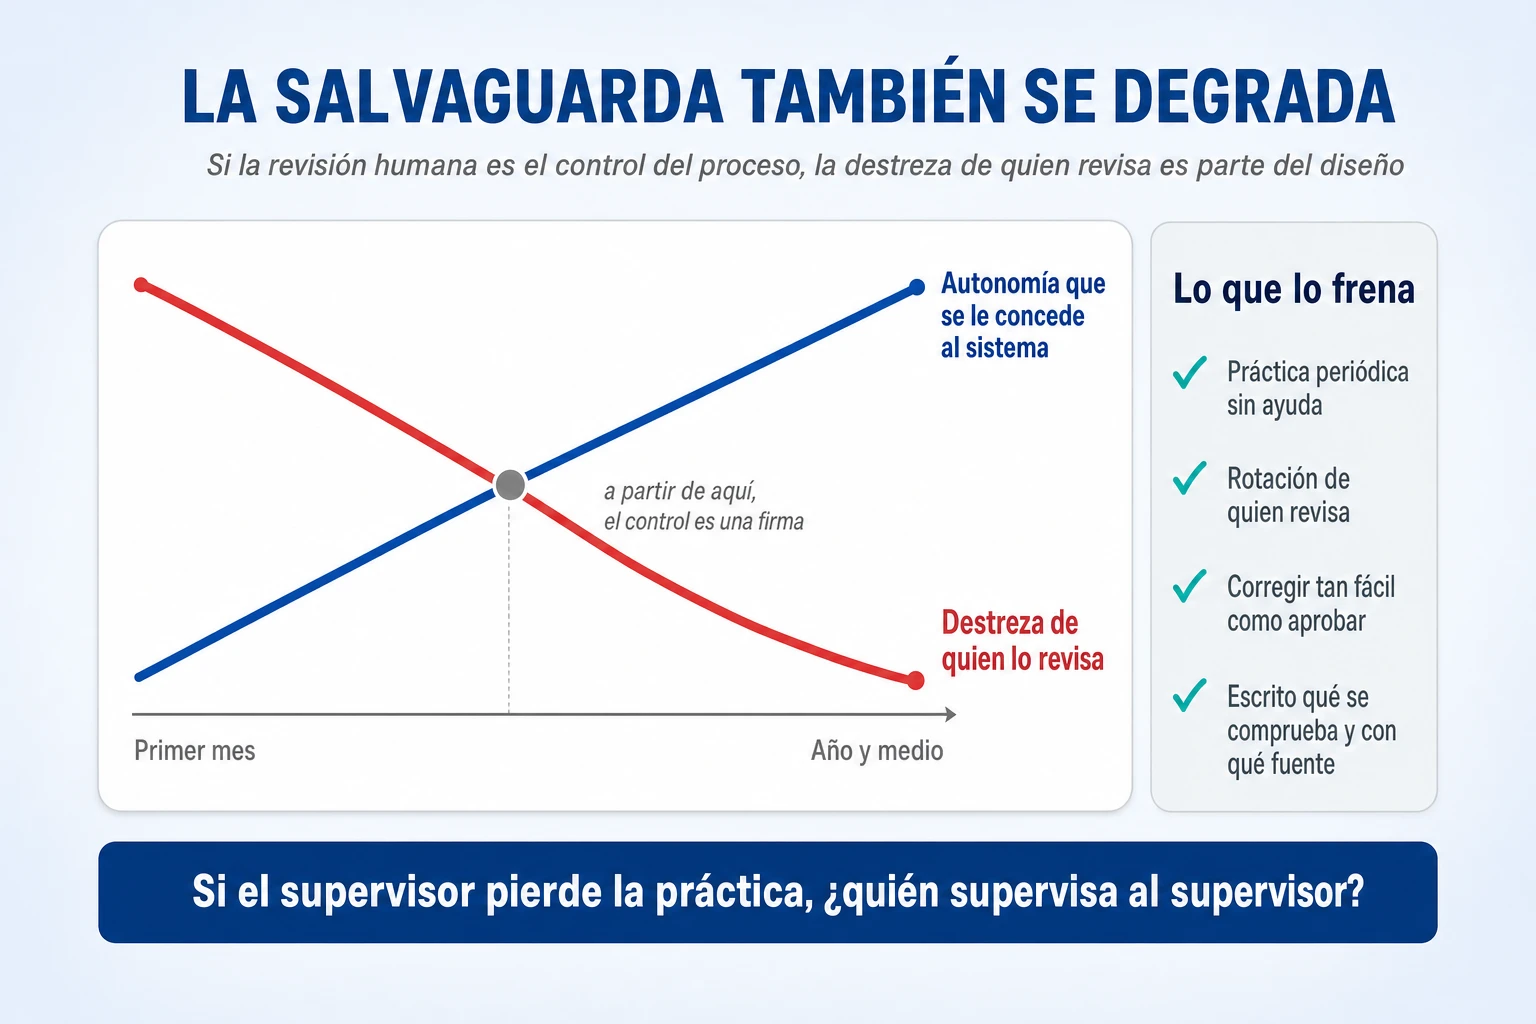
Existe un segundo mecanismo, distinto del anterior y peor, porque no necesita que pase el tiempo: el sesgo de automatización. La idea cómoda de que una persona con experiencia filtrará los errores de la máquina está medida y no sale bien parada. En un experimento publicado en Radiology en 2023 con veintisiete radiólogos, cuando la sugerencia que acompañaba a la imagen era errónea, el acierto de los lectores más veteranos bajó del 82,3 al 45,5 por ciento, y el de los menos experimentados del 79,7 al 19,8. Conviene leer bien esos números, porque el primero es el del grupo que mejor resistió: la experiencia amortigua el golpe, no lo evita. Y antes de extrapolar hay que decir que la ayuda era simulada y que la proporción de sugerencias equivocadas era muy superior a la de un sistema real, de modo que lo que el experimento mide es la vulnerabilidad de la persona, no la fiabilidad de la máquina.
La reacción natural a esto es pedir formación, y hay un dato que conviene conocer antes de firmar el presupuesto. En un ensayo aleatorizado publicado en NEJM AI con cuarenta y cuatro médicos que ya habían hecho veinte horas de formación específica en inteligencia artificial, a quienes les tocaron sugerencias con errores deliberados la precisión diagnóstica les bajó catorce puntos, del 84,9 al 73,3 por ciento. Haber recibido el curso no les protegió. Es un estudio pequeño y en un contexto concreto, así que la magnitud no se puede generalizar; la dirección sí, y es suficiente para dejar de tratar la formación como la respuesta completa a este problema.
Lo mismo ocurre cuando la tarea es aprender y no revisar, que es el caso de cualquier profesional que se incorpora a un proceso nuevo. Un experimento aleatorizado de Anthropic con cincuenta y dos desarrolladores puso a la mitad a aprender una librería desconocida con un asistente y a la otra mitad sin él. Los que lo usaron sacaron algo más de cuatro puntos menos sobre veintisiete en el cuestionario de comprensión posterior, en torno a un diecisiete por ciento de la nota, y además no terminaron antes. El detalle que más sirve, sin embargo, está dentro del grupo que sí usó la herramienta: lo que distinguía a quienes aprendieron de quienes no era preguntarle por qué en lugar de pedirle el resultado. Los que delegaron del todo acabaron igual de tarde y entendieron menos.
Nada de esto es un descubrimiento reciente, y saberlo evita tratarlo como un problema de esta tecnología concreta. En 1983, en un artículo de cinco páginas sobre control de procesos industriales, Lisanne Bainbridge formuló lo que llamó la segunda ironía de la automatización: el diseñador que intenta eliminar al operador le deja de todos modos las tareas que no sabe cómo automatizar. Cuarenta años después el reparto se sigue haciendo igual. Se automatiza lo que es fácil de especificar y le queda a la persona lo que no se sabe especificar, que es justamente lo que exige más destreza y lo que menos se practica. Esa es la razón de fondo por la que la supervisión se vacía sola si nadie la diseña.
De aquí salen cuatro decisiones concretas, y ninguna es cara. La primera es mantener práctica deliberada sin ayuda: una parte del volumen, pequeña y rotatoria, que se resuelve a mano para que la competencia no se oxide y para tener además una referencia viva con la que comparar. La segunda es rotar a quien revisa, porque revisar siempre lo mismo es exactamente la situación en la que el sello sustituye al criterio. La tercera tiene que ver con cómo está construida la pantalla, y es la más olvidada: en los experimentos que han mirado esto, lo que predice que alguien detecte un error no es tanto su competencia técnica como cuánto esfuerzo le cuesta corregirlo. Un botón de aprobar más accesible que el de corregir convierte la revisión en un trámite, por bueno que sea el revisor. Y la cuarta es declarar qué tiene que hacer la persona exactamente: revisar no es mirar, y si no está escrito qué comprueba, con qué fuente y en qué orden, lo que hay es una firma, no un control.
Quitar las tareas del junior ahorra hoy y deja sin cantera mañana
El apartado anterior tiene una consecuencia que no aparece en ninguna lista de errores y que se paga con cinco años de retraso. Las tareas que se automatizan primero son casi siempre las mismas: las repetitivas, las acotadas, las que tienen una respuesta comprobable. Y esas son exactamente las tareas con las que se aprendía el oficio. Si el proceso nuevo no deja ningún sitio donde un profesional joven se equivoque barato, la empresa ha resuelto un problema de coste y ha creado un problema de sucesión.
El dato que mejor dimensiona esto viene del Stanford Digital Economy Lab, que usa nóminas reales en lugar de encuestas: el empleo de los jóvenes de veintidós a veinticinco años en las ocupaciones más expuestas a la inteligencia artificial está en torno a un diecinueve por ciento por debajo de lo que cabría esperar, y el ajuste se produce por dejar de contratar y no por despedir. Los propios autores insisten en que son patrones descriptivos y no estimaciones causales, y en que la cifra se ha movido entre revisiones del trabajo, así que conviene citarla con fecha y sin convertirla en una ley. La conexión con la supervisión, además, es un argumento nuestro y no un hallazgo suyo. Pero el argumento se sostiene solo: quien no contrata profesionales jóvenes hoy no tendrá dentro de cinco años a quien sepa auditar lo que hace el sistema, y para entonces habrá perdido también a los que sí sabían, por jubilación o por rotación.
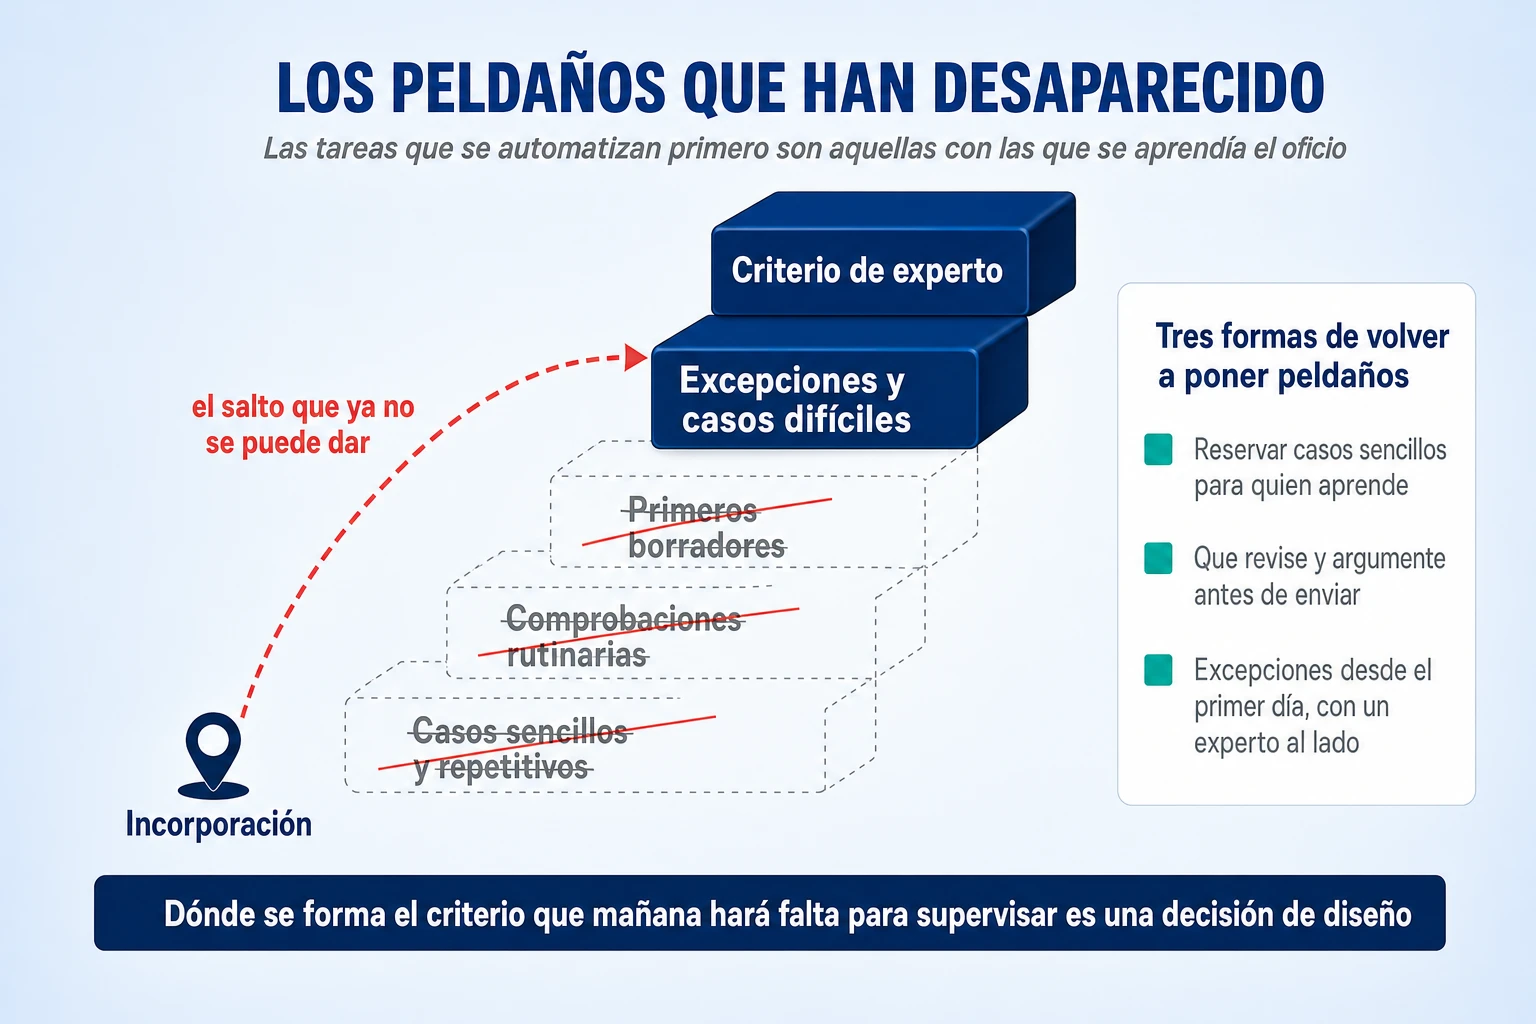
Lo importante es que esto no es un dilema moral sobre el empleo juvenil, aunque también lo sea. Es una decisión de diseño de procesos, y por eso pertenece a este artículo. Cuando se reparte el trabajo entre personas, automatización e inteligencia artificial, hay que añadir una tercera pregunta a las dos habituales. No basta con decidir qué hace cada uno y quién responde: hay que decidir también dónde se forma el criterio que mañana hará falta para supervisar. Eso puede significar reservar deliberadamente un porcentaje de casos sencillos para que los resuelva una persona que está aprendiendo, aunque la máquina los haría más barato; puede significar que el profesional joven revise y argumente el trabajo del sistema antes de que se envíe; o puede significar que su trabajo pase a ser la gestión de excepciones desde el primer día, con un experto al lado. Las tres opciones son defendibles y cuestan dinero. No decidir nada también cuesta, solo que la factura llega más tarde y a otro.
Shadow AI: cómo combinar seguridad, agilidad y descubrimiento de oportunidades
De todas las señales de la lista original, esta es la que mejor está formulada: un ciclo de revisión de seis meses no detiene la adopción, la empuja a la clandestinidad. Merece la pena entender por qué, porque la explicación no es la indisciplina de la gente. Un empleado tiene un problema que resolver hoy, tiene delante una herramienta que lo resuelve y tiene enfrente un procedimiento que tardará dos trimestres en decirle si puede usarla. En esa situación, la política de seguridad no está compitiendo con la comodidad: está compitiendo con el trabajo que esa persona tiene que entregar esta semana.
Sobre el tamaño del fenómeno circulan cifras que conviene no usar como si fueran una serie. Se repite que entre un tercio y dos tercios de los empleados usan inteligencia artificial no autorizada, pero ese rango no es un rango: son tres encuestas distintas, las tres de proveedores de tecnología, con poblaciones que no se parecen y preguntas que miden cosas distintas. Una pregunta a oficinistas de grandes corporaciones si han usado herramientas creyendo que la política lo prohibía; otra, a empleados de empresas medianas; otra, a profesionales de sectores regulados. Que las tres den cifras altas dice algo; que se puedan restar o comparar, no.
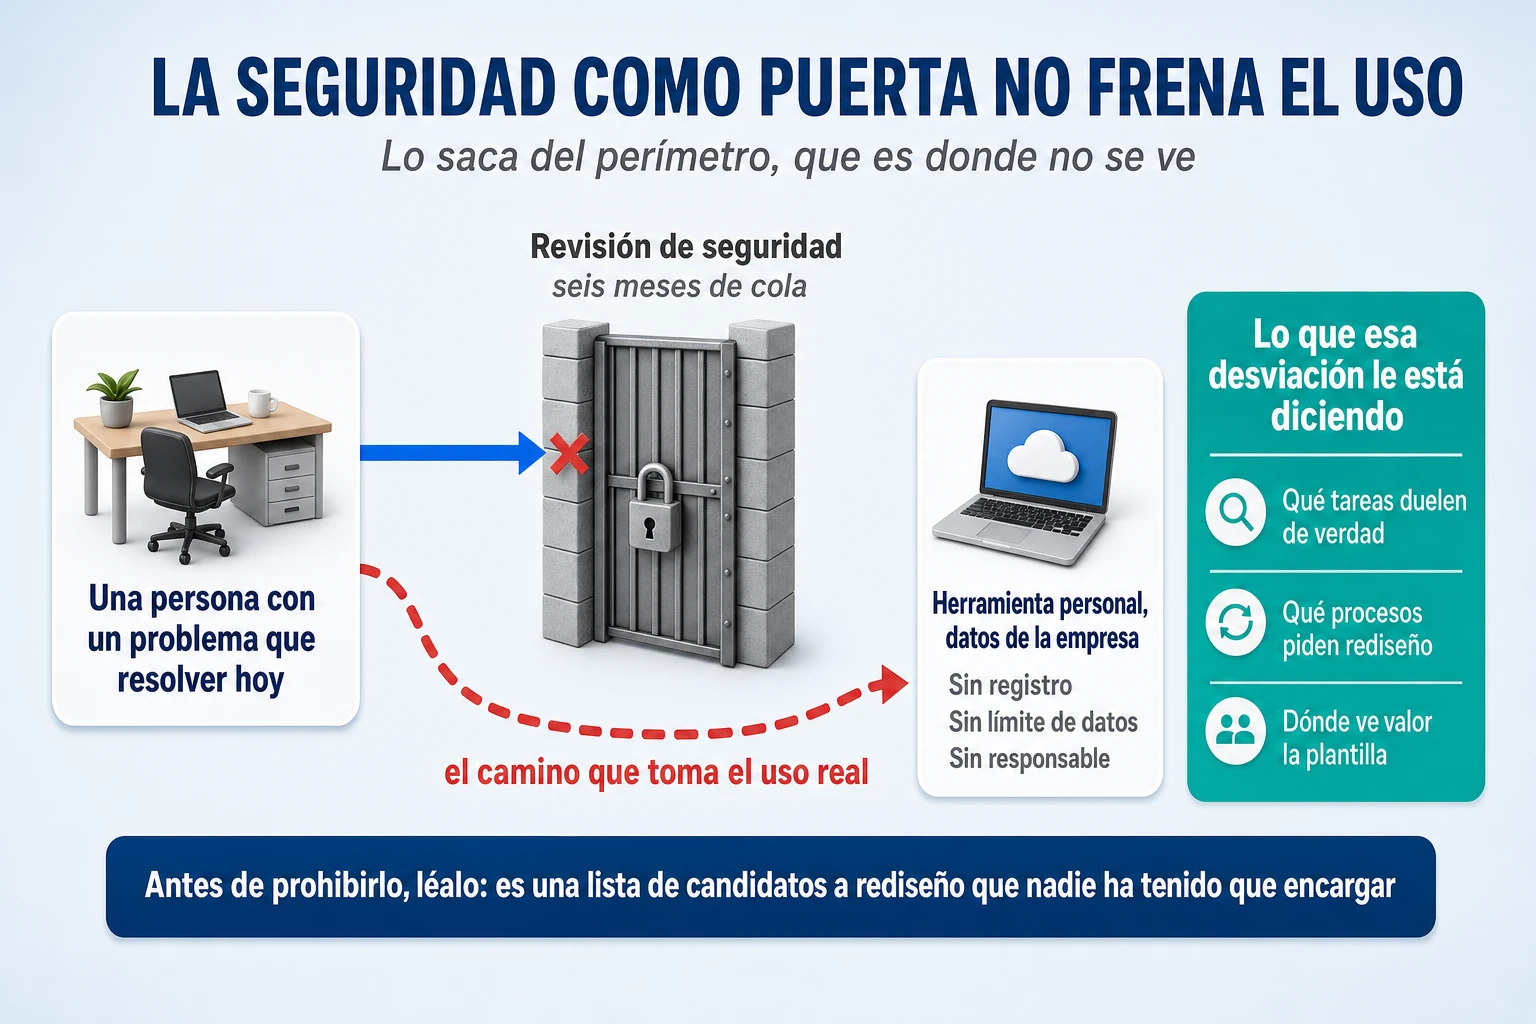
Lo interesante de ese uso no autorizado no es el riesgo, que es evidente y real: datos corporativos en un servicio que nadie ha revisado, sin registro de lo que se consultó y sin nadie que responda. Lo interesante es la información que contiene. La lista de lo que la gente está resolviendo por su cuenta es la mejor lista de candidatos a rediseño que una empresa puede tener, y nadie ha tenido que encargarla ni pagarla. Dice qué tareas duelen de verdad, con qué frecuencia y en qué momento del proceso, que es exactamente la información que falta cuando se elige un caso de uso en una sala de reuniones. Por eso el orden correcto es leerlo antes de prohibirlo: primero se pregunta qué se está resolviendo así y por qué, y después se decide qué se habilita de forma segura y qué se corta.
Convertir la seguridad en socio en lugar de en puerta no significa invitarla a las reuniones, que es la versión cosmética de esta recomendación. Significa tomar tres decisiones concretas. La primera es clasificar los casos por riesgo, criticidad y autonomía, porque no es lo mismo un sistema que consulta información que uno que puede cambiar precios, modificar contratos o ejecutar pagos: tratarlos con el mismo procedimiento garantiza que el primero vaya demasiado lento y el segundo demasiado rápido. La segunda es diseñar los controles dentro de la arquitectura y no al final del proyecto: permisos mínimos, identidad propia para cada sistema automático, límites de actuación declarados, trazabilidad completa y aprobación humana donde el riesgo lo justifique. Y la tercera es automatizar las comprobaciones, porque un control que depende de que alguien revise manualmente cada caso se convierte en una cola y la cola vuelve a producir el desvío que estábamos intentando evitar.
Conviene añadir una nota sobre lo que existe y lo que no en este terreno, porque hay mucha literatura y poca medición. Las recomendaciones sobre identidad y permisos de agentes —que cada uno tenga identidad propia en lugar de usar la credencial de una persona, que sus permisos se acoten al mínimo imprescindible, que su límite de actuación esté escrito y que quede rastro de la cadena completa de acciones— son consenso técnico razonable, no hallazgos con evidencia cuantitativa detrás. Hay que presentarlas como lo que son. Lo que sí es exigible y está escrito en norma es otra cosa, y de eso trata el apartado del gobierno mínimo.
Modelo operativo de IA: qué centralizar y qué dejar bajo responsabilidad del negocio
Una de las señales de la lista original describe un síntoma que cualquiera reconoce: la misma tecnología produce resultados muy distintos en dos equipos de la misma empresa, y al investigarlo se descubre que no había nada estandarizado. El diagnóstico es correcto. La conclusión que suele seguirle, en cambio, provoca el problema contrario, porque de ahí se salta casi siempre a que todas las áreas deben implantar exactamente la misma solución. Estandarizar no es uniformar: hay piezas que tienen que estar en el centro y decidirse una sola vez, y piezas que tienen que estar pegadas al negocio y decidirse una vez por área. Confundirlas cuesta caro en las dos direcciones.
Las piezas que van al centro comparten una característica: resolverlas dos veces no aporta nada y resolverlas mal una vez afecta a todos. La identidad y los permisos con los que actúa un sistema automático son el ejemplo más claro, porque de ellos depende qué puede tocar y en nombre de quién, y nadie quiere esa decisión repartida entre cinco áreas con criterios distintos. Lo mismo ocurre con el acceso y el gobierno del dato, con la plataforma de conectores e integraciones que permite que una capacidad construida para un proceso sirva en otro, con la observabilidad y la evaluación que detectan que algo se ha degradado, con el control del coste y con los principios de arquitectura que fijan cuánta autonomía puede concederse según el tipo de acción. Esa última pieza merece una nota: es una decisión de arquitectura corporativa, no una preferencia de cada equipo, y conviene tenerla escrita antes de que cada área la resuelva por su cuenta. Sobre cómo se construye esa capa común hay un artículo entero en este blog, y lo único que hace falta retener aquí es que es común por una razón económica, no por una preferencia de control.
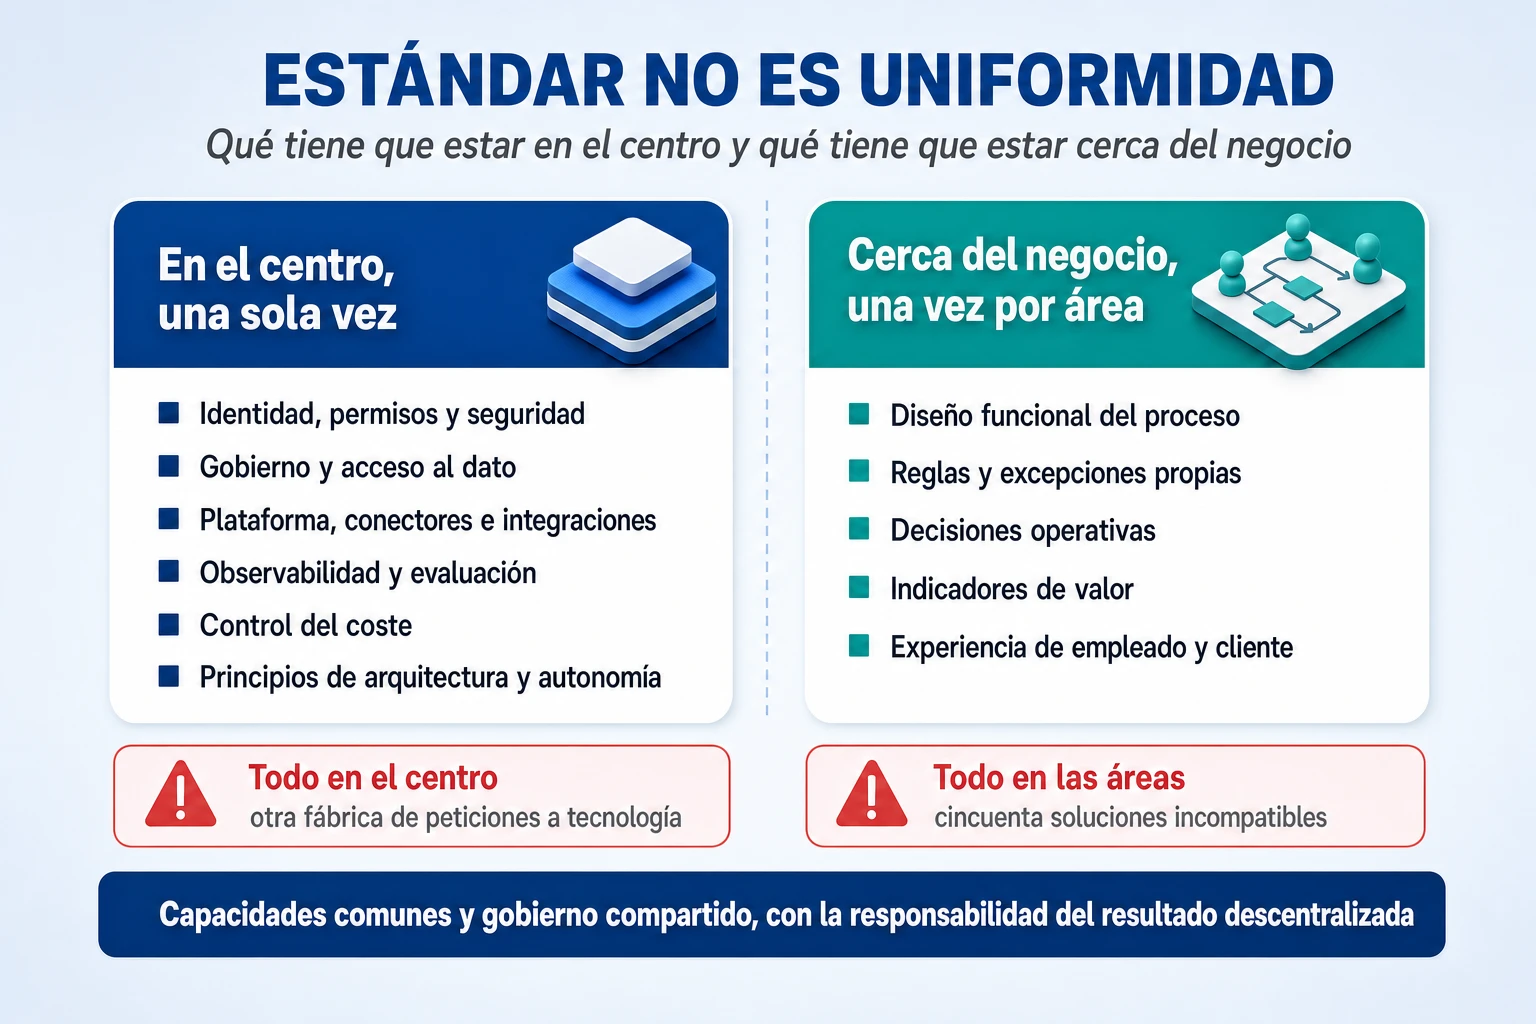
Las piezas que se quedan cerca del negocio comparten la característica opuesta: dependen de un conocimiento que no existe en el centro y cambian a un ritmo que el centro no puede seguir. El diseño funcional del proceso es la primera, porque nadie en una plataforma corporativa sabe qué excepciones tiene de verdad la facturación de un contrato de mantenimiento. También las reglas específicas y las excepciones de cada área, las decisiones operativas del día a día, los indicadores con los que esa área demuestra que ha mejorado, y la experiencia que acaban teniendo el empleado y el cliente, que es donde se nota si el rediseño era bueno o solo barato.
Los dos extremos fallan de forma reconocible y conviene saber a cuál se parece uno antes de corregir. Centralizarlo todo convierte al equipo de inteligencia artificial en otra fábrica de peticiones a tecnología, con una cola de meses, un comité de priorización y áreas de negocio que vuelven a hacer lo de siempre mientras esperan. Descentralizarlo todo produce cincuenta soluciones incompatibles que multiplican el coste, impiden reutilizar nada y hacen imposible saber cuánto se está gastando en total y qué está tocando cada sistema. La forma que funciona es intermedia y tiene nombre: capacidades comunes y gobierno compartido, con la responsabilidad del resultado descentralizada en quien responde del proceso.
Para saber si el reparto está bien hecho basta una prueba que cabe en una reunión. Elija una capacidad construida para un proceso concreto —extraer datos de un documento, clasificar una solicitud por riesgo, redactar una respuesta con el histórico del cliente— y pregunte cuánto tardaría otra área en usarla. Si la respuesta es que tendría que construirla de nuevo, lo que la empresa tiene son proyectos. Si la respuesta es que puede usarla pero necesita pedir permiso a un comité que se reúne cada tres semanas, lo que tiene es una fábrica de peticiones. Y si la respuesta es que puede usarla cambiando las reglas propias de su proceso, entonces el reparto está bien hecho y lo que la empresa tiene es una capacidad.
La nueva economía de la IA: del coste por licencia al coste por proceso
Durante treinta años el software empresarial se ha presupuestado igual: un precio por usuario y por mes, pactado en una negociación anual, que permite saber en enero lo que se va a gastar en diciembre. Con sistemas que ejecutan trabajo, esa unidad deja de funcionar. El coste deja de depender de cuánta gente tiene acceso y pasa a depender de cuánto trabajo se hace, de lo difícil que sea cada caso y de cuántas veces haya que reintentarlo. Es un cambio de naturaleza, no de tarifa, y afecta a quién tiene que presupuestar y con qué unidad.
El ejemplo más citado de lo que ocurre cuando no se ha hecho ese cambio es el de una gran empresa de transporte que agotó en cuatro meses su presupuesto anual de herramientas de inteligencia artificial para desarrollo y tuvo que imponer un tope mensual por empleado y herramienta. Lo interesante no es el tope, que es una medida razonable de emergencia. Lo interesante es la explicación que dio su propia dirección: resultaba muy difícil trazar una línea entre lo que se gastaba en inteligencia artificial y el valor que producía. Es decir, que el límite administrativo no vino de una decisión de economía unitaria, sino de la ausencia de una unidad con la que medir. Cuando no existe un coste por caso, lo único que se puede hacer con un gasto que crece es ponerle un techo arbitrario.
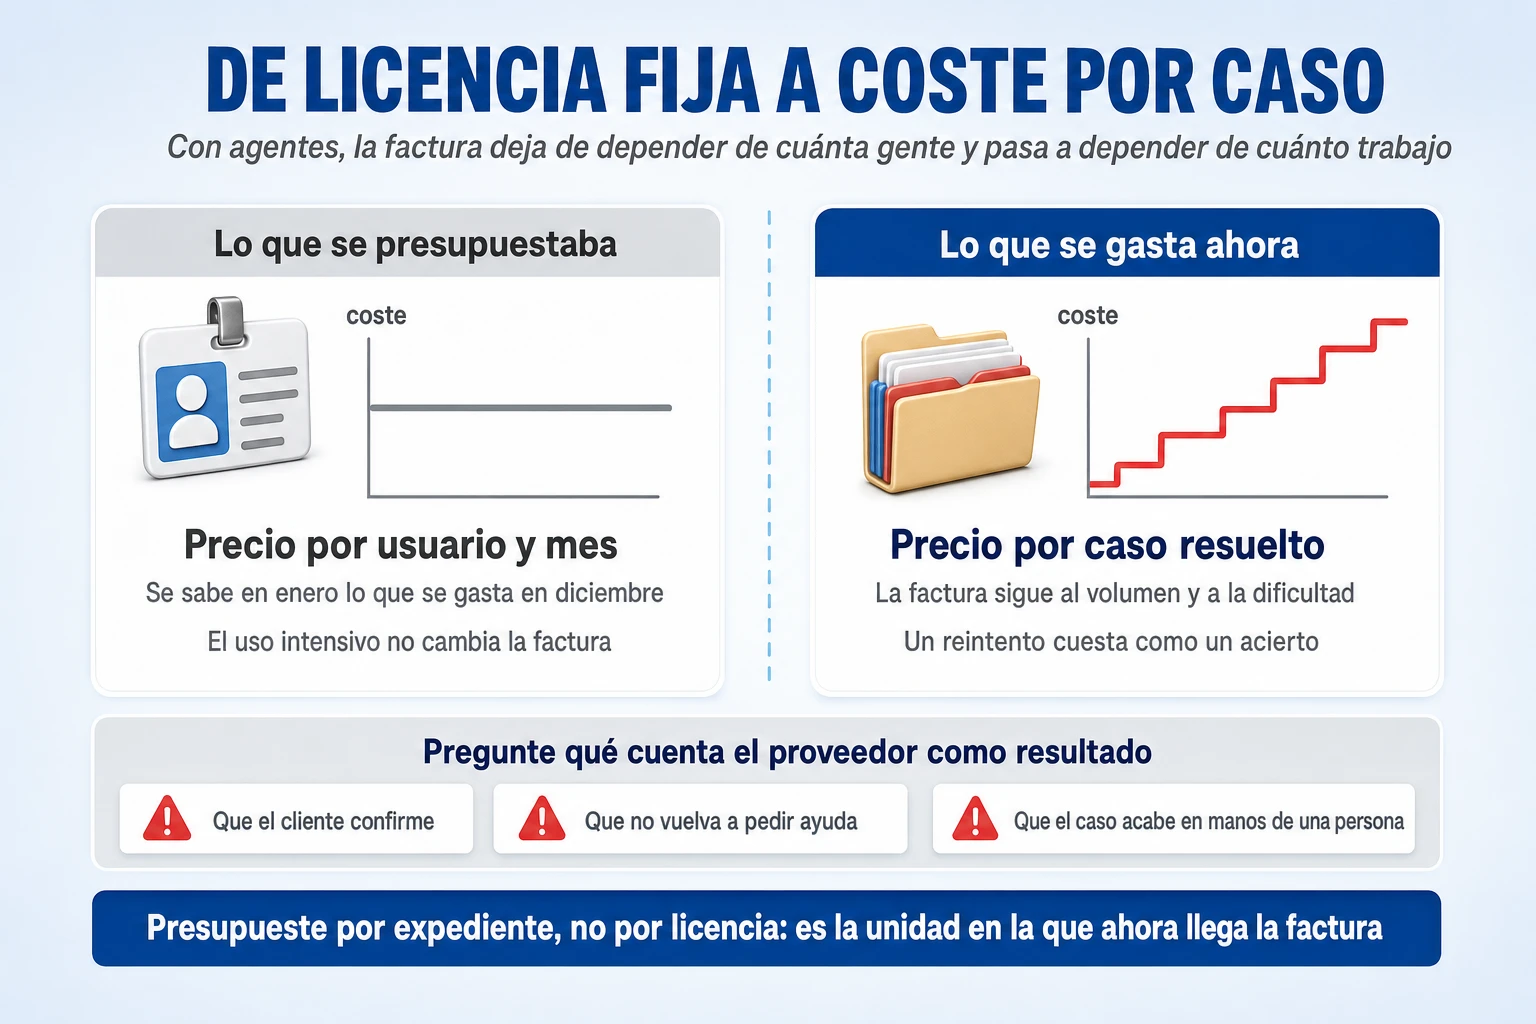
El mercado ya se está moviendo hacia esa unidad, y aquí hay que mirar la letra pequeña con mucha atención, porque la parte interesante de un precio por resultado es quién define el resultado. Un proveedor conocido de atención al cliente cobra alrededor de un dólar por resolución y considera resuelto, entre otros supuestos, que el cliente no vuelva a pedir ayuda después de la última respuesta del sistema; en otro de sus supuestos, el procedimiento se da por completado aunque termine traspasando el caso a una persona. Otro proveedor es bastante más estricto y solo cuenta la resolución si un segundo modelo verifica la transcripción y la conversación no se escaló, con ventanas de cierre distintas según el canal. Y un tercero directamente negocia por contrato qué cuenta como resultado. Dicho de otra manera: en algunos de estos modelos, el silencio del cliente factura exactamente igual que su satisfacción. Antes de firmar un precio por resultado hay que leer la definición, porque es ahí donde está el contrato de verdad.
Sobre la evolución del coste hay que deshacer un malentendido muy extendido, porque las dos afirmaciones contrarias que circulan son ciertas a la vez y se refieren a cosas distintas. A capacidad constante, es decir, para resolver lo mismo que se resolvía el año pasado, el precio cae de forma muy rápida, con factores de varias veces al año. Y al mismo tiempo, el precio de ejecutar lo más capaz que existe en cada momento sube, porque cada nueva frontera cuesta más de operar. Las dos cosas conviven, y la consecuencia práctica es que una solución bien diseñada se abarata sola con el tiempo y una solución que siempre usa el modelo más potente disponible no se abarata nunca. Conviene además no dar la bajada por garantizada: a fecha de este artículo, al menos un proveedor importante ha anunciado que duplica precios a partir de enero de 2027.
Queda la parte que casi ningún cálculo incluye y que suele ser mayor que el consumo de la tecnología. El coste de resolver un caso no es lo que cuesta la llamada al modelo: es eso más la supervisión humana que el diseño exige, más los reintentos cuando la respuesta no vale, más la evaluación periódica que comprueba que el sistema sigue funcionando, más el mantenimiento cuando cambia una integración o una regla, más el soporte cuando algo se rompe, más la corrección de los errores que llegan al cliente. Un sistema con un coste de inferencia bajísimo y una tasa de revisión del cien por cien puede ser más caro que el proceso anterior, y eso no se ve en ninguna factura de proveedor.
De ahí sale la recomendación, que es sencilla de enunciar y exige disciplina: presupuestar por unidad de proceso en lugar de por herramienta o por usuario. Cuánto cuesta tramitar una factura, resolver un expediente, procesar un pedido. Con esa unidad se puede contestar la única pregunta que de verdad importa en la revisión anual, que es si el gasto crece con el valor o solo con el consumo. Y se puede contestar también la que viene después y que decide si el programa sigue: si ese coste por caso baja cuando el volumen sube. Si no baja, lo que hay no es una capacidad: es una subcontratación con tarifa variable.
Gobierno de la IA: responsabilidades, niveles de autonomía, controles y cumplimiento
La palabra gobierno asusta en una empresa mediana porque suena a comité nuevo, a política de veinte páginas y a una reunión mensual que nadie quiere. El gobierno mínimo que de verdad hace falta es mucho más modesto y cabe en una página: una tabla donde cada automatización tenga escrito qué hace, qué datos toca, qué puede decidir sola, en qué umbral pasa el caso a una persona, quién responde cuando se equivoca y cuándo se revisó por última vez. No hace falta nada más para empezar, y casi ninguna empresa lo tiene.
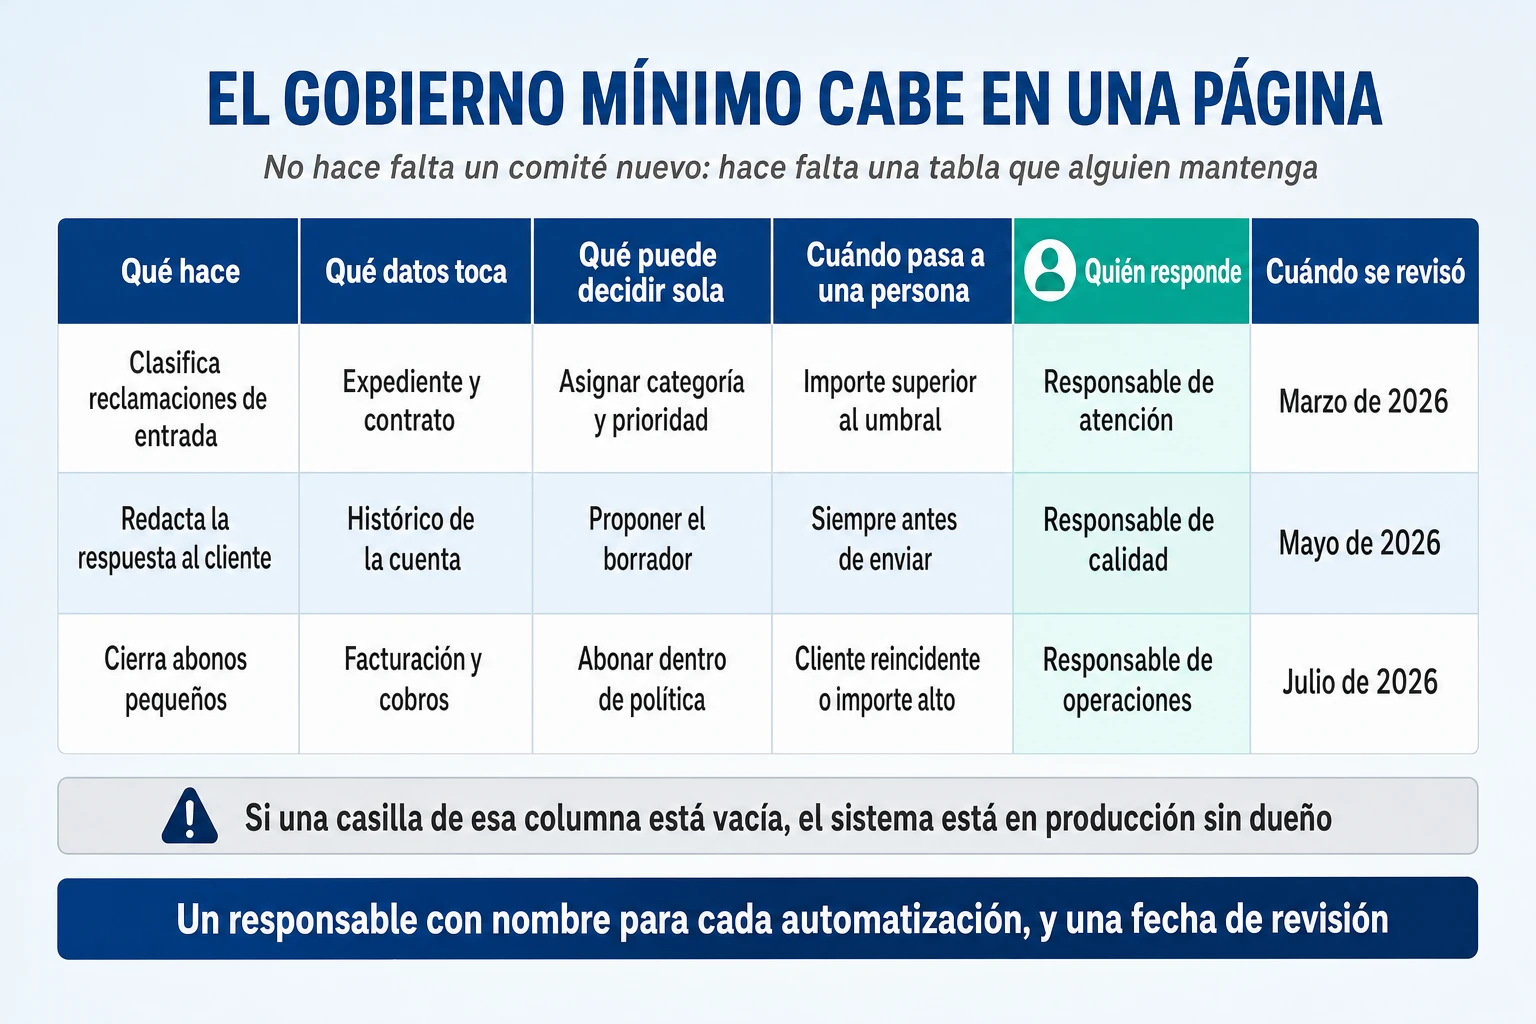
Sobre el estado real de esto hay encuestas que conviene leer por lo que enseñan y no por el porcentaje. Las que publican los proveedores de servicios dicen que cerca de ocho de cada diez directivos operan hoy sus sistemas automáticos con aprobación humana sobre la mayoría de las acciones, y que solo una minoría pequeña declara tener un modelo de gobierno maduro. Son autodeclaraciones de directivos con el nombre del patrocinador en la portada y sin una definición comprobable de qué es maduro, así que no sirven como prueba de nada. Lo que sí sirve es el inventario de lo que falta, porque ese sí se puede verificar en cualquier empresa en una tarde: la mayoría de los sistemas en producción no tienen identidad propia, nadie vigila su comportamiento de forma sistemática y no queda rastro completo de lo que han hecho. Esas tres carencias no exigen un programa de gobierno para corregirse. Exigen tres columnas de una tabla.
Empuja en la misma dirección un calendario que conviene tener bien, porque las fechas que circulan por internet están mal con bastante frecuencia. El ómnibus digital europeo sobre inteligencia artificial, el Reglamento (UE) 2026/1744, adoptado el 8 de julio de 2026 y en vigor desde el 27 del mismo mes, aplazó las obligaciones de alto riesgo: al 2 de diciembre de 2027 para los sistemas del anexo III, entre los que están los de selección y gestión de personas, y al 2 de agosto de 2028 para los del anexo I. Lo que no se aplazó es lo que más gente da por aplazado: las obligaciones de transparencia rigen desde el 2 de agosto de 2026, con un techo de sanción de quince millones de euros o el tres por ciento del volumen de negocio mundial, el mayor de los dos. Y hay un matiz que casi nadie cuenta y que a una empresa mediana le importa: para las pymes el criterio se invierte y se aplica el menor de los dos. El aplazamiento, además, no suspende la protección de datos ni los derechos de información de la representación de los trabajadores, de modo que quien tenga inteligencia artificial metida en un proceso de personas tiene obligaciones hoy, no en 2027.
Lo sensato con ese plazo no es esperar sino usarlo, y el trabajo que hay que hacer es exactamente el inventario de antes. Saber qué sistemas de inteligencia artificial hay metidos en procesos de personas, asignarle un responsable a cada uno, documentar cómo funciona la supervisión humana y conservar los registros de funcionamiento —la norma habla de un periodo adecuado y de al menos seis meses para los sistemas de alto riesgo— es trabajo de meses, no de semanas, y quien lo empiece en otoño de 2027 llegará tarde.
Una última precisión sobre los marcos, porque se citan de forma intercambiable y no lo son. El marco de gestión de riesgos de inteligencia artificial del NIST, el estadounidense de las cuatro funciones, es una referencia voluntaria, sigue en su versión de 2023, no es certificable y está en revisión sin fecha anunciada: sirve para organizar el pensamiento y no para demostrar nada ante un cliente o un auditor. La norma ISO/IEC 42001 sí da certificado, con un circuito de acreditación que solo lleva operativo desde principios de 2026. Si lo que se busca es orden interno, el primero vale y es gratis; si lo que se busca es poder enseñar algo a un tercero, hace falta el segundo. Confundirlos lleva a presentaciones donde una empresa dice estar alineada con un marco voluntario como si eso fuera una acreditación.
Queda la prueba más simple de todas, y cierra este apartado mejor que cualquier recomendación. Coja su inventario, si lo tiene, y mire la columna de quién responde. Si hay una casilla vacía, hay un sistema en producción sin dueño, y el día que se equivoque la conversación no será sobre tecnología.
Cómo escalar la IA: de proyectos aislados a capacidades empresariales reutilizables
La señal original dice que hay que documentar antes de escalar, porque de lo contrario el segundo equipo reaprende todo lo que el primero ya había resuelto. El diagnóstico vuelve a ser correcto y el remedio vuelve a quedarse corto, porque la documentación por sí sola casi nunca produce reproducibilidad. Cualquiera que haya heredado un proyecto ajeno lo sabe: el documento explica qué se hizo y rara vez explica qué se probó y no funcionó, que es justo lo que necesita el que viene detrás. Lo que permite escalar no es haber escrito el procedimiento, es que exista algo construido que la siguiente área pueda usar sin volver a construirlo.
Conviene ser concreto sobre qué es ese «algo», porque la palabra reutilizable se usa para muchas cosas distintas. Hay siete tipos de pieza que deberían sobrevivir al proyecto que las produjo. Los patrones de proceso, con las decisiones que se tomaron y, sobre todo, las excepciones que rompían el flujo. Los componentes técnicos: conectores a los sistemas corporativos, servicios y piezas que ya tienen permisos resueltos. El conocimiento del negocio convertido en algo consultable: reglas, taxonomías, el contexto que hace que una solicitud de un cliente grande no se trate igual que la de uno pequeño. Los controles de seguridad y las políticas de permisos, que son caros de diseñar y baratos de copiar. Las pruebas y los criterios de aceptación, que es la pieza que más se pierde y la que más tiempo ahorra. La operación: cómo se vigila, quién da soporte y cómo se gestiona una incidencia. Y la parte de cambio, que son las guías y la formación por puesto que ya se escribieron una vez.
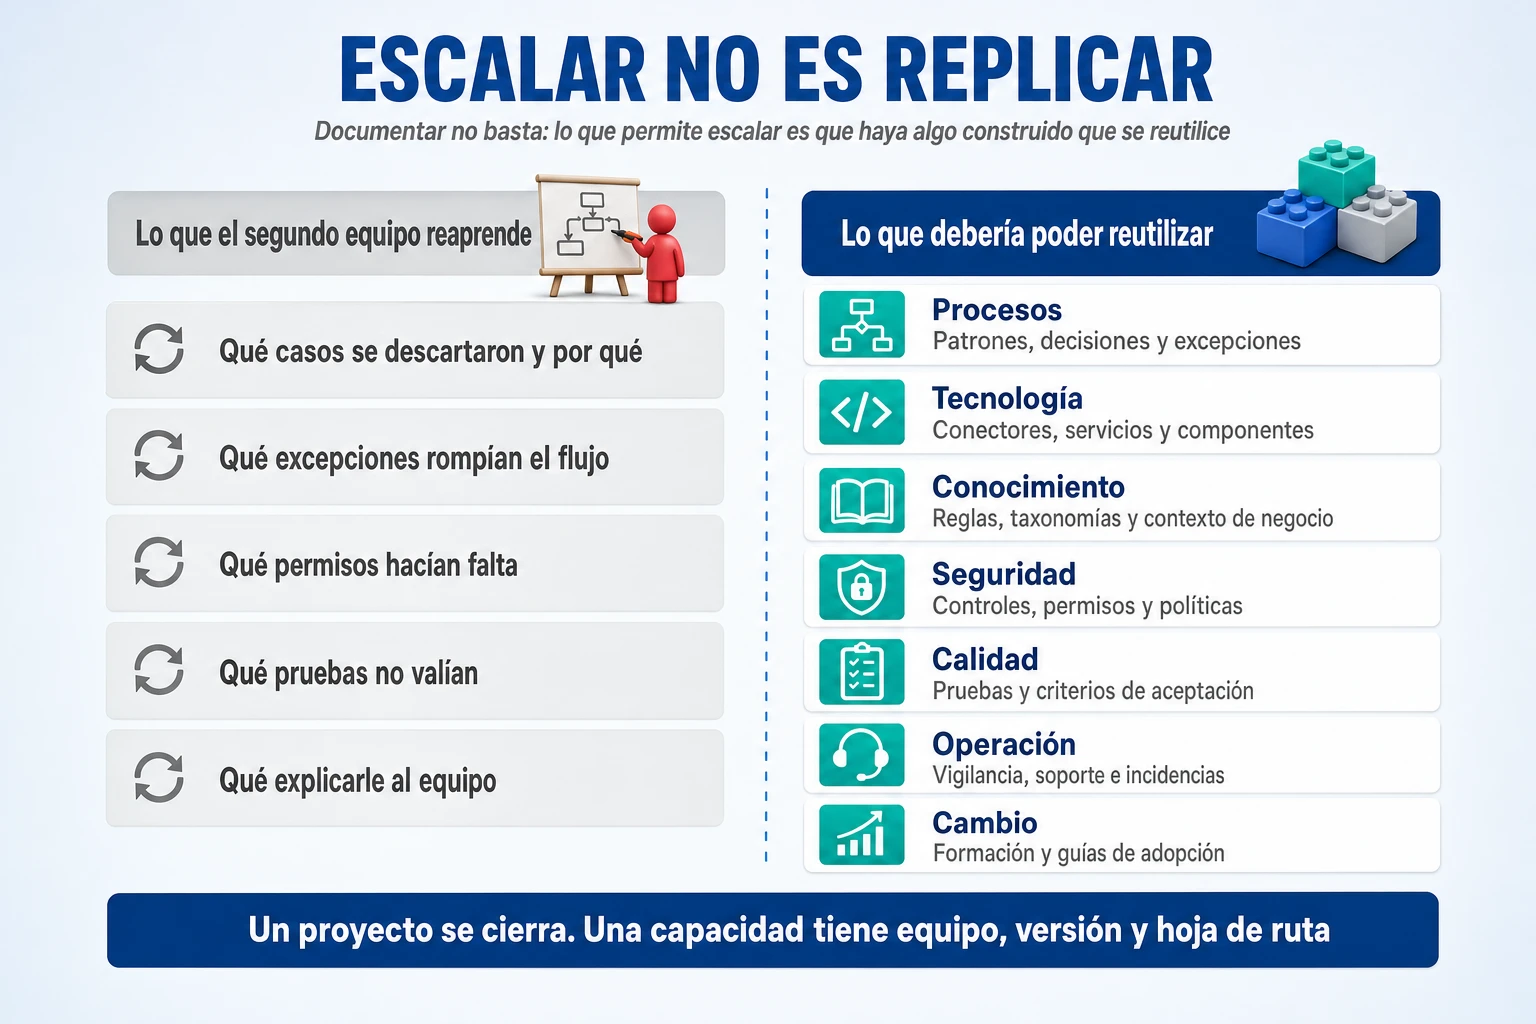
El problema es que ninguna de esas siete piezas se produce sola, y un proyecto que se cierra no tiene ningún incentivo para producirlas. Empaquetar un conector para que lo use otra área cuesta tiempo que no mejora el resultado del proyecto que lo paga, y escribir por qué se descartó una alternativa no entra en el acta de cierre de nadie. Por eso el salto de escala casi nunca es un problema de voluntad: es que la unidad de gestión equivocada hace que lo reutilizable sea siempre trabajo extra para alguien que no se beneficia de él. Mientras la empresa gestione iniciativas de inteligencia artificial como una sucesión de proyectos independientes, cada uno competirá por los mismos recursos, reaprenderá lo mismo y contabilizará beneficios que en parte ya se habían contado.
La alternativa tiene nombre conocido y es menos exótica de lo que parece: tratar las capacidades como un producto, con un equipo que responde de su evolución, una versión, una hoja de ruta y usuarios internos que piden cosas. Eso no significa montar una estructura nueva ni rebautizar la oficina de proyectos. Significa que cuando el primer rediseño termina, alguien se queda con las piezas, las mantiene y responde de que sigan funcionando cuando cambie el modelo, el sistema de gestión o la normativa. Es exactamente la diferencia entre haber hecho un proyecto y haber construido una capacidad, y es el mismo razonamiento que ordena la arquitectura de un sistema empresarial inteligente.
Comprobar si esto está ocurriendo es barato y no requiere ninguna auditoría. Mire cuánto tardó la primera área en tener su primer resultado útil y cuánto tardó la segunda. Si los dos plazos se parecen, no se escaló nada: se hicieron dos proyectos. Si el segundo es sensiblemente más corto, hay una capacidad detrás, y entonces merece la pena medir también el tercero, porque la curva que de verdad importa es la que baja con cada repetición. El indicador de que una empresa ha aprendido a implantar inteligencia artificial no es cuántos casos tiene en producción: es cuánto le cuesta el siguiente.
Cómo financiar las transformaciones con IA: hitos, curva de inversión y criterios de continuidad
La última señal de la lista original es la más fácil de aceptar y la más peligrosa de aceptar sin matices. Dice que los consejos de administración retiran la financiación justo antes de que aparezca el retorno, y propone como remedio nombrar el valle antes de que lo descubran por su cuenta. La primera parte es cierta y tiene una explicación que no es la cobardía del consejo: un rediseño paga por adelantado el aprendizaje, la integración, la seguridad y la adaptación de las personas, y durante ese tramo la organización puede ser temporalmente menos productiva que antes, porque está haciendo dos cosas a la vez, el trabajo de siempre y el trabajo de aprender a hacerlo de otra manera. La curva en jota existe y conviene anticiparla.
El problema está en el remedio, porque anunciar el valle por adelantado es también la mejor forma de blindar durante dieciocho meses una iniciativa que simplemente no funciona. No toda inversión que pierde dinero está atravesando una curva en jota: algunas destruyen valor, y las diapositivas son magníficas en los dos casos. Al principio las dos curvas son indistinguibles, que es precisamente lo que hace que el argumento del valle sea tan cómodo para quien lo invoca y tan difícil de rebatir para quien escucha.
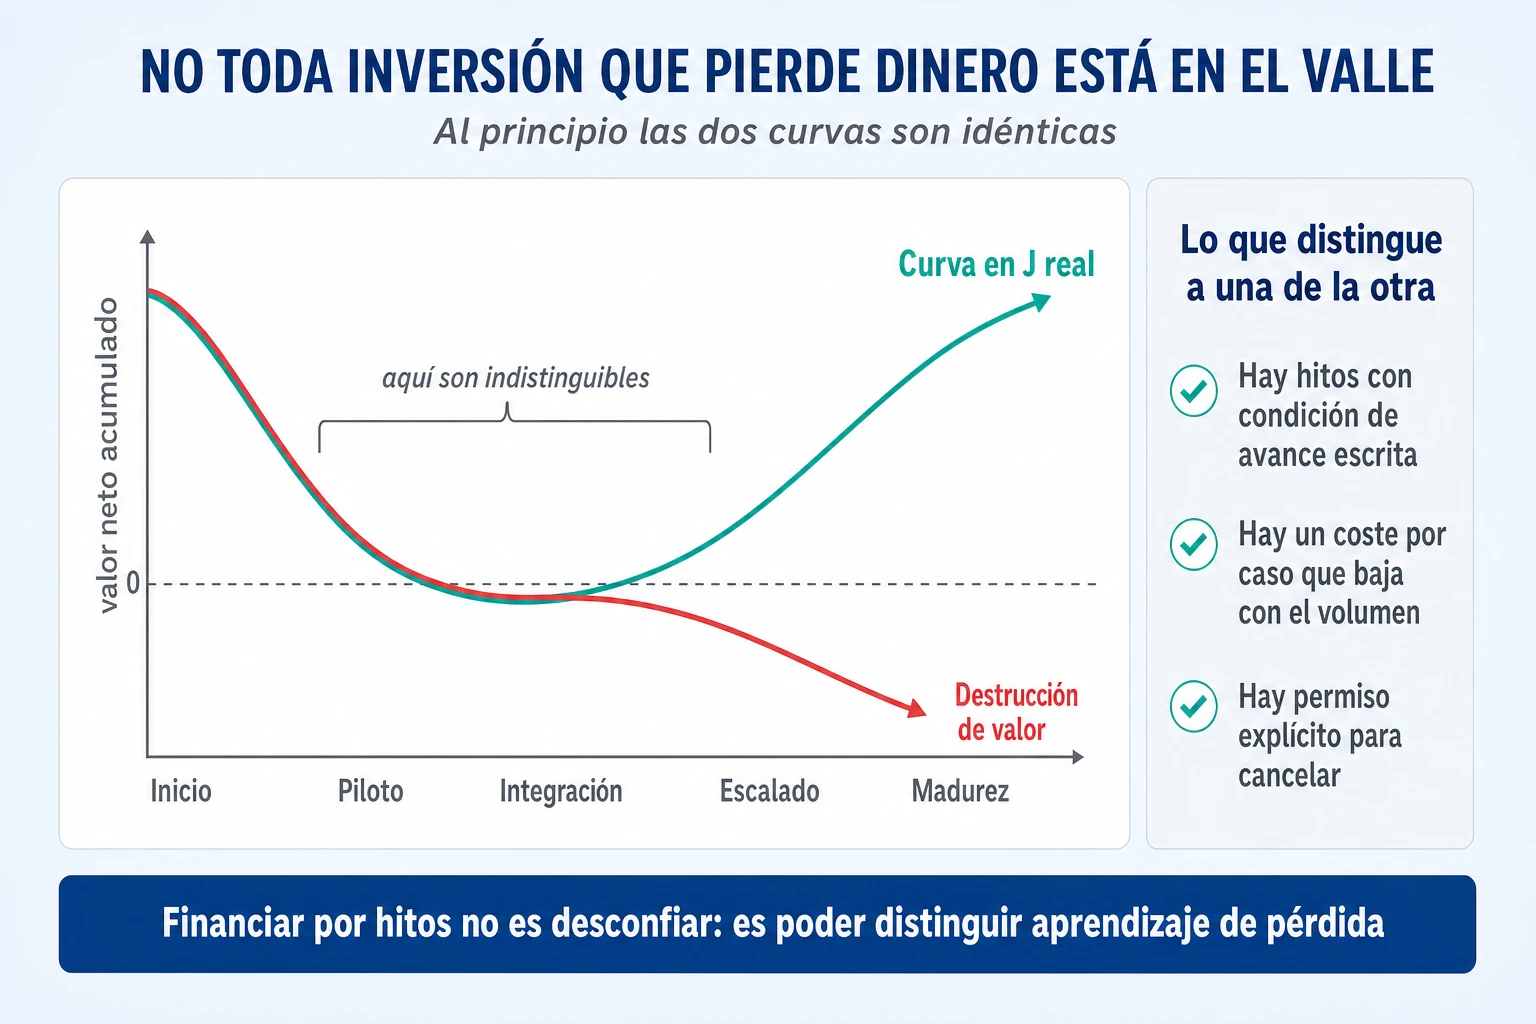
Se pueden distinguir sin esperar al final, y no consiste en pedir retorno antes de tiempo. Consiste en financiar por tramos con una condición de avance escrita antes de empezar cada uno. El primer tramo comprueba viabilidad y potencial económico, y su condición de avance es que exista un cálculo creíble de cuánto valdría el resultado completo. El segundo demuestra estabilidad operativa y un coste por caso sostenible, y su condición es que ese coste exista y esté medido, no estimado. El tercero multiplica resultados ya contrastados, y su condición es que la segunda área tarde menos que la primera. El cuarto sigue mejorando la solución y el proceso, y ya no es un proyecto: es operación. En cada tramo tiene que ser posible continuar, rediseñar o cancelar, y la palabra que falta en casi todos los comités es la tercera, porque un programa que no puede cancelarse no está siendo dirigido, solo está siendo financiado.
Esto le pide algo a las dos partes, y conviene decir las dos. Al patrocinador le pide que no exija un retorno plenamente materializado mientras todavía se está construyendo la capacidad, porque esa exigencia produce exactamente los pilotos cosméticos que luego se citan como prueba de que la inteligencia artificial no funciona. Y al responsable del programa le pide que acepte que el valle no es un salvoconducto: si al terminar el segundo tramo no hay un coste por caso medido y una comparación contra la línea base, lo que hay no es un valle, es una pérdida.
Queda una pregunta que casi nunca se hace y que ordena todas las demás: cuándo se para. Es una pregunta rara en las empresas grandes, donde es fácil recordar programas que se retrasaron o que cambiaron de alcance y muy difícil recordar uno que se detuviera porque su valor esperado hubiera dejado de estar claro. Esa dificultad para parar no es exclusiva de la inteligencia artificial, pero aquí hace más daño que en otros sitios, porque la tecnología cambia lo bastante deprisa como para que un rediseño largo pueda quedar desfasado antes de recuperar la inversión. Conviene por eso fijar desde el principio no solo los hitos de avance, sino la señal concreta que obligaría a replantear el diseño entero: un cambio de coste de un orden de magnitud, una capacidad nueva que hace innecesaria media solución, o un volumen que se multiplica y rompe los supuestos. Nombrar esa señal al empezar es mucho más útil que nombrar el valle, porque el valle solo pide paciencia y la señal pide una decisión.
Las diecisiete señales de errores de implantación: causas, responsables y cómo detectarlas
Esta es la tabla que la lista original no trae y que convierte un inventario de alertas en algo que se puede usar en una revisión de programa. Cada fila tiene la señal tal como se observa, el mecanismo que la produce, quién debería responder de que no ocurra y, lo más útil de todo, la pregunta que la detecta antes de que haya consecuencias. Las cinco últimas filas no estaban en la lista de doce y en la práctica cuestan tanto o más que las que sí estaban.
| La señal | El mecanismo que la produce | Quién responde | La pregunta que la detecta |
| Se financia antes de acordar qué es el éxito | Se aprueba un presupuesto en lugar de un resultado con dueño | Comité de dirección | ¿Qué indicador de qué área vamos a dar por bueno aunque empeore? |
| El proyecto se queda en la asistencia individual | El entregable era una herramienta, no un reparto distinto del trabajo | Dueño del proceso | ¿Qué paso del proceso ha dejado de existir? |
| El piloto se confunde con una prueba | Se probó para enseñar que puede funcionar, no para descubrir cuándo deja de funcionar | Dueño del proceso y operación | ¿Con qué casos difíciles se probó y cuáles fallaron? |
| Se mide la adopción en lugar del resultado | Se mide lo que se compró, que es acceso, y no lo que se quiso cambiar | Dirección y finanzas | ¿Cuánto cuesta y cuánto tarda hoy un caso frente a la línea base? |
| La prueba la hace quien estaba disponible | Se trató como un despliegue, y un despliegue no necesita conocer el proceso | Dueño del proceso | ¿Quién del equipo conoce las excepciones reales de este proceso? |
| Se automatiza lo que se puede, no lo que limita | El punto lo eligió la facilidad técnica o la demostración del proveedor | Dueño del proceso | ¿Qué parte del plazo total ocupa lo que vamos a automatizar? |
| Se infravalora la resistencia | Se trató como adopción de una herramienta y es un cambio de competencia, poder y responsabilidad | Dirección, personas y dueño del proceso | ¿Quién pierde capacidad de decidir con este diseño? |
| La seguridad actúa como puerta | El control se puso al final en lugar de dentro del flujo | Seguridad y arquitectura | ¿Cuánto tarda hoy una autorización y qué hace la gente mientras espera? |
| Faltan guardarraíles | Nadie decidió qué se estandariza y qué se deja a cada área | Arquitectura corporativa | ¿Qué dos equipos han resuelto lo mismo de forma distinta? |
| Se celebra un buen sprint | Se confundió un dato con un patrón y se fijó un número de ciclos en vez de una condición | Operación | ¿Cuántos casos representativos ha atravesado y con cuánta variación? |
| Se escala antes de codificar | El proyecto se cerró y nadie se quedó con las piezas | Responsable de la capacidad | ¿Cuánto tardó la segunda área frente a la primera? |
| Se lee mal la curva de inversión | Se financió como una compra, sin condición de avance escrita | Patrocinador y finanzas | ¿Qué tendría que ocurrir para que canceláramos esto? |
| El sistema no tiene el contexto del negocio | Se dio por hecho que el modelo conocería las reglas y las relaciones de la empresa | Gobierno del dato y negocio | ¿De dónde saca el sistema la versión vigente de esa regla? |
| Nadie vigila el sistema en producción | Se entregó como un producto terminado y no como algo que se degrada | Operación | ¿Cómo nos enteraríamos de que ha empeorado? |
| No se rediseña la organización | Cambió el trabajo y no cambiaron puestos, supervisión ni estructura | Dirección y personas | ¿Qué puesto es hoy distinto de como era hace un año? |
| No se conoce el coste de resolver un caso | Se presupuestó por herramienta o por usuario y el coste real es por caso | Finanzas y dueño del proceso | ¿Cuánto cuesta un caso y cómo cambia ese coste con el volumen? |
| Hay una cartera de proyectos donde hace falta un sistema de capacidades | Cada iniciativa se aprueba sola y compite por los mismos recursos | Dirección y oficina de transformación | ¿Qué comparten entre sí los casos de uso que tenemos aprobados? |
No todas pesan igual ni hay que abordarlas a la vez, y conviene decir cuáles irían primero. Las críticas son las que determinan si se está resolviendo el problema correcto y si el valor llega a alguna parte: qué se considera éxito, qué se mide, dónde se pone la tecnología y cuánto cuesta resolver un caso. Si esas cuatro están mal, ninguna excelencia de ejecución lo compensa. Las muy altas son las que deciden si el programa puede llegar a producción y sostenerse: cómo se prueba, cómo entra la seguridad y cómo se financia. Las altas condicionan el cambio organizativo y la escalabilidad: la resistencia, los estándares y la codificación. Y las contextuales influyen en la ejecución, pero su importancia depende mucho del caso: quién hace la prueba, cuántos ciclos se esperan y hasta dónde llega la autonomía.
Esa prioridad es de gestión y no es un modelo universal de riesgo, y conviene no leerla como si lo fuera. Para un sistema que ejecuta transacciones sensibles, la seguridad deja de ser una señal de segundo nivel y pasa a ser la primera condición de viabilidad, porque un solo incidente cierra el programa entero con independencia de lo bien que estuviera medido todo lo demás. La tabla ordena dónde mirar primero cuando todo parece ir bien; no sustituye al criterio sobre qué puede salir mal en un proceso concreto.
Caso práctico: automatización de tareas frente a reingeniería integral con IA
Todo lo anterior se entiende mejor aplicado a un caso, así que vale la pena volver a la empresa del principio y llevarla hasta el final por los dos caminos. Es una empresa de servicios que gestiona diez mil reclamaciones al mes, tarda una media de seis días y medio en resolverlas y reabre o corrige el quince por ciento. Los números son ilustrativos y están ahí para enseñar el mecanismo, no para prometer un resultado.
El camino que probablemente fracase empieza con una decisión razonable. La empresa compra licencias de inteligencia artificial generativa para los agentes de atención, que son quienes más escriben y quienes antes notan la ayuda. Los agentes redactan las respuestas más deprisa, los resúmenes de conversación salen solos, la satisfacción interna sube y la adopción llega al ochenta y cinco por ciento. El proyecto se declara un éxito y se aprueba la extensión a otras áreas. Mientras tanto, la reclamación sigue esperando la misma aprobación de siempre, sigue circulando entre los mismos tres departamentos y sigue acumulando los mismos errores de información que obligan a volver atrás. El plazo total apenas se mueve, y nadie lo ve porque el plazo total no estaba en el cuadro de mando del proyecto.
El camino del rediseño empieza en otro sitio: no en qué herramienta comprar, sino en cómo debería funcionar este proceso si se diseñara hoy desde cero. De esa pregunta sale un flujo con cuatro tramos en lugar de seis. En la entrada, el sistema interpreta la reclamación, extrae lo que hace falta y detecta qué información falta antes de que el caso empiece a circular, que es cuando ese hueco cuesta barato. Después, la validación consulta los sistemas corporativos y comprueba las evidencias con reglas y conexiones de siempre, sin inteligencia artificial, porque son comprobaciones deterministas y meterle un modelo encima sería más caro y menos fiable. El tercer tramo clasifica por riesgo y complejidad, y es donde está la decisión de diseño que de verdad cambia el resultado: los casos rutinarios se resuelven de forma automática dentro de una política escrita, y los casos ambiguos o de alto impacto van a un especialista con el expediente ya preparado y con capacidad real de decidir. El cuarto actualiza los sistemas, informa al cliente y vigila errores, excepciones y resultados.
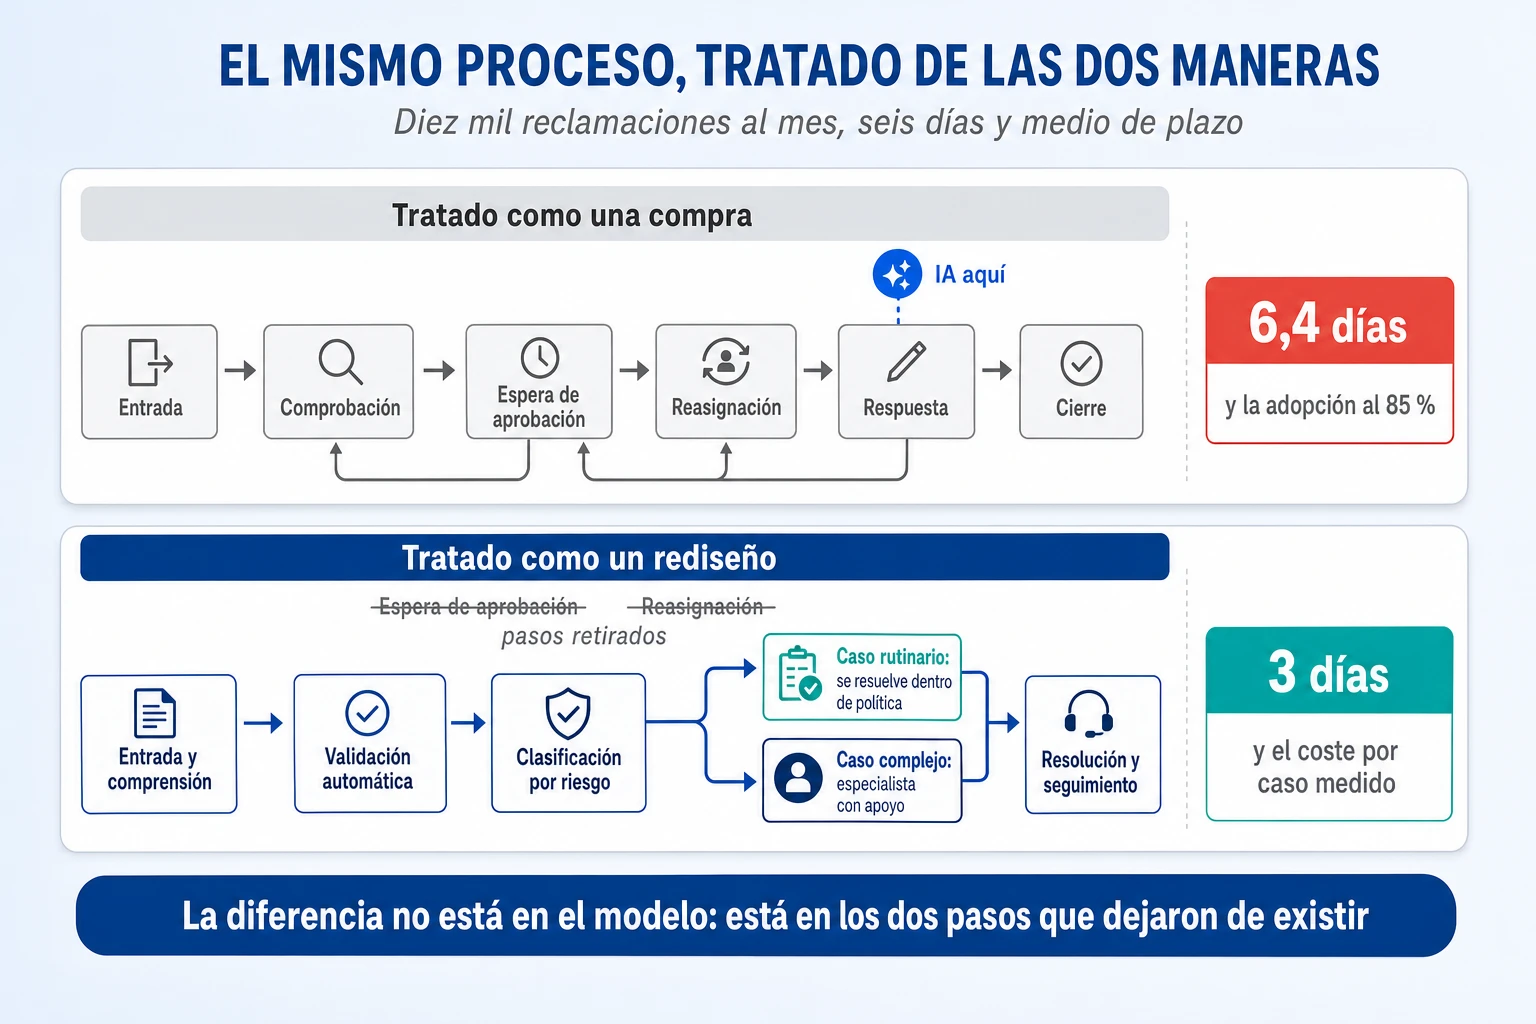
Merece la pena detenerse en qué ha cambiado de verdad, porque no es lo que parece desde fuera. No se ha automatizado la redacción: se han cuestionado validaciones que nadie recordaba por qué existían, se han eliminado traspasos entre departamentos, se han redistribuido decisiones hacia donde está la información y se ha escrito una política que dice qué puede resolverse sin que intervenga una persona. La inteligencia artificial se ha usado donde hacía falta capacidad de interpretación, la automatización de siempre donde hay reglas estables, y las personas donde hace falta juicio, negociación o responsabilidad. Esa asignación es el rediseño; lo demás es instalación. Hay un artículo entero dedicado a este tipo de reingeniería para quien quiera el detalle de cómo se hace.
La última pieza es cómo se comprobaría que ha salido bien, y aquí es donde el aparato de gestión se nota más. Un proyecto de compra habría cerrado con la adopción y la satisfacción interna. Un rediseño cierra cada hito contra un cuadro que tiene línea base, objetivo y forma de medirlo.
| Indicador | Situación de partida | Objetivo |
| Plazo de punta a punta | Seis días y medio | Tres días |
| Reaperturas y correcciones | Quince por ciento | Siete por ciento |
| Coste por caso | Índice cien | Índice ochenta |
| Casos sencillos resueltos sin intervención humana | Pendiente de medir | La mitad |
| Decisiones tomadas fuera de política | Línea base por establecer | Ninguna admisible |
| Capacidad liberada y su destino | No se mide | Declarado antes de empezar |
Dos advertencias sobre ese cuadro, porque sin ellas se convierte en otra diapositiva optimista. La primera es que las mejoras hay que comprobarlas con una comparación honesta y no atribuyendo a la inteligencia artificial cualquier variación de rendimiento que coincida en el tiempo; más adelante hay un apartado entero sobre cómo se hace eso en una empresa normal. La segunda es que los objetivos tienen que seguir cumpliéndose después de escalar, y la experiencia dice que es en ese momento cuando aparecen los casos raros que el piloto no vio. Un rediseño que funciona en el primer área y se degrada en la segunda no ha fracasado al escalar: ha descubierto tarde que lo que funcionaba era el equipo, no el diseño.
Qué hacer en los próximos noventa días
Todo lo anterior se puede convertir en cinco movimientos que caben en un trimestre, y antes de empezar hay que decir lo que tienen en común: ninguno de los cinco exige comprar nada nuevo. Si su empresa ya tiene licencias desplegadas, ya tiene todo lo que hace falta para hacer esto; y si no las tiene, hacer esto primero le va a ahorrar comprar las que no necesita.
El primer movimiento es medir un proceso, uno solo, el que más duela. No hace falta un proyecto de minería de procesos ni un proveedor: hacen falta tres números que el sistema de gestión ya tiene y que alguien puede extraer en una tarde. El plazo medio y el mediano de un caso, porque la diferencia entre los dos ya dice mucho. El mayor hueco entre dos eventos consecutivos y a qué porcentaje de casos afecta. Y qué porcentaje de casos tiene al menos un paso hacia atrás. Con esos tres números se tiene una conversación completamente distinta de la que se tiene con una presentación de proveedor.
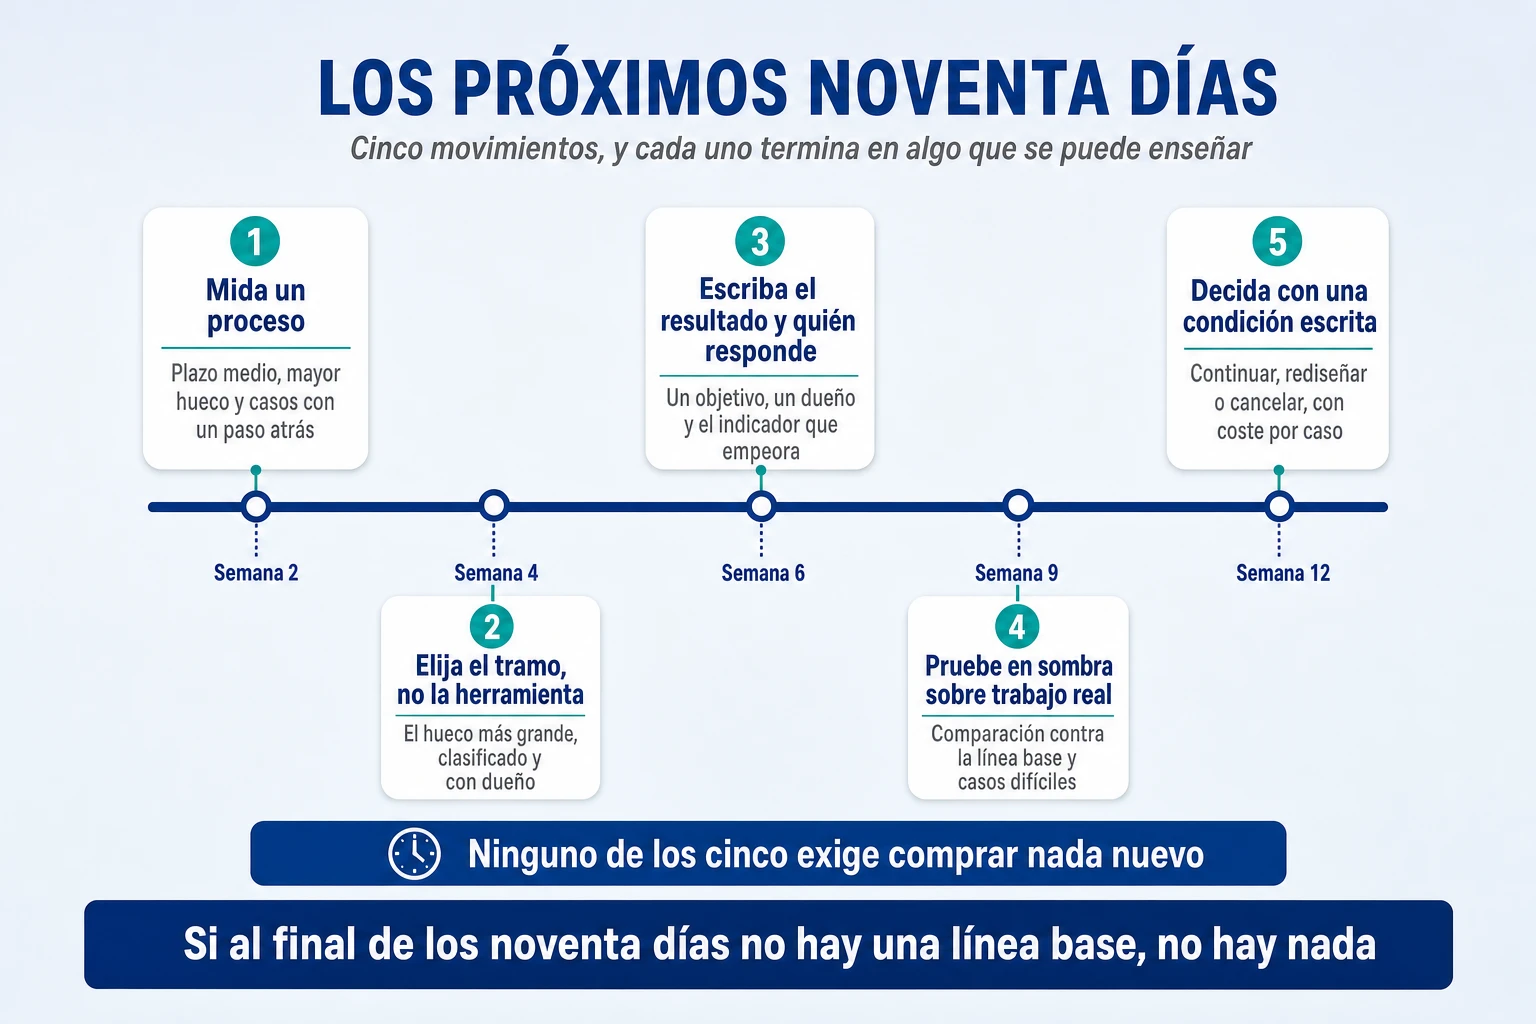
El segundo es elegir el tramo y no la herramienta. Coja el hueco más grande que haya salido del paso anterior y clasifíquelo: espera pactada con un tercero, espera por cola o espera por error. Si es pactada, el trabajo está en otra conversación y es mejor saberlo antes de gastar un euro. Si es por cola, el problema es de capacidad o de reglas de asignación y puede que no necesite inteligencia artificial en absoluto. Y si es por error, ahí está el dinero, porque es trabajo que ya se hizo una vez. Solo después de esa clasificación tiene sentido preguntarse qué tecnología encaja, y con las cuatro preguntas en orden que decían que la mayoría de los casos no necesita un agente.
El tercero es escribir el resultado y quién responde de él, en una página y antes de que se mueva dinero. Un objetivo expresado en coste o plazo por caso, no en adopción. Un dueño del proceso con nombre, que no es el director de tecnología. El indicador departamental que se va a dar por bueno aunque empeore, que es la parte que convierte una lista de buenas intenciones en una decisión de dirección. Y el destino de la capacidad que se libere, porque si eso no está decidido antes, no se decide después.
El cuarto es probar en sombra sobre trabajo real. Deje correr el sistema en paralelo sin que su respuesta se aplique, incluyendo a propósito los casos difíciles y las excepciones, y compare lo que habría hecho con lo que hizo la persona. Mida el coste por caso de verdad, con la supervisión y los reintentos dentro. Y aproveche para escribir la condición de terminado en cada traspaso que toque, porque es el momento más barato de hacerlo.
Y el quinto es decidir con una condición escrita de antemano: continuar, rediseñar o cancelar, con el coste por caso y la comparación contra la línea base sobre la mesa. Esa condición tiene que estar escrita antes de la prueba, no después, por una razón que cualquiera reconoce: después, todo el mundo en la sala tiene ya una opinión que defender.
Cierra este apartado con la prueba de que se ha hecho bien, que es más exigente de lo que parece. Si al final de los noventa días no existe una línea base tomada antes, no hay nada, por muchas demostraciones que se hayan enseñado. Y si existe, aunque el piloto haya salido regular, la empresa tiene algo que antes no tenía y que no se puede comprar: la capacidad de saber si lo siguiente funciona.
Cómo leer la próxima cifra que le pongan delante
Queda una última capacidad que merece la pena tener antes de la siguiente reunión, y es la de desarmar una cifra en treinta segundos. Casi todas las decisiones malas de este terreno se toman con un número en una diapositiva que nadie ha interrogado, y basta con cinco preguntas en orden para saber si merece la pena seguir escuchando.
La primera es quién lo publica y qué vende. No para descartar la fuente —las consultoras y los proveedores tienen a menudo los mejores datos— sino para saber en qué dirección conviene dudar. La segunda es qué mide exactamente: no es lo mismo uso declarado que retorno cobrado, ni madurez autoevaluada que margen auditado, y esas tres cosas aparecen en el mismo tipo de titular. La tercera es sobre qué muestra: cuántos, de qué tamaño, de qué país y respondiendo voluntariamente a qué. La cuarta es frente a qué línea base, porque sin punto de partida no hay mejora, solo una fotografía. Y la quinta, que es la que casi nunca se contesta, es con qué grupo de comparación: qué habría pasado si no se hubiera hecho nada.
Las cinco se resumen en una sola regla de higiene que vale también para las cifras de este artículo: desconfíe de toda cifra sobre inteligencia artificial empresarial cuyo denominador no esté explícito. El noventa y cinco por ciento que fracasa y el cinco por ciento que acierta son el mismo fenómeno contado desde dos muestras blandas, y las dos se mueven cuando cambia el humor del sector. Lo que no se mueve son las mediciones hechas contra registros, y todas apuntan a lo mismo: efectos de un solo dígito, repartidos de forma muy desigual y concentrados en quien además cambió la forma de trabajar.
Lo que de verdad hay que cambiar
Si hubiera que quedarse con una sola frase de todo lo anterior, sería esta: el problema no es que las empresas gestionen mal sus proyectos de inteligencia artificial, es que los gestionan bien, pero como proyectos de tecnología. Y un proyecto de tecnología bien gestionado entrega una tecnología funcionando, que es exactamente lo que estas empresas tienen y exactamente lo que no están buscando.
De ahí salen cinco desplazamientos, y los cinco son de gestión y no de arquitectura. El primero es dejar de pensar en casos de uso y empezar a pensar en procesos completos, porque la unidad que produce valor es el flujo de punta a punta y no la actividad que resulta cómodo automatizar. El segundo es anteponer la simplificación a la automatización: antes de automatizar una actividad hay que preguntarse si debe existir, y a veces el mejor uso de esta tecnología es demostrar que no. El tercero es sustituir la adopción por la captura de valor, con alguien que responda de qué pasa con la capacidad liberada. El cuarto es dejar de encadenar proyectos y empezar a construir capacidades que alguien mantiene. Y el quinto, el más difícil, es pasar de gestionar un cambio a tener capacidad de cambiar: el reto no es conseguir que la gente acepte una herramienta nueva, es construir una organización que pueda rediseñarse otra vez el año que viene sin que eso sea un programa extraordinario.
Esa última idea merece una frase más, porque cambia cómo hay que planificar. Esta transformación no tiene un final claro. Los procesos que hoy se diseñan alrededor de unas capacidades concretas pueden quedar desfasados antes de haber recuperado la inversión, y eso no es un motivo para no hacerlos: es un motivo para hacerlos modulares, para escribir desde el principio qué señal obligará a replantearlos y para no comprometer tres años de trabajo en una arquitectura que supone que nada va a cambiar.
La buena noticia, y con esto se cierra, es que nada de lo anterior exige tener la mejor tecnología. El experimento de las quinientas quince empresas lo dejaba claro: con la misma herramienta y el mismo acceso, lo que separaba a unas de otras era saber dónde encajaba en su trabajo. Los equipos que están sacando resultados de la inteligencia artificial no son más listos ni tienen mejores modelos. Han entendido antes que lo que estaban comprando no era una herramienta, sino una excusa para rediseñar cómo trabajan.
Si está en medio de esa conversación en su empresa —o si tiene las licencias desplegadas y el resultado sin aparecer— en Transformalix ayudamos a medir dónde se va de verdad el tiempo de un proceso y a convertirlo en un rediseño con dueño, línea base y condición de avance. Hablemos.